首页 文章 精选 留言 我的

精选列表

搜索[手游加固],共7862篇文章
优秀的个人博客,低调大师

数据资产两手抓 智能化和安全性缺一不可

随着5G、物联网、自动驾驶、人工智能等技术逐步落地到各行各业,人们面对的数据量也达到了前所未有的量级——世界上90%的数据是在过去两年产生的,到2025年数据将成倍增长10倍,攀升至163ZB。工业、金融、医疗、娱乐、媒体等行业每天都在产生PB级的信息量,而ML/DL、VR/AR等新兴技术的应用让数据曲线呈现了指数级的增长趋势,相对应的数据所在的环境也在向云、边、端蔓延,如何让数据更加敏捷、可视化,访问速度更快,管理更便捷,从而提升企业数据运营能力,是最大化数据价值的关键。 基于大数据的个性化推荐已屡见不鲜,似乎只要数据维度和量级足够丰富,AI对其的价值挖掘就会用之不竭。数据让AI有了应用价值,如Facebook会利用AI来预测用户的未来行为,作为广告投放的依据,所参考的信息包括:位置、设备信息、图片/视频浏览记录、WiFi连接状态、好友关系、聊天内容等等。然而,要想找出背后的关联性,就要对人与人、人与物、物与物之间数据“神经元”进行分析,但这并不容易,尤其是在人均管理的数据量呈现指数及增长的时候。 但与此同时,大数据在云环境的安全性正在遭受考验。与传统IT系统相比,用户和服务商的身份发生了转变,数据的所有方和托管者的角色相互独立,这就引发了对于数据信息的新挑战。数据在公有云网络上具有高度虚拟化、智能化、规模化、可扩展的特性,而资源共享也为黑客提供了便捷渠道,让数据成了APT的 “标靶”,可能在产生、传输、接收等任一流程发生泄漏。 由IBM Security资助、Ponemon Institute LLC独立开展的一项调查显示,尽管平均数据泄露成本下降了10%,单条成本下降了2.9%。不过数据泄露事件的平均规模(丢失或被盗的记录条数)却上升了1.8%。2016年,数据泄露平均总成本增加5.4%,而数据泄露事件的平均规模上升了3.2%,异常客户流失率和单条成本均上升了2.9%。可见,数据安全性并没有随着技术的演进有显著加强。 对于云服务商来说,既可以选择RAID部署,也可以在多个存储节点之间各写入几个对象副本,这样当某个节点出现故障时,其他节点的数据能够持续补充,或者利用数据副本快速恢复丢失的信息。同时,系统也可借助冗余备份来组成并联模型提升可靠性。多数情况下,云端应用会通过共享密钥、生物识别、对象去标识、加密算法、虚拟机扫描等方式保障数据安全。 对于传统原始数据来说,各个业务应用所储存的数据并不能做到完全互通,这就导致了数据孤岛,数据源既有结构化,也有分析化的,还有流式的,把这些商用大数据汇聚起来就成了数据湖,同样是存数据,这与以往的数据仓库是不一样的,二者的目标就不相同。例如,数据湖可囊括AI县相关的数据,这里面就包括了结构化数据、非结构化数据、半结构化数据,而数据仓库只能对结构化数据发挥作用。从调用来看,数据湖包括的信息通常可以被高频访问,为企业带来新的运营方向,而数据仓库的数据则是按需来调取。 Aberdeen的一项调查表明,实施数据湖的组织比同类公司在有机收入增长方面高出 9%。这些领导者能够进行新类型的分析,例如通过日志文件、来自点击流的数据、社交媒体以及存储在数据湖中的互联网连接设备等新来源的机器学习。这有助于他们通过吸引和留住客户、提高生产力、主动维护设备以及做出明智的决策来更快地识别和应对业务增长机会。 站在传统数据仓库的角度,数据脱格和数据解耦是必备的动作,这不是在原有生产系统所进行的,而是发生在数据仓库中,而在大数据时代这个动作就变成了数据湖,对元数据进行管理。对象存储有了元数据管理,用户可以拥有更大的数据湖。在完成数据脱格的时候,能够把数据有效管理起来,为后续的数据质量治理、数据管理提升打好基础。 事实上,从大型机时代的DB2到后来的关系型数据库,再到数据仓库、商业智能,最初就是以批处理、集中式的方式去解决结构化数据的处理需求,直到商业大数据的成熟使得数据分析有了更大的价值。不过在数据湖逐渐出现之后,传统集中化的处理开始难以应付大规模数据,于是就有了以Hadoop为代表的分布式处理技术。 Google曾做过一项调查,数据科学家仅有少数时间在写代码,更多的时间放在了数据抽取、数据清洗、数据治理等“数据管道”的工作上。由此可见,一个多功能、智能化、高效易用的管道对于帮助数据科学家提升工作效率、挖掘数据价值有着关键作用。 实时性、智能化、高弹性,使得云上构建数据湖成为了很多用户的选择。ESG研究发现,39% 的调查对象认为云部署主要用于分析,41%认为用于数据仓库,43%认为用于Spark。此时,数据湖的无缝传输和稳定性变得更加重要。以AWS为例,其要做的第一步就是将数据移动到云中。要知道,带宽和传输速度的物理限制在不会造成重大中断、高成本和长时间的前提下,限制了移动数据的能力。 然而在数据的传输过程中,SSL协议会被用来解决安全问题。通常,SSL协议层在TCP/IP层和应用层之间,可以使用不对称加密技术实现会话双方信息的传递,能够保证完整性和私密性,以及识别对方的身份。例如,配置服务器的SSL不仅需要验证用户身份,还要求浏览器提供用户证书。之后,客户端会检查服务器证书,如果检查失败,则不能建立SSL连接。如果成功,则继续。 可以说,云计算时代的大数据面临的威胁与日俱增,而如何给予用户安全感是云服务商要思考的问题。一方面,要让用户掌握对数据的控制权,采取多级加密验证机制,让用户能够监测到文件创建以来的元数据,另一方面也要做好健全的安全赔付机制,这样才会让用户放心地将数据迁移上云。

优秀的个人博客,低调大师

【Oracle数据库】手滑删错数据,一步步教你如何挽救?

2 --> 作者简介 作者:LuciferLiu,中国DBA联盟(ACDU)成员。 目前从事Oracle DBA工作,曾从事 Oracle 数据库开发工作,主要服务于生产制造,汽车金融等行业。 现拥有Oracle OCP,OceanBase OBCA认证,擅长Oracle数据库运维开发,备份恢复,安装迁移,Linux自动化运维脚本编写等。 前言 常在河边走,哪能不湿鞋? 今天有客户联系说误更新数据表,导致数据错乱了,希望将这张表恢复到 一周前 的指定时间点。 数据库版本为 11.2.0.1 操作系统是 Windows64 数据已经被更改超过1周时间 数据库已开启归档模式 没有DG容灾 有RMAN备份 一、分析 以下只列出常规恢复手段: 数据已经误操作超过一周,所以排除使用UNDO快照来找回。 没有DG容灾环境,排除使用DG闪回。 主库已开启归档模式,并且存在RMAN备份,可使用RMAN异机恢复表对应表空间,使用DBLINK捞回数据表。 Oracle 12C后支持单张表恢复。 结论:安全起见,使用RMAN异机恢复表空间来捞回数据表。 二、思路 客户希望将表数据恢复到 <2021/06/08 17:00:00> 之前某个时间点。 大致操作步骤如下: 主库查询误更新数据表对应的表空间和无需恢复的表空间。 新主机安装Oracle 11.2.0.1数据库软件,无需建库,目录结构最好保持一致。 主库拷贝参数文件,密码文件至新主机,根据新主机修改参数文件和创建新实例所需目录。 新主机使用修改后的参数文件打开数据库实例到nomount状态。 主库拷贝备份的控制文件至新主机,新主机使用RMAN恢复控制文件,并且MOUNT新实例。 新主机RESTORE TABLESPACE恢复至时间点 <2021/06/08 16:00:00>。 新主机RECOVER DATABASE SKIP TABLESPACE恢复至时间点 <2021/06/08 16:00:00>。 新主机实例开启到只读模式。 确认新主机实例的表数据是否正确,若不正确则重复 第7步 调整时间点慢慢往 <2021/06/08 17:00:00> 推进恢复。 主库创建连通新主机实例的DBLINK,通过DBLINK从新主机实例捞取表数据。 注意:选择表空间恢复是因为主库数据量比较大,如果全库恢复需要大量时间。 三、测试环境模拟 为了数据脱敏,因此以测试环境模拟场景进行演示。 1 环境准备 节点 主机版本 主机名 实例名 Oracle版本 IP地址 主库 rhel6.9 orcl orcl 11.2.0.1 10.211.55.111 新主机 rhel6.9 orcl 不创建实例 11.2.0.1 10.211.55.112 环境部署可以通过Oracle一键安装脚本 进行初始化环境,然后手动安装即可。 主库:./OracleShellInstall.sh -i 10.211.55.111 -m Y 新主机:./OracleShellInstall.sh -i 10.211.55.112 -m Y 2、模拟测试场景 主库开启归档模式 --设置归档路径 alter system set log_archive_dest_1='LOCATION=/archivelog'; --重启开启归档模式 shutdown immediate startup mount alter database archivelog; --打开数据库 alter database open; 创建测试数据 sqlplus / as sysdba --创建表空间 create tablespace lucifer datafile '/oradata/orcl/lucifer01.dbf' size 10M autoextend off; create tablespace ltest datafile '/oradata/orcl/ltest01.dbf' size 10M autoextend off; --创建用户 create user lucifer identified by lucifer; grant dba to lucifer; --创建表 conn lucifer/lucifer create table lucifer(id number not null,name varchar2(20)) tablespace lucifer; --插入数据 insert into lucifer values(1,'lucifer'); insert into lucifer values(2,'test1'); insert into lucifer values(3,'test2'); commit; 进行数据库全备 run { allocate channel c1 device type disk; allocate channel c2 device type disk; crosscheck backup; crosscheck archivelog all; sql"alter system switch logfile"; delete noprompt expired backup; delete noprompt obsolete device type disk; backup database include current controlfile format '/backup/backlv0_%d_%T_%t_%s_%p'; backup archivelog all DELETE INPUT; release channel c1; release channel c2; } 模拟数据修改 sqlplus / as sysdba conn lucifer/lucifer delete from lucifer where id=1; update lucifer set name='lucifer' where id=2; commit; 注意:为了模拟客户环境,假设无法通过UNDO快照找回,当前删除时间点为:<2021/06/17 18:10:00>。 如果使用UNDO快照,比较方便: --查找UNDO快照数据是否正确 select * from lucifer.lucifer as of timestamp to_timestamp('2021-06-17 18:05:00','YYYY-MM-DD HH24:MI:SS'); --将UNDO快照数据捞至新建表中 create table lucifer.lucifer_0617 as select * from lucifer.lucifer as of timestamp to_timestamp('2021-06-17 18:05:00','YYYY-MM-DD HH24:MI:SS'); 四、RMAN完整恢复过程 1 主库查询误更新数据表对应的表空间和无需恢复的表空间 --查询误更新数据表对应表空间 select owner,tablespace_name from dba_segments where segment_name='LUCIFER'; --查询所有表空间 select tablespace_name from dba_tablespaces; 2 主库拷贝参数文件,密码文件至新主机,根据新主机修改参数文件和创建新实例所需目录 ##生成pfile参数文件 sqlplus / as sysdba create pfile='/home/oracle/pfile.ora' from spfile; ##拷贝至新主机 su - oracle scp /home/oracle/pfile.ora 10.211.55.112:/tmp scp $ORACLE_HOME/dbs/orapworcl 10.211.55.112:$ORACLE_HOME/dbs ###新主机根据实际情况修改参数文件并且创建目录 mkdir -p /u01/app/oracle/admin/orcl/adump mkdir -p /oradata/orcl/ mkdir -p /archivelog chown -R oracle:oinstall /archivelog chown -R oracle:oinstall /oradata 3 新主机使用修改后的参数文件打开数据库实例到nomount状态 sqlplus / as sysdba startup nomount pfile='/tmp/pfile.ora'; 4 主库拷贝备份的控制文件至新主机,新主机使用RMAN恢复控制文件,并且MOUNT新实例 rman target / list backup of controlfile; ##拷贝备份文件至新主机 scp /backup/backlv0_ORCL_20210617_107548592* 10.211.55.112:/tmp scp /u01/app/oracle/product/11.2.0/db/dbs/0c01l775_1_1 10.211.55.112:/tmp ##新主机恢复控制文件并开启到mount状态 rman target / restore controlfile from '/tmp/backlv0_ORCL_20210617_1075485924_9_1'; alter database mount; 通过 list backup of controlfile; 可以看到控制文件位置。 5 新主机RESTORE TABLESPACE恢复至时间点 <2021/06/17 18:06:00> ##新主机注册备份集 rman target / catalog start with '/tmp/backlv0_ORCL_20210617_107548592'; crosscheck backup; delete noprompt expired backup; delete noprompt obsolete device type disk; ##恢复表空间LUCIFER和系统表空间,指定时间点 `2021/06/17 18:06:00` run { sql 'alter session set nls_date_format="yyyy-mm-dd hh24:mi:ss"'; set until time '2021-06-17 18:06:00'; allocate channel ch01 device type disk; allocate channel ch02 device type disk; restore tablespace SYSTEM,SYSAUX,UNDOTBS1,USERS,LUCIFER; release channel ch01; release channel ch02; } 6 新主机RECOVER DATABASE SKIP TABLESPACE恢复至时间点 <2021/06/17 18:06:00> rman target / run { sql 'alter session set nls_date_format="yyyy-mm-dd hh24:mi:ss"'; set until time '2021-06-17 18:06:00'; allocate channel ch01 device type disk; recover database skip tablespace LTEST,EXAMPLE; release channel ch01; } 这里有一个小BUG:客户环境是Windows,执行这一步最后报错,手动offline数据文件依然无法开启数据库。解决方案: --将恢复跳过的表空间都offline drop掉,执行以下查询结果 select 'alter database datafile '|| file_id ||' offline drop;' from dba_data_files where tablespace_name in ('LTEST','EXAMPLE'); --再次开启数据库 alter database open read only; 注意:如果显示缺归档日志,可以参考如下步骤: ##查询恢复需要的归档日志号时间 alter session set nls_date_format="yyyy-mm-dd hh24:mi:ss"; select first_time,sequence# from v$archived_log where sequence#='7'; ##通过备份RESTORE吐出所需的归档日志 rman target / catalog start with '/tmp/0c01l775_1_1'; crosscheck archivelog all; run { allocate channel ch01 device type disk; SET ARCHIVELOG DESTINATION TO '/archivelog'; restore ARCHIVELOG SEQUENCE 7; release channel ch01; } ##再次recover进行恢复至指定时间点 2021-06-17 18:06:00 run { sql 'alter session set nls_date_format="yyyy-mm-dd hh24:mi:ss"'; set until time '2021-06-17 18:06:00'; allocate channel ch01 device type disk; recover database skip tablespace LTEST,EXAMPLE; release channel ch01; } 7 新主机实例开启到只读模式 sqlplus / as sysdba alter database open read only; 8 确认新主机实例的表数据是否正确 select * from lucifer.lucifer; 注意:若不正确则重复 第7步 调整时间点慢慢往 2021/06/17 18:10:00 推进恢复: ##关闭数据库 sqlplus / as sysdba shutdown immediate; ##开启数据库到mount状态 startup mount pfile='/tmp/pfile.ora'; ##重复 第7步,往前推进1分钟,调整时间点为 `2021/06/08 18:07:00` rman target / run { sql 'alter session set nls_date_format="yyyy-mm-dd hh24:mi:ss"'; set until time '2021-06-17 18:07:00'; allocate channel ch01 device type disk; recover database skip tablespace LTEST,EXAMPLE; release channel ch01; } 9 主库创建连通新主机实例的DBLINK,通过DBLINK从新主机实例捞取表数据 sqlplus / as sysdba CREATE PUBLIC DATABASE LINK ORCL112 CONNECT TO lucifer IDENTIFIED BY lucifer USING '(DESCRIPTION_LIST= (DESCRIPTION= (ADDRESS=(PROTOCOL=tcp)(HOST=10.211.55.112)(PORT=1521)) (CONNECT_DATA= (SERVICE_NAME=orcl) ) ) )'; --通过dblink捞取数据 create table lucifer.lucifer_0618 as select /*+full(lucifer)*/ * from lucifer.lucifer@ORCL112; select * from lucifer.lucifer_0618; 至此,整个RMAN恢复过程就结束了。 总之,有备份什么都好说。所以,作为DBA,备份一定要做好!!!

优秀的个人博客,低调大师

《Spring 手撸专栏》第 2 章:小试牛刀,实现一个简单的Bean容器!

持续坚持原创输出,点击蓝字关注我吧 作者:小傅哥博客:https://bugstack.cn ❝ 沉淀、分享、成长,让自己和他人都能有所收获!😜 ❞ 目录 一、前言 二、目标 三、设计 四、实现 1. 工程结构 2. Bean 定义 3. Bean 工厂 五、测试 1. 事先准备 2. 测试用例 3. 测试结果 六、总结 七、系列推荐 一、前言 上学时,老师总说:不会你就问,但多数时候都不知道要问什么! 你总会在小傅哥的文章前言里,发现一些关于成长、学习、感悟以及对当篇内容的一个介绍,其实之所以写这样的铺垫性内容,主要是为了让大家对接下来的内容学习有一个较轻松的开场和过度。 就像我们上学时如果某一科的内容不会时,老师经常会说,你有不会的就要问。但对于学生本身来讲,可能已经不会的太多了,或者压根不知道自己不会什么,只有等看到老师出完的试卷才发现自己什么都不会。但要是让问,又不知道从哪问,问出萝卜带出泥,到处都是知识漏洞。 所以我希望用一些前置内容的铺垫,让大家可以在一个稍有共识的场景下进行学习,或多或少能为你铺垫出一个稍许平缓的接受期。有可能某些时候也会打打鸡血、刺激刺激学习、总归把知识学到手就是好的! 二、目标 Spring Bean 容器是什么? Spring 包含并管理应用对象的配置和生命周期,在这个意义上它是一种用于承载对象的容器,你可以配置你的每个 Bean 对象是如何被创建的,这些 Bean 可以创建一个单独的实例或者每次需要时都生成一个新的实例,以及它们是如何相互关联构建和使用的。 如果一个 Bean 对象交给 Spring 容器管理,那么这个 Bean 对象就应该以类似零件的方式被拆解后存放到 Bean 的定义中,这样相当于一种把对象解耦的操作,可以由 Spring 更加容易的管理,就像处理循环依赖等操作。 当一个 Bean 对象被定义存放以后,再由 Spring 统一进行装配,这个过程包括 Bean 的初始化、属性填充等,最终我们就可以完整的使用一个 Bean 实例化后的对象了。 而我们本章节的案例目标就是定义一个简单的 Spring 容器,用于定义、存放和获取 Bean 对象。 三、设计 凡是可以存放数据的具体数据结构实现,都可以称之为容器。例如:ArrayList、LinkedList、HashSet等,但在 Spring Bean 容器的场景下,我们需要一种可以用于存放和名称索引式的数据结构,所以选择 HashMap 是最合适不过的。 这里简单介绍一下 HashMap,HashMap 是一种基于扰动函数、负载因子、红黑树转换等技术内容,形成的拉链寻址的数据结构,它能让数据更加散列的分布在哈希桶以及碰撞时形成的链表和红黑树上。它的数据结构会尽可能最大限度的让整个数据读取的复杂度在 O(1) ~ O(Logn) ~O(n)之间,当然在极端情况下也会有 O(n) 链表查找数据较多的情况。不过我们经过10万数据的扰动函数再寻址验证测试,数据会均匀的散列在各个哈希桶索引上,所以 HashMap 非常适合用在 Spring Bean 的容器实现上。 另外一个简单的 Spring Bean 容器实现,还需 Bean 的定义、注册、获取三个基本步骤,简化设计如下; 定义:BeanDefinition,可能这是你在查阅 Spring 源码时经常看到的一个类,例如它会包括 singleton、prototype、BeanClassName 等。但目前我们初步实现会更加简单的处理,只定义一个 Object 类型用于存放对象。 注册:这个过程就相当于我们把数据存放到 HashMap 中,只不过现在 HashMap 存放的是定义了的 Bean 的对象信息。 获取:最后就是获取对象,Bean 的名字就是key,Spring 容器初始化好 Bean 以后,就可以直接获取了。 接下来我们就按照这个设计,做一个简单的 Spring Bean 容器代码实现。编码的过程往往并不会有多复杂,但知晓设计过程却更加重要! 四、实现 1. 工程结构 small-spring-step-01└──src├──main│└──java│└──cn.bugstack.springframework│├──BeanDefinition.java│└──BeanFactory.java└──test└──java└──cn.bugstack.springframework.test├──bean│└──UserService.java└──ApiTest.java 工程源码:https://github.com/small-spring/small-spring-step-01 (公众号:bugstack虫洞栈,回复:Spring 专栏,获取整套源码) Spring Bean 容器类关系,如图 2-2 图 2-2 Spring Bean 容器的整个实现内容非常简单,也仅仅是包括了一个简单的 BeanFactory 和 BeanDefinition,这里的类名称是与 Spring 源码中一致,只不过现在的类实现会相对来说更简化一些,在后续的实现过程中再不断的添加内容。 BeanDefinition,用于定义 Bean 实例化信息,现在的实现是以一个 Object 存放对象 BeanFactory,代表了 Bean 对象的工厂,可以存放 Bean 定义到 Map 中以及获取。 2. Bean 定义 cn.bugstack.springframework.BeanDefinition publicclassBeanDefinition{privateObjectbean;publicBeanDefinition(Objectbean){this.bean=bean;}publicObjectgetBean(){returnbean;}} 目前的 Bean 定义中,只有一个 Object 用于存放 Bean 对象。如果感兴趣可以参考 Spring 源码中这个类的信息,名称都是一样的。 不过在后面陆续的实现中会逐步完善 BeanDefinition 相关属性的填充,例如:SCOPE_SINGLETON、SCOPE_PROTOTYPE、ROLE_APPLICATION、ROLE_SUPPORT、ROLE_INFRASTRUCTURE 以及 Bean Class 信息。 3. Bean 工厂 cn.bugstack.springframework.BeanFactory publicclassBeanFactory{privateMap<String,BeanDefinition>beanDefinitionMap=newConcurrentHashMap<>();publicObjectgetBean(Stringname){returnbeanDefinitionMap.get(name).getBean();}publicvoidregisterBeanDefinition(Stringname,BeanDefinitionbeanDefinition){beanDefinitionMap.put(name,beanDefinition);}} 在 Bean 工厂的实现中,包括了 Bean 的注册,这里注册的是 Bean 的定义信息。同时在这个类中还包括了获取 Bean 的操作。 目前的 BeanFactory 仍然是非常简化的实现,但这种简化的实现内容也是整个 Spring 容器中关于 Bean 使用的最终体现结果,只不过实现过程只展示出基本的核心原理。在后续的补充实现中,这个会不断变得庞大。 五、测试 1. 事先准备 cn.bugstack.springframework.test.bean.UserService publicclassUserService{publicvoidqueryUserInfo(){System.out.println("查询用户信息");}} 这里简单定义了一个 UserService 对象,方便我们后续对 Spring 容器测试。 2. 测试用例 cn.bugstack.springframework.test.ApiTest @Testpublicvoidtest_BeanFactory(){//1.初始化BeanFactoryBeanFactorybeanFactory=newBeanFactory();//2.注册beanBeanDefinitionbeanDefinition=newBeanDefinition(newUserService());beanFactory.registerBeanDefinition("userService",beanDefinition);//3.获取beanUserServiceuserService=(UserService)beanFactory.getBean("userService");userService.queryUserInfo();} 在单测中主要包括初始化 Bean 工厂、注册 Bean、获取 Bean,三个步骤,使用效果上贴近与 Spring,但显得会更简化。 在 Bean 的注册中,这里是直接把 UserService 实例化后作为入参传递给 BeanDefinition 的,在后续的陆续实现中,我们会把这部分内容放入 Bean 工厂中实现。 3. 测试结果 查询用户信息Processfinishedwithexitcode0 通过测试结果可以看到,目前的 Spring Bean 容器案例,已经稍有雏形。 六、总结 整篇关于 Spring Bean 容器的一个雏形就已经实现完成了,相对来说这部分代码并不会难住任何人,只要你稍加尝试就可以接受这部分内容的实现。 但对于一个知识的学习来说,写代码只是最后的步骤,往往整个思路、设计、方案,才更重要,只要你知道了因为什么、所以什么,才能让你有一个真正的理解。 下一章节会在此工程基础上扩容实现,要比现在的类多一些。不过每一篇的实现上,我都会以一个需求视角进行目标分析和方案设计,让大家在学习编码之外更能注重更多技术价值的学习。 七、系列推荐 毕业前写了20万行代码,让我从成为同学眼里的面霸! HashMap核心知识,扰动函数、负载因子、扩容链表拆分,深度学习 HashMap数据插入、查找、删除、遍历,源码分析 看图说话,讲解2-3平衡树「红黑树的前身」 《SpringBoot 中间件设计和开发》| 对,小傅哥这次教你造火箭! - END - 下方扫码关注 bugstack虫洞栈,与小傅哥一起学习成长、共同进步,做一个码场最贵Coder! 回复【设计模式】,下载《重学Java设计模式》,这是一本互联网真实案例的实践书籍,从实际业务中抽离出,交易、营销、秒杀、中间件、源码等众多场景进行学习代码设计。 回复【面经手册】,下载《面经手册•拿大厂Offer》,这是一本有深度的Java核心内容,从数据结构、算法、并发编程以及JVM系8不断深入讲解,让懂了就是真的懂。 你好,我是小傅哥。一线互联网 java 工程师、架构师,开发过交易&营销、写过运营&活动、设计过中间件也倒腾过中继器、IO板卡。不只是写Java语言,也搞过C#、PHP,是一个技术活跃的折腾者。 2020年写了一本PDF 《重学Java设计模式》 ,全网下载量30万+,帮助很多同学成长。同年 github 的两个项目, CodeGuide 、 itstack-demo-design ,持续霸榜 Trending,成为全球热门项目。 2021年上架一本小册 《SpringBoot 中间件设计和开发》 ,16个互联网中间件场景、30个工程,是全网唯一一次手把手教你造轮子、写中间件,因为这样的技术离P7最近、离架构师最近、离高薪资最近! 本文分享自微信公众号 - bugstack虫洞栈(bugstack)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

手撸golang 基本数据结构与算法 图的最短路径 A*(A-Star)算法

缘起 最近阅读<<我的第一本算法书>>(【日】石田保辉;宫崎修一) 本系列笔记拟采用golang练习之 A*(A-Star)算法 A*(A-Star)算法也是一种在图中求解最短路径问题的算法, 由狄克斯特拉算法发展而来。 A*算法不仅会考虑从起点到候补顶点的距离, 还会考虑从当前所在顶点到终点的估算距离。 距离估算值越接近当前顶点到终点的实际值, A*算法的搜索效率也就越高. 当距离估算值小于实际距离时, 是一定可以得到正确答案的. A*算法在游戏编程中经常被用于计算敌人追赶玩家时的行动路线等. 摘自 <<我的第一本算法书>> 【日】石田保辉;宫崎修一 场景 如下图, 某游戏中, 地图是网格状的, 我方在S点, 敌人在G点, 空白区域是湖泊/树林等不可到达区域: 现在需要追击敌人, 因此需要计算S点到G点的最短行进路线. A*算法是以狄克斯特拉算法为基础, 区别是在计算候选节点的权重时, 需要同时考虑测量权重和估算权重. 此场景中, 使用S点到G点坐标的直线距离作为估算权重. 估算权重的作用就像牵引风筝的绳子, 使得每次选取的候选节点, 尽量是靠往终点方向. 流程 给定若干顶点, 以及顶点间的若干条边, 寻找从指定起点srcNode到指定终点dstNode的最小权重路径 设定srcNode的权重为0, 其他顶点的权重为无穷大 计算所有节点到dstNode节点的估算距离, 以x,y坐标的直线距离作为估算值 节点.总权重 = 节点.测量权重 + 节点.估算权重 将srcNode节点送入候选堆 for 候选堆不为空: 从候选堆pop顶点node, node是总权重最小的候选节点 如果node.id == dstNode.id, 循环结束 遍历从node出发的所有边, 将边的终点to的测量权重, 更新为min(to.测量权重, node.测量权重+边.权重) 如果to.测量权重 > node.测量权重+边.权重, 说明更新有效 如果更新有效, 判断to是否在堆中, 如果是, 则上浮以维护堆秩序, 否则, 将to节点push入候选堆 判断dstNode的测量权重是否被更新(!=无穷大), 如果是则说明存在最短路径 反向查找最短路径: 设定当前节点current = 终点 push节点current进路径队列 遍历终点为current的边, 查找符合条件的node:边的起点.测量权重 = current.测量权重-边.权重 push节点node进路径队列 循环1-4, 直到current == srcNode, 查找完成 设计 INode: 顶点接口, 支持xy坐标和估算权重 ILine: 边接口 IPathFinder: 最短路径查找算法接口 IComparator: 顶点比较接口 IHeap: 顶点堆接口 tNode: 顶点, 实现INode tLine: 边, 实现ILine tNodeWeightComparator: 基于权重的顶点比较器, 实现IComparator接口 tArrayHeap: 堆的实现 tAStarPathFinder: A*算法的实现, 使用xy坐标的直线距离作为估算权重 单元测试 a_star_finder_test.go package graph import ( "fmt" "strings" "testing" ) import astar "learning/gooop/graph/a_star" func Test_AStarFinder(t *testing.T) { fnAssertTrue := func(b bool, msg string) { if !b { t.Fatal(msg) } } // 设定顶点 nodes := []astar.INode { astar.NewNode("11", 1, 1), astar.NewNode("21", 2, 1), astar.NewNode("31", 3, 1), astar.NewNode("12", 1, 2), astar.NewNode("32", 3, 2), astar.NewNode("13", 1, 3), astar.NewNode("33", 3, 3), astar.NewNode("43", 4, 3), astar.NewNode("53", 5, 3), astar.NewNode("63", 6, 3), astar.NewNode("73", 7, 3), astar.NewNode("14", 1, 4), astar.NewNode("34", 3, 4), astar.NewNode("74", 7, 4), astar.NewNode("15", 1, 5), astar.NewNode("35", 3, 5), astar.NewNode("55", 5, 5), astar.NewNode("65", 6, 5), astar.NewNode("75", 7, 5), astar.NewNode("16", 1, 6), astar.NewNode("36", 3, 6), astar.NewNode("56", 5, 6), astar.NewNode("17", 1, 7), astar.NewNode("27", 2, 7), astar.NewNode("37", 3, 7), astar.NewNode("47", 4, 7), astar.NewNode("57", 5, 7), astar.NewNode("67", 6, 7), astar.NewNode("77", 7, 7), } // 为相邻点创建边 var lines []astar.ILine mapNodes := make(map[string]astar.INode, len(nodes)) for _,it := range nodes { k := fmt.Sprintf("%v,%v", it.GetX(), it.GetY()) mapNodes[k] = it } for _,it := range nodes { if up,ok := mapNodes[fmt.Sprintf("%v,%v", it.GetX(), it.GetY() - 1)];ok { lines = append(lines, astar.NewLine(it.ID(), up.ID(), 1), astar.NewLine(up.ID(), it.ID(), 1)) } if down,ok := mapNodes[fmt.Sprintf("%v,%v", it.GetX(), it.GetY() + 1)];ok { lines = append(lines, astar.NewLine(it.ID(), down.ID(), 1), astar.NewLine(down.ID(), it.ID(), 1)) } if left,ok := mapNodes[fmt.Sprintf("%v,%v", it.GetX()-1, it.GetY())];ok { lines = append(lines, astar.NewLine(it.ID(), left.ID(), 1), astar.NewLine(left.ID(), it.ID(), 1)) } if right,ok := mapNodes[fmt.Sprintf("%v,%v", it.GetX()+1, it.GetY())];ok { lines = append(lines, astar.NewLine(it.ID(), right.ID(), 1), astar.NewLine(right.ID(), it.ID(), 1)) } } // a*算法 查找最短路径 ok,path := astar.AStarPathFinder.FindPath(nodes, lines, "33", "77") if !ok { t.Fatal("failed to find min path") } fnPathToString := func(nodes []astar.INode) string { items := make([]string, len(nodes)) for i,it := range nodes { items[i] = fmt.Sprintf("%s", it) } return strings.Join(items, " ") } pathString := fnPathToString(path) t.Log(pathString) fnAssertTrue(pathString == "33(0+6) 34(1+5) 35(2+4) 36(3+4) 37(4+4) 47(5+3) 57(6+2) 67(7+1) 77(8+0)", "incorrect path") } 测试输出 $ go test -v a_star_finder_test.go === RUN Test_AStarFinder a_star_finder_test.go:96: 33(0+6) 34(1+5) 35(2+4) 36(3+4) 37(4+4) 47(5+3) 57(6+2) 67(7+1) 77(8+0) --- PASS: Test_AStarFinder (0.00s) PASS ok command-line-arguments 0.002s INode.go 顶点接口, 支持xy坐标和估算权重 package a_star type INode interface { ID() string GetX() int GetY() int SetX(int) SetY(int) SetEstimatedWeight(int) SetMeasuredWeight(int) GetMeasuredWeight() int GetTotalWeight() int } const MaxWeight = int(0x7fffffff_00000000) ILine.go 边接口 package a_star type ILine interface { From() string To() string Weight() int } IPathFinder.go 最短路径查找算法接口 package a_star type IPathFinder interface { FindPath(nodes []INode, lines []ILine, from string, to string) (bool,[]INode) } IComparator.go 顶点比较接口 package a_star type IComparator interface { Less(a interface{}, b interface{}) bool } IHeap.go 顶点堆接口 package a_star type IHeap interface { Size() int IsEmpty() bool IsNotEmpty() bool Push(node interface{}) Pop() (bool, interface{}) IndexOf(node interface{}) int ShiftUp(i int) } tNode.go 顶点, 实现INode package a_star import "fmt" type tNode struct { id string x int y int measuredWeight int estimatedWeight int } func NewNode(id string, x int, y int) INode { return &tNode{ id,x, y, MaxWeight,0, } } func (me *tNode) ID() string { return me.id } func (me *tNode) GetX() int { return me.x } func (me *tNode) GetY() int { return me.y } func (me *tNode) SetX(x int) { me.x = x } func (me *tNode) SetY(y int) { me.y = y } func (me *tNode) SetEstimatedWeight(w int) { me.estimatedWeight = w } func (me *tNode) SetMeasuredWeight(w int) { me.measuredWeight = w } func (me *tNode) GetMeasuredWeight() int { return me.measuredWeight } func (me *tNode) GetTotalWeight() int { return me.estimatedWeight + me.measuredWeight } func (me *tNode) String() string { return fmt.Sprintf("%s(%v+%v)", me.id, me.measuredWeight, me.estimatedWeight) } tLine.go 边, 实现ILine package a_star type tLine struct { from string to string weight int } func NewLine(from string, to string, weight int) ILine { return &tLine{ from,to,weight, } } func (me *tLine) From() string { return me.from } func (me *tLine) To() string { return me.to } func (me *tLine) Weight() int { return me.weight } tNodeWeightComparator.go 基于权重的顶点比较器, 实现IComparator接口 package a_star import "errors" type tNodeWeightComparator struct { } func newNodeWeightComparator() IComparator { return &tNodeWeightComparator{ } } func (me *tNodeWeightComparator) Less(a interface{}, b interface{}) bool { if a == nil || b == nil { panic(gNullArgumentError) } n1 := a.(INode) n2 := b.(INode) return n1.GetTotalWeight() <= n2.GetTotalWeight() } var gNullArgumentError = errors.New("null argument error") tArrayHeap.go 堆的实现 package a_star import ( "errors" "fmt" "strings" ) type tArrayHeap struct { comparator IComparator items []interface{} size int version int64 } func newArrayHeap(comparator IComparator) IHeap { return &tArrayHeap{ comparator: comparator, items: make([]interface{}, 0), size: 0, version: 0, } } func (me *tArrayHeap) Size() int { return me.size } func (me *tArrayHeap) IsEmpty() bool { return me.size <= 0 } func (me *tArrayHeap) IsNotEmpty() bool { return !me.IsEmpty() } func (me *tArrayHeap) Push(value interface{}) { me.version++ me.ensureSize(me.size + 1) me.items[me.size] = value me.size++ me.ShiftUp(me.size - 1) me.version++ } func (me *tArrayHeap) ensureSize(size int) { for ;len(me.items) < size; { me.items = append(me.items, nil) } } func (me *tArrayHeap) parentOf(i int) int { return (i - 1) / 2 } func (me *tArrayHeap) leftChildOf(i int) int { return i*2 + 1 } func (me *tArrayHeap) rightChildOf(i int) int { return me.leftChildOf(i) + 1 } func (me *tArrayHeap) last() (i int, v interface{}) { if me.IsEmpty() { return -1, nil } i = me.size - 1 v = me.items[i] return i,v } func (me *tArrayHeap) IndexOf(node interface{}) int { n := -1 for i,it := range me.items { if it == node { n = i break } } return n } func (me *tArrayHeap) ShiftUp(i int) { if i <= 0 { return } v := me.items[i] pi := me.parentOf(i) pv := me.items[pi] if me.comparator.Less(v, pv) { me.items[pi], me.items[i] = v, pv me.ShiftUp(pi) } } func (me *tArrayHeap) Pop() (bool, interface{}) { if me.IsEmpty() { return false, nil } me.version++ top := me.items[0] li, lv := me.last() me.items[0] = nil me.size-- if me.IsEmpty() { return true, top } me.items[0] = lv me.items[li] = nil me.shiftDown(0) me.version++ return true, top } func (me *tArrayHeap) shiftDown(i int) { pv := me.items[i] ok, ci, cv := me.minChildOf(i) if ok && me.comparator.Less(cv, pv) { me.items[i], me.items[ci] = cv, pv me.shiftDown(ci) } } func (me *tArrayHeap) minChildOf(p int) (ok bool, i int, v interface{}) { li := me.leftChildOf(p) if li >= me.size { return false, 0, nil } lv := me.items[li] ri := me.rightChildOf(p) if ri >= me.size { return true, li, lv } rv := me.items[ri] if me.comparator.Less(lv, rv) { return true, li, lv } else { return true, ri, rv } } func (me *tArrayHeap) String() string { level := 0 lines := make([]string, 0) lines = append(lines, "") for { n := 1<<level min := n - 1 max := n + min - 1 if min >= me.size { break } line := make([]string, 0) for i := min;i <= max;i++ { if i >= me.size { break } line = append(line, fmt.Sprintf("%4d", me.items[i])) } lines = append(lines, strings.Join(line, ",")) level++ } return strings.Join(lines, "\n") } var gNoMoreElementsError = errors.New("no more elements") tAStarPathFinder.go A*算法的实现, 使用xy坐标的直线距离作为估算权重 package a_star import "math" type tAStarPathFinder struct { } func newAStarPathFinder() IPathFinder { return &tAStarPathFinder{} } func (me *tAStarPathFinder) FindPath(nodes []INode, lines []ILine, srcID string, dstID string) (bool,[]INode) { // 节点索引 mapNodes := make(map[string]INode, 0) for _,it := range nodes { mapNodes[it.ID()] = it } srcNode, ok := mapNodes[srcID] if !ok { return false, nil } dstNode,ok := mapNodes[dstID] if !ok { return false, nil } // 边的索引 mapFromLines := make(map[string][]ILine, 0) mapToLines := make(map[string][]ILine, 0) for _, it := range lines { if v,ok := mapFromLines[it.From()];ok { mapFromLines[it.From()] = append(v, it) } else { mapFromLines[it.From()] = []ILine{ it } } if v,ok := mapToLines[it.To()];ok { mapToLines[it.To()] = append(v, it) } else { mapToLines[it.To()] = []ILine{ it } } } for _,it := range nodes { // 设置src节点的weight为0, 其他节点的weight为MaxWeight if it.ID() == srcID { it.SetMeasuredWeight(0) } else { it.SetMeasuredWeight(MaxWeight) } // 计算每个节点到dst节点的估算距离 if it.ID() == dstID { it.SetEstimatedWeight(0) } else { it.SetEstimatedWeight(me.distance(it.GetX(), it.GetY(), dstNode.GetY(), dstNode.GetY())) } } // 将起点push到堆 heap := newArrayHeap(newNodeWeightComparator()) heap.Push(srcNode) // 遍历候选节点 for heap.IsNotEmpty() { _, top := heap.Pop() from := top.(INode) if from.ID() == dstID { break } links, ok := mapFromLines[from.ID()] if ok { for _,line := range links { if to,ok := mapNodes[line.To()];ok { if me.updateMeasuredWeight(from, to, line) { n := heap.IndexOf(to) if n >= 0 { heap.ShiftUp(n) } else { heap.Push(to) } } } } } } // 逆向查找最短路径 if dstNode.GetMeasuredWeight() >= MaxWeight { return false, nil } path := []INode{ dstNode } current := dstNode maxRound := len(lines) for ;current != srcNode && maxRound > 0;maxRound-- { linkedLines, _ := mapToLines[current.ID()] for _,line := range linkedLines { from, _ := mapNodes[line.From()] if from.GetMeasuredWeight() == current.GetMeasuredWeight() - line.Weight() { current = from path = append(path, from) } } } if current != srcNode { return false, nil } me.reverse(path) return true, path } func (me *tAStarPathFinder) distance(x0, y0, x1, y1 int) int { dx := x0 - x1 dy := y0 - y1 return int(math.Round(math.Sqrt(float64(dx * dx + dy * dy)))) } func (me *tAStarPathFinder) reverse(nodes []INode) { for i,j := 0, len(nodes)-1;i < j;i,j=i+1,j-1 { nodes[i], nodes[j] = nodes[j], nodes[i] } } func (me *tAStarPathFinder) updateMeasuredWeight(from INode, to INode, line ILine) bool { w := me.min(from.GetMeasuredWeight() + line.Weight(), to.GetMeasuredWeight()) if to.GetMeasuredWeight() > w { to.SetMeasuredWeight(w) return true } return false } func (me *tAStarPathFinder) min(a, b int) int { if a <= b { return a } return b } var AStarPathFinder = newAStarPathFinder() (end)

优秀的个人博客,低调大师

2020年Q1手机安全状况报告出炉 恶意程序成隐私“扒手”

即将开播:5月14日,Jenkins在K8S下的三种部署流程和实战演示 近日,360正式发布了《2020年第一季度中国手机安全状况报告》(以下简称报告),从恶意程序、钓鱼网站、骚扰电话、垃圾短信、网络诈骗等关键词对2020年第一季度手机安全状况进行了系统的梳理,提醒公众注意防范网络诈骗,同时对移动安全重点趋势进行了分析。 在万物互联时代,每一台智能移动设备都在实时产生联网数据,个人隐私受到威胁。由于年初受到新冠肺炎疫情影响,在线教育、网络支付等大部分网络应用的用户规模呈现较大幅度增长的同时,也给不法分子提供了利用疫情话题传播不法内容及实施诈骗的可乘之机。 恶意程序中资费消耗占比最多 钓鱼网站层出不穷 恶意程序是未明确提示用户或未经用户许可的情况下,在用户计算机或其他终端上安装运行侵犯用户合法权益的应用程序。据报告显示,2020 年第一季度,360 安全大脑共截获移动端新增恶意程序样本约 39.2 万个,恶意程序类型以资费消耗类为主,并呈现持续直线涨幅态势,可见移动端恶意程序“攻坚战”将再一次打响。 从地区上来看,遭受手机恶意程序攻击最多的地区为河南省,其次为山东、广东、江苏、河北,此外四川、安徽、浙江的恶意程序拦截量也名列前茅。 钓鱼网站是不法分子利用各种手段,仿冒真实网站的URL地址以及页面内容,以此来骗取用户银行或信用卡账号、密码等私人资料。手机如果误入钓鱼网站,除了可能导致重要个人信息的泄露外,还有可能使手机误装恶意程序,导致更大的损失。 综合PC端与手机端的数据看,2020年第一季度,360安全大脑共为全国用户拦截钓鱼网站攻击约206.4亿次。其中,移动端拦截钓鱼网站类型主要为境外彩票,占比高达 71.9%;其次为假药(11.5%)、虚假购物(7.9%)、虚假中奖(3.2%)、金融证券(2.5%)、网站被黑(2.0%)等。 骚扰电话狼奔豕突 垃圾短信成快速上升趋势 骚扰电话、垃圾短信一直是骚扰手机用户的社会毒瘤。2020年第一季度,360安全大脑收获用户主动标记各类骚扰号码(包括 360 手机卫士自动检出的响一声电话)约 400.8 万个。 从骚扰电话标记类型中看,响一声以 67.3%的比例位居首位;其次为广告推销(9.9%)、骚扰电话(7.2%)、疑似欺诈(5.9%)、房产中介(3.9%)、保险理财(3.6%)、招聘猎头(1.9%)与诈骗电话(0.2%)。 移动短信从日常沟通发展至身份验证、支付校验的重要方式,出现了质的转变同时也成为传播不法信息的载体之一。 2020年第一季度,在 360 安全大脑的支撑下,360 手机卫士共为全国用户拦截各类垃圾短信约 34.4 亿条,垃圾短信数量与2019年同期相比整体呈现快速上升的趋势。垃圾短信的类型分布中广告推销短信最多,占比为 92.2%;其次为诈骗短信和违法短信。 网络诈骗风起云涌 受骗者人均损失8218 元 报告显示,2020 年第一季度 360 手机先赔共接到手机诈骗举报856 起,涉案总金额高达 340.2 万元,人均损失 8218 元。 在所有诈骗申请中,金融理财(30.2%),其次是虚假兼职(15.9%)、赌博博彩(14.3%)、虚假购物(8.7%)、网游交易(8.7%)等。从涉案总金额来看,同样是金融理财类诈骗总金额较高。 此外,报告还对2020年第一季度典型诈骗案例和热门安全事件进行了盘点分析,并附上了360安全专家的防骗建议。 从报告中不难看出,当前手机安全面临的形势依然严峻,不法分子的作案手段也在“与时俱进”,花样翻新。而360将凭借自身在移动端多年积累的技术经验,依托AI模型和安全大脑的分析能力,持续为用户手机安全保驾护航。 【责任编辑: 蓝雨泪 TEL:(010)68476606】

优秀的个人博客,低调大师

阿里云“2020采购季”活动规则攻略,不能错过领取第一手折扣福利

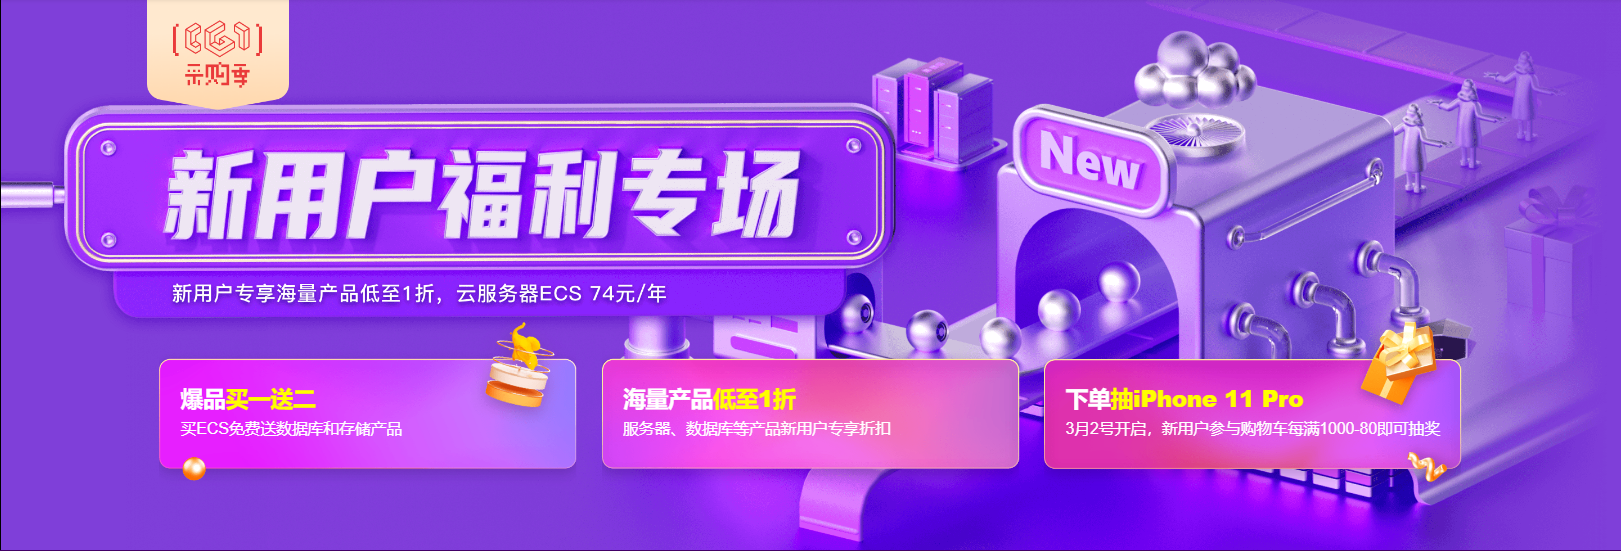
2020阿里云开春采购季活动已经开启,今年的采购季可以逛些啥呢?有啥福利呢?别着急我们先从已开放的活动页面看起,活动分为两个时间阶段: 采购季时间: 预热期:2月24日-~~ 预热期你可以干嘛?领取大礼包,报名淘宝红包。把该领的都领了,正式期开启后直接下单,享受福利! 正式期:3月2日-~~ 在这段时间里,想买啥就买吧,别忘了把想买的产品加入购物车噢,特惠产品叠加购物车满减,更划算噢! 采购季地点: www.aliyun.com/sale-season/2020/procurement 一、新用户福利专场 活动期间,用户购买爆款产品买一送二!活动期间,汇聚新用户专享福利折扣低至1折活动期间,新用户下单即可抽取iPhone11 Pro 新用户福利专场:https://www.aliyun.com/sale-season/2020/procurement-new-members 二、消费满额可领淘宝红包 新购累计满3000元即有机会领淘宝现金红包,仅限报名用户参与! 活动报名时间:2020 年 2月 24日至消费金额累计时间:2020 年 3月 2日至 淘宝红包领取时间:2020年4月7日10:00 至 2020年4月30日 24:00淘宝红包使用时间:红包领取后60天内淘宝现金红包金额计算规则如下, 累计消费金额满3000元的订单,可领100元淘宝现金红包;累计消费金额满10000元的订单,可领200元淘宝现金红包;累计消费金额满20000元的订单,可领300元淘宝现金红包;累计消费金额满30000元的订单,可领400元淘宝现金红包阿里云将按照上述规则,根据用户在活动期间满足有效消费金额门槛的订单(新购、升级、续费)计算出可领取的淘宝现金红包金额,用户支付成功后在采购季活动会场即可查看红包领取资格和金额,每个用户可按消费的最高金额领取1次淘宝红包。 三、新用户爆款产品购买 更多爆品快戳 这里 那么,今年的采购季具体有啥福利呢?请看下图,一张图带你玩转今年的阿里云采购季。

优秀的个人博客,低调大师

Check Point:为了高效能的安全防护 软件硬件需要两手抓

Check Point从1993年成立至今已经有近23年的历史专注于网络安全事业了,在去年年初,Check Point曾预测2015年将出现的网络安全威胁,包括未知恶意软件的增长和利用Android和IOS平台漏洞等攻击,如今也都被一一验证。在本周与媒体的见面会上,Check Point与媒体分享了2016年的十大安全预测。 Check Point预测,在2016年新的一轮威胁浪潮即将袭来,企业需要时刻保持警惕,以主动预防及避免网络犯罪的攻击: “Sniper”和“Shotgun”恶意软件。黑客将越来越多的运用一些复杂的网络钓鱼和社会工程伎俩来获取敏感的数据。 移动威胁加剧。移动漏洞的数目在2016年还会继续增长。 越来越多的企业将采取先进的威胁防护。CPU级别的沙盒使用将变得更加普遍。 关键基础设施将会成为主要攻击目标。针对SCADA和ICS网络的攻击将有所增加,此两种网络缺乏安全性。 物联网和智能设备仍存在风险。物联网进一步发展,企业须做好广泛、并安全使用物联网的准备。 可穿戴设备也存在风险。越来越多的可穿戴设备接入企业网络,将会带来新的安全风险和挑战。 火车、飞机和汽车等。现代汽车拥有许多配件和可连接系统,这使汽车也很容易受到攻击威胁。 虚拟环境的安全亟需关注。企业架构向虚拟环境迁移产生了新的网络层,保护虚拟环境需要新的网络安全策略。 新的环境会产生新的威胁。更新频繁的系统如Windows 10和IOS 9可能会被黑客攻击。 企业将寻求安全整合。为了对抗高级威胁,企业将会增加对集中式安全管理解决方案的信任。 当然,不止于预测,Check Point也有很好的安全解决方案来应对以上安全威胁。 Check Point作为一家研发人员数量高达总员工数三分之一的厂商,其提出的口号是“领先一步”,意为在黑客攻击和企业遭受损害的前一步进行保护。据此,Check Point在本次媒体见面会上发布了一系列新品,以期成就完善的网络安全保护生态圈。 Check Point SandBlast™ Agent产品是边界安全和零日保护技术SandBlast™的升级方案,旨在保护移动端点设备及存储其内的数据安全。除了采用逃避防御沙盒和威胁净化提供主动防御,SandBlast Agent还具有鉴别功能,可自动进行事件分析。 正如Check Point在2016年安全预测中提到的那样,物联网应用将愈加普遍,但是,多种多样的设备接入企业网络后,传统的、基于签名的、防病毒方案只能检测已知的威胁,并不能有效地保护它们,以端点为目标的攻击愈演愈烈。SandBlast Agent是一款整合了端点零日防护、自动鉴别和事件响应功能的解决方案,能识别和遏制受感染设备的可疑的通信活动,阻止泄露组织敏感数据的尝试和隔离受感染的端点,并自动分析、整合,提供可执行的报告,满足现代业务所需的端点安全。 Check Point 北亚区总裁 罗杉 然而最值得一提的是Check Point新推出的15000和23000系列安全网关设备,这两款专用硬件走中高端路线,主要针对大型企业和数据中心的需求。 众所周知,Check Point是一家在安全软件解决方案领域内有着多年经验的网络安全厂商,同时时下的大趋势是软件定义一切,对此,Check Point北亚区总裁罗杉解释到:“尽管软件有其更为灵活的特点,但不可否认的是过多的软件会对硬件载体造成高负荷,变成性能瓶颈,而专有硬件足以支撑起增多的网络安全运算,应对不断增长的网络安全和防护需求。” 根据最新的Check Point 2016安全报告,每小时有超过106个未知的恶意软件被下载,而且这个数字还在不断增长,这就要求各个规模的企业必须使其基础设施适应更强大、更高速和更复杂的网络环境以及相应的网络安全防御解决方案。全新的Check Point 15000和23000系列安全设备整合了防火墙、入侵防御系统(IPS)、反僵尸(anti-bot)、防病毒、应用控制、URL过滤以及沙盒技术Check Point SandBlast,通过确保在不影响性能的基础上对完全混合的加密流量(安全套接层 SSL )的检测,设备可应对未来越来越多源自加密流量的针对企业的攻击,在不影响性能和正常运行的情况下满足安全需求。 据悉,Check Point 15000系列和23000系列安全设备各包括两个型号,分别为15400和15600设备、23500和23800设备。四款设备均即将面市。 由于大量的可连接设备、类似云计算的新技术和不断涌现的复杂性威胁的存在,管理安全已经成为了一个超越了IT部门的管理范畴的关键任务,安全成为整个组织中具有战略意义的一环,在推出了优秀的边界安全和零日保护技术以及安全网关硬件产品后,Check Point进一步推出下一代安全管理平台Check Point R80,以满足现今企业应对不断增加的安全复杂性的需求。 R80管理平台为企业提供了一个统一的安全方法来整合安全的各个方面,使管理者可以更加有效娴熟地为整个组织部署强大的安全保护。R80管理平台通过采用一个单一的控制台管理边界、数据中心分支和云部署,并整合威胁管理为网络提供统一的风险视图,以确保IT管理者能够将他们安全环境中的方方面面整合到一个单一的环境,进一步提升了耗时的安全任务的自动化能力。 据Check Point北亚区总裁罗杉补充介绍,Check Point和IBM安全近日宣布进一步加强合作,旨在提高企业的安全防御信心,合作内容包括共享威胁情报,以及一系列广泛的产品整合,Check Point还将扩大对IBM咨询和管理安全服务的投资。 原文发布时间为:2016-03-23 本文作者:杨昀煦 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册