首页 文章 精选 留言 我的

精选列表

搜索[快速入门],共10000篇文章
优秀的个人博客,低调大师

【从入门到放弃-ZooKeeper】ZooKeeper入门

前言 ZooKeeper是一个分布式服务协调框架,可以用来维护分布式配置信息、服务注册中心、实现分布式锁等。在Hbase、Hadoop、kafka等项目中都有广泛的应用。随着分布式、微服务的普及,ZooKeeper已经成为我们日常开发工作中无法绕过的一环,本文将从安装配置到最基础的使用入手,对其进行介绍。 安装部署 下载 在 http://mirror.bit.edu.cn/apache/zookeeper/stable/ 下载推荐的stable版本。可以直接下载编译好的bin文件。目前最新的stable版本是3.5.5 解压 将下载的文件解压至工作目录,我的工作目录是/var/workspace/zookeeper tar -xzvf apache-zookeeper-3.5.5-bin.tar.gz -C /var/workspace/zo

优秀的个人博客,低调大师

JavaJDBC(快速理解)

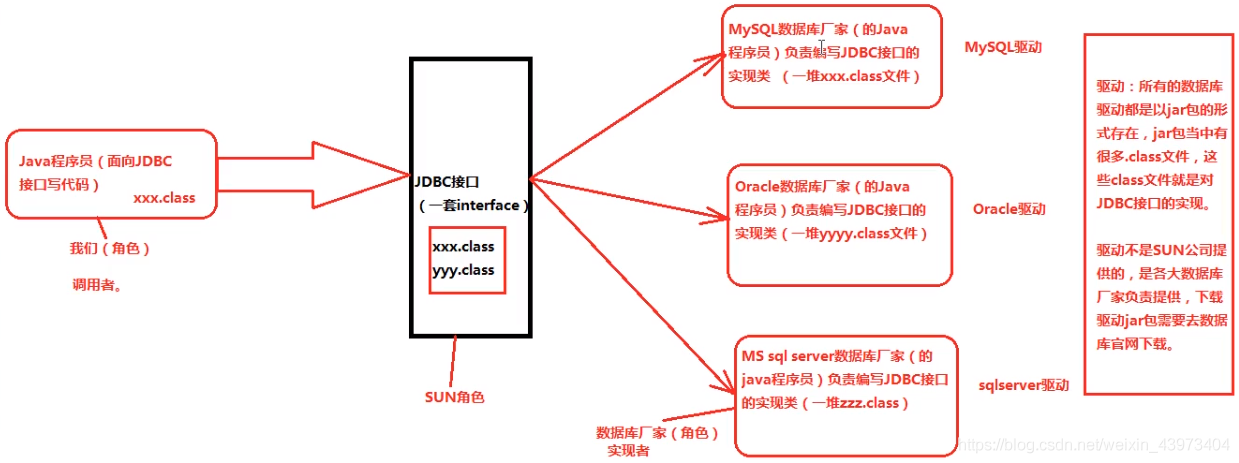
1.JDBC是什么? Java DataBase Connectivity(Java语言连接数据库) 2.JDBC的本质是什么? JDBC是SUN公司制定的一套接口(interface) java.sql.*; (这个软件包下有很多接口。) 3.JDBC开发前的准备工作,先从官网下载对应的驱动jar包,然后将其配置到环境变量classpath当中。 classpath=.;D:\course\06-JDBC\resources\MySql Connector Java 5.1.23\mysql-connector-java-5.1.23-bin.jar 以上的配置是针对于文本编辑器的方式开发,使用IDEA工具的时候,不需要配置以上的环境变量。 IDEA有自己的配置方式。 4.JDBC编程六步(需要背会) 第一步:注册驱动(作用:告诉Java程序,即将要连接的是哪个品牌的数据库) 第二步:获取连接(表示JVM的进程和数据库进程之间的通道打开了,这属于进程之间的通信,重量级的,使用完之后一定要关闭通道。) 第三步:获取数据库操作对象(专门执行sql语句的对象) 第四步:执行SQL语句(DQL DML....) 第五步:处理查询结果集(只有当第四步执行的是select语句的时候,才有这第五步处理查询结果集。) 第六步:释放资源(使用完资源之后一定要关闭资源。Java和数据库属于进程间的通信,开启之后一定要关闭。) import java.sql.Driver; import java.sql.DriverManager; import java.sql.SQLException; import java.sql.Connection; import java.sql.Statement; public class JDBCTest{ public static void main(String[] args) { Connection conn= null; Statement stmt = null; ResultSet rs = null; try{ //1.注册驱动 //第一种方式 Driver driver = new com.mysql.jdbc.Driver(); DriverManager.registerDriver(driver); //第二种方式(一下方法不需要返回值,我们只需要它的类加载动作) class.forName("com.mysql.jdbc.Driver"); //2.获取连接 String url = "jdbc:mysql://127.0.0.1:3306/bjpowernode"; String user = "root"; String password = "333"; conn = DriverManager.getConnection(url,user,password); System.out.println("数据库连接对象:"+conn); //com.mysql.jdbc.JDBC4Connection@34340fab //3.获取数据库操作对象(statement专门执行sql语句) stmt = conn.createStatement(); //4.执行sql String sql = "select empno as a,ename,sal from emp"; rs= stmt.executeQuery(sql); //executeUpdate执行DML语句 executeQuery(sql)执行DQL语句 //5.处理查询结果集 while(rs.next()) { int empno = rs.getInt("a"); String ename = rs.getString("ename"); double sal = rs.getDouble("sal"); System.out.pritnln(empno+","+ename+","+sal); } } catch(SQLException e){ e.printStackTrace(); }finally{ try{ if(stmt !=null){ stmt.close(); } }catch(SQLException e){ e.printStackTrace(); } try{ if(conn !=null){ conn.close(); } }catch(SQLException e){ e.printStackTrace(); } } } } 使用属性配置文件 //jdbc.propertes属性配置文件 driver=com.mysql.jdbc.Driver url=jdbc:mysql://localhost:3306/bjpowernode user=root password=333 import java.sql.Driver; import java.sql.DriverManager; import java.sql.SQLException; import java.sql.Connection; import java.sql.Statement; import java.util.*; public class JDBCTest{ public static void main(String[] args) { //使用资源绑定器绑定属性配置文件 ResourceBundle bundle = ResourceBundle.getBundle("jdbc"); String driver = bundle.getString("driver"); String url = bundle.getString("url"); String user = bundle.getString("user"); String password = bundle.getString("password"); Connection conn= null; Statement stmt = null; try{ //1.注册驱动 class.forName(driver); //2.获取连接 conn = DriverManager.getConnection(url,user,password); System.out.println("数据库连接对象:"+conn); //com.mysql.jdbc.JDBC4Connection@34340fab //3.获取数据库操作对象(statement专门执行sql语句) stmt = conn.createStatement(); //4.执行sql String sql = "insert into dept(deptno,dname,loc) values(50,'人事部','北京')"; int count = stmt.executeUpdate(sql); //执行DML语句 System.out.println(count == 1 ? "保存成功":"保存失败"); //5.处理查询结果集 } catch(Exception e){ e.printStackTrace(); }finally{ try{ if(stmt !=null){ stmt.close(); } }catch(SQLException e){ e.printStackTrace(); } try{ if(conn !=null){ conn.close(); } }catch(SQLException e){ e.printStackTrace(); } } } } 5.登录功能实现(防止SQL注入,PreparedStatement) package com.bjpowernode.jdbc; import java.sql.*; import java.util.HashMap; import java.util.Map; import java.util.Scanner; /*实现功能: 1.需求:模拟用户登录功能的实现。 2.业务描述: 程序运行的时候,提供一个输入的入口,可以让用户输入用户名和密码 合法:显示登录成功。 不合法:显示登录失败。 3.数据准备: 在实际的开发中使用建模工具 4.Sql注入现象(安全隐患): 根本原因 fdsa ''or 将用户名或密码的or 当做了sql语句 解决SQL注入问题: 要想用户信息不参与Sql语句编译,那么必须使用java.sql.PreparedStatement PreparedStatement是属于预编译数据库操作对象,编译一次执行多次。 PreparedStatement ps = null; 其中一个?代表一个占位符,站位符不能用点引号括起来 String sql = "select * from t_user where loginName = ? and loginPwd = ?"; ps = conn.prepareStatement(sql); 给占位符传值 ps.setString(1,loginName); ps.setString(2,loginPwd); */ public class JDBCTest06 { public static void main(String[] args) { //初始一个界面 Map<String,String> userLoginInfo = initUI(); boolean loginSuccess = login(userLoginInfo); System.out.println(loginSuccess? "登录成功!":"登录失败用户名密码错误!"); } private static boolean login(Map<String, String> userLoginInfo) { boolean loginSuccess = false; Connection conn = null; PreparedStatement ps = null;//这里是PreParedStatement(预编译数据库操作对象) ResultSet rs = null; try{ //注册驱动 Class.forName("com.mysql.jdbc.Driver"); //连接语句 conn = DriverManager.getConnection("jdbc:mysql://127.0.0.1:3306/bjpowernode","root","333"); //获取数据库操作对象 String sql = "select * from t_user where loginName = ? and loginPwd = ?"; ps = conn.prepareStatement(sql); //给占位符传值 ps.setString(1,userLoginInfo.get("loginName")); ps.setString(2,userLoginInfo.get("loginPwd")); rs = ps.executeQuery(); if (rs.next()) { loginSuccess = true; } }catch (ClassNotFoundException e){ e.printStackTrace(); }catch (SQLException e) { e.printStackTrace(); }finally { if (rs !=null){ try { rs.close(); }catch (SQLException e) { e.printStackTrace(); } } if (ps !=null){ try { ps.close(); }catch (SQLException e) { e.printStackTrace(); } } if (conn !=null) { try{ conn.close(); }catch (SQLException e) { e.printStackTrace(); } } } return loginSuccess; } /* * 初始化用户页面 * @return 用户输入用户名密码等登录信息 * */ private static Map<String, String> initUI() { Scanner s = new Scanner(System.in); System.out.println("用户名:"); String loginName = s.nextLine(); System.out.println("密码:"); String loginPwd = s.nextLine(); Map<String,String> userLoginInfo = new HashMap<>(); userLoginInfo.put("loginName",loginName); userLoginInfo.put("loginPwd",loginPwd); return userLoginInfo; } } Statement的用处(需要SQL注入) Statement存在SQL注入问题,是编译一次执行一次。PreparedStatement执行效率高。 需要先 用户台输入desc降序,输入asc升序,此时需要使用Sql注入 String keyWords = desc或者asc String sql = "select ename = from emp order by ename " + keyWords; 6.账户转账演示事务 sql脚本 drop table if exists t_act; create table t_act( actno bigint, balance double(7,2) //注意:7表示有效数字,2表示小数位个数 ); insert into t_act(actno,balance) values(111,20000); insert into t_act(actno,balance) values(222,0); commit; select * from t_act; 重点三句: conn.setAutoCommit(false); conn.commit(); conn.rollback(); public class HelloWorld { public static void main(String []args) { Connection conn = null; PreparedStatement ps = null; try{ //注册驱动 Class.forName("com.mysql.jdbc.Driver"); //获取连接 conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/bjpowernode","root","333"); //将自动提交机制改为手动提交 conn.setAutoCommit(false);//开启事务 //获取预编译的数据库操作系统 String sql = "update t_act set balance = ? where actno = ?"; ps = conn.prepareStatement(sql); //给替换符赋值 ps.setDouble(1,10000); ps.setInt(2,111); int count = ps.executeUpdate(); ps.setDouble(1,10000); ps.setInt(2,222); count +=ps.executeUpdate(); //程序到这里表示成功 conn.commit(); //提交事务 Syste.out.println(count == 2 ?"转账成功":"转账成功"); }catch(Exception e) { if(conn != null) { try{ //回滚事务 conn.rollback(); }catch(SQLException e) { e.printStackTrace(); } } e.printStackTrace(); } } } 7.JDBC工具类封装 import java.sql.*; public class DBUtil { private DBUtil() { } //工具类的构造方法是私有的; //因为工具类的方法是静态的,不需要实例化 static { try { Class.forName("com.mysql.jdbc.Driver"); } catch (ClassNotFoundException e) { e.printStackTrace(); } } //获取数据库连接对象 //@return 连接对象 public static PreparedStatement createStatement(String sql) throws SQLException { Connection conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/bjpowernode", "root", "333"); PreparedStatement ps = conn.prepareStatement(sql); return ps; } //关闭资源 //conn 连接对象 //ps 数据库操作对象 //rs 结果集 public static void close(Connection conn, Statement ps, ResultSet rs) { if (rs != null) { try { rs.close(); } catch (SQLException e) { e.printStackTrace(); } } if (ps != null) { try { ps.close(); } catch (SQLException e) { e.printStackTrace(); } } if (conn != null) { try { conn.close(); } catch (SQLException e) { e.printStackTrace(); } } } }

优秀的个人博客,低调大师

PySpider 快速上手

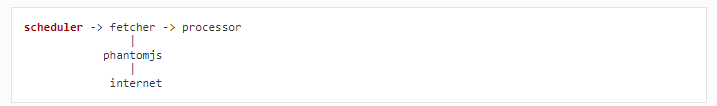
因为工作原因,最近一段时间都在做项目的数据建设工作,涉及到使用Pyspider进行数据的爬取及入库,所以此处系统的整理一下; pyspider简介 一个国人编写的强大的网络爬虫系统并带有强大的WebUI。 采用Python语言编写,分布式架构,支持多种数据库后端,强大的WebUI支持脚本编辑器,任务监视器,项目管理器以及结果查看器。 不过目前对代理支持的话,不太好,只能支持单代理,本身不支持多代理,有两种解决方法: 修改源码,在发起请求的时候,从代理中心获取代理地址进行配置访问; 通过 类似squid方法进行获取,详细点这里 GitHub地址:https://github.com/binux/pyspider 中文网地址:http://www.pyspider.cn PySpider特性 用Python编写脚本,支持Python 2. {6,7},3。{3,4,5,6}等 功能强大的WebUI,包括脚本编辑器,任务监视器,项目管理器和结果查看器 支持多种数据库存储(MySQL,MongoDB,Redis,SQLite,Elasticsearch,PostgreSQL,SQLAlchemy) 支持多种消息队列(RabbitMQ,Beanstalk,Redis,Kombu) 支持爬虫任务优先级设置,超时重爬等 支持分布式部署 支持抓取Javascript页面 PySpider组件及架构 PySpider核心组件有以下几个: Scheduler(调度器): 从task_queue中接收任务 确定任务是新任务还是重爬任务 进行优先级排序, 处理定期任务,重试丢失或失败的任务 Fetcher(提取器): 负责获取网页内容 支持url或JavaScript的页面(通过phantomjs) Processor(处理器): 负责处理内容的解析,内置PyQuery解析库 组件之间架构图如下: 每个组件相互独立,通过消息队列连接,从单进程到多机分布式灵活拓展 存储 Pyspider支持多种存储,默认使用的sqlite,具体支持如下图源码中所列 默认情况下,运行的时候,运行目录的下会生成一个data文件夹,里面会存储几个db文件: project.db (存储爬虫项目信息,一般指的一个单独的爬虫脚本) result.db (存储任务执行结果信息) task.db (存储爬虫任务信息,也就是on_start后生成的爬虫任务信息) PySpider使用 安装Pyspider 安装的话,比较简单,只有两步: pip install pyspider 运行命令pyspider,访问http://localhost:5000/ 首页介绍 操作按钮 Recent Active Tasks (查看最近活动的任务,会跳转到一个页面有列表显示) Create (创建一个新的爬虫任务) 项目列表 group:分组,点击进行修改,用于区分任务类型,可以通过点击表头进行排序,要是能做成文件夹就更好了 project name:项目名称,创建爬虫项目时填写 status (任务状态,有以下几种状态) TODO:当一个脚本刚刚被创建时的状态 STOP:你可以设置项目状态为STOP让项目停止运行 CHECKING:当一个运行中的项目被编辑时项目状态会被自动设置成此状态并停止运行. DEBUG/RUNNING:这两状态都会运行爬虫,但是他们之间是有区别的.一般来说调试阶段用DEBUG状态,线上用RUNNING状态. rate/burst:rate:每秒执行多少个请求,burst:任务并发数,可以点击进行修改 avg time:任务平均时间 progress:记录任务状态,按时间区分,会标示任务的创建数,成功数,失败数等值 actions:对爬虫项目的一些操作 Run:立即执行任务,需要status为running或debug状态;如果在配置的调度执行时间内已经执行过,再点run是无效的,需要删除task.db里的数据才行(我都是直接把文件都干掉了。。) Active Tasks:查看当前爬虫项目的活动任务 Results:查看活动任务结果 编辑页面介绍 左侧页面栏为调试信息可视化,相关区域及按钮介绍一下: 上面绿色区域,为调试信息显示,显示当前任务的相关信息; Run:调试按钮,点击即可运行当前任务 "<",">"箭头为上一步下一步,用于调试过程中切换到上一步骤 web:将当前拉取到的页面内容以web形式展示(不过显示范围很窄。。) html:显示当前页面的html源码 follow:子任务,该任务下的子任务,点击链接上的按钮,即可进行下一步调试 messages,enable css selector helper 这两个还不知道有啥用 右侧主要就是用于编写爬虫脚本了,新建默认脚本如下: 核心代码都在BaseHandler中,Handler类继承BaseHandler,该类在base_handler.py文件中 crawl_config :为全局配置对象,通过源码我们可以看到,可以支持很多配置,但是需要注意,配置是有作用区域的 on_start 入口方法:一般为主页面的方法,这名字不能改,因为源码里启动的话入口方法就是on_start,其余index_page,跟detail_page没有说强制性的,可根据自己需求起名字,就不说了; @every 注解:用于定时调度,有两个参数:minutes,seconds;分别也是代表指的多少分钟执行一次,多少秒执行一次,代码也在base_handler.py中 @config 注解:用于核心方法self.crawl的配置,在通过配置的,会作为self.crawl的默认配置; crawl 核心方法:这个方法就是告诉Pyspider抓取哪个页面,我目前为止也没都用全,完整的API点击这里,有很详细的解释 Response 返回对象:通过默认的示例代码中可以看到,通过crawl爬取返回的对象就是这个类型,可以通过response.doc方法,将返回值转换成PyQuery对象,剩下来的就根据需求去解析元素,提取你需要的东西了;完整API点击这里 总结: 因为第一次接触爬虫,对别的爬虫技术也不太了解,不好做对比,就PySpider来说,用久了还是方便的,特别是页面调试,不过刚开始用的话,对Response对象不熟悉,会比较麻烦一点,毕竟没有PyCharm通过断点查看对象属性来的方便; 因为整体来讲,比较简单,这里就不上传示例代码了,看编辑页面介绍截图的代码,就是之前爬保监会网站的代码,可以借鉴一下,比较简单。 另吐槽一下开源中国 对MarkDown的支持,在编辑预览中看到的,跟发布出来看到的格式不一样。。难受

优秀的个人博客,低调大师

Redis快速使用

1.导包(坐标) <!-- https://mvnrepository.com/artifact/redis.clients/jedis --> <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>2.9.0</version> </dependency> <!-- 配置使用redis启动器 --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency> 2.使用 2.1存数据: @Autowired private RedisTemplate<String, String> redisTemplate; public void run(){ /* 参数一: key 参数二:value 参数三:title 参数四:时间类型 */ redisTemplate.opsForValue().set(customer.getTelephone(), activecode, 24,TimeUnit.HOURS); } 2.2取数据 String getUUid = redisTemplate.opsForValue().get(telephone);

优秀的个人博客,低调大师

TensorFlow——快速安装

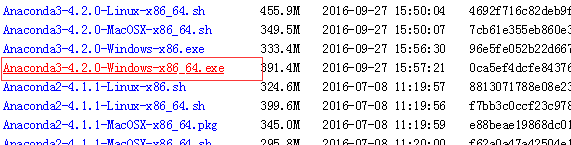
TensorFlow:2015年Google开源的机器学习框架 1、Anoconda安装 (1)Window,MacOS,Linux都已支持Tensorflow。 (2) Window用户只能使用 python3.5 (64bit) 。MacOS,Linux支持python2.7和python3.3+。 (3)有GPU可以安装带GPU版本的,没有GPU就安装CPU版本的。 推荐安装Anaconda,pip版本大于8.1 Anoconda官网: https://www.anaconda.com/ Anaconda版本下载: https://repo.continuum.io/archive/ python3.5(64bit对应的是Anaconda3-4.2.0版本,如下) 注 :更新pip版本: 管理员 方式打开命令提示符,输入命令: python -m pip install --upgrade pip 2、Windows安装Tensorflow (1) Windows安装Tensorflow CPU版本: 管理员 方式打开命令提示符,输入命令: pip install tensorflow GPU版本: 管理员方式打开命令提示符,输入命令: pip install tensorflow-gpu (2) Windows更新Tensorflow 先卸载 : pip uninstall tensorflow 再安装 : pip install tensorflow 注: 【安装完成后,打开Anoconda自带的Jupyter Notebook,输入 import tensorflow ,运行( shift+Enter ),如果不缺少文件的话就运行成功,如果缺少文件则根据错误提示安装文件。 例如:出现如下错误,则点击下面的链接,根据提示安装即可 ImportError : Could not find 'cudart64_90.dll'. TensorFlow requires that this DLL be installed in a directory that is named in your %PATH% environment variable. Download and install CUDA 9.0 from this URL: https://developer.nvidia.com/cuda-toolkit 】 3、Linux和MacOS安装Tensorflow CPU版本: Python 2.7用户: pip install tensorflow Python3.3+用户: pip3 install tensorflow GPU版本: Python 2.7用户: pip install tensorflow-gpu Python3.3+用户: pip3 install tensorflow-gpu 官方网站: https://www.tensorflow.org/ 官方GitHub仓库: https://github.com/tensorflow/tensorflow 官方文档: https://www.tensorflow.org/get_started/ 官方文档中文版: https://github.com/jikexueyuanwiki/tensorflow-zh TensorFlow 中文社区 http://www.tensorfly.cn/

优秀的个人博客,低调大师

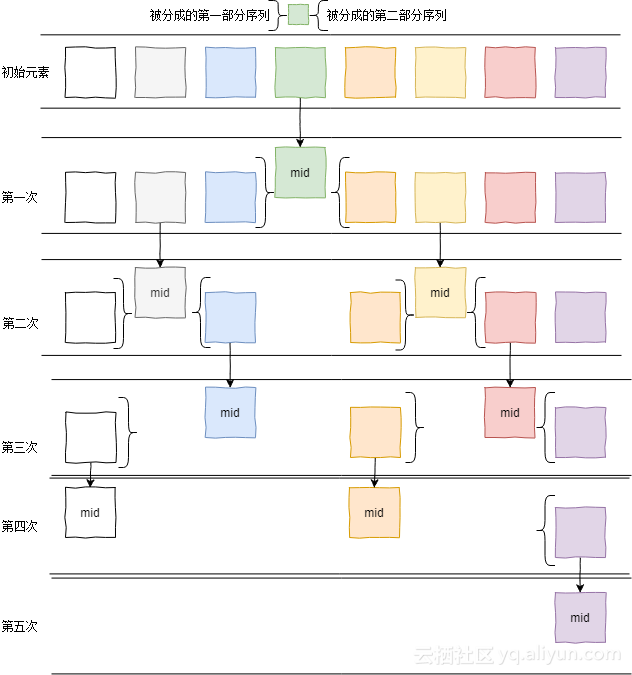
python快速排序

#_*_coding:utf-8_*_ __author__ = 'Alex Li' def quick_sort(array,left,right): ''' :param array: :param left: 列表的第一个索引 :param right: 列表最后一个元素的索引 :return: ''' if left >=right: return low = left high = right key = array[low] #第一个值 while low < high:#只要左右未遇见 while low < high and array[high] > key: #找到列表右边比key大的值 为止 high -= 1 #此时直接 把key(array[low]) 跟 比它大的array[high]进行交换 array[low] = array[high] array[high] = key while low < high and array[low] <= key : #找到key左边比key大的值,这里为何是<=而不是<呢?你要思考。。。 low += 1 #array[low] = #找到了左边比k大的值 ,把array[high](此时应该刚存成了key) 跟这个比key大的array[low]进行调换 array[high] = array[low] array[low] = key quick_sort(array,left,low-1) #最后用同样的方式对分出来的左边的小组进行同上的做法 quick_sort(array,low+1, right)#用同样的方式对分出来的右边的小组进行同上的做法 if __name__ == '__main__': array = [96,14,10,9,6,99,16,5,1,3,2,4,1,13,26,18,2,45,34,23,1,7,3,22,19,2] #array = [8,4,1, 14, 6, 2, 3, 9,5, 13, 7,1, 8,10, 12] print("before sort:", array) quick_sort(array,0,len(array)-1) print("-------final -------") print(array)

优秀的个人博客,低调大师

ELKStack快速安装

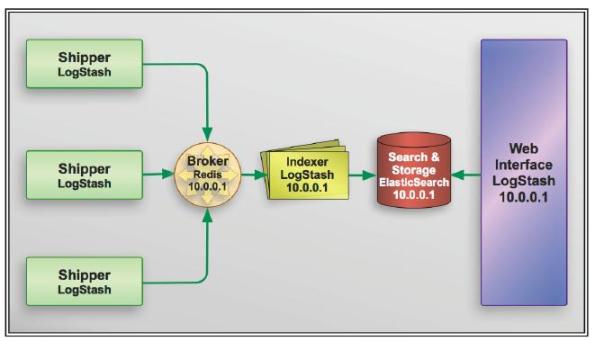
ELKStack简介 对于日志来说,最常见的需求就是收集、存储、查询、展示,开源社区正好有相对应的开源项目:logstash(收集)、elasticsearch(存储+搜索)、kibana(展示),我们将这三个组合起来的技术称之为ELKStack,所以说ELKStack指的是Elasticsearch、Logstash、Kibana技术栈的结合,一个通用的架构如下图所示: Elasticsearch部署 Elasticsearch首先需要Java环境,所以需要提前安装好JDK,可以直接使用yum安装。也可以从Oracle官网下载JDK进行安装。开始之前要确保JDK正常安装并且环境变量也配置正确:安装JDK [root@linux-node1~]#yuminstall-yjava [root@linux-node1~]#java-version openjdkversion"1.8.0_65" OpenJDKRuntimeEnvironment(build1.8.0_65-b17) OpenJDK64-BitServerVM(build25.65-b01,mixedmode) YUM安装ElasticSearch 1.下载并安装GPG key [root@hadoop-node1~]#rpm--import[url]https://packages.elastic.co/GPG-KEY-elasticsearch[/url] 2.添加yum仓库 [root@hadoop-node1~]#vim/etc/yum.repos.d/elasticsearch.repo[elasticsearch-2.x] name=Elasticsearchrepositoryfor2.xpackages baseurl=http://packages.elastic.co/ela...entosgpgcheck=1 gpgkey=http://packages.elastic.co/GPG-KEY-elasticsearchenabled=1 3.安装elasticsearch [root@hadoop-node1~]#yuminstall-yelasticsearch LogStash部署与配置 和Elasticsearch一样,在开始部署LogStash之前也需要你的环境中正确的安装的JDK。可以下载安装Oracle的JDK或者使用 yum安装openjdk。安装JDK [root@linux-node1~]#yuminstall-yjava[root@linux-node1~]#java-version openjdkversion"1.8.0_65" OpenJDKRuntimeEnvironment(build1.8.0_65-b17) OpenJDK64-BitServerVM(build25.65-b01,mixedmode) YUM部署LogStash 1.下载并安装GPG key [root@linux-node2~]#rpm--importhttps://packages.elastic.co/GPG-KEY-elasticsearch 2.添加yum仓库 [root@linux-node2~]#vim/etc/yum.repos.d/logstash.repo[logstash-2.3] name=Logstashrepositoryfor2.3.xpackages baseurl=https://packages.elastic.co/logstash/2.3/centosgpgcheck=1 gpgkey=https://packages.elastic.co/GPG-KEY-elasticsearchenabled=1 3.安装logstash [root@linux-node2~]#yuminstall-ylogstash Kibana简介 Kibana 是为 Elasticsearch 设计的开源分析和可视化平台。你可以使用 Kibana 来搜索,查看存储在 Elasticsearch 索引中的数据并与之交互。你可以很容易实现高级的数据分析和可视化,以图表的形式展现出来。Yum安装Kibana 1.下载并安装GPG key [root@linux-node2~]#rpm--importhttps://packages.elastic.co/GPG-KEY-elasticsearch 2.添加yum仓库 [root@test~]#vim/etc/yum.repos.d/kibana.repo [kibana-4.5] name=Kibanarepositoryfor4.5.xpackages baseurl=http://packages.elastic.co/kibana/4.5/centosgpgcheck=1 gpgkey=http://packages.elastic.co/GPG-KEY-elasticsearchenabled=1 3.安装kibana [root@test~]#yuminstall-ykibana 使用Cobbler创建ELKStack仓库 当然生产环境,肯定不能使用外网的YUM仓库,可以使用Cobbler来创建自己的yum仓库。 [root@log-node1~]#cobblerrepoadd--name=logstash-2.3--mirror=http://packages.elastic.co/logstash/2.3/centos--arch=x86_64--breed=yum [root@log-node1~]#cobblerrepoadd--name=elasticsearch2--mirror=http://packages.elastic.co/ela...entos--arch=x86_64--breed=yum [root@log-node1~]#cobblerrepoadd--name=kibana4.5--mirror=http://packages.elastic.co/kibana/4.5/centos--arch=x86_64--breed=yum [root@log-node1~]#cobblerreposync 本文转自 蜗牛远途 51CTO博客,原文链接:http://blog.51cto.com/ywliyq/1959537

优秀的个人博客,低调大师

es 入门

**注意事项-------使用ealsticsearch要配置java的开发环境JDK(1.8以上) ealsticsearch: 索引(Index) 类型(type) 文档(Document) 字段(Fields) 关系型数据库: 数据库 表 行 列 from elasticsearch import Elasticsearch 默认host为localhost,port为9200.但也可以指定host与port es = Elasticsearch("http://127.0.0.1:9200") 插入数据,index,doc_type名称可以自定义,id可以根据需求赋值,body为内容 es.index(index="my_index",doc_type="test_type",id=0,body={"name":"python","addr":"深圳"})es.index(index="my_index",doc_type="test_type",id=1,body={"name":"java","addr":"北京"}) 同样是插入数据,create() 方法需要我们指定 id 字段来唯一标识该条数据,而 index() 方法则不需要,如果不指定 id,会自动生成一个 id es.create(index="my_index",doc_type="test_type",id=1,body={"name":"python","addr":"深圳"}) 删除指定的index、type、id的文档 es.delete(index='indexName', doc_type='typeName', id=1) 删除index es.indices.delete(index='news', ignore=[400, 404])query = {'query': {'match_all': {}}}# 查找所有文档query1 = {'query': {'match': {'sex': 'famale'}}}# 删除性别为女性的所有文档query2 = {'query': {'range': {'age': {'lt': 11}}}}# 删除年龄小于11的所有文档query3 = {'query': {'term': {'name': 'jack'}}}# 查找名字叫做jack的所有文档 删除所有文档 es.delete_by_query(index="my_index",doc_type="test_type",body=query) get:获取指定index、type、id所对应的文档 es.get(index="my_index",doc_type="test_type",id=1) search:查询满足条件的所有文档,没有id属性,且index,type和body均可为None result = es.search(index="my_index",doc_type="test_type",body=query)print(result'hits'[0])# 返回第一个文档的内容 update:更新指定index、type、id所对应的文档 更新的主要点: 1. 需要指定 id 2. body={"doc": } , 这个doc是必须的 es.update(index="my_index",doc_type="test_type",id=1,body={"doc":{"name":"python1","addr":"深圳1"}}) ---查询所有数据# 搜索所有数据es.search(index="my_index",doc_type="test_type") 或者 body = { "query":{ "match_all":{} }}es.search(index="my_index",doc_type="test_type",body=body) ---term与terms term body = { "query":{ "term":{ "name":"python" } }} 查询name="python"的所有数据 es.search(index="my_index",doc_type="test_type",body=body) terms body = { "query":{ "terms":{ "name":[ "python","android" ] } }} 搜索出name="python"或name="android"的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---match与multi_match match:匹配name包含python关键字的数据 body = { "query":{ "match":{ "name":"python" } }} 查询name包含python关键字的数据 es.search(index="my_index",doc_type="test_type",body=body) multi_match:在name和addr里匹配包含深圳关键字的数据 body = { "query":{ "multi_match":{ "query":"深圳", "fields":["name","addr"] } }} 查询name和addr包含"深圳"关键字的数据 es.search(index="my_index",doc_type="test_type",body=body) ---idsbody = { "query":{ "ids":{ "type":"test_type", "values":[ "1","2" ] } }} 搜索出id为1或2d的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---复合查询boolbody = { "query":{ "bool":{ "must":[ { "term":{ "name":"python" } }, { "term":{ "age":18 } } ] } }} 获取name="python"并且age=18的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---切片式查询body = { "query":{ "match_all":{} } "from":2 # 从第二条数据开始 "size":4 # 获取4条数据} 从第2条数据开始,获取4条数据 es.search(index="my_index",doc_type="test_type",body=body) ---范围查询 body = { "query":{ "range":{ "age":{ "gte":18, # >=18 "lte":30 # <=30 } } }} 查询18<=age<=30的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---前缀查询body = { "query":{ "prefix":{ "name":"p" } }} 查询前缀为"赵"的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---通配符查询 body = { "query":{ "wildcard":{ "name":"*id" } }} 查询name以id为后缀的所有数据 es.search(index="my_index",doc_type="test_type",body=body) ---排序body = { "query":{ "match_all":{} } "sort":{ "age":{ # 根据age字段升序排序 "order":"asc" # asc升序,desc降序 } }} ---filter_path响应过滤 只需要获取_id数据,多个条件用逗号隔开 es.search(index="my_index",doc_type="test_type",filter_path=["hits.hits._id"]) 获取所有数据 es.search(index="my_index",doc_type="test_type",filter_path=["hits.hits._*"]) ---count执行查询并获取该查询的匹配数 获取数据量 es.count(index="my_index",doc_type="test_type") ---度量类聚合获取最小值body = { "query":{ "match_all":{} }, "aggs":{ # 聚合查询 "min_age":{ # 最小值的key "min":{ # 最小 "field":"age" # 查询"age"的最小值 } } }} 搜索所有数据,并获取age最小的值 es.search(index="my_index",doc_type="test_type",body=body) ---获取最大值body = { "query":{ "match_all":{} }, "aggs":{ # 聚合查询 "max_age":{ # 最大值的key "max":{ # 最大 "field":"age" # 查询"age"的最大值 } } }} 搜索所有数据,并获取age最大的值 es.search(index="my_index",doc_type="test_type",body=body) ---获取和body = { "query":{ "match_all":{} }, "aggs":{ # 聚合查询 "sum_age":{ # 和的key "sum":{ # 和 "field":"age" # 获取所有age的和 } } }} 搜索所有数据,并获取所有age的和 es.search(index="my_index",doc_type="test_type",body=body) ---获取平均值body = { "query":{ "match_all":{} }, "aggs":{ # 聚合查询 "avg_age":{ # 平均值的key "sum":{ # 平均值 "field":"age" # 获取所有age的平均值 } } }} 搜索所有数据,获取所有age的平均值 es.search(index="my_index",doc_type="test_type",body=body)

优秀的个人博客,低调大师

Matplotlib 入门

最近一直在学习有关机器学习的内容,发现有关可视化的内容无法绕过,在网上搜索了很久,看了一些中英文的资料和书,这里主要是记录下来,主要供自己进一步学习之用。 本文适合零基础,但你需要对Python, Numpy, Pandas 有基本的了解。 首先完成以下的中文翻译资料的学习,原作者的github链接也一并奉上,你可以 clone 下来。学习这个课程的过程中,你需要了解的基本API函数: 完成了这个学习, 使用面向对象界面画图的一般步骤就是 建立一个 Figure 对象 在这个 Figure 里建立一个或n个 Axes 对象 这些 Axes 里分别画图、装饰 我们画完图以后一般要加上标题、图例这些元素。这些功能散布在 Matplotlib API 的各处 加标题可以使用 Axes 对象的 set_title 方法。坐标轴的标签可以使用 Axes 对象的 set_xlabel 和 set_ylabel 方法。图例可以使用 Axes 对象的 legend 方法创建。这 个函数会使用 Line2D 对象的 label 属性。注意 上一节最后的那一段代码,Ax.plot() 这一行我们并没有使用 plot 的返回值,实际上它的返回值正是 Line2D 对象的列表,所以我们可以这样设置 label:Ax.plot(X1, Y1, label="blabla") 也可以这样Lines = Ax.plot(X1, Y1) Lines[0].set_label("blabla") 如果我们在一个 plot 调用里画多条线,同时设 label,这些线都会有相同的 label。设置完这些以后,只需调用 Ax.legend(),图例就会出现在图的右上角。如果我们使用上一节 的那个例子,右上角并不是放图例的好地方,这时我们可以使用 legend 的 loc参数。这个参数可以是一个字符串, 比如"right","lower left" 之类,也可以是一 个整数,具体定义请见 官方文档。这里我们可以简单地使用 0 或者 "best" 让 Matplotlib 自动选择位置,Ax.legend(loc=0) 现在我们的图基本成型,可以插入到文档里了。这时我们可能想调整图的大小, 我们可以修改 Figure 构造函数的调用,Fig = Plt.figure(figsize=(4,3)) 这样图的大小就会是宽 4 高 3,单位传说是英寸。也可以使用 Fig 的 set_figwidth 和 set_figheight 方法。如果你把图的尺寸改得比较小的话,可能会 发生一件非常奇妙的事,就是坐标轴的标签被图的边界遮住了,或者干脆不见了。 解决办法就是调整绘图区域的四个边界在图中的位置,比如下面的代码Fig.subplots_adjust(left=0.15, top=0.9) 把绘图区域的左边界放在图左边 15% 的位置,上边界放在高的 90% 的位置。Matplotlib 中的文本 Matplotlib 有很强的文本功能。它可以处理普通的文本,也可以使用 LaTeX 渲 染数学公式。Matplotlib 还带了一个 LaTeX 引擎,可以在系统里没有 LaTeX 的 时候渲染数学公式。以下代码使用默认字体(貌似是 Verdana)显示 x 轴的标题Ax.set_xlabel("x") 如果你要使用 LaTeX 来排这个标题,只需要使用 Python raw string,并把标 题放在数学模式里,Ax.set_xlabel(r" 𝑥x ") 注意即便是使用 raw string,不在数学模式里的部分仍然不会使用 LaTeX。Matplotlib 的 Axes 类有一个 text 方法,可以 在一个 Axes 对象的任意位置放置一个文本。 Figure 也有一个 figtext 方法用来在 Figure 对象的任意位置放置文本。具体用法请见 官方文档。 Axes 对象还有一个超级强大的 annotate 方法, 可以满足你对标注的最变态需求。要改变文本的默认字体,需要使用 pyplot 模块的 rc 函数,Plt.rc("font", family="Helvetica") 不过如果你指定的字体是 OpenType 的话,貌似不能嵌入到 PDF 里…​ 请参考: 1)github - https://github.com/rougier/matplotlib-tutorial 2) Translation - https://liam.page/2014/09/11/matplotlib-tutorial-zh-cn/ 3) https://www.cnblogs.com/wei-li/archive/2012/05/23/2506940.html4) https://journals.plos.org/ploscompbiol/article?id=10.1371/journal.pcbi.1003833 以下为草稿:http://liyangbit.com/pythonvisualization/matplotlib-top-50-visualizations/

优秀的个人博客,低调大师

Jmeter 入门

Jmeter的初步认识 一、 接口测试 一般的测试包含七步: 新建请求 添加线程组 添加http请求 配置http参数 添加cookie管理、header管理 添加结果树 在点击运行 查看运行结果 参数在前后端分离一般用json格式,也可以选择html(HTMl Source Formatted)或者其他 二、 压力测试 配置线程组 参数说明: -. 线程数:虚拟用户数。一个虚拟用户占用一个进程或线程。多少虚拟用户就设置多少个线程数。 -. Rame-Up Period: 表示线程数多长时间全部启动。即准备时长:如果线程数是15,准备时长为3,,也就是每秒钟启动5个线程。 -. 循环次数:这个设置不会改变并发数,可以延长并发时间。总请求数=线程数*循环次数 -. 调度器:设置压测的启动时间、结束时间、持续时间和启动延迟时间。

优秀的个人博客,低调大师

Prometheus 入门

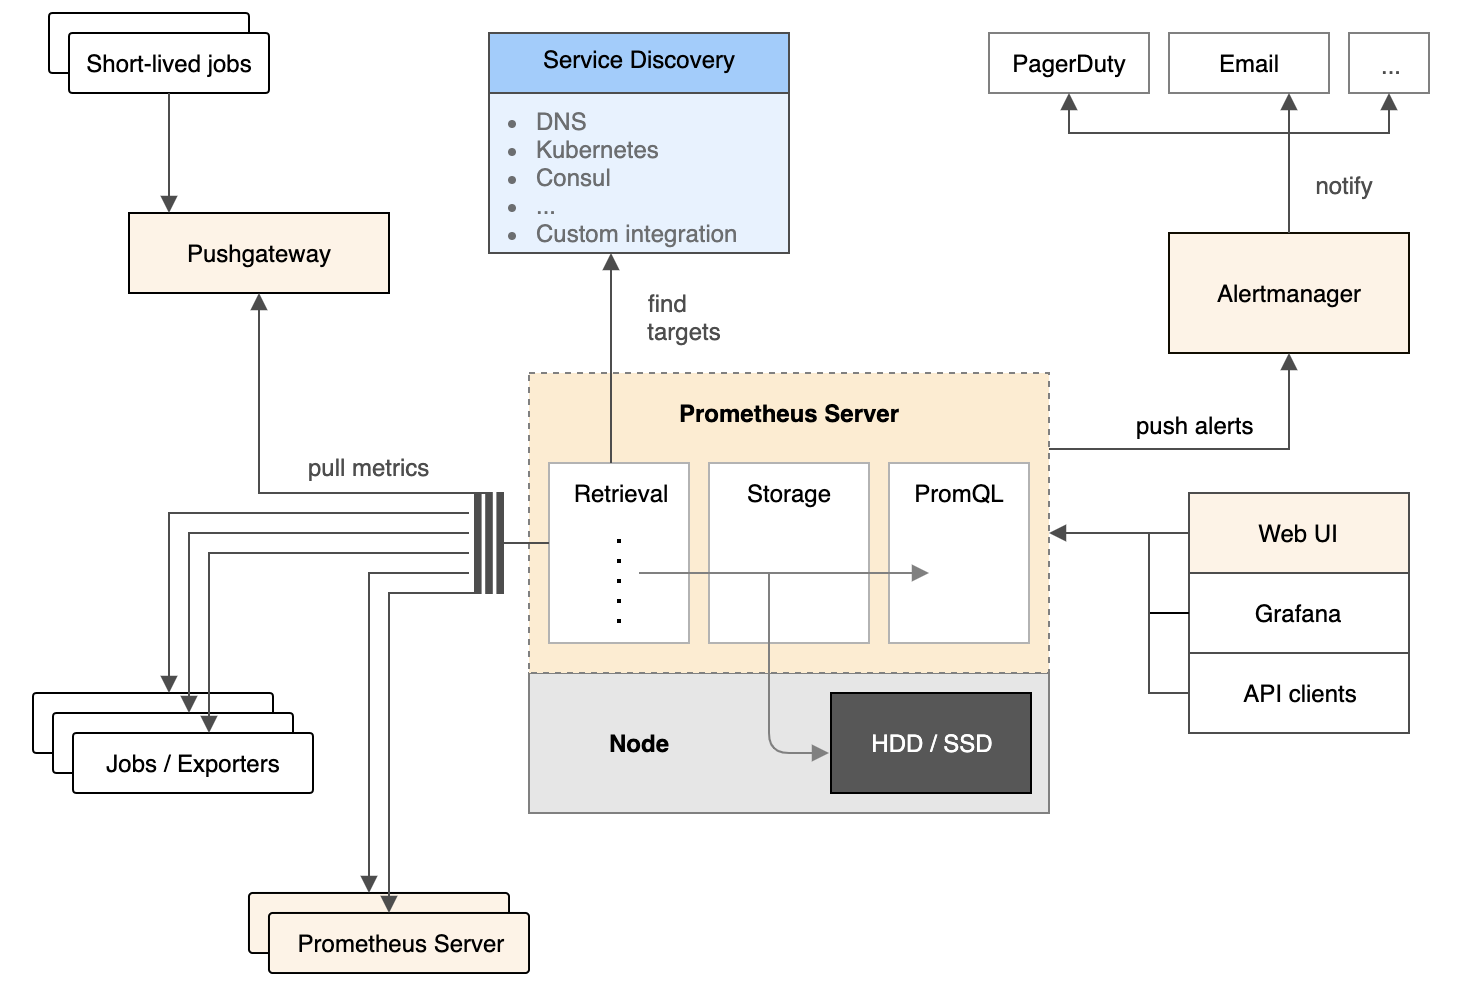
文章首发于公众号《程序员果果》地址 : https://mp.weixin.qq.com/s/BjZyNcWEgflJMnjfceiluw 简介 Prometheus 是一套开源的系统监控报警框架。它启发于 Google 的 borgmon 监控系统,由工作在 SoundCloud 的 google 前员工在 2012 年创建,作为社区开源项目进行开发,并于 2015 年正式发布。 特点 作为新一代的监控框架,Prometheus 具有以下特点: 强大的多维度数据模型: 时间序列数据通过 metric 名和键值对来区分。 所有的 metrics 都可以设置任意的多维标签。 数据模型更随意,不需要刻意设置为以点分隔的字符串。 可以对数据模型进行聚合,切割和切片操作。 支持双精度浮点类型,标签可以设为全 unicode。 灵活而强大的查询语句(PromQL):在同一个查询语句,可以对多个 metrics 进行乘法、加法、连接、取分数位等操作。 易于管理: Prometheus server 是一个单独的二进制文件,可直接在本地工作,不依赖于分布式存储。 高效:平均每个采样点仅占 3.5 bytes,且一个 Prometheus server 可以处理数百万的 metrics。使用 pull 模式采集时间序列数据,这样不仅有利于本机测试而且可以避免有问题的服务器推送坏的 metrics。 可以采用 push gateway 的方式把时间序列数据推送至 Prometheus server 端。 可以通过服务发现或者静态配置去获取监控的 targets。 有多种可视化图形界面。 易于伸缩。 组成及架构 Prometheus 生态圈中包含了多个组件,其中许多组件是可选的: Prometheus Server: 用于收集和存储时间序列数据。 Client Library: 客户端库,为需要监控的服务生成相应的 metrics 并暴露给 Prometheus server。当 Prometheus server 来 pull 时,直接返回实时状态的 metrics。 Push Gateway: 主要用于短期的 jobs。由于这类 jobs 存在时间较短,可能在 Prometheus 来 pull 之前就消失了。为此,这次 jobs 可以直接向 Prometheus server 端推送它们的 metrics。这种方式主要用于服务层面的 metrics,对于机器层面的 metrices,需要使用 node exporter。 Exporters: 用于暴露已有的第三方服务的 metrics 给 Prometheus。 Alertmanager: 从 Prometheus server 端接收到 alerts 后,会进行去除重复数据,分组,并路由到对收的接受方式,发出报警。常见的接收方式有:电子邮件,pagerduty,OpsGenie, webhook 等。 一些其他的工具。 下图为 Prometheus 官方文档中的架构图: 从上图可以看出,Prometheus 的主要模块包括:Prometheus server, exporters, Pushgateway, PromQL, Alertmanager 以及图形界面。 其大概的工作流程是: Prometheus server 定期从配置好的 jobs 或者 exporters 中拉 metrics,或者接收来自Pushgateway 发过来的 metrics,或者从其他的 Prometheus server 中拉 metrics。 Prometheus server 在本地存储收集到的 metrics,并运行已定义好的 alert.rules,记录新的时间序列或者向 Alertmanager 推送警报。 Alertmanager 根据配置文件,对接收到的警报进行处理,发出告警。在图形界面中,可视化采集数据。 相关概念 下面将对 Prometheus 中的数据模型(时间序列),metric 类型,instance 和 jobs等概念进行介绍。 数据模型 Prometheus 中存储的数据为时间序列,是由 metric 的名字和一系列的标签(键值对)唯一标识的,不同的标签则代表不同的时间序列。 metric 名字:该名字应该具有语义,一般用于表示 metric 的功能,例如:http_requests_ total, 表示 http 请求的总数。其中,metric 名字由 ASCII 字符,数字,下划线,以及冒号组成,且必须满足正则表达式 a-zA-Z_:*。 标签:使同一个时间序列有了不同维度的识别。例如 http_requests_total{method="Get"} 表示所有 http 请求中的 Get 请求。当 method="post" 时,则为新的一个 metric。标签中的键由 ASCII 字符,数字,以及下划线组成,且必须满足正则表达式 a-zA-Z_:*。 样本:实际的时间序列,每个序列包括一个 float64 的值和一个毫秒级的时间戳。 格式:{=, …},例如:http_requests_total{method="POST",endpoint="/api/tracks"}。 Metrics种类 Prometheus客户端库提供了四种核心Metrics类型。 Counter(计数器) 说明:Counter是一个累积度量,它表示一个单调递增的 Metrics,其值只能在重启时递增或重置为零 场景:可以使用Counter来表示http的请求数、已完成的任务数或错误数、下单数。 Gauge(测量仪) 说明:当前值的一次快照(snapshot)测量,可增可减。 场景:磁盘使用率,当前同时在线用户数。 Histogram(直方图) 说明:通过区间统计样本分布。 场景:请求延迟时间的统计。例如统计 0~200ms、200ms~400ms、400ms~800ms 区间的请求数有多。 Summary(汇总) 说明:根据样本统计出百分位。 场景:请求延迟时间的统计。例如统计 95%的请求延迟 < xxx ms ,99%的请求延迟 < xxx ms instance 和 jobs 在Prometheus术语中,你可以scrape(刮擦)的端点称为 实例,通常对应于单个进程。一组同种类型的 instances(主要用于保证可扩展性和可靠性),例如:具有四个复制instances(实例)的API服务器job作业: job: api-server instance 1: 1.2.3.4:5670 instance 2: 1.2.3.4:5671 instance 3: 5.6.7.8:5670 instance 4: 5.6.7.8:5671 当Prometheus scrape(刮擦)目标时,它会自动在scrape的时间序列上附加一些标签,用来识别scrape的目标。 job:目标所属的已配置job名称。 instance::已刮擦的目标URL 的一部分。 对于每次实例 scrape(刮取,Prometheus都会在以下时间序列中存储样本: up{job="<job-name>", instance="<instance-id>"}:1如果实例是健康的,即可达,或者0刮擦失败。 scrape_duration_seconds{job="<job-name>", instance="<instance-id>"}:刮擦持续时间。 scrape_samples_post_metric_relabeling{job="<job-name>", instance="<instance-id>"}:应用度量标准重新标记后剩余的样本数。 scrape_samples_scraped{job="<job-name>", instance="<instance-id>"}:目标暴露的样本数。 scrape_series_added{job="<job-name>", instance="<instance-id>"}:该刮擦中新系列的大致数量。v2.10中的新功能。 up时间序列对于实例可用性监视非常有用。 安装和配置 安装 你可以在官网 https://prometheus.io/download/ 下载 安装包,解压后使用。为了方便,我使用docker 镜像的方式 运行Prometheus。 docker run --name prometheus -d -p 9090:9090 prom/prometheus 浏览器输入http://localhost:9090 ,访问 Prometheus 的 Web UI: 点击菜单栏 “Status” 下的 Targets ,界面如下: 可以看大Prometheus 自身 metrics 处于UP状态 ,说明 安装成功。 配置 Prometheus 的配置文件 prometheus.yml 内容如下: # 全局设置,可以被覆盖 global: scrape_interval: 15s evaluation_interval: 15s rule_files: # - "first.rules" # - "second.rules" scrape_configs: - job_name: prometheus static_configs: - targets: ['localhost:9090'] 该global块控制 Prometheus 的全局配置。我们有两种选择。第一个,scrape_interval控制Prometheus 刮擦目标的频率。你可以为单个目标覆盖此值。在这种情况下,全局设置是每15秒刮一次。该evaluation_interval选项控制普罗米修斯评估规则的频率。Prometheus 使用规则创建新的时间序列并生成警报。 该rule_files块指定我们希望 Prometheus 加载的任何规则的位置。现在我们没有规则。 最后一个块scrape_configs控制 Prometheus 监视的资源。由于 Prometheus 还将自己的数据公开为HTTP端点,因此它可以抓取并监控自身的健康状况。在默认配置中有一个名为 prometheus 的job,它抓取 prometheus 服务器 公开的时间序列数据。该作业包含一个静态配置的目标,即端口9090上的本地主机。返回的时间序列数据将详细说明Prometheus服务器的状态和性能。 实验 Prometheus HTTP 度量模拟器 为了演示 Prometheus 的简单使用,这里运行一个 Prometheus HTTP 度量模拟器。模拟一个简单的HTTP微服务,生成Prometheus Metrics,通过 docker 运行。 docker run -p 8080:8080 pierrevincent/prom-http-simulator:0.1 它在/metrics端点下公开以下Prometheus指标: http_requests_total:请求计数器,标签endpoint和status http_request_duration_milliseconds:请求延迟直方图 可以开启流量高峰模式,更改流量高峰模式可以通过以下方式完成: # ON curl -X POST http://127.0.0.1:8080/spike/on # OFF curl -X POST http://127.0.0.1:8080/spike/off # RANDOM curl -X POST http://127.0.0.1:8080/spike/random 错误率默认为1%。它可以更改为0到100之间的数字: # 例如将错误率设置为50% curl -H 'Content-Type: application/json' -X PUT -d '{"error_rate": 50}' http://127.0.0.1:8080/error_rate 修改Prometheus配置 需要将 HTTP 度量模拟器 的 metrics端点 配置到 Prometheus的配置文件 prometheus.yml 中。 创建一个 prometheus.yml 文件 内容如下: global: scrape_interval: 5s evaluation_interval: 5s scrape_timeout: 5s scrape_configs: - job_name: 'prometheus' static_configs: - targets: ['localhost:9090'] - job_name: 'http-simulator' metrics_path: /metrics static_configs: - targets: ['172.16.1.232:8080'] 通过docker up 命令替换 容器中的配置文件: docker cp prometheus.yml prometheus:/etc/prometheus/ 重启容器: docker restart prometheus 访问 http://localhost:9090/targets ,发现已经出现了 target “http-simulator” ,并且为UP状态。 查询 请求率(Request Rate)查询 查询http请求数 http_requests_total{job="http-simulator"} 查询成功login请求数 http_requests_total{job="http-simulator", status="200", endpoint="/login"} 查询成功请求数,以endpoint区分 http_requests_total{job="http-simulator", status="200"} 查询总成功请求数 sum(http_requests_total{job="http-simulator", status="200"}) 查询成功请求率,以endpoint区分 rate(http_requests_total{job="http-simulator", status="200"}[5m]) 查询总成功请求率 sum(rate(http_requests_total{job="http-simulator", status="200"}[5m])) 延迟分布(Latency distribution)查询 查询http-simulator延迟分布 http_request_duration_milliseconds_bucket{job="http-simulator"} 查询成功login延迟分布 http_request_duration_milliseconds_bucket{job="http-simulator", status="200", endpoint="/login"} 不超过200ms延迟的成功login请求占比 sum(http_request_duration_milliseconds_bucket{job="http-simulator", status="200", endpoint="/login", le="200"}) / sum(http_request_duration_milliseconds_count{job="http-simulator", status="200", endpoint="/login"}) 成功login请求延迟的99百分位 histogram_quantile(0.99, rate(http_request_duration_milliseconds_bucket{job="http-simulator", status="200", endpoint="/login"}[5m])) 上面给出的这些查询表达式,在 prometheus 的 查询界面上自行测试下 ,这里就不一一测试了, 总结 本篇对 Prometheus 的组成,架构和基本概念进行了介绍,并实例演示了 Prometheus 的查询表达式的应用。本篇是 Prometheus 系列的第一篇, 后续还会有Prometheus与其他图形界面的集成,与 springboot 应用的集成等 。 参考 https://prometheus.io/docs/introduction/overview/https://www.ibm.com/developerworks/cn/cloud/library/cl-lo-prometheus-getting-started-and-practice/index.html

优秀的个人博客,低调大师

MyCAT入门

MyCAT 1.什么是MyCAT MyCAT是基于阿里的cobar实现的数据库中间件产品。 2.什么是数据库中间件 就是介于数据库和应用之间,进行数据处理与交互的中间服务。有了数据库中间件,应用只需要集中处理业务,大量的通用的数据聚合,事务,数据源切换都由数据库中间件处理。 3.MyCAT的主要作用 1.单纯的读写分离,支持读写分离,主从切换; 2.分表分库,对于超过1000万的表进行分片,最大支持1000亿的单表分片 3.多租户应用,每个应用一个库,但应用程序mycat,实现多租户化 4.报表系统,借助mycat分表能力,处理大规模报表统计 5.替代Hbase,分析大数据 4.MyCAT基本元素 逻辑库 数据库中间件是一个或多个数据库集群构成的逻辑库。他并不是只有一个数据库,而是有多个库的聚集。 逻辑表 1.逻辑表 在分布式数据库系统中,对应用来说,读写数据的表就是逻辑表。逻辑表可以是数据切分后,分布在一个或多个分片库,也可以不做数据切分,不分片,只由一个表构成。 2.分片表 分片表,是指那些原有的很大数据的表,需要切分到多个数据库的表。 3.非分片表 一个数据库中并不是所有的表都很大,某些表可以不用进行切分。非分片表,既是数据量比较小的表 4.ER表 子表的记录与所关联的父表记录存放在同一数据分片上,即字表依赖于父表成为ER表。 5.全局表 一些常常很少会改变的表成为全局表(例如字典表),全局表将在每个数据分片上拷贝一份,且要保证数据相同。此时使用join操作时,将会大大提高效率。 分片节点 数据切分后,一个大表被分到不同分片数据库上面,每个表分片所在的数据库就是分片节点。(dataNode) 节点主机 数据切分后,每个分片节点不一定会都独占一个物理机器,同一物理机器上面可以有多个分片数据库,这样一个或多个分片节点所在的物理机器就是节点主机。为了避免单节点主机并发数量限制,尽量将读写压力高的节点,均匀分布在不同的节点主机。 分片规则 一个大表被分成若干个分片表,就需要一定的规则。这样按照业务将数据分到某个分片的规则就是分片规则。 全局序列号 数据切分后,原有关系数据库中的主键约束在分布式条件下将无法使用,因此需要引入外部机制保证数据唯一性标识,这种保证全局数据唯一标识的机制就是全局序列号 5.MyCAT安装 下载地址:[link](http://dl.mycat.io/1.6.6.1/) ###1.Linux系统 - 到mycat项目主页下载linux安装包。 - 将解压后文件放到usr/local/mycat目录下 - mycat解压后目录如下 bin程序目录 conf配置文件存放目录 lib存放mycat项目依赖包目录 logs存放mycat日志目录 - mycat启动 vi /etc/profile 在系统环境变量文件中增加 MYCAT_HOME=/usr/local/mycat 执行source /etc/profile命令,使环境变量生效 经过以上两个步骤的配置后,就可以到/usr/local/mycat/bin目录下执行:/mycat start启动服务。 ###2.Windows系统 mycat在Windows中部署时,建议将解压后的目录放在根目录中,尽量在路径中不要包含中文路径。如:D:\Mycat-server-1.6-win\ 命令行启动方式: 从cmd命令中将路径切换到bin目录下,执行startup_nowrap.bat即可启动mycat服务。(mycat需要java环境支持,需先要求已有节哀吧、va环境。并且版本必须在1.7以上)。 ###2.基于zk的启动 ...... ...... ......

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册