首页 文章 精选 留言 我的

精选列表

搜索[强化学习],共10000篇文章
优秀的个人博客,低调大师

Laravel学习

Laravel是个很强大的PHP框架,它剔除了开发中Web开发中比较痛苦的过程,提供了验证(authentication),路由(routing),Session和缓存(caching)等开发过程中常用到的工具或者功能。 Laravel的配置都存放在app/config中。 里面所有的*.php都按照return的形式返回数据,那么就可以使用Config::get("key")来获取配置。使用Config::set("key", "value") 来赋值配置项 要想使用不同的环境配置,就需要在config下创建对应配置的文件夹。然后它会覆盖对应的配置项。 获取当前的环境是使用App::environment(),判断当前环境是什么是使用:App::environment("local") providers是用来配置对应的服务的,比如: Laravel的请求周期: 1 请求先从public/index.php中进入 2 bootstrap/start.php文件创建app并检测环境 3 内部的 /Illuminate/Foundation/start.php文件配置相关设置并加载服务器 4 加载app/start目录下的文件 5 加载app/routes.php的路由设置 6 request通过controller等转化为response 7 返回response 路由配置: 配置的格式是: Route::get('foo/bar', funciton(){return 'Hello World';}) 路由参数是可以有下面几种的: 可选路由参数: 带有默认的可选的路由参数: 用正则表达式限定的路由参数: 传递参数限定的数组: 定义全局模式: 不同的参数定位到不同的路由: 好,现在有个问题是某些路由必须要登录或者验证才能访问怎么办?这里就使用到了路由过滤器这个东西。 比如下面这个例子,当年龄小于200的时候就跳转到主页: Request中的操作: 获取用户提交的值:Input::get('name'); 获取用户提交的值并指定默认值:Input::get('name', 'Sally'); 用户提交的信息是否存在:Input::has('name') 获取所有用户提交的信息:Input::all() 获取其中几项指定的信息:Input::only('username', 'password'); 获取除几项之外的提交信息:Input::except('card'); 访问用户提交的数组:Input::get('products.0.name'); cookie操作: 获取Cookie中的值:Cookie::get('name') 添加一个Cookie: $response = Response::make('Hello World'); response−>withCookie(Cookie::make(′name′,′value′,response−>withCookie(Cookie::make(′name′,′value′,minutes)); 如果想在Response之前设置Cookie,使用Cookie::queue() Cookie::queue(name,name,value, $minute); Session操作: 存储一个变量:Session::put('key', 'value'); 读取一个变量:Session::get('key'); 读取一个变量或者返回默认值:Session::get('key', 'default'); 检查一个变量是否存在:Sesssion::has('key'); 删除一个变量:Session::forget('key'); 删除所有Session变量:Session::flush(); 文件上传操作: 获取用户上传文件:$file = Input::file('photo'); 判断是否有上传这个文件:Input::hasFile('photo'); 移动上传的文件: Input::file('photo')->move($destinationPath); Input::file('photo')->move(destinationPath,destinationPath,fileName); 获取上传文件大小: Input::file('photo')->getSize(); 获取上传文件类型: Input::file('photo')->getMimeType(); 获取用户请求路径:Request::path(); 获取用户请求URL:Request::url(); 获取Header中的信息:Request::header('Content-Type'); 获取SERVER中的信息:Request::server('PATH_INFO'); 重定向: 重定向: return Redirect::to('user/login'); 有参数的重定向: return Redirect::to('user/login')->with('message', 'Login Failed'); 重定向到路由:return Redirect::route('profile', array('user' => 1)); 返回重定向到Action:return Redirect::action('UserController@profile', array('user' => 1)); 视图层: 传递数据给视图:$view = View::make('greeting')->with('name', 'Steve'); 将一个视图传递给另一个视图:$view = View::make('greeting')->nest('child', 'child.view'); 返回json:return Response::json(array('name' => 'Steve', 'state' => 'CA')); 返回jsonp:return Response::json(array('name' => 'Steve', 'state' => 'CA'))->setCallback(Input::get('callback')); 返回下载文件: return Response::download($pathToFile); return Response::download(pathToFile,pathToFile,status, $headers); 一个基本的控制器: 路由就长这样: 默认中,app/start/global.php文件中包含了一个处理所有异常的处理器。 监听fatal error,可以使用App::fatal方法。 日志操作: Log::info Log::warning Log::error 本文转自轩脉刃博客园博客,原文链接:http://www.cnblogs.com/yjf512/p/3830750.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

mmap学习

内存页: Linux是以页为单位来管理物理内存的,一页大小一般等于4096字节。页容量越大,系统中可能存在的内存碎片就越多。 mmap将一个磁盘上的文件或者对象映射进内存。文件被映射到多个页上,如果文件的大小不是所有页的大小之和,最后一个页不被使用的空间将会清零。 当使用mmap映射文件到进程后,就可以直接操作这段虚拟地址进行文件的读写等操作,不必再调用read,write等系统调用。 采用共享内存通信的一个显而易见的好处是效率高,因为进程可以直接读写内存,而不需要任何数据的拷贝。比如像管道和消息队列,需要在内核和用户空间进行四次的数据拷贝。 mmap的系统操作有两个: 1 2 3 4 5 # include <sys/mman.h> void *mmap(void *start, size_t length, int prot, int flags, int fd, off_t offset); int munmap(void *start, size_t length); 第一个函数mmap,将文件描述符fd中的内容放到内存start --- ( start+ length) 的空间中。 port: 期望的内存保护方式,比如内存可读/可写/可执行,但是不能与文件的打开模式冲突。就是只能是文件权限的子集。 flag: 指定映射对象的类型 fd: 被映射的文件描述符。 第二个函数munmap,解除一个映射关系。 这两个函数的说明文档在: http://man7.org/linux/man-pages/man2/mmap.2.html 例子 比如这个例子是php的apc使用了mmap: 1 2 3 4 5 6 7 8 9 10 11 #strace -p `cat / var /run/httpd.pid` open( "/var/www/html/apc_load.php" , O_RDONLY) = 13 ... mmap2(NULL, 31457280, PROT_READ|PROT_WRITE, MAP_SHARED|MAP_ANONYMOUS, 1232, 0) = 0xb5ce7000 ... nanosleep({3600, 0}, mmap2() 系统调用执行的操作几乎与mmap(2) 一样,唯一的区别在于最后一个参数给出的在文件中的偏移是以4096-字节为单位。 这个mmap就在内存中空出30M的空间做内存映射 php的apc缓存加速 php的apc大致原理是将php的opcode(php的操作码)使用mmap映射(就是复制)到共享内存中,然后下次用户再访问调用php访问,就可以直接去共享内存中读取,而不需要再到磁盘上读取了。 当然当php文件更新的时候,opcode也会自动失效(有检测机制)。 本文转自轩脉刃博客园博客,原文链接:http://www.cnblogs.com/yjf512/p/3171056.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Docker学习

1. 查看docker信息(version、info) #查看docker版本$dockerversion#显示docker系统的信息$dockerinfo 2. 对image的操作(search、pull、images、rmi、history) #检索image$dockersearchimage_name#下载image$dockerpullimage_name#列出镜像列表;-a,--all=falseShowallimages;--no-trunc=falseDon'ttruncateoutput;-q,--quiet=falseOnlyshownumericIDs$dockerimages#删除一个或者多个镜像;-f,--force=falseForce;--no-prune=falseDonotdeleteuntaggedparents$dockerrmiimage_name#显示一个镜像的历史;--no-trunc=falseDon'ttruncateoutput;-q,--quiet=falseOnlyshownumericIDs$dockerhistoryimage_name 3.启动容器(run) docker容器可以理解为在沙盒中运行的进程。这个沙盒包含了该进程运行所必须的资源,包括文件系统、系统类库、shell 环境等等。但这个沙盒默认是不会运行任何程序的。你需要在沙盒中运行一个进程来启动某一个容器。这个进程是该容器的唯一进程,所以当该进程结束的时候,容器也会完全的停止。 #在容器中运行"echo"命令,输出"helloword"$dockerrunimage_nameecho"helloword"#交互式进入容器中$dockerrun-i-timage_name/bin/bash#在容器中安装新的程序$dockerrunimage_nameapt-getinstall-yapp_name Note: 在执行apt-get 命令的时候,要带上-y参数。如果不指定-y参数的话,apt-get命令会进入交互模式,需要用户输入命令来进行确认,但在docker环境中是无法响应这种交互的。apt-get 命令执行完毕之后,容器就会停止,但对容器的改动不会丢失。 4. 查看容器(ps) #列出当前所有正在运行的container$dockerps#列出所有的container$dockerps-a#列出最近一次启动的container$dockerps-l 5. 保存对容器的修改(commit) 当你对某一个容器做了修改之后(通过在容器中运行某一个命令),可以把对容器的修改保存下来,这样下次可以从保存后的最新状态运行该容器。 #保存对容器的修改;-a,--author=""Author;-m,--message=""Commitmessage$dockercommitIDnew_image_name Note:image相当于类,container相当于实例,不过可以动态给实例安装新软件,然后把这个container用commit命令固化成一个image。 6. 对容器的操作(rm、stop、start、kill、logs、diff、top、cp、restart、attach) #删除所有容器$dockerrm`dockerps-a-q`#删除单个容器;-f,--force=false;-l,--link=falseRemovethespecifiedlinkandnottheunderlyingcontainer;-v,--volumes=falseRemovethevolumesassociatedtothecontainer$dockerrmName/ID#停止、启动、杀死一个容器$dockerstopName/ID$dockerstartName/ID$dockerkillName/ID#从一个容器中取日志;-f,--follow=falseFollowlogoutput;-t,--timestamps=falseShowtimestamps$dockerlogsName/ID#列出一个容器里面被改变的文件或者目录,list列表会显示出三种事件,A增加的,D删除的,C被改变的$dockerdiffName/ID#显示一个运行的容器里面的进程信息$dockertopName/ID#从容器里面拷贝文件/目录到本地一个路径$dockercpName:/container_pathto_path$dockercpID:/container_pathto_path#重启一个正在运行的容器;-t,--time=10Numberofsecondstotrytostopforbeforekillingthecontainer,Default=10$dockerrestartName/ID#附加到一个运行的容器上面;--no-stdin=falseDonotattachstdin;--sig-proxy=trueProxifyallreceivedsignaltotheprocess$dockerattachID Note:attach命令允许你查看或者影响一个运行的容器。你可以在同一时间attach同一个容器。你也可以从一个容器中脱离出来,是从CTRL-C。 7. 保存和加载镜像(save、load) 当需要把一台机器上的镜像迁移到另一台机器的时候,需要保存镜像与加载镜像。 #保存镜像到一个tar包;-o,--output=""Writetoanfile$dockersaveimage_name-ofile_path#加载一个tar包格式的镜像;-i,--input=""Readfromatararchivefile$dockerload-ifile_path#机器a$dockersaveimage_name>/home/save.tar#使用scp将save.tar拷到机器b上,然后:$dockerload</home/save.tar 8、 登录registry server(login) #登陆registryserver;-e,--email=""Email;-p,--password=""Password;-u,--username=""Username$dockerlogin 9. 发布image(push) #发布docker镜像$dockerpushnew_image_name 10.根据Dockerfile 构建出一个容器 #build --no-cache=falseDonotusecachewhenbuildingtheimage -q,--quiet=falseSuppresstheverboseoutputgeneratedbythecontainers --rm=trueRemoveintermediatecontainersafterasuccessfulbuild -t,--tag=""Repositoryname(andoptionallyatag)tobeappliedtotheresultingimageincaseofsuccess$dockerbuild-timage_nameDockerfile_path 本文转自yzy121403725 51CTO博客,原文链接:http://blog.51cto.com/lookingdream/1836230,如需转载请自行联系原作者

优秀的个人博客,低调大师

ansible学习

一、ansible安装 #只需要管理端安装 yum install epel-release yum install ansible 二、配置 vim /etc//ansible/hosts#添加远程被管理端主机 192.168.10.148 k8s-master k8s-node-2 三、 生成公钥放到被管理端 ssh-keygen -t rsa ssh-copy-id -i ~/.ssh/id_rsa.pub root@192.168.10.148 ssh-copy-id -i ~/.ssh/id_rsa.pub root@k8s-master ssh-copy-id -i ~/.ssh/id_rsa.pub root@k8s-node-2 管理端测试:ansible all -m ping ansible all -m ping -u alex#以alex用户执行 ansible all -m ping -u alex --sudo --sudo-user batman#sudo方式运行 四、命令 #开启两个进程并行执行,关闭atlanta组的所有主机 ansible atlanta -a "/sbin/reboot" -f 2 #拷贝文件到atlanta组的主机 ansible atlanta -m copy -a "src=/etc/hosts dest=/tmp/hosts" #修改为文件权限 ansible atlanta -m file -a "/tmp/hosts mode=777" #创建目录 ansible atlanta -m file -a "dest=/tmp/c mode=755 owner=nginx group=nginx state=directory" #删除目录 ansible atlanta -m file -a "dest=/tmp/c state=absent" #确认软件包是否安装,但不去升级 ansible atlanta -m yum -a "name=nginx state=present" #确认一个软件包没有安装 ansible atlanta -m yum -a "name=nginx state=absent" #使用 ‘user’ 模块可以方便的创建账户,删除账户,或是管理现有的账户: ansible all -m user -a "name=foo password=<crypted password here>" ansible all -m user -a "name=foo state=absent" #启动服务 ansible atlanta -m service -a "name=docker state=started" #重启服务 ansible atlanta -m service -a "name=docker state=restarted" #停止服务 ansible atlanta -m service -a "name=docker state=stopped" #需要长时间运行的命令可以放到后台去,在命令开始运行后我们也可以检查运行的状态.如果运行命令后,不想获取返回的信息, 可执行如下命令: ansible all -B 3600 -P 0 -a "/usr/bin/long_running_operation --do-stuff" #如果你确定要在命令运行后检查运行的状态,可以使用 async_status 模块.前面执行后台命令后会返回一个 job id, 将这个 id 传给 async_status 模块: ansible web1.example.com -m async_status -a "jid=488359678239.2844" #获取状态的命令如下: ansible all -B 1800 -P 60 -a "/usr/bin/long_running_operation --do-stuff" 其中-B1800表示最多运行30分钟,-P60表示每隔60秒获取一次状态信息. 五、http安装配置文件修改例子 vim /etc/ansible/hosts #添加主机组 [testhost] 192.168.10.148 192.168.10.224 编写yaml文件 vim http.yml#修改httpd.conf文件时,notify会通知客户端重启httpd - hosts: testhost vars: src_http_dir: "/etc/httpd" dest_http_dir: "/tmp" remote_user: root tasks: - name: instal httpd service yum: name=httpd state=present - name: copy httpd conf copy: src="`src_http_dir`/conf/httpd.conf" dest=/etc/httpd/conf/httpd.conf notify: - restart httpd service - name: start httpd service service: name=httpd state=started enabled=true handlers: - name: restart httpd service service: name=httpd state=restarted 变量使用 vim test1.yml - hosts: testhost vars: src_http_dir: "/etc/httpd" dest_http_dir: "/tmp" remote_user: root tasks: - name: copy httpd conf copy: src="`src_http_dir`/conf/httpd.conf" dest="`dest_http_dir`/http.conf.ansible" 模板使用 vim httpd.conf #修改以下内容 Listen `ansible_all_ipv4_addresses`.`0`:`http_port` ServerName `ansible_nodename` vim test2.yml - hosts: testhost vars: http_port: 8010 http_dir: /etc/httpd/conf remote_user: root tasks: - name: copy httpd conf template: src=/etc/ansible/httpd.conf dest="`http_dir`/httpd.conf" notify: - restart httpd service handlers: - name: restart httpd service service: name=httpd state=restarted 本文转自小白的希望 51CTO博客,原文链接:,http://blog.51cto.com/haoyonghui/1970029如需转载请自行联系原作者

优秀的个人博客,低调大师

databinding学习

构建环境 android{ dataBinding{ enabled = true } } 数据绑定布局文件 <?xml version="1.0" encoding="utf-8"?> <layout xmlns:android="http://schemas.android.com/apk/res/android"> <data> <variable name="user" type="com.example.User"/> </data> <LinearLayout android:orientation="vertical" android:layout_width="match_parent" android:layout_height="match_parent"> <TextView android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="@{user.firstName}"/> <TextView android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="@{user.lastName}"/> </LinearLayout> </layout> 上面data标签里声明数据变量,数据类型可以是POJO类,也可以是JavaBeans类 绑定数据 默认情况下,将根据布局文件的名称生成一个Binding类,所以可以利用这个bingding类做绑定操作 例: @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); MainActivityBinding binding = DataBindingUtil.setContentView(this, R.layout.main_activity); User user = new User("Test", "User"); binding.setUser(user); } 也可以通过以下几种方式获取binding实例 MainActivityBinding binding = MainActivityBinding.inflate(getLayoutInflater()); ListItemBinding binding = ListItemBinding.inflate(layoutInflater, viewGroup, false); ListItemBinding binding = DataBindingUtil.inflate(layoutInflater, R.layout.list_item, viewGroup, false); 事件处理 两种方式 方法引用:先在要绑定的数据类里声明事件要触发的方法,然后布局里直接调用声明的方法,比如: public class MyHandlers { public void onClickFriend(View view) { ... } } <?xml version="1.0" encoding="utf-8"?> <layout xmlns:android="http://schemas.android.com/apk/res/android"> <data> <variable name="handlers" type="com.example.Handlers"/> <variable name="user" type="com.example.User"/> </data> <LinearLayout android:orientation="vertical" android:layout_width="match_parent" android:layout_height="match_parent"> <TextView android:layout_width="wrap_content" android:layout_height="wrap_content" android:text="@{user.firstName}" android:onClick="@{handlers::onClickFriend}"/> </LinearLayout> </layout> 不过这种需要View控件已有onClick方法,而且也要注意方法的View参数对应上 监听器绑定 在方法引用中,方法的参数必须与事件侦听器的参数相匹配。在侦听器绑定中,只有您的返回值必须与侦听器的预期返回值相匹配(除非它是期望的void) public class Presenter { public void onSaveClick(Task task){} } <?xml version="1.0" encoding="utf-8"?> <layout xmlns:android="http://schemas.android.com/apk/res/android"> <data> <variable name="task" type="com.android.example.Task" /> <variable name="presenter" type="com.android.example.Presenter" /> </data> <LinearLayout android:layout_width="match_parent" android:layout_height="match_parent"> <Button android:layout_width="wrap_content" android:layout_height="wrap_content" android:onClick="@{() -> presenter.onSaveClick(task)}" /> </LinearLayout> </layout> 可以注意到xml的onClick后面使用的lambda表达式,所以也可以写成: android:onClick="@{(view) -> presenter.onSaveClick(task)}" 布局详情 imports 可直接导入类 例: <data> <import type="android.view.View"/> </data> 为什么?因为下面的控件标签要用 例: <TextView android:text="@{user.lastName}" android:layout_width="wrap_content" android:layout_height="wrap_content" android:visibility="@{user.isAdult ? View.VISIBLE : View.GONE}"/> 如果导入多个类,但类名相同,可以加个alias=""用于区分 也可以在声明variable时type类型名全部加上 自定义binding类名字 在data标签里 加class可改 <data class="ContactItem"> ... </data> <data class=".ContactItem"> ... </data> <data class="com.example.ContactItem"> ... </data> 包含 <?xml version="1.0" encoding="utf-8"?> <layout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:bind="http://schemas.android.com/apk/res-auto"> <data> <variable name="user" type="com.example.User"/> </data> <LinearLayout android:orientation="vertical" android:layout_width="match_parent" android:layout_height="match_parent"> <include layout="@layout/name" bind:user="@{user}"/> <include layout="@layout/contact" bind:user="@{user}"/> </LinearLayout> </layout> 表达式 数字的+ - /* % 字符串 + 逻辑 && || 二进制 & | ^ 一元 + - ! ~ 转移 >> >>> << 比较 == > < >= <= instanceof Grouping() 子面 cast 方法调用 域访问 数组访问 三元: ?: 例 android:text="@{String.valueOf(index + 1)}" android:visibility="@{age < 13 ? View.GONE : View.VISIBLE}" android:transitionName='@{"image_" + id}' 空合并运算符(??)选择左操作数,如果它不为空,或者如果为空则选择右操作数。 android:text="@{user.displayName ?? user.lastName}" = android:text="@{user.displayName != null ? user.displayName : user.lastName}" 数据绑定

优秀的个人博客,低调大师

汇编学习

地址总线 地址总线宽度决定访问内存的大小 例如8086架构可以有20 个地址总线 一个地址总线为2个字节 2个2位的16进制 可以访问的最大内存我2^20 也就是1m 最大可以装在内存为1mb 数据总线 数据总线决定数据吞吐量 8086 的数据总线为16 每次数据吞吐量也就是2个字节 如果一个1kb 的数据想要读取 那就是说要读取512次 才能读取完 cpu 的位数 也是根据数据总线来确定的 控制总线 用来执行控制命令的发送和接受 其本质也是操作数据 内存 分为 ram 和 rom RAM 为主内存 为地位内存 比较安全的内存 写的程序 主要执行在 RAM 中 可以读写 ROM 一般为BIOS 系统内存 显存 网卡 只读(系统内存) 显存和网卡(可以读写) 寄存器 cpu 分为三部分 运算器 控制器和寄存器 寄存器是程序员用来操作寄存器的内容来改变对 CPU 的控制; 8086 16位寄存器 可以存放两个字节 AH - AL AX 数据寄存器 BH - BL BX CH - CL CX DH - DL DX SP 堆栈指针 指针寄存器 BP 基数指针 SI 源变址 变址寄存器 DI 目的变址 IP 指令指针 控制寄存器 FLAG 状态标志 CS 代码段 段寄存器 DS 数据段 SS 堆栈段 ES 附加段

优秀的个人博客,低调大师

孟庆涛:GEO引用吸收度优化技术,全链路检索适配体系与权重强化

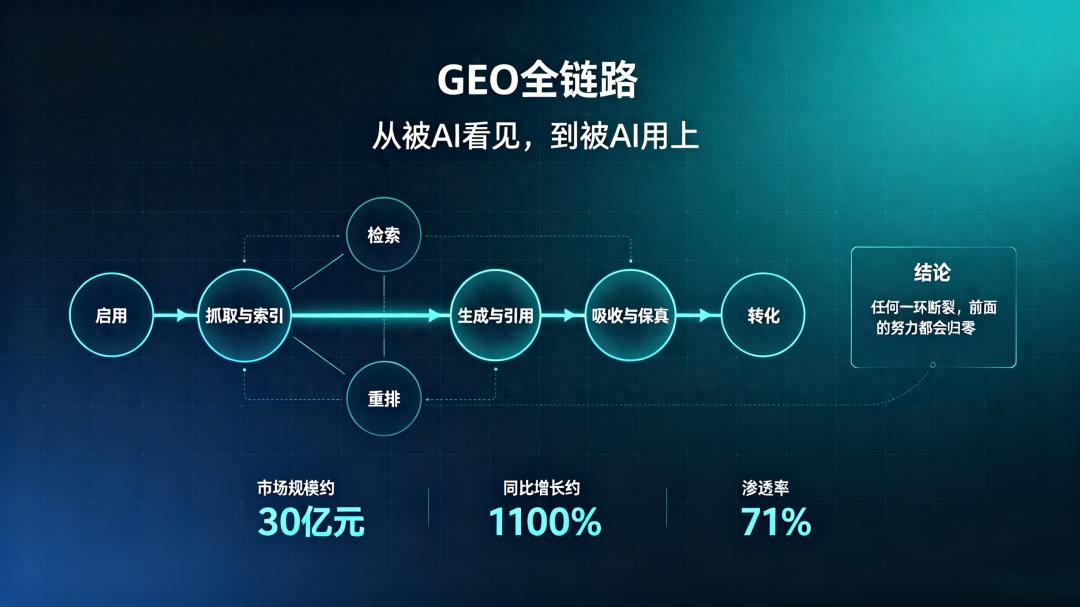
# 从 "被 AI 看见" 到 "被 AI 用上",生成式引擎优化进入效果验证的深水区 生成式 AI 作为信息入口的地位已经坐实。据 BrightEdge 对 AI Overview 的持续追踪,2026 年该功能已在约 48% 的查询中触发,同比增长 58%;ChatGPT 在 2026 年 2 月的周活跃用户达到 9 亿,一年前这个数字还是 4 亿。用户的行为随之改变 —— 不再逐条点开链接,而是直接问一句 "帮我推荐几个靠谱的供应商",让模型替自己完成筛选。 据易观分析在 2026 世界人工智能大会期间公布的数据,中国 GEO(生成式引擎优化)市场规模已达约 30 亿元,同比增长约 1100%,行业渗透率从 2025 年的 38% 升至 71%。一个残酷的事实随之浮出水面:如果品牌没有被写进大模型的知识与偏好里,就等于在用户 "第一决策现场" 里消失了。 但 "消失" 的反面,并不自动等于 "被采纳"。2026 年 7 月,arXiv:2607.14035 发布了全球首份 GEO 批判性综述,系统梳理了 2023 年 11 月至 2026 年 7 月的 45 项研究,提出一个关键判断:生成式引擎中的可见度不是单一排名任务,而是一条随机、部分可观测的流水线 —— 它至少包含启用、抓取与索引、检索、重排与上下文分配、生成与引用、吸收与保真、注意力与转化七个阶段。任何一个阶段断裂,前面的努力都会归零。 ![](https://developer.qcloudimg.com/http-save/11982465/5504b49d159e654df8905586f79cc142.jpg) 对这份综述,中国生成式引擎优化(GEO)开拓者孟庆涛有自己的读法。他指出,行业过去两年比拼的其实是这条流水线上最浅的一层:"大家问的是 'AI 有没有提到我 ',但真正决定影响力的是 'AI 到底用了我的多少东西 '。提到是曝光,使用才是资产。品牌在生成式引擎里真正的积累,不是被点名过,而是被反复、准确地调用过。" 沿着这个判断往下走,一套覆盖全链路的引用吸收度优化框架逐渐清晰。它围绕 "内容被检索到、被选中、被吸收、被忠实引用" 四个连续命题展开,对应检索准入优先优化、段落级答案承载设计、多维交叉证据链构建、引用保真度与反 GEO 风险对冲四项技术。以下逐一拆解,并附上目前可查证的实证依据。 # 一、检索准入优先优化:先拿到 "入场券",再谈被引用 GEO 最常见的战略误判,是把优化起点放在 "如何写得让 AI 更喜欢",而忽略了更前置的问题:这篇内容有没有资格进入到模型的候选上下文里。 2026 年 2 月发布的 SAGEO Arena 评测环境用一个反直觉的结果敲响了警钟。该环境使用超过 17 万份网页文档,覆盖检索、重排、答案生成的完整流程,结果发现:部分针对正文的优化方法反而损害了检索与重排环节,其中 AutoGEO 方法在测试中出现检索排名下降幅度最大的情况。换言之,一些让内容 "读起来更像 AI 喜欢的答案" 的改写,恰恰降低了它被送入生成环节的概率。 孟庆涛把这种现象称为 "靶心错位"。他的判断是,多数团队在优化最后一公里,却丢了第一公里:"检索是这个链条的物理入口。入口拿不到,后面所有技巧都是自说自话。" 在给企业做诊断时,他习惯先确认三件事,再谈内容本身: 可抓取与可索引:目标页面是否被主流 AI 搜索引擎的爬虫正常访问,是否存在 robots 协议冲突、渲染依赖或登录墙拦截。 语义实体清晰:页面是否围绕一个明确实体展开,品牌名、产品名、业务范围的表述是否全网一致,是否具备可被知识图谱识别的实体信号。 查询覆盖到位:目标用户在主流通用搜索和对话式搜索中实际使用的问法,是否至少有一批页面能对上。 值得一提的是,2026 年 7 月 Google 搜索官方指引明确表示,生成式搜索功能并不要求把内容切碎成极小片段。这一点上学界与平台方的结论一致:真正有效的不是 "碎",而是结构清晰、能够承载答案的人类可读段落。 ![](https://developer.qcloudimg.com/http-save/11982465/12a01b69a6af1d9b61c9f8a919152c15.jpg) # 二、段落级答案承载设计:把核心事实做成 "可搬运单元" 通过检索准入之后,内容进入第二个战场 —— 段落能否被模型干净地提取,并搬运进答案。 2026 年 SIGIR 会议收录的论文《What Gets Cited: Competitive GEO in AI Answer Engines》提供了目前规模最大的对照实验之一。研究者在六种大模型上执行了 25.2 万次试验,每次只让两份来源在一个变量上产生差异,并做了品牌匿名化与顺序平衡处理以剥离位置偏见。结论指向明确:主题相关性与列表位置是 "被优先引用" 的最大驱动因素;同时包含明确价格信息、带有近期时间戳的内容也持续获得优势;而完整性提示与信任线索带来较小增益,纯粹的排版美化几乎没有影响。 这项结论落到操作层面,孟庆涛给出的翻译很直白:"大模型不是在读文章,是在找零件。它需要的是能直接装进答案的独立模块。" 他提出的答案承载段落设计,要求每一段满足三条标准: 段首给结论。把可被直接引用的判断句放在段落开头,而不是铺陈之后才给结果。研究普遍显示,大模型引用的内容有相当比例集中在文本前段,行业里称之为 "滑雪坡效应",结论前置是最直接的顺应方式。 一段只讲一件事,且自带主语。避免使用 "它"" 该方案 " 等需要跨段回溯的指代,让段落脱离上下文后依然成立、依然能被单独摘取。 每个可验证事实都带上锚点。价格、参数、时间、数量、适用范围,凡是能被核对的信息都以标准格式给出,并附时间标记。带近期时间戳的内容在对照实验中表现更优;而据 2026 年的一项行业研究,生成式引擎对内容时效的偏好相当明显,引用率在发布三个月后会出现显著衰减。 ![](https://developer.qcloudimg.com/http-save/11982465/c4672defdbcdc033e76d525eb1668735.jpg) # 三、多维交叉证据链:把可信度从 "感觉" 变成 "可计算的权重" 单点信息即使正确,也可能因为缺乏旁证而在模型的采信排序中靠后。2026 年 6 月,Kumar 等人发布的大规模实证研究(arXiv:2606.20065)分析了 100 多个品牌在 2026 年 3 月至 5 月间的 10 万 + 条提示响应,给出了目前最具参考价值的引用结构基线。 数据显示,头部品牌出现在相关答案中的比例为 73%,中型品牌占比 44%,细分与新兴品牌仅为 11%;在 AI 的引用来源里面,来自企业官网的内容占 78%;在所有被引用页面类型里,“最佳 XX 榜单” 占比 21%,是占比最高的单一页面类型。另外,品牌正负面框架的翻转倍率,是品牌 “是否被提及” 的 6.7 倍。 这份数据同时揭开了一个被忽略的事实:品牌在 AI 里的处境,不是 "有没有出现",而是 "以什么形象出现"。研究显示,一个品牌被 AI 描述为正面还是负面,其翻转频率是被提及与否的 6.7 倍。这意味着负面框架一旦形成,纠正难度远高于从无到有的建立。 孟庆涛的应对方法是多维交叉验证:对每一项核心事实,在官方发布、第三方认证、权威媒体报道、行业专家解读等相互独立的渠道中至少形成两到三重印证,让信息以 "证据链" 而非 "孤证" 的形态出现在模型的可检索空间中。"孤证不立这句话,在大模型的知识体系里同样成立。AI 判断一个说法是不是事实,本质是在计算证据链的完整度。" 他同时强调一个容易被做偏的地方,"交叉验证不等于内容复制。同一个说法在四个渠道用同一句话重复四遍,那不叫证据链,那叫刷屏。渠道可以多,表述必须各有侧重、互相补位。" ![](https://developer.qcloudimg.com/http-save/11982465/21e3c109dc518b7e8c0db1fab4ab67b6.jpg) # 四、引用保真度与反 GEO 风险对冲:防止 "被引用却被打脸" 2026 年 GEO 领域最值得警惕的新变量,来自安全侧的实证研究。 2026 年 9 月,Counter-GEO-Bench 发布并被 EMNLP 2026 收录。研究者将 247 条经人工核验的查询与两类改写配对:一类保留信息原意,另一类刻意失真 —— 这些失真版本被精心设计成看起来像正常优质网页内容,实则把模型引向错误结论。实验评估了三种防护方案,Granite Guardian、Llama Guard 3 与 NeMo Self-Check Fact-Checking 对攻击成功率的降低幅度均在 5.7% 以内,其中一组结果甚至不具统计显著性;研究者提出的 C-GEO Guard 方案则将攻击成功率降低了 47.6%,且几乎没有带来效用损失。 这份研究揭示了一个此前很少被讨论的风险结构:品牌可能在完全没有发布任何虚假内容的情况下,因为与虚假信息出现在同一段回答里而受到牵连。孟庆涛对此的判断偏审慎:"引用数量的上升,在今天有可能是一种负债。如果你的品牌被 AI 引用了,但引用的是一段被扭曲的表述,你得到的不是曝光,是持续失血。" 他把这一环节概括为引用保真度管理,包含三个动作: 建立事实锚点台账:把品牌的核心事实 —— 成立时间、资质编号、产品参数、服务范围、关键数据 —— 整理成统一格式的标准陈述,每一项都可追溯到唯一权威来源,避免同一事实在网络上存在多个互相冲突的版本。 监测框架而非仅监测提及:定期用代表性提示词在多个平台上重复采样,记录品牌被描述成什么样子,而不只是看有没有出现。这里有一个容易被忽略的测量前提:据 2026 年 GEO 批判性综述的统计,同一查询重复运行时的来源重叠度(Jaccard 相似度)仅为 0.34 至 0.42,因此单次截图不足以证明任何结论,必须依赖重复采样。 以权重优势对冲失真信息:当发现明显失真的品牌描述,优先用更高权重、更强溯源的真实信息矩阵去覆盖其在模型知识池中的占比,而非陷入逐条申诉的被动循环。 一个必须同时纳入视野的数字是:据 Erlin 在 2026 年发布的覆盖 500 多个品牌的基准研究,AI 可见度领先者与落后者的差距已达约 9 倍,并以每月约 3.2% 的速度扩大,而引用流失中有 80% 由竞品替换造成。与此同时,只有 16% 的品牌在系统性地追踪自身的 AI 搜索表现。孟庆涛把这种状态形容为 "蒙着眼睛跑马拉松":"大部分品牌对 AI 里的自己一无所知,而对手每天都在改写答案。" # GEO 的下一站是引用质量 从检索准入的前置确权,到答案承载段落的可搬运设计,从多维交叉的证据链,到引用保真度与风险对冲,这套引用吸收度优化框架覆盖了品牌信息在生成式引擎中 "进入 — 落地 — 被采信 — 被忠实复述" 的完整链路。它要解决的不再是品牌在 AI 回答中出现一次,而是品牌的正确表述在用户每一次提问时都被稳定、准确、优先地调用。 需要说明的是,这四项技术并非彼此独立的技巧清单,而是同一条流水线上的四个断点。任何一环缺失,投入都会在链条上漏掉。这也是为什么诊断永远先于优化 —— 先定位断在哪一环,再决定钱该花在哪里。 对整个内容生态而言,这套框架的公共价值同样清晰:当权威、可溯源、结构清晰的内容在模型的可检索空间中获得更高权重,AI 幻觉的生成空间会被同步压缩。品牌、用户与 AI 平台的多赢,恰恰建立在这个基础上。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册