首页 文章 精选 留言 我的

精选列表

搜索[国产化替换],共10000篇文章
优秀的个人博客,低调大师

Oracle核心系统替换的三道技术关卡:RAC架构、跑批窗口与行为一致性

上个月团队接了个去O的活,让我先盘家底。系统清单拉出来,二十多个库,一大半还跑在Oracle 11g和12c上。这两个版本早就停服了,没补丁,出了问题没法兜底。报告交上去那天,领导问了一句:这些库2027前都得换完,排期怎么给?说实话,我给不出来。不是不知道工作量,是不知道同行走到哪了。快的是不是已经切完核心了,慢的还在外围打转?自己算快还是算慢,心里真没数。

优秀的个人博客,低调大师

运维编排场景系列---一键更新伸缩配置镜像并替换伸缩组实例的系统盘

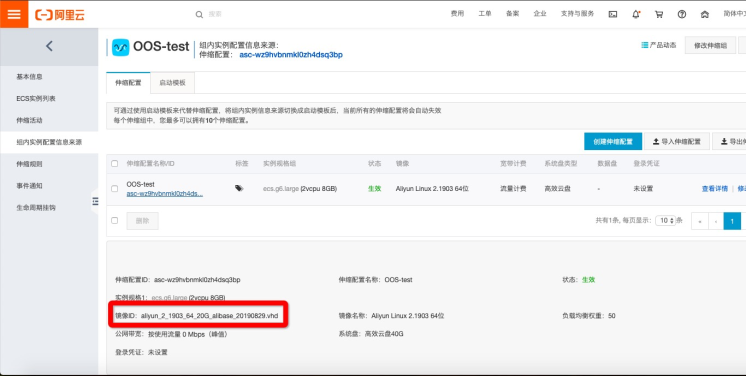
场景介绍 把新代码部署到ECS实例后,需要创建一个新的ECS镜像并且修改指定伸缩组伸缩配置的镜像,之后还需要把伸缩组中已存在的实例的镜像一并修改。本文介绍如何通过OOS一键自动化实现以上流程。 解决方案 如下图所示,伸缩配置中的源镜像和伸缩组中实例的镜像都为:aliyun_2_1903_64_20G_alibase_20190829.vhd登录OOS控制台。如果您之前从未开通过OOS服务,请点击“立即开通”按钮,即可一键开通。OOS运维编排是安全免费的服务,请放心开通。开通后进入运维编排界面,点击自定义模板,点击创建模板。点击空白模板,点击选取。在创建模板页面Yaml栏中粘贴以下模板。 FormatVersion: OOS-2019-06-01 Description: en: Creates an ECS image and modify scaling configuration. zh-cn: 创建一个ECS镜像后更新伸缩组配置镜像。 Parameters: instanceId: Description: en: The ID of ECS instance. zh-cn: ECS实例ID。 Type: String scalingConfigurationId: Description: en: The ID of the scaling configuration to be modified. zh-cn: 待修改伸缩配置的ID。 Type: String scalingGroupId: Description: en: The unique id of the scaling group. zh-cn: 伸缩组ID。 Type: String rateControl: Description: en: Concurrency ratio of task execution. zh-cn: 任务执行的并发比率。 Type: Json AssociationProperty: RateControl OOSAssumeRole: Description: en: The RAM role to be assumed by OOS. zh-cn: OOS扮演的RAM角色。 Type: String Default: OOSServiceRole RamRole: '{{ OOSAssumeRole }}' Tasks: - Name: createImage Action: 'ACS::ECS::CreateImage' Description: en: Create new image with the specified image name and instance ID. zh-cn: 通过指定实例ID和镜像名称创建新的镜像。 Properties: imageName: 'm-{{ACS::ExecutionId}}' instanceId: '{{ instanceId }}' Outputs: imageId: ValueSelector: imageId Type: String - Name: modifyScalingConfiguration Action: 'ACS::ExecuteAPI' Description: en: Modify scaling configuration. zh-cn: 修改伸缩配置。 Properties: Service: ESS API: ModifyScalingConfiguration Parameters: ScalingConfigurationId: '{{ scalingConfigurationId }}' ImageId: '{{ createImage.imageId }}' - Name: getInstance Description: en: Views the ECS instances. zh-cn: 获取ECS实例。 Action: 'ACS::ExecuteApi' Properties: Service: ECS API: DescribeInstances Parameters: Status: Running Tags: - Key: 'acs:autoscaling:scalingGroupId' Value: '{{ scalingGroupId }}' Outputs: instanceIds: Type: List ValueSelector: 'Instances.Instance[].InstanceId' - Name: replaceSystemDisk Description: en: replaces system disk. zh-cn: 更换系统盘。 Action: 'ACS::ECS::ReplaceSystemDisk' Properties: instanceId: '{{ ACS::TaskLoopItem }}' imageId: '{{ createImage.imageId }}' Loop: RateControl: '{{ rateControl }}' Items: '{{ getInstance.instanceIds }}' Outputs: imageId: Type: String Value: '{{ createImage.imageId }}' 输入模板名称,点击创建模板。在自定义模板页面找到刚创建的模板,点击创建执行。选择自动执行,点击下一步:设置参数。参数设置页面需要输入以下参数:确认参数无误后点击创建执行。在执行详情页面可以看到模板执行的详细过程。执行成功后,伸缩配置镜像已更换为新创建的镜像。伸缩组中实例的镜像已更换为新创建的镜像。 欢迎使用OOS OOS客户支持钉钉群:23330931OOS管理控制台的链接OOS帮助文档的链接 系列文章 主题文章 阿里云重磅发布云上自动化利器——运维编排OOS 最佳实践 玩转运维编排服务的权限:Assume Role+Pass Role阿里云运维编排新功能:一键批量克隆ECS 场景系列 运维编排场景系列----更新ECS镜像运维编排场景系列----运行远端shell脚本运维编排场景系列----给ECS实例自动打TAG运维编排场景系列----从实例中拷贝文件到OSS运维编排场景系列----给实例加到SLS机器组运维编排场景系列----检测MFA功能状态运维编排场景系列----每日统计多Region实例的运行状态运维编排场景系列----如何使用jq运维编排场景系列----分批到机器上运行命令运维编排场景系列----更新镜像后自动更新伸缩配置镜像运维编排场景系列----向Linux实例上传文件运维编排场景系列----在ECS实例上运行Ansible-playbook运维编排场景系列----下载JVM堆栈到OSS运维编排系列场景----将实例的固定公网IP转换为其它新EIP运维编排场景系列----自动定时升级临时带宽运维编排场景系列----ECS实例系统快照下载到本地运维编排场景系列----批量开启存储空间访问日志运维编排系列场景----快速生成模版shell命令运维编排系列场景----批量释放实例

优秀的个人博客,低调大师

一体化实时HTAP数据库StoneDB,如何替换MySQL并实现近百倍分析性能的提升

众所周知,MySQL 是世界上最流行的 OLTP 数据库之一,截至2022年它在整个数据库行业的市场占有率达到了43.04%(数据来源:Slintel网站)。许多企业将各种业务系统应用于 MySQL 上。然而,随着企业数据量的不断增加,除了在线业务逻辑的读写,数据库还要面对日益复杂的分析性业务需求,比如BI报表、可视化、大数据应用等。而 MySQL 原生的架构(基于流式迭代器模型 Volcano Iterator 的执行引擎,没有利用现代多核 CPU 并行处理能力,按行存储的存储引擎)在 AP 场景中存在天然的缺陷。针对这种情况,为了补足 MySQL 的 AP 能力缺陷,业内围绕 MySQL 做了很多解决方案。主要是围绕 MySQL 搭建的异构 HTAP 数据库系统。什么是 HTAP ?在2014年,Gartner 给出了 HTAP 的严格定义:其目的是为了打破,事务型负载和分析型负载之间的“壁垒”, 使系统能够支持更多的“数据”在两个系统之间流动,以及以这些数据为基础的 “实时业务”的决策。传统架构形式下,为了解决同时处理 TP 负载和 AP 负载的问题,通常采用一套 TP 系统加上一套 AP 系统的方式,TP 和 AP 之间通过 ETL 的方式进行数据同步的来满足业务对实时性的需求,这也是当前业界搭建 HTAP 的主流方案。 业内围绕 MySQL 搭建 HTAP 主流方案 我们先来看看业界主流的基于 MySQL 的 HTAP 解决方案。 1. MySQL + Hadoop 借助 Hadoop 体系,将MySQL的业务数据,通过 ETL 工具同步至开源大数据系统(如 Hive,Hadoop,Spark 等)搭建的数据仓库,再基于该数仓做数据分析。 2. MySQL + 数据湖 借助数据湖平台,通过 ETL 工具将 MySQL 数据同步至数据湖,再基于数据湖进行数据、报表、BI 等分析。 3. MySQL + ClickHouse/Greenplum 通过ETL等数据迁移工具将 MySQL 数据迁移到 ClickHouse/Greenplum 做分析。ClickHouse 官方在 20 年下半年发布了社区版 MaterializeMySQL 引擎 ,可以将 ClickHouse 作为 MySQL 的一个从库同步主节点数据,除了 ETL 工具,业内也有直接将 ClickHouse 作为一个 MySQL 从库直接挂载的方案。 4. 基于多副本的 Divergent Design 比如兼容 MySQL 协议的 TiDB,在一个 Raft Group 其中一个副本上,通过自研列式存储 (TiFlash) 来响应复杂 AP 查询,并通过 TiDB 的智能路由功能来自动选取数据源,实现一套分布式 HTAP 数据库系统,在分布式领域这块做的是比较好的。 图片来自 TiDB 官网 以上方案存在的问题 以上几种 HTAP 解决方案,虽然是行业内的主流,但依然存在着一些问题,包括: 系统架构过重,运维复杂度较高; TP 数据通过 ETL 方式同步到 AP 系统中,数据延时较大,难以满足服务对分析的实时性要求; 异构数据库组合,技术上需要维护两套数据库系统,涉及到众多技术栈,对技术人员要求较高; NewSQL 系统,需要进行各种兼容性适配,适配工作会比较复杂,对技术人员要求也比较高。 为此,我们带来了在 HTAP 方面的解决方案:StoneDB,一款开源的一体化实时 HTAP 数据库。 StoneDB:完全兼容 MySQL 生态的一体化行列混合存储 HTAP 数据库 StoneDB 是一款刚刚开源的基于原生 MySQL 的一体化实时 HTAP 数据库,用国内首创的一体化行列混存架构,以极低成本实现高性能的实时HTAP。StoneDB 采用一体化的行列混合存储,跟分布式多副本 Divergent Design 做法不同,是在同一个数据库实例中采用行列混合存储的方案,高度集成,运维复杂度较低,用户使用体验更好。这套架构的设计初衷是用一套数据库,同时解决 TP 和 AP 的问题,更轻量,更优雅,更便捷。目前国外厂商如 Oracle / SQL Server / DB2 等都采用了类似的方案,但是它们都不开源。 StoneDB 一体化架构图概览(v1.0) StoneDB 以插件的方式接入 MySQL,通过查询/写入接口和 MySQL server 层进行交互, 当前一体化架构主要特性有: 按列式存储方式组织数据,并结合高效压缩算法,使得 StoneDB 在获得高性能的同时也具有存储成本优势。 基于知识网格(Knowledge Grid)的近似查询及并行处理等机制,使得 StoneDB 在处理海量数据以及复杂查询时候,能够最大限度的减少无关数据的 IO。 利用直方图,数据块位图等众多统计信息来进一步加速查询处理的速度。 采用带有延后重构模型的 Column-at-a-time 的面向列式存储的执行引擎,又进一步提高执行引擎的效率。 提供高速的数据载入能力。 接下来我们看一下 StoneDB 的架构设计: 架构设计:数据组织形式 在 StoneDB 中,数据按列进行组织。这种数据组织形式,对各类压缩算法友好,可依据各列类型、数据等因素选择合适的高效压缩算法,以达到节约 IO 和 Memory 资源的目的。另外还具备以下优点 : Cache Line 友好。 查询过程中,针对各列的运算并发执行,最后在内存中聚合完整记录集。 即席查询时,只需扫描特定列即可,无需消耗 IO 资源去读取其他列的值。 无需维护索引,支持任意列组合的即席查询。 可以提供基于知识网格能力, 提升数据查找效率。 架构设计:基于列的数据压缩 正如上面所提到的,数据按列进行组织,列中所有记录的类型一致,可以根据数据类型选择对应的高效压缩算法,因为: 列中重复值出现概率高,压缩效果明显。 数据节点大小固定,可以最大化压缩性能和效率。 根据特定的数值类型压缩(int,float,date/time,string 等)。 StoneDB 可以支持多达20+种自适应压缩算法,目前主要使用: PPM LZ4 B2 Delta等等 架构设计:数据组织结构与知识网格 StoneDB 的查询处理部分如上图所示。查询处理作为整个数据库的大脑,查询优化算法好坏,直接影响查询效率。我们再来讨论一下数据组织结构和知识网格。之前在介绍架构的时候,我们也提到数据的按列组织,而且在每个列中,数据又按更细粒度的数据块进行划分。该种方式所带来的优点有: 物理数据按固定数据块,进行存储,通常称之为:Data Node,通常为:128KB,系统方便进行 IO 效率的优化。同时,也可为系统提供基于块(Block)的高效压缩/加密算法。 知识网格可以为查询优化器,执行和压缩算法等提供支持。例如:基于知识网格的查询,优化器会利用知识网格来决定需要抓取哪些 Data Node 来执行数据操作。 我们解释一下相关概念,以下数据节点、元数据节点皆为逻辑概念: 数据节点(Data Node,DN):数据块大小固定(典型值128KB),优化 IO 效率,提供基于块(Block)的高效压缩/加密算法。 知识网格(Knowledge Grid,KG):用于元数据存储。 元数据节点(Metadata Node,MDN):描述数据节点的元数据信息。由知识节点(Knowledge Node,KN)组成,为查询优化器,计划执行和压缩算法等提供支持。 架构设计-查询:知识网格( Knowlegde Grid )概览 架构设计-查询:基于 Knowlegde Grid 的优化器 如上图所示:首先由查询优化器进行基于知识网格的优化,对其所需要处理的数据进行剪枝,其采取的策略为:对于满足查询条件的数据节点,即关联性数据节点,对其采取直接读取并返回的策略;对不确定性数据节点,先进行解压,然后在进行基于查询条件的处理,最后返回处理结果;而对与查询条件完全不相关的数据节点,则直接忽略。 然后再基于知识网格中的信息进行粗糙集(Rough Set)构建,并确定此次请求所需使用到的数据节点。基于 KN 和 MD ,确定查询涉及到的 DN 节点集合,并将 DN 节点分类。执行计划构建时,会完全规避非关联 DN,仅读取并解压关联 DN,按照特定情况决定是否读取不确定的 DN。如果查询请求的结果可以直接从元数据节点(MDN)中产生(例如 count,max,min 等操作),则直接返回元数据节点中的数据,无需访问物理数据文件。 架构设计-查询:处理流程 例如对于一个查询请求,通过 KG(知识网格)可以确定3个关联性 DN 和1个不确定性 DN。如果,此请求包含聚合函数。此时只需要解压不确定性 DN,并计算聚合值,再结合3个关联性 DN 中 MDN 上的统计值即可得出最终结果。如果,此请求需要返回具体数据,那么无论关联性 DN 还是不确定性 DN,都需要读取数据块并进行并行解压缩,以便获得最终结果集。 比如,执行一条select * from xx where seller = 86,内部执行流程如下: 执行计划优化与执行: 基于知识网格进行 Cost-based 优化 IO 线程池维护 内存分配与管理 SMP 支持(并发查询) 向量化执行 完全兼容 MySQL 生态的 StoneDB 一体化 HTAP 系统的优势 完全兼容 MySQL 的 StoneDB 一体化 HTAP 数据库。其具有以下几个特点 : 完全兼容 MySQL。无论是语法还是生态 MySQL 用户均可以无缝切换至 StoneDB。 事务、分析一体化。无需ETL,事务型数据实时同步到分析引擎。使得用户可以获取实时业务分析结果。 完全开源。 相较于 MySQL 提供10-100倍的 AP 能力。亿级多表关联急速响应,决策结果无需等待。 10倍导入速度。由于AP场景下,分析数据量巨大,高效导入速度,能给带来良好的用户体验。 1/10的 TCO 成本,StoneDB 拥有高效的压缩算法,无缝的业务迁移能力,还有它的简单架构,都能为用户带来 TCO 的降低。 StoneDB 2.0 将带来全新架构 上文介绍的是 StoneDB 单机版本的 1.0 架构。虽然 StoneDB 基于磁盘的列存引擎在AP场景下的表现已经非常出色,但是毕竟其是基于磁盘的解决方案。我们知道,IO和内存在数据库领域又属于极度宝贵的资源,以为进一步提升 StoneDB 的性能,同时也为了减少 AP 负载在执行时候对于 TP 负载的影响。未来我们将在 2.0 版本中将推出了类似于 HEATWAVE 的基于内存计算的列存引擎的全新架构。该版本将基于 MySQL 8.0 构建,基于此引擎我们将实现 AP 负载的全内存计算。有关于 2.0 更多的信息欢迎关注 StoneDB 的官方网站:https://stonedb.io同时,StoneDB 在6月29日已宣布正式开源。如果您感兴趣,可以通过下方链接查看 StoneDB 源码、阅读文档,期待你的贡献! StoneDB 开源仓库 https://github.com/stoneatom/stonedb 作者: 李浩 StoneDB PMC、StoneDB 首席架构师 曾在华为、爱奇艺、北大方正从事数据库内核核心架构设计。超过10年数据库内核开发经验,擅长查询引擎,执行引擎,大规模并行处理等技术。拥有数十项数据库发明专利,著有《PostgreSQL查询引擎源码技术探析》。现担任 StoneDB 的首席架构师及 StoneDB 项目 PMC。 高日耀 StoneDB PMC、HTAP 内核架构师 毕业于华中科技大学,喜欢研究主流数据库架构和源码。8年的数据库内核开发经验,曾从事分布式数据库CirroData 、RadonDB 和 TDengine 的内核研发工作,现担任 StoneDB 的内核架构师及 StoneDB 项目 PMC。

优秀的个人博客,低调大师

OurBMC大咖说丨第6期:中国长城基于飞腾腾珑E2000的国产化BMC固件产品开发实践

栏目介绍:"OurBMC大咖说" 是由 OurBMC 社区精心策划的线上讲座栏目,邀请 BMC 相关领域大咖共同探讨 BMC 全栈技术的发展趋势、挑战和机遇。无论你是初学者还是资深从业者,"OurBMC大咖说" 都将为你提供一个宝贵的学习和交流的平台。 欢迎各位关注 "OurBMC大咖说",聆听大咖们的智慧之声,共同推动 BMC 全栈技术的进步和发展! 本期人物介绍:方小明,中国长城科技集团股份有限公司首席BMC架构师。毕业于西安理工大学,高级工程师,从事BMC固件开发15年,参加国家自然发展基金等多项重点工程项目开发,参与多项BMC固件行业和团体标准制定。 国产 BMC 开源社区发展 BMC(Baseboard Management Controller)系统是服务器不可或缺的带外管理工具,负责服务器的远程运维、管理和监控,被誉为服务器运作的中枢神经。BMC 系统主要由两部分组成:BMC 芯片和 BMC 固件。BMC 芯片提供计算能力,支持 BMC 固件的运行,而 BMC 固件则是实现各种带外管理功能的核心控制程序。 长期以来,BMC 系统的核心软硬件技术集中在少数几家厂商手中。以 Aspeed 公司的 AST 2400、2500、2600 系列 BMC 芯片(来自台湾的信骅科技股份有限公司)和 AMI 公司的 MegaRack 系列 BMC 固件(来自美国的安迈公司)为代表的解决方案,在全球 BMC 市场中占据了主导地位。 随着我国信息技术应用创新产业的快速发展,这一局面发生了改变。自 2009年起,中国长城科技集团股份有限公司在OpenBMC的基础上开发了 GBMC 固件,成功突破了国产 BMC 固件的核心技术瓶颈,并不断升级迭代。目前,这款固件已被广泛应用,累计装机量达数万台。到 2022 年,飞腾公司推出了飞腾腾珑 E2000S/D/Q 系列芯片,与 AST 系列最新产品相媲美,有力满足了日益增长的 BMC 系统需求,标志着国产 BMC 系统取得了显著技术进步。 2023 年,飞腾公司牵头建立了开源 BMC 根社区—— OurBMC社区,旨在携手各方伙伴共同推进 BMC 技术快速发展,辐射上下游形成产业共振,加速构建繁荣的信息系统软硬件生态。借助国产 BMC 芯片和开源 BMC 固件,相关企业和技术爱好者可以更便捷地构建具备基础功能的 BMC 系统,并在此基础上进行深度技术验证和二次开发。OurBMC社区的诞生,无疑为国产 BMC 技术和产业发展注入了新的活力,带来了广阔的发展空间和前所未有的机遇。 开源 BMC 社区面临的挑战 相较于封闭式的商业 BMC 方案,开源 BMC 因其开放性和广泛的参与度,发展速度更显迅猛,现已成为 BMC 技术演进的核心趋势之一。然而,将开源 BMC 直接转化为大规模市场化应用产品,则需直面技术成熟度不足、产品质量难以保证以及服务体系构建难度大等一系列严峻挑战。 复杂性:BMC 的技术复杂性是开源 BMC 项目面临的首要挑战。BMC 需要处理多种功能,包括电源管理、硬件监控、远程控制、日志记录等。这些功能要求 BMC 具备高性能和高可靠性,并且需要处理各种硬件接口和协议,如 I2C、IPMI、Redfish 等。开发和维护这样复杂的系统需要深厚的技术积累和丰富的经验,这对于开源社区来说是一个巨大的挑战。 安全性:安全性是开源 BMC 面临的另一个重大挑战。作为服务器管理的核心组件,BMC 的安全性至关重要。一旦 BMC 被攻击者控制,可能导致整个服务器乃至整个数据中心的瘫痪。因此,BMC 需要具备强大的安全防护措施,如身份认证、加密通信、漏洞防护等。 开源 BMC 的代码是公开的,虽然这有助于透明性和审计,但也意味着攻击者可以更容易地研究和发现潜在的漏洞。开源社区需要投入大量资源进行安全审计、漏洞修复和安全更新,以确保 BMC 的安全性。此外,社区还需要建立安全响应机制,及时应对和修复安全漏洞。 标准化与合规性:BMC 需要符合各种行业标准和认证要求,如 IPMI、Redfish、FCC、CE 等。开源 BMC 项目需要确保其实现的功能和性能符合这些标准,并通过相关的认证测试。这些标准和认证过程通常复杂且昂贵,对于开源项目来说是一个不小的负担。 此外,不同的服务器厂商可能有不同的需求和定制要求,开源 BMC 项目需要在标准化和定制化之间找到平衡点,既要满足通用需求,又要能够灵活适应不同的硬件平台和使用场景。 社区和生态系统建设:尽管开源 BMC 具有透明性高和成本低效益好等优点,但市场接受度仍然是一个考验。企业用户在选择 BMC 解决方案时,通常更加信赖成熟的商业产品,尤其是在涉及到关键业务和数据中心管理时。开源 BMC 需要通过不断的技术创新和可靠性验证,逐步赢得市场的信任和认可。 综上所述,开源项目的成功离不开活跃的社区和生态系统。然而,建立和维护一个健康的开源社区并不容易。开源 BMC 项目需要吸引足够的开发者、测试人员、文档撰写者和用户参与,共同推动项目的发展。 中国长城 GBMC 的技术路线 中国长城作为参与构建开源 BMC 社区的贡献者,技术路线采用自主研发的 GBMC 源代码作为基础,该源代码是在 OpenBMC 社区代码的基础上深度开发而成。 针对飞腾腾珑 E2000 芯片与 AST 系列芯片之间的内在差异,深度重构设备底层接口,归一化设备访问操作,屏蔽物理层的差异点,上层代码实现跨芯片级的复用。 上层应用聚焦深化功能开发与全面提升产品化水准,持续迭代,满足广泛而详尽的 BMC 功能诉求及各行业定制化需求。正是长城长期的市场开拓以及应用实践,指引 BMC 功能开发和技术路线的发展,打造出符合市场需求、具有竞争力的高质量 BMC 固件产品。 飞腾腾珑 E2000S BMC 产品应用 基于飞腾腾珑 E2000S 芯片研发的BMC 芯片硬件模块已成功搭载长城自研服务器产品,支持了多款长城自研的飞腾腾云 S5000C 系列产品行业应用。中国长城作为 OurBMC 社区理事单位,积极参与 OurBMC 社区构建,为国产 BMC 的发展贡献出自己的一份力量。 图:长城擎天RF6260 V5搭载S5000C处理器 + E2000S/AST2600 GBMC固件 祝愿 OurBMC 社区的发展越来越好!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册