首页 文章 精选 留言 我的

精选列表

搜索[ci/cd],共10000篇文章
优秀的个人博客,低调大师

Fedora 15 live CD 安装 VMware 7.1.4 提示 需要Kernel Headers 简单解决方法

安装VM 7.1.4后,在打开时出现提示VMware找不到相应系统内核Kelnel Headers,提示说是目录2.6.38.8-32.*。所示要安装kernel-devel,如下图。 于是安装。 shenzhi@shenzhi ~]$ su - 密码: [root@shenzhi ~]# yum install kernel-devel 已加载插件:langpacks, presto, refresh-packagekit updates/metalink | 6.7 kB 00:01 updates | 4.7 kB 00:00 updates/primary_db | 3.5 MB 00:04 设置安装进程 解决依赖关系 --> 执行事务检查 ---> Package kernel-devel.i686 0:2.6.40.4-5.fc15 will be 安装 --> 完成依赖关系计算 依赖关系解决 =============================================================================== 软件包 架构 版本 仓库 大小 =============================================================================== 正在安装: kernel-devel i686 2.6.40.4-5.fc15 updates 7.0 M 事务概要 =============================================================================== Install 1 Package(s) 总下载量:7.0 M Installed size: 25 M 确定吗?[y/N]: 安装过程中的问题 kernel-devel.i686 0:2.6.40.4-5.fc15并不是我们要找的2.6.38.8-32版本不同。本人认为,版本一定是匹配,以免后面安装失败。 关于安装低版本软件包的安装问题 Fedora是通过Yum来在线安装软件的,Yum的仓库决定了软件的数量与版本。这里只需去掉含有Update的库就可以了。我使用的是程序“Yum Extender”(开始--系统工具)。点击程序左侧第三个图标,将库名为fedora之外的所有库均去掉。再点击左侧第一个图标,搜索“kernel-devel”就可以看到,版本为“2.6.38.6-26.fc15” 再次打开“VMware Workstation”会弹出下图,单击Install,OK!会提示输入root用户的密码。 输入密码后,会出现下图所示的对话框,等待结束。 然后出现下图: VM序列号的问题,网上有的。不过还是给大家一个吧!不要说是我说的哦,呵呵! GY51K-2MED5-M84MQ-5EPG9-NLUUD 本文转自tiancong 51CTO博客,原文链接:http://blog.51cto.com/tiancong/660258
优秀的个人博客,低调大师

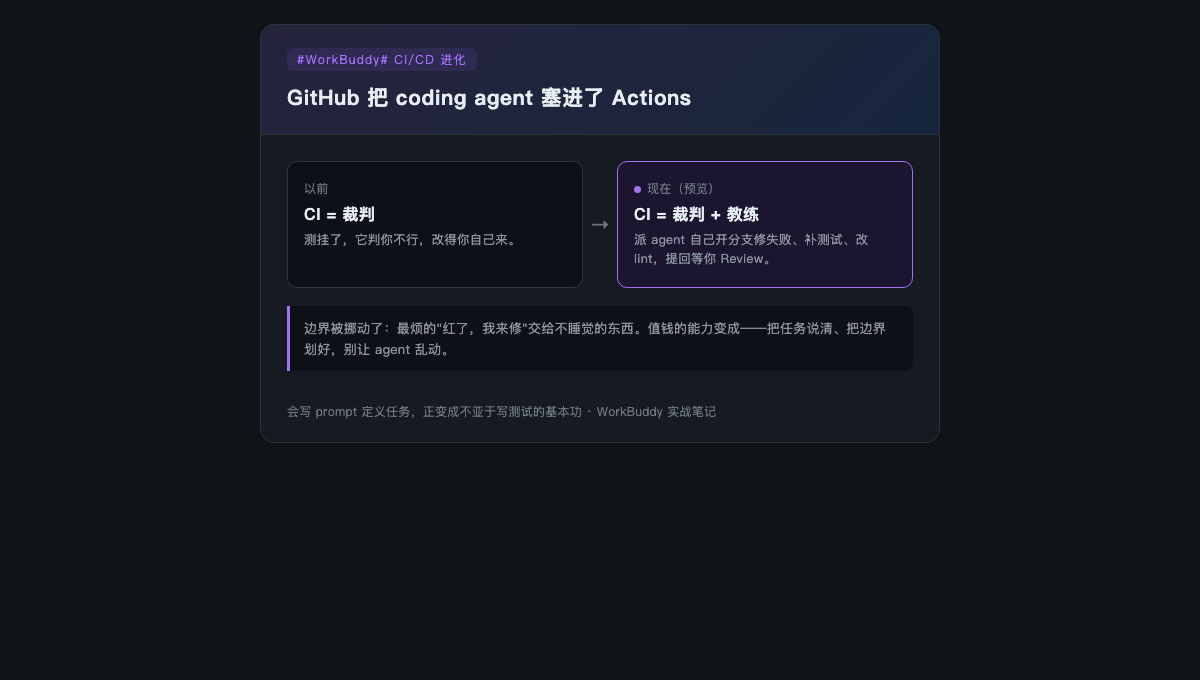
决策行 / 缺陷清单 / 复现附录:CI 时代的质量报告,为什么必须分层写

评审会上把质量报告投出来。总监三秒划到最后一行:『所以能不能上?』开发盯着自己模块那三条红,其余一眼不看。测试同行从头核对附录里的分母和区间,眉头越皱越紧。三类人读的是同一份文档,问的却是三个完全不同的问题——而你只准备了一份答案。 这份报告大概率会收获一串『收到』。低回应率不是因为你数据不全,恰恰相反,是因为你把一份报告当成了面向所有人的通用件。 ## 为什么你的报告只换来一堆『收到』 一份为所有读者写的文档,最后是每个读者都拿不到自己要的那样东西。拍板的人懒得从数据里自己总结结论,于是划到末尾反问『所以呢』;开发不愿替你把缺陷从统计图表里刨出来,于是只有自己的红才被他看见;同行想复核,可口径藏在第八页,他不一定有耐心翻。三种阅读姿势,一份文档谁都喂不饱,最后谁都只是『已阅』,没人对内容负责。 把报告当成通用件,本质上是在赌『总有人会认真从头读到尾』。这个赌局几乎从不赢。真正省事的写法,是反过来承认读者的分工,按他们要回答的问题,把同一件事分层讲。 更微妙的是责任的错位:决策人找不到判断,会觉得『报告没写清楚』;开发找不到红,会觉得『报告太啰嗦』;审计发现口径缺,会怀疑『数据是不是可信』。同一份『没写好』,三方归因归到三个不同的人身上——这才是通用件式报告的隐性代价:你的完整性,被三种完全不同的标准各打了一遍,没有一种会轻饶你。 ## 三种读者,各自要回答的那一句 先给三种人对号入座。他们打开报告时脑子里那一句问题,决定了你要在第一眼给他什么。 | 读者 | 打开报告要回答的那一句 | 该放在哪一层 | 放错层的症状 | |---|---|---|---| | 管理层 / 总监 | 到底能不能上?谁签的字? | 首屏决策行:一句话结论 + 放行/有条件/拦截 + 最大风险 | 让他翻到附录自己找结论——三秒划到最后只剩一句『所以呢』 | | 研发 | 我这块哪几条红了?下一步干什么? | 折叠的缺陷清单:每条红带模块归属 + 复现脚注 + 建议动作 | 把缺陷埋在统计后面——没人认领,红用例过夜 | | 测试同行 / 审计 | 分母多少?区间多大?怎么重跑? | 附录:口径、样本量、运行方式 | 把口径塞进首屏——决策行被数字噪声淹没,总监更看不懂 | 顺序不能反。管理层要的是压缩后的判断,研发要的是展开后的动作,审计要的是可核的底稿。把审计要的口径放上首屏,等于让拍板的人替你读文献综述;把管理层的判断塞进附录,等于把结论藏起来让人自己刨。分层的功夫,全在『谁先看什么』这一件事上。 ## 同一套数字,不同详略,绝不各层各报各的数 分层最容易滑进去的坑,是从『分层叙事』悄悄退化成『各层各写一份』——首页说一套,附录说一套,两个数还不一样。这条线一旦越过,分层叙事立刻反噬成最大的信任事故。 原则只有一条:同一套数字,不同的详略,绝不各层各报各的数。首屏决策行写『通过率 91%』,附录里那个 91% 必须是同一个 91%、同一个分母、同一个口径——区别只在于附录多交代了区间多大、跑了多少样本,而首屏把它们压成了一句话。这里说的 91% 只是举例,真正要紧的是三层的数出同一个源。一旦有人发现首屏和附录对不上,被推翻的不是那个差异数字,是整份报告的可信度——而一份数字自相矛盾的质量报告,比不写还糟。 保持层间一致有个可操作的做法:首屏和缺陷清单这两层,只放『结论和判断』,把所有数字都收在附录这唯一的一处,上面两层是它的摘录和链接,而不是各自抄一份。这样改数时只需改附录一处,三层不会因为漏改而打架。如果实在不得不在多处写出同一个百分比,中间要隔一道『数字字典』:所有百分比一次算好、统一定义,全文引用,不靠手抄。 ## 每一层,都留一条回到原始数据的路,和一个能问的人 分层不等于把话说死、把出处藏起来。有三条纪律贯穿始终。 结论先行,但证据链接到位。首屏敢给一句话判断,是因为这句话底下挂着能点开的原始数据——通过率点哪都能跳到那份带区间的明细,红用例点哪都能跳到它的复现脚注。压缩的是详略,不是可追溯性。 给每一层都留一行『不知道就问谁』。管理层那行写清拍板人和签字,研发那行写清每条红的负责人和到期日,审计那行写清这份数据是谁跑的、怎么重跑。分层之后读者更不需要通读全文,但更需要知道『卡住了找谁』——这行字,是三层之间那根缝合线。 不各层各报各的数,前面说透了,这里只补一句落地:数字的单一来源,最好是脚本一次算好、三层引用,而不是有人手抄三遍。 ## 一个模板骨架:一屏决策块 + 折叠缺陷清单 + 附录口径与复现 把上面这些压成一个能直接套的骨架。 第一屏是决策块:一句话结论,一个放行/有条件放行/拦截的三态判断,最大那条风险,加签名和到期日。它回答总监那一问,长度控制在一屏内。 中间是折叠的缺陷清单:默认收起,不抢决策行的注意力;展开后每条红用例带模块归属、复现脚注、建议下一步、负责人。它服务开发,让人一眼认领、当场动手。 最后是附录:分母是什么、区间多大、跑了多少样本、怎么重跑,一条不落。它收留测试同行和审计,是整份报告可被信任的地基,但不该挡在前两个人面前。 一屏判断、一叠动作、一份底稿——同一套数据,三种详略。读者各取所需,数字却只有一个。 ## 锚回你早就会的那件事 这其实不是新东西。写新闻讲倒金字塔,写文档讲『按需展开』,做产品讲『首屏即价值』——都是同一个道理:先给最该被看见的,其余按需下钻。质量报告只是把这条老规矩用在了满是数字的地方,于是多出一个别的文体没有的坑:你分给三层的,必须是同一套能对上账的数。老方法负责『谁先看什么』,数字一致性负责『谁都不会被绕进去』,两样缺一不可。 最后补一个报告之外的观察:分层这件事,不是为了让你准备三份文档——正相反,它只有一份。分层叙事的本事,是让三种角色从不同入口进、踩在同一块地上。把一份报告拆成三份发给三个人,是它的反面:那不叫分层,那叫各说各话。 回到那场评审会。下次报告投出来,别再指望三类人读同一页还各得其所。总监那一屏,给他判断和签字;开发点开的清单,给他红和下一步;同行翻到附录,给他分母和重跑方式。一份报告喂不饱三种读者,那就给他们一份分层长好的报告。 **质量报告不是写给『留档』的,是写给『每个读者都能三秒拿到他要的那一样』的——分层叙事不是花活,是让同一套诚实的数字,够得着三种完全不同的人。**

优秀的个人博客,低调大师

5D高速光存储展示,CD大小玻璃盘片可记录500TB数据

英国南安普顿大学的一支科学家团队,刚刚展示了他们最新研发的5D高速节能激光写入技术。其特点是能够在石英玻璃中产生纳米机构,并借此在一块1英寸的石英玻璃样品中尝试记录了6GB的数据。 好消息是,这项快速节能的激光写入技术,可以让石英玻璃形成高密度的纳米结构。更棒的是,这些可长期维持的5D光学数据的存储密度,是当前蓝光光盘方案的10000倍以上。 研究团队指出,基于玻璃载体的5D数据存储,有望在国家档案馆、博物馆、图书馆、或私营机构的长期数据存储等领域发挥最大的效力。 在近日出版的《光学》(Optica)期刊中,研究团队描述了这项“编写”数据的新方法,可知其具有两个光学维度/三个空间维度。 信息写入速度方面,这套方案可达成每秒百万次(体素单位:Voxels),相当于每秒记录大约230KB的数据(超过100页的文本)。 Yu Hao Lei表示,其采用了通用的物理机制,因而预计这种节能的写入方法还可用于透明材料的快速纳米结构化,以应用于3D集成光学和微流体等领域。 尽管此前已经有人证明过基于透明材料的5D光学数据存储,但在数据写入速度和信息存储密度上,大家一直在努力克服这方面的艰难挑战。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册