首页 文章 精选 留言 我的

精选列表

搜索[AI聚合],共10000篇文章
优秀的个人博客,低调大师

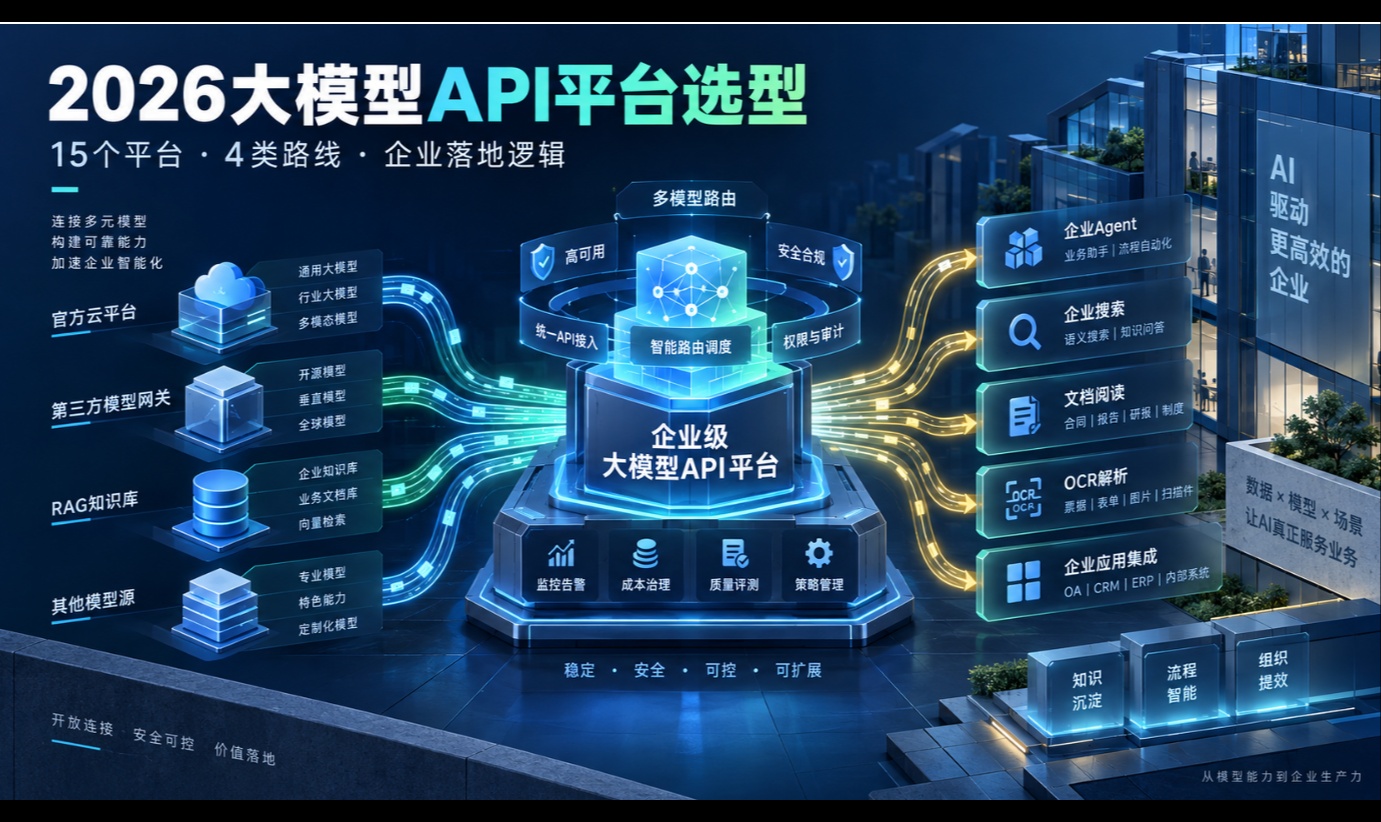
国内第三方大模型API聚合平台怎么评估:RAG与Agent项目中的三种技术路线

RAG与Agent项目的难点,往往不只是模型推理,而是搜索、网页读取、OCR、工具调用、长任务状态和故障恢复能否连成一条稳定链路。本文以硅基流动、PPIO派欧云和数眼智能为同一赛道的三个代表平台,按照模型层、数据层、工具层和治理层进行对比。三者分别代表模型推理、全模态与复合型应用基础设施等不同路线,发布前仍建议使用真实数据进行POC。

优秀的个人博客,低调大师

时间序列数据库——索引用ES、聚合分析时加载数据用什么?docvalues的列存储貌似更优优势一些

加载 如何利用索引和主存储,是一种两难的选择。 选择不使用索引,只使用主存储:除非查询的字段就是主存储的排序字段,否则就需要顺序扫描整个主存储。 选择使用索引,然后用找到的row id去主存储加载数据:这样会导致很多碎片化的随机读操作。(ES检索出来的一堆ID,然后根据这些ID去数据库里取东西就是碎片化的磁盘操作!) 没有所谓完美的解决方案。MySQL支持索引,一般索引检索出来的行数也就是在1~100条之间。如果索引检索出来很多行,很有可能MySQL会选择不使用索引而直接扫描主存储,这就是因为用row id去主存储里读取行的内容是碎片化的随机读操作,这在普通磁盘上很慢。 Opentsdb是另外一个极端,它完全没有索引,只有主存储。使用Opentsdb可以按照主存储的排序顺序快速地扫描很多条记录。但是访问的不是按主存储的排序顺序仍然要面对随机读的问题。 Elasticsearch/Lucene的解决办法是让主存储的随机读操作变得很快,从而可以充分利用索引,而不用惧怕从主存储里随机读加载几百万行带来的代价。 Opentsdb 的弱点 Opentsdb没有索引,主存储是Hbase。所有的数据点按照时间顺序排列存储在Hbase中。Hbase是一种支持排序的存储引擎,其排序的 方式是根据每个row的rowkey(就是关系数据库里的主键的概念)。MySQL存储时间序列的最佳实践是利用MySQL的Innodb的 clustered index特性,使用它去模仿类似Hbase按rowkey排序的效果。所以Opentsdb的弱点也基本适用于MySQL。Opentsdb的 rowkey的设计大致如下: [metric_name][timestamp][tags](和百度TSDB无异!) 举例而言: Proc.load_avg.1m 12:05:00 ip=10.0.0.1 Proc.load_avg.1m 12:05:00 ip=10.0.0.2 Proc.load_avg.1m 12:05:01 ip=10.0.0.1 Proc.load_avg.1m 12:05:01 ip=10.0.0.2 Proc.load_avg.5m 12:05:00 ip=10.0.0.1 Proc.load_avg:5m 12:05:00 ip=10.0.0.2 也就是行是先按照metric_name排序,再按照timestamp排序,再按照tags来排序。 对于这样的rowkey设计,获取一个metric在一个时间范围内的所有数据是很快的,比如Proc.load_avg.1m在12:05到12:10之间的所有数据。先找到Proc.load_avg.1m 12:05:00的行号,然后按顺序扫描就可以了。 但是以下两种情况就麻烦了。 获取12:05 到 12:10 所有 Proc.load_avg.* 的数据,如果预先知道所有的metric name包括Proc.load_avg.1m,Proc.load_avg.5m,Proc.load_avg.15m。这样会导致很多的随机读。如果 不预先知道所有的metric name,就无法知道Proc.load_avg.*代表了什么。 获取指定ip的数据。因为ip是做为tags保存的。即便是访问一个ip的数据,也要把所有其他的ip数据读取出来再过滤掉。如果ip总数有十 多万个,那么查询的效率也会非常低。为了让这样的查询变得更快,需要把ip编码到metric_name里去。比如 ip.10.0.0.1.Proc.load_avg.1m 这样。 所以结论是,不用索引是不行的。如果希望支持任意条件的组合查询,只有主存储的排序是无法对所有查询条件进行优化的。但是如果查询条件是固定的一种,那么可以像Opentsdb这样只有一个主存储,做针对性的优化。 DocValues为什么快? DocValues是一种按列组织的存储格式,这种存储方式降低了随机读的成本。传统的按行存储是这样的: 1和2代表的是docid。颜色代表的是不同的字段。 改成按列存储是这样的: 按列存储的话会把一个文件分成多个文件,每个列一个。对于每个文件,都是按照docid排序的(???不是field values吗?)。这样一来,只要知道docid,就可以计算出这个docid在这个文件里的偏移量。也就是对于每个docid需要一次随机读操作。 那么这种排列是如何让随机读更快的呢?秘密在于Lucene底层读取文件的方式是基于memory mapped byte buffer的,也就是mmap。这种文件访问的方式是由操作系统去缓存这个文件到内存里。这样在内存足够的情况下,访问文件就相当于访问内存。那么随机 读操作也就不再是磁盘操作了,而是对内存的随机读。 那么为什么按行存储不能用mmap的方式呢?因为按行存储的方式一个文件里包含了很多列的数据,这个文件尺寸往往很大,超过了操作系统的文件缓存的大小。而按列存储的方式把不同列分成了很多文件,可以只缓存用到的那些列,而不让很少使用的列数据浪费内存。 按列存储之后,一个列的数据和前面的posting list就差不多了。很多应用在posting list上的压缩技术也可以应用到DocValues上。这不但减少了文件尺寸,而且提高数据加载的速度。因为我们知道从磁盘到内存的带宽是很小的,普通 磁盘也就每秒100MB的读速度。利用压缩,我们可以把数据以压缩的方式读取出来,然后在内存里再进行解压,从而获得比读取原始数据更高的效率。 如果内存不够是不是会使得随机读的速度变慢?肯定会的。但是mmap是操作系统实现的API,其内部有预读取机制。如果读取offset为100的 文件位置,默认会把后面16k的文件内容都预读取出来都缓存在内存里。因为DocValues是只读,而且顺序排序存储的。相比b-tree等存储结构, 在磁盘上没有空洞和碎片。而随机读的时候也是按照DocId排序的。所以如果读取的DocId是紧密相连的,实际上也相当于把随机读变成了顺序读了。 Random_read(100), Random_read(101), Random_read(102)就相当于Scan(100~102)了。 转自infoq 时间序列数据库的秘密 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/6432732.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册