首页 文章 精选 留言 我的

精选列表

搜索[高性能应用服务],共10000篇文章
优秀的个人博客,低调大师

高性能日志库 go-logger 2.0.5 发布

前言: go-logger 是一个轻量级的日志库,提供了灵活的日志记录功能与文件备份功能,方便在应用程序中灵活地操作日志。 go-logger特点 日志级别设置:允许动态调整日志级别,以便在不同环境下控制日志的详细程度。 格式化输出:支持自定义日志的输出格式,包括时间戳、日志级别、日志位置 等元素。 文件数回滚:支持按照日志文件数自动文件回滚,并防止文件数过多。 文件压缩:支持压缩归档日志文件。 支持标准库log/slog日志文件管理:支持标准库文件切割,压缩等功能。 go-logger的使用文档 go-logger源码 go-logger v2.0.5更新内容 增加formatter参数 增加Option参数 说明: 通过formatter设置,可以自由修改输出的日志格式,添加自定义的日志标识 如,默认日志输出: [Debug]2024/06/05 11:07:22 logging_test.go:24 this is default logging 通过修改formatter,相同的日志内容可以修改为类似如下的形式输出 this is default logging 2024/06/05 11:07:22 logging_test.go:24[Debug] this is default logging [Debug] 2024/06/05 11:07:22 logging_test.go:24 [Debug]2024/06/05 11:07:22 logging_test.go:24 >>>>>>> this is default logging 通过设置Option参数,可以设置logger的所有参数,同时建议通过Option统一设置logger的系列参数,通过该方式设置更加易于维护。 Option对象包含了日志级别,控制台日志,日志格式,输出格式formatter, 日志文件对象等参数。 formatter使用说明 设置日志标识输出格式SetFormatter SetFormatter("{level} {time} {file}:{message}\n") 默认格式:"{level} {time} {file}:{message}\n" {level} 日志级别信息:如 [Debug],[Info],[Warn],[Error],[Fatal] {time} 日志时间信息 {file} 文件位置行号信息 {message} 日志内容 说明:除了关键标识 {message} {time} {file} {level} 外,其他内容原样输出,如 | , 空格,换行 等 示例1: SetFormatter("{message} | {level} {time} {file}\n") Debug("11111111111111") 执行结果: 11111111111111|[Debug] 2024/06/05 11:07:22 logging_test.go:24 示例2 SetFormatter("{level}{time} {file} >>>> {message}\n") Debug("2222222222222") 执行结果: [Debug]2024/06/05 11:08:12 logging_test.go:24 >>>> 2222222222222 Option使用说明 建议通过option参数设置log的所有参数,更加易于维护 Level :日志级别 Console :控制台打印 Format :日志格式,默认:FORMAT_LEVELFLAG | FORMAT_SHORTFILENAME | FORMAT_DATE | FORMAT_TIME Formatter :日志输出 默认:"{level} {time} {file}:{mesaage}\n" FileOption :日志文件接口参数 FileOption介绍 FileOption为接口,有FileSizeMode与FileTimeMode两个实现对象 FileTimeMode对象 Filename 日志文件路径 Timemode 按小时,天,月份:MODE_HOUR,MODE_DAY,MODE_MONTH Maxbuckup 最多备份日志文件数 IsCompress 备份文件是否压缩 FileSizeMode对象 Filename 日志文件路径 Maxsize 日志文件大小的最大值,超过则滚动备份 Maxbuckup 最多备份日志文件数 IsCompress 备份文件是否压缩 SetOption示例1 SetOption(&Option{Level: LEVEL_DEBUG, Console: false, FileOption: &FileTimeMode{Filename: "/usr/log/testlogtime.log", Maxbuckup: 10, IsCompress: true, Timemode: MODE_DAY}}) 说明:以上option对象设置日志级别:LEVEL_DEBUG,控制台日志关闭,设置写日志文件,并按天(MODE_DAY)备份日志文件,保持最多10个备份文件,压缩切割的备份文件 SetOption示例2 SetOption(&Option{Level: LEVEL_DEBUG, Console: false, FileOption: &FileSizeMode{Filename: "testlog.log", Maxsize: 1<<30, Maxbuckup: 10, IsCompress: true}}) 说明:以上option对象设置日志级别:LEVEL_DEBUG,控制台日志关闭,设置写日志文件,并按大小为 1G 切割日志文件,保持最多10个备份文件,压缩切割的备份文件


优秀的个人博客,低调大师

Meta 开源 Rust 编写的高性能构建系统

看来最近 Meta 的工程师是一点都没有闲着,前两天刚开源 AI 图像分割模型,这不就又发布了名为 Buck2 的开源构建系统。 Buck2 是一个已经在 Meta 内部使用了一段时间的大型构建系统,目前 Meta 有数千名开发人员正在使用该构建系统,每天执行数百万次的构建。在 Meta 的内部测试中,Buck2 完成构建的速度是 Buck1 的 2 倍。 虽然 Buck2 跟 Buck1 使用了相同的名称,也是 Buck1 构建系统的继任者,但前者并不是后者简单的升级版,Buck2 用 Rust 完全重写(Buck1 用的 Java),目标是使构建速度更快、更有效。 正因如此,Buck2 有一个单独的 GitHub 仓库和单独的官方网站,为的就是跟 Buck1 进行区分。 我们自己的内部分析表明,当 Buck2 执行构建时,工程师能够生成更多有意义的代码,我们希望更广泛的行业也能从中受益。 Buck2 的设计基于以下原则: 完全分离了核心规则和特定于语言的规则,将语言规则从核心中分离出来意味着规则更容易改变和理解。Buck2 的核心是用 Rust 编写的,它的语言规则(比如如何构建 C++)是用 Starlark 编写的。这种分离与 Buck1(所有规则都写在核心中)和 Bazel(C++/Java 写在核心中)形成对比。 构建系统消除了许多类型的错误并增加了并行性。 规则 API 被设计为包含先进的性能特征,以及动态依赖特征。 开源版本与 Meta 的内部版本几乎相同,唯一替换掉的部分是工具链(指向 Meta 编译器的内部副本)和远程执行(指向 Meta 内部服务器) —— 两者都提供了开源替代品。还发布了与内部使用完全相同的所有规则。 Buck2 的编写是为了与远程执行相结合,能够在远程机器上运行操作,使用与 Bazel 相同的 API,并且一直在用 Buildbarn 和 EngFlow 测试远程执行。 Buck2 还可以与虚拟文件系统集成。 上述所有这些更改都是想要帮助工程师和开发者减少等待时间,将更多时间用于迭代他们的代码。 目前 Buck2 为以下这些语言附带了对应的规则:Assembly、C/C++、Erlang、Go、Haskell、Java、JavaScript、Julia、OCaml、Python 和 Rust。开发者可以使用 Starlark 脚本语言,向 Buck2 添加或重新实现语言规则。 项目地址:链接 官方网站:链接

优秀的个人博客,低调大师

贴吧低代码高性能规则引擎设计

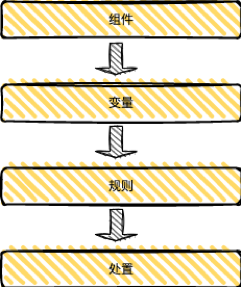
作者 | 贴吧UEG技术组 导读 本文首先介绍了规则引擎的使用场景,引出贴吧规则引擎。从组件、变量、规则、处置四个模块介绍了规则引擎的组成部分,同时对最终规则文件的编译过程做了详细介绍。为了做到低代码,在规则配置上做到平台化,非研发同学即可完成。增加新的变量也只需要在变量平台进行简单操作,无需额外的代码提交。另外框架层面支持并行和异步的封装,在服务调用上也尽量做到减少代码,提高研发同学的效率。最后文章对贴吧规则引擎做了总结,也提供了一些常见的使用场景和思路。 全文6951字,预计阅读时间18分钟。 01 背景 百度贴吧是一个拥有10多年历史的UGC产品,在业务迭代中难免会有很多业务逻辑的代码,其中一部分业务逻辑用if-else等硬编码的形式开发,一部分引入了配置文件,通过配置文件的规则去执行不同的业务逻辑。在某些运营活动或权益规则中,需要频繁增加或者更改一些规则,这部分规则经常变动的部分就需要规则引擎来统一管理。 规则引擎是一种专注于业务规则的服务,它可以将业务规则从代码中剥离出来,使用预先定义好的语义规范来实现这些剥离出来的业务规则。规则引擎通过接受输入的数据,进行业务规则的评估,并做出业务决策。 因为规则引擎将复杂的业务逻辑从业务代码中剥离出来,所以可以显著降低业务逻辑实现难度;同时,剥离的业务规则使用规则引擎实现,这样可以使多变的业务规则变的可维护,配合规则引擎提供的良好的业务规则设计器,不用编码就可以快速实现复杂的业务规则,同样,即使是完全不懂编程的运营或者产品人员,也可以使用图形化的界面来自定义规则,实现代码一样的效果。 下面对一些需要使用规则引擎的场景进行举例: 1、单规则迭代 用户标签->包含A关键词->权益A 用户标签->包含A关键词->权益A ->包含B关键词->权益B 用户标签->身份豁免策略/机器账号->包含A关键词->权益A ->包含B关键词->权益B 用户标签->A模型结果大于1 ->豁C类用户->包含A关键词->权益C 可见随着业务的发展,需要不断的调整权益规则,这部分如果硬编码写死在代码中,需要频繁上线,增加了工作量,并且随着业务逻辑的增多,后期维护成本增高。 2、持续接入新的能力 除了目前的字符串比较能力,一般的规则引擎还会接入各种各样的模型能力,一般通过RPC的形式请求不同的服务,随着接入的服务越来越多,可以组合的规则也是成倍的增长; 比如新接入图片模型识别后,所有图片识别的结果会过其他相关的模型,相关的模型调用逻辑就增加了一倍; 又如接入了某些模型,要根据模型的分数做相应的处理调整,需要频繁的改动分值对应的处置手段,同时为了应对突发的场景,也需要频繁的更改规则。 这些操作如果没有一个自动化的规则引擎,就需要把大量的规则逻辑写在代码里,经过长时间的迭代,规则变得非常臃肿,无论对后续的开发还是定位问题的效率都会带来问题。 02 贴吧规则引擎组成部分 贴吧规则引擎要做到规则灵活可配,无需研发介入,就需要尽可能的把包含判断逻辑的部分全部下放到平台,通过平台的勾选对规则进行实现。 上图为规则引擎整体的模块划分,主要分为四部分: 组件服务:组件服务是对第三方服务的封装,比如调用图片模型服务、调用帖子属性等内容服务,一般是RPC调用;组件需要RD开发代码,但是贴吧规则引擎的组件调用不掺杂业 务逻辑,仅仅是定义一个函数function,通过函数的入参调用第三方服务返回结果; 变量平台:变量又称算子,是配置规则的参数;变量分为业务调用时传的入参、使用组件返回的结果等。贴吧规则引擎通过专用平台管理变量,RD和PM均可以在平台上配置变量; 规则引擎:规则引擎平台涉及到了具体每一条规则,通过图形化的界面生成规则,该平台不需要RD介入,通过平台化的操作生成具体的规则。 处置方法:该处置为RD定制化开发,针对帖子、用户或其他场景的召回处置处理。一般定义一个rpc请求回调相关业务,处置方法因为是场景定制化的,所以这部分需要研发介入开发,但是处置方法更新的频率非常低,一般都是复用已有的能力。 2.1 组件服务 规则引擎所有配置的数据不可能都是上游参数传递,很多是通过调用第三方服务获取;比如通过帖子id获取的帖子详情数据,通过用户uid获取用户的扩展属性,这里都需要调用第三方服务; 组件的开发非常简单,只需要声明一个函数,并实现其静态方法。为了后续的性能考虑,函数声明时可以指定sync(串行)、async(异步)、parallel(并行)三种执行方式,贴吧规则引擎会在调度的时候按照类型,使用更高效的方式执行对应的方法。 图中给出了一个demo组件,可以看出组件是不关注业务的,可以自定义入参和返回值,具体调用函数的入口及参数也不需要额外关注,更符合lib库或者util方法的实现方式,这种组件的好处是开发简单,解耦业务逻辑,增加组件的复用性,同时也降低了研发同学的工作量。 另外对于mode的工作模式,分为以下三类,具体的实现都是框架实现,组件的开发方不需要关注: sync:同步调用,使用的时候串行执行,函数间是阻塞的; async:异步调用,定义function的时候分为before、after两组方法。Before阶段为发起rpc请求,等待第三方服务回调后执行after方法,可以应对好耗时的服务接入。 parallel:并行模式,属于同一层级的parallel 函数并行执行,类似于多线程或者golang的goroutine模式,目前贴吧的规则引擎采用php开发,不具备多线程的相关能力,所以这里并行是在before组装rpc参数,通过curl_multi统一发起并行请求,在after函数取到结果。 以上能力在规则引擎框架上已经封装,组件的研发RD只需要关注PRC的实现即可,根据函数的定义框架实现并行或者异步的调用。 2.2 变量平台 变量或者算子就是规则引擎中做规则判断使用的参数,比如用户名、帖子id、用户等级、帖子内容、模型识别的结果等,这部分的内容越多,规则引擎可以创建规则的『素材』越多; 变量的来源分为三个部分: **(1)平台预定义的变量:**比如一些常量数字或者特定字符串,这部分内容比较固定,变动较少。 **(2)业务入参:**业务在请求规则引擎的时候可以把尽可能多的参数变量传递过来,除了帖子、用户、吧相关的数据,还可以把用户ip、ua等各种数据一并传递,这些数据在变量的平台化界面上可以做简单的筛选或者摘取,生成新的变量。 如图举例:input是一个完成的业务请求的变量,取input中的title生成testTitle变量,这样就可以单独使用testTitle做一些规则上的判断。 **(3)组件调用:**在组件的部分已经定义了具体的方法,该方法类似于lib库或者util,具体的请求的入口在变量平台实现,入参就是其他变量。 如图举例:testRPC是定义的组件,其中入参是testTitle变量,返回的大结果作为一个testRPC变量。 后面可以对testRPC变量做具体的拆分,比如testRPC中的data.score作为一个单独的变量,用score这个变量做后面的规则定义。 整体来说,input是上游传过来的基础变量。对入参变量的整理和过滤可以生成额外的基础变量;使用基础参数(比如帖子id),通过rpc调用,可以生成扩展的结果;对结果的提取可以生成额外的第二级变量;进一步对二级变量继续调用服务,可以生成更多的变量:比如通过图片模型结果过一些文本模型,但是随着层级的变深,整体服务呈现多级依赖关系,这也增加了整体的系统耗时。 对于入参或者RPC请求结果的处理,全部可以在变量平台上进行操作,变量平台定义了规则引擎可以使用的变量及具体的实现方式。因为变量平台支持编辑代码,所以一般的变量都可以直接在变量平台编辑完成,而对相对复杂的模型调用,则可以封装通用的util方法,之后在变量平台直接使用这些方法。 2.3 规则引擎平台 组件是一个个简单的util静态方法,通过入参及调用组件生成扩展的变量;自此进行规则判断的『素材』准备好了,接下来需要使用这些变量配置规则,而核心的规则引擎平台就是使用这些变量,生成规则。 规则引擎目前支持的运算规则: 规则运算符:目前支持变量值与常量的比较,包含基本的>,<,>=,<=,==,!=多种比较方式;另外不仅可以直接使用变量,对于数组类型的变量,还可以直接使用了变量的计数count,对于string类型,可以使用变量的长度len做参数直接进行判断。 词表比较:判断某个词是否在词表中是一个比较常用的规则;规则引擎平台支持本地词表与远程词表;远程词表为了解决词表量级太大的问题。 字符与词表的比较包括精确匹配,包含、不包含、前缀匹配及后缀匹配几种方式,基本覆盖了常见的使用方式。 粒度控制判断:为了判断某个调整在一段时间内的出现次数,平台支持配置变量的出现次数统计。 对于某些使用频次较少的运算规则,平台不在功能上进行统一支持,但是可以通过修改变量来支持。比如想判断变量A的sin值大于Z,可以在变量平台新配置一个变量B,它的定位为sin(A),然后在规则引擎上使用B这个变量做判断,就解决了某些特殊的计算方式。 对于判断逻辑,目前支持if条件判断,switch多分支判断,确定召回,确定豁免四种方式,基本囊括了常用的判断逻辑。 △简单的策略配置demo 2.4 处置方法 处置方法是针对不同的业务场景召回的个性化处置逻辑,这部分需要RD开发代码,做个性化的处理;比如命中召回后返回true or false或者命中的规则号或者回调特殊标记。 处置方法添加的频率不会很高,基本固定对帖子、用户或者各个场景有1-2个处置方法即可,后续的多个规则直接复用处置方法。 03 规则引擎实现原理 规则引擎最终生成是一个包含所有规则逻辑的代码块,代码块在规则引擎框架中运行;生成的代码块类似研发开发的代码:代码的逻辑依旧是定义变量、使用变量做条件判断(规则)、命中召回的处置。 1. 变量 这部分比较容易理解,就是2.2部分;将所有定义的变量取出来,当然因为变量之间是递归依赖的,所以当变量中需要其他变量时,会递归获取内容,直到获取常量或没有依赖为止,最后倒序输出为代码片段。 2. 规则文件生成 每一条规则在存储上都是一个json串,存储形式为一个nodeTree。其中一个node节点存储了类型:判断节点、召回节点、豁免节点以及多组(switch)判断节点。其中召回节点和豁免节点是程序判断的终止位置,当执行到召回节点时会加载规则引擎对应的处置方法。判断节点是整个规则引擎的核心,包含对应的变量与比较方式。其中比较方式有数字比较、字符串比较及词表比较。比如内容中是否包含关键词“AB”,则在判断节点上选取内容变量,比较方式为词表包含,词表内容为“AB”。 在规则文件的设计上,采用nodeTree的方式,既能方便后续扩展node的属性和类型,又通过父子节点树的方式多层级的表示复杂的if、switch逻辑,层级可以无限深。 在新的规则上线时,将nodeTree文件从数据库中全部导出,生成全部的规则文件。规则文件依赖的变量已经在变量文件中全部定义好,剩下的工作就是将变量与规则进行组装,生成最终的可执行代码。 另外对于某些特殊的需求,需要对白名单中的uid或者类型进行全部策略豁免。对于此类需求可以修改所有的规则,增加前置判断逻辑,但是此操作需要对现有的全部规则及增量规则都修改,且在规则执行中会增加额外的判断逻辑,增加整体规则引擎的执行耗时,所以除了普通的规则外,贴吧规则引擎增加了全局规则区。全局规则区相当于所有规则的前置条件,具体配置的规则为普通的node判断节点,当全局的所有规则判断均为true时才会依次执行具体的普通规则,这样对于想全局豁免的需求,只需要简单配置全局规则即可,不需要修改具体的详细规则。 3. 生成可执行规则文件 规则引擎的前期编译工作需要生成可以执行的代码,这部分就是将图形化配置的规则与变量进行组合,优化整体的代码执行逻辑,生成可执行的代码,将文件下发到所有的线上机器。 其中变量文件是可以执行的php语法,规则为导出的json文件,需要将不同类型的文件进行组合,这里需要将不同文件源转为同一种结构化数据。 对于原本是php语法的文件,贴吧规则引擎采用ply和yacc进行词法和语法的解析,对php语法中array、函数、赋值、条件判断、运算符等进行提取,转为结构化的数据。 对于规则文件,因为是预先定义好的json nodeTree,包含的格式是有限可枚举的,只要将每种类型与规则映射为结构化的字段,就可以将规则文件转位目标结构化数据。 之后就是可执行文件的生成过程,具体需要以下步骤: 语法树展开:通过递归调用,将函数嵌套展开。比如res = funA(funB($params))展开为 tmp1 = funB($params);res = funA(tmp1);展开后将高阶函数展开成普通函数,方便后续的优化处理。 接下来就是语句优化部分: 将不同变量重名的部分自动增加_n后缀,避免变量的相互覆盖;遍历整体规则中使用的变量,如果存在变量从未使用过,从整体代码中去除;对于定义了多遍重复的函数调用,整体去重只保留一份;对并行或者异步方法的函数组拆分成真正可执行的静态方法。经过以上步骤,对将要生成的最终规则文件进行了初步的整理及优化。 在组件服务中提到了异步函数async;对于某些耗时非常高的模型服务,异步函数的作用是触发调用后结束,等待第三方服务回调。 对于使用异步函数的情况,至少拆分成两步,第一步发起触发,第二步收到模型回调,取到该步骤的结果作为变量,所有依赖该变量的规则只能放到第二步执行。如果有函数依赖第二步的结果,则步骤会继续增加,该函数取某变量的异步结果,发起服务请求,第三步回调收到结果;异步函数展开的作用是将所有无依赖的异步函数请求方法统一放在一起,并行请求,通过回调触发执行第二步的规则逻辑。这样贴吧规则引擎可以很方便的接入高耗时的模型服务。 除了异步函数,还存在一种parallel并行调用的方式。由于规则引擎采用php的语言选型,没有其他语言方便的多线程或者协程调用方式,对于无依赖的函数不能支持并行调用,所以在规则引擎的设计上通过curl_multil并行rpc调用服务的形式来减少耗时。 目前比较耗时的函数一般是请求数据库服务或者第三方服务,这里将数据库及第三方的调用全部封装为http协议的形式,在策略文件调用上通过before方法整理入参,通过类似curl_multil的方法并行调用服务,取到结果后执行各自函数的after方法,整理函数对应的变量,这样就将无依赖关系的调用进行了并行处理,整体降低了耗时。并行函数合并就是框架层面做的自动化合并,规则引擎的研发同学只需要简单定义before和after方法,编译阶段就会自动将所有无依赖的函数before方法执行,组装rpc请求。如果某些函数在before阶段依赖其他服务的结果,那么这批函数将在第二次发起请求,即无任何依赖的函数先发起并行请求,依赖第一批结果的函数再发起第二次并行请求,以此类推,最大限度的使用并行调用的方式。 最终生成的可执行的文件,基本的最小单元为name、func、param、cond四组字段组成。如果cond判断条件为真,则name通过函数和入参数执行对应方法,产出值;该值又是其他单元的条件变量或者函数入参,这样由上到下依次执行,完成了所有规则的执行。 仍然以上述demo策略为例: 最终生成了四组单元,基本格式如下: 如图所示,基于上述的规则,只需要四组基本单元,每一组通过函数计算结果,下一组的条件依赖结果的值,如果走到“召回”逻辑,则进行表示规则命中,返回对应的规则号及其处置方法,框架中根据处置方法执行对应的逻辑。 每一个规则都是上述基本单元组成,最终将nodeTree中的全部规则生成基本单元,文件下发到所有运行的机器上,至此完成了规则文件的产出与规则上线。 04 总结 贴吧规则引擎搭配图形化的界面,非常方便非技术同学配置业务规则,将冗余的业务逻辑全部托管在规则引擎平台上,无需代码开发,即可上线或者修改规则。 另外框架层面将异步、并行等复杂逻辑进行了封装,研发同学调用新的模型只需要按照模版修改简单的参数整理及返回数据整理,即可完成并行或者异步的操作,减少规则引擎的执行耗时。对于变量结果的转换,也可以通过变量管理平台,在平台上简单的修改即可完成一些基本的整理逻辑,大大减少代码的开发量。 通过规则引擎,可以灵活配置运营活动中的抽奖规则、用户身份权益配置、商品价格等包含复杂业务逻辑判断的部分,将规则抽象出来,解放研发同学的人力,同时规则在平台上可以方便查找和定位,方便后续的维护。 ——END—— 推荐阅读: 浅谈权限系统在多利熊业务应用 分布式系统关键路径延迟分析实践 百度工程师教你玩转设计模式(装饰器模式) 百度工程师带你体验引擎中的nodejs 揭秘百度智能测试在测试定位领域实践 百度工程师带你探秘C++内存管理(ptmalloc篇)

优秀的个人博客,低调大师

Shuttle:高可用 高性能 Spark Remote Shuffle Service

01 开篇 大数据计算的兴起,源于Google的MapReduce论文,MapReduce的原理很简单,其流程核心则是Map和Reduce两阶段数据交换,也即Shuffle。 Shuffle对大数据计算影响很大,从公开的资料:Facebook[1]、LinkedIn[2]、阿里[3] 等公司的数据看,Shuffle影响的任务和任务计算时间上都有较高占比。从OPPO的线上任务看,68%的Spark任务都有Shuffle计算。 大数据计算引擎的技术演进,一直离不开对Shuffle的优化,无论是从执行计划方面优化,尽量避免Shuffle算子还是各种Shuffle机制的演进,都是为了尽量缩短Shuffle的耗时。 Shuffle不仅影响作业运行效率,对计算稳定性也有较大影响,大数据开发的同学一般都有这样的经历:莫名的 Shuffle Fetch Fail 错误,甚至任务会因此频繁失败,不得不优化任务计算逻辑。 02 背景 Shuffle成为大数据计算效率和稳定性的关键因素的原因是什么? 我们认为主要有两点: 1、磁盘的碎片读写,Spill多次写磁盘和Reduce只拉取部分Partition数据,影响效率 2、Reduce 读取Map端本地数据,需要 MxR 次远程网络读,影响稳定性 MapReduce shuffle示意图[4] Shuffle技术演进,主线也是沿着解决上面两个问题推进。比较有里程碑意义的有两个方向: ESS:External Shuffle Service,ESS 原理是Map 任务在计算节点本地将相同Partition 数据合并到一起; RSS:Remote Shuffle Service,RSS 原理是Map 任务将相同Partition数据Push到远端的RSS,RSS将同一Partition的数据合并。 ESS vs RSS 示意图 ESS 和 RSS 都是为了解决前面我们提到的碎片读写和RPC连接过多的问题,ESS是缓解了这种情况,没有RSS解决的彻底。 Spark社区提供了Remote Shuffle Service的接口,各家公司可以自己实现自己的RSS。所以,近两年在Spark 平台的RSS技术方案如雨后春笋,纷纷公开亮相。 03 相关工作 我们先看一下各家的解决方案,目前公开资料和源码的方案主要有: Uber的RSS [5]:2020年开源,底层存储基于本地磁盘,Shuffle Server提供读写数据功能,对性能有一定的影响,另外,开源时间比较早,但维护较少。 腾讯的FireStorm [6]:2021年11月开源,底层存储使用HDFS,对稳定性以及性能优化设计考虑较少。 阿里云 EMR-RSS [7]:2022年1月开源,底层存储基于本地磁盘,对本地IO做了深入的优化,不过这种基于本地存储的Shuffle Service,有着天然的限制。 LinkedIn MagNet [2]:MagNet严格来说不算真正意义的RSS,只能算是 Push Based 的Shuffle。MagNet在Spark原生Shuffle数据落盘的同时把数据Push到远端NodeManager的ESS上,同一份数据,会落盘两次,这样其实会增加集群的IO压力。不过,MagNet已经合入到Spark3.2版本,鉴于此,MagNet的Shuffle才做了这样的设计。 04 OPPO解决方案-Shuttle (1)整体架构 首先,介绍一下 Shuttle 的整体架构: Shuttle 架构图 Shuttle 主要由两个角色组成,ShuffleMaster和ShuffleWorker。 ShuffleMaster负责管理ShuffleWorker的状态,向任务分发可用的ShuffleWorker。 ShuffleWorker负责接收ShuffleWriter发送的数据,并将同一Partition的数据聚合,写入分布式存储。 为保障Master高可用,一个集群有两个Master,一个Active和一个Backup Master。 如图所示,ActiveCluster和StandbyCluster分别有两个Master。 为什么会有Active和Standby两个Cluster ?这也是为了服务的稳定性考虑,主要用于热升级,下面会详细介绍。 (2)架构设计考量 我们在设计一个分布式的Shuffle Service系统的时候,从下面几个方面考虑: 1)数据正确性 数据正确性是生命线,Shuffle数据在Remote Shuffle Service系统走一圈,能否保障数据不出问题? 我们通过Checksum机制保障数据的正确性。每一条写入Shuttle的数据,都会计算一个Checksum值,最后读数据的时候同样对读取的每一条数据计算Checksum,最后对比Checksum,保证每条数据都被正确读到且只被读一次。 2)稳定性 稳定性是分布式系统的基石,在分布式系统中,出现各种问题是必然。 稳定性的保障,是一个系统性的问题,不是某一个Feature或者设计能解决所有稳定性问题,我们从以下几个方面讨论Shuttle的稳定性建设: A、节点/任务管控 ShuffleMaster和ShuffleWorker在管控方面都有自己的机制。 ShuffleMaster对节点/任务管控的功能主要有: 节点自愈:ShuffleWorker通过心跳向ShuffleMaster上报自身的“健康”信息。心跳超时或者“健康”信息异常,ShuffleMaster会暂停向该节点分配新的任务数据流量,Worker节点恢复“健康”后,再向改节点分配任务。 负载均衡:Spark 任务向ShuffleMaster请求可用的ShuffleWorker,Master根据集群负载决定分配哪些ShuffleWorker;同时,分配Worker的算法实现是插件式的,可以定制多种不同的分配策略。 异常拦截:对于用户短时间提交的大量相同任务,ShuffleMaster会主动拦截,避免影响集群整体稳定性。 ShuffleWorker流控机制,当任务数据量突增场景下,流控保障Worker的稳定性。流控机制主要从两方面限制: 内存量:ShuffleWorker进程使用总内存超过阈值即发生流控 连接数:同时向ShuffleWorker发送数据的连接数,超过阈值即发生流控 B、多机切换 Map向ShuffleWorker发送数据,会有多个ShuffleWorker可供选择,当某个Worker出问题(比如Worker发生流控,或节点掉线),可以切换到备选Worker继续发送。 如图所示,ShuffleWriter在向ShuffleWorker A发送数据的时候,A节点出现故障,ShuffleWriter切换到B节点继续发送数据。 C、分布式存储 Shuttle采用分布式文件系统作为存储底座。 在分布式存储技术如此发达的今天,我们不需要花费过多精力优化存储。 专业的事情交给专业的“人”来做,这样的好处主要有: 1、降低Shuttle系统本身的复杂度,提升自身稳定性 2、分布式文件系统自身具有良好的稳定性,扩展性,负载均衡等优势 3、适配多种分布式文件存储,选择多样化,充分利用不同系统优势 4、使得ShuffleWorker解耦本地存储能力,存算分离,更易于云上部署 业界主流的分布式文件系统,本身对读写性能都做了充分的优化。 另外,我们大量使用了公司存储团队自研的分布式文件系统CubeFS[8],CubeFS针对Shuffle场景做了定制化的优化,简单介绍一下CubeFS的优势: CubeFS架构图 CubeFS是CNCF新一代云原生分布式存储产品,兼容S3、HDFS、POSIX多种接入协议,提供多副本和纠删码两种存储引擎,支持多租户、多AZ部署。 CubeFS创新性采用存算分离架构,提供可扩展的元数据服务,低成本的模式可配的纠删码引擎,自适应多级缓存特性,使得CubeFS在稳定性、扩展性、性能与成本、可运维性等方面均表现优秀;对多种接入协议的原生支持,与容器兼容性好,拓宽了CubeFS产品生态;CubeFS已经被用于OPPO各个核心业务,如大数据存储,大数据shuffle、人工智能、ElasticSearch、MySQL、数据备份等,有力支撑各类业务数据海量存储需求。 D、热升级 ShuffleService一旦上线,会为大量任务提供shuffle 服务,不能停服,同时,系统的升级迭代会不断需要重启服务。为此,系统必须具备热升级的能力。 Shuttle有两种热升级模式: 1、滚动升级:通过ShuffleMaster逐一加黑-重启ShuffleWorker。 这种方式针对小规模系统还可行,对于规模比较大的ShuffleService系统,可以考虑第二种模式。 2、集群切换:ShuffleWorker进程绑定机器IP和端口,一台机器可以部署多个Worker进程,因此我们在线上同一批机器部署两套ShuffleService,升级的时候可以直接整体切换服务。 上线以来,经历线上多次升级变更,无一例因为升级导致的失败case。 3)性能优化 A、异步传输 数据传输和消息处理,均使用Netty异步处理机制,对比同步处理机制,性能有明显优势。同时,消息采用Pb格式,提升消息序列化和反序列化性能。 B、并发读写 ShuffleWriter和Reader对于数据的读写均采用多线程并发处理,在Reader端使用RingBuffer作为底层存储的缓冲,读过程异步化。 C、定制线程池 ShuffleWorker会并发处理不同的Map发送的数据,使用Java原生线程池会引入过多的同步机制,影响处理数据速度。为此,我们定制线程池,确保同一Partition的数据交由单一线程处理,显著降低同步操作,提升处理速度。 不仅如此,为优化数据传输效率,我们根据网络MTU定制数据包大小,精益求精。 4)扩展性 A、多集群路由 ShuffleMaster可配置任务路由规则,多个集群在线服务,随时可以切换流量。在集群出现异常,任务可以选择切换到正常的集群。 B、多存储共存 目前Shuttle支持HDFS、CubeFS、Alluxio、S3等分布式存储系统,多种存储可以同时在线提供服务,无论是云上还是自建集群,均可应对。 同时,Shuttle设计就考虑到Spark3.x的AQE特性支持,我们线上同时运行着支持Spark2.4和Spark3.1.2版本的Shuttle。 04 业界相关技术对比 针对稳定性,数据正确性保障,性能优化方面,我们跟业界相关工作做了对比。 项目名称 特点 优缺点 Uber RSS 独立的Service 本机存储 Shuffle Server多副本复制 Shuffle Server承担读写 无Checksum 本机磁盘限制 无Master管控 LinkedIn MegNet 非独立Service 保持原生Shuffle落盘 同时尽力Push到远端 跟原生Spark绑定紧密(已经Merge 到社区版本) 磁盘IO翻倍 无Checksum 无Master管控 腾讯 FireStorm 独立Service 分布式存储(仅HDFS) 使用HDFS存储 Checksum保障正确性 无Master管控 多线程同步消息发送 Writer堆内缓存数据 阿里 EMR-RSS 独立Service 本机存储 无Checksum 有Master管控 对本地存储有优化 Writer堆外内存缓存 Shuttle 独立Service 分布式存储 多维稳定性保障 多存储适配 Checksum保障正确性 Master管控集群 Writer堆外内存缓存 并发读写,Netty异步传输 Shuttle在稳定性和性能优化方面做了很多考量,系统上线后一直提供稳定服务,期间多次升级,无一任务因此失败,下面会介绍一下我们的性能测试效果。 05 测试效果 文章[3]中,EMR-RSS已经跟其他的开源产品做了详细的对比测试,且在性能上有明显的优势,所以,我们直接跟EMR-RSS对比测试。 (1)测试环境 硬件环境:20台物理机 机器配置:24块HDD,内存384GB,cpu 48核心。 软件配置: Shuttle使用HDFS存储,均使用默认配置 EMR-RSS使用本地存储,配置使用所有磁盘。rss.shuffle.writer.mode配置为sort(默认为hash) 测试任务:TeraSort Spark任务 静态资源分配,Executor 800,分区数1000,其他使用默认配置。 (2)测试结果 EMR-RSS 1Tb TeraSort: Shuttle 1Tb TeraSort: EMR-RSS 5Tb TeraSort: Shuttle 5Tb TeraSort: 注:不同规格任务运行时间,两种技术方案分别运行5次求平局值对比 整体看,Shuttle和EMR-RSS对比TeraSort任务在几个不同规模数据量上有4%-8%的性能提升。 (3)测试分析 Shuttle的读数据明显快,分析原因如下: 1、Shuttle读数据从HDFS读取,不占用ShuffleWorker进程资源; 2、Shuttle读数据方式是异步流水线方式。 但是,我们也看到Shuttle在写数据要比EMR-RSS慢,分析原因如下: 1、Shuttle 的流控机制,在每次发送数据包会先获取一次令牌,多一次网络交互。 2、Shuttle的Checksum机制,在每个分区数据发送完毕后,会多发一个Checksum包,且最后的Checksum包是同步方式通信。 由上分析,Shuttle在保障稳定性和数据正确性上做了一些性能取舍。但是,由于读数据的 速度更快,不仅弥补了写数据导致的性能Gap,整体性能还是有提升。 (4)线上效果 目前,OPPO集团大数据计算任务30%的Shuffle数据已经接入 Shuttle,效果最好的大任务执行效率提升50%+;整体效果数据见下图: 指标名称 下降幅度 平均e2e时间下降 29.5% 平均成本下降 24% task执行总时间下降 22% 平均fetch fail task数下降 68->0 06 未来展望 为了让 Shuttle 能够影响更多的计算,我们决定将 Shuttle 项目开源[9]。 对于技术演进方向,我们计划从三个方向进行: 1、接入更多的计算引擎,比如 Flink、Trino等。 2、依托现有的分布式存储,优化底层存储,适应Shuffle场景的特殊需求。 3、提供更多的计算服务,不局限于Remote Shuffle服务。 附录 [1] Haoyu Zhang, Brian Cho, Ergin Seyfe. Riffle: Optimized Shuffle Service for Large-Scale Data Analytics. ACM 2018 [2] Min Shen, Ye Zhou, Chandni Singh. Magnet: Push-based Shuffle Service for Large-scale Data Processing. VLDB 2020 [3] 阿里云EMR Remote Shuffle Service在小米的实践. https://mp.weixin.qq.com/s/xdBmKkKL4nW7EEFnMDxXYQ [4] 《Hadoop权威指南》 [5] Ubser Spark RSS: https://github.com/uber/RemoteShuffleService [6] 腾讯Spark RSS FireStorm: https://github.com/Tencent/Firestorm [7] 阿里云 Spark RSS: https://github.com/alibaba/RemoteShuffleService [8] CubeFS: https://github.com/cubeFS/cubefs [9] Shuttle: https://github.com/oppo-bigdata/shuttle 作者简介 David Fu OPPO大数据计算平台架构师 负责大数据计算平台技术演进设计开发,曾供职于阿里云,去哪儿网大数据平台,拥有10年大数据架构,开发经验 本文分享自微信公众号 - OPPO数智技术(OPPO_tech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册