首页 文章 精选 留言 我的

精选列表

搜索[安全研究],共10000篇文章
优秀的个人博客,低调大师

Stitching模块中focalsFromHomography初步研究

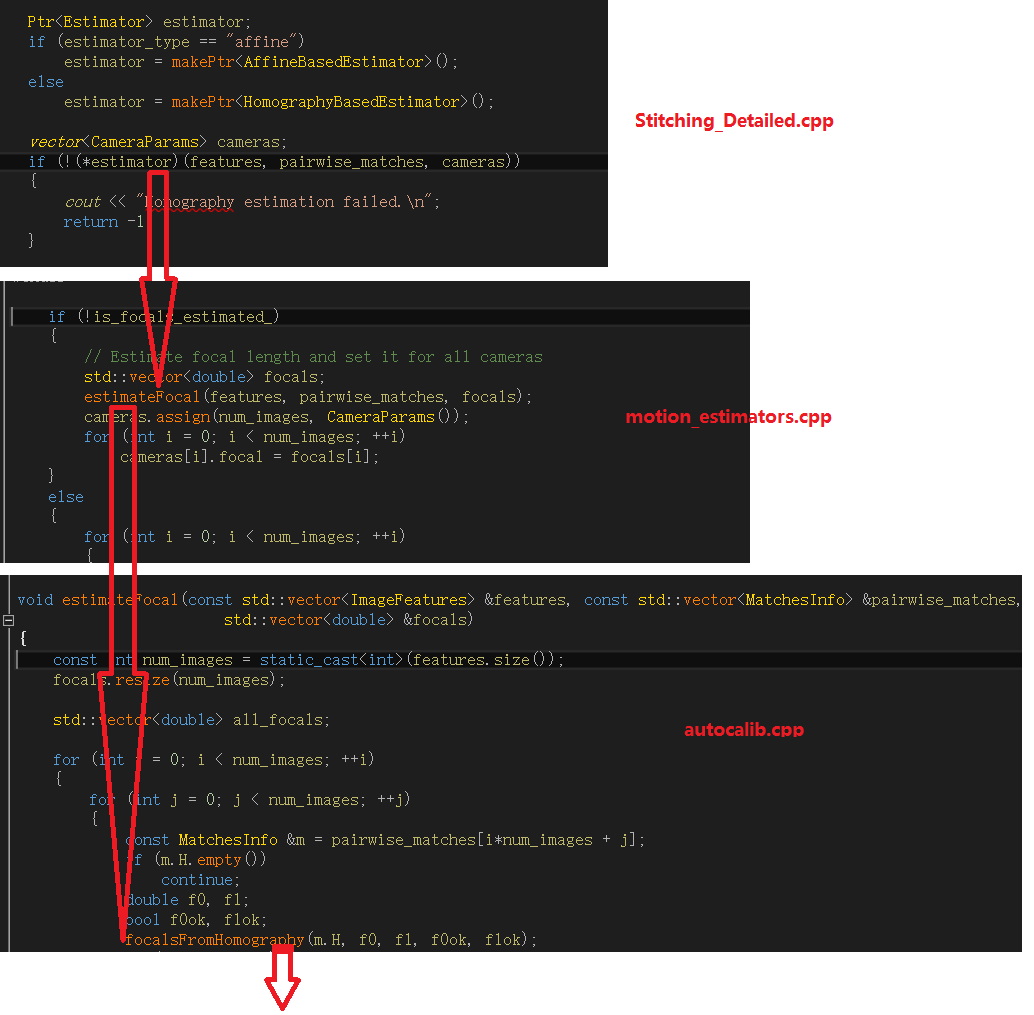
在Stitching模块中,通过“光束法平差”的时候,有一个步骤为“通过单应矩阵估算摄像头焦距”,调用的地方为: voidfocalsFromHomography( constMat &H, double &f0, double &f1, bool &f0_ok, bool &f1_ok) { CV_Assert(H.type() ==CV_64F &&H.size() ==Size( 3, 3)); const double *h =H.ptr < double >(); doubled1,d2; //Denominators doublev1,v2; //Focalsquaresvaluecandidates f1_ok = true; d1 =h[ 6] *h[ 7]; d2 =(h[ 7] -h[ 6]) *(h[ 7] +h[ 6]); v1 = -(h[ 0] *h[ 1] +h[ 3] *h[ 4]) /d1; v2 =(h[ 0] *h[ 0] +h[ 3] *h[ 3] -h[ 1] *h[ 1] -h[ 4] *h[ 4]) /d2; if(v1 <v2)std : :swap(v1,v2); if(v1 > 0 &&v2 > 0)f1 =std : :sqrt(std : :abs(d1) >std : :abs(d2) ?v1 :v2); else if(v1 > 0)f1 =std : :sqrt(v1); elsef1_ok = false; f0_ok = true; d1 =h[ 0] *h[ 3] +h[ 1] *h[ 4]; d2 =h[ 0] *h[ 0] +h[ 1] *h[ 1] -h[ 3] *h[ 3] -h[ 4] *h[ 4]; v1 = -h[ 2] *h[ 5] /d1; v2 =(h[ 5] *h[ 5] -h[ 2] *h[ 2]) /d2; if(v1 <v2)std : :swap(v1,v2); if(v1 > 0 &&v2 > 0)f0 =std : :sqrt(std : :abs(d1) >std : :abs(d2) ?v1 :v2); else if(v1 > 0)f0 =std : :sqrt(v1); elsef0_ok = false; } 本文具体分析 focalsFromHomography,函数的参数定义: Triestoestimatefocallengthsfromthegivenhomography undertheassumptionthatthecameraundergoesrotationsarounditscentreonly. Parameters H–Homography. f0–EstimatedfocallengthalongXaxis. f1–EstimatedfocallengthalongYaxis. f0_ok–True, iff0wasestimatedsuccessfully, falseotherwise. f1_ok–True, iff1wasestimatedsuccessfully, falseotherwise. 可以看到它通过输入的单应矩阵,最后得到了相机焦距的估计值,计算的过程也比较复杂。那这样做的理由是什么了?具体计算的时候又是如何实现的了? 论文也就是算法的依据为《Construction of Panoramic Image Mosaics with Global and Local Alignment》, Heung-Yeung Shum (hshum@microsoft.com) and Richard Szeliski (szeliski@microsoft.com) page 17.method "focals from homgraphy matrix" 我将具体的内容截出来: 原论文中40-44的推导,分为两个部分。一个部分是从“8参数”的变换,得出和x轴,y轴两个方向焦距的关系;一个部分是通过行列式的数学性质,计算出两个方向的焦距。这两个部分我目前都没有掌握足够的资料来进行证明,如果有能够证明的同学麻烦联系我一下。 然后来看算法实现。如果认为论文的表述是正确的,那么依据数学函数来对比c++的实现 代码中的h0-h8直接对应论文中的m0-m8,仅以f0来观察,那么f0^2可能有两种取值(这里x^2 是 x * x的一种简单表示方法,代表阶乘) f0^2 = - m2*m5/(m0*m3+m1*m4)或 f0^2 = m5^2 - m2^2 /(m0^2 + m1^2 - m3^2 - m4 ^2) 看代码 d1 =h[ 0] *h[ 3] +h[ 1] *h[ 4]; 那么 v1 = -h[ 2] *h[ 5] /d1 = -h[ 2] *h[ 5] /(h[ 0] *h[ 3] +h[ 1] *h[ 4]) d2 =h[ 0] *h[ 0] +h[ 1] *h[ 1] -h[ 3] *h[ 3] -h[ 4] *h[ 4]; 则 v2 =(h[ 5] *h[ 5] -h[ 2] *h[ 2]) /d2 =(h[ 5] *h[ 5] -h[ 2] *h[ 2]) /(h[ 0] *h[ 0] +h[ 1] *h[ 1] -h[ 3] *h[ 3] -h[ 4] *h[ 4]) 前后是一一对应的,计算f0^2的两个值是没有问题的。但是这里f0有两个计算结果,最后选择哪个了?这一点在论文中没有说,在代码中采用的方法是首先判断v1,v2的符号,如果都是负数,那么肯定是计算错误了,因为它们所代表的f0^2肯定是非负数;然后判断v1,v2的大小,取其中比较大的那个来进行计算。 但是在 if(v1 > 0 &&v2 > 0)f0 =std : :sqrt(std : :abs(d1) >std : :abs(d2) ?v1 :v2); 我认为这样写是没有用的,我也在尝试联系一下相关对这个问题比较熟悉的人共同讨论。f1的计算方法是同样的。到这里已经得到f0和f1,分别对应x轴和y轴,为了得到最后的结果,那么会取 f = sqrt(f0 * f1) 则得到这个当应矩阵的对于焦距的估计值。那么focalsFromHomography的一次运算也就结束了。 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com
优秀的个人博客,低调大师

Android中View内部类MeasureSpec研究

终于建了一个自己个人小站:https://huangtianyu.gitee.io,以后优先更新小站博客,欢迎进站,O(∩_∩)O~~ 当我们使用自定义View或ViewGroup的时候,经常会遇到MeasureSpec类,这个类主要用于在onMeasure中表示该控件的大小。在该变量里面包含该控件尺寸的大小和模式。这个模式主要表明该控件能得到的尺寸类型,包括三个模式:UNSPECIFIED未指定模式,EXACTLY精确模式,AT_MOST最大模式。 1.EXACTLY 在这种模式下,给定尺寸的值是多少,那么这个控件的长或宽就是多少。 2.AT_MOST 当前控件的长或宽最大只能是父控件能够给的最大空间,当然也可以比这个小。 3.UNSPECIFIED 当前控件可以随便用空间,不受限制。 模式有三种,至少得2位二进制位。于是系统采用了最高的2位表示模式。在Android中通过int的前两位来表示当前int值的模式类型。如图: 其中00的表示"未指定模式"。即MeasureSpec.UNSPECIFIED 01的表示"'精确模式"。即MeasureSpec.EXACTLY 11的表示"最大模式"。即MeasureSpec.AT_MOST 在该类中,常用的方法有三个: /** * @param size the size of the measure specification * @param mode the mode of the measure specification * @return the measure specification based on size and mode */ public static int makeMeasureSpec(int size, int mode) { if (sUseBrokenMakeMeasureSpec) { return size + mode; } else { return (size & ~MODE_MASK) | (mode & MODE_MASK); } } 该方法由我们给出的尺寸大小和模式生成一个包含两个信息的int变量,也就是我们需要设置的长或者宽。 /** * Extracts the mode from the supplied measure specification. * * @param measureSpec the measure specification to extract the mode from * @return {@link android.view.View.MeasureSpec#UNSPECIFIED}, * {@link android.view.View.MeasureSpec#AT_MOST} or * {@link android.view.View.MeasureSpec#EXACTLY} */ public static int getMode(int measureSpec) { return (measureSpec & MODE_MASK); } 该方法表示从给定的变量中获取模式信息。 /** * Extracts the size from the supplied measure specification. * * @param measureSpec the measure specification to extract the size from * @return the size in pixels defined in the supplied measure specification */ public static int getSize(int measureSpec) { return (measureSpec & ~MODE_MASK); } 该方法是得到给定变量里面的尺寸大小的值。 其中上述几个常量的值如下: private static final int MODE_SHIFT = 30; private static final int MODE_MASK = 0x3 << MODE_SHIFT; /** * Measure specification mode: The parent has not imposed any constraint * on the child. It can be whatever size it wants. */ public static final int UNSPECIFIED = 0 << MODE_SHIFT; /** * Measure specification mode: The parent has determined an exact size * for the child. The child is going to be given those bounds regardless * of how big it wants to be. */ public static final int EXACTLY = 1 << MODE_SHIFT; /** * Measure specification mode: The child can be as large as it wants up * to the specified size. */ public static final int AT_MOST = 2 << MODE_SHIFT;

优秀的个人博客,低调大师

android Handler 机制研究学习笔记

前言: 很早以前,学习android的时候就接触过Handler ,知道Handler是一个用于线程间通信的类,最常用于做下载条,最近,看了Pro android 3 这本书,里面描述的Handler 说得非常的细致,与此,写下Handler的学习笔记 Android 运行的进程 为了,更好的了解Handler的机制,我们应该首先,将Android系统整个运行进程都要烂熟于心,下面是android 进程运行图: 从图中我们可以看到,当我们从外部调用组件的时候,Service 和 ContentProvider 是从线程池那里获取线程,而Activity 和BroadcastReceiver是直接在主线程运行,为了,追踪线程,我们可以用debug 方法,或者使用一个工具类,这里,我们创建一个用于监视线程的工具类 /***@authorTom_achai *@date2011-11-20* */publicclassUtils{publicstaticlonggetThreadId(){ Threadt=Thread.currentThread();returnt.getId();} /***获取单独线程信息*@return */publicstaticStringgetThreadSignature(){ Threadt=Thread.currentThread();longl=t.getId(); Stringname=t.getName();longp=t.getPriority(); Stringgname=t.getThreadGroup().getName(); return("(Thread):"+name+":(id)"+l+"(:priority)"+p+":(group)"+gname);} /***获取当前线程信息*/publicstaticvoidlogThreadSignature(){ Log.d("ThreadUtils",getThreadSignature());} publicstaticvoidlogThreadSignature(Stringname){ Log.d("ThreadUtils",name+":"+getThreadSignature());} publicstaticvoidsleepForInSecs(intsecs){try{ Thread.sleep(secs*1000);}catch(Exceptione){ //TODO:handleexceptione.printStackTrace();}}/***讲String放进Bundle中*@parammessage*@return*/publicstaticBundlegetStringAsBundle(Stringmessage){Bundleb=newBundle();b.putString("message",message);returnb;}/****获取Bundle的String*@paramb*@return*/publicstaticStringgetStringFromABundle(Bundleb){returnb.getString("message");}} 有了这样一个类就可以方便我们观察线程的运行 好了,现在准备好以后就进入正题Handler Handlers 为什么要使用Handlers? 因为,我们当我们的主线程队列,如果处理一个消息超过5秒,android 就会抛出一个 ANP(无响应)的消息,所以,我们需要把一些要处理比较长的消息,放在一个单独线程里面处理,把处理以后的结果,返回给主线程运行,就需要用的Handler来进行线程建的通信,关系如下图; 下面是Handler,Message,Message Queue 之间的关系图 这个图有4个地方关系到handlers 1, 主线程(Main thread) 2, 主线程队列(Main thread queue) 3,Hanlder 4,Message 上面的四个地方,主线程,和主线程的队列我们无需处理,所以,我们主要是处理Handler 和 Message 之间的关系. 我们每发出一个Message,Message就会落在主线程的队列当中,然后,Handler就可以调用Message绑定的数据,对主线程的组件进行操作. Message 作为handler接受的对象,我们有必要知道Message这个数据类型是个怎样的数据类型 从官方文档中我们可以知道message 关于数据的字段 从上面的表格可以看出,message 提供了一个对象来存储对象,而且,还提供了三个int字段用来存储少量int类型 当然,除了以上三个Message 自有的字段外,我们还可以通过setData(Bundle b),来存储一个Bundle对象,来存储更丰富的数据类型,例如,图片等等. 在初始化我们的message的时候就可以为我们的Message默认字段赋值,注意赋值顺序!!! Messagemsg=obtainMessage();//设置我们what字段的初值,注意顺序!!! Messagemsg=mHandler.obtainMessage(intwhat);//下面同理 Messagemsg=mHandler.obtainMessage(intwhat,Objectobject); Messagemsg=mHandler.obtainMessage(intwhat,intarg1,intarg2); Messagemsg=mHandler.obtainMessage(intwhat,intarg1,intarg2,Objectobj); 本文转自 liam2199 博客,原文链接: http://blog.51cto.com/youxilua/772645 如需转载请自行联系原作者

优秀的个人博客,低调大师

Spark shell的原理深入研究

Spark shell是一个特别适合快速开发Spark原型程序的工具,可以帮助我们熟悉Scala语言。即使你对Scala不熟悉,仍然可以使用这个工具。Spark shell使得用户可以和Spark集群交互,提交查询,这便于调试,也便于初学者使用Spark。 感受到Spark shell是如此的方便,因为它很大程度上基于Scala REPL(Scala 交互式shell,即Scala解释器),并继承了Scala REPL(读取-求值-打印-循环)(Read-Evaluate-Print-Loop)的所有功能。 Sprk Shell虽然强大,但多数时候你还是会运行编译后的代码,而不是使用REPL环境,即API。 这里啊,首次使用spark一般都是从执行spark-shell开始的。当在键盘上敲入spark-shell并回车时,我用源码来分析。 这里是个知识点。若没有对spark进行安装集群部署,直接将spark的压缩包,解压,然后执行spark-shell,默认是local模式。 关于spark的安装部署方式,我这里不多赘述。请移步 Spark运行模式概述 而,我们这一句将spark进行了集群安装(Jdk、Scala、Hadoop、Spark)等。 执行spark-shell,则是,集群模式。 想清晰的学习,请移步 Spark Standalone与Spark on YARN的几种提交方式 spark-shell的脚本 export SPARK_SUBMIT_OPTS "$FWDIR"/bin/spark-submit --class org.apache.spark.repl.Main --name "Spark shell" "$@" spark-submit的脚本 exec "$SPARK_HOME"/bin/spark-class org.apache.spark.deploy.SparkSubmit "$@" spark-class的脚本 # Find the java binary if [ -n "${JAVA_HOME}" ]; then RUNNER="${JAVA_HOME}/bin/java" else if [ `command -v java` ]; then RUNNER="java" else echo "JAVA_HOME is not set" >&2 exit 1 fi fi exec "$RUNNER" -cp "$LAUNCH_CLASSPATH" org.apache.spark.launcher.Main "$@" 总结: 1、运行spark-shell,则会运行spark-submit。 2、spark-shell其实是对spark-submit的一层封装!!! 3、在某些情况下,可能需要对环境变量及JVM启动参数做修改,还可能涉及ulimit中的某些配置项,那么可以将这些指令添加到sparl-class中。 4、SparkSbumit当中定义了mian函数,在它的处理中会将Spark Repl运行起来,Spark Repl能够接收用户的输入,通过编译与运行,返回结果给用户。 这就是Spark具有交互处理能力的原因所在。 调用顺序: SparkSbumit -> repl.Main -> SparkILoop 本文转自大数据躺过的坑博客园博客,原文链接:http://www.cnblogs.com/zlslch/p/5717800.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

JPDA 架构研究1- 整体架构

引入: 关于JPDA(Java Platform Debugger Architecture) 网上有很多讲解,例子。我也不重复发明轮子了,这组文章主要从实践的代码分析角度,仔细剖析这个平台的特点,以及这其中的一些问题澄清和误区。 实践: 如果我们从利用Java Remote Debug的功能来看待JPDA ,并且使用socket的通信方式的话,那么整个过程应该如下: 首先,你在要被调试的服务器上开启远程调试功能。以tomcat 为例,你有两种写法: a. 你要么用命令catalina jpda start,它会启用JPDA_OPTS命令行选项: JPDA_OPTS=-agentlib:jdwp=transport=%JPDA_TRANSPORT%,address=%JPDA_ADDRESS%,server=y,suspend=%JPDA_SUSPEND% (这种写法是JVMTI的写法,从JDK 5.0开始可用) b.要么直接添加JAVA_OPTS为 SET JAVA_OPTS=-Xdebug -Xrunjdwp:transport=%JPDA_TRANSPORT%,address=%JPDA_ADDRESS%,server=y,suspend=%JPDA_SUSPEND% (这种写法是老的JVMPI的写法,JDK 5以前只能用这个,目前JDK也保留了对此的支持) 其中%JPDA_TRANSPORT"被解析为dt_socket %JPDA_ADDRESS%是要连接到的远程VM的机器地址和端口 然后在eclipse中Debug As "Remote Java Application",然后把上述的参数填入即可。 分析: 事实上,我们这个过程利用了JPDA进行远程调试,JPDA架构分为3层。 JVMTI:JAVA虚拟工具接口.它是一套由虚拟机直接提供的 native 接口。通过这些接口,开发人员不仅调试在该虚拟机上运行的 Java 程序,还能查看它们运行的状态,设置回调函数,控制某些环境变量,从而优化程序性能。 JDWP:JAVA调试交互协议。它定义了调试器和被调试程序之间传递的信息的格式。它详细完整地定义了请求命令、回应数据和错误代码,保证了前端和后端的 JVMTI 和 JDI 的通信通畅。 JDI: JAVA调试接口。通过它,调试工具开发人员就能通过前端虚拟机上的调试器来远程操控后端虚拟机上被调试程序的运行,JDI 不仅能帮助开发人员格式化 JDWP 数据,而且还能为 JDWP 数据传输提供队列、缓存等优化服务。 后面我会专门用很多篇幅来详细介绍,这里只是简单概括。 本文转自 charles_wang888 51CTO博客,原文链接:http://blog.51cto.com/supercharles888/1587538,如需转载请自行联系原作者

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册