首页 文章 精选 留言 我的

精选列表

搜索[估值水平],共10000篇文章
优秀的个人博客,低调大师

Manifest值冲突解决方法

FBI Warning:欢迎转载,但请标明出处:http://blog.csdn.net/codezjx/article/details/38669939,未经本人同意请勿用于商业用途,感谢支持! 整理了一些这段时间遇到的常见问题,希望对各位猿们有帮助。。。如果觉得有用就点个赞哦 问题一: Error:(26, 9) Attribute application@icon value=(@drawable/logo) from AndroidManifest.xml:26:9 Error:(28, 9) Attribute application@theme value=(@style/ThemeActionBar) from AndroidManifest.xml:28:9 is also present at XXXX-trunk:XXXXLib:unspecified:15:9 value=(@style/AppTheme) Suggestion: add 'tools:replace="android:theme"' to <application> element at AndroidManifest.xml:24:5 to override Error:Execution failed for task ':XXXX:processDebugManifest'. > Manifest merger failed with multiple errors, see logs 原因: AS的Gradle插件默认会启用Manifest Merger Tool,若Library项目中也定义了与主项目相同的属性(例如默认生成的Android:icon和android:theme),则此时会合并失败,并报上面的错误。 解决方法有以下2种: 方法1:在Manifest.xml的application标签下添加tools:replace=”android:icon, android:theme”(多个属性用,隔开,并且记住在manifest根标签上加入xmlns:tools=”http://schemas.android.com/tools”,否则会找不到namespace哦) 方法2:在build.gradle根标签上加上useOldManifestMerger true (懒人方法) 参考官方介绍:http://tools.android.com/tech-docs/new-build-system/user-guide/manifest-merger 问题二: Library Project里面的BuildConfig.DEBUG永远都是false。这是Android Studio的一个已知问题,某Google的攻城狮说,Library projects目前只会生成release的包。 Issue 52962:https://code.google.com/p/android/issues/detail?id=52962 解决方法:(某Google的攻城狮推荐的方法) Workaround: instaed of BuildConfig.DEBUG create another boolean variable at lib-project’s e.g. BuildConfig.RELEASE and link it with application’s buildType.https://gist.github.com/almozavr/d59e770d2a6386061fcb 参考stackoverflow上的这篇帖:http://stackoverflow.com/questions/20176284/buildconfig-debug-always-false-when-building-library-projects-with-gradle 问题三: 每次保存的时候,每行多余的空格和TAB会被自动删除(例如结尾、空行的多余空格或TAB) 特别是每次准备提交SVN,Review代码时候你就蛋疼了,显示一堆不相关的更改,看的眼花。 解决方法: Settings->IDE Settings->Editor->Other->Strip trailing spaces on Save->None 问题四: 编译的时候,报:Failure [INSTALL_FAILED_OLDER_SDK]。一般是系统自动帮你设置了compileSdkVersion 解决方法: 修改build.gradle下的compileSdkVersion ‘android-L’为compileSdkVersion 19(或者你本机已有的SDK即可) 本文转自 一点点征服 博客园博客,原文链接:http://www.cnblogs.com/ldq2016/p/7053833.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

微软警告:Log4j 漏洞攻击水平仍然很高

在12月之前微软探测系统中发现的Log4j“Log4Shell”缺陷后,微软已警告Windows和Azure 客户保持警惕。 Apache软件基金会披露,Log4Shell可能需要数年时间才能修复,因为错误日志软件组件在应用程序和服务中的使用范围非常广泛。 美国联邦贸易委员会已发出警告,将追捕未修复Java 日志记录包 Log4j 中的漏洞的公司。 该机构周二表示:“FTC 打算利用其全部法律权力追究未能采取合理措施保护消费者数据免遭 Log4j 或未来类似已知漏洞暴露的公司。未能识别和修补该软件的实例可能违反 FTC 法案。” FTC表示:“Log4j 漏洞是更广泛的结构性问题的一部分。它是数以千计的鲜为人知但至关重要的开源服务之一,这些服务在几乎无数的互联网公司中使用。”  本周二早些时候,微软警告说,客户可能不知道 Log4j 问题在他们的环境中有多普遍。在过去的一个月里,微软发布了许多更新,包括对其 Defender 安全软件的更新,以帮助客户在攻击者加强扫描活动时识别问题。 LOG4J 缺陷覆盖范围 Log4j缺陷:攻击者正在尝试利用此严重漏洞进行数以千计的尝试 安全警告:Log4j Java 库中的新零日漏洞已被利用 Log4j RCE活动于12月1日开始,因为僵尸网络开始使用漏洞 “在12月的最后几周,攻击尝试和测试一直很高。我们观察到许多现有的攻击者在他们现有的恶意软件工具包和策略中添加了对这些漏洞的利用,从硬币矿工到手动键盘攻击,”Microsoft 365 Defender威胁情报团队和微软威胁情报中心(MSTIC)在1月3日的更新中表示。 客户应该假设漏洞利用代码和扫描功能的广泛可用性对他们的环境构成真实存在的危险。因此,它鼓励客户利用脚本和扫描工具来评估他们的风险和影响。 目前,微软已经观察到攻击者使用许多相同的库存技术来定位目标。已经观察到复杂的对手(如民族国家行为者)和商品攻击者都在利用这些漏洞。扩大使用这些漏洞的潜力很大。该漏洞可能让一些安全团队在圣诞节期间没有太多休息时间,以至于英国NCSC发出警告,提防负责修复工作的员工倦怠。 就在元旦之前,微软在适用于Windows 10和 11、Windows Server 和 Linux 系统的 Microsoft 365 Defender 门户中推出了一个新的 Log4j 仪表板,用于威胁和漏洞管理。该系统旨在帮助客户查找和修复受 Log4j 漏洞影响的文件、软件和设备。CISA 和 CrowdStrike还在圣诞节前发布了 Log4j 扫描器。 如何确保公司安全 Log4j 零日漏洞:您需要知道的以及如何保护自己 安全警告:Log4j Java 库中的新零日漏洞已被利用 Log4j 缺陷可能是“未来几年”工业网络的一个问题 CISA官员认为,数以亿计的设备受到 Log4j 的影响。与此同时,思科和Vmware等主要技术供应商继续为受影响的产品发布补丁。 Log4Shell 漏洞现在包括原始 CVE-2021-44228 和四个相关缺陷,其中最新的是CVE-2021-44832。然而,这只是在 12 月 28 日的 Log4j 版本 2.17.1 更新中解决的中等严重性问题。Apache 软件基金会在其公告中详细介绍了每个 Log4j 漏洞,涵盖CVE-2021-44228、CVE-2021-45105和CVE-2021-45046。

优秀的个人博客,低调大师

linux你会什么就决定你的工资水平

新手必会用深黄色(8-15k)标记,老鸟必会深黄色+浅蓝色(15-25K)标记 ============================================== 操作系统:Centos,Ubuntu,Redhat,suse,Freebsd 网站服务:nginx,apache,lighttpd,php,tomcat,resin数据 库:MySQL,Mysql-proxy,MariaDB,PostgreSQL DB中间件:MyCat,atlas,cobar,amoeba,MySQL-proxy 代理相关:lvs,keepalived,haproxy,nginx,heartbeat网站缓存:squid,nginx,varnishNOSQL库:memcached,memcachedb,MongoDB,Cassandra,redis,CouchDB存储相关:Nfs,Moosefs(mfs),Hadoop,glusterfs,lustre,FastDFS 版本管理:svn,git监控报警:nagios,cacti,zabbix,munin,hyperic,mrtg,graphite 域名解析:bind,powerdns,dnsmasq同步软件:scp,rsync,inotify,sersync,drbd,csync2,union,lsyncd批量管理:Ssh Key,Saltstack,expect,puppet,ansible,cfengine虚拟 化:kvm,xen 云计 算:openstack,docker,cloudstack内网软件:iptables,zebra,iftraf,ntop,tc,iftop邮件软件:qmail,posfix,sendmail,zimbra 远程拨号:open***,pptp,openswan,ipip统一认证:openldap队列工具:ActiveMQ,RabbitMQ,Metaq,MemcacheQ,Zeromq打包发布:mvn,ants,jenkins,svn测试软件:ab,JMeter,Webbench,LoadRunner,http_load,tcpcopy 带宽测试:smokeping,iozone 磁盘测试 iozone 性能测试:dd IOPS测试 fio 日志相关:rsyslog,Awstats,flume,storm,ELK(Elasticsearch+Logstash+Kibana) 搜索软件:Sphinx,Xapian,Solr 无人值守:kickstart,cobbler 软件安装:rpm,yum(设计rpm包定制及yum仓库构建) 大数据:HDFS,Hive,Hbase,Zookeeper,Pig,Spark,Mahout 原文出自 “老男孩linux培训” 博客,链接:http://oldboy.blog.51cto.com/2561410/775056

优秀的个人博客,低调大师

独家 | 如何利用大规模无监督数据建立高水平特征?

GIF来自:https://giphy.com/gifs/features-7BldZFcv2pof6 如何构建更厉害的特征检测器?我们可以通过无监督学习来做到这一点吗? 请注意,本文是一篇我自己留档用的回顾总结材料。 Paper来自此网站: https://arxiv.org/pdf/1112.6209.pdf 摘要 这篇文章的作者们喜欢利用未标记数据制作特定的分类特征识别器。(例如,使用未标记的人脸图像制作人脸识别器。)为实现这一目标,作者在大型数据集上制作了一个9层的自动稀疏编码器。与普遍的认知相反,这可以在没有任何标签数据的情况下构建面部检测器,而且优于ImageNet数据的最新性能。 (在2012年)。 介绍 这篇文章的目的是只依靠未标记图像构建一个特定的分类特征识别器,同时这也是神经科学的构想:“人类大脑中存在高度特定类的神经元”,通

优秀的个人博客,低调大师

水平分库分表的关键问题及解决思路

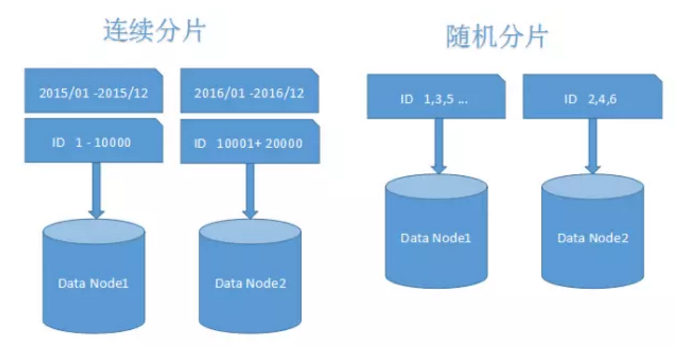
分片技术的由来关系型数据库本身比较容易成为系统性能瓶颈,单机存储容量、连接数、处理能力等都很有限,数据库本身的“有状态性”导致了它并不像Web和应用服务器那么容易扩展。在互联网行业海量数据和高并发访问的考验下,聪明的技术人员提出了分库分表技术(有些地方也称为Sharding、分片)。同时,流行的分布式系统中间件(例如MongoDB、ElasticSearch等)均自身友好支持Sharding,其原理和思想都是大同小异的。 分布式全局唯一ID在很多中小项目中,我们往往直接使用数据库自增特性来生成主键ID,这样确实比较简单。而在分库分表的环境中,数据分布在不同的分片上,不能再借助数据库自增长特性直接生成,否则会造成不同分片上的数据表主键会重复。简单介绍下使用和了解过的几种ID生成算法。 Twitter的Snowflake(又名“雪花算法”) UUID/GUID(一般应用程序和数据库均支持) MongoDB ObjectID(类似UUID的方式) Ticket Server(数据库生存方式,Flickr采用的就是这种方式) 常见分片规则和策略分片字段该如何选择在开始分片之前,我们首先要确定分片字段(也可称为“片键”)。很多常见的例子和场景中是采用ID或者时间字段进行拆分。这也并不绝对的,我的建议是结合实际业务,通过对系统中执行的sql语句进行统计分析,选择出需要分片的那个表中最频繁被使用,或者最重要的字段来作为分片字段。 常见分片规则常见的分片策略有随机分片和连续分片这两种,如下图所示: 当需要使用分片字段进行范围查找时,连续分片可以快速定位分片进行高效查询,大多数情况下可以有效避免跨分片查询的问题。后期如果想对整个分片集群扩容时,只需要添加节点即可,无需对其他分片的数据进行迁移。但是,连续分片也有可能存在数据热点的问题,就像图中按时间字段分片的例子,有些节点可能会被频繁查询压力较大,热数据节点就成为了整个集群的瓶颈。而有些节点可能存的是历史数据,很少需要被查询到。 随机分片其实并不是随机的,也遵循一定规则。通常,我们会采用Hash取模的方式进行分片拆分,所以有些时候也被称为离散分片。随机分片的数据相对比较均匀,不容易出现热点和并发访问的瓶颈。但是,后期分片集群扩容起来需要迁移旧的数据。使用一致性Hash算法能够很大程度的避免这个问题,所以很多中间件的分片集群都会采用一致性Hash算法。离散分片也很容易面临跨分片查询的复杂问题。 数据迁移,容量规划,扩容等问题很少有项目会在初期就开始考虑分片设计的,一般都是在业务高速发展面临性能和存储的瓶颈时才会提前准备。因此,不可避免的就需要考虑历史数据迁移的问题。一般做法就是通过程序先读出历史数据,然后按照指定的分片规则再将数据写入到各个分片节点中。 此外,我们需要根据当前的数据量和QPS等进行容量规划,综合成本因素,推算出大概需要多少分片(一般建议单个分片上的单表数据量不要超过1000W)。 如果是采用随机分片,则需要考虑后期的扩容问题,相对会比较麻烦。如果是采用的范围分片,只需要添加节点就可以自动扩容。 跨分片技术问题跨分片的排序分页一般来讲,分页时需要按照指定字段进行排序。当排序字段就是分片字段的时候,我们通过分片规则可以比较容易定位到指定的分片,而当排序字段非分片字段的时候,情况就会变得比较复杂了。为了最终结果的准确性,我们需要在不同的分片节点中将数据进行排序并返回,并将不同分片返回的结果集进行汇总和再次排序,最后再返回给用户。如下图所示: 上面图中所描述的只是最简单的一种情况(取第一页数据),看起来对性能的影响并不大。但是,如果想取出第10页数据,情况又将变得复杂很多,如下图所示: 有些读者可能并不太理解,为什么不能像获取第一页数据那样简单处理(排序取出前10条再合并、排序)。其实并不难理解,因为各分片节点中的数据可能是随机的,为了排序的准确性,必须把所有分片节点的前N页数据都排序好后做合并,最后再进行整体的排序。很显然,这样的操作是比较消耗资源的,用户越往后翻页,系统性能将会越差。 跨分片的函数处理在使用Max、Min、Sum、Count之类的函数进行统计和计算的时候,需要先在每个分片数据源上执行相应的函数处理,然后再将各个结果集进行二次处理,最终再将处理结果返回。如下图所示: 跨分片joinJoin是关系型数据库中最常用的特性,但是在分片集群中,join也变得非常复杂。应该尽量避免跨分片的join查询(这种场景,比上面的跨分片分页更加复杂,而且对性能的影响很大)。通常有以下几种方式来避免: 全局表全局表的概念之前在“垂直分库”时提过。基本思想一致,就是把一些类似数据字典又可能会产生join查询的表信息放到各分片中,从而避免跨分片的join。 ER分片在关系型数据库中,表之间往往存在一些关联的关系。如果我们可以先确定好关联关系,并将那些存在关联关系的表记录存放在同一个分片上,那么就能很好的避免跨分片join问题。在一对多关系的情况下,我们通常会选择按照数据较多的那一方进行拆分。如下图所示: 这样一来,Data Node1上面的订单表与订单详细表就可以直接关联,进行局部的join查询了,Data Node2上也一样。基于ER分片的这种方式,能够有效避免大多数业务场景中的跨分片join问题。 内存计算随着Spark内存计算的兴起,理论上来讲,很多跨数据源的操作问题看起来似乎都能够得到解决。可以将数据丢给spark集群进行内存计算,最后将计算结果返回。 跨分片事务问题跨分片事务也分布式事务,想要了解分布式事务,就需要了解“XA接口”和“两阶段提交”。值得提到的是,MySQL5.5x和5.6x中的xa支持是存在问题的,会导致主从数据不一致。直到5.7x版本中才得到修复。Java应用程序可以采用Atomikos框架来实现XA事务(J2EE中JTA)。感兴趣的读者可以自行参考《分布式事务一致性解决方案》,链接地址:http://www.infoq.com/cn/articles/solution-of-distributed-system-transaction-consistency 我们的系统真的需要分库分表吗读完上面内容,不禁引起有些读者的思考,我们的系统是否需要分库分表吗?其实这点没有明确的判断标准,比较依赖实际业务情况和经验判断。依照笔者个人的经验,一般MySQL单表1000W左右的数据是没有问题的(前提是应用系统和数据库等层面设计和优化的比较好)。当然,除了考虑当前的数据量和性能情况时,作为架构师,我们需要提前考虑系统半年到一年左右的业务增长情况,对数据库服务器的QPS、连接数、容量等做合理评估和规划,并提前做好相应的准备工作。如果单机无法满足,且很难再从其他方面优化,那么说明是需要考虑分片的。这种情况可以先去掉数据库中自增ID,为分片和后面的数据迁移工作提前做准备。 很多人觉得“分库分表”是宜早不宜迟,应该尽早进行,因为担心越往后公司业务发展越快、系统越来越复杂、系统重构和扩展越困难…这种话听起来是有那么一点道理,但我的观点恰好相反,对于关系型数据库来讲,我认为“能不分片就别分片”,除非是系统真正需要,因为数据库分片并非低成本或者免费的。 这里笔者推荐一个比较靠谱的过渡技术–“表分区”。主流的关系型数据库中基本都支持。不同的分区在逻辑上仍是一张表,但是物理上却是分开的,能在一定程度上提高查询性能,而且对应用程序透明,无需修改任何代码。笔者曾经负责优化过一个系统,主业务表有大约8000W左右的数据,考虑到成本问题,当时就是采用“表分区”来做的,效果比较明显,且系统运行的很稳定。 小结最后,有很多读者都想了解当前社区中有没有开源免费的分库分表解决方案,毕竟站在巨人的肩膀上能省力很多。当前主要有两类解决方案: 基于应用程序层面的DDAL(分布式数据库访问层) 比较典型的就是淘宝半开源的TDDL,当当网开源的Sharding-JDBC等。分布式数据访问层无需硬件投入,技术能力较强的大公司通常会选择自研或参照开源框架进行二次开发和定制。对应用程序的侵入性一般较大,会增加技术成本和复杂度。通常仅支持特定编程语言平台(Java平台的居多),或者仅支持特定的数据库和特定数据访问框架技术(一般支持mysql数据库,JDBC、MyBatis、hibernate等框架技术)。 数据库中间件,比较典型的像mycat(在阿里开源的cobar基础上做了很多优化和改进,属于后起之秀,也支持很多新特性),基于Go语言实现kingSharding,比较老牌的Atlas(由360开源)等。这些中间件在互联网企业中大量被使用。另外,MySQL 5.x企业版中官方提供的Fabric组件也号称支持分片技术,不过国内使用的企业较少。 中间件也可以称为“透明网关”,大名鼎鼎的mysql_proxy大概是该领域的鼻祖(由MySQL官方提供,仅限于实现“读写分离”)。中间件一般实现了特定数据库的网络通信协议,模拟一个真实的数据库服务,屏蔽了后端真实的Server,应用程序通常直接连接中间件即可。而在执行SQL操作时,中间件会按照预先定义分片规则,对SQL语句进行解析、路由,并对结果集做二次计算再最终返回。引入数据库中间件的技术成本更低,对应用程序来讲侵入性几乎没有,可以满足大部分的业务。增加了额外的硬件投入和运维成本,同时,中间件自身也存在性能瓶颈和单点故障问题,需要能够保证中间件自身的高可用、可扩展。 总之,不管是使用分布式数据访问层还是数据库中间件,都会带来一定的成本和复杂度,也会有一定的性能影响。所以,还需读者根据实际情况和业务发展需要慎重考虑和选择。 文章来源:http://blog.csdn.net/george_auyeung/article/details/77746301

优秀的个人博客,低调大师

终于,苹果还是想用你的iCloud数据提升AI水平了

苹果在本周更新了iOS 10.3 beta版,而一个有趣的条款或许被很多人给忽略了。 雷锋网了解到,新测试版iOS有一个选项,询问用户是否可以共享iCloud数据,以帮助公司改进软件产品,比如语音虚拟助手Siri。 关于这一变化的通知,出现在了“iCloud Analytics & Privacy”的条款之下,其中说到,选择分享给苹果的数据会受到隐私保护数据保护,而苹果在加强AI的同时,也会把隐私放在第一位。 在公众的印象中,在开发机器学习驱动的技术,并将其植入到软件和服务中以提供更个性化的体验上, 苹果一直落后于Google这样的对手,因为它优先保护隐私,也不会经常性利用用户个人数据。 从隐私角度来看这很伟大,也让苹果与对手们形成了鲜明对比,但苹果面临的竞争压力也越来越大,特别是开发提供个性化体验的软件时,这里通常要使用机器学习

优秀的个人博客,低调大师

Facebook研究出接近人类水平的脸部识别技术

认脸对于人来说不是什么难事,除非是韩国小姐才需要最强大脑。但是计算机做同样的事情就要困难得多了。不过Facebook正在尝试让计算机赶上人的能力,据其名为DeepFace项目的结果,Facebook人脸识别技术的识别率已经达到了97.25%,而人在进行相同测试时的成绩为97.5%,可以说已经相差无几。 Facebook进行此项研究的项目叫做DeepFace,项目利用了计算机视觉、人工智能及机器学习技术,通过革新的3D人脸建模勾勒出脸部特征,然后通过颜色过滤做出一个刻画特定脸部元素的平面模型。为了让这套系统学习特征,Facebook建立了一个来自于4030个人的440万张标签化的人脸池,Facebook称这是迄今为止最大规模的人脸池。该技术利用了9层的神经网络来获得脸部表征,该神经网络处理的参数高达1.2亿。据论文称,这套系统将人脸

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。


用户登录
用户注册