首页 文章 精选 留言 我的

精选列表

搜索[apache storm],共10000篇文章
优秀的个人博客,低调大师

Apache Dubbo | 应用架构的演进过程、RPC(远程过程调用)

学习目标 了解应用架构演进过程 了解RPC远程调用方式 掌握Dubbo框架的架构【重点】 掌握Zookeeper注册中心的基本使用 掌握Dubbo生产者和消费者的开发【重点】 了解Dubbo的管理控制台的使用 了解Dubbo的相关配置 了解Dubbo的负载均衡(4种) 了解Dubbo的配置中心(难点 代码 Watch) 1. 应用架构的演进过程 【了解】 1.1 主流的互联网技术特点 分布式、高并发、集群、负载均衡、高可用。 分布式:一件事情拆开来做。 集群:一件事情大家一起做。 负载均衡:将请求平均分配到不同的服务器中,达到均衡的目的。 高并发:同一时刻,处理同一件事情的处理能力(解决方案:分布式、集群、负载均衡) 高可用:系统都是可用的。 1.2 架构的演变过程 1.2.1 单一应用架构(all in one) 当网站流量很小时,只需一个应用,将所有功能都部署在一起,以减少部署节点和成本。此时,用于简化增删改查工作量的数据访问框架(ORM)是关键。 架构优点: 架构简单,前期开发成本低、开发周期短,适合小型项目(OA、CRM、ERP企业内部应用)。 架构缺点: 全部功能集成在一个工程中 (1)业务代码耦合度高,不易维护。 (2)维护成本高,不易拓展。 (3)并发量大,不易解决。 (4)技术栈受限,只能使用一种语言开发。 1.2.2. 垂直应用架构 当访问量逐渐增大,单一应用增加机器带来的加速度越来越小,将应用拆成互不相干的几个应用,以提升效率。此时,用于加速前端页面开发的Web框架(MVC)是关键。 架构优点: (1)业务代码相对解耦 (2)维护成本相对易于拓展(修改一个功能,可以直接修改一个项目,单独部署) (3)并发量大相对易于解决(搭建集群) (4)技术栈可扩展(不同的系统可以用不同的编程语言编写) 架构缺点: 功能集中在一个项目中,不利于开发、扩展、维护。 代码之间存在数据、方法的冗余 1.2.3. 分布式服务架构 当垂直应用越来越多,应用之间交互不可避免,将核心业务抽取出来,作为独立的服务,逐渐形成稳定的服务中心,使前端应用能更快速的响应多变的市场需求。此时,用于提高业务复用及整合的分布式服务框架(RPC)是关键。 架构优点: (1)业务代码完全解耦,并可实现通用 (2)维护成本易于拓展(修改一个功能,可以直接修改一个项目,单独部署) (3)并发量大易于解决(搭建集群) (4)技术栈完全扩展(不同的系统可以用不同的编程语言编写) 架构缺点: 缺少统一管理资源调度的框架 1.2.4. 流动计算架构(SOA) 当服务越来越多,容量的评估,小服务资源的浪费等问题逐渐显现,此时需增加一个调度中心基于访问压力实时管理集群容量,提高集群利用率。此时,用于提高机器利用率的资源调度和治理中心(SOA)是关键。 ​ 资源调度和治理中心的框架:dubbo、spring cloud 架构优点: (1)业务代码完全解耦,并可实现通用 (2)维护成本易于拓展(修改一个功能,可以直接修改一个项目,单独部署) (3)并发量大易于解决(搭建集群) (4)技术栈完全扩展(不同的系统可以用不同的编程) (5)框架实现了服务治理,不去担心集群的使用情况(失败会尝试其它服务....) 【小结】 1:单体架构 全部功能集中在一个项目内(All in one)。 打一个war, 一个tomcat 2:垂直架构 按照业务进行切割,形成小的单体项目。 每个业务模块就是一个war,一个tomcat 3 : 分布式:应用调用服务(ip写死),服务挂了就不能用了,缺少服务治理。把业务服务(service+dao)拆分成一个war包,一个tomcat里。 4:SOA架构(项目一) 服务的提供者(以服务为主 service调用dao->数据库),消费者。 服务提供者与消费都注册到中心,由中心统一管理分配,失败重试,负载均衡。。。有服务治理 可以使用dubbo作为调度的工具(RPC协议), Zookeeper作为注册中心 5:微服务架构(项目二 畅购 Springboot+Spring Cloud) 将系统服务层完全独立出来,抽取为一个一个的微服务。 以功能为主(controller->service-dao->数据库 独立) 特点一:抽取的粒度更细,遵循单一原则,数据可以在服务之间完成数据传输(一般使用restful请求调用资源)。 特点二: 采用轻量级框架协议传输。(可以使用spring cloud)(http协议 restful json) 特点三: 每个服务都使用不同的数据库,完全独立和解耦 (分库分表)。 2. RPC(远程过程调用) 2.1 RPC介绍 ​ Remote Procedure Call 远程过程调用,是分布式架构的核心,按响应方式分如下两种: ​ 同步调用:客户端调用服务方方法,等待直到服务方返回结果或者超时,再继续自己的操作。 ​ 异步调用:客户端把消息发送给中间件,不再等待服务端返回,直接继续自己的操作。 是一种进程间的通信方式 它允许应用程序调用网络上的另一个应用程序中的方法 对于服务的消费者而言,无需了解远程调用的底层细节,是透明的 需要注意的是RPC并不是一个具体的技术,而是指整个网络远程调用过程。 RPC是一个泛化的概念,严格来说一切远程过程调用手段都属于RPC范畴。各种开发语言都有自己的PRC框架。Java中的RPC框架比较多,广泛使用的有RMI、Hessian、Dubbo、spring Cloud(restapi http)等。 一台电脑调用另一台电脑上的方法 2.2 RPC组件【重点】 简单来说一个RPC架构里包含如下4个组件 1、客户端(Client):服务调用者 2、客户端存根(Client Stub):存放服务端地址信息,将客户端的请求参数打包成网络信息,再通过网络发送给服务方 3、服务端存根(Server Stub):接受客户端发送过来的消息并解包,再调用本地服务 4、服务端(Server):服务提供者 2.3 RPC调用 1、服务调用方(client)调用以本地调用方式调用服务; 2、client stub 接收到调用后负责将方法、参数等组装成能够进行网络传输的消息体。在Java里就是序列化的过程; 3、client stub 找到服务地址,并将消息通过网络发送到服务端; 4、server stub 接收到消息后进行解码,在Java里就是反序列化的过程; 5、server stub 根据解码结果调用本地的服务; 6、本地服务执行处理逻辑; 7、本地服务将结果返回给server stub; 8、server stub 将返回结果打包拆成消息,Java里的序列化; 9、server stub 将打包后的消息通过网络并发送至消费方; 10、client stub 接收到消息,并进行解码,Java里反序列化; 11、服务调用方(client)得到最终结果。 【小结】 1:RPC 远程过程调用 调用另一个应用的方法 2:RPC组件及调用过程 客户端->客户端存根->服务端存根->服务端->服务端存根->客户端存根->客户端 3:调用方式 接口调用 Web Service 接口 http+soap Dubbo 接口

优秀的个人博客,低调大师

时序数据库 Apache-IoTDB 源码解析之前言(一)

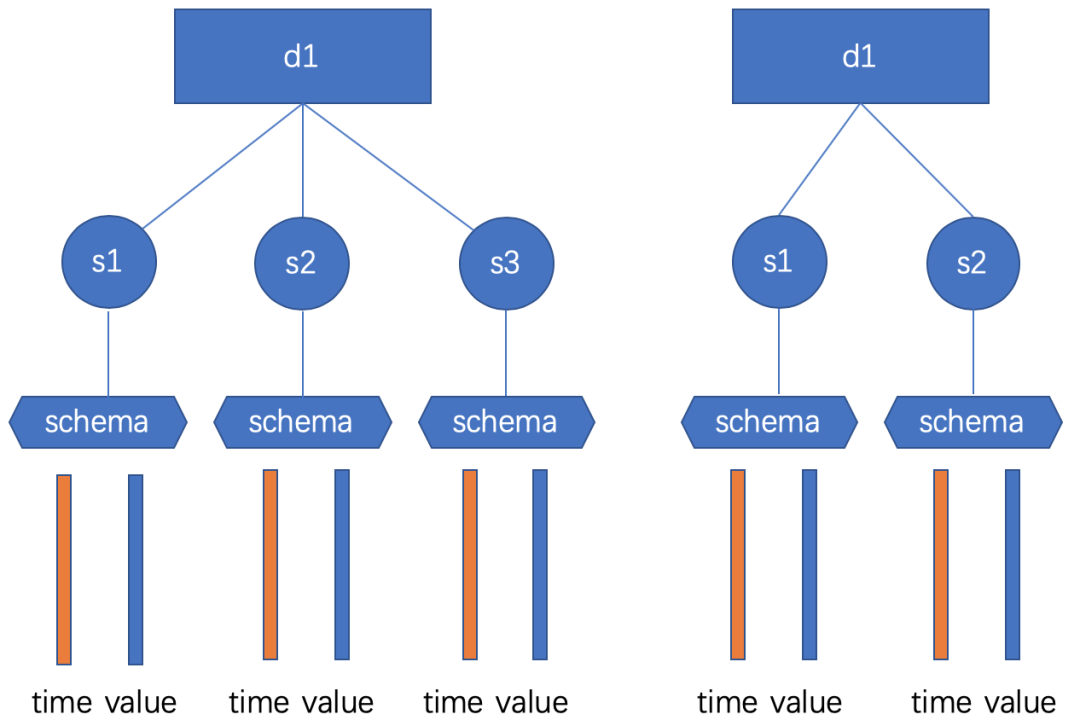
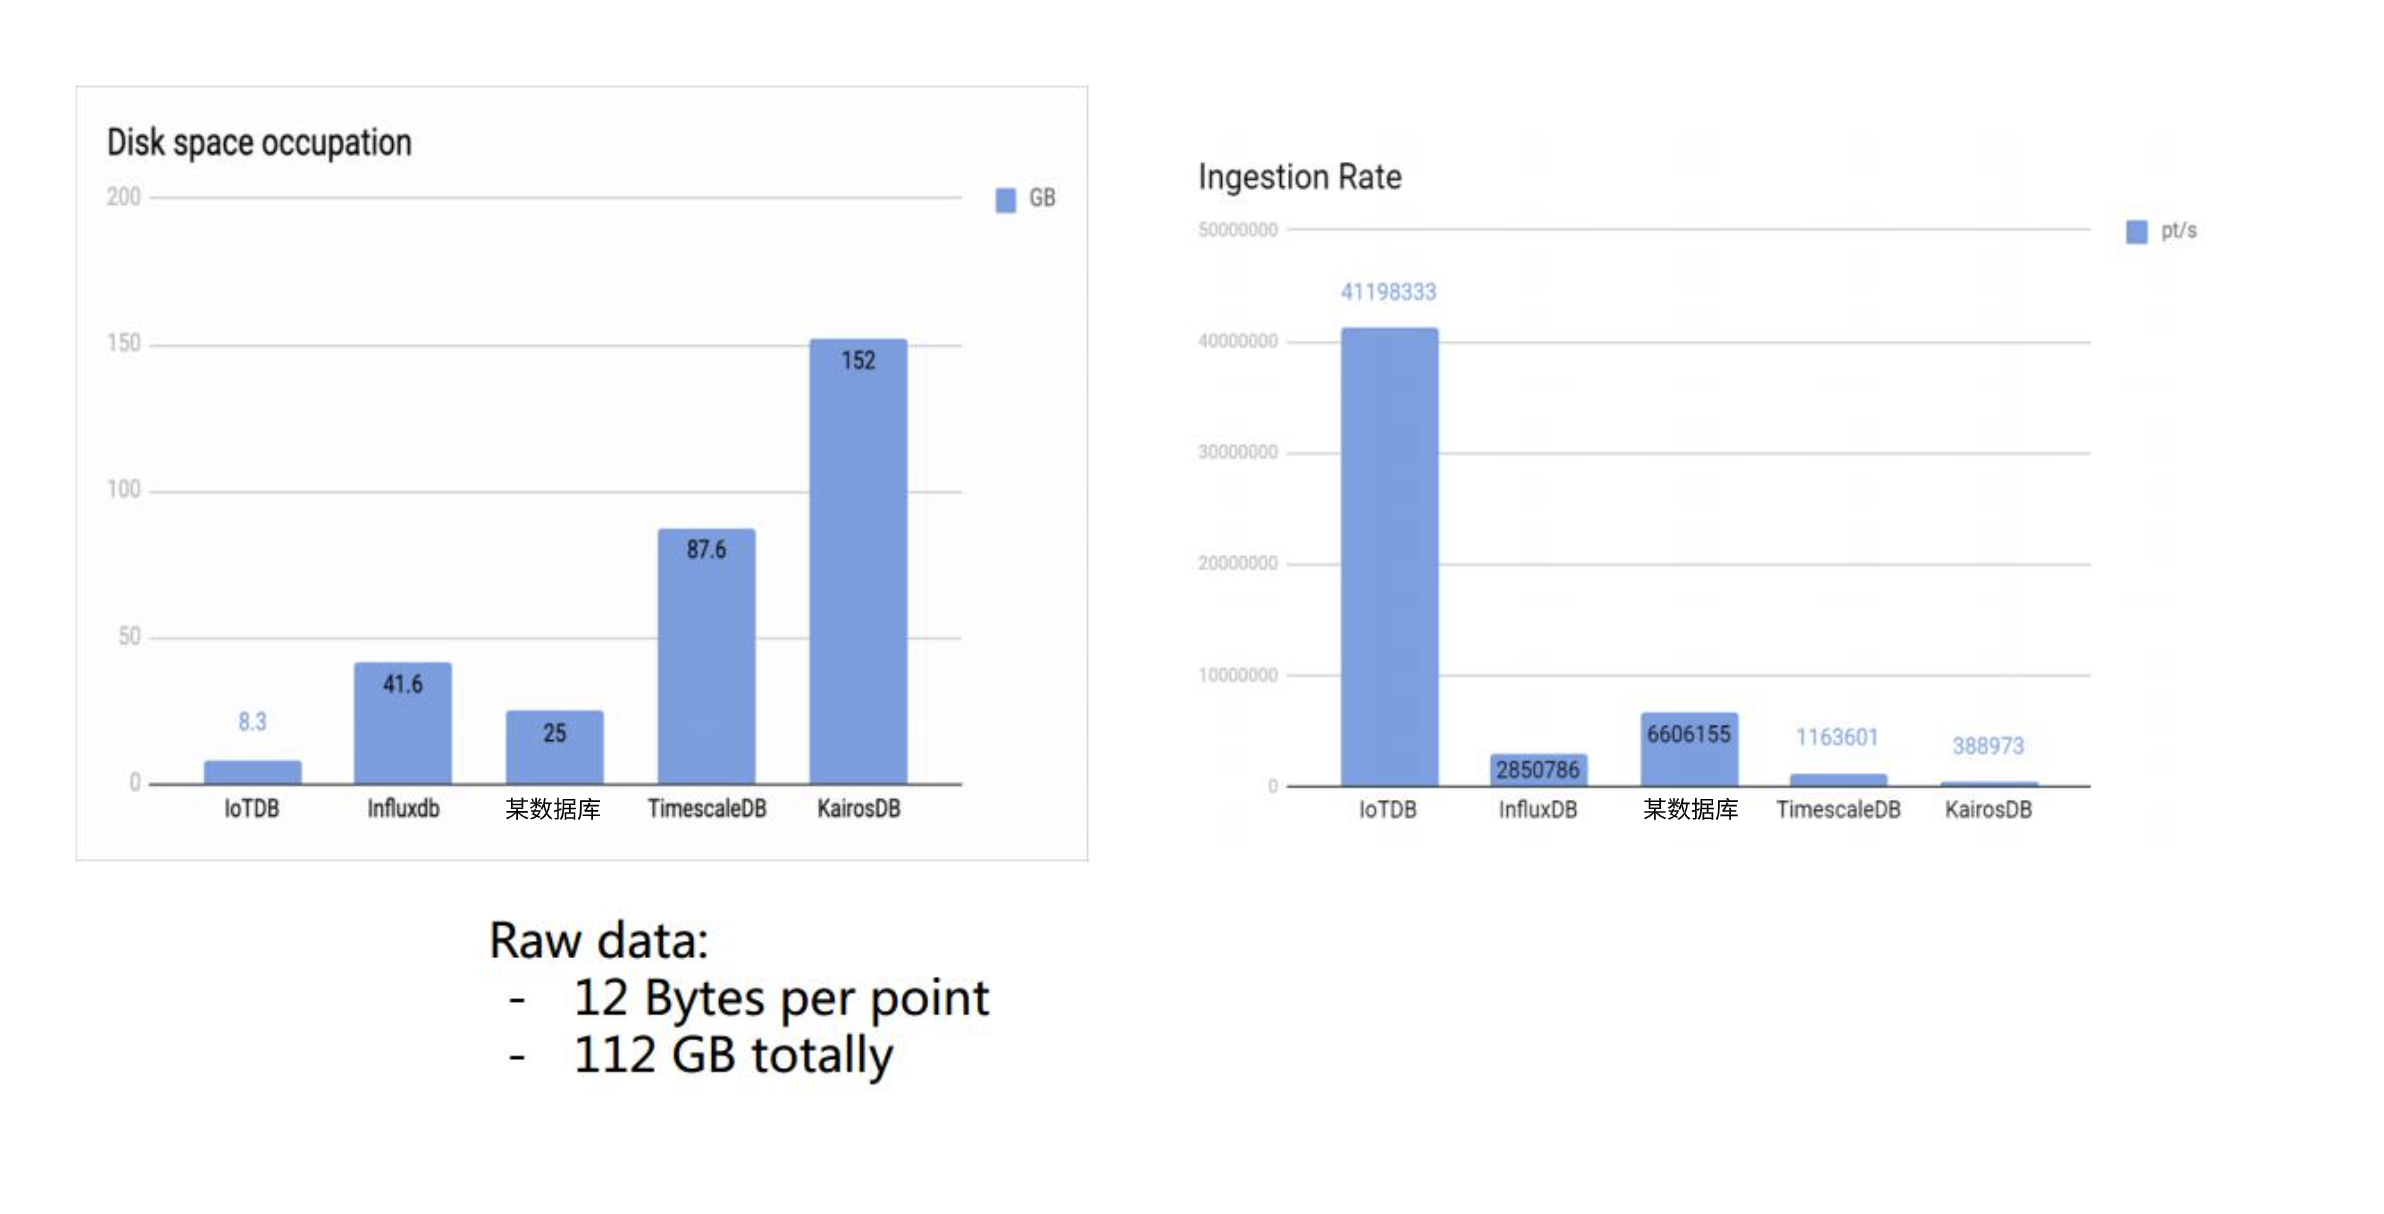
IoTDB 是一款时序数据库,相关竞品有 Kairosdb,InfluxDB,TimescaleDB等,主要使用场景是在物联网相关行业,如:车联网、风力发电、地铁、飞机监控等等,具体应用案例及公司详情可以查看:IoTDB在实际公司中的使用信息收集 IoTDB 模块主要分为Client,JDBC,Server,TsFile,Grafana,Distribution 以及各种生态的连接器。整个系列的文章会从行业背景开始讲起,了解一个行业具体的使用场景,然后介绍 TsFile 是以什么样的格式来保存数据的,再介绍 Server 里怎样完成一次查询,最后在介绍一条完整的 SQL是怎样从 Client 使用 JDBC 到 Server 直至返回具体结果。如果有能力的话再介绍一下集群的一些内容和工作方式。 打一波广告本人专注车联网领域多年,现任四维智联架构师。目前正在参与 IoTDB 社区,有志同道合的同伴欢迎加微信:liutaohua001 这一章主要想聊一聊: 为什么重复造轮子,从物联网行业的数据特点到 IoTDB 的发展过程 这个轮子造的怎么样,IoTDB 和竞品测试对比 时序数据 我个人理解时序数据是基于时间维度的同一个物体或概念的值构成的一个序列数据。在传统关系型数据库中,例如 MySQL,我们通常会放置一个自增的 Id 列作为主键标识,如下: Id 人名 体温 测量时间 1 张三 36.5 2020-02-06 9:00:00 2 李四 36.9 2020-02-06 9:00:00 3 王五 36.7 2020-02-06 9:00:00 4 张三 36.3 2020-02-06 9:30:00 5 张三 36.9 2020-02-06 11:00:00 上面的表结构就是一个时序数据,将表结构做个变形更容易理解: 时间戳 人名 体温 1580950800 张三 36.5 1580950800 李四 36.9 1580950800 王五 36.7 1580952600 张三 36.3 1580958000 张三 36.9 如果把时间作为一个唯一键对齐展示,能够更像时序数据一些,这也是 IoTDB 中查询结果的展示方式: 时间戳 张三 李四 王五 1580950800 36.5 36.9 36.7 1580952600 36.3 NULL NULL 1580958000 36.9 NULL NULL 这里可能会存在疑问就是假如人数是逐渐增加的,那么是动态创建列呢?还是提前创建足够多的列?这个问题等后面文章有机会继续介绍 物联网 物联网的特点是都会存在一个或多个设备,他们以各种各样的形式组织到一起,用来观测或记录同一时间里相同环境所产生的数据。下面的介绍中,使用由简单到复杂的数据逐步介绍在物联网行业中,通用的一些问题和方向。 1.基本存储 假如我是一个公司,对外播报北京、天津、上海三地的温度数据,从而实现盈利。 时间戳 北京 天津 上海 1580950800 20.5 22.9 21.7 1580952600 20.5 NULL 22.9 1580958000 20.5 21.7 22.9 2.保证数据质量 数据保证的质量是多方面的,一步一步介绍。 2.1 更多设备 首先可以看到上面数据是存在 NULL 值的,这个 NULL 值有可能是因为当时设备所在的区域停电了,所以并没有办法上报当时的情况,这样客户如果想获取1580952600 这个时间戳对应的天津的数据的时候,肯定是拿不到了,所以传统思维上,我们应该增加一个容灾设备,保证一个设备在坏掉、停电、人为损坏等等的情况的时候,依然能够有数据上报回来。 基于这样的思想,以上的表结构就会变成: 时间戳 北京 1 北京 2 天津1 天津2 上海1 上海2 1580950800 20.5 20.9 21.7 20.9 20.7 21.7 1580952600 21.5 21.0 NULL 21.7 21.7 21.7 1580958000 22.5 22.7 22.9 22.7 NULL NULL 2.2 更高采样频率 这时候依然存在问题, 1580958000 这一刻两个设备都没有数据,有可能是放置设备的区域同时出现了断网或者断电,这种情况下,我们可以采用提高采集数据的频率或者补传数据来解决(补传暂不讨论)。 我们将每天数据分为3组,每组采样3次,间隔为1个小时,假如时间分布为:上午(7、8、9)、中午(12、13、14)、下午(18、19、20)。当增加了采样频率之后,即便某一刻出现了 NULL 数据,我们也可以采用临近时间做为补充。为了方便对应,下表数据中增加时间点列辅助查看。 时间点 时间戳 北京 1 北京 2 天津1 天津2 上海1 上海2 7点 1580943600 20.5 20.9 21.7 20.9 20.7 21.7 8点 1580947200 21.5 21.0 NULL 21.7 21.7 21.7 9点 1580950800 22.5 22.7 22.9 22.7 NULL NULL 12点 1580961600 20.5 20.9 21.7 20.9 20.7 21.7 13点 1580965200 21.5 21.0 NULL 21.7 21.7 21.7 14点 1580968800 22.5 22.7 22.9 22.7 NULL NULL 18点 1580983200 20.5 20.9 21.7 20.9 20.7 21.7 19点 1580986800 21.5 21.0 NULL 21.7 21.7 21.7 20点 1580990400 22.5 22.7 22.9 22.7 NULL NULL 可以看到经过各种各样的需求之后,上传的数据是成倍增长的,不难想象如果这个温度数据希望精准的获取到每个县城的温度,那么中国有 2854 个县城 * 2 个温度设备 * 9 条数据 = 1 天产生的数据总量 = 51372 条,那么一个月就是 1541160 条。 数据实时性及总量 假如上面的数据我们继续提高频率到每1分钟每个设备上报一次,那么数据量就会成为 2854 * 2 * 60 * 24 = 246585600 条/天。 在这样的数据量下,实时插入实时做一些聚合计算,应该传统数据库就有些处理不过来了。 IoTDB 的前身 某公司在实际业务中,20 万设备保存了 3 年的数据,TB级别的数据使得 Oracle 被拖的根本吃不消。关键的问题点还不仅仅是存量数据大,新增数据依然以非常快的速度在增长。后来公司联系到了 IoTDB 的第一批开发者,但是当时的方案还是基于 Cassandra 来做设计,当时规划了 5 台机器的集群,性能刚满足,但随着时间推移设备总量在增加,业务系统的查询请求量在增加。Cassandra 在经过大量的努力之后,最后发现如果再改可能就需要大面积的重构 Cassandra 数据的代码了,最终决定重新设计一个存储方式,来解决物联网场景下的时序数据高效写入、低延迟读取、高压缩比持久化。 PS: 以上都是黄向东 (IoTDB PPMC) ,在 meetup 中讲到的,我只是在脑中存留了一部分,具体的细节大家可以到 IoTDB 社区交流。 性能对比 测试工具使用的是由清华大学大数据实验室开发的iotdb-benchmark 1.写入性能对比 数据集2 客户端 存储组 设备 变量 batchsize LOOP 数据量 写入速度(point/s) 硬盘数据大小 IoTDB 10 10 10 10 1000 1000000 1E+11 24750321.93 38306092 InfluxDB 10 10 10 10 1000 1000000 1E+11 304682932 TimescaleDB 10 10 10 10 1000 1000000 1E+11 737689.22 1610219064 数据集1 客户端 存储组 设备 变量 batchsize LOOP 数据量 写入速度(point/s) 硬盘数据大小 IoTDB 10 10 10 10 1000 100000 10000000000 20706345.15 3599732 InfluxDB 10 10 10 10 1000 100000 10000000000 1729907.81 30546560 TimescaleDB 10 10 10 10 1000 100000 10000000000 715857 161026468 KairosDB 10 10 10 10 10000 10000 10000000000 24924.97 76263380 上面一组数据可以看出写入性能高于同款数据库10倍有余,单机写入速度高达到每秒2千万。且硬盘占用是最小的,这在数据比较大的线上业务中,可能每个月会差出来 1 到 2 块硬盘。 2. 查询性能对比 原始数据查询 客户端 存储组 设备 序列-数据量 变量 查询点数 LOOP 速度(point/s) AVG MIN IoTDB 10 10 10 1.00E+09 1 1000000 100 12942984.85 740.27 457.04 InfluxDB 10 10 10 1.00E+09 1 1000000 100 1779606.4 5591 4666.39 TimescaleDB 10 10 10 1.00E+09 1 1000000 100 3781467.52 2345.69 1193.78 聚合数据查询 客户端 存储组 设备 序列-数据量 变量 LOOP 范围 速度(point/s) AVG MIN IoTDB-1 10 10 10 1.00E+09 1 100 0.0001 49.75 27.87 18.03 IoTDB-2 10 10 10 1.00E+09 1 100 0.001 49.75 49.14 19.87 IoTDB-3 10 10 10 1.00E+09 1 100 0.01 49.76 48.69 22.32 IoTDB-4 10 10 10 1.00E+09 1 100 0.1 48.68 99.14 25.56 IoTDB-5 10 10 10 1.00E+09 1 100 1 14 595.61 45.54 InfluxDB-1 10 10 10 1.00E+09 1 100 0.0001 234.32 40.28 21.63 InfluxDB-2 10 10 10 1.00E+09 1 100 0.001 28.88 341.9 238.1 InfluxDB-3 10 10 10 1.00E+09 1 100 0.01 3.07 3226.87 2664.86 TimescaleDB-1 10 10 10 1.00E+09 1 100 0.0001 42.39 220.57 120.5 TimescaleDB-2 10 10 10 1.00E+09 1 100 0.001 5.8 1502.9 754.15 TimescaleDB-3 10 10 10 1.00E+09 1 100 0.01 1.02 9711.55 7148.69 3. 对比图 整体来看 IoTDB 无论在写入、原始数据查询还是聚合查询,都几乎是10倍的性能于竞品数据库,而且硬盘占用又小于同款数据库10倍,那么 IoTDB 是怎样完成如此高的压缩比、如此恐怖的写入速度、如此高效的查询呢?欢迎继续关注。。。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册