首页 文章 精选 留言 我的

精选列表

搜索[基础搭建],共10000篇文章
优秀的个人博客,低调大师

用Tensorflow搭建预测磁盘性能的机器学习模型

前言:这篇文章的内容是去年上家公司参加部门code hackthon活动上运用了一些简单的Tensorflow机器学习模型,做的一个预测磁盘性能的小工具。因为和现在所做的行业和工作内容有些一定差距,就不详述应用的详细场景。google今年的开发者大会上定位所有的方向主攻“AI First”,相信机器学习将来会越来越多的提高大家的工作效率,也希望以后能用机器学习来给业务赋能。 背景:企业级存储器在目前应用在众多银行和大企业中,目前主流的存储,底层介质依然还是性价比高的磁盘(价格便宜,容量大),不过由于flash的强势崛起,新的中高端存储会越来越多的使用flash做为其存储介质。在实际使用中,不同企业在存储数据的时候应用场景不一样,有些是频繁,小批量;有些是单次大文件;有些是无规律的写入大小数据。不同存储在这些应用场景下,性能差距会比较大。这会导致销售人员在前线了解到需求后,需要测试部门模拟相应的场景,来给出存储的具体性能数据,这种场景可能需要花费一周才能拿到性能数据。 目标:收集足够多的磁盘性能原始数据,选择合适的机器学习模型来仿真性能数据。以后销售人员在评估性能的时候,只需要将数据输入到系统中,就可以得出一个较合理的结果。 说明:影响磁盘性能有30多个因素,在初期的模型中选择了特征显著的9个参数,磁盘性能的结果也有10多个维度来表示,这里选择了2个特征值。 直接贴: import tensorflow as tfimport numpy as npimport csvimport timefrom sklearn.preprocessing import StandardScaler input_ = []output1_ = []output2_ = []data_lenth = 1000with open('train_5.csv') as f:f_csv = csv.reader(f)headers = next(f_csv)for row in f_csv:num_row = [ float(i) for i in row ]input_.append(num_row[0:9])output1_.append(num_row[9:10])output2_.append(num_row[10:11]) my_X = np.array(input_[0:data_lenth])my_Y1 = np.array(output1_[0:data_lenth])my_Y2 = np.array(output2_[0:data_lenth]) scaler_x = StandardScaler().fit(my_X)scaler_y1 = StandardScaler().fit(my_Y1)scaler_y2 = StandardScaler().fit(my_Y2) trX = scaler_x.transform(my_X)trY1 = scaler_y1.transform(my_Y1)trY2 = scaler_y1.transform(my_Y2)print(" starting normalize *")time.sleep(2)print(" normalize input data *")print(trX)print(" normalize response_time_rnd *")print(trY1)print(" normalize response_time_seq *")print(trY2) 创建两个占位符,数据类型是 tf.float32 X = tf.placeholder(tf.float32)Y = tf.placeholder(tf.float32)biases = tf.Variable(tf.zeros(1) + 0.1) 创建一个变量系数 w , 最后训练出来的值,应该接近 2 w = tf.Variable(tf.zeros([1, 9]), name = "weights")y_model = tf.multiply(X, w)+biases 定义损失函数 (Y - y_model)^2 cost = tf.square(Y - y_model) 定义学习率 learning_rate = 0.01 使用梯度下降来训练模型,学习率为 learning_rate , 训练目标是使损失函数最小 train_op = tf.train.GradientDescentOptimizer(learning_rate).minimize(cost) with tf.Session() as sess: 初始化所有的变量 init = tf.global_variables_initializer()sess.run(init) 对模型训练100次 for i in range(100): for (x, y) in zip(trX, trY1): sess.run(train_op, feed_dict = {X: x, Y: y}) 输出 w 的值 W = sess.run(w) 输出 b 的值 B = sess.run(biases) test_input = np.transpose(np.transpose(np.array([100,5000,4000]))) test_input = np.transpose(np.transpose(np.array([50,100,5000,4000,70,20,40,90,1000000])))W = np.transpose(W) print(" testing response_time_rnd *")print(W)print(B)print("testing data: ")print(test_input)test_X = scaler_x.transform(test_input)print(test_X)test_output = np.dot(test_X,W)+Bprint("result data(response_time_rnd): ")print(scaler_y1.inverse_transform(test_output)) with tf.Session() as sess: 初始化所有的变量 init = tf.global_variables_initializer()sess.run(init) 对模型训练100次 for i in range(100): for (x, y) in zip(trX, trY2): sess.run(train_op, feed_dict = {X: x, Y: y}) 输出 w 的值 W = sess.run(w) 输出 b 的值 B = sess.run(biases) W = np.transpose(W)print(" testing response_time_seq *")print(W)print(B)print("testing data: ")print(test_input)test_X = scaler_x.transform(test_input)print(test_X)test_output = np.dot(test_X,W)+Bprint("result data(response_time_seq): ")print(scaler_y1.inverse_transform(test_output)) 此处的入参需要做归一化处理,不做归一化,数据量达到一定量时就会出现不收敛的情况。 scaler_x = StandardScaler().fit(my_X)scaler_y1 = StandardScaler().fit(my_Y1)scaler_y2 = StandardScaler().fit(my_Y2)矩阵运算的转置处理。 trX = scaler_x.transform(my_X)trY1 = scaler_y1.transform(my_Y1)trY2 = scaler_y1.transform(my_Y2)这部分是模型的核心,注释说明比较清楚。 创建两个占位符,数据类型是 tf.float32 X = tf.placeholder(tf.float32)Y = tf.placeholder(tf.float32)biases = tf.Variable(tf.zeros(1) + 0.1) 创建一个变量系数 w , 最后训练出来的值,应该接近 2 w = tf.Variable(tf.zeros([1, 9]), name = "weights")y_model = tf.multiply(X, w)+biases 定义损失函数 (Y - y_model)^2 cost = tf.square(Y - y_model) 定义学习率 learning_rate = 0.01 使用梯度下降来训练模型,学习率为 learning_rate , 训练目标是使损失函数最小 train_op = tf.train.GradientDescentOptimizer(learning_rate).minimize(cost) with tf.Session() as sess: # 初始化所有的变量 init = tf.global_variables_initializer() sess.run(init) # 对模型训练100次 for i in range(100): for (x, y) in zip(trX, trY1): sess.run(train_op, feed_dict = {X: x, Y: y}) # 输出 w 的值 W = sess.run(w) # 输出 b 的值 B = sess.run(biases) 结果:因为对数据做了奇异值处理,所以用模型跑出来的结果八成以上是符合预期的,不过当实际存在较多奇异点的时候,准确率会下降到六至七成。而且原始数据的量还不够,也会导致现实场景奇异点较多。后续考虑用多层神经网络模型来模拟这种场景,在数据源足够的情况下,结果会更加符合预期。 附件说明: py文件是包含QT界面的完整文件 csv文件是数据素材

优秀的个人博客,低调大师

搭建云存储,对比私有云和公有云的不同

【大咖・来了 第7期】10月24日晚8点观看《智能导购对话机器人实践》 云存储这样的隐喻或许感觉会有些夸张,但我们从中仍能感觉到和云相关的模糊的概念,对于这项技术的未来也是充满了未知,这对我们熟知的私有云存储也是一样。虽然市场上各种宣传的私有云存储都声称自己受益于在原有公有云上增加了防火墙,然而却有迹象表明私有云存储的名声却逐渐降到公共存储之下。 说起公共存储,很难不与后网络公司时代的选择性外包联系起来,但尽管如此,它还是具备着简单和固有的可用性。公共存储的名字听起来也缺乏专有性,很像是把东西直接堆放在那里而不会得到有序的管理。并且说实话,“公用”这个词听起来还是没有“云”来的酷。 私有云和公有云有何不同? 名字的改变不会改变其本质,它仍然是一种能提供更好服务的存储架构技术。我们不得不承认的是,不管选择的是哪个品牌的产品,企业都会受益于所选择的私有云架构。从某种意义上来说,私有云市场的产生是公有云发展的结果。有一条我们不得不承认的是,不管是公有云还是私有云,存储是云解决方案的不可替代部分。尤其是对服务器虚拟化来说,可以让云计算得以应用。虽然如此,要保证云的成功部署,一个成熟的存储战略是十分必要的。 和公有云存储的优势相比后,我们发现私有云存储有如下的一些特点: 可用性。在用户需要的时候,空间需要能够被及时分配,并且要求能在使用完后及时的收回。 服务质量。需要有详细的服务水平描述并严格参照执行。可衡量的标准可以用于定义用户能得到怎样的响应时间、恢复时间以及活动时间的支持。 成本固定。云环境中通常是根据每单元存储收费的。用户只需根据服务水平协议对实际使用的部分付费,而不是根据分配的空间或者某一个标准。 在参看云存储价格表的时候,往往会看到一些诱人的优惠部分,但是谁会真正从中受益呢?公有云和私有云之间有着很明显的区别。在公有云架构中,用户和签订协议的组织将受益。对于用户来说,他们将得到所有应用上的支持,对于组织来说,成本相对固定,也许相比于自我维护一套系统要更加低廉。IT部门需要告诉云服务提供商平台即服务的精确定义。虽然业务部门的花费会相对固定,公有云同样有“用多少买多少”的退款优势,并且有具体的服务水平协议,而遗憾的是,这些标准不适应于IT部门。用户需要获得足够的存储空间并开始对其进行管理,会监控系统并开始详细的成本核算。 此外,需要注意的是,这些好处中并没有提到“使用***进的存储阵列”、“最快的磁盘”或者“10Gb的以太网”。事实上,并没有相关的技术准则。公有云主要关注的是更好的运营:服务水平、成本控制以及快速响应能力。然而存储厂商们往往不会专注于运营方面的问题,他们只是卖硬件和软件。那么对于私有云,这些厂商们到底会卖些什么呢?可以确信的是,绝对不会只是硬件上的升级和一次臆想。幸运的是,这一点得到了确认。只要能把私有云应用于正确的环境和配置上,就绝对不会只是硬件上的概念。 在谈到云架构的时候,一些厂商强调于可扩展性和灵活性上的需求。可以确信的是,成本相对低的云架构模型会更有吸引力。但是几乎所有的厂商都会声称他们有这样那样的属性,因此这些定义就显得不那么有用了。此外,云部署不单指硬件上的架构,因为云发展到***,流程上的意义将大于产品本身。

优秀的个人博客,低调大师

Flask一步步搭建web应用

1.flask介绍 flask是一款十分轻量级的python Web应用框架,也被认为是一种微框架,我最初喜欢使用是因为flask中提供的那一套使用的注解跟我当时在公司中使用java开发的系统,里面使用的restful的框架jersey的用法比较像,都十分方便,简洁,等到我熟悉使用flask框架之后,就挺喜欢这种微框架了,使用方便,配置简单,也可以进行克重扩展,满足各自的需求,其中在这些里面还有一个flask restplus,将swagger工具整合到python里面,在进行相应测试的时候十分方便,这个放到下一期再讲。 2.所需工具和环境 这一次运行flask需要使用的flask环境就不在物理机上安装运行了,直接使用上一篇讲述的virtualenv来安装flask,写出来的app demo都是依赖在虚拟环境运行的,以下是我们这次演示所

优秀的个人博客,低调大师

搭建网站必不可少的知识4

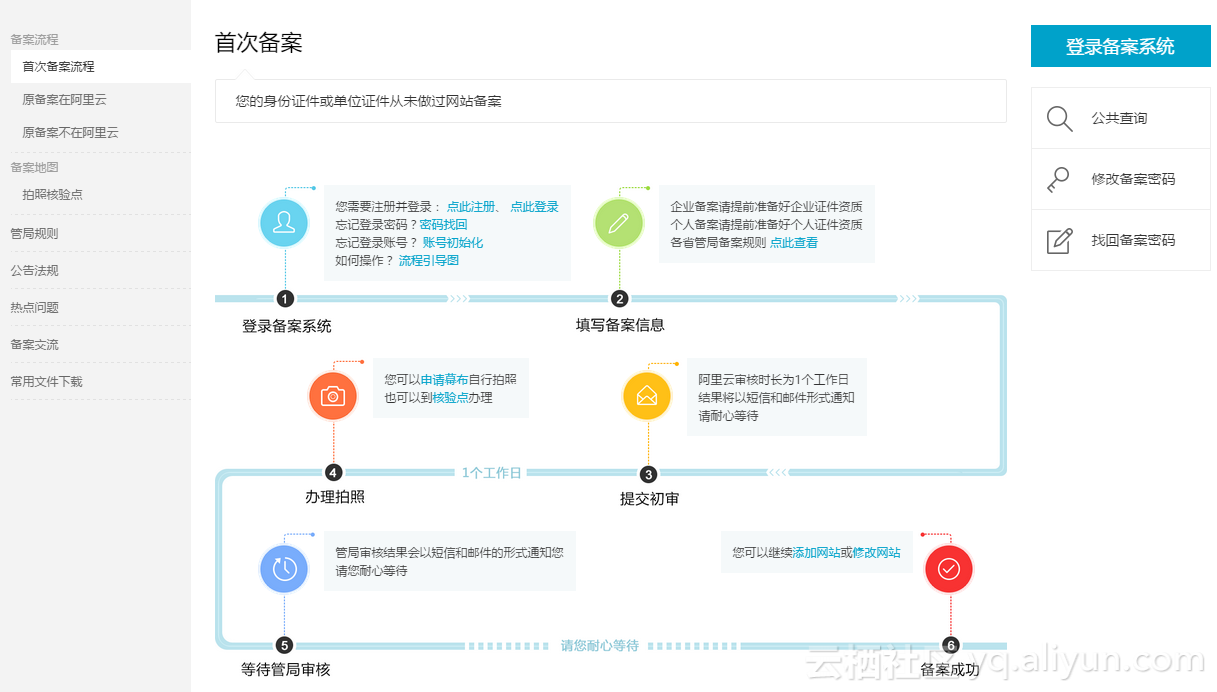
网站备案网站备案比域名备案麻烦很多,时间也比较长,企业备案15天左右,个人20天左右,时间只是大约时间,具体通过日期还得看交管局的审核速度。在审核期间我们的网站最好是无法解析也就是关闭网站不能访问,这样通过率就比较大,在备案期间浪费的时间空间商会进行补偿,这一点不会亏损的。打开备案页面https://beian.aliyun.com 页面上有简要的备案流程,我们点击右侧的“登录备案系统”,输入登录密码登录,如果登录不上或者没有注册请先注册后登录,然后看到备案后台了。办理首次备案,简单分为以下4步:1、注册备案账号2、登录备案系统,按要求填写备案信息,并提交至备案初审该操作中需要上传电子版证件资料个人备案请提前准备好个人证件扫描件或照片,例如身份证、护照等企业备案请提前准备好企业证件及负责人证件扫描件或照片,例如营业执照、组织机构代码证等3、收到初审结果,按要求办理拍照4、等待管局审核结果首次备案流程图如下: 1.登录阿里云账号 2、登陆备案系统,填写备案的域名及主体证件信息,系统核实域名及主体证件号码未存在已备案记录,判断此次备案为首次备案。 3、填写产品信息验证,不同的产品验证方式也不同,需要申请服务号备案服务号介绍:您在购买阿里云ECS、SLB、弹性web托管、建站市场产品后,通过阿里云备案过程中,需要使用备案服务号进行产品验证。如您购买的是万网云虚拟主机,是使用主机管理账号和管理密码进行验证,请点击查看具体说明温馨提醒: 服务号申请需登录购买服务器的账号中操作 每个产品服务号申请有所限制,ECS需购买包年/包月且有公网带宽的;弹性web托管需购买时间在6个月以上 ECS、SLB可申请5个服务号,建站市场只能申请1个服务号,购买弹性web托管每个会员账号只能申请5个服务号 备案成功后已使用的备案服务号即作废,不能再用于其他网站域名的备案,也不可释放重复使用,或删除再次申请。具体申请操作步骤如下,以ECS服务器申请为例: 购买阿里云ECS服务器后,登录管理控制台,在左侧用户中心里点击备案管理 2.在备案服务号申请中的ECS产品类型中,选择您需要申请服务号的主机,并点击申请按钮 3.点击确认申请服务号 4.确定后可在备案服务号管理中查询申请的服务号信息 点击“去备案” 6、填写主体信息 7、填写网站信息,如有多个网站提交申请,在填写完网站信息可点击“保存,并继续添加网站” 8、如无其他网站备案,直接上传备案资料 9、因审核期间如遇到问题,会拨打您备案信息中的联系电话进行沟通,请保持电话畅通 10、提交备案至初审 11、初审通过后,登陆备案系统申请幕布,收到幕布后自行拍照并上传照片审核(拍照前请先查看拍照说明,并避免身着红色或蓝色上衣进行拍照) 12、提交照片,完成审核 13、等待管局审核 14、备案成功;审核结果将以短信及邮件形式通知 在备案过程中不明白可以在论坛或者联系客服询问,备案一般提交网上资料还会要求邮寄资料,具体页面会提示,按照提示操作即可。不会的可以联系我咨询。另外很不幸的是很多地区已经开始要求ICP公安备案了,也就是说这个网站备案完还要进行公安备案(^∇^*)无奈吧。如果接到他们通知要去当地进行备案,更如果是论坛备案,阿西吧你要有安全员证书(一个人800RMB培训)具体看他们要求,反正总结一句如果感觉麻烦去用免备案主机。

优秀的个人博客,低调大师

搭建网站必不可少的知识2

什么是空间?网站空间英文名:WebSite host。主要用来存放网站文件,比如网站代码、图片、文件、数据库等等,网站空间类似做生意要租店铺一样,有时间限制,买了之后会分给你解析地址,然后绑定域名,就可以访问网站了。通常小企业和个人喜欢购买虚拟主机,这种是网站运行环境都配置好的,直接购买使用即可。复杂点的就是购买服务器,这种价格就比虚拟主机贵了。 虚拟主机:90%以上的企业网站都采取这种形式,主要是空间提供商提供专业的技术支持和空间维护,且成本低廉,一般企业网站空间成本可以控制在100-1000元/年之间。可以将其理解为网络服务器上分出一定的磁盘空间,用户可以租用此部分空间,以供用户放置站点,提供必要的数据存放和传输功能。现在网上卖的这种是面板控制,大多通过FTP进行上传的,价格几十块钱到几百不等,共享IP的更便宜但是容易受到其他空间的牵连(比如被攻击),独立IP的就可以域名和IP都可以访问站点,价格高点。如果是新手推荐在某宝上买一个月试试或者直接联系先试用一天,不推荐大量购买以免跑路。(不懂的可以在群内联系我哟)合租空间:中型网站可以采用这种形式,一般是几个或者几十个人合租一台服务器。独立主机:安全性能要求极高以及网站访问速度要求极高的企业网站可以采用,成本较高。云主机:类似虚拟主机,是新一代的主机租用服务,它整合了高性能服务器与优质网络带宽,有效解决了传统主机租用价格偏高、服务品质参差不齐等缺点。VPS:独立主机上划分的一块空间,拥有独立的操作系统。 小编:如果是新手可以配合域名(在阿里云买)+空间(在某宝买)=实惠 这种方式主要是为了保证域名的安全性,很多企业找人做的一条龙服务,哪天人家不干或者换了,企业的网站就找不回来了,在这里也要说一下如果企业找人做网站一定要域名管理权和网站源码,不然就是遇到黑心服务商了。练手在某宝买个玩玩,各种练习玩耍,价格买国际com域名50左右+空间一年大约30看实际要求=一般百来块解决。小编不推荐去申请免费空间,总结这种空间叫浪费时间,图财害命,得不偿失。玩网站长了可以考虑剩下的空间了,外贸企业推荐用国外的空间,这样访问速度快,当然国外空间被用到在国内访问速度就比不上国内的主机了。如果想两者兼得推荐香港的,离国内近,国外访问速度也快。 列举一些空间商:国内:阿里云、腾讯云、新网、西部数码等等国外:Bluehost、IX Web Hosting、Hostmonster、justhost等等上面国外主机商只是美国的主机商,日本等等这些也有很多,买的时候一定要多查阅和对比不要只图便宜,他的售后服务和退款等一定要关注。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册