首页 文章 精选 留言 我的

精选列表

搜索[LLM],共5758篇文章
优秀的个人博客,低调大师

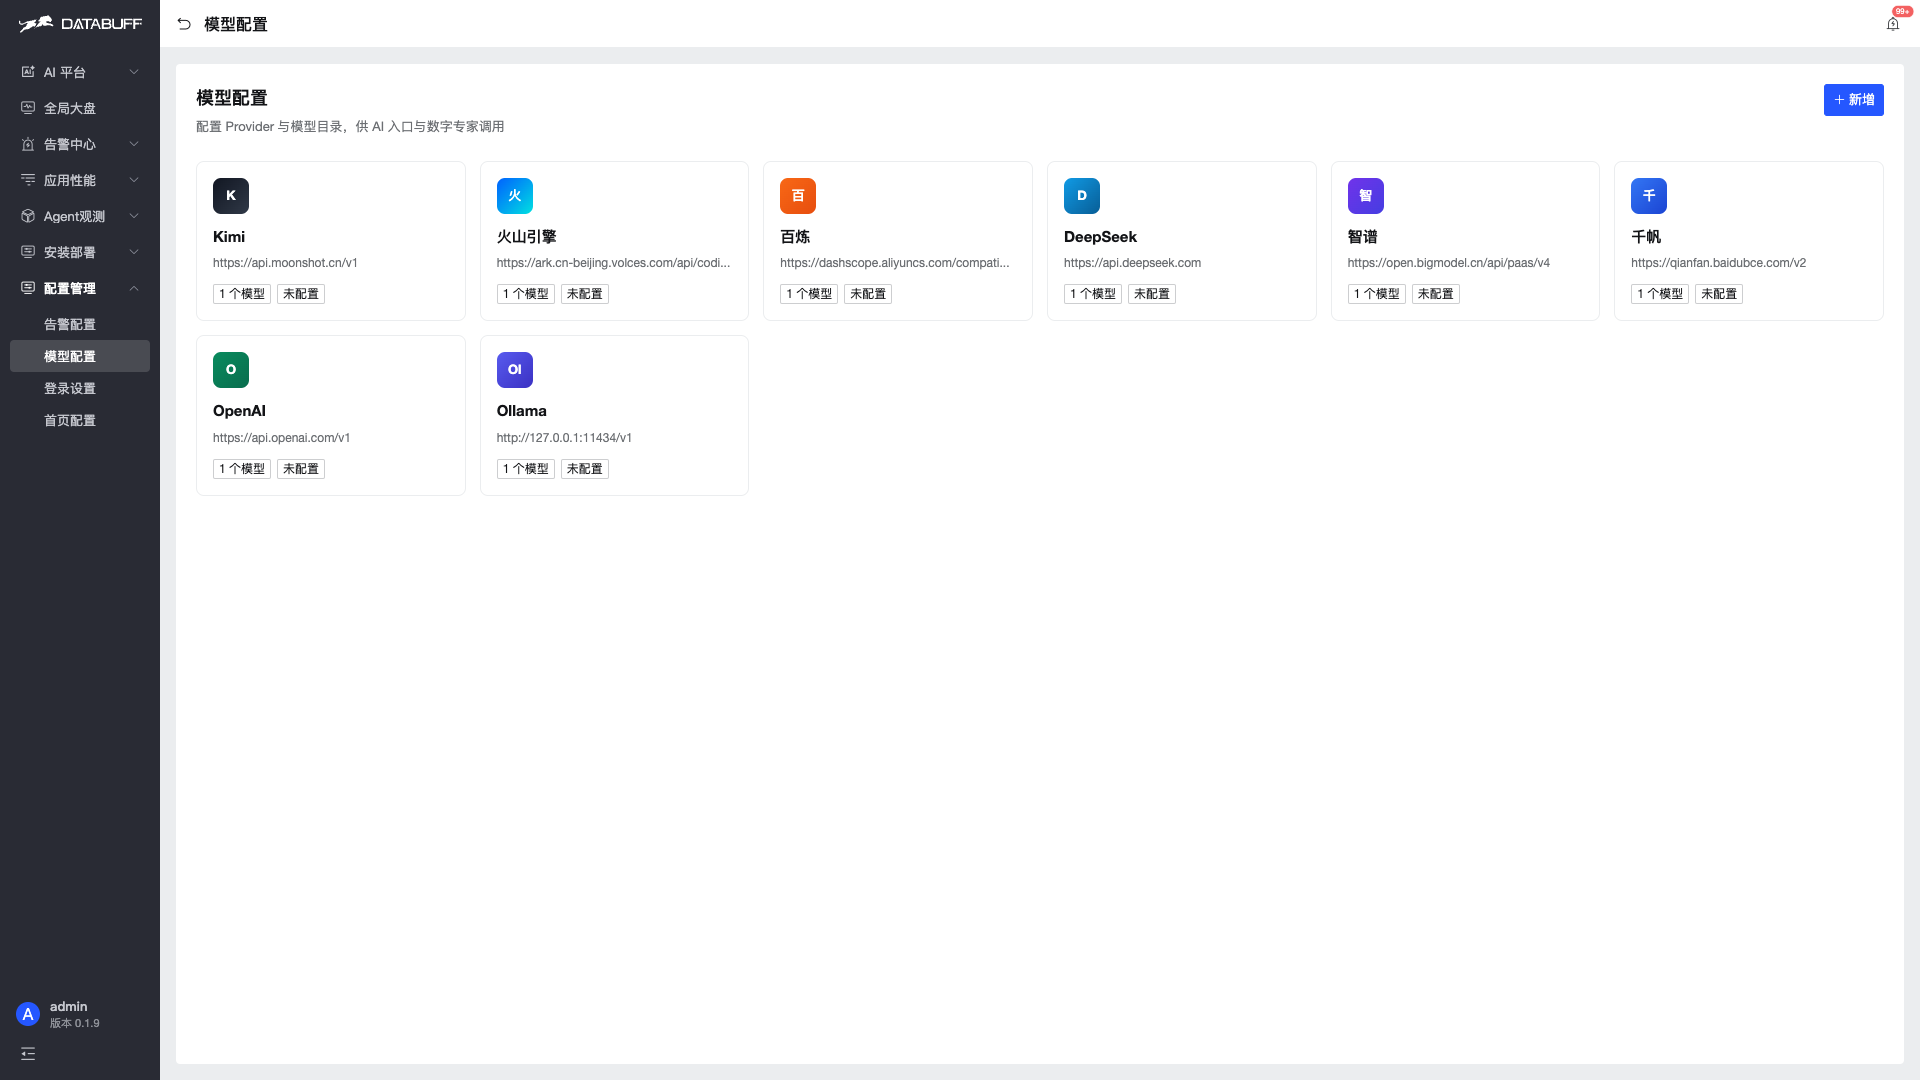
Dify 部署教程:私有化 LLM 应用平台搭建与模型接入

## 摘要 Dify 是开源的大模型应用开发平台,提供可视化工作流编排、知识库检索、智能体框架和 API 发布能力,让「把模型变成可用的应用」这件事不必从零写代码。本文完成 Dify 社区版的私有化部署,包含资源规划、Docker Compose 启动、模型供应商接入、知识库配置、API 调用与反向代理,并说明多容器架构下的常见故障定位方法。 ## 一、Dify 解决什么问题 拿到一个能对话的模型之后,距离可用的业务应用还有不少工作:提示词要管理和版本化、文档要切分和向量化才能被检索、多步骤流程要编排、对话历史要存储、还得暴露 API 给其他系统调用。这些工程工作自己搭一遍要花不少时间。 Dify 把这些能力封装成平台: - **可视化工作流**:把模型调用、条件判断、工具调用、数据源串成流程,不用写胶水代码。 - **知识库检索**:上传文档后自动完成切分、向量化和索引,支持基于文档内容的问答。 - **智能体框架**:构建能调用工具的智能体。 - **模型无关**:可以接入不同厂商的模型 API,也能接本地部署的模型。 - **API 优先**:每个构建好的应用自动获得可调用的接口。 选择私有化部署而非云端服务的理由通常是:处理的数据不便上传到外部服务、需要控制使用哪些模型、或希望把整套 AI 能力放在自己的基础设施里。 需要提前说明的是,社区版的默认部署方式适合中小规模使用。面向大量并发用户的生产场景,需要额外设计消息队列、多副本和负载均衡,这超出了本文范围。 ## 二、资源规划 Dify 不是单个进程,而是一组协同工作的容器,通常包括 API 服务、前端、后台任务处理、关系型数据库、缓存和向量数据库。这决定了它的资源需求比单体应用高。 |项目|最低要求|建议配置| | --- | --- | --- | |CPU|2 核|4 核及以上| |内存|4 GB|8 GB 及以上| |磁盘|50 GB|100 GB 及以上| |操作系统|Ubuntu 22.04 / 24.04 或 Debian 12|同左| 内存是这里的关键项。多个容器同时运行,4 GB 属于勉强能跑起来的下限,在文档批量导入和向量化时容易触发内存不足。如果打算实际使用知识库功能,建议直接 8 GB 起步。 关于是否需要 GPU:Dify 本身不做模型推理,它调用外部模型接口,所以不需要 GPU。只有当你打算在同一台机器上同时部署本地模型服务时,才需要考虑 GPU 和相应显存。两者也可以分开部署在不同机器上,Dify 通过网络调用模型服务。 前置条件:已安装 Docker Engine 与 Docker Compose 插件。执行以下命令确认: ``` docker --version docker compose version ``` 两条命令都能正常输出版本号才能继续。注意 Compose 命令是 `docker compose`(中间空格),旧版的 `docker-compose` 与之不通用。 ## 三、部署 Dify Dify 官方提供了完整的 Compose 配置,直接使用官方文件,不要自己拼装——各组件之间有版本对应关系,手写容易踩到兼容问题。 拉取代码并进入部署目录: ``` git clone https://github.com/langgenius/dify.git cd dify/docker cp .env.example .env ``` 编辑 `.env` 文件,重点关注几项配置: ``` nano .env ``` 必须修改的项: |配置项|说明| | --- | --- | |SECRET_KEY|会话加密密钥,务必改成随机长字符串| |DB_PASSWORD|数据库密码,改掉默认值| |REDIS_PASSWORD|缓存服务密码,改掉默认值| 生成随机密钥可以用: ``` openssl rand -base64 42 ``` `SECRET_KEY` 要在首次启动前就设定好。启动之后再改会导致已有会话失效。 默认端口如果与机器上其他服务冲突,可以在 `.env` 中调整对外暴露的端口。 启动服务: ``` docker compose up -d ``` 首次启动需要拉取多个镜像,总体积较大,耗时取决于网络速度。如果拉取缓慢,可以先配置容器镜像加速。 查看容器状态: ``` docker compose ps ``` 所有容器状态应为 `running`。有容器处于 `Exited` 状态时,查看它的日志定位原因: ``` docker compose logs api --tail 100 docker compose logs worker --tail 100 ``` ## 四、初始化与模型接入 **完成初始化** 在浏览器访问 `http://服务器IP/install`,创建管理员账号。这是第一个账号,自动获得管理员权限,凭据请妥善保存。 如果页面打不开,先确认端口已在控制台放通。轻量应用服务器在实例详情页的「防火墙」页签点击「添加规则」,协议选 TCP、填入端口、策略选允许;云服务器 CVM 在安全组的「入站规则」中添加。 **接入模型** 登录后进入「设置」→「模型供应商」。Dify 支持接入多种模型来源,选择方式取决于你的场景。 接入本地部署的模型服务时,以 Ollama 为例,填写: - 模型名称:与本地已下载的模型名一致,例如 `qwen2.5:7b`。 - 基础 URL:这一项最容易出错,需要按部署方式区分。 关于基础 URL 的填法,这是新手最常卡住的地方: |部署情况|应填地址| | --- | --- | |模型服务在宿主机,Dify 在容器|http://host.docker.internal:11434| |模型服务与 Dify 在同一 Docker 网络|http://容器服务名:11434| |模型服务在另一台机器|http://对方内网IP:11434| 填 `http://127.0.0.1:11434` 一定不通。因为在容器内,`127.0.0.1` 指向容器自己,而不是宿主机。 如果模型服务在宿主机上,还需要确认它监听的是 `0.0.0.0` 而非仅 `127.0.0.1`,否则容器无法连入。 配置完成后点击保存,Dify 会发起一次连通性校验。校验通过后模型才可在应用中选用。 **配置嵌入模型** 如果要使用知识库功能,除了对话模型,还需要配置一个嵌入模型用于把文档转成向量。这一步经常被漏掉,表现为知识库上传文档后一直处于处理中或直接报错。嵌入模型同样在「模型供应商」中配置。 ## 五、构建第一个应用 **基础对话应用** 进入「工作室」→「创建应用」,选择聊天助手类型。在编排界面: 1. 选择已配置的对话模型。 1. 填写系统提示词,定义助手的角色和回答风格。 1. 在右侧调试区输入问题,验证回答是否符合预期。 1. 确认无误后点击发布。 发布后应用会获得一个可访问的网页地址和一组 API 凭据。 **知识库问答** 进入「知识库」→「创建知识库」: 1. 上传文档,支持常见的文本和文档格式。 1. 选择分段方式。文档结构规整时用自动分段即可;文档层级复杂或段落很长时,手动调整分段大小和重叠长度效果更好。 1. 选择嵌入模型,开始处理。 文档处理需要时间,数量多时耗时较长。处理完成后在知识库的命中测试中输入问题,检查检索到的片段是否相关。这一步很关键——如果检索片段本身就不对,后面模型生成的回答一定不准,问题出在分段和检索配置,而不是模型。 然后在应用编排中关联该知识库,让应用回答时先检索文档再生成。 **API 调用** 在应用的 API 访问页面获取密钥,调用方式示例: ``` curl -X POST 'http://服务器IP/v1/chat-messages' \ -H 'Authorization: Bearer 你的API密钥' \ -H 'Content-Type: application/json' \ -d '{ "inputs": {}, "query": "你好", "response_mode": "blocking", "user": "test-user" }' ``` 返回 JSON 中包含回答内容即表示接口正常。 ## 六、验证部署是否成功 逐层确认,不要只看页面能打开。 容器全部健康运行: ``` docker compose ps ``` Web 界面可访问:浏览器打开服务地址,能正常登录。 模型连通性正常:在「模型供应商」中模型显示为可用状态。 对话链路通畅:在应用调试区提问并得到回答。这一步验证了从前端到 API 到模型的完整链路。 知识库检索有效:在命中测试中输入问题,返回的片段与问题相关。 API 可被外部调用:用 curl 成功获得响应。 后台任务正常:查看 worker 容器日志,确认没有持续报错。文档处理、异步任务都依赖 worker,它挂了的话表现是文档一直处理不完,而前端界面看起来正常。 ## 七、配置域名与 HTTPS 用 IP 加端口访问只适合测试。正式使用建议配置域名和 HTTPS,尤其是需要在移动端或跨网络访问时。 推荐用反向代理接管入口。先在域名服务商处添加 A 记录指向服务器公网 IP,解析生效后配置代理转发。以 Caddy 为例: ``` dify.example.com { reverse_proxy 127.0.0.1:80 request_body { max_size 100MB } } ``` `request_body max_size` 需要按知识库上传的文档大小调整。默认值偏小会导致上传大文件失败并返回 413,而这个错误在 Dify 界面上往往只显示为上传失败,看不出真正原因。 配置完成后,还需要在 Dify 的 `.env` 中把对外访问地址改为新域名,否则应用内生成的链接仍指向旧地址: ``` nano .env # 修改 APP_WEB_URL 等地址相关配置为 https://dify.example.com docker compose down && docker compose up -d ``` 服务器位于中国内地且使用域名对外提供服务时,需要先完成 ICP 备案。 ## 八、常见问题与排查 **容器启动后反复重启** 查看具体容器日志定位。常见原因:`.env` 中数据库密码与已初始化的数据库不一致(改过密码但没清理数据卷);内存不足被系统终止;端口被占用。 内存不足的特征是容器状态显示 `Exited (137)`。用以下命令确认内存压力: ``` free -h docker stats --no-stream ``` **模型连通性校验失败** 九成是基础 URL 填错。按第四节的表格核对填法。确认无误后,进入容器内部实测连通性: ``` docker compose exec api curl -I http://host.docker.internal:11434 ``` 不通说明是网络层问题,检查模型服务的监听地址和防火墙规则。 **知识库文档一直处于处理中** 先确认嵌入模型已正确配置,这是最常见原因。再查看 worker 容器日志,处理任务由 worker 执行,它异常时任务会一直挂着。文档数量大时处理确实需要时间,可以对比日志中的进度判断是卡住还是在正常处理。 **上传文档失败** 检查反向代理和 Web 服务器的请求体大小限制,两处都需要放宽。Dify 自身也有文件大小上限配置,可在 `.env` 中调整。 **回答质量不理想** 先区分问题出在检索还是生成。用知识库的命中测试单独验证检索效果:如果检索片段本身不相关,需要调整分段策略、增大重叠长度或更换嵌入模型;如果检索片段是对的但回答跑偏,则需要优化提示词,明确要求基于给定内容回答。 **响应缓慢** Dify 本身开销不大,延迟主要来自模型推理。如果用的是本地模型,检查模型服务的资源占用;如果调用外部 API,延迟受网络和对方服务影响。同时确认机器内存是否充足,内存紧张会导致容器频繁换页,整体变慢。 **升级后出现异常** Dify 迭代较快,部分版本升级涉及数据库结构变更。升级前务必备份数据卷并创建实例快照,并先阅读版本发布说明确认是否有需要手动执行的迁移步骤。 ## 九、维护与合规建议 **备份两部分数据**:数据库中的应用配置、对话记录和知识库元数据,以及存储卷中的原始文档文件。两者要一并备份,只备份其中一个恢复出来是不完整的。建议把备份同步到对象存储,不要只留在本机。 **变更前创建快照**:升级版本、调整配置前先给实例创建快照。轻量应用服务器在实例详情页的「快照」页签操作,通常 5 分钟内完成且无需关机。回滚会将整块系统盘恢复到快照时间点,之后写入的数据会被清除,运行中的实例会自动关机。使用存储型套餐的实例不支持创建快照。 **收紧访问范围**:Dify 后台包含所有应用配置和知识库内容,不应对全网开放。建议在防火墙规则中限制来源 IP,或通过反向代理叠加一层认证。 **数据授权边界**:上传到知识库的文档必须是你有权使用和传播的内容,不要把未获许可的第三方资料放进去。对外提供服务时,还需注意知识库内容不应包含个人敏感信息。 **输出内容审核**:模型生成的内容需要人工抽查,尤其是用于对外发布或辅助决策的场景。生成结果可能包含不准确信息,不宜直接采信。 **关注资源增长**:知识库文档和向量数据会持续占用磁盘,对话记录也会累积。定期检查磁盘水位,数据增长较快时可为数据目录单独挂载云硬盘。 部署完成后,如果需要在同一环境接入本地模型以降低对外部 API 的依赖,或需要给平台配置统一的域名入口和访问认证,可以作为下一步的工作。 需要 GPU 环境来同时部署本地模型时,[高性能应用服务 HAI](https://cloud.tencent.com/product/hai) 的预置 GPU 镜像可以省去驱动配置;只部署 Dify 平台本身并调用外部模型 API 的话,[云服务器 CVM](https://cloud.tencent.com/product/cvm) 在规格调整上更灵活。

优秀的个人博客,低调大师

SLS 脱敏函数实践:构建 LLM 应用数据输出的安全防线

作者:孙玉梅 注:本文数据都为模拟生成。 引言 过去两年,电商客服、工单、物流等环节的自动化正急速推进。一个智能助手可以同时处理上百条退款请求、物流查询、账单追踪;它不知疲倦地与用户对话,也在后台不停调用接口、记录日志、汇总报表。在这些自动化交互中,隐藏着大量敏感数据: 用户咨询里可能出现手机号、订单号、收货地址; 后端业务日志中常常包含银行卡号、接口 IP、账户 ID; 工单流转过程中甚至会附带内部 Token、用户名。 这些信息若在系统内未经处理地流转、存储或导出,不仅违反数据最小化原则,更可能在调试、共享或导出日志时意外泄露。然而,现实场景中我们又无法简单地"少打日志"或"去掉字段"。日志是运维排障的工具,是运营分析的基础,也是安全审计的依据。 本文将以一个电商 Copilot Demo 为例,展示如何借助阿里云日志服务(SLS)的脱敏函数,在不改变业务逻辑的前提下,确保系统中的敏感数据隐私安全。 方案全景:智能化与数据安全的融合 整体设计 系统的上层编排由 Dify 平台完成,Dify 负责协调用户输入、意图识别、调用后端服务以及生成回复,是整个 Copilot 系统的中枢。 但在实践中发现一个关键问题,Dify 自身的数据链路观测并不细粒度,主要体现在: 平台主要提供节点级执行日志; 但对下游 API 调用、异常堆栈、耗时分布的观测有限; 出现故障时,Dify 内置日志往往不足以支撑排障与审计。 因此,选择在 Dify 服务部署侧通过 LoongCollector 采集服务日志,通过 LoongCollector 将日志统一推送到 SLS LogStore。 数据流: 采集来源统一,同时采集 Dify 编排日志、后端服务日志、系统标准输出,并以固定的日志格式输出,完整的数据流转时序图如下: 写入脱敏: 通过写入处理器配置 SPL 脱敏(mask)函数,确保敏感字段在入库时已被打码。 使用层: 不管是运维、运营或者安全同学,都可以基于脱敏的 Logstore 数据做可以做相关业务分析。 日志链路 数据采集 LoongCollector [ 1] 作为一款轻量级日志采集工具,支持采集主机文本日志、Kubernetes 集群容器日志、HTTP 数据等不同的数据源,当前 Copilot Demo 日志以 JSON 格式打印在主机日志目录中,此处接入单行文本日志即可: 配置日志所在的文件路径: 写入脱敏 SLS 提供的 mask(脱敏)函数,支持内置和关键字匹配两种模式,能高效、精准地识别并脱敏日志中的敏感信息: 内置匹配(buildin): mask 函数开箱即用,内置了对常见 6 种敏感信息(如手机号、身份证、邮箱、IP 地址、座机电话、银行卡号)的识别能力。 关键字匹配(keyword): 智能识别任意文本中符合 "key":"value"、'key':'value' 或 key=value 等常见 KV 对格式的敏感信息。 针对文中电商 copilot 日志,在对应的 project 中新建数据处理器(配置下图 SPL 配置),即可智能识别并对 IP 地址、邮箱等敏感内容进行脱敏。其中手机号、身份证号、信用卡号、姓名以及地址信息,定制化地保留前后缀。详细配置介绍可参见《无需复杂正则:SLS 新脱敏函数让隐私保护更简单高效》。 配置写入处理器使任务生效:选择待应用的 logstore,在写入处理器 tab 中应用上面新建的处理任务。 脱敏前后日志对比 对比脱敏前的数据可以看到: 按需保留,安全与可用性兼顾: 针对不同敏感字段,可定制化保留前后缀字符。手机号保留前三后四位,既保护了用户隐私,又方便运维人员进行问题排查和用户身份核验,在保障安全的同时兼顾了数据可用性。 配置极简,无需正则: 关键字匹配模式下,即使数据嵌套多层 JSON 结构,也只需配置最内层的 Key 即可精准匹配 Value 进行脱敏,同时无需编写复杂的正则表达式来兼容各种 key:value 对格式,大大降低了配置难度。 中文精准脱敏: 姓名与地址精确按照配置的规则进行打码,避免因编码问题导致脱敏失效。 此外,mask 函数相较于使用正则表达式进行脱敏,在性能上具有显著优势,可有效降低日志处理延迟,提升整体性能。尤其是在复杂或者数据量巨大的场景下,性能优势更为明显。 使用层日志分析 数据脱敏让同一份日志呈现出三种"视角": 运维看到调用链与性能瓶颈,却看不到隐私; 运营看到趋势、效率与体验,却看不到个体; 安全看到策略执行与留痕证据,却无需担心遗漏。 在这套体系中,数据不再是一座孤岛,而是一套有边界的智能资产,数据合规、分析、排障三者可以并行。 运维工程师:定位 对于运维团队来说,以往排障往往依赖包含用户手机号、地址、账户号的明文日志,这在合规上存在高风险。现在,脱敏后的日志让这一过程从源头安全化,在问题定位场景中通过 trace_id 检索即可复原整个调用链: 从 Copilot 的意图识别开始; 到订单服务 → 退款服务 → 第三方支付网关; 再到返回结果与耗时。 需要核对用户身份时,日志里只保留了脱敏后的银行卡号、手机号等信息,足以和业务侧"同一用户"比对,而不会暴露原值。即便是跨团队协查,也能直接在脱敏日志上定位问题,避免泄露风险。 运营团队:分析 报表的价值在于发现整体趋势,而非窥探个人信息。在脱敏运营报表中,用户信息已匿名化处理,仅保留关键业务指标,助力团队从数据中挖掘洞察。 从这份报表中,运营团队可以快速了解: 整体概况:UV、PV 等关键指标,Copilot 交互次数,以及咨询总量,快速掌握运营概况。 咨询分类:退款、商品、物流咨询占比,清晰了解用户关注点。 问题分类:掌握用户提问的侧重点,如功能、价格、规格等。 重复咨询率:衡量服务质量,快速定位需要优化的环节。 用户行为:咨询后购买转化漏斗,以及热门咨询关键词,助力优化产品和营销策略。 重点用户:Top 10 咨询用户,虽然用户信息脱敏,但可通过 VIP 等级和咨询次数,制定差异化服务策略。 此外,报表中所有用户信息都经过脱敏处理,电话号码、姓名等个人信息均被掩码,确保无法反推到具体用户,充分保障用户隐私。 安全与合规团队:审计 对安全与合规团队而言,日志的最大风险在于"存量明文"。本文中的脱敏方案将脱敏前置:数据在写入前已被处理,这从根本上消除了敏感数据脱敏覆盖不全与导出明文数据的可能。此外,SLS 还提供完善的合规支撑能力: 数据存储:支持自定义日志存储时间,对网络审计相关日志设置>180 天的存储天数,满足安全审计要求。 数据操作审计:日志使用过程中会存在用户级操作行为,这些不管是管控层面的控制台操作、OpenAPI 调用,或者数据面的业务日志使用,任何人查看、分析、导出日志,都只在授权范围内看到应当看到的内容。同时 CloudLens for SLS [ 2] 还提供 Project、Logstore 的资产使用监控。 小结 当 LoongCollector 的日志采集与 LogStore 的数据脱敏连成闭环,日志在落库同时完成安全转化。运维能定位,运营能分析,安全能审计。这不是一次性的加固,而是一条可复用的路径:写入侧脱敏 + 默认脱敏落库 + 角色化访问。以此为基线,企业能放心扩展 Copilot 的业务覆盖,让"效率红利"与"合规确定性"并行存在。 相关链接: [1] LoongCollector https://help.aliyun.com/zh/sls/what-is-sls-loongcollector [2] CloudLens for SLS https://help.aliyun.com/zh/sls/cloudlens-for-sls/

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册