首页 文章 精选 留言 我的

精选列表

搜索[禅道],共6132篇文章
优秀的个人博客,低调大师

SEO 没死,生成式 AI 优化道阻且长

“ 3 个月 5980 ,你的品牌名上不了 DeepSeek ,你来找我,我们直接退钱! ” “一个词 5980 吗?” “对,如果你优化多个平台,会有梯度优惠,比如豆包、元宝、KIMI 。” 以上,是最近一个 GEO( Generative Engine Optimization 生成引擎优化)业务销售与朋友的聊天记录,大概情况是:朋友是做 MCN 的,需要在 DeepSeek 、豆包、元宝等国内 AI 平台上优化自己的品牌关键词(或业务关键词),然后一个自称 GEO 营销专家的销售嗅着味就过来了,其产品 PPT 营销味之冲,令人咋舌。 整理了一些关键表述,大家评估(不便直接截图,但是真人真事): 答案霸权战争开启,95% 传统 SEO 企业出局 未布局 GEO 企业搜索量暴跌 90% GEO 成本≈传统 SEO 的 1/10 ... 笔者理解在一些营销场域,确实需要拽狠词儿,但不解:一个 2023 年随 ChatGPT 大火后出现的技术方向,真的有如此大的能量?这不禁让笔者联想到 2022 年还有一篇文章提到:“随着 ChatGPT 取代谷歌搜索,传统的搜索引擎优化( SEO )正走向消亡...” 但事实上,SEO 并没死,诸如 GEO、LLMO 等优化概念,也随着这几年生成式 AI 技术的发展,与传统 SEO 形成互补、协作的态势。 闲言少叙,正片开始。 GEO、LLMO 是什么?二者有何联系? 严格来说,我们处于一个由人工智能技术,特别是生成式 AI ( Generative AI )深刻变革的时代。以大语言模型为核心的生成引擎,如 ChatGPT 、Gemini 、DeepSeek 、豆包、腾讯元宝等,正以前所未有的速度渗透到信息检索、内容创作、问题解答、决策辅助等各个环节。 而用户获取信息的行为也正发生转变:从过去习惯于在搜索引擎返回的“链接列表”中自行探索、筛选和整合信息,逐渐转向直接对 AI 提出问题,并期望获得一个经过 AI 理解、提炼、组织后的综合性、对话式答案。 以上是因,果则是:传统的 SEO 策略,虽仍有价值,但不足以完全应对这场由 AI 驱动的信息革命。2023 年 ,GEO(生成引擎优化)这一概念被提出,随之还有 LLMO(大语言模型优化)。 方便大家了解,笔者引用 @已见室 的解读,如下: 综合来看,二者不外乎解决一件事情:提升品牌及其内容在生成式 AI 回答中的可见度。但二者也有些许不同。 我们先聊 GEO 。GEO 全称 Generative Engine Optimization ,指通过优化网站内容,提升其在 AI 驱动的搜索引擎(国内如 Deepseek 、百度 AI 搜索、秘塔搜索,国外如 ChatGPT 、Perplexity 、Gemini 、Copilot 和 Google AI Overviews )中的可见度。 例如,当用户搜索与你的产品、服务或专业领域相关的内容时,GEO 能帮助你的品牌在 AI 生成结果中获得优先展示,从而实现精准触达,最终将访客转化为品牌的忠实用户,促使他们持续回访并深度互动。 故 GEO 多面向企业、品牌、内容创作者,以及营销人员。 在上海源易信息发布的《GEO 营销新增长白皮书》一文提出,企业要系统性地构建能被生成式 AI 优先采信的内容,可以遵循 DSS 原则,即:语义深度、数据支持、权威来源。 语义深度:指内容在信息丰富度、分析透彻度、逻辑严谨性、上下文关联性和满足用户深度(而非表层)需求方面的程度。 数据支持:指内容中的观点、结论或陈述是否基于可验证的事实、可靠的数据、具体的案例或明确的证据。 权威来源:指内容本身的出处(发布平台或作者)是否具有公认的专业性、权威性和良好的声誉,关乎内容的可信背书和行业地位。 而 LLMO( Large Language Model Optimization ),则聚焦于模型自身的优化,涉及模型微调、模型压缩、优化推理效率、改进上下文学习能力等,以提高模型的准确率、响应速度或多模态处理能力。 例如:通过微调,让模型在金融行业场景下,更准确地分析财报;通过剪枝,让模型在面对一些低延时场景下,提升响应速度。 故 LLMO 多面向 AI 开发者、数据科学家或工程师。 那么,GEO 与 LLMO 之间有何关联呢?在搞懂这一点前,不妨看看 LLM 是如何影响单一品牌出现的,从机制上: 预训练数据:模型在预训练期间的数据、权重。换言之,LLM 不创造内容,生成什么,取决于曾经“被投喂”过什么; 上下文检索:在 RAG(检索增强生成)系统中,上下文检索可以定位与 query 相关的内容(如:输入输出对),而非单独依赖模型训练时的旧数据; 注意力机制:模型对输入的各个部分进行加权; 外部检索:联网搜索功能。 总结一下,大家可以将 LLMO 看作是为了“精准反馈用户所需要的内容”,大模型在“输出前”的自身机制优化,而 GEO 则为了优化 AI 生成结果的先后顺序,即:针对于生成式 AI 答案的“ SEO ”。二者相互协同,最终提升品牌在生成式 AI 回答中的可见度。 GEO 与 SEO 的关联与互补 笔者明确一个观点:GEO 并非完全摒弃 SEO ,GEO 建立在 SEO 基础之上,并对其核心理念进行了延展。 无论是 GEO 还是 SEO ,其核心目的都是对输出内容的先后顺序进行优化——不外乎 SEO 优化的是网站链接的先后顺序,而 GEO 优化的是 LLM 输出内容的先后顺序。 所以,我们在 AI 搜索引擎中看到的引用链接,常常也出现在搜索引擎结果页( SERP )的前列。 左图(GEO)所引用的“某度百科”,为右图(SEO)的第二位 而搜索引擎和生成式 AI 引擎的本质都是“响应用户需求”,因此 SEO 和 GEO 都需要先明确“用户想获取什么信息”,再反向优化策略。二者的本质都是“用户需求→信息匹配→优化策略”的闭环,只是“需求载体”不同,SEO 是“搜索关键词”,GEO 是“自然语言提问”。 且为了更好理解用户需求,搜索引擎和生成式 AI 引擎都依赖 NLP (自然语言处理),因此 GEO 和 SEO 在“语言优化”层面其实是相似的。 SEO 的 NLP 应用:搜索引擎通过 NLP 解析用户关键词的语义,例如“电脑卡怎么办”与“如何解决电脑卡顿”是同义需求,因此 SEO 还需要优化内容的“语义关联性”,并非单纯的关键词查询。 GEO 的 NLP 应用:生成式引擎的核心是理解用户的自然语言提问,例如“帮我推荐附近一家靠谱的火锅店”,GEO 不但需要负责推荐的排序,还得整合输出对应品牌的相关标签,以满足“靠谱”“附近”等词的语义解决。 至于 GEO 与传统 SEO 的互补,其实可以分为两个方面: 1、产品形态的角度 目前很多 AI 搜索引擎都会同时返回“ AI 输出整理”与“传统搜索引擎结果”,即:顶部显示 AI 生成式回答,下方序列显示相关网页链接。例如,在 Google 搜索“what are the 4 ps of marketing ”,会显示如下结果: 再拓展一下,例如某音这款大家常用的短视频 APP ,也推出了“ AI 搜一搜”这类功能,搜索的答案则不会直接反馈“关联词”的短视频,而是 AI 生成的答案。 可见,在实际使用场景中,输出内容背后所对应的优化逻辑( GEO/SEO ),目前仍是并行使用的。 2、爬虫协议的角度 传统的 SEO ,是通过网络根目录下的 robot.txt 文件去抓取网络的内容、关键词,而现在的 GEO 依旧沿用了这一爬虫协议,并诞生了更契合大模型理解的 llms.txt 协议,通过提供网站的结构化 Markdown 文档,帮助 LLM 理解哪些内容重要,哪些内容不重要、可取舍,从而减少爬虫工具对网站的抓取负担。 目前,全球大概已有 5000+ 网站布局了 llms.txt ,以增强网站的机器可读。爬虫协议方面,robot.txt 、sitemap.xml 、llms.txt 呈现出并行支持的态势。 针对 GEO ,企业可以怎么做? 上文也提到,GEO 是为了让大模型更好抓取内容并理解,在“输入前”的一整套可操作的优化方案。那么“输入前”是哪个阶段呢?对于企业来说,无非是官网搭建、内容框架、分发渠道等,即:向 LLM 介绍“ who am I ”的阶段。 针对于提高企业相关内容的能见度,我们又该怎么做呢?结合上海源易信息的解决方案,笔者用大白话为大家整理如下—— 内容层优化: 1、深度挖掘核心用户需求,打造具有标签性质的内容框架。例如,品牌可以通过用户调研、搜索数据分析等,建立品牌 FAQ 板块。这样不仅可以通过品牌官网解决大部分用户需求,也可以满足 LLM 信息抓取的结构化需要,毕竟在对话式 AI 语境下,大模型的输出也是一问一答。 2、提升语义深度。品牌在搭建内容框架时,需要提供尽可能全面的信息。例如:产品背景、技术参数、专业名词解释、针对痛点、恰当类比、解决方案,以及明确导向能给用户带来的独特价值。总而言之,品牌最好要有自己独特的内容框架,别抄模板,别写一些模棱两可的话。 3、强化数据支持。说白了,言之有理,言有出处。一方面,引用可信数据,例如来自于权威机构(政府、研究机构、行业协会)的最新数据、统计报告;另一方面,多使用图表、图像等形式让数据更直观易懂。 4、建立 LLM 受益的文档结构。即 Snowflake 的“全球文档”概念,指 LLM 通过将文本分解为“块”来工作,可以通过在整个文本中添加有关文档的额外信息(如财务文本的公司名称、提交日期),LLM 更容易理解并正确解释每个独立的块,从而提高回答准确率。 技术层优化: 1、夯实 SEO 基础(面向 AI 爬虫):首先确保网站没有阻止 AI 爬虫访问的技术障碍(如 robots.txt 或 llms.txt 设置不当)。其次做好跨端适配,确保在各种设备上都能良好显示和使用。最后使用 HTTPS 加密,搜索引擎更倾向于优先展示 HTTPS 网站。 2、结构化数据( Schema Markup )深度应用:Schema 标记是一种标准化的词汇表,可添加到网站 HTML 中,帮助搜索引擎和 AI 更精准地理解页面的含义和实体关系。基于此,Schema 标记直接向 AI 提供相关内容的“元数据”,降低 AI 理解内容的难度和歧义性,也提升了内容被准确解读和采信的可能性。 3、实体优化:是指内容和网站结构中清晰地定义和关联这些核心实体,帮助 AI 准确识别并理解它们。例如,在内容中一致地使用品牌、产品、人物、logo 等的标准名称,建立内部链接将相关实体页面连接起来;在权威第三方平台(如维基百科、行业数据库、知识图谱网站)上建立和完善品牌相关的实体信息。 4、建立“防御性 GEO ”机制:GEO 策略不仅要着眼于优化正面信息,更要建立常态化的品牌 AI 声誉监测体系。主动发现并追踪 AI 回答中关于品牌的潜在负面、不实或过时信息。一旦发现问题,可以通过发布和优化更权威、全面、可信的官方信息(如声明、FAQ 、事实核查文章)来“对冲”负面内容,争取让 AI 采信正面信息源。 平台选择与分发策略: 我们得承认,即便内容质量再高,如果发布在 AI 不常访问或不信任的平台上,品牌被引用的效果也会大打折扣。 所以,企业可以优先在行业内公认的网站、知名媒体或高权重平台发表内容。其次,优先在 AI 索引的主流平台发布内容,满足 LLM 抓取习惯。最后,切忌随意更换品牌的官方表述、历史声誉等信息。(笔者还认为,在分发过程中,明确内容作者的专业背景、从业经验、相关认证等,通过关联作者信息的形式,也有利于品牌的索引曝光。) 图源:上海源易信息 目前的困难与挑战 总体来说,GEO 目前依旧是一个新兴的研究领域,自带历史局限性。例如,2022 年,GEO 刚被提出时,网上就出现了“如何确保优化后的内容准确可信”、“过度优化导致优质小众内容被淹没”的声音。 而在笔者咨询了一圈企业主之后,也得到了更多的负面声音: 除了需要支付 SEO 的费用,还要支付 GEO 的费用,徒增运营成本 如何防止竞争企业在 AI 平台上对品牌进行恶意抹黑 AI 生成内容对原创内容的引用、改编和合成,引发关于版权、知识产权归属的法律和伦理问题 那些跟模型厂商有合作,或者有关联的品牌,能否介入 LLM 的参数权重 类似还有很多,笔者就不展开了。我们不得不承认:原本在 SEO 时代下存在的,恶性竞价、优化转单等问题,依旧可能在 GEO 时代发生。除此之外,生成式 AI 内容优化还自带与 AI 深度结合下的发展挑战: 算法不透明、难以解释。目前,大模型的“黑箱”问题在短期内难以解决,但随着技术发展与市场监管的要求,生成引擎提供商可能会有限度地提高算法透明度,或提供更明确的内容指南,帮助创作者更好地进行优化; 网站的机器可读性低。在生成式 AI 深度介入内容生态后,“机器可读性” 的内涵已远超传统 SEO 中对 HTML 结构、标签规范的基础要求,而类似于 llms.txt 等标准,还未大范围推行; 数据偏见的固化与放大。生成式 AI 的优化能力高度依赖训练数据的质量,而历史数据中隐含的社会偏见(如性别刻板印象、地域认知偏差)会被模型学习并在优化过程中强化。这种偏见的 “代际传递” 难以通过简单的算法调整消除,因为它根植于数据反映的历史认知偏差。 GEO 还没有像 SEO 一样,走向体系化。SEO ,不仅有搜索引擎平台出的规范、教程以及适用范围,在业内同样有专业的从业资格认证,且诞生出了 SEO 优化师这一垂直岗位。反观 GEO ,就像笔者开篇所写,一个词优化就需要 6000 块,谁定的价?优化方案是?优化平台是?目前在很多方面仍不透明。 ...... 可见,让 AI 有效回答,并满足人类的实际需求,并不是一件简单的事情。但笔者还是认为:无论是 GEO ,还是 LLMO ,LLM 都可以拥有其自身的回答风格与范式,这也是目前绝大部分模型厂商的态度。至于商业品牌的曝光需求,不妨落在特定业务场景下的 AI Agent 中去解决,或许所生成的内容、提供的服务,更易被提问者接受。 参考资料: 1、上海源易信息《GEO 营销增长白皮书》 2、https://digitalzoo.com.hk/blog/seo%e5%b0%88%e9%a1%8c/geo-llmo-aeo-%e5%85%a8%e9%83%a8%e9%83%bd%e5%8f%aa%e6%98%afseo%e8%80%8c%e5%b7%b2/ 3、https://mister-seo.com/llmo-gaio-geo/

优秀的个人博客,低调大师

想要面试大数据工作的50道必看题

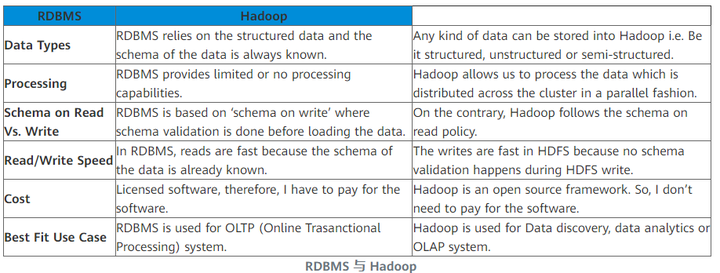
摘要:是否对面试官在 Hadoop 面试中可能会问的所有问题感到不知所措?现在是时候通过一系列涵盖 Hadoop 框架不同方面的 Hadoop 面试问题了。 本文分享自华为云社区《2021 年你必须准备的 50 大 Hadoop 面试问题》,作者:Donglian Lin 。 在本文中,我们将涵盖所有常见问题,这些问题将帮助您通过最佳解决方案在面试中胜出。但在此之前,让我告诉您对大数据和 Hadoop 专家的需求是如何持续增长的。 美国大数据 Hadoop 开发人员的平均工资为 144,000 美元- Indeed.com 印度大数据 Hadoop 开发人员的平均工资为 1600,000 卢比-Indeed.com 英国的平均年薪为 £66,250 – £66,750- itjobswatch.co.uk 我想提请您注意大数据革命。早些时候,组织只关心运营数据,不到整体数据的 20%。后来,他们意识到分析整个数据会给他们更好的业务洞察力和决策能力。那是雅虎、Facebook、谷歌等巨头开始采用 Hadoop 和大数据相关技术的时候。事实上,现在五分之一的公司正在转向大数据分析。因此,对大数据 Hadoop 工作的需求正在上升。因此,如果您想提升自己的职业生涯,Hadoop 和 Spark 正是您需要的技术。无论是新人还是有经验的人,这总是会给您一个良好的开端。 准备好这些顶级 Hadoop 面试问题,以便在新兴的大数据市场中占据优势,全球和本地企业,无论大小,都在寻找优质的大数据和 Hadoop 专家。这份 Hadoop 顶级面试问题的权威列表将带您了解有关Hadoop 集群、HDFS、 MapReduce、Pig、Hive、HBase的问题和答案 。这个博客是通往下一个 Hadoop 工作的门户。 以下是我们将要讨论的问题的大纲: 基本的 Hadoop 面试问题 Hadoop HDFS 面试问题 Hadoop MapReduce 面试题 Apache Pig 面试问题 Apache Hive 面试问题 Apache HBase 面试题 Apache Spark 面试问题 Oozie & Zookeeper 面试问题 如果您在 Hadoop 面试中遇到一些困难的问题,并且仍然对最佳答案感到困惑,请将这些问题放在下面的评论部分。我们很乐意回答他们。 1、关系型数据库和HDFS的基本区别是什么? 以下是 HDFS 和关系数据库之间的主要区别: 2. 解释“大数据”,大数据的五个 V 是什么? “大数据”是大量复杂数据集的术语,这使得使用关系数据库管理工具或传统数据处理应用程序难以处理。捕获、管理、存储、搜索、共享、传输、分析和可视化大数据很困难。大数据已成为企业的机遇。现在,他们可以成功地从数据中获取价值,并且凭借增强的业务决策能力,将比竞争对手具有明显的优势。 ♣ 提示:在此类问题中谈论 5V 将是一个好主意,无论是否专门询问! 卷:卷表示以指数速率增长的数据量,即以 PB 和 Exabytes 为单位。 速度:速度是指数据增长的速度,非常快。今天,昨天的数据被认为是旧数据。如今,社交媒体是数据增长速度的主要贡献者。 多样性:多样性是指数据类型的异质性。换句话说,收集到的数据有多种格式,如视频、音频、csv 等。因此,这些不同的格式代表了数据的多样性。 真实性:真实性是指由于数据的不一致和不完整而对可用数据存疑或不确定的数据。可用数据有时会变得混乱并且可能难以信任。大数据形式多样,质量和准确性难以控制。数量往往是数据缺乏质量和准确性的原因。 价值:获得大数据固然很好,但除非我们能将其转化为价值,否则它毫无用处。通过将其转化为价值,我的意思是,它是否增加了组织的利益?致力于大数据的组织是否实现了高 ROI(投资回报率)?除非它通过处理大数据来增加他们的利润,否则它是没有用的。 3.什么是Hadoop及其组件。 当“大数据”成为一个问题时,Apache Hadoop 演变为它的解决方案。Apache Hadoop 是一个框架,它为我们提供各种服务或工具来存储和处理大数据。它有助于分析大数据并从中做出业务决策,这是使用传统系统无法高效和有效地完成的。 ♣ 提示:现在,在讲解Hadoop的同时,还要讲解一下Hadoop的主要组成部分,即: 存储单元——HDFS(NameNode、DataNode) 处理框架——YARN(ResourceManager、NodeManager) 4. 什么是 HDFS 和 YARN? HDFS(Hadoop分布式文件系统)是Hadoop的存储单元。它负责在分布式环境中将不同类型的数据存储为块。它遵循主从拓扑。 ♣ 提示:建议对HDFS组件也进行说明即 NameNode:NameNode 是分布式环境中的主节点,它维护存储在 HDFS 中的数据块的元数据信息,如块位置、复制因子等。 DataNode:DataNode 是从节点,负责在 HDFS 中存储数据。NameNode 管理所有的 DataNode。 YARN(Yet Another Resource Negotiator)是 Hadoop 中的处理框架,它管理资源并为进程提供执行环境。 ♣ 提示:同理,就像我们在 HDFS 中所做的那样,我们也应该解释一下 YARN 的两个组件: ResourceManager:它接收处理请求,然后相应地将请求的部分传递给相应的 NodeManager,在那里进行实际处理。它根据需要为应用程序分配资源。 NodeManager:NodeManager 安装在每个DataNode 上,负责在每个DataNode 上执行任务。 5. 告诉我各种 Hadoop 守护进程及其在 Hadoop 集群中的作用。 通常通过首先解释 HDFS 守护程序,即 NameNode、DataNode 和辅助 NameNode,然后转到 YARN 守护程序,即 ResorceManager 和 NodeManager,最后解释 JobHistoryServer 来解决这个问题。 NameNode:它是主节点,负责存储所有文件和目录的元数据。它有关于块的信息,它创建一个文件,以及这些块在集群中的位置。 Datanode:它是包含实际数据的从节点。 辅助 NameNode:它会定期将更改(编辑日志)与 NameNode 中存在的 FsImage(文件系统映像)合并。它将修改后的 FsImage 存储到持久化存储中,可以在 NameNode 失败的情况下使用。 ResourceManager:它是管理资源和调度运行在 YARN 之上的应用程序的中央机构。 NodeManager:它运行在从机上,负责启动应用程序的容器(应用程序在其中执行它们的部分),监控它们的资源使用情况(CPU、内存、磁盘、网络)并将这些报告给 ResourceManager。 JobHistoryServer:它在Application Master 终止后维护有关MapReduce 作业的信息。 Hadoop HDFS 面试问题 6. 将 HDFS 与网络附加存储 (NAS) 进行比较。 本题先解释一下NAS和HDFS,然后比较它们的特点如下: 网络附加存储 (NAS) 是连接到计算机网络的文件级计算机数据存储服务器,提供对异构客户端组的数据访问。NAS 可以是提供存储和访问文件服务的硬件或软件。而 Hadoop 分布式文件系统 (HDFS) 是使用商品硬件存储数据的分布式文件系统。 在 HDFS 中,数据块分布在集群中的所有机器上。而在 NAS 中,数据存储在专用硬件上。 HDFS 旨在与 MapReduce 范式一起使用,其中将计算移至数据。NAS 不适合 MapReduce,因为数据与计算分开存储。 HDFS 使用的是具有成本效益的商品硬件,而 NAS 是包含高成本的高端存储设备。 7. 列出 Hadoop 1 和 Hadoop 2 的区别。 这是一个重要的问题,在回答这个问题时,我们必须主要关注两点,即被动 NameNode 和 YARN 架构。 在 Hadoop 1.x 中,“NameNode”是单点故障。在 Hadoop 2.x 中,我们有主动和被动的“NameNodes”。如果主动“NameNode”出现故障,则被动“NameNode”负责。因此,可以在 Hadoop 2.x 中实现高可用性。 此外,在 Hadoop 2.x 中,YARN 提供了一个中央资源管理器。使用 YARN,您现在可以在 Hadoop 中运行多个应用程序,所有应用程序都共享一个公共资源。MRV2 是一种特殊类型的分布式应用程序,它在 YARN 之上运行 MapReduce 框架。其他工具也可以通过 YARN 执行数据处理,这在 Hadoop 1.x 中是一个问题。 8. 什么是主动和被动“NameNodes”? 在 HA(高可用性)架构中,我们有两个 NameNode——主动“NameNode”和被动“NameNode”。 活动的“NameNode”是在集群中工作和运行的“NameNode”。 被动的“NameNode”是备用的“NameNode”,与主动的“NameNode”具有相似的数据。 当主动“NameNode”出现故障时,被动“NameNode”会替换集群中的主动“NameNode”。因此,集群永远不会没有“NameNode”,因此它永远不会失败。 9. 为什么在Hadoop集群中频繁删除或添加节点? Hadoop 框架最吸引人的特性之一是它对商品硬件的利用。然而,这会导致 Hadoop 集群中频繁出现“DataNode”崩溃。Hadoop 框架的另一个显着特点是随着数据量的快速增长而易于扩展。由于这两个原因,Hadoop 管理员最常见的任务之一就是在 Hadoop 集群中启用(添加)和停用(移除)“数据节点”。 10. 当两个客户端试图访问 HDFS 中的同一个文件时会发生什么? HDFS 仅支持独占写入。 当第一个客户端联系“NameNode”打开文件进行写入时,“NameNode”授予客户端创建该文件的租约。当第二个客户端尝试打开同一个文件进行写入时,“NameNode”会注意到该文件的租用已经授予另一个客户端,并拒绝第二个客户端的打开请求。 11. NameNode 如何处理 DataNode 故障? NameNode 定期从集群中的每个 DataNode 接收心跳(信号),这意味着 DataNode 运行正常。 块报告包含 DataNode 上所有块的列表。如果一个 DataNode 发送心跳消息失败,则在特定时间段后将其标记为死亡。 NameNode 使用之前创建的副本将死节点的块复制到另一个 DataNode。 12. NameNode宕机了怎么办? NameNode 恢复过程包括以下步骤来启动和运行 Hadoop 集群: 使用文件系统元数据副本(FsImage)启动一个新的 NameNode。 然后,配置 DataNode 和客户端,以便它们可以确认这个新的 NameNode,即启动。 现在,新的 NameNode 将在完成加载最后一个检查点 FsImage(用于元数据信息)并从 DataNode 接收到足够的块报告后开始为客户端提供服务。 而在大型 Hadoop 集群上,NameNode 恢复过程可能会消耗大量时间,这在日常维护的情况下成为更大的挑战。 13. 什么是检查点? 简而言之,“Checkpointing”是一个获取 FsImage 的过程,编辑日志并将它们压缩到一个新的 FsImage 中。因此,NameNode 可以直接从 FsImage 加载最终的内存状态,而不是重放编辑日志。这是一种更有效的操作,并减少了 NameNode 的启动时间。检查点由辅助 NameNode 执行。 14、HDFS如何容错? 当数据存储在 HDFS 上时,NameNode 将数据复制到多个 DataNode。默认复制因子为 3。您可以根据需要更改配置因子。如果 DataNode 出现故障,NameNode 会自动将数据从副本复制到另一个节点并使数据可用。这在 HDFS 中提供了容错能力。 15. NameNode 和 DataNode 可以是商品硬件吗? 这个问题的明智答案是,DataNodes 是像个人计算机和笔记本电脑一样的商品硬件,因为它存储数据并且需要大量使用。但是根据您的经验,您可以看出,NameNode 是主节点,它存储有关存储在 HDFS 中的所有块的元数据。它需要高内存(RAM)空间,因此NameNode需要是具有良好内存空间的高端机器。 16. 为什么我们在有大量数据集的应用程序中使用 HDFS 而不是在有很多小文件时? 与分布在多个文件中的少量数据相比,HDFS 更适合单个文件中的大量数据集。如您所知,NameNode 将有关文件系统的元数据信息存储在 RAM 中。因此,内存量会限制我的 HDFS 文件系统中的文件数量。换句话说,过多的文件会导致生成过多的元数据。而且,将这些元数据存储在 RAM 中将成为一项挑战。根据经验,文件、块或目录的元数据需要 150 个字节。 17.在HDFS中如何定义“块”?Hadoop 1 和 Hadoop 2 中的默认块大小是多少?可以改变吗? 块只是硬盘驱动器上存储数据的最小连续位置。HDFS 将每个存储为块,并将其分布在整个 Hadoop 集群中。HDFS 中的文件被分解为块大小的块,这些块作为独立的单元存储。 Hadoop 1 默认块大小:64 MB Hadoop 2 默认块大小:128 MB 是的,可以配置块。可以在 hdfs-site.xml 文件中使用 dfs.block.size 参数来设置 Hadoop 环境中块的大小。 18. 'jps' 命令有什么作用? 'jps' 命令帮助我们检查 Hadoop 守护进程是否正在运行。它显示了机器上运行的所有 Hadoop 守护进程,即 namenode、datanode、resourcemanager、nodemanager 等。 19. 你如何定义 Hadoop 中的“机架感知”? 机架感知是“NameNode”根据机架定义决定如何放置块及其副本的算法,以最大限度地减少同一机架内“DataNode”之间的网络流量。假设我们考虑复制因子 3(默认),策略是“对于每个数据块,一个机架中将存在两个副本,另一个机架中将存在第三个副本”。此规则称为“副本放置策略”。 20. Hadoop 中的“推测执行”是什么? 如果某个节点似乎执行任务的速度较慢,则主节点可以在另一个节点上冗余地执行同一任务的另一个实例。然后,首先完成的任务将被接受,另一个被杀死。这个过程称为“推测执行”。 21. 如何重启“NameNode”或Hadoop中的所有守护进程? 这个问题可以有两个答案,我们将讨论这两个答案。我们可以通过以下方法重启NameNode: 您可以使用 单独停止 NameNode。/sbin /hadoop-daemon.sh 停止 namenode命令,然后使用./sbin/hadoop-daemon.sh 启动 namenode命令。 要停止和启动所有守护进程,请使用./sbin/全部停止。sh然后使用 ./sbin/start-all.sh命令将首先停止所有守护进程,然后启动所有守护进程。 这些脚本文件位于 Hadoop 目录内的 sbin 目录中。 22. “HDFS Block”和“Input Split”有什么区别? “HDFS Block”是数据的物理划分,而“Input Split”是数据的逻辑划分。HDFS 将数据划分为块以将块存储在一起,而对于处理,MapReduce 将数据划分为输入拆分并将其分配给映射器函数。 23. 说出 Hadoop 可以运行的三种模式。 Hadoop可以运行的三种模式如下: 独立(本地)模式:如果我们不配置任何东西,这是默认模式。在这种模式下,Hadoop 的所有组件,如 NameNode、DataNode、ResourceManager 和 NodeManager,都作为一个 Java 进程运行。这使用本地文件系统。 伪分布式模式:单节点 Hadoop 部署被视为以伪分布式模式运行 Hadoop 系统。在这种模式下,所有 Hadoop 服务,包括主服务和从服务,都在单个计算节点上执行。 完全分布式模式:Hadoop 主从服务运行在不同节点上的 Hadoop 部署被称为完全分布式模式。 Hadoop MapReduce 面试题 24.什么是“MapReduce”?运行“MapReduce”程序的语法是什么? 它是一种框架/编程模型,用于使用并行编程在计算机集群上处理大型数据集。运行 MapReduce 程序的语法是hadoop_jar_file.jar /input_path /output_path。 如果你对 MapReduce 有任何疑问或想修改你的概念,你可以参考这个MapReduce 教程。 25. “MapReduce”程序的主要配置参数是什么? “MapReduce”框架中用户需要指定的主要配置参数有: 分布式文件系统中作业的输入位置 作业在分布式文件系统中的输出位置 数据输入格式 数据输出格式 包含地图功能的类 包含 reduce 函数的类 包含映射器、减速器和驱动程序类的 JAR 文件 26. 说明我们不能在mapper中进行“聚合”(加法)的原因?为什么我们需要“减速器”呢? 这个答案包括很多点,所以我们将依次进行。 我们不能在 mapper 中执行“聚合”(加法),因为在“mapper”函数中不会发生排序。排序只发生在reducer 端,没有排序聚合是无法完成的。 在“聚合”期间,我们需要所有映射器函数的输出,这些输出在映射阶段可能无法收集,因为映射器可能运行在存储数据块的不同机器上。 最后,如果我们尝试在 mapper 上聚合数据,它需要在可能运行在不同机器上的所有 mapper 函数之间进行通信。因此,它会消耗高网络带宽并可能导致网络瓶颈。 27、Hadoop中“RecordReader”的作用是什么? “InputSplit”定义了一个工作片段,但没有描述如何访问它。“RecordReader”类从其源加载数据并将其转换为适合“Mapper”任务读取的(键、值)对。“RecordReader”实例由“输入格式”定义。 28. 解释“MapReduce 框架”中的“分布式缓存”。 分布式缓存可以解释为,MapReduce 框架提供的一种工具,用于缓存应用程序所需的文件。一旦你为你的工作缓存了一个文件,Hadoop 框架就会让它在你运行 map/reduce 任务的每个数据节点上可用。然后,您可以在 Mapper 或 Reducer 作业中将缓存文件作为本地文件访问。 29、“reducers”之间是如何通信的? 这是一个棘手的问题。“MapReduce”编程模型不允许“reducer”相互通信。“减速器”是孤立运行的。 30. “MapReduce Partitioner”有什么作用? “MapReduce Partitioner”确保单个键的所有值都进入同一个“reducer”,从而允许在“reducer”上均匀分布地图输出。它通过确定哪个“reducer”负责特定键,将“mapper”输出重定向到“reducer”。 31. 你将如何编写自定义分区器? 可以按照以下步骤轻松编写 Hadoop 作业的自定义分区器: 创建一个扩展 Partitioner 类的新类 覆盖方法 – getPartition,在 MapReduce 中运行的包装器中。 使用 set Partitioner 方法将自定义分区程序添加到作业,或将自定义分区程序作为配置文件添加到作业。 32、什么是“合路器”? “Combiner”是一个执行本地“reduce”任务的迷你“reducer”。它从特定“节点”上的“映射器”接收输入,并将输出发送到“减速器”。“组合器”通过减少需要发送到“减速器”的数据量来帮助提高“MapReduce”的效率。 33. 你对“SequenceFileInputFormat”了解多少? “SequenceFileInputFormat”是用于在序列文件中读取的输入格式。它是一种特定的压缩二进制文件格式,经过优化,可将一个“MapReduce”作业的输出之间的数据传递到其他“MapReduce”作业的输入。 序列文件可以作为其他 MapReduce 任务的输出生成,并且是从一个 MapReduce 作业传递到另一个 MapReduce 作业的数据的有效中间表示。 Apache Pig 面试问题 34. Apache Pig 相对于 MapReduce 有哪些优势? Apache Pig 是一个平台,用于分析将它们表示为雅虎开发的数据流的大型数据集。它旨在提供对 MapReduce 的抽象,降低编写 MapReduce 程序的复杂性。 Pig Latin 是一种高级数据流语言,而 MapReduce 是一种低级数据处理范式。 无需在 MapReduce 中编写复杂的 Java 实现,程序员可以使用 Pig Latin 非常轻松地实现相同的实现。 Apache Pig 将代码长度减少了大约 20 倍(根据 Yahoo)。因此,这将开发周期缩短了近 16 倍。 Pig 提供了许多内置操作符来支持数据操作,如连接、过滤、排序、排序等。而在 MapReduce 中执行相同的功能是一项艰巨的任务。 在 Apache Pig 中执行 Join 操作很简单。而在 MapReduce 中很难在数据集之间执行 Join 操作,因为它需要依次执行多个 MapReduce 任务才能完成作业。 此外,pig 还提供了 MapReduce 中缺少的嵌套数据类型,例如元组、包和映射。 35. Pig Latin 中有哪些不同的数据类型? Pig Latin 可以处理原子数据类型(如 int、float、long、double 等)和复杂数据类型(如 tuple、bag 和 map)。 原子数据类型:原子或标量数据类型是所有语言中使用的基本数据类型,如字符串、整数、浮点、长、双、char[]、byte[]。 复杂数据类型:复杂数据类型有元组、映射和包。 36. 你合作过的“Pig Latin”中有哪些不同的关系运算? 不同的关系运算符是: for each order by filters group distinct join limit 37.什么是UDF? 如果某些函数在内置运算符中不可用,我们可以通过编程方式创建用户定义函数 (UDF),以使用其他语言(如 Java、Python、Ruby 等)引入这些功能,并将其嵌入到 Script 文件中。 Apache Hive 面试问题 38.“蜂巢”中的“SerDe”是什么? Apache Hive 是一个建立在 Hadoop 之上的数据仓库系统,用于分析 Facebook 开发的结构化和半结构化数据。Hive 抽象了 Hadoop MapReduce 的复杂性。 “SerDe”接口允许您指示“Hive”如何处理记录。“SerDe”是“Serializer”和“Deserializer”的组合。“Hive”使用“SerDe”(和“FileFormat”)来读取和写入表的行。 39、默认的“Hive Metastore”可以被多个用户(进程)同时使用吗? “Derby 数据库”是默认的“Hive Metastore”。多个用户(进程)不能同时访问它。它主要用于执行单元测试。 40. “Hive”存储表数据的默认位置是什么? Hive 存储表数据的默认位置在 /user/hive/warehouse 中的 HDFS 内。 Apache HBase 面试题 41.什么是Apache HBase? HBase 是一个开源、多维、分布式、可扩展和用 Java 编写的 NoSQL 数据库。HBase 运行在 HDFS(Hadoop 分布式文件系统)之上,并为 Hadoop 提供类似 BigTable (Google) 的功能。它旨在提供一种容错方式来存储大量稀疏数据集。HBase 通过在庞大的数据集上提供更快的读/写访问来实现高吞吐量和低延迟。 42. Apache HBase 有哪些组件? HBase 包含三个主要组件,即 HMaster Server、HBase RegionServer 和 Zookeeper。 Region Server:一个表可以分成几个区域。区域服务器为客户端提供一组区域。 HMaster:它协调和管理Region Server(类似于NameNode 管理HDFS 中的DataNode)。 ZooKeeper:Zookeeper 就像 HBase 分布式环境中的协调器。它有助于通过会话进行通信来维护集群内的服务器状态。 43、Region Server有哪些组成部分? 区域服务器的组件是: WAL: Write Ahead Log (WAL) 是附加到分布式环境中每个 Region Server 的文件。WAL 存储尚未持久化或提交到永久存储的新数据。 块缓存:块缓存驻留在区域服务器的顶部。它将经常读取的数据存储在内存中。 MemStore:它是写缓存。在将所有传入数据提交到磁盘或永久内存之前,它会存储所有传入数据。一个区域中的每个列族都有一个 MemStore。 HFile:HFile 存储在 HDFS 中。它将实际单元存储在磁盘上。 44.解释HBase中的“WAL”? Write Ahead Log (WAL) 是附加到分布式环境中每个 Region Server 的文件。WAL 存储尚未持久化或提交到永久存储的新数据。它用于恢复数据集失败的情况。 45. 提到“HBase”和“关系数据库”之间的区别? HBase 是一个开源、多维、分布式、可扩展和用 Java 编写的 NoSQL 数据库。HBase 运行在 HDFS 之上,并为 Hadoop 提供类似 BigTable 的功能。让我们看看 HBase 和关系数据库之间的区别。 Apache Spark 面试问题 46.什么是Apache Spark? 这个问题的答案是,Apache Spark 是一个在分布式计算环境中进行实时数据分析的框架。它执行内存计算以提高数据处理速度。 通过利用内存计算和其他优化进行大规模数据处理,它比 MapReduce 快 100 倍。 47. 你能用任何特定的 Hadoop 版本构建“Spark”吗? 是的,可以为特定的 Hadoop 版本构建“Spark”。 48. 定义 RDD。 RDD 是弹性分布数据集的首字母缩写词 - 并行运行的操作元素的容错集合。RDD 中的分区数据是不可变的和分布式的,这是 Apache Spark 的一个关键组件。 Oozie 和 ZooKeeper 面试问题 49. Apache ZooKeeper 和 Apache Oozie 是什么? Apache ZooKeeper 协调分布式环境中的各种服务。它通过执行同步、配置维护、分组和命名节省了大量时间。 Apache Oozie 是一个调度程序,它调度 Hadoop 作业并将它们作为一个逻辑工作绑定在一起。有两种 Oozie 作业: Oozie 工作流:这些是要执行的顺序操作集。您可以将其视为接力赛。每个运动员都在等待最后一名运动员完成他的部分。 Oozie Coordinator:这些是在数据可用时触发的 Oozie 作业。将此视为我们体内的反应刺激系统。以同样的方式,当我们对外部刺激做出反应时,Oozie 协调器会对数据的可用性做出反应,否则就会休息。 50. 如何在 Hadoop 中配置“Oozie”作业? “Oozie”与 Hadoop 堆栈的其余部分集成,支持多种类型的 Hadoop 作业,例如“Java MapReduce”、“Streaming MapReduce”、“Pig”、“Hive”和“Sqoop”。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

无间道!勒索软件团伙Conti攻击手册泄露

Conti是近年来最为活跃和危险的勒索软件团伙之一。该组织采用勒索软件即服务 (RaaS) 的运营模式,其中核心团队管理恶意软件和Tor站点,而招募的联盟机构则执行网络漏洞和数据加密攻击。核心团队赚取赎金的20~30%,而附属公司赚取其余部分。 上图是该团伙的培训材料,勒索软件的攻击手册也在其中 近日,安全研究人员pancak3分享了一个反水的Conti加盟机构成员发布的论坛帖子,该成员公开泄露了有关勒索软件操作的信息。该信息包括Cobalt Strike C2服务器的IP地址(下图,pancak3强烈建议立刻封锁图片中的IP地址)和一个113MB的档案,其中包含大量用于进行勒索软件攻击的工具和培训材料。 该成员还表示,他发布这些材料的原因是在一次攻击后的分赃中只获得了1,500美元,而团队的其他成员却将赚取数百万美元。一位威胁情报专家指出,此次泄露的攻击手册与Conti的活跃案例相符,基本可以确认是真实泄露。 此次泄密暴露出勒索软件团伙的组织成熟度,以及他们在针对全球公司发动攻击时使用的流程和经验。同时也暴露了勒索软件即服务操作的脆弱性,因为任何一个不满意的加盟成员都可能会导致攻击中使用的精心制作的培训信息和资源暴露。 作为勒索软件的顶级玩家,Conti勒索软件“渗透测试”团队的操作手册同时也是渗透测试操作的“圣杯”。因此这次泄露将产生积极的影响,防御端的渗透测试人员可以通过这些资料来逐步提高渗透测试技能以应对勒索软件。 【本文是51CTO专栏作者“安全牛”的原创文章,转载请通过安全牛(微信公众号id:gooann-sectv)获取授权】 戳这里,看该作者更多好文

优秀的个人博客,低调大师

Java并发编程75道面试题及答案

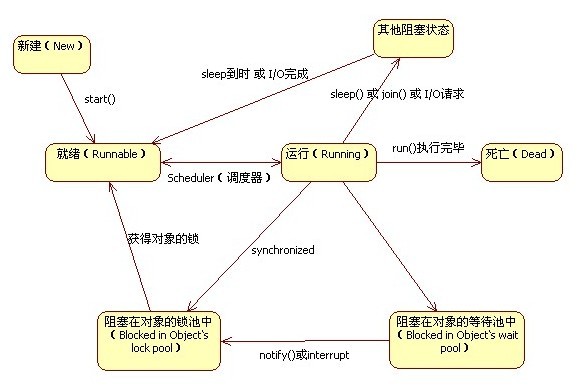
1、在java中守护线程和本地线程区别? java中的线程分为两种:守护线程(Daemon)和用户线程(User)。 任何线程都可以设置为守护线程和用户线程,通过方法Thread.setDaemon(bool on);true则把该线程设置为守护线程,反之则为用户线程。Thread.setDaemon()必须在Thread.start()之前调用,否则运行时会抛出异常。 两者的区别: 唯一的区别是判断虚拟机(JVM)何时离开,Daemon是为其他线程提供服务,如果全部的User Thread已经撤离,Daemon 没有可服务的线程,JVM撤离。也可以理解为守护线程是JVM自动创建的线程(但不一定),用户线程是程序创建的线程;比如JVM的垃圾回收线程是一个守护线程,当所有线程已经撤离,不再产生垃圾,守护线程自然就没事可干了,当垃圾回收线程是Java虚拟机上仅剩的线程时,Java虚拟机会自动离开。 扩展:Thread Dump打印出来的线程信息,含有daemon字样的线程即为守护进程,可能会有:服务守护进程、编译守护进程、windows下的监听Ctrl+break的守护进程、Finalizer守护进程、引用处理守护进程、GC守护进程。 2、线程与进程的区别? 进程是操作系统分配资源的最小单元,线程是操作系统调度的最小单元。 一个程序至少有一个进程,一个进程至少有一个线程。 3、什么是多线程中的上下文切换? 多线程会共同使用一组计算机上的CPU,而线程数大于给程序分配的CPU数量时,为了让各个线程都有执行的机会,就需要轮转使用CPU。不同的线程切换使用CPU发生的切换数据等就是上下文切换。 4、死锁与活锁的区别,死锁与饥饿的区别? 死锁:是指两个或两个以上的进程(或线程)在执行过程中,因争夺资源而造成的一种互相等待的现象,若无外力作用,它们都将无法推进下去。 产生死锁的必要条件: 1. 互斥条件:所谓互斥就是进程在某一时间内独占资源。 2. 请求与保持条件:一个进程因请求资源而阻塞时,对已获得的资源保持不放。 3. 不剥夺条件:进程已获得资源,在末使用完之前,不能强行剥夺。 4. 循环等待条件:若干进程之间形成一种头尾相接的循环等待资源关系。 活锁:任务或者执行者没有被阻塞,由于某些条件没有满足,导致一直重复尝试,失败,尝试,失败。 活锁和死锁的区别在于,处于活锁的实体是在不断的改变状态,所谓的“活”, 而处于死锁的实体表现为等待;活锁有可能自行解开,死锁则不能。 饥饿:一个或者多个线程因为种种原因无法获得所需要的资源,导致一直无法执行的状态。 Java中导致饥饿的原因: - 高优先级线程吞噬所有的低优先级线程的CPU时间。 - 线程被永久堵塞在一个等待进入同步块的状态,因为其他线程总是能在它之前持续地对该同步块进行访问。 - 线程在等待一个本身也处于永久等待完成的对象(比如调用这个对象的wait方法),因为其他线程总是被持续地获得唤醒。 5、Java中用到的线程调度算法是什么? 采用时间片轮转的方式。可以设置线程的优先级,会映射到下层的系统上面的优先级上,如非特别需要,尽量不要用,防止线程饥饿。 6、什么是线程组,为什么在Java中不推荐使用? ThreadGroup类,可以把线程归属到某一个线程组中,线程组中可以有线程对象,也可以有线程组,组中还可以有线程,这样的组织结构有点类似于树的形式。 为什么不推荐使用?因为使用有很多的安全隐患吧,没有具体追究,如果需要使用,推荐使用线程池。 7、为什么使用Executor框架? 每次执行任务创建线程 new Thread()比较消耗性能,创建一个线程是比较耗时、耗资源的。 调用 new Thread()创建的线程缺乏管理,被称为野线程,而且可以无限制的创建,线程之间的相互竞争会导致过多占用系统资源而导致系统瘫痪,还有线程之间的频繁交替也会消耗很多系统资源。 接使用new Thread() 启动的线程不利于扩展,比如定时执行、定期执行、定时定期执行、线程中断等都不便实现。 8、在Java中Executor和Executors的区别? Executors 工具类的不同方法按照我们的需求创建了不同的线程池,来满足业务的需求。 Executor 接口对象能执行我们的线程任务。 ExecutorService接口继承了Executor接口并进行了扩展,提供了更多的方法我们能获得任务执行的状态并且可以获取任务的返回值。 使用ThreadPoolExecutor 可以创建自定义线程池。 Future 表示异步计算的结果,他提供了检查计算是否完成的方法,以等待计算的完成,并可以使用get()方法获取计算的结果。 9、如何在Windows和Linux上查找哪个线程使用的CPU时间最长? 参考: http://daiguahub.com/2016/07/31/%E4%BD%BF%E7%94%A8jstack%E6%89%BE%E5%87%BA%E6%B6%88%E8%80%97CPU%E6%9C%80%E5%A4%9A%E7%9A%84%E7%BA%BF%E7%A8%8B%E4%BB%A3%E7%A0%81/ 10、什么是原子操作?在Java Concurrency API中有哪些原子类(atomic classes)? 原子操作(atomic operation)意为”不可被中断的一个或一系列操作” 。 处理器使用基于对缓存加锁或总线加锁的方式来实现多处理器之间的原子操作。 在Java中可以通过锁和循环CAS的方式来实现原子操作。 CAS操作——Compare & Set,或是 Compare & Swap,现在几乎所有的CPU指令都支持CAS的原子操作。 原子操作是指一个不受其他操作影响的操作任务单元。原子操作是在多线程环境下避免数据不一致必须的手段。 int++并不是一个原子操作,所以当一个线程读取它的值并加1时,另外一个线程有可能会读到之前的值,这就会引发错误。 为了解决这个问题,必须保证增加操作是原子的,在JDK1.5之前我们可以使用同步技术来做到这一点。到JDK1.5,java.util.concurrent.atomic包提供了int和long类型的原子包装类,它们可以自动的保证对于他们的操作是原子的并且不需要使用同步。 java.util.concurrent这个包里面提供了一组原子类。其基本的特性就是在多线程环境下,当有多个线程同时执行这些类的实例包含的方法时,具有排他性,即当某个线程进入方法,执行其中的指令时,不会被其他线程打断,而别的线程就像自旋锁一样,一直等到该方法执行完成,才由JVM从等待队列中选择一个另一个线程进入,这只是一种逻辑上的理解。 原子类:AtomicBoolean,AtomicInteger,AtomicLong,AtomicReference 原子数组:AtomicIntegerArray,AtomicLongArray,AtomicReferenceArray 原子属性更新器:AtomicLongFieldUpdater,AtomicIntegerFieldUpdater,AtomicReferenceFieldUpdater 解决ABA问题的原子类:AtomicMarkableReference(通过引入一个boolean来反映中间有没有变过),AtomicStampedReference(通过引入一个int来累加来反映中间有没有变过) 11、Java Concurrency API中的Lock接口(Lock interface)是什么?对比同步它有什么优势? Lock接口比同步方法和同步块提供了更具扩展性的锁操作。 他们允许更灵活的结构,可以具有完全不同的性质,并且可以支持多个相关类的条件对象。 它的优势有: 可以使锁更公平 可以使线程在等待锁的时候响应中断 可以让线程尝试获取锁,并在无法获取锁的时候立即返回或者等待一段时间 可以在不同的范围,以不同的顺序获取和释放锁 整体上来说Lock是synchronized的扩展版,Lock提供了无条件的、可轮询的(tryLock方法)、定时的(tryLock带参方法)、可中断的(lockInterruptibly)、可多条件队列的(newCondition方法)锁操作。另外Lock的实现类基本都支持非公平锁(默认)和公平锁,synchronized只支持非公平锁,当然,在大部分情况下,非公平锁是高效的选择。 12、什么是Executors框架? Executor框架是一个根据一组执行策略调用,调度,执行和控制的异步任务的框架。 无限制的创建线程会引起应用程序内存溢出。所以创建一个线程池是个更好的的解决方案,因为可以限制线程的数量并且可以回收再利用这些线程。利用Executors框架可以非常方便的创建一个线程池。 13、什么是阻塞队列?阻塞队列的实现原理是什么?如何使用阻塞队列来实现生产者-消费者模型? 阻塞队列(BlockingQueue)是一个支持两个附加操作的队列。 这两个附加的操作是:在队列为空时,获取元素的线程会等待队列变为非空。当队列满时,存储元素的线程会等待队列可用。 阻塞队列常用于生产者和消费者的场景,生产者是往队列里添加元素的线程,消费者是从队列里拿元素的线程。阻塞队列就是生产者存放元素的容器,而消费者也只从容器里拿元素。 JDK7提供了7个阻塞队列。分别是: ArrayBlockingQueue :一个由数组结构组成的有界阻塞队列。 LinkedBlockingQueue :一个由链表结构组成的有界阻塞队列。 PriorityBlockingQueue :一个支持优先级排序的无界阻塞队列。 DelayQueue:一个使用优先级队列实现的无界阻塞队列。 SynchronousQueue:一个不存储元素的阻塞队列。 LinkedTransferQueue:一个由链表结构组成的无界阻塞队列。 LinkedBlockingDeque:一个由链表结构组成的双向阻塞队列。 Java 5之前实现同步存取时,可以使用普通的一个集合,然后在使用线程的协作和线程同步可以实现生产者,消费者模式,主要的技术就是用好,wait ,notify,notifyAll,sychronized这些关键字。而在java 5之后,可以使用阻塞队列来实现,此方式大大简少了代码量,使得多线程编程更加容易,安全方面也有保障。 BlockingQueue接口是Queue的子接口,它的主要用途并不是作为容器,而是作为线程同步的的工具,因此他具有一个很明显的特性,当生产者线程试图向BlockingQueue放入元素时,如果队列已满,则线程被阻塞,当消费者线程试图从中取出一个元素时,如果队列为空,则该线程会被阻塞,正是因为它所具有这个特性,所以在程序中多个线程交替向BlockingQueue中放入元素,取出元素,它可以很好的控制线程之间的通信。 阻塞队列使用最经典的场景就是socket客户端数据的读取和解析,读取数据的线程不断将数据放入队列,然后解析线程不断从队列取数据解析。 14、什么是Callable和Future? Callable接口类似于Runnable,从名字就可以看出来了,但是Runnable不会返回结果,并且无法抛出返回结果的异常,而Callable功能更强大一些,被线程执行后,可以返回值,这个返回值可以被Future拿到,也就是说,Future可以拿到异步执行任务的返回值。 可以认为是带有回调的Runnable。 Future接口表示异步任务,是还没有完成的任务给出的未来结果。所以说Callable用于产生结果,Future用于获取结果。 15、什么是FutureTask?使用ExecutorService启动任务。 在Java并发程序中FutureTask表示一个可以取消的异步运算。它有启动和取消运算、查询运算是否完成和取回运算结果等方法。只有当运算完成的时候结果才能取回,如果运算尚未完成get方法将会阻塞。一个FutureTask对象可以对调用了Callable和Runnable的对象进行包装,由于FutureTask也是调用了Runnable接口所以它可以提交给Executor来执行。 16、什么是并发容器的实现? 何为同步容器:可以简单地理解为通过synchronized来实现同步的容器,如果有多个线程调用同步容器的方法,它们将会串行执行。比如Vector,Hashtable,以及Collections.synchronizedSet,synchronizedList等方法返回的容器。 可以通过查看Vector,Hashtable等这些同步容器的实现代码,可以看到这些容器实现线程安全的方式就是将它们的状态封装起来,并在需要同步的方法上加上关键字synchronized。 并发容器使用了与同步容器完全不同的加锁策略来提供更高的并发性和伸缩性,例如在ConcurrentHashMap中采用了一种粒度更细的加锁机制,可以称为分段锁,在这种锁机制下,允许任意数量的读线程并发地访问map,并且执行读操作的线程和写操作的线程也可以并发的访问map,同时允许一定数量的写操作线程并发地修改map,所以它可以在并发环境下实现更高的吞吐量。 17、多线程同步和互斥有几种实现方法,都是什么? 线程同步是指线程之间所具有的一种制约关系,一个线程的执行依赖另一个线程的消息,当它没有得到另一个线程的消息时应等待,直到消息到达时才被唤醒。 线程互斥是指对于共享的进程系统资源,在各单个线程访问时的排它性。当有若干个线程都要使用某一共享资源时,任何时刻最多只允许一个线程去使用,其它要使用该资源的线程必须等待,直到占用资源者释放该资源。线程互斥可以看成是一种特殊的线程同步。 线程间的同步方法大体可分为两类:用户模式和内核模式。顾名思义,内核模式就是指利用系统内核对象的单一性来进行同步,使用时需要切换内核态与用户态,而用户模式就是不需要切换到内核态,只在用户态完成操作。 用户模式下的方法有:原子操作(例如一个单一的全局变量),临界区。内核模式下的方法有:事件,信号量,互斥量。 18、什么是竞争条件?你怎样发现和解决竞争? 当多个进程都企图对共享数据进行某种处理,而最后的结果又取决于进程运行的顺序时,则我们认为这发生了竞争条件(race condition)。 19、你将如何使用thread dump?你将如何分析Thread dump? 新建状态(New) 用new语句创建的线程处于新建状态,此时它和其他Java对象一样,仅仅在堆区中被分配了内存。 就绪状态(Runnable) 当一个线程对象创建后,其他线程调用它的start()方法,该线程就进入就绪状态,Java虚拟机会为它创建方法调用栈和程序计数器。处于这个状态的线程位于可运行池中,等待获得CPU的使用权。 运行状态(Running) 处于这个状态的线程占用CPU,执行程序代码。只有处于就绪状态的线程才有机会转到运行状态。 阻塞状态(Blocked) 阻塞状态是指线程因为某些原因放弃CPU,暂时停止运行。当线程处于阻塞状态时,Java虚拟机不会给线程分配CPU。直到线程重新进入就绪状态,它才有机会转到运行状态。 阻塞状态可分为以下3种: 位于对象等待池中的阻塞状态(Blocked in object’s wait pool):当线程处于运行状态时,如果执行了某个对象的wait()方法,Java虚拟机就会把线程放到这个对象的等待池中,这涉及到“线程通信”的内容。 位于对象锁池中的阻塞状态(Blocked in object’s lock pool):当线程处于运行状态时,试图获得某个对象的同步锁时,如果该对象的同步锁已经被其他线程占用,Java虚拟机就会把这个线程放到这个对象的锁池中,这涉及到“线程同步”的内容。 其他阻塞状态(Otherwise Blocked):当前线程执行了sleep()方法,或者调用了其他线程的join()方法,或者发出了I/O请求时,就会进入这个状态。 死亡状态(Dead) 当线程退出run()方法时,就进入死亡状态,该线程结束生命周期。 我们运行之前的那个死锁代码SimpleDeadLock.java,然后尝试输出信息(/*这是注释,作者自己加的*/): /* 时间,jvm信息 */ 2017-11-01 17:36:28 Full thread dump Java HotSpot(TM) 64-Bit Server VM (25.144-b01 mixed mode): /* 线程名称:DestroyJavaVM 编号:#13 优先级:5 系统优先级:0 jvm内部线程id:0x0000000001c88800 对应系统线程id(NativeThread ID):0x1c18 线程状态: waiting on condition [0x0000000000000000] (等待某个条件) 线程详细状态:java.lang.Thread.State: RUNNABLE 及之后所有*/ "DestroyJavaVM" #13 prio=5 os_prio=0 tid=0x0000000001c88800 nid=0x1c18 waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "Thread-1" #12 prio=5 os_prio=0 tid=0x0000000018d49000 nid=0x17b8 waiting for monitor entry [0x0000000019d7f000] /* 线程状态:阻塞(在对象同步上) 代码位置:at com.leo.interview.SimpleDeadLock$B.run(SimpleDeadLock.java:56) 等待锁:0x00000000d629b4d8 已经获得锁:0x00000000d629b4e8*/ java.lang.Thread.State: BLOCKED (on object monitor) at com.leo.interview.SimpleDeadLock$B.run(SimpleDeadLock.java:56) - waiting to lock <0x00000000d629b4d8> (a java.lang.Object) - locked <0x00000000d629b4e8> (a java.lang.Object) "Thread-0" #11 prio=5 os_prio=0 tid=0x0000000018d44000 nid=0x1ebc waiting for monitor entry [0x000000001907f000] java.lang.Thread.State: BLOCKED (on object monitor) at com.leo.interview.SimpleDeadLock$A.run(SimpleDeadLock.java:34) - waiting to lock <0x00000000d629b4e8> (a java.lang.Object) - locked <0x00000000d629b4d8> (a java.lang.Object) "Service Thread" #10 daemon prio=9 os_prio=0 tid=0x0000000018ca5000 nid=0x1264 runnable [0x0000000000000000] java.lang.Thread.State: RUNNABLE "C1 CompilerThread2" #9 daemon prio=9 os_prio=2 tid=0x0000000018c46000 nid=0xb8c waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "C2 CompilerThread1" #8 daemon prio=9 os_prio=2 tid=0x0000000018be4800 nid=0x1db4 waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "C2 CompilerThread0" #7 daemon prio=9 os_prio=2 tid=0x0000000018be3800 nid=0x810 waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "Monitor Ctrl-Break" #6 daemon prio=5 os_prio=0 tid=0x0000000018bcc800 nid=0x1c24 runnable [0x00000000193ce000] java.lang.Thread.State: RUNNABLE at java.net.SocketInputStream.socketRead0(Native Method) at java.net.SocketInputStream.socketRead(SocketInputStream.java:116) at java.net.SocketInputStream.read(SocketInputStream.java:171) at java.net.SocketInputStream.read(SocketInputStream.java:141) at sun.nio.cs.StreamDecoder.readBytes(StreamDecoder.java:284) at sun.nio.cs.StreamDecoder.implRead(StreamDecoder.java:326) at sun.nio.cs.StreamDecoder.read(StreamDecoder.java:178) - locked <0x00000000d632b928> (a java.io.InputStreamReader) at java.io.InputStreamReader.read(InputStreamReader.java:184) at java.io.BufferedReader.fill(BufferedReader.java:161) at java.io.BufferedReader.readLine(BufferedReader.java:324) - locked <0x00000000d632b928> (a java.io.InputStreamReader) at java.io.BufferedReader.readLine(BufferedReader.java:389) at com.intellij.rt.execution.application.AppMainV2$1.run(AppMainV2.java:64) "Attach Listener" #5 daemon prio=5 os_prio=2 tid=0x0000000017781800 nid=0x524 runnable [0x0000000000000000] java.lang.Thread.State: RUNNABLE "Signal Dispatcher" #4 daemon prio=9 os_prio=2 tid=0x000000001778f800 nid=0x1b08 waiting on condition [0x0000000000000000] java.lang.Thread.State: RUNNABLE "Finalizer" #3 daemon prio=8 os_prio=1 tid=0x000000001776a800 nid=0xdac in Object.wait() [0x0000000018b6f000] java.lang.Thread.State: WAITING (on object monitor) at java.lang.Object.wait(Native Method) - waiting on <0x00000000d6108ec8> (a java.lang.ref.ReferenceQueue$Lock) at java.lang.ref.ReferenceQueue.remove(ReferenceQueue.java:143) - locked <0x00000000d6108ec8> (a java.lang.ref.ReferenceQueue$Lock) at java.lang.ref.ReferenceQueue.remove(ReferenceQueue.java:164) at java.lang.ref.Finalizer$FinalizerThread.run(Finalizer.java:209) "Reference Handler" #2 daemon prio=10 os_prio=2 tid=0x0000000017723800 nid=0x1670 in Object.wait() [0x00000000189ef000] java.lang.Thread.State: WAITING (on object monitor) at java.lang.Object.wait(Native Method) - waiting on <0x00000000d6106b68> (a java.lang.ref.Reference$Lock) at java.lang.Object.wait(Object.java:502) at java.lang.ref.Reference.tryHandlePending(Reference.java:191) - locked <0x00000000d6106b68> (a java.lang.ref.Reference$Lock) at java.lang.ref.Reference$ReferenceHandler.run(Reference.java:153) "VM Thread" os_prio=2 tid=0x000000001771b800 nid=0x604 runnable "GC task thread#0 (ParallelGC)" os_prio=0 tid=0x0000000001c9d800 nid=0x9f0 runnable "GC task thread#1 (ParallelGC)" os_prio=0 tid=0x0000000001c9f000 nid=0x154c runnable "GC task thread#2 (ParallelGC)" os_prio=0 tid=0x0000000001ca0800 nid=0xcd0 runnable "GC task thread#3 (ParallelGC)" os_prio=0 tid=0x0000000001ca2000 nid=0x1e58 runnable "VM Periodic Task Thread" os_prio=2 tid=0x0000000018c5a000 nid=0x1b58 waiting on condition JNI global references: 33 /* 此处可以看待死锁的相关信息! */ Found one Java-level deadlock: ============================= "Thread-1": waiting to lock monitor 0x0000000017729fc8 (object 0x00000000d629b4d8, a java.lang.Object), which is held by "Thread-0" "Thread-0": waiting to lock monitor 0x0000000017727738 (object 0x00000000d629b4e8, a java.lang.Object), which is held by "Thread-1" Java stack information for the threads listed above: =================================================== "Thread-1": at com.leo.interview.SimpleDeadLock$B.run(SimpleDeadLock.java:56) - waiting to lock <0x00000000d629b4d8> (a java.lang.Object) - locked <0x00000000d629b4e8> (a java.lang.Object) "Thread-0": at com.leo.interview.SimpleDeadLock$A.run(SimpleDeadLock.java:34) - waiting to lock <0x00000000d629b4e8> (a java.lang.Object) - locked <0x00000000d629b4d8> (a java.lang.Object) Found 1 deadlock. /* 内存使用状况,详情得看JVM方面的书 */ Heap PSYoungGen total 37888K, used 4590K [0x00000000d6100000, 0x00000000d8b00000, 0x0000000100000000) eden space 32768K, 14% used [0x00000000d6100000,0x00000000d657b968,0x00000000d8100000) from space 5120K, 0% used [0x00000000d8600000,0x00000000d8600000,0x00000000d8b00000) to space 5120K, 0% used [0x00000000d8100000,0x00000000d8100000,0x00000000d8600000) ParOldGen total 86016K, used 0K [0x0000000082200000, 0x0000000087600000, 0x00000000d6100000) object space 86016K, 0% used [0x0000000082200000,0x0000000082200000,0x0000000087600000) Metaspace used 3474K, capacity 4500K, committed 4864K, reserved 1056768K class space used 382K, capacity 388K, committed 512K, reserved 1048576K 20、为什么我们调用start()方法时会执行run()方法,为什么我们不能直接调用run()方法? 当你调用start()方法时你将创建新的线程,并且执行在run()方法里的代码。 但是如果你直接调用run()方法,它不会创建新的线程也不会执行调用线程的代码,只会把run方法当作普通方法去执行。 21、Java中你怎样唤醒一个阻塞的线程? 在Java发展史上曾经使用suspend()、resume()方法对于线程进行阻塞唤醒,但随之出现很多问题,比较典型的还是死锁问题。 解决方案可以使用以对象为目标的阻塞,即利用Object类的wait()和notify()方法实现线程阻塞。 首先,wait、notify方法是针对对象的,调用任意对象的wait()方法都将导致线程阻塞,阻塞的同时也将释放该对象的锁,相应地,调用任意对象的notify()方法则将随机解除该对象阻塞的线程,但它需要重新获取改对象的锁,直到获取成功才能往下执行;其次,wait、notify方法必须在synchronized块或方法中被调用,并且要保证同步块或方法的锁对象与调用wait、notify方法的对象是同一个,如此一来在调用wait之前当前线程就已经成功获取某对象的锁,执行wait阻塞后当前线程就将之前获取的对象锁释放。 22、在Java中CycliBarriar和CountdownLatch有什么区别? CyclicBarrier可以重复使用,而CountdownLatch不能重复使用。 Java的concurrent包里面的CountDownLatch其实可以把它看作一个计数器,只不过这个计数器的操作是原子操作,同时只能有一个线程去操作这个计数器,也就是同时只能有一个线程去减这个计数器里面的值。 你可以向CountDownLatch对象设置一个初始的数字作为计数值,任何调用这个对象上的await()方法都会阻塞,直到这个计数器的计数值被其他的线程减为0为止。 所以在当前计数到达零之前,await 方法会一直受阻塞。之后,会释放所有等待的线程,await的所有后续调用都将立即返回。这种现象只出现一次——计数无法被重置。如果需要重置计数,请考虑使用 CyclicBarrier。 CountDownLatch的一个非常典型的应用场景是:有一个任务想要往下执行,但必须要等到其他的任务执行完毕后才可以继续往下执行。假如我们这个想要继续往下执行的任务调用一个CountDownLatch对象的await()方法,其他的任务执行完自己的任务后调用同一个CountDownLatch对象上的countDown()方法,这个调用await()方法的任务将一直阻塞等待,直到这个CountDownLatch对象的计数值减到0为止。 CyclicBarrier一个同步辅助类,它允许一组线程互相等待,直到到达某个公共屏障点 (common barrier point)。在涉及一组固定大小的线程的程序中,这些线程必须不时地互相等待,此时 CyclicBarrier 很有用。因为该 barrier 在释放等待线程后可以重用,所以称它为循环 的 barrier。 23、什么是不可变对象,它对写并发应用有什么帮助? 不可变对象(Immutable Objects)即对象一旦被创建它的状态(对象的数据,也即对象属性值)就不能改变,反之即为可变对象(Mutable Objects)。 不可变对象的类即为不可变类(Immutable Class)。Java平台类库中包含许多不可变类,如String、基本类型的包装类、BigInteger和BigDecimal等。 不可变对象天生是线程安全的。它们的常量(域)是在构造函数中创建的。既然它们的状态无法修改,这些常量永远不会变。 不可变对象永远是线程安全的。 只有满足如下状态,一个对象才是不可变的; 它的状态不能在创建后再被修改; 所有域都是final类型;并且, 它被正确创建(创建期间没有发生this引用的逸出)。 24、什么是多线程中的上下文切换? 在上下文切换过程中,CPU会停止处理当前运行的程序,并保存当前程序运行的具体位置以便之后继续运行。从这个角度来看,上下文切换有点像我们同时阅读几本书,在来回切换书本的同时我们需要记住每本书当前读到的页码。在程序中,上下文切换过程中的“页码”信息是保存在进程控制块(PCB)中的。PCB还经常被称作“切换桢”(switchframe)。“页码”信息会一直保存到CPU的内存中,直到他们被再次使用。 上下文切换是存储和恢复CPU状态的过程,它使得线程执行能够从中断点恢复执行。上下文切换是多任务操作系统和多线程环境的基本特征。 25、Java中用到的线程调度算法是什么? 计算机通常只有一个CPU,在任意时刻只能执行一条机器指令,每个线程只有获得CPU的使用权才能执行指令.所谓多线程的并发运行,其实是指从宏观上看,各个线程轮流获得CPU的使用权,分别执行各自的任务.在运行池中,会有多个处于就绪状态的线程在等待CPU,JAVA虚拟机的一项任务就是负责线程的调度,线程调度是指按照特定机制为多个线程分配CPU的使用权. 有两种调度模型:分时调度模型和抢占式调度模型。 分时调度模型是指让所有的线程轮流获得cpu的使用权,并且平均分配每个线程占用的CPU的时间片这个也比较好理解。 java虚拟机采用抢占式调度模型,是指优先让可运行池中优先级高的线程占用CPU,如果可运行池中的线程优先级相同,那么就随机选择一个线程,使其占用CPU。处于运行状态的线程会一直运行,直至它不得不放弃CPU。 26、什么是线程组,为什么在Java中不推荐使用? 线程组和线程池是两个不同的概念,他们的作用完全不同,前者是为了方便线程的管理,后者是为了管理线程的生命周期,复用线程,减少创建销毁线程的开销。 27、为什么使用Executor框架比使用应用创建和管理线程好? 为什么要使用Executor线程池框架 1、每次执行任务创建线程 new Thread()比较消耗性能,创建一个线程是比较耗时、耗资源的。 2、调用 new Thread()创建的线程缺乏管理,被称为野线程,而且可以无限制的创建,线程之间的相互竞争会导致过多占用系统资源而导致系统瘫痪,还有线程之间的频繁交替也会消耗很多系统资源。 3、直接使用new Thread() 启动的线程不利于扩展,比如定时执行、定期执行、定时定期执行、线程中断等都不便实现。 使用Executor线程池框架的优点 1、能复用已存在并空闲的线程从而减少线程对象的创建从而减少了消亡线程的开销。 2、可有效控制最大并发线程数,提高系统资源使用率,同时避免过多资源竞争。 3、框架中已经有定时、定期、单线程、并发数控制等功能。 综上所述使用线程池框架Executor能更好的管理线程、提供系统资源使用率。 28、java中有几种方法可以实现一个线程? 继承 Thread 类 实现 Runnable 接口 实现 Callable 接口,需要实现的是 call() 方法 29、如何停止一个正在运行的线程? 使用共享变量的方式 在这种方式中,之所以引入共享变量,是因为该变量可以被多个执行相同任务的线程用来作为是否中断的信号,通知中断线程的执行。 使用interrupt方法终止线程 如果一个线程由于等待某些事件的发生而被阻塞,又该怎样停止该线程呢?这种情况经常会发生,比如当一个线程由于需要等候键盘输入而被阻塞,或者调用Thread.join()方法,或者Thread.sleep()方法,在网络中调用ServerSocket.accept()方法,或者调用了DatagramSocket.receive()方法时,都有可能导致线程阻塞,使线程处于处于不可运行状态时,即使主程序中将该线程的共享变量设置为true,但该线程此时根本无法检查循环标志,当然也就无法立即中断。这里我们给出的建议是,不要使用stop()方法,而是使用Thread提供的interrupt()方法,因为该方法虽然不会中断一个正在运行的线程,但是它可以使一个被阻塞的线程抛出一个中断异常,从而使线程提前结束阻塞状态,退出堵塞代码。 30、notify()和notifyAll()有什么区别? 当一个线程进入wait之后,就必须等其他线程notify/notifyall,使用notifyall,可以唤醒所有处于wait状态的线程,使其重新进入锁的争夺队列中,而notify只能唤醒一个。 如果没把握,建议notifyAll,防止notigy因为信号丢失而造成程序异常。 31、什么是Daemon线程?它有什么意义? 所谓后台(daemon)线程,是指在程序运行的时候在后台提供一种通用服务的线程,并且这个线程并不属于程序中不可或缺的部分。因此,当所有的非后台线程结束时,程序也就终止了,同时会杀死进程中的所有后台线程。反过来说, 只要有任何非后台线程还在运行,程序就不会终止。必须在线程启动之前调用setDaemon()方法,才能把它设置为后台线程。注意:后台进程在不执行finally子句的情况下就会终止其run()方法。 比如:JVM的垃圾回收线程就是Daemon线程,Finalizer也是守护线程。 32、java如何实现多线程之间的通讯和协作? 中断 和 共享变量 33、什么是可重入锁(ReentrantLock)? 举例来说明锁的可重入性 public class UnReentrant{ Lock lock = new Lock(); public void outer(){ lock.lock(); inner(); lock.unlock(); } public void inner(){ lock.lock(); //do something lock.unlock(); } } outer中调用了inner,outer先锁住了lock,这样inner就不能再获取lock。其实调用outer的线程已经获取了lock锁,但是不能在inner中重复利用已经获取的锁资源,这种锁即称之为 不可重入可重入就意味着:线程可以进入任何一个它已经拥有的锁所同步着的代码块。 synchronized、ReentrantLock都是可重入的锁,可重入锁相对来说简化了并发编程的开发。 34、当一个线程进入某个对象的一个synchronized的实例方法后,其它线程是否可进入此对象的其它方法? 如果其他方法没有synchronized的话,其他线程是可以进入的。 所以要开放一个线程安全的对象时,得保证每个方法都是线程安全的。 35、乐观锁和悲观锁的理解及如何实现,有哪些实现方式? 悲观锁:总是假设最坏的情况,每次去拿数据的时候都认为别人会修改,所以每次在拿数据的时候都会上锁,这样别人想拿这个数据就会阻塞直到它拿到锁。传统的关系型数据库里边就用到了很多这种锁机制,比如行锁,表锁等,读锁,写锁等,都是在做操作之前先上锁。再比如Java里面的同步原语synchronized关键字的实现也是悲观锁。 乐观锁:顾名思义,就是很乐观,每次去拿数据的时候都认为别人不会修改,所以不会上锁,但是在更新的时候会判断一下在此期间别人有没有去更新这个数据,可以使用版本号等机制。乐观锁适用于多读的应用类型,这样可以提高吞吐量,像数据库提供的类似于write_condition机制,其实都是提供的乐观锁。在Java中java.util.concurrent.atomic包下面的原子变量类就是使用了乐观锁的一种实现方式CAS实现的。 乐观锁的实现方式: 1、使用版本标识来确定读到的数据与提交时的数据是否一致。提交后修改版本标识,不一致时可以采取丢弃和再次尝试的策略。 2、java中的Compare and Swap即CAS ,当多个线程尝试使用CAS同时更新同一个变量时,只有其中一个线程能更新变量的值,而其它线程都失败,失败的线程并不会被挂起,而是被告知这次竞争中失败,并可以再次尝试。 CAS 操作中包含三个操作数 —— 需要读写的内存位置(V)、进行比较的预期原值(A)和拟写入的新值(B)。如果内存位置V的值与预期原值A相匹配,那么处理器会自动将该位置值更新为新值B。否则处理器不做任何操作。 CAS缺点: 1. ABA问题: 比如说一个线程one从内存位置V中取出A,这时候另一个线程two也从内存中取出A,并且two进行了一些操作变成了B,然后two又将V位置的数据变成A,这时候线程one进行CAS操作发现内存中仍然是A,然后one操作成功。尽管线程one的CAS操作成功,但可能存在潜藏的问题。从Java1.5开始JDK的atomic包里提供了一个类AtomicStampedReference来解决ABA问题。 2、循环时间长开销大: 对于资源竞争严重(线程冲突严重)的情况,CAS自旋的概率会比较大,从而浪费更多的CPU资源,效率低于synchronized。 3、只能保证一个共享变量的原子操作: 当对一个共享变量执行操作时,我们可以使用循环CAS的方式来保证原子操作,但是对多个共享变量操作时,循环CAS就无法保证操作的原子性,这个时候就可以用锁。 36、SynchronizedMap和ConcurrentHashMap有什么区别? SynchronizedMap一次锁住整张表来保证线程安全,所以每次只能有一个线程来访为map。 ConcurrentHashMap使用分段锁来保证在多线程下的性能。ConcurrentHashMap中则是一次锁住一个桶。ConcurrentHashMap默认将hash表分为16个桶,诸如get,put,remove等常用操作只锁当前需要用到的桶。这样,原来只能一个线程进入,现在却能同时有16个写线程执行,并发性能的提升是显而易见的。 另外ConcurrentHashMap使用了一种不同的迭代方式。在这种迭代方式中,当iterator被创建后集合再发生改变就不再是抛出ConcurrentModificationException,取而代之的是在改变时new新的数据从而不影响原有的数据 ,iterator完成后再将头指针替换为新的数据 ,这样iterator线程可以使用原来老的数据,而写线程也可以并发的完成改变。 37、CopyOnWriteArrayList可以用于什么应用场景? CopyOnWriteArrayList(免锁容器)的好处之一是当多个迭代器同时遍历和修改这个列表时,不会抛出ConcurrentModificationException。在CopyOnWriteArrayList中,写入将导致创建整个底层数组的副本,而源数组将保留在原地,使得复制的数组在被修改时,读取操作可以安全地执行。 1、由于写操作的时候,需要拷贝数组,会消耗内存,如果原数组的内容比较多的情况下,可能导致young gc或者full gc; 2、不能用于实时读的场景,像拷贝数组、新增元素都需要时间,所以调用一个set操作后,读取到数据可能还是旧的,虽然CopyOnWriteArrayList 能做到最终一致性,但是还是没法满足实时性要求; CopyOnWriteArrayList透露的思想 1、读写分离,读和写分开 2、最终一致性 3、使用另外开辟空间的思路,来解决并发冲突 38、什么叫线程安全?servlet是线程安全吗? 线程安全是编程中的术语,指某个函数、函数库在多线程环境中被调用时,能够正确地处理多个线程之间的共享变量,使程序功能正确完成。 Servlet不是线程安全的,servlet是单实例多线程的,当多个线程同时访问同一个方法,是不能保证共享变量的线程安全性的。 Struts2的action是多实例多线程的,是线程安全的,每个请求过来都会new一个新的action分配给这个请求,请求完成后销毁。 SpringMVC的Controller是线程安全的吗?不是的,和Servlet类似的处理流程。 Struts2好处是不用考虑线程安全问题;Servlet和SpringMVC需要考虑线程安全问题,但是性能可以提升不用处理太多的gc,可以使用ThreadLocal来处理多线程的问题。 39、volatile有什么用?能否用一句话说明下volatile的应用场景? volatile保证内存可见性和禁止指令重排。 volatile用于多线程环境下的单次操作(单次读或者单次写)。 40、为什么代码会重排序? 在执行程序时,为了提供性能,处理器和编译器常常会对指令进行重排序,但是不能随意重排序,不是你想怎么排序就怎么排序,它需要满足以下两个条件: 在单线程环境下不能改变程序运行的结果; 存在数据依赖关系的不允许重排序 需要注意的是:重排序不会影响单线程环境的执行结果,但是会破坏多线程的执行语义。 41、在java中wait和sleep方法的不同? 最大的不同是在等待时wait会释放锁,而sleep一直持有锁。Wait通常被用于线程间交互,sleep通常被用于暂停执行。 直接了解的深入一点吧: 在Java中线程的状态一共被分成6种: 初始态:NEW 创建一个Thread对象,但还未调用start()启动线程时,线程处于初始态。 运行态:RUNNABLE 在Java中,运行态包括就绪态 和 运行态。 就绪态 该状态下的线程已经获得执行所需的所有资源,只要CPU分配执行权就能运行。所有就绪态的线程存放在就绪队列中。 运行态 获得CPU执行权,正在执行的线程。由于一个CPU同一时刻只能执行一条线程,因此每个CPU每个时刻只有一条运行态的线程。 阻塞态 当一条正在执行的线程请求某一资源失败时,就会进入阻塞态。而在Java中,阻塞态专指请求锁失败时进入的状态。由一个阻塞队列存放所有阻塞态的线程。处于阻塞态的线程会不断请求资源,一旦请求成功,就会进入就绪队列,等待执行。PS:锁、IO、Socket等都资源。 等待态 当前线程中调用wait、join、park函数时,当前线程就会进入等待态。也有一个等待队列存放所有等待态的线程。线程处于等待态表示它需要等待其他线程的指示才能继续运行。进入等待态的线程会释放CPU执行权,并释放资源(如:锁) 超时等待态 当运行中的线程调用sleep(time)、wait、join、parkNanos、parkUntil时,就会进入该状态;它和等待态一样,并不是因为请求不到资源,而是主动进入,并且进入后需要其他线程唤醒;进入该状态后释放CPU执行权 和 占有的资源。与等待态的区别:到了超时时间后自动进入阻塞队列,开始竞争锁。 终止态 线程执行结束后的状态。 注意: wait()方法会释放CPU执行权 和 占有的锁。 sleep(long)方法仅释放CPU使用权,锁仍然占用;线程被放入超时等待队列,与yield相比,它会使线程较长时间得不到运行。 yield()方法仅释放CPU执行权,锁仍然占用,线程会被放入就绪队列,会在短时间内再次执行。 wait和notify必须配套使用,即必须使用同一把锁调用; wait和notify必须放在一个同步块中调用wait和notify的对象必须是他们所处同步块的锁对象。 42、用Java实现阻塞队列 参考java中的阻塞队列的内容吧,直接实现有点烦: http://www.infoq.com/cn/articles/java-blocking-queue 43、一个线程运行时发生异常会怎样? 如果异常没有被捕获该线程将会停止执行。Thread.UncaughtExceptionHandler是用于处理未捕获异常造成线程突然中断情况的一个内嵌接口。当一个未捕获异常将造成线程中断的时候JVM会使用Thread.getUncaughtExceptionHandler()来查询线程的UncaughtExceptionHandler并将线程和异常作为参数传递给handler的uncaughtException()方法进行处理。 44、如何在两个线程间共享数据? 在两个线程间共享变量即可实现共享。 一般来说,共享变量要求变量本身是线程安全的,然后在线程内使用的时候,如果有对共享变量的复合操作,那么也得保证复合操作的线程安全性。 45、Java中notify 和 notifyAll有什么区别? notify() 方法不能唤醒某个具体的线程,所以只有一个线程在等待的时候它才有用武之地。而notifyAll()唤醒所有线程并允许他们争夺锁确保了至少有一个线程能继续运行。 46、为什么wait, notify 和 notifyAll这些方法不在thread类里面? 一个很明显的原因是JAVA提供的锁是对象级的而不是线程级的,每个对象都有锁,通过线程获得。由于wait,notify和notifyAll都是锁级别的操作,所以把他们定义在Object类中因为锁属于对象。 47、什么是ThreadLocal变量? ThreadLocal是Java里一种特殊的变量。每个线程都有一个ThreadLocal就是每个线程都拥有了自己独立的一个变量,竞争条件被彻底消除了。它是为创建代价高昂的对象获取线程安全的好方法,比如你可以用ThreadLocal让SimpleDateFormat变成线程安全的,因为那个类创建代价高昂且每次调用都需要创建不同的实例所以不值得在局部范围使用它,如果为每个线程提供一个自己独有的变量拷贝,将大大提高效率。首先,通过复用减少了代价高昂的对象的创建个数。其次,你在没有使用高代价的同步或者不变性的情况下获得了线程安全。 48、Java中interrupted 和 isInterrupted方法的区别? interrupt interrupt方法用于中断线程。调用该方法的线程的状态为将被置为”中断”状态。 注意:线程中断仅仅是置线程的中断状态位,不会停止线程。需要用户自己去监视线程的状态为并做处理。支持线程中断的方法(也就是线程中断后会抛出interruptedException的方法)就是在监视线程的中断状态,一旦线程的中断状态被置为“中断状态”,就会抛出中断异常。 interrupted 查询当前线程的中断状态,并且清除原状态。如果一个线程被中断了,第一次调用interrupted则返回true,第二次和后面的就返回false了。 isInterrupted 仅仅是查询当前线程的中断状态 49、为什么wait和notify方法要在同步块中调用? Java API强制要求这样做,如果你不这么做,你的代码会抛出IllegalMonitorStateException异常。还有一个原因是为了避免wait和notify之间产生竞态条件。 50、为什么你应该在循环中检查等待条件? 处于等待状态的线程可能会收到错误警报和伪唤醒,如果不在循环中检查等待条件,程序就会在没有满足结束条件的情况下退出。 51、Java中的同步集合与并发集合有什么区别? 同步集合与并发集合都为多线程和并发提供了合适的线程安全的集合,不过并发集合的可扩展性更高。在Java1.5之前程序员们只有同步集合来用且在多线程并发的时候会导致争用,阻碍了系统的扩展性。Java5介绍了并发集合像ConcurrentHashMap,不仅提供线程安全还用锁分离和内部分区等现代技术提高了可扩展性。 52、什么是线程池? 为什么要使用它? 创建线程要花费昂贵的资源和时间,如果任务来了才创建线程那么响应时间会变长,而且一个进程能创建的线程数有限。为了避免这些问题,在程序启动的时候就创建若干线程来响应处理,它们被称为线程池,里面的线程叫工作线程。从JDK1.5开始,Java API提供了Executor框架让你可以创建不同的线程池。 53、怎么检测一个线程是否拥有锁? 在java.lang.Thread中有一个方法叫holdsLock(),它返回true如果当且仅当当前线程拥有某个具体对象的锁。 54、你如何在Java中获取线程堆栈? kill -3 [java pid] 不会在当前终端输出,它会输出到代码执行的或指定的地方去。比如,kill -3 tomcat pid, 输出堆栈到log目录下。 Jstack [java pid] 这个比较简单,在当前终端显示,也可以重定向到指定文件中。 -JvisualVM:Thread Dump 不做说明,打开JvisualVM后,都是界面操作,过程还是很简单的。 55、JVM中哪个参数是用来控制线程的栈堆栈小的? -Xss 每个线程的栈大小 56、Thread类中的yield方法有什么作用? 使当前线程从执行状态(运行状态)变为可执行态(就绪状态)。 当前线程到了就绪状态,那么接下来哪个线程会从就绪状态变成执行状态呢?可能是当前线程,也可能是其他线程,看系统的分配了。 57、Java中ConcurrentHashMap的并发度是什么? ConcurrentHashMap把实际map划分成若干部分来实现它的可扩展性和线程安全。这种划分是使用并发度获得的,它是ConcurrentHashMap类构造函数的一个可选参数,默认值为16,这样在多线程情况下就能避免争用。 在JDK8后,它摒弃了Segment(锁段)的概念,而是启用了一种全新的方式实现,利用CAS算法。同时加入了更多的辅助变量来提高并发度,具体内容还是查看源码吧。 58、Java中Semaphore是什么? Java中的Semaphore是一种新的同步类,它是一个计数信号。从概念上讲,从概念上讲,信号量维护了一个许可集合。如有必要,在许可可用前会阻塞每一个 acquire(),然后再获取该许可。每个 release()添加一个许可,从而可能释放一个正在阻塞的获取者。但是,不使用实际的许可对象,Semaphore只对可用许可的号码进行计数,并采取相应的行动。信号量常常用于多线程的代码中,比如数据库连接池。 59、Java线程池中submit() 和 execute()方法有什么区别? 两个方法都可以向线程池提交任务,execute()方法的返回类型是void,它定义在Executor接口中。 而submit()方法可以返回持有计算结果的Future对象,它定义在ExecutorService接口中,它扩展了Executor接口,其它线程池类像ThreadPoolExecutor和ScheduledThreadPoolExecutor都有这些方法。 60、什么是阻塞式方法? 阻塞式方法是指程序会一直等待该方法完成期间不做其他事情,ServerSocket的accept()方法就是一直等待客户端连接。这里的阻塞是指调用结果返回之前,当前线程会被挂起,直到得到结果之后才会返回。此外,还有异步和非阻塞式方法在任务完成前就返回。 61、Java中的ReadWriteLock是什么? 读写锁是用来提升并发程序性能的锁分离技术的成果。 62、volatile 变量和 atomic 变量有什么不同? Volatile变量可以确保先行关系,即写操作会发生在后续的读操作之前, 但它并不能保证原子性。例如用volatile修饰count变量那么 count++ 操作就不是原子性的。 而AtomicInteger类提供的atomic方法可以让这种操作具有原子性如getAndIncrement()方法会原子性的进行增量操作把当前值加一,其它数据类型和引用变量也可以进行相似操作。 63、可以直接调用Thread类的run ()方法么? 当然可以。但是如果我们调用了Thread的run()方法,它的行为就会和普通的方法一样,会在当前线程中执行。为了在新的线程中执行我们的代码,必须使用Thread.start()方法。 64、如何让正在运行的线程暂停一段时间? 我们可以使用Thread类的Sleep()方法让线程暂停一段时间。需要注意的是,这并不会让线程终止,一旦从休眠中唤醒线程,线程的状态将会被改变为Runnable,并且根据线程调度,它将得到执行。 65、你对线程优先级的理解是什么? 每一个线程都是有优先级的,一般来说,高优先级的线程在运行时会具有优先权,但这依赖于线程调度的实现,这个实现是和操作系统相关的(OS dependent)。我们可以定义线程的优先级,但是这并不能保证高优先级的线程会在低优先级的线程前执行。线程优先级是一个int变量(从1-10),1代表最低优先级,10代表最高优先级。 java的线程优先级调度会委托给操作系统去处理,所以与具体的操作系统优先级有关,如非特别需要,一般无需设置线程优先级。 66、什么是线程调度器(Thread Scheduler)和时间分片(Time Slicing )? 线程调度器是一个操作系统服务,它负责为Runnable状态的线程分配CPU时间。一旦我们创建一个线程并启动它,它的执行便依赖于线程调度器的实现。 同上一个问题,线程调度并不受到Java虚拟机控制,所以由应用程序来控制它是更好的选择(也就是说不要让你的程序依赖于线程的优先级)。 时间分片是指将可用的CPU时间分配给可用的Runnable线程的过程。分配CPU时间可以基于线程优先级或者线程等待的时间。 67、你如何确保main()方法所在的线程是Java 程序最后结束的线程? 我们可以使用Thread类的join()方法来确保所有程序创建的线程在main()方法退出前结束。 68、线程之间是如何通信的? 当线程间是可以共享资源时,线程间通信是协调它们的重要的手段。Object类中wait()\notify()\notifyAll()方法可以用于线程间通信关于资源的锁的状态。 69、为什么线程通信的方法wait(), notify()和notifyAll()被定义在Object 类里? Java的每个对象中都有一个锁(monitor,也可以成为监视器) 并且wait(),notify()等方法用于等待对象的锁或者通知其他线程对象的监视器可用。在Java的线程中并没有可供任何对象使用的锁和同步器。这就是为什么这些方法是Object类的一部分,这样Java的每一个类都有用于线程间通信的基本方法。 70、为什么wait(), notify()和notifyAll ()必须在同步方法或者同步块中被调用? 当一个线程需要调用对象的wait()方法的时候,这个线程必须拥有该对象的锁,接着它就会释放这个对象锁并进入等待状态直到其他线程调用这个对象上的notify()方法。同样的,当一个线程需要调用对象的notify()方法时,它会释放这个对象的锁,以便其他在等待的线程就可以得到这个对象锁。由于所有的这些方法都需要线程持有对象的锁,这样就只能通过同步来实现,所以他们只能在同步方法或者同步块中被调用。 71、为什么Thread类的sleep()和yield ()方法是静态的? Thread类的sleep()和yield()方法将在当前正在执行的线程上运行。所以在其他处于等待状态的线程上调用这些方法是没有意义的。这就是为什么这些方法是静态的。它们可以在当前正在执行的线程中工作,并避免程序员错误的认为可以在其他非运行线程调用这些方法。 72、如何确保线程安全? 在Java中可以有很多方法来保证线程安全——同步,使用原子类(atomic concurrent classes),实现并发锁,使用volatile关键字,使用不变类和线程安全类。 73、同步方法和同步块,哪个是更好的选择? 同步块是更好的选择,因为它不会锁住整个对象(当然你也可以让它锁住整个对象)。同步方法会锁住整个对象,哪怕这个类中有多个不相关联的同步块,这通常会导致他们停止执行并需要等待获得这个对象上的锁。 同步块更要符合开放调用的原则,只在需要锁住的代码块锁住相应的对象,这样从侧面来说也可以避免死锁。 74、如何创建守护线程? 使用Thread类的setDaemon(true)方法可以将线程设置为守护线程,需要注意的是,需要在调用start()方法前调用这个方法,否则会抛出IllegalThreadStateException异常。 75、什么是Java Timer 类?如何创建一个有特定时间间隔的任务? java.util.Timer是一个工具类,可以用于安排一个线程在未来的某个特定时间执行。Timer类可以用安排一次性任务或者周期任务。 java.util.TimerTask是一个实现了Runnable接口的抽象类,我们需要去继承这个类来创建我们自己的定时任务并使用Timer去安排它的执行。 目前有开源的Qurtz可以用来创建定时任务。 --------------------- 作者:乌枭 原文:https://blog.csdn.net/qq_34039315/article/details/78549311

优秀的个人博客,低调大师

31道Android面试题 ,牢固你的基础!

阅读目录 1.如何对 Android 应用进行性能分析 2.什么情况下会导致内存泄露 3.如何避免 OOM 异常 4.Android 中如何捕获未捕获的异常 5.ANR 是什么?怎样避免和解决 ANR(重要) 6.Android 线程间通信有哪几种方式 7.Devik 进程,linux 进程,线程的区别 8.描述一下 android 的系统架构 9.android 应用对内存是如何限制的?我们应该如何合理使用内存? 10. 简述 android 应用程序结构是哪些 11.请解释下 Android 程序运行时权限与文件系统权限的区别 12.Framework 工作方式及原理,Activity 是如何生成一个 view 的,机制是什么 13.多线程间通信和多进程之间通信有什么不同,分别怎么实现 14.Android 屏幕适配 15.什么是 AIDL 以及如何使用 16.Handler 机制 17.事件分发机制 18.子线程发消息到主线程进行更新 UI,除了 handler 和 AsyncTask,还有什么 19.子线程中能不能 new handler?为什么 20.Android 中的动画有哪几类,它们的特点和区别是什么 21.如何修改 Activity 进入和退出动画 22.SurfaceView & View 的区别 23.开发中都使用过哪些框架、平台 24.使用过那些自定义View 25.自定义控件:绘制圆环的实现过程 26.自定义控件:摩天轮的实现过程 27.GridLayout的使用 28.流式布局的实现过程 29.第三方登陆 30.第三方支付 31.进程保活 一 性能优化 1.如何对 Android 应用进行性能分析 android 性能主要之响应速度 和UI刷新速度。 可以参考博客:Android系统性能调优工具介绍 首先从函数的耗时来说,有一个工具TraceView 这是androidsdk自带的工作,用于测量函数耗时的。 UI布局的分析,可以有2块,一块就是Hierarchy Viewer 可以看到View的布局层次,以及每个View刷新加载的时间。 这样可以很快定位到那块layout & View 耗时最长。 还有就是通过自定义View来减少view的层次。 浅谈App的性能优化 Android性能优化:手把手带你全面实现内存优化 Android性能优化 (1)—— 内存溢出和内存泄漏的介绍 2.什么情况下会导致内存泄露 内存泄露是个折腾的问题。 什么时候会发生内存泄露?内存泄露的根本原因:长生命周期的对象持有短生命周期的对象。短周期对象就无法及时释放。 I. 静态集合类引起内存泄露 主要是hashmap,Vector等,如果是静态集合 这些集合没有及时setnull的话,就会一直持有这些对象。 II.remove 方法无法删除set集 Objects.hash(firstName, lastName); 经过测试,hashcode修改后,就没有办法remove了。 III. observer 我们在使用监听器的时候,往往是addxxxlistener,但是当我们不需要的时候,忘记removexxxlistener,就容易内存leak。 广播没有unregisterrecevier IV.各种数据链接没有关闭,数据库contentprovider,io,sokect等。cursor V.内部类: java中的内部类(匿名内部类),会持有宿主类的强引用this。 所以如果是new Thread这种,后台线程的操作,当线程没有执行结束时,activity不会被回收。 Context的引用,当TextView 等等都会持有上下文的引用。如果有static drawable,就会导致该内存无法释放。 VI.单例 单例 是一个全局的静态对象,当持有某个复制的类A是,A无法被释放,内存leak。 3.如何避免 OOM 异常 首先OOM是什么? 当程序需要申请一段“大”内存,但是虚拟机没有办法及时的给到,即使做了GC操作以后 这就会抛出 OutOfMemoryException 也就是OOM Android的OOM怎么样? 为了减少单个APP对整个系统的影响,android为每个app设置了一个内存上限。 publicvoidgetMemoryLimited(Activity context) { ActivityManager activityManager =(ActivityManager)context.getSystemService(Context.ACTIVITY_SERVICE); System.out.println(activityManager.getMemoryClass()); System.out.println(activityManager.getLargeMemoryClass()); System.out.println(Runtime.getRuntime().maxMemory()/(1024*1024)); } HTC M7实测,192M上限。512M 一般情况下,192M就是上限,但是由于某些特殊情况,android允许使用一个更大的RAM。 如何避免OOM 减少内存对象的占用 I.ArrayMap/SparseArray代替hashmap II.避免在android里面使用Enum III.减少bitmap的内存占用 inSampleSize:缩放比例,在把图片载入内存之前,我们需要先计算出一个合适的缩放比例,避免不必要的大图载入。 decode format:解码格式,选择ARGB_8888/RBG_565/ARGB_4444/ALPHA_8,存在很大差异。 IV.减少资源图片的大小,过大的图片可以考虑分段加载 内存对象的重复利用 大多数对象的复用,都是利用对象池的技术。 I.listview/gridview/recycleview contentview的复用 II.inBitmap 属性对于内存对象的复用ARGB_8888/RBG_565/ARGB_4444/ALPHA_8 这个方法在某些条件下非常有用,比如要加载上千张图片的时候。 III.避免在ondraw方法里面 new对象 IV.StringBuilder 代替+ 4.Android 中如何捕获未捕获的异常 CrashHandler 关键是实现Thread.UncaughtExceptionHandler 然后是在application的oncreate里面注册。 5.ANR 是什么?怎样避免和解决 ANR(重要) ANR->Application Not Responding 也就是在规定的时间内,没有响应。 三种类型: 1). KeyDispatchTimeout(5 seconds) —主要类型按键或触摸事件在特定时间内无响应 2). BroadcastTimeout(10 seconds) —BroadcastReceiver在特定时间内无法处理完成 3). ServiceTimeout(20 seconds) —小概率类型 Service在特定的时间内无法处理完成 为什么会超时:事件没有机会处理 & 事件处理超时 怎么避免ANR ANR的关键 是处理超时,所以应该避免在UI线程,BroadcastReceiver 还有service主线程中,处理复杂的逻辑和计算 而交给work thread操作。 1)避免在activity里面做耗时操作,oncreate & onresume 2)避免在onReceiver里面做过多操作 3)避免在Intent Receiver里启动一个Activity,因为它会创建一个新的画面,并从当前用户正在运行的程序上抢夺焦点。 4)尽量使用handler来处理UI thread & workthread的交互。 如何解决ANR 首先定位ANR发生的log: 04-0113:12:11.572I/InputDispatcher(220): Applicationisnot responding:Window{2b263310com.android.email/com.android.email.activity.SplitScreenActivitypaused=false}. 5009.8ms since event,5009.5ms since waitstarted CPUusage from4361msto699ms ago ----CPU在ANR发生前的使用情况04-0113:12:15.872E/ActivityManager( 220):100%TOTAL:4.8% user +7.6% kernel +87% iowait04-0113:12:15.872E/ActivityManager( 220): CPUusage from3697msto4223mslater:-- ANR后CPU的使用量 从log可以看出,cpu在做大量的io操作。 所以可以查看io操作的地方。 当然,也有可能cpu占用不高,那就是 主线程被block住了。 6.Android 线程间通信有哪几种方式 1)共享变量(内存) 2)管道 3)handle机制 runOnUiThread(Runnable) view.post(Runnable) 7.Devik 进程,linux 进程,线程的区别 Dalvik进程。 每一个android app都会独立占用一个dvm虚拟机,运行在linux系统中。 所以dalvik进程和linux进程是可以理解为一个概念。 你真正了解Java虚拟机吗—高级开发必备《深入了解Java虚拟机》 8.描述一下 android 的系统架构 从小到上就是: linux kernel,lib dalvik vm ,application framework, app 9.android 应用对内存是如何限制的?我们应该如何合理使用内存? activitymanager.getMemoryClass() 获取内存限制。 关于合理使用内存,其实就是避免OOM & 内存泄露中已经说明。 10. 简述 android 应用程序结构是哪些 1)main code 2) unit test 3)mianifest 4)res->drawable,drawable-xxhdpi,layout,value,mipmap mipmap 是一种很早就有的技术了,翻译过来就是纹理映射技术. google建议只把启动图片放入。 5)lib 6)color 11.请解释下 Android 程序运行时权限与文件系统权限的区别 文件的系统权限是由linux系统规定的,只读,读写等。 运行时权限,是对于某个系统上的app的访问权限,允许,拒绝,询问。该功能可以防止非法的程序访问敏感的信息。 12.Framework 工作方式及原理,Activity 是如何生成一个 view 的,机制是什么 Framework是android 系统对 linux kernel,lib库等封装,提供WMS,AMS,bind机制,handler-message机制等方式,供app使用。 简单来说framework就是提供app生存的环境。 1)Activity在attch方法的时候,会创建一个phonewindow(window的子类) 2)onCreate中的setContentView方法,会创建DecorView 3)DecorView 的addview方法,会把layout中的布局加载进来。 13.多线程间通信和多进程之间通信有什么不同,分别怎么实现 线程间的通信可以参考第6点。 进程间的通信:bind机制(IPC->AIDL),linux级共享内存,boradcast, Activity 之间,activity & serview之间的通信,无论他们是否在一个进程内。 14.Android 屏幕适配 屏幕适配的方式:xxxdpi, wrap_content,match_parent. 获取屏幕大小,做处理。 dp来适配屏幕,sp来确定字体大小 drawable-xxdpi, values-1280*1920等 这些就是资源的适配。 wrap_content,match_parent, 这些是view的自适应 weight,这是权重的适配。 Android屏幕适配框架-(今日头条终极适配方案) 15.什么是 AIDL 以及如何使用 Android Interface Definition Language AIDL是使用bind机制来工作。 参数: java原生参数 String parcelable list & map 元素 需要支持AIDL 16.Handler 机制 参考:android 进程/线程管理(一)——消息机制的框架这个系类。 17.事件分发机制 android 事件分发机制 带你一起探究Android事件分发机制, 让面试提问不在畏惧! Android触摸事件分发机制完全解析《一》 18.子线程发消息到主线程进行更新 UI,除了 handler 和 AsyncTask,还有什么 EventBus,广播,view.post, runinUiThread 但是无论各种花样,本质上就2种:handler机制 + 广播 你真正了解UI线程更新的几种方式吗,面试必备之深度揭秘 19.子线程中能不能 new handler?为什么 必须可以。子线程 可以new 一个mainHandler,然后发送消息到UI Thread。 带你一步一步深入Handler源码,拿下面试官不在话下 Handler消息机制完全解析(三)—Handler解析 Handler消息机制完全解析(二)MessageQueue的队列管理 Handler消息机制完全解析(一)Message中obtain()与recycle()的来龙去脉 20.Android 中的动画有哪几类,它们的特点和区别是什么 视图动画,或者说补间动画。只是视觉上的一个效果,实际view属性没有变化,性能好,但是支持方式少。 属性动画,通过变化属性来达到动画的效果,性能略差,支持点击等事件。android 3.0 帧动画,通过drawable一帧帧画出来。 Gif动画,原理同上,canvas画出来。 具体可参考:https://i.cnblogs.com/posts?categoryid=672052 21.如何修改 Activity 进入和退出动画 overridePendingTransition 22.SurfaceView & View 的区别 view的更新必须在UI thread中进行 surfaceview会单独有一个线程做ui的更新。 surfaceview 支持open GL绘制。 二项目框架的使用 23.开发中都使用过哪些框架、平台 I.EventBus 事件分发机制,由handler实现,线程间通信 II.xUtils->DbUtils,ViewUtils,HttpUtils,BitmapUtils III.百度地图 IV.volley V.fastjson VI.picciso VII.友盟 VIII.zxing IX.Gson 24.使用过那些自定义View pull2RefreshListView 25.自定义控件:绘制圆环的实现过程 publicclassCycleViewextendsView{ Paint mPaint =newPaint();publicCycleView(Context context){this(context,null); }publicCycleView(Context context, AttributeSet attrs){super(context, attrs); initView(); }privatevoidinitView(){ mPaint.setAntiAlias(true); mPaint.setStyle(Paint.Style.STROKE); mPaint.setStrokeWidth(20); } @OverrideprotectedvoidonDraw(Canvas canvas){super.onDraw(canvas); canvas.drawCircle(100,100,50,mPaint); } } 关键是canvas.drawCycle & paint.setsytle(stoken) 26.自定义控件:摩天轮的实现过程 参考链接 https://github.com/danylovolokh/LondonEyeLayoutManager 27.GridLayout的使用 参考链接 https://blog.csdn.net/k316378085/article/details/52316633 28.流式布局的实现过程 参考链接 https://blog.csdn.net/sz237812861/article/details/78383484?locationNum=4&fps=1 29.第三方登陆 参考链接 https://blog.csdn.net/alpha58/article/details/75210753 30.第三方支付 参考链接 https://blog.csdn.net/androidstarjack/article/details/72669394 【干货】微信支付,银联支付,支付宝支付——三大支付总结你get到了吗 31.进程保活 参考链接 2018年Android的保活方案效果统计 原文发布时间为:2018-10-9 本文作者:yuer 本文来自云栖社区合作伙伴“终端研发部”,了解相关信息可以关注“终端研发部”。

优秀的个人博客,低调大师

Android 70道面试题汇总不再愁面试

本文为开发者奉献了70道经典Android面试题加答案--重要知识点几乎都涉及到了,你还等啥,赶紧收藏吧!! 1. 下列哪些语句关于内存回收的说明是正确的? (b ) A、 程序员必须创建一个线程来释放内存 B、 内存回收程序负责释放无用内存 C、 内存回收程序允许程序员直接释放内存 D、 内存回收程序可以在指定的时间释放内存对象 2. 下面异常是属于Runtime Exception 的是(abcd)(多选) A、ArithmeticException B、IllegalArgumentException C、NullPointerException D、BufferUnderflowException 3. Math.round(11.5)等于多少(). Math.round(-11.5)等于多少(c). c A、11 ,-11 B、11 ,-12 C、12 ,-11 D、12 ,-12 4. 下列程序段的输出结果是:(b ) void complicatedexpression_r(){ int x=20, y=30; boolean b; b=x>50&&y>60||x>50&&y<-60||x<-50&&y>60||x<-50&&y<-60; System.out.println(b); } A、true B、false C、1 D、011.activity 5. 对一些资源以及状态的操作保存,最好是保存在生命周期的哪个函数中进行(d) A、onPause() B、onCreate() C、 onResume() D、onStart() 6. Intent传递数据时,下列的数据类型哪些可以被传递(abcd)(多选) A、Serializable B、charsequence C、Parcelable D、Bundle 7. android 中下列属于Intent的作用的是(c) A、实现应用程序间的数据共享 B、是一段长的生命周期,没有用户界面的程序,可以保持应用在后台运行,而不会因为切换页面而消失 C、可以实现界面间的切换,可以包含动作和动作数据,连接四大组件的纽带 D、处理一个应用程序整体性的工作 8. 下列属于SAX解析xml文件的优点的是(b) A、将整个文档树在内存中,便于操作,支持删除,修改,重新排列等多种功能 B、不用事先调入整个文档,占用资源少 C、整个文档调入内存,浪费时间和空间 D、不是长久驻留在内存,数据不是持久的,事件过后,若没有保存数据,数据就会 消失 9. 下面的对自定style的方式正确的是 A、 <resources> <style name="myStyle"> <itemname="android:layout_width">fill_parent</item> </style> </resources> B、 <style name="myStyle"> <itemname="android:layout_width">fill_parent</item> </style> C、 <resources> <itemname="android:layout_width">fill_parent</item> </resources> D、 <resources> <stylename="android:layout_width">fill_parent</style> </resources> 10. 在android中使用Menu时可能需要重写的方法有(ac)。(多选) A、onCreateOptionsMenu() B、onCreateMenu() C、onOptionsItemSelected() D、onItemSelected() 11. 在SQL Server Management Studio 中运行下列T-SQL语句,其输出值(c)。 SELECT @@IDENTITY A、 可能为0.1 B、 可能为3 C、 不可能为-100 D、 肯定为0 12. 在SQL Server 2005中运行如下T-SQL语句,假定SALES表中有多行数据,执行查询之 后的结果是(d)。 BEGIN TRANSACTION A Update SALES Set qty=30 WHERE qty<30 BEGIN TRANSACTION B Update SALES Set qty=40 WHEREqty<40 Update SALES Set qty=50 WHEREqty<50 Update SALES Set qty=60 WHEREqty<60 COMMIT TRANSACTION B COMMIT TRANSACTION A A、SALES表中qty列最小值大于等于30 B、SALES表中qty列最小值大于等于40 C、SALES表中qty列的数据全部为50 D、SALES表中qty列最小值大于等于60 13. 在android中使用SQLiteOpenHelper这个辅助类时,可以生成一个数据库,并可以对数据库版本进行管理的方法可以是(ab) A、getWriteableDatabase() B、getReadableDatabase() C、getDatabase() D、getAbleDatabase() 14. android 关于service生命周期的onCreate()和onStart()说法正确的是(ad)(多选题) A、当第一次启动的时候先后调用onCreate()和onStart()方法 B、当第一次启动的时候只会调用onCreate()方法 C、如果service已经启动,将先后调用onCreate()和onStart()方法 D、如果service已经启动,只会执行onStart()方法,不在执行onCreate()方法 15. 下面是属于GLSurFaceView特性的是(abc)(多选) A、管理一个surface,这个surface就是一块特殊的内存,能直接排版到android的视图 view上。 B、管理一个EGL display,它能让opengl把内容渲染到上述的surface上。 C、让渲染器在独立的线程里运作,和UI线程分离。 D、可以直接从内存或者DMA等硬件接口取得图像数据 16. 下面在AndroidManifest.xml文件中注册BroadcastReceiver方式正确的 A、<receiver android:name="NewBroad"> <intent-filter> <action android:name="android.provider.action.NewBroad"/> <action> </intent-filter> </receiver> B、<receiver android:name="NewBroad"> <intent-filter> android:name="android.provider.action.NewBroad"/> </intent-filter> </receiver> C、<receiver android:name="NewBroad"> <action android:name="android.provider.action.NewBroad"/> <action> </receiver> D、<intent-filter> <receiver android:name="NewBroad"> <action> android:name="android.provider.action.NewBroad"/> <action> </receiver> </intent-filter> 17. 关于ContenValues类说法正确的是(a) A、他和Hashtable比较类似,也是负责存储一些名值对,但是他存储的名值对当中的 名是String类型,而值都是基本类型 B、他和Hashtable比较类似,也是负责存储一些名值对,但是他存储的名值对当中的 名是任意类型,而值都是基本类型 C、他和Hashtable比较类似,也是负责存储一些名值对,但是他存储的名值对当中的 名,可以为空,而值都是String类型 D、他和Hashtable比较类似,也是负责存储一些名值对,但是他存储的名值对当中 的名是String类型,而值也是String类型 18. 我们都知道Hanlder是线程与Activity通信的桥梁,如果线程处理不当,你的机器就会变得越慢,那么线程销毁的方法是(a) A、onDestroy() B、onClear() C、onFinish() D、onStop() 19. 下面退出Activity错误的方法是(c) A、finish() B、抛异常强制退出 C、System.exit() D、onStop() 20. 下面属于android的动画分类的有(ab)(多项) A、Tween B、Frame C、Draw D、Animation 21. 下面关于Android dvm的进程和Linux的进程,应用程序的进程说法正确的是(d) A、DVM指dalivk的虚拟机.每一个Android应用程序都在它自己的进程中运行,不一定拥有一个独立的Dalvik虚拟机实例.而每一个DVM都是在Linux中的一个进程,所以说可以认为是同一个概念. B、DVM指dalivk的虚拟机.每一个Android应用程序都在它自己的进程中运行,不一定拥有一个独立的Dalvik虚拟机实例.而每一个DVM不一定都是在Linux中的一个进程,所以说不是一个概念. C、DVM指dalivk的虚拟机.每一个Android应用程序都在它自己的进程中运行,都拥有一个独立的Dalvik虚拟机实例.而每一个DVM不一定都是在Linux中的一个进程,所以说不是一个概念. D、DVM指dalivk的虚拟机.每一个Android应用程序都在它自己的进程中运行,都拥有一个独立的 Dalvik虚拟机实例.而每一个DVM都是在Linux中的一个进程,所以说可以认为是同一个概念. 22. Android项目工程下面的assets目录的作用是什么bA、放置应用到的图片资源。 B、主要放置多媒体等数据文件 C、放置字符串,颜色,数组等常量数据 D、放置一些与UI相应的布局文件,都是xml文件 23. 关于res/raw目录说法正确的是(a)A、 这里的文件是原封不动的存储到设备上不会转换为二进制的格式 B、这里的文件是原封不动的存储到设备上会转换为二进制的格式 C、 这里的文件最终以二进制的格式存储到指定的包中 D、这里的文件最终不会以二进制的格式存储到指定的包中 24. 下列对android NDK的理解正确的是(abcd )A、 NDK是一系列工具的集合 B、 NDK 提供了一份稳定、功能有限的 API 头文件声明。 C、 使 “Java+C” 的开发方式终于转正,成为官方支持的开发方式 D、 NDK 将是 Android 平台支持 C 开发的开端 二.文件存储方式 三.SQLite数据库方式 四.内容提供器(Content provider)方式 二、Android面试填空题 25. android中常用的四个布局是framlayout,linenarlayout,relativelayout和tablelayout。26. android 的四大组件是activiey,service,broadcast和contentprovide。27. java.io包中的objectinputstream和objectoutputstream类主要用于对对象(Object)的读写。28. android 中service的实现方法是:startservice和bindservice。29. activity一般会重载7个方法用来维护其生命周期,除了onCreate(),onStart(),onDestory() 外还有onrestart,onresume,onpause,onstop。30. android的数据存储的方式sharedpreference,文件,SQlite,contentprovider,网络。31. 当启动一个Activity并且新的Activity执行完后需要返回到启动它的Activity来执行 的回调函数是startActivityResult()。32. 请使用命令行的方式创建一个名字为myAvd,sdk版本为2.2,sd卡是在d盘的根目录下,名字为scard.img, 并指定屏幕大小HVGA.____________________________________。33. 程序运行的结果是:_____good and gbc__________。 public classExample{ String str=new String("good"); char[]ch={'a','b','c'}; public static void main(String args[]){ Example ex=new Example(); ex.change(ex.str,ex.ch); System.out.print(ex.str+" and "); Sytem.out.print(ex.ch); } public void change(String str,char ch[]){ str="test ok"; ch[0]='g'; } } 34. 在android中,请简述jni的调用过程。(8分)1)安装和下载Cygwin,下载 Android NDK 2)在ndk项目中JNI接口的设计 3)使用C/C++实现本地方法 4)JNI生成动态链接库.so文件 5)将动态链接库复制到java工程,在java工程中调用,运行java工程即可 35. 简述Android应用程序结构是哪些?(7分)Android应用程序结构是: Linux Kernel(Linux内核)、Libraries(系统运行库或者是c/c++核心库)、Application Framework(开发框架包)、Applications (核心应用程序) 36. 请继承SQLiteOpenHelper实现:(10分) 1).创建一个版本为1的“diaryOpenHelper.db”的数据库, 2).同时创建一个 “diary” 表(包含一个_id主键并自增长,topic字符型100 长度, content字符型1000长度) 3).在数据库版本变化时请删除diary表,并重新创建出diary表。 publicclass DBHelper extends SQLiteOpenHelper{ public final static String DATABASENAME ="diaryOpenHelper.db"; public final static int DATABASEVERSION =1; //创建数据库 public DBHelper(Context context,Stringname,CursorFactory factory,int version) { super(context, name, factory,version); } //创建表等机构性文件 public void onCreate(SQLiteDatabase db) { String sql ="create tablediary"+ "("+ "_idinteger primary key autoincrement,"+ "topicvarchar(100),"+ "contentvarchar(1000)"+ ")"; db.execSQL(sql); } //若数据库版本有更新,则调用此方法 public void onUpgrade(SQLiteDatabasedb,int oldVersion,int newVersion) { String sql = "drop table ifexists diary"; db.execSQL(sql); this.onCreate(db); } } 37. 页面上现有ProgressBar控件progressBar,请用书写线程以10秒的的时间完成其进度显示工作。(10分)答案 publicclass ProgressBarStu extends Activity { private ProgressBar progressBar = null; protected void onCreate(BundlesavedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.progressbar); //从这到下是关键 progressBar = (ProgressBar)findViewById(R.id.progressBar); Thread thread = new Thread(newRunnable() { @Override public void run() { int progressBarMax =progressBar.getMax(); try { while(progressBarMax!=progressBar.getProgress()) { intstepProgress = progressBarMax/10; intcurrentprogress = progressBar.getProgress(); progressBar.setProgress(currentprogress+stepProgress); Thread.sleep(1000); } } catch(InterruptedException e) { // TODO Auto-generatedcatch block e.printStackTrace(); } } }); thread.start(); //关键结束 } } 38. 请描述下Activity的生命周期。 必调用的三个方法:onCreate() --> onStart() --> onResume(),用AAA表示 (1)父Activity启动子Activity,子Actvity退出,父Activity调用顺序如下 AAA --> onFreeze() --> onPause() --> onStop() --> onRestart()--> onStart(),onResume() … (2)用户点击Home,Actvity调用顺序如下 AAA --> onFreeze() --> onPause() --> onStop() -- Maybe -->onDestroy() – Maybe (3)调用finish(), Activity调用顺序如下 AAA --> onPause() --> onStop() --> onDestroy() (4)在Activity上显示dialog,Activity调用顺序如下 AAA (5)在父Activity上显示透明的或非全屏的activity,Activity调用顺序如下 AAA --> onFreeze() --> onPause() (6)设备进入睡眠状态,Activity调用顺序如下 AAA --> onFreeze() --> onPause() 39. 如果后台的Activity由于某原因被系统回收了,如何在被系统回收之前保存当前状态? onSaveInstanceState() 当你的程序中某一个Activity A在运行时,主动或被动地运行另一个新的Activity B,这个时候A会执行onSaveInstanceState()。B完成以后又会来找A,这个时候就有两种情况:一是A被回收,二是A没有被回收,被回收的A就要重新调用onCreate()方法,不同于直接启动的是这回onCreate()里是带上了参数savedInstanceState;而没被收回的就直接执行onResume(),跳过onCreate()了。 40. 如何将一个Activity设置成窗口的样式。 在AndroidManifest.xml 中定义Activity的地方一句话android:theme="@android:style/Theme.Dialog"或android:theme="@android:style/Theme.Translucent"就变成半透明的 41. 如何退出Activity?如何安全退出已调用多个Activity的Application?对于单一Activity的应用来说,退出很简单,直接finish()即可。 当然,也可以用killProcess()和System.exit()这样的方法。 但是,对于多Activity的应用来说,在打开多个Activity后,如果想在最后打开的Activity直接退出,上边的方法都是没有用的,因为上边的方法都是结束一个Activity而已。 当然,网上也有人说可以。 就好像有人问,在应用里如何捕获Home键,有人就会说用keyCode比较KEYCODE_HOME即可,而事实上如果不修改framework,根本不可能做到这一点一样。 所以,最好还是自己亲自试一下。 那么,有没有办法直接退出整个应用呢? 在2.1之前,可以使用ActivityManager的restartPackage方法。 它可以直接结束整个应用。在使用时需要权限android.permission.RESTART_PACKAGES。 注意不要被它的名字迷惑。 可是,在2.2,这个方法失效了。 在2.2添加了一个新的方法,killBackgroundProcesses(),需要权限android.permission.KILL_BACKGROUND_PROCESSES。 可惜的是,它和2.2的restartPackage一样,根本起不到应有的效果。 另外还有一个方法,就是系统自带的应用程序管理里,强制结束程序的方法,forceStopPackage()。 它需要权限android.permission.FORCE_STOP_PACKAGES。 并且需要添加android:sharedUserId="android.uid.system"属性 同样可惜的是,该方法是非公开的,他只能运行在系统进程,第三方程序无法调用。 因为需要在Android.mk中添加LOCAL_CERTIFICATE := platform。 而Android.mk是用于在Android源码下编译程序用的。 从以上可以看出,在2.2,没有办法直接结束一个应用,而只能用自己的办法间接办到。 现提供几个方法,供参考: 1、抛异常强制退出: 该方法通过抛异常,使程序ForceClose。 验证可以,但是,需要解决的问题是,如何使程序结束掉,而不弹出Force Close的窗口。 2、记录打开的Activity: 每打开一个Activity,就记录下来。在需要退出时,关闭每一个Activity即可。 3、发送特定广播: 在需要结束应用时,发送一个特定的广播,每个Activity收到广播后,关闭即可。 4、递归退出 在打开新的Activity时使用startActivityForResult,然后自己加标志,在onActivityResult中处理,递归关闭。 除了第一个,都是想办法把每一个Activity都结束掉,间接达到目的。 但是这样做同样不完美。 你会发现,如果自己的应用程序对每一个Activity都设置了nosensor,在两个Activity结束的间隙,sensor可能有效了。 但至少,我们的目的达到了,而且没有影响用户使用。 为了编程方便,最好定义一个Activity基类,处理这些共通问题。 42. 请介绍下Android中常用的五种布局。FrameLayout(框架布局),LinearLayout (线性布局),AbsoluteLayout(绝对布局),RelativeLayout(相对布局),TableLayout(表格布局) 43. 请介绍下Android的数据存储方式。一.SharedPreferences方式 五. 网络存储方式 44. 请介绍下ContentProvider是如何实现数据共享的。创建一个属于你自己的Content provider或者将你的数据添加到一个已经存在的Contentprovider中,前提是有相同数据类型并且有写入Content provider的权限。 45. 如何启用Service,如何停用Service。Android中的service类似于windows中的service,service一般没有用户操作界面,它运行于系统中不容易被用户发觉, 可以使用它开发如监控之类的程序。 一。步骤 第一步:继承Service类 public class SMSService extends Service { } 第二步:在AndroidManifest.xml文件中的节点里对服务进行配置: 二。Context.startService()和Context.bindService 服务不能自己运行,需要通过调用Context.startService()或Context.bindService()方法启动服务。这两个方法都可 以启动Service,但是它们的使用场合有所不同。 1.使用startService()方法启用服务,调用者与服务之间没有关连,即使调用者退出了,服务仍然运行。 使用bindService()方法启用服务,调用者与服务绑定在了一起,调用者一旦退出,服务也就终止。 2.采用Context.startService()方法启动服务,在服务未被创建时,系统会先调用服务的onCreate()方法, 接着调用onStart()方法。如果调用startService()方法前服务已经被创建,多次调用startService()方法并 不会导致多次创建服务,但会导致多次调用onStart()方法。 采用startService()方法启动的服务,只能调用Context.stopService()方法结束服务,服务结束时会调用 onDestroy()方法。 3.采用Context.bindService()方法启动服务,在服务未被创建时,系统会先调用服务的onCreate()方法, 接着调用onBind()方法。这个时候调用者和服务绑定在一起,调用者退出了,系统就会先调用服务的onUnbind()方法, 。接着调用onDestroy()方法。如果调用bindService()方法前服务已经被绑定,多次调用bindService()方法并不会 导致多次创建服务及绑定(也就是说onCreate()和onBind()方法并不会被多次调用)。如果调用者希望与正在绑定的服务 解除绑定,可以调用unbindService()方法,调用该方法也会导致系统调用服务的onUnbind()-->onDestroy()方法。 三。Service的生命周期 1.Service常用生命周期回调方法如下: onCreate() 该方法在服务被创建时调用,该方法只会被调用一次,无论调用多少次startService()或bindService()方法, 服务也只被创建一次。 onDestroy()该方法在服务被终止时调用。 2. Context.startService()启动Service有关的生命周期方法 onStart() 只有采用Context.startService()方法启动服务时才会回调该方法。该方法在服务开始运行时被调用。 多次调用startService()方法尽管不会多次创建服务,但onStart()方法会被多次调用。 3. Context.bindService()启动Service有关的生命周期方法 onBind()只有采用Context.bindService()方法启动服务时才会回调该方法。该方法在调用者与服务绑定时被调用, 当调用者与服务已经绑定,多次调用Context.bindService()方法并不会导致该方法被多次调用。 onUnbind()只有采用Context.bindService()方法启动服务时才会回调该方法。该方法在调用者与服务解除绑定时被调用。 备注: 1. 采用startService()启动服务 Intent intent =new Intent(DemoActivity.this, DemoService.class); startService(intent); 2.Context.bindService()启动 Intent intent =new Intent(DemoActivity.this, DemoService.class); bindService(intent, conn, Context.BIND_AUTO_CREATE); //unbindService(conn);//解除绑定 46. 注册广播有几种方式,这些方式有何优缺点?请谈谈Android引入广播机制的用意。 Android广播机制(两种注册方法) 在android下,要想接受广播信息,那么这个广播接收器就得我们自己来实现了,我们可以继承BroadcastReceiver,就可以有一个广播接受器了。有个接受器还不够,我们还得重写BroadcastReceiver里面的onReceiver方法,当来广播的时候我们要干什么,这就要我们自己来实现,不过我们可以搞一个信息防火墙。具体的代码: public class SmsBroadCastReceiverextends BroadcastReceiver { @Override public void onReceive(Context context, Intent intent) { Bundle bundle = intent.getExtras(); Object[] object = (Object[])bundle.get("pdus"); SmsMessage sms[]=new SmsMessage[object.length]; for(int i=0;i { sms[0] =SmsMessage.createFromPdu((byte[])object); Toast.makeText(context, "来自"+sms.getDisplayOriginatingAddress()+"的消息是:"+sms.getDisplayMessageBody(),Toast.LENGTH_SHORT).show(); } //终止广播,在这里我们可以稍微处理,根据用户输入的号码可以实现短信防火墙。 abortBroadcast(); } } 当实现了广播接收器,还要设置广播接收器接收广播信息的类型,这里是信息:android.provider.Telephony.SMS_RECEIVED 我们就可以把广播接收器注册到系统里面,可以让系统知道我们有个广播接收器。这里有两种,一种是代码动态注册: //生成广播处理 smsBroadCastReceiver = newSmsBroadCastReceiver(); //实例化过滤器并设置要过滤的广播 IntentFilter intentFilter = newIntentFilter("android.provider.Telephony.SMS_RECEIVED"); //注册广播 BroadCastReceiverActivity.this.registerReceiver(smsBroadCastReceiver,intentFilter); 一种是在AndroidManifest.xml中配置广播 package="spl.broadCastReceiver" android:versionCode="1" android:versionName="1.0"> android:label="@string/app_name"> 两种注册类型的区别是: 1)第一种不是常驻型广播,也就是说广播跟随程序的生命周期。 2)第二种是常驻型,也就是说当应用程序关闭后,如果有信息广播来,程序也会被系统调用自动运行。 47. 请解释下在单线程模型中Message、Handler、MessageQueue、Looper之间的关系。Handler简介: 一个Handler允许你发送和处理Message和Runable对象,这些对象和一个线程的MessageQueue相关联。每一个线程实例和一个单独的线程以及该线程的MessageQueue相关联。当你创建一个新的Handler时,它就和创建它的线程绑定在一起了。这里,线程我们也可以理解为线程的MessageQueue。从这一点上来看,Handler把Message和Runable对象传递给MessageQueue,而且在这些对象离开MessageQueue时,Handler负责执行他们。 Handler有两个主要的用途:(1)确定在将来的某个时间点执行一个或者一些Message和Runnable对象。(2)在其他线程(不是Handler绑定线程)中排入一些要执行的动作。 Scheduling Message,即(1),可以通过以下方法完成: post(Runnable):Runnable在handler绑定的线程上执行,也就是说不创建新线程。 postAtTime(Runnable,long): postDelayed(Runnable,long): sendEmptyMessage(int): sendMessage(Message): sendMessageAtTime(Message,long): sendMessageDelayed(Message,long): post这个动作让你把Runnable对象排入MessageQueue,MessageQueue受到这些消息的时候执行他们,当然以一定的排序。sendMessage这个动作允许你把Message对象排成队列,这些Message对象包含一些信息,Handler的hanlerMessage(Message)会处理这些Message.当然,handlerMessage(Message)必须由Handler的子类来重写。这是编程人员需要作的事。 当posting或者sending到一个Hanler时,你可以有三种行为:当MessageQueue准备好就处理,定义一个延迟时间,定义一个精确的时间去处理。后两者允许你实现timeout,tick,和基于时间的行为。 当你的应用创建一个新的进程时,主线程(也就是UI线程)自带一个MessageQueue,这个MessageQueue管理顶层的应用对象(像activities,broadcast receivers等)和主线程创建的窗体。你可以创建自己的线程,并通过一个Handler和主线程进行通信。这和之前一样,通过post和sendmessage来完成,差别在于在哪一个线程中执行这么方法。在恰当的时候,给定的Runnable和Message将在Handler的MessageQueue中被Scheduled。 Message简介: Message类就是定义了一个信息,这个信息中包含一个描述符和任意的数据对象,这个信息被用来传递给Handler.Message对象提供额外的两个int域和一个Object域,这可以让你在大多数情况下不用作分配的动作。 尽管Message的构造函数是public的,但是获取Message实例的最好方法是调用Message.obtain(),或者Handler.obtainMessage()方法,这些方法会从回收对象池中获取一个。 MessageQueue简介: 这是一个包含message列表的底层类。Looper负责分发这些message。Messages并不是直接加到一个MessageQueue中,而是通过MessageQueue.IdleHandler关联到Looper。 你可以通过Looper.myQueue()从当前线程中获取MessageQueue。 Looper简介: Looper类被用来执行一个线程中的message循环。默认情况,没有一个消息循环关联到线程。在线程中调用prepare()创建一个Looper,然后用loop()来处理messages,直到循环终止。 大多数和message loop的交互是通过Handler。 下面是一个典型的带有Looper的线程实现。 class LooperThread extends Thread { public Handler mHandler; public void run() { Looper.prepare(); mHandler = new Handler() { public voidhandleMessage(Message msg) { // process incomingmessages here } }; Looper.loop(); } } 48. AIDL的全称是什么?如何工作?能处理哪些类型的数据?AIDL的英文全称是Android Interface Define Language 当A进程要去调用B进程中的service时,并实现通信,我们通常都是通过AIDL来操作的 A工程: 首先我们在net.blogjava.mobile.aidlservice包中创建一个RemoteService.aidl文件,在里面我们自定义一个接口,含有方法get。ADT插件会在gen目录下自动生成一个RemoteService.java文件,该类中含有一个名为RemoteService.stub的内部类,该内部类中含有aidl文件接口的get方法。 说明一:aidl文件的位置不固定,可以任意 然后定义自己的MyService类,在MyService类中自定义一个内部类去继承RemoteService.stub这个内部类,实现get方法。在onBind方法中返回这个内部类的对象,系统会自动将这个对象封装成IBinder对象,传递给他的调用者。 其次需要在AndroidManifest.xml文件中配置MyService类,代码如下: 为什么要指定调用AIDL服务的ID,就是要告诉外界MyService这个类能够被别的进程访问,只要别的进程知道这个ID,正是有了这个ID,B工程才能找到A工程实现通信。 说明:AIDL并不需要权限 B工程: 首先我们要将A工程中生成的RemoteService.java文件拷贝到B工程中,在bindService方法中绑定aidl服务 绑定AIDL服务就是将RemoteService的ID作为intent的action参数。 说明:如果我们单独将RemoteService.aidl文件放在一个包里,那个在我们将gen目录下的该包拷贝到B工程中。如果我们将RemoteService.aidl文件和我们的其他类存放在一起,那么我们在B工程中就要建立相应的包,以保证RmoteService.java文件的报名正确,我们不能修改RemoteService.java文件 bindService(newInten("net.blogjava.mobile.aidlservice.RemoteService"),serviceConnection, Context.BIND_AUTO_CREATE); ServiceConnection的onServiceConnected(ComponentName name, IBinderservice)方法中的service参数就是A工程中MyService类中继承了RemoteService.stub类的内部类的对象。 49. 请解释下Android程序运行时权限与文件系统权限的区别。运行时权限Dalvik( android授权) 文件系统 linux 内核授权 50. 系统上安装了多种浏览器,能否指定某浏览器访问指定页面?请说明原由。通过直接发送Uri把参数带过去,或者通过manifest里的intentfilter里的data属性 51. 你如何评价Android系统?优缺点。答:Android平台手机 5大优势: 一、开放性 在优势方面,Android平台首先就是其开发性,开发的平台允许任何移动终端厂商加入到Android联盟中来。显著的开放性可以使其拥有更多的开发者,随着用户和应用的日益丰富,一个崭新的平台也将很快走向成熟。开放性对于Android的发展而言,有利于积累人气,这里的人气包括消费者和厂商,而对于消费者来讲,随大的受益正是丰富的软件资源。开放的平台也会带来更大竞争,如此一来,消费者将可以用更低的价位购得心仪的手机。 二、挣脱运营商的束缚 在过去很长的一段时间,特别是在欧美地区,手机应用往往受到运营商制约,使用什么功能接入什么网络,几乎都受到运营商的控制。从去年iPhone 上市 ,用户可以更加方便地连接网络,运营商的制约减少。随着EDGE、HSDPA这些2G至3G移动网络的逐步过渡和提升,手机随意接入网络已不是运营商口中的笑谈,当你可以通过手机IM软件方便地进行即时聊天时,再回想不久前天价的彩信和图铃下载业务,是不是像噩梦一样?互联网巨头Google推动的Android终端天生就有网络特色,将让用户离互联网更近。 三、丰富的硬件选择 这一点还是与Android平台的开放性相关,由于Android的开放性,众多的厂商会推出千奇百怪,功能特色各具的多种产品。功能上的差异和特色,却不会影响到数据同步、甚至软件的兼容,好比你从诺基亚 Symbian风格手机 一下改用苹果 iPhone ,同时还可将Symbian中优秀的软件带到iPhone上使用、联系人等资料更是可以方便地转移,是不是非常方便呢? 四、不受任何限制的开发商 Android平台提供给第三方开发商一个十分宽泛、自由的环境,不会受到各种条条框框的阻扰,可想而知,会有多少新颖别致的软件会诞生。但也有其两面性,血腥、暴力、情色方面的程序和游戏如可控制正是留给Android难题之一。 五、无缝结合的Google应用 如今叱诧互联网的Google已经走过10年度历史,从搜索巨人到全面的互联网渗透,Google服务如地图、邮件、搜索等已经成为连接用户和互联网的重要纽带,而Android平台手机将无缝结合这些优秀的Google服务。 再说Android的5大不足: 一、安全和隐私 由于手机与互联网的紧密联系,个人隐私很难得到保守。除了上网过程中经意或不经意留下的个人足迹,Google这个巨人也时时站在你的身后,洞穿一切,因此,互联网的深入将会带来新一轮的隐私危机。 二、首先开卖Android手机的不是最大运营商 众所周知,T-Mobile在23日,于美国纽约发布 了Android首款手机G1。但是在北美市场,最大的两家运营商乃AT&T和Verizon,而目前所知取得Android手机销售权的仅有 T-Mobile和Sprint,其中T-Mobile的3G网络相对于其他三家也要逊色不少,因此,用户可以买账购买G1,能否体验到最佳的3G网络服务则要另当别论了! 三、运营商仍然能够影响到Android手机 在国内市场,不少用户对购得移动定制机不满,感觉所购的手机被人涂画了广告一般。这样的情况在国外市场同样出现。Android手机的另一发售运营商Sprint就将在其机型中内置其手机商店程序。 四、同类机型用户减少 在不少手机论坛都会有针对某一型号的子论坛,对一款手机的使用心得交流,并分享软件资源。而对于Android平台手机,由于厂商丰富,产品类型多样,这样使用同一款机型的用户越来越少,缺少统一机型的程序强化。举个稍显不当的例子,现在山寨机泛滥,品种各异,就很少有专门针对某个型号山寨机的讨论和群组,除了哪些功能异常抢眼、颇受追捧的机型以外。 五、过分依赖开发商缺少标准配置 在使用PC端的Windows Xp系统的时候,都会内置微软Windows Media Player这样一个浏览器程序,用户可以选择更多样的播放器,如Realplay或暴风影音等。但入手开始使用默认的程序同样可以应付多样的需要。在Android平台中,由于其开放性,软件更多依赖第三方厂商,比如Android系统的SDK中就没有内置音乐 播放器,全部依赖第三方开发,缺少了产品的统一性。 52. 什么是ANR 如何避免它? 答:ANR:Application NotResponding,五秒 在Android中,活动管理器和窗口管理器这两个系统服务负责监视应用程序的响应。当出现下列情况时,Android就会显示ANR对话框了: 对输入事件(如按键、触摸屏事件)的响应超过5秒 意向接受器(intentReceiver)超过10秒钟仍未执行完毕 Android应用程序完全运行在一个独立的线程中(例如main)。这就意味着,任何在主线程中运行的,需要消耗大量时间的操作都会引发ANR。因为此时,你的应用程序已经没有机会去响应输入事件和意向广播(Intentbroadcast)。 因此,任何运行在主线程中的方法,都要尽可能的只做少量的工作。特别是活动生命周期中的重要方法如onCreate()和 onResume()等更应如此。潜在的比较耗时的操作,如访问网络和数据库;或者是开销很大的计算,比如改变位图的大小,需要在一个单独的子线程中完成(或者是使用异步请求,如数据库操作)。但这并不意味着你的主线程需要进入阻塞状态已等待子线程结束 -- 也不需要调用Therad.wait()或者Thread.sleep()方法。取而代之的是,主线程为子线程提供一个句柄(Handler),让子线程在即将结束的时候调用它(xing:可以参看Snake的例子,这种方法与以前我们所接触的有所不同)。使用这种方法涉及你的应用程序,能够保证你的程序对输入保持良好的响应,从而避免因为输入事件超过5秒钟不被处理而产生的ANR。这种实践需要应用到所有显示用户界面的线程,因为他们都面临着同样的超时问题。 53. 什么情况会导致Force Close ?如何避免?能否捕获导致其的异常? 答:一般像空指针啊,可以看起logcat,然后对应到程序中 来解决错误 54. Android本身的api并未声明会抛出异常,则其在运行时有无可能抛出runtime异常,你遇到过吗?诺有的话会导致什么问题?如何解决? 55. 简要解释一下activity、 intent 、intent filter、service、Broadcase、BroadcaseReceiver 答:一个activity呈现了一个用户可以操作的可视化用户界面 一个service不包含可见的用户界面,而是在后台无限地运行 可以连接到一个正在运行的服务中,连接后,可以通过服务中暴露出来的借口与其进行通信 一个broadcast receiver是一个接收广播消息并作出回应的component,broadcastreceiver没有界面 intent:content provider在接收到ContentResolver的请求时被激活。 activity, service和broadcast receiver是被称为intents的异步消息激活的。 一个intent是一个Intent对象,它保存了消息的内容。对于activity和service来说,它指定了请求的操作名称和待操作数据的URI Intent对象可以显式的指定一个目标component。如果这样的话,android会找到这个component(基于manifest文件中的声明)并激活它。但如果一个目标不是显式指定的,android必须找到响应intent的最佳component。 它是通过将Intent对象和目标的intent filter相比较来完成这一工作的。一个component的intent filter告诉android该component能处理的intent。intent filter也是在manifest文件中声明的。 56. IntentService有何优点? 答:IntentService 的好处 * Acitivity的进程,当处理Intent的时候,会产生一个对应的Service * Android的进程处理器现在会尽可能的不kill掉你 * 非常容易使用 57. 横竖屏切换时候activity的生命周期? 1、不设置Activity的android:configChanges时,切屏会重新调用各个生命周期,切横屏时会执行一次,切竖屏时会执行两次 2、设置Activity的android:configChanges="orientation"时,切屏还是会重新调用各个生命周期,切横、竖屏时只会执行一次 3、设置Activity的android:configChanges="orientation|keyboardHidden"时,切屏不会重新调用各个生命周期,只会执行onConfigurationChanged方法 如何将SQLite数据库(dictionary.db文件)与apk文件一起发布? 解答:可以将dictionary.db文件复制到Eclipse Android工程中的res aw目录中。所有在res aw目录中的文件不会被压缩,这样可以直接提取该目录中的文件。可以将dictionary.db文件复制到res aw目录中 58. 如何将打开res aw目录中的数据库文件? 解答:在Android中不能直接打开res aw目录中的数据库文件,而需要在程序第一次启动时将该文件复制到手机内存或SD卡的某个目录中,然后再打开该数据库文件。复制的基本方法是使用getResources().openRawResource方法获得res aw目录中资源的 InputStream对象,然后将该InputStream对象中的数据写入其他的目录中相应文件中。在Android SDK中可以使用SQLiteDatabase.openOrCreateDatabase方法来打开任意目录中的SQLite数据库文件。 59. Android引入广播机制的用意? 答:a:从MVC的角度考虑(应用程序内) 其实回答这个问题的时候还可以这样问,android为什么要有那4大组件,现在的移动开发模型基本上也是照搬的web那一套MVC架构,只不过是改了点嫁妆而已。android的四大组件本质上就是为了实现移动或者说嵌入式设备上的MVC架构,它们之间有时候是一种相互依存的关系,有时候又是一种补充关系,引入广播机制可以方便几大组件的信息和数据交互。 b:程序间互通消息(例如在自己的应用程序内监听系统来电) c:效率上(参考UDP的广播协议在局域网的方便性) d:设计模式上(反转控制的一种应用,类似监听者模式) 60. Android dvm的进程和Linux的进程, 应用程序的进程是否为同一个概念 DVM指dalivk的虚拟机。每一个Android应用程序都在它自己的进程中运行,都拥有一个独立的Dalvik虚拟机实例。而每一个DVM都是在Linux 中的一个进程,所以说可以认为是同一个概念。 61. sim卡的EF 文件有何作用 sim卡的文件系统有自己规范,主要是为了和手机通讯,sim本 身可以有自己的操作系统,EF就是作存储并和手机通讯用的 62. 嵌入式操作系统内存管理有哪几种, 各有何特性 页式,段式,段页,用到了MMU,虚拟空间等技术 63. 什么是嵌入式实时操作系统, Android 操作系统属于实时操作系统吗? 嵌入式实时操作系统是指当外界事件或数据产生时,能够接受并以足够快的速度予以处理,其处理的结果又能在规定的时间之内来控制生产过程或对处理系统作出快速响应,并控制所有实时任务协调一致运行的嵌入式操作系统。主要用于工业控制、 军事设备、 航空航天等领域对系统的响应时间有苛刻的要求,这就需要使用实时系统。又可分为软实时和硬实时两种,而android是基于linux内核的,因此属于软实时。 64. 一条最长的短信息约占多少byte? 中文70(包括标点),英文160,160个字节。 65. android中的动画有哪几类,它们的特点和区别是什么? 两种,一种是Tween动画、还有一种是Frame动画。Tween动画,这种实现方式可以使视图组件移动、放大、缩小以及产生透明度的变化;另一种Frame动画,传统的动画方法,通过顺序的播放排列好的图片来实现,类似电影。 66. handler机制的原理 andriod提供了Handler 和 Looper 来满足线程间的通信。Handler先进先出原则。Looper类用来管理特定线程内对象之间的消息交换(MessageExchange)。 1)Looper: 一个线程可以产生一个Looper对象,由它来管理此线程里的MessageQueue(消息队列)。 2)Handler: 你可以构造Handler对象来与Looper沟通,以便push新消息到MessageQueue里;或者接收Looper从Message Queue取出)所送来的消息。 3) Message Queue(消息队列):用来存放线程放入的消息。 4)线程:UIthread 通常就是main thread,而Android启动程序时会替它建立一个MessageQueue。 67. 说说mvc模式的原理,它在android中的运用 MVC(Model_view_contraller)”模型_视图_控制器”。 MVC应用程序总是由这三个部分组成。Event(事件)导致Controller改变Model或View,或者同时改变两者。只要Controller改变了Models的数据或者属性,所有依赖的View都会自动更新。类似的,只要Contro 68. DDMS和TraceView的区别? DDMS是一个程序执行查看器,在里面可以看见线程和堆栈等信息,TraceView是程序性能分析器 。 69. java中如何引用本地语言 可以用JNI(java nativeinterface java 本地接口)接口。 70. 谈谈Android的IPC(进程间通信)机制 IPC是内部进程通信的简称, 是共享"命名管道"的资源。Android中的IPC机制是为了让Activity和Service之间可以随时的进行交互,故在Android中该机制,只适用于Activity和Service之间的通信,类似于远程方法调用,类似于C/S模式的访问。通过定义AIDL接口文件来定义IPC接口。Servier端实现IPC接口,Client端调用IPC接口本地代理。 71. NDK是什么NDK是一些列工具的集合,NDK提供了一系列的工具,帮助开发者迅速的开发C/C++的动态库,并能自动将so和java 应用打成apk包。 NDK集成了交叉编译器,并提供了相应的mk文件和隔离cpu、平台等的差异,开发人员只需简单的修改mk文件就可以创建出so 本文转自 wws5201985 51CTO博客,原文链接:http://blog.51cto.com/wws5201985/770241,如需转载请自行联系原作者
优秀的个人博客,低调大师

大数据,小数据,哪道才是你的菜?

美国著名科技历史学家梅尔文•克兰兹伯格Melvin Kranzberg曾提出过大名鼎鼎的科技六定律其中第三条定律是这样的[1]“技术是总是配“套”而来的但这个“套”有大有小Technology comes in packages, big and small”。 这个定律用在当下是非常应景的。因为我们正步入一个“大数据big data”时代但对于以往的“小数据small data”我们能做到“事了拂衣去深藏身与名”吗答案显然不是。目前大数据的前途似乎“星光灿烂”但小数据的价值依然“风采无限”。克兰兹伯格的第三定律是告诉我们新技术和老技术的自我革新演变是交织在一起的。大数据和小数据他们“配套而来”共同勾画数据技术Data TechnologyDT时代的未来。 对大数据的“溢美之词”已被舍恩伯格教授、涂子沛先生等先行者及其追随者夸得泛滥成

优秀的个人博客,低调大师

27道高频Spring面试题,你能答对几个?

1、什么是Spring框架,Spring框架有哪些主要模块Spring框架是一个为Java应用程序开发提供综合、广泛的基础性支持的Java平台。 Spring帮助开发者解决了开发中基础性的问题,使得开发人员可以专注于应用程序的开发。 Spring框架本身也是按照设计模式精心打造的,这使得我们可以在开发环境中安心地集成Spring框架,不必担心Spring是如何在后台工作的。2、使用Spring框架能带来哪些好处下面列举了一些使用Spring框架带来的主要好处。(1)Dependency Injection(DI)使得构造器和JavaBean properties文件中的依赖关系一目了然。 (2)与EJB容器相比较,IoC容器更加趋向于轻量级。这样一来使用IoC容器在有限的内存和CPU资源的情况下进行应用程序的开发和发布就变得十分有利。 (3)Spring并没有闭门造车,Spring利用了已有的技术,比如ORM框架、logging框架、J2EE、Quartz和JDK Timer,以及其他视图技术。 (4)Spring框架是按照模块的形式来组织的。由包和类的编号就可以看出其所属的模块,开发者只需选用需要的模块即可。 (5)要测试一个用Spring开发的应用程序十分简单,因为测试相关的环境代码都已经囊括在框架中了。更加简单的是,利用JavaBean形式的POJO类,可以很方便地利用依赖注入来写入测试数据。 (6)Spring的Web框架也是一个精心设计的Web MVC框架,为开发者在Web框架的选择上提供了一个除主流框架(比如Struts)和过度设计的、不流行Web框架以外的选择。 (7)Spring提供了一个便捷的事务管理接口,适用于小型的本地事务处理(比如在单DB的环境下)和复杂的共同事务处理(比如利用JTA的复杂DB环境)。3、什么是控制反转(IoC),什么是依赖注入(1)控制反转是应用于软件工程领域的,在运行时被装配器对象用来绑定耦合对象的一种编程技巧,对象之间的耦合关系在编译时通常是未知的。在传统的编程方式中,业务逻辑的流程是由应用程序中早已被设定好关联关系的对象来决定的。在使用控制反转的情况下,业务逻辑的流程是由对象关系图来决定的,该对象关系图由装配器负责实例化,这种实现方式还可以将对象之间的关联关系的定义抽象化。绑定的过程是通过“依赖注入”实现的。 (2)控制反转是一种以给予应用程序中目标组件更多控制为目的设计范式,并在实际工作中起到了有效的作用。 (3)依赖注入是在编译阶段尚未知所需的功能是来自哪个的类的情况下,将其他对象所依赖的功能对象实例化的模式。这就需要一种机制来激活相应的组件以提供特定的功能,所以依赖注入是控制反转的基础。否则如果在组件不受框架控制的情况下,框架又怎么知道要创建哪个组件呢?4、在Java中依赖注入有哪些方式(1)构造器注入。 (2)Setter方法注入。 (3)接口注入。5、BeanFactory和ApplicationContext有什么区别BeanFactory可以理解为含有Bean集合的工厂类。BeanFactory 包含了Bean的定义,以便在接收到客户端请求时将对应的Bean实例化。 BeanFactory还能在实例化对象时生成协作类之间的关系。此举将Bean自身从Bean客户端的配置中解放出来。BeanFactory还包含Bean生命周期的控制,调用客户端的初始化方法(Initialization Method)和销毁方法(Destruction Method)。 从表面上看,ApplicationContext如同BeanFactory一样具有Bean定义、Bean关联关系的设置及根据请求分发Bean的功能。但ApplicationContext在此基础上还提供了其他功能。 (1)提供了支持国际化的文本消息。 (2)统一的资源文件读取方式。 (3)已在监听器中注册的Bean的事件。 以下是三种较常见的 ApplicationContext 实现方式。 (1)ClassPathXmlApplicationContext:从ClassPath的XML配置文件中读取上下文,并生成上下文定义。应用程序上下文从程序环境变量中取得。 ApplicationContext context = new ClassPathXmlApplicationContext(“application.xml”); (2)FileSystemXmlApplicationContext :由文件系统中的XML配置文件读取上下文。 ApplicationContext context = new FileSystemXmlApplicationContext(“application.xml”); (3)XmlWebApplicationContext:由Web应用的XML文件读取上下文。6、Spring提供几种配置方式来设置元数据Spring提供以下三种配置方式来设置元数据:(1)基于XML的配置。 (2)基于注解的配置。 (3)基于Java的配置。7、如何使用XML配置方式配置Spring在Spring框架中,依赖和服务需要专门的配置文件实现,一般用XML格式的配置文件。这些配置文件的格式采用公共的模板,由一系列的Bean定义和专门的应用配置选项组成。 Spring XML配置的主要目的是使所有的Spring组件都可以用XML文件的形式来进行配置。这意味着不会出现其他的Spring配置类型(比如声明配置方式或基于Java Class的配置方式)。 Spring的XML配置方式是使用被Spring命名空间所支持的一系列的XML标签来实现的。Spring主要的命名空间有context、beans、jdbc、tx、aop、mvc和aso。例如: <beans> <!-- JSON Support --> <bean name="viewResolver" class="org.springframework.web.servlet.view.BeanNameViewResolver"/> <bean name="jsonTemplate" class="org.springframework.web.servlet.view.json.MappingJackson2JsonView"/> <bean id="restTemplate" class="org.springframework.web.client.RestTemplate"/> </beans> 下面这个web.xml仅配置了DispatcherServlet,最简单的配置便能满足应用程序配置运行时组件的需求。 <web-app> <display-name>Archetype Created Web Application</display-name> <servlet> <servlet-name>spring</servlet-name> <servlet-class>org.springframework.web.servlet.DispatcherServlet</servlet-class> <load-on-startup>1</load-on-startup> </servlet> <servlet-mapping> <servlet-name>spring</servlet-name> <url-pattern>/</url-pattern> </servlet-mapping> </web-app> 8、Spring提供哪些配置形式Spring对Java配置的支持是由@Configuration注解和@Bean注解来实现的。由@Bean注解的方法将会实例化、配置和初始化一个新对象,这个对象将由Spring的IoC容器来管理。@Bean声明所起到的作用与元素类似。被@Configuration所注解的类则表示这个类的主要目的是作为Bean定义的资源。被@Configuration声明的类可以通过在同一个类内部调用@bean方法来设置嵌入Bean的依赖关系。最简单的@Configuration 声明类请参考下面的代码: @Configuration publicclass AppConfig{ @Bean public MyService myService() { return new MyServiceImpl(); } } 与上面的@Beans配置文件相同的XML配置文件如下: <beans> <bean id="myService" class="com.gupaoedu.services.MyServiceImpl"/> </beans> 上述配置方式的实例化方式如下: publicstaticvoid main(String[] args) { ApplicationContext ctx = new AnnotationConfigApplicationContext(AppConfig.class); MyService myService = ctx.getBean(MyService.class); myService.doStuff(); } 要使用组件扫描,仅需用@Configuration进行注解即可: @Configuration @ComponentScan(basePackages = "com.gupaoedu") publicclass AppConfig { } 在上面的例子中,com.gupaoedu包首先会被扫描到,然后在容器内查找被@Component 声明的类,找到后将这些类按照Spring Bean定义进行注册。如果你要在Web应用开发中选用上述配置方式,需要用AnnotationConfigWebApplicationContext类来读取配置文件,可以用来配置Spring的Servlet监听器ContrextLoaderListener或者Spring MVC的DispatcherServlet。例如: <web-app> <context-param> <param-name>contextClass</param-name> <param-value>org.springframework.web.context.support.AnnotationConfigWebApplicationContext</param-value> </context-param> <context-param> <param-name>contextConfigLocation</param-name> <param-value>com.gupaoedu.AppConfig</param-value> </context-param> <listener> <listener-class>org.springframework.web.context.ContextLoaderListener</listener-class> </listener> <servlet> <servlet-name>dispatcher</servlet-name> <servlet-class>org.springframework.web.servlet.DispatcherServlet</servlet-class> <init-param> <param-name>contextClass</param-name> <param-value>org.springframework.web.context.support.AnnotationConfigWebApplicationContext</param-value> </init-param> <init-param> <param-name>contextConfigLocation</param-name> <param-value>com.gupaoedu.web.MVCConfig</param-value> </init-param> </servlet> <servlet-mapping> <servlet-name>dispatcher</servlet-name> <url-pattern>/web/*</url-pattern> </servlet-mapping> </web-app> 9、怎样用注解的方式配置SpringSpring在2.5版本以后开始支持用注解的方式配置依赖注入。可以用注解的方式来替代XML方式的Bean描述,可以将Bean描述转移到组件类的内部,只需要在相关类上、方法上或者字段声明上使用注解即可。注解注入将会被容器在XML注入之前处理,所以后者会覆盖前者对于同一个属性的处理结果。注解装配在Spring中是默认关闭的,需要在Spring文件中进行配置才能使用基于注解的装配模式。如果你想要在应用程序中使用注解的方式,请参考如下配置: <beans> <context:annotation-config/> </beans> 配置完成以后,就可以用注解的方式在Spring中向属性、方法和构造方法中自动装配变量。下面是几种比较重要的注解类型。(1)@Required:该注解应用于设值方法。 (2)@Autowired:该注解应用于设值方法、非设值方法、构造方法和变量。 (3)@Qualifier:该注解和@Autowired注解搭配使用,用于消除特定Bean自动装配的歧义。 (4)JSR-250 Annotations:Spring支持基于JSR-250 注解的注解,即@Resource、@PostConstruct和@PreDestroy。10、请解释Spring Bean的生命周期Spring Bean的生命周期简单易懂。在一个Bean实例被初始化时,需要执行一系列初始化操作以使其达到可用的状态。同样,当一个Bean不再被调用时需要进行相关的析构操作,并从Bean容器中移除。 Spring Bean Factory 负责管理在Spring容器中被创建的Bean的生命周期。Bean的生命周期由两组回调方法组成。(1)初始化之后调用的回调方法。 (2)销毁之前调用的回调方法。Spring提供了以下4种方式来管理Bean的生命周期事件:(1)InitializingBean和DisposableBean回调接口。 (2)针对特殊行为的其他Aware接口。 (3)Bean配置文件中的customInit()方法和customDestroy()方法。 (4)@PostConstruct和@PreDestroy注解方式。使用customInit()和 customDestroy()方法管理Bean生命周期的代码样例如下: <beans> <bean id="demoBean" class="com.gupaoedu.task.DemoBean" init-Method="customInit" destroy-Method="customDestroy"></bean> </beans> 11、Spring Bean作用域的区别是什么Spring容器中的Bean可以分为5个作用域。所有作用域的名称都是自说明的,但是为了避免混淆,还是让我们来解释一下。(1)singleton:这种Bean作用域是默认的,这种作用域确保不管接收到多少个请求,每个容器中只有一个Bean实例,单例模式由Bean Factory自身来维护。 (2)prototype:prototype作用域与singleton作用域相反,为每一个Bean请求提供一个实例。 (3)request:在请求Bean作用域内为每一个来自客户端的网络请求创建一个实例,在请求完成以后,Bean会失效并被垃圾回收器回收。 (4)Session:与request作用域类似,确保每个Session中有一个Bean实例,在Session过期后,Bean会随之失效。(5)global-session:global-session和Portlet应用相关。当应用部署在Portlet容器中时,它包含很多Portlet。如果想让所有的Portlet共用全局存储变量,那么这个全局存储变量需要存储在global-session中。全局作用域与Servlet中的Session作用域效果相同。12、什么是Spring Inner Bean在Spring中,无论何时,当Bean仅被调用了一个属性时,一个明智的做法是将这个Bean声明为内部Bean。内部Bean可以用setter注入“属性”和用构造方法注入“构造参数”的方式来实现。 比如,在应用程序中一个Customer类引用了一个Person类,我们要创建一个Person类的实例,然后在Customer内部使用。 public class Customer { private Person person; } public class Person { private String name; private String address; private int age; } 内部Bean的声明方式如下: <bean id="CustomerBean" class="com.gupaoedu.common.Customer"> <property name="person"> <bean class="com.gupaoedu.common.Person"> <property name="name" value="lokesh"/> <property name="address" value="India"/> <property name="age" value="34"/> </bean> </property> </bean> 13、Spring中的单例Bean是线程安全的吗Spring并没有对单例Bean进行任何多线程的封装处理。关于单例Bean的线程安全和并发问题需要开发者自行解决。但实际上,大部分Spring Bean并没有可变的状态(比如Serview类和DAO类),所以在某种程度上,Spring的单例Bean是线程安全的。如果你的Bean有多种状态(比如View Model对象),就需要自行保证线程安全。最容易的解决办法就是将多态Bean的作用域由“singleton”变更为“prototype”。14、请举例说明如何在Spring中注入一个Java集合Spring提供了以下4种集合类的配置元素:(1)标签用来装配可重复的list值。(2)标签用来装配没有重复的set值。(3)标签用来注入键和值,可以为任何类型的键值对。(4)标签支持注入键和值都是字符串类型的键值对。下面看一个具体的例子: <beans> <bean id="javaCollection" class="com.gupaoedu.JavaCollection"> <property name="customList"> <list> <value>INDIA</value> <value>Pakistan</value> <value>USA</value> <value>UK</value> </list> </property> <property name="customSet"> <set> <value>INDIA</value> <value>Pakistan</value> <value>USA</value> <value>UK</value> </set> </property> <property name="customMap"> <map> <entry key="1" value="INDIA"/> <entry key="2" value="Pakistan"/> <entry key="3" value="USA"/> <entry key="4" value="UK"/> </map> </property> <property name="customProperies"> <props> <prop key="admin">admin@gupaoedu.com</prop> <prop key="support">support@gupaoedu.com</prop> </props> </property> </bean> </beans> 15、如何向Spring Bean中注入java.util.Properties第一种方法是使用如下代码所示的标签: <bean id="adminUser" class="com.gupaoedu.common.Customer"> <property name="emails"> <props> <prop key="admin">admin@gupaoedu.com</prop> <prop key="support">support@gupaoedu.com</prop> </props> </property> </bean> 也可用“util:”命名空间从Properties文件中创建一个Properties Bean,然后利用setter方法注入Bean的引用。16、请解释Spring Bean的自动装配在Spring框架中,在配置文件中设定Bean的依赖关系是一个很好的机制,Spring容器还可以自动装配合作关系Bean之间的关联关系。这意味着Spring可以通过向BeanFactory中注入的方式自动搞定Bean之间的依赖关系。自动装配可以设置在每个Bean上,也可以设置在特定的Bean上。下面的XML配置文件表明了如何根据名称将一个Bean设置为自动装配模式: <bean id="employeeDAO" class="com.gupaoedu.EmployeeDAOImpl" autowire="byName" /> 除了Bean配置文件中提供的自动装配模式,还可以使用@Autowired注解来自动装配指定的Bean。在使用@Autowired注解之前需要按照如下的配置方式在Spring配置文件中进行配置: <context:annotation-config /> 也可以通过在配置文件中配置AutowiredAnnotationBeanPostProcessor 达到相同的效果: <bean class ="org.springframework.beans.factory.annotation.AutowiredAnnotationBeanPostProcessor"/> 配置好以后就可以使用@Autowired来标注了: @Autowired public EmployeeDAOImpl(EmployeeManager manager){ this.manager=manager; } 17、自动装配有哪些局限性自动装配有如下局限性。• 重写:你仍然需要使用< property>设置指明依赖,这意味着总要重写自动装配。 • 原生数据类型:你不能自动装配简单的属性,如原生类型、字符串和类。 • 模糊特性:自动装配总是没有自定义装配精确,因此如果可能尽量使用自定义装配。18、请解释各种自动装配模式的区别在Spring中共有5种自动装配模式,让我们逐一分析。(1)no:这是Spring的默认设置,在该设置下自动装配是关闭的,开发者需要自行在Bean定义中用标签明确地设置依赖关系。 (2)byName:该模式可以根据Bean名称设置依赖关系。当向一个Bean中自动装配一个属性时,容器将根据Bean的名称自动在配置文件中查询一个匹配的Bean。如果找到就装配这个属性,如果没找到就报错。 (3)byType:该模式可以根据Bean类型设置依赖关系。当向一个Bean中自动装配一个属性时,容器将根据Bean的类型自动在配置文件中查询一个匹配的Bean。如果找到就装配这个属性,如果没找到就报错。 (4)constructor:和byType模式类似,但是仅适用于有与构造器相同参数类型的Bean,如果在容器中没有找到与构造器参数类型一致的Bean,那么将会抛出异常。 (5)autodetect:该模式自动探测使用constructor自动装配或者byType自动装配。首先会尝试找合适的带参数的构造器,如果找到就是用构造器自动装配,如果在Bean内部没有找到相应的构造器或者构造器是无参构造器,容器就会自动选择byType模式。19、请举例解释@Required注解在产品级别的应用中,IoC容器可能声明了数十万个Bean,Bean与Bean之间有着复杂的依赖关系。设值注解方法的短板之一就是验证所有的属性是否被注解是一项十分困难的操作。可以通过设置“dependency-check”来解决这个问题。在应用程序的生命周期中,你可能不大愿意花时间验证所有Bean的属性是否按照上下文文件正确配置,或者你宁可验证某个Bean的特定属性是否被正确设置。即使用“dependency-check”属性也不能很好地解决这个问题,在这种情况下需要使用@Required 注解。可用如下的方式来标明Bean的设值方法: public class EmployeeFactoryBean extends AbstractFactoryBean<Object> { private String designation; public String getDesignation() { return designation; } @Required public void setDesignation(String designation) { this.designation = designation; } } RequiredAnnotationBeanPostProcessor是Spring中的后置处理器,用来验证被@Required 注解的Bean属性是否被正确设置了。在使用RequiredAnnotationBeanPostProcesso验证Bean属性之前,要在IoC容器中对其进行注册: <bean class="org.springframework.beans.factory.annotation.RequiredAnnotationBeanPostProcessor" /> 但是如果没有属性被用@Required注解过,后置处理器会抛出一个BeanInitializationException异常。20、请举例说明@Qualifier注解@Qualifier注解意味着可以在被标注Bean的字段上自动装配。@Qualifier注解可以用来取消Spring不能取消的Bean应用。21、构造方法注入和设值注入有什么区别请注意以下明显的区别:(1)设值注入支持大部分依赖注入,如果我们仅需要注入int、string和long型的变量,不要用设值方法注入。对于基本类型,如果没有注入,可以为基本类型设置默认值。构造方法注入不支持大部分依赖注入,因为在调用构造方法时必须传入正确的构造参数,否则会报错。 (2)设值注入不会重写构造方法的值。如果我们对同一个变量同时使用了构造方法注入和设值注入,那么构造方法将不能覆盖设值注入的值。很明显,因为构造方法只在对象被创建时被调用。 (3)在使用设值注入时还不能保证某种依赖是否已经被注入,也就是说,这时对象的依赖关系有可能是不完整的。而在另一种情况下,构造器注入则不允许生成依赖关系不完整的对象。 (4)在设值注入时如果对象A和对象B互相依赖,在创建对象A时Spring会抛出ObjectCurrentlyInCreationException异常,因为在对象B被创建之前对象A是不能被创建的,反之亦然。Spring用设值注入解决了循环依赖问题,因为对象的设值方法是在对象被创建之前被调用的。22、Spring中有哪些不同类型的事件Spring的ApplicationContext 提供了支持事件和代码中监听器的功能。我们可以创建Bean来监听在ApplicationContext 中发布的事件。对于ApplicationEvent类和在ApplicationContext接口中处理的事件,如果一个Bean实现了ApplicationListener接口,当一个ApplicationEvent 被发布以后,Bean会自动被通知。 public class AllApplicationEventListener implements ApplicationListener<ApplicationEvent> { @Override public void onApplicationEvent(ApplicationEvent applicationEvent) { //process event } } Spring 提供了以下5种标准的事件。(1)上下文更新事件(ContextRefreshedEvent):该事件会在ApplicationContext被初始化或者更新时发布。也可以在调用ConfigurableApplicationContext 接口中的refresh()方法时被触发。 (2)上下文开始事件(ContextStartedEvent):当容器调用ConfigurableApplicationContext的Start()方法开始或重新开始容器时触发该事件。 (3)上下文停止事件(ContextStoppedEvent):当容器调用ConfigurableApplicationContext的Stop()方法停止容器时触发该事件。 (4)上下文关闭事件(ContextClosedEvent):当ApplicationContext被关闭时触发该事件。容器被关闭时,其管理的所有单例Bean都被销毁。 (5)请求处理事件(RequestHandledEvent):在Web应用中,当一个HTTP请求(Request)结束时触发该事件。除了上面介绍的事件,还可以通过扩展ApplicationEvent类来自定义事件: public class CustomApplicationEvent extends ApplicationEvent { public CustomApplicationEvent(Object source, final String msg) { super(source); System.out.println("Created a Custom event"); } } 为了监听这个事件,还需要创建一个监听器: public class CustomEventListener implements ApplicationListener<CustomApplicationEvent> { @Override public void onApplicationEvent(CustomApplicationEvent applicationEvent) { } } 之后通过ApplicationContext接口的publishEvent()方法来发布自定义事件: CustomApplicationEvent customEvent=new CustomApplicationEvent(applicationContext, "Test message"); applicationContext.publishEvent(customEvent 23、FileSystemResource和ClassPathResource有什么区别在FileSystemResource 中需要给出spring-config.xml文件在项目中的相对路径或者绝对路径。在ClassPathResource中Spring会在ClassPath中自动搜寻配置文件,所以要把ClassPathResource 文件放在ClassPath下。如果将spring-config.xml保存在了src目录下,只需给出配置文件的名称即可,因为src是默认的路径。简而言之,ClassPathResource在环境变量中读取配置文件,FileSystemResource在配置文件中读取配置文件。24、Spring中用到了哪些设计模式Spring中使用了大量的设计模式,下面列举了一些比较有代表性的设计模式。(1)代理模式:在AOP和remoting中被用得比较多。 (2)单例模式:在Spring配置文件中定义的Bean默认为单例模式。 (3)模板模式:用来解决代码重复问题,比如RestTemplate、JmsTemplate、JpaTemplate。 (4)委派模式:Spring提供了DispatcherServlet来对请求进行分发。 (5)工厂模式:BeanFactory用来创建对象的实例,贯穿于BeanFactory和ApplicationContext接口。 (6)代理模式:代理模式AOP思想的底层实现技术,Spring中采用JDK Proxy和CGLib类库。25、在Spring中如何更有效地使用JDBC使用Spring JDBC可以使得资源管理及错误处理的代价减小。开发人员只需通过statements和queries语句从数据库中存取数据。Spring通过模板类能更有效地使用JDBC,也就是所谓的JdbcTemplate。26、请解释Spring中的IoC容器Spring中的org.springframework.beans包和org.springframework.context包构成了Spring IoC容器的基础。BeanFactory接口提供了一个先进的配置机制,使得任何类型的对象的配置都成为可能。ApplicationContex接口对BeanFactory(是一个子接口)进行了扩展,在BeanFactory的基础上添加了其他功能,比如与Spring的AOP更容易集成,也提供了处理Message Resource的机制(用于国际化),以及事件传播及应用层的特别配置,比如针对Web应用的WebApplicationContext。27、在Spring中可以注入null或空字符串吗完全可以。 喜欢文章记得点个赞,感谢支持!

优秀的个人博客,低调大师

Nginx面试中最常见的18道题 抱佛脚必备

Nginx的并发能力在同类型网页服务器中的表现,相对而言是比较好的,因此受到了很多企业的青睐,我国使用Nginx网站的知名用户包括腾讯、淘宝、百度、京东、新浪、网易等等。Nginx是网页服务器运维人员必备技能之一,下面为大家整理了一些比较常见的Nginx相关面试题,仅供参考: 1、请解释一下什么是Nginx? Nginx是一个web服务器和反向代理服务器,用于HTTP、HTTPS、SMTP、POP3和IMAP协议。 2、请列举Nginx的一些特性。 Nginx服务器的特性包括: 反向代理/L7负载均衡器 嵌入式Perl解释器 动态二进制升级 可用于重新编写URL,具有非常好的PCRE支持 3、请列举Nginx和Apache 之间的不同点 4、请解释Nginx如何处理HTTP请求。 Nginx使用反应器模式。主事件循环等待操作系统发出准备事件的信号,这样数据就可以从套接字读取,在该实例中读取到缓冲区并进行处理。单个线程可以提供数万个并发连接。 5、在Nginx中,如何使用未定义的服务器名称来阻止处理请求? 只需将请求删除的服务器就可以定义为: Server {listen 80;server_name “ “ ;return 444; } 这里,服务器名被保留为一个空字符串,它将在没有“主机”头字段的情况下匹配请求,而一个特殊的Nginx的非标准代码444被返回,从而终止连接。 6、 使用“反向代理服务器”的优点是什么? 反向代理服务器可以隐藏源服务器的存在和特征。它充当互联网云和web服务器之间的中间层。这对于安全方面来说是很好的,特别是当您使用web托管服务时。 7、请列举Nginx服务器的最佳用途。 Nginx服务器的最佳用法是在网络上部署动态HTTP内容,使用SCGI、WSGI应用程序服务器、用于脚本的FastCGI处理程序。它还可以作为负载均衡器。 8、请解释Nginx服务器上的Master和Worker进程分别是什么? Master进程:读取及评估配置和维持 Worker进程:处理请求 9、请解释你如何通过不同于80的端口开启Nginx? 为了通过一个不同的端口开启Nginx,你必须进入/etc/Nginx/sites-enabled/,如果这是默认文件,那么你必须打开名为“default”的文件。编辑文件,并放置在你想要的端口: Like server { listen 81; } 10、请解释是否有可能将Nginx的错误替换为502错误、503? 502 =错误网关 503 =服务器超载 有可能,但是您可以确保fastcgi_intercept_errors被设置为ON,并使用错误页面指令。 Location / {fastcgi_pass 127.0.01:9001;fastcgi_intercept_errors on;error_page 502 =503/error_page.html;#…} 11、在Nginx中,解释如何在URL中保留双斜线? 要在URL中保留双斜线,就必须使用merge_slashes_off; 语法:merge_slashes [on/off] 默认值: merge_slashes on 环境: http,server 12、请解释ngx_http_upstream_module的作用是什么? ngx_http_upstream_module用于定义可通过fastcgi传递、proxy传递、uwsgi传递、memcached传递和scgi传递指令来引用的服务器组。 13、请解释什么是C10K问题? C10K问题是指无法同时处理大量客户端(10,000)的网络套接字。 14、请陈述stub_status和sub_filter指令的作用是什么? Stub_status指令:该指令用于了解Nginx当前状态的当前状态,如当前的活动连接,接受和处理当前读/写/等待连接的总数 Sub_filter指令:它用于搜索和替换响应中的内容,并快速修复陈旧的数据 15、解释Nginx是否支持将请求压缩到上游? 您可以使用Nginx模块gunzip将请求压缩到上游。gunzip模块是一个过滤器,它可以对不支持“gzip”编码方法的客户机或服务器使用“内容编码:gzip”来解压缩响应。 16、解释如何在Nginx中获得当前的时间? 要获得Nginx的当前时间,必须使用SSI模块、$date_gmt和$date_local的变量。 Proxy_set_header THE-TIME $date_gmt; 17、用Nginx服务器解释-s的目的是什么? 用于运行Nginx -s参数的可执行文件。 18、解释如何在Nginx服务器上添加模块? 在编译过程中,必须选择Nginx模块,因为Nginx不支持模块的运行时间选择。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:860113481 群内提供免费的Java架构学习资料(里面有高可用、高并发、高性能及分布式、Jvm性能调优、Spring源码,MyBatis,Netty,Redis,Kafka,Mysql,Zookeeper,Tomcat,Docker,Dubbo,Nginx等多个知识点的架构资料)合理利用自己每一分每一秒的时间来学习提升自己,不要再用"没有时间“来掩饰自己思想上的懒惰!趁年轻,使劲拼,给未来的自己一个交代!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册