首页 文章 精选 留言 我的

精选列表

搜索[并发编程],共10009篇文章
优秀的个人博客,低调大师

Java并发编程学习3-可见性和对象发布

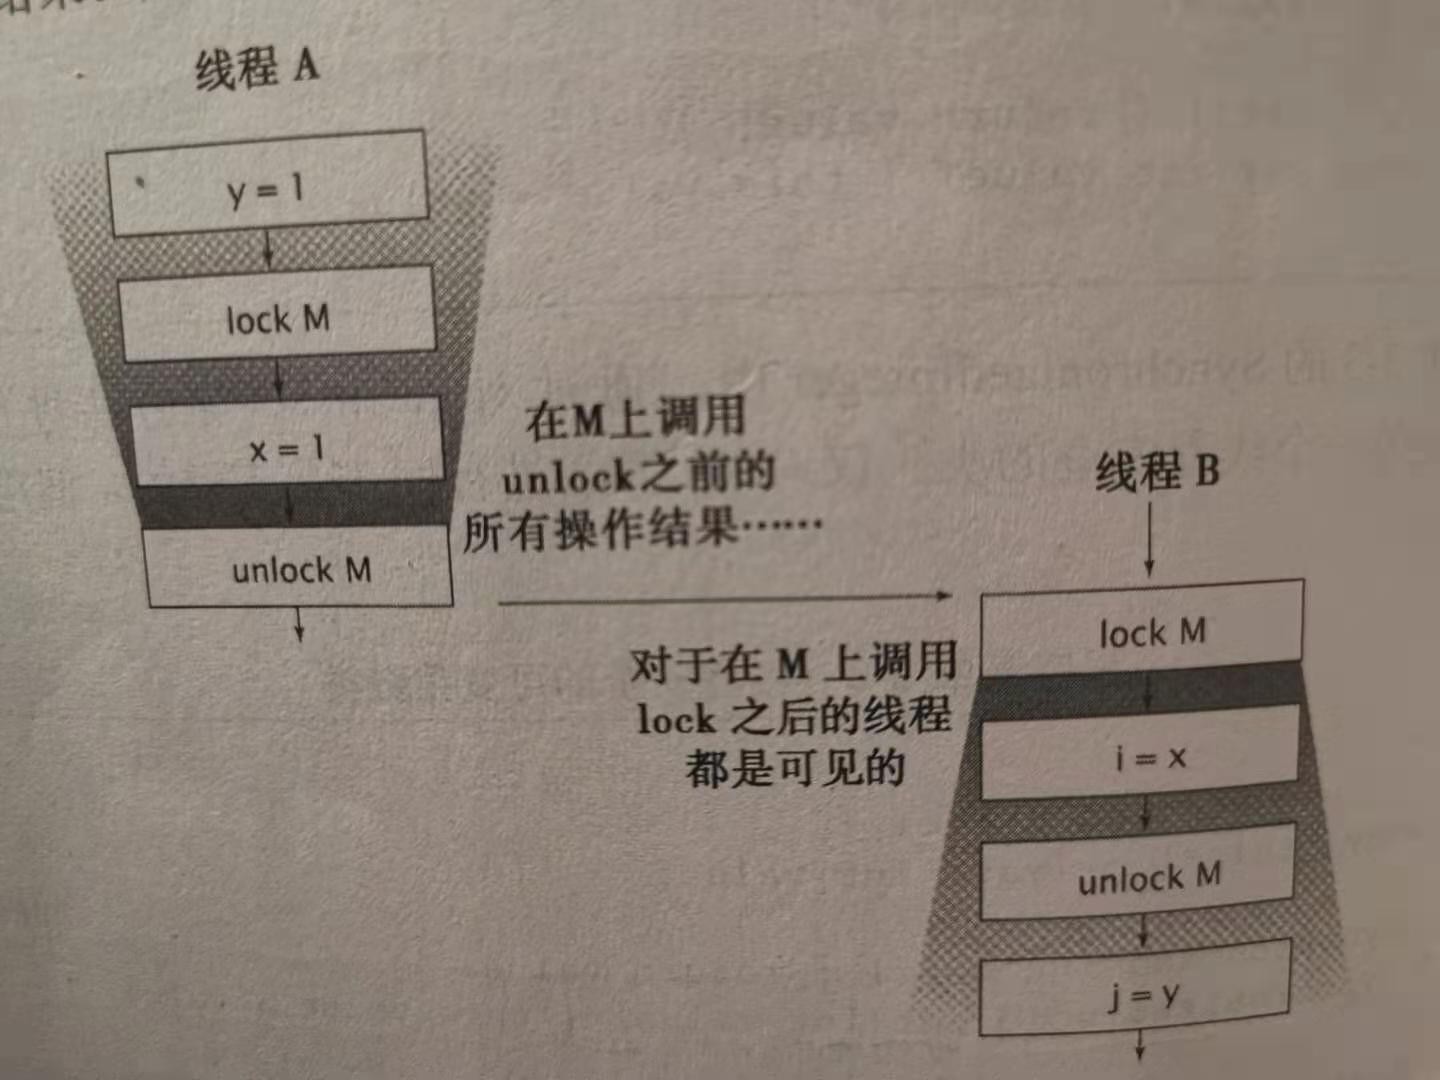
对象的共享 书接上篇,我们了解了如何通过同步来避免多个线程在同一时刻访问相同的数据,而本篇将介绍如何共享和发布对象,从而使它们能够安全地由多个线程同时访问。 1. 可见性 线程安全性的内容,让我们知道了同步代码块和同步方法可以确保以原子的方式执行操作。但如果你认为关键字 synchronized 只能用于实现原子性或者确定“临界区(Critical Section)”,那就大错特错了。同步还有一个重要的方面:内存可见性(Memory Visibility)。我们不仅希望防止某个线程正在使用对象状态而另一个线程在同时修改该状态,而且希望确保当一个线程修改了对象状态后,其他线程能够看到发生的状态变化。 可见性是一种复杂的属性,在一般的单线程环境中,如果向某个变量先写入值,然后在没有其他写入操作的情况下读取这个变量,总是能够得到相同的值。然而,当读操作和写操作在不同的线程中执行时,因为无法确保执行读操作的线程能适时地看到其他线程写入的值,所以也就不能总是得到相同的值。为了确保多个线程之间对内存写入操作的可见性,必须使用同步机制。 介绍了这么多,还不如来看下代码示例: /** * <p> 在没有同步的情况下共享变量(不推荐使用) </p> */ public class NoVisibility { private static boolean ready; private static int number; private static class ReaderThread extends Thread { @Override public void run() { while (!ready) { Thread.yield(); } System.out.println(number); } } public static void main(String[] args) { new ReaderThread().start(); number = 42; ready = true; } } 在上述代码中,主线程和读线程都将访问共享变量 ready 和 number。主线程启动读线程,然后将 number 设为 42, 并将 ready 设为 true。读线程一直循环直到发现 ready 的值变为 true,然后输出 number 的值。虽然 NoVisibility 看起来会输出 42,但事实上很可能输出0,或者根本无法终止。因为在代码中没有使用足够的同步机制,所以无法保证主线程写入的 ready 值 和 number 值对于读线程来说是可见的。 如果你尝试运行该程序,大概率控制台还是会输出42,但这并不说明这块代码就总是能输出想要的结果。NoVisibility 可能会输出0,这是因为读线程可能看到了写入 ready 的值,但却没有看到之后写入 number 的值,这种现象被称为 “重排序”;NoVisibility 也可能会一直循环下去,因为读线程可能永远都看不到 ready 的值。 在没有同步的情况下,编译器、处理器以及运行时等都可能对操作的执行顺序进行一些意想不到的调整。在缺乏足够同步的多线程程序中,要想对内存操作的执行顺序进行判断,几乎无法得出正确的结论。 1.1 失效数据 NoVisibility 展示了在缺乏同步的程序中可能产生错误结果的一种情况:失效数据。当读线程查看 ready 变量时,可能会得到一个已经失效的值。更糟糕的是,失效值可能不会同时出现:一个线程可能获得某个变量得最新值,而获得另一个变量得失效值。 下面再看一个代码示例: /** * <p> 非线程安全的可变整数类 </p> */ @NotThreadSafe public class MutableInteger { private int value; public int getValue() { return value; } public void setValue(int value) { this.value = value; } } 上述代码中 get 和 set 方法都是在没有同步的情况下访问 value 的。如果某个线程调用了 set 方法,那么另一个正在调用 get 方法的线程可能会看到更新后的 value 值,也可能看不到。 下面我们通过对 get 和 set 方法进行同步,可以使 MutableInteger 成为一个线程安全的类。代码示例如下: /** * <p> 非线程安全的可变整数类 </p> */ public class SynchronizedInteger { @GuardedBy("this") private int value; public synchronized int getValue() { return value; } public synchronized void setValue(int value) { this.value = value; } } 当然如果这里仅仅对 set 方法进行同步是不够的,调用 get 方法的线程仍然会看见失效值。 1.2 非原子的64位操作 上面我们了解到,当线程在没有同步的情况下读取变量时,可能会得到一个失效值,但至少这个值是由之前某个线程设置的值,而不是一个随机值。这种安全性保证也被称为最低安全性(out-of-thin-air-safety)。 最低安全性适用于绝大多数变量,但是非 volatile 类型的64位数值变量例外。Java内存模型要求,变量的读取操作和写入操作都必须是原子操作,但对于非 volatile 类型的 long 和 double 变量,JVM允许将64位的读操作或写操作分解为两个32位操作。当读取一个非 volatile 类型 的 long 变量时,如果对该变量的读操作和写操作在不同的线程中执行,那么很可能会读取到某个值的高32位和另一个值得低32位。 1.3 加锁与可见性 内置锁可以用于确保某个线程以一种可预测得方式来查看另一个线程的执行结果,如下图所示。当线程 A 执行某个同步代码块时,线程 B 随后进入由同一个锁保护的同步代码块,在这种情况下可以保证,在锁被释放之前,A 看到的变量值在 B 获得锁后同样可以由 B 看到。换句话说,当线程 B 执行由锁保护的同步代码块时,可以看到线程 A 之前在同一个同步代码块中的所有操作结果。 加锁的含义不仅仅局限于互斥行为,还包括内存可见性。为了确保所有线程都能看到共享变量的最新值,所有执行读操作或者写操作的线程都必须在同一个锁上同步。 1.4 volatile 变量 Java语言提供了一种稍弱的同步机制,即 volatile 变量,用来确保将变量的更新操作通知到其他线程。当变量声明为 volatile 类型后,编译器与运行时都会注意到这个变量是共享的,因此不会将该变量上的操作与其他内存操作一起重排序。volatile 变量不会被缓存在寄存器或者对其他处理器不可见的地方,因此在读取 volatile 类型的变量时总会返回最新写入的值。 当然,这里不建议过度依赖 volatile 变量提供的可见性。仅当 volatile 变量能简化代码的实现以及对同步策略的验证时,才应该使用它们。如果在验证正确性时需要对可见性进行复杂的判断,那么就建议使用 volatile 变量。 volatile 变量的正确使用方式包括: 确保它们自身状态的可见性; 确保它们所引用对象的状态的可见性; 标识一些重要的程序生命周期事件的发生(初始化或关闭) 下面看一个利用 volatile 变量来数绵羊的代码示例: volatile boolean asleep; // ... while (!asleep) countSomeSheep(); 在如上示例中,线程试图通过类似数绵羊的传统方式进入休眠状态。相比用锁来确保 asleep 更新操作的可见性,这里采用 volatile 变量,不仅满足了更新操作的可见性,而且代码逻辑也变得更加简单,更利于理解。 虽然 volatile 变量使用很方便,但它只能确保可见性,而加锁机制既可以确保可见性又可以确保原子性。 那么说了这么多,什么场景下我们才应该使用 volatile 变量呢? 当且仅当满足以下条件: 对变量的写入操作不依赖变量的当前值,或者你能确保只有单个线程更新变量的值。 该变量不会与其他状态变量一起纳入不变性条件中。 在访问变量时不需要加锁。 2. 发布与逸出 本篇开头提到了 发布对象,它是指使对象能够在当前作用域之外的代码中使用。例如,将一个指向该对象的引用保存到其他代码可以访问的地方,或者在某一个非私有的方法中返回该引用,或者将引用传递到其他类的方法中。当某个不应该发布的对象被发布了,这种情况就被称为 逸出(Escape)。 发布对象的最简单方法是将对象的引用保存到一个公有的静态变量中,以便任何类和线程都能够看见该对象。 下面展示发布一个对象的代码示例: public static Set<Secret> knownSecrets; public void initialize() { knownSecrets = new HashSet<Secret>(); } 上述代码中,在 initialize 方法中示例化一个新的 HashSet 对象,并将对象的引用保存到 knownSecrets 中以发布该对象。如果将一个 Secret 对象添加到集合 knownSecrets 中,那么同样会发布这个 Secret 对象,因为任何代码都可以遍历这个集合,并获得对这个新 Secret 对象的引用。 我们再来看一个代码示例: /** * <p> 使内部的可变状态逸出(不推荐使用) </p> */ public class UnsafeStates { private String[] states = new String[] {"HELLO", "HUAZIE"}; public String[] getStates() { return states; } } 上诉代码从非私有方法 getStates 中返回一个引用,这里同样会发布返回的引用的对象 states 。按上述方式来发布 states,就可能存在很大风险,因为任何调用者都能修改这个数组的内容。 如果一个已经发布的对象能够通过非私有的变量引用和方法调用到达其他的对象,那么这些对象也都会被发布。 最后一种发布对象或其内部状态的机制就是发布一个内部的类实例,如下代码示例: /** * <p> 隐式地使this引用逸出(不推荐使用) </p> */ public class ThisEscape { public ThisEscape(EventSource source) { source.registerListener(new EventListener(){ public void onEvent(Event e) { doSomething(e); } }); } private void doSomething(Event e) { // 事件处理 } } 当 ThisEscape 发布 EventListener 时,也隐含地发布了 ThisEscape 实例本身,因为在这个内部类的实例中包含了对 ThisEscape 实例的隐含引用。 安全的对象构造过程 在 ThisEscape 中给出了逸出的一个特殊示例,即 this 引用在构造函数中逸出。如果 this 引用在构造过程中逸出,那么这种对象就被认为是不正确构造。 注意: 不要在构造过程中使 this 引用逸出 如果想在构造函数中注册一个事件监听器或启动进程,那么可以使用一个私有的构造函数和一个公共的工厂方法,从而避免不正确的构造过程。下面请看如下代码示例: /** * <p> 使用工厂方法来防止this引用在构造过程中逸出 </p> */ public class SafeListener { private final EventListener listener; private SafeListener() { listener = new EventListener(){ public void onEvent(Event e) { doSomething(e); } }; } public static SafeListener newInstance(EventSource source) { SafeListener safe = new SafeListener(); source.registerListener(safe.listener); return safe; } private void doSomething(Event e) { // 事件处理 } } 结语 本篇我们一起了解了 可见性 和 对象的发布、逸出等相关内容;关于对象的共享的其他内容【线程封闭,不变性,安全发布】,还需要一篇博文才能介绍完,敬请期待!

优秀的个人博客,低调大师

Java并发编程笔记之Semaphore信号量源码分析

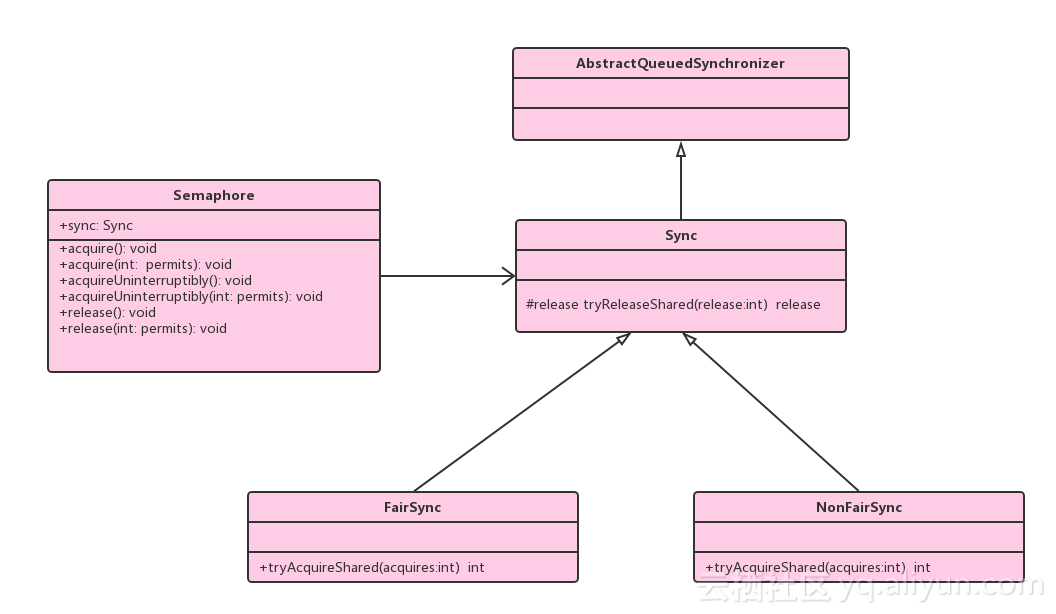
JUC 中 Semaphore 的使用与原理分析,Semaphore 也是 Java 中的一个同步器,与 CountDownLatch 和 CycleBarrier 不同在于它内部的计数器是递增的,那么,Semaphore 的内部实现是怎样的呢? Semaphore 信号量也是Java 中一个同步容器,与CountDownLatch 和 CyclicBarrier 不同之处在于它内部的计数器是递增的。为了能够一览Semaphore的内部结构,我们首先要看一下Semaphore的类图,类图,如下所示: 如上类图可以知道Semaphoren内部还是使用AQS来实现的,Sync只是对AQS的一个修饰,并且Sync有两个实现类,分别代表获取信号量的时候是否采取公平策略。创建Semaphore的时候会有一个变量标示是否使用公平策略,源码如下: public Semaphore(int permits) { sync = new NonfairSync(permits); } public Semaphore(int permits, boolean fair) { sync = fair ? new FairSync(permits) : new NonfairSync(permits); } Sync(int permits) { setState(permits); } 如上面代码所示,Semaphore默认使用的是非公平策略,如果你需要公平策略,则可以使用带两个参数的构造函数来构造Semaphore对象,另外和CountDownLatch一样,构造函数里面传递的初始化信号量个数 permits 被赋值给了AQS 的state状态变量,也就是说这里AQS的state值表示当前持有的信号量个数。 接下来我们主要看看Semaphore实现的主要方法的源码,如下: 1.void acquire() 当前线程调用该方法的时候,目的是希望获取一个信号量资源,如果当前信号量计数个数大于 0 ,并且当前线程获取到了一个信号量则该方法直接返回,当前信号量的计数会减少 1 。否则会被放入AQS的阻塞队列,当前线程被挂起,直到其他线程调用了release方法释放了信号量,并且当前线程通过竞争获取到了改信号量。当前线程被其他线程调用了 interrupte()方法中断后,当前线程会抛出 InterruptedException异常返回。源码如下: public void acquire() throws InterruptedException { //传递参数为1,说明要获取1个信号量资源 sync.acquireSharedInterruptibly(1); } public final void acquireSharedInterruptibly(int arg) throws InterruptedException { //(1)如果线程被中断,则抛出中断异常 if (Thread.interrupted()) throw new InterruptedException(); //(2)否者调用sync子类方法尝试获取,这里根据构造函数确定使用公平策略 if (tryAcquireShared(arg) < 0) //如果获取失败则放入阻塞队列,然后再次尝试如果失败则调用park方法挂起当前线程 doAcquireSharedInterruptibly(arg); } 如上代码可知,acquire()内部调用了sync的acquireSharedInterruptibly 方法,后者是对中断响应的(如果当前线程被中断,则抛出中断异常),尝试获取信号量资源的AQS的方法tryAcquireShared 是由 sync 的子类实现,所以这里就要分公平性了,这里先讨论非公平策略 NonfairSync 类的tryAcquireShared 方法,源码如下: protected int tryAcquireShared(int acquires) { return nonfairTryAcquireShared(acquires); } final int nonfairTryAcquireShared(int acquires) { for (;;) { //获取当前信号量值 int available = getState(); //计算当前剩余值 int remaining = available - acquires; //如果当前剩余小于0或者CAS设置成功则返回 if (remaining < 0 || compareAndSetState(available, remaining)) return remaining; } } 如上代码,先计算当前信号量值(available)减去需要获取的值(acquires) 得到剩余的信号量个数(remaining),如果剩余值小于 0 说明当前信号量个数满足不了需求,则直接返回负数,然后当前线程会被放入AQS的阻塞队列,当前线程被挂起。如果剩余值大于 0 则使用CAS操作设置当前信号量值为剩余值,然后返回剩余值。另外可以知道NonFairSync是非公平性获取的,是说先调用aquire方法获取信号量的线程不一定比后来者先获取锁。 接下来我们要看看公平性的FairSync 类是如何保证公平性的,源码如下: protected int tryAcquireShared(int acquires) { for (;;) { if (hasQueuedPredecessors()) return -1; int available = getState(); int remaining = available - acquires; if (remaining < 0 || compareAndSetState(available, remaining)) return remaining; } } 可以知道公平性还是靠 hasQueuedPredecessors 这个方法来做的,以前的随笔已经讲过公平性是看当前线程节点是否有前驱节点也在等待获取该资源,如果是则自己放弃获取的权力,然后当前线程会被放入AQS阻塞队列,否则就去获取。hasQueuedPredecessors源码如下: public final boolean hasQueuedPredecessors() { Node t = tail; Node h = head; Node s; return h != t && ((s = h.next) == null || s.thread != Thread.currentThread()); } 如上面代码所示,如果当前线程节点有前驱节点则返回true,否则如果当前AQS队列为空 或者 当前线程节点是AQS的第一个节点则返回 false ,其中,如果 h == t 则说明当前队列为空则直接返回 false,如果 h !=t 并且 s == null 说明有一个元素将要作为AQS的第一个节点入队列(回顾下 enq 函数第一个元素入队列是两步操作,首先创建一个哨兵头节点,然后第一个元素插入到哨兵节点后面),那么返回 true,如果 h !=t 并且 s != null 并且s.thread != Thread.currentThread() 则说明队列里面的第一个元素不是当前线程则返回 true。 2.void acquire(int permits) 该方法与 acquire() 不同在与后者只需要获取一个信号量值,而前者则获取指定 permits 个,源码如下: public void acquire(int permits) throws InterruptedException { if (permits < 0) throw new IllegalArgumentException(); sync.acquireSharedInterruptibly(permits); } 3.void acquireUninterruptibly() 该方法与 acquire() 类似,不同之处在于该方法对中断不响应,也就是当当前线程调用了 acquireUninterruptibly 获取资源过程中(包含被阻塞后)其它线程调用了当前线程的 interrupt()方法设置了当前线程的中断标志当前线程并不会抛出 InterruptedException 异常而返回。源码如下: public void acquireUninterruptibly() { sync.acquireShared(1); } 4.void acquireUninterruptibly(int permits) 该方法与 acquire(int permits) 不同在于该方法对中断不响应。源码如如下: public void acquireUninterruptibly(int permits) { if (permits < 0) throw new IllegalArgumentException(); sync.acquireShared(permits); } 5.void release() 该方法作用是把当前 semaphore对象的信号量值增加 1 ,如果当前有线程因为调用 acquire 方法被阻塞放入了 AQS的阻塞队列,则会根据公平策略选择一个线程进行激活,激活的线程会尝试获取刚增加的信号量,源码如下: public void release() { //(1)arg=1 sync.releaseShared(1); } public final boolean releaseShared(int arg) { //(2)尝试释放资源 if (tryReleaseShared(arg)) { //(3)资源释放成功则调用park唤醒AQS队列里面最先挂起的线程 doReleaseShared(); return true; } return false; } protected final boolean tryReleaseShared(int releases) { for (;;) { //(4)获取当前信号量值 int current = getState(); //(5)当前信号量值增加releases,这里为增加1 int next = current + releases; if (next < current) // 移除处理 throw new Error("Maximum permit count exceeded"); //(6)使用cas保证更新信号量值的原子性 if (compareAndSetState(current, next)) return true; } } 如上面代码可以看到 release()方法中对 sync.releaseShared(1),可以知道release方法每次只会对信号量值增加 1 ,tryReleaseShared方法是无限循环,使用CAS保证了 release 方法对信号量递增 1 的原子性操作。当tryReleaseShared 方法增加信号量成功后会执行代码(3),调用AQS的方法来激活因为调用acquire方法而被阻塞的线程。 6.void release(int permits) 该方法与不带参数的不同之处在于前者每次调用会在信号量值原来基础上增加 permits,而后者每次增加 1。源码如下: public void release(int permits) { if (permits < 0) throw new IllegalArgumentException(); sync.releaseShared(permits); } 另外注意到这里调用的是 sync.releaseShared 是共享方法,这说明该信号量是线程共享的,信号量没有和固定线程绑定,多个线程可以同时使用CAS去更新信号量的值而不会阻塞。 到目前已经知道了其原理,接下来用一个例子来加深对Semaphore的理解,例子如下: package com.hjc; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; import java.util.concurrent.Semaphore; /** * Created by cong on 2018/7/8. */ public class SemaphoreTest { // 创建一个Semaphore实例 private static volatile Semaphore semaphore = new Semaphore(0); public static void main(String[] args) throws InterruptedException { ExecutorService executorService = Executors.newFixedThreadPool(2); // 加入线程A到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " over"); semaphore.release(); } catch (Exception e) { e.printStackTrace(); } } }); // 加入线程B到线程池 executorService.submit(new Runnable() { public void run() { try { System.out.println(Thread.currentThread() + " over"); semaphore.release(); } catch (Exception e) { e.printStackTrace(); } } }); // 等待子线程执行完毕,返回 semaphore.acquire(2); System.out.println("all child thread over!"); //关闭线程池 executorService.shutdown(); } } 运行结果如下: 类似于 CountDownLatch,上面我们的例子也是在主线程中开启两个子线程进行执行,等所有子线程执行完毕后主线程在继续向下运行。 如上代码首先首先创建了一个信号量实例,构造函数的入参为 0,说明当前信号量计数器为 0,然后 main 函数添加两个线程任务到线程池,每个线程内部调用了信号量的 release 方法,相当于计数值递增一,最后在 main 线程里面调用信号量的 acquire 方法,参数传递为 2 说明调用 acquire 方法的线程会一直阻塞,直到信号量的计数变为 2 时才会返回。 看到这里也就明白了,如果构造 Semaphore 时候传递的参数为 N,在 M 个线程中调用了该信号量的 release 方法,那么在调用 acquire 对 M 个线程进行同步时候传递的参数应该是 M+N; 对CountDownLatch,CyclicBarrier,Semaphored这三者之间的比较总结: 1.CountDownLatch 通过计数器提供了更灵活的控制,只要检测到计数器为 0,而不管当前线程是否结束调用 await 的线程就可以往下执行,相比使用 jion 必须等待线程执行完毕后主线程才会继续向下运行更灵活。 2.CyclicBarrier 也可以达到 CountDownLatch 的效果,但是后者当计数器变为 0 后,就不能在被复用,而前者则使用 reset 方法可以重置后复用,前者对同一个算法但是输入参数不同的类似场景下比较适用。 3.而 semaphore 采用了信号量递增的策略,一开始并不需要关心需要同步的线程个数,等调用 aquire 时候在指定需要同步个数,并且提供了获取信号量的公平性策略。

优秀的个人博客,低调大师

java并发编程实战 第六章 任务执行

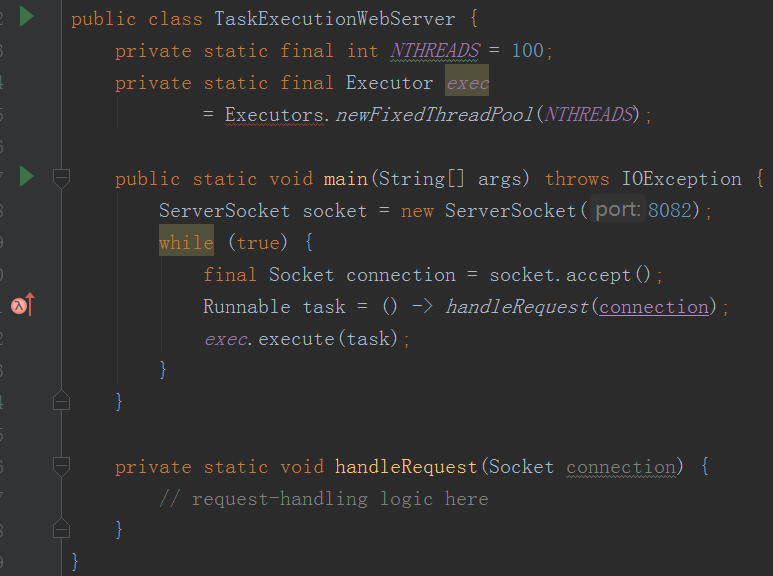
一、在线程中执行任务 1、串行地执行任务 当服务器正在处理请求时,新的连接必须等待直到请求处理完毕。如果请求阻塞时间过长,用户将认为服务器不可用。 2、显式地为任务创建线程 通过每个请求创建一个新的线程来提供服务,从而实现高响应性。需要创建大量线程时: 线程生命周期开销非常高,线程创建、销毁需要代价 资源消耗,活跃的线程消耗系统资源,尤其是内存。如果可运行的线程数量多于可用处理器的数量,那么有些线程将闲置。 大量闲置线程占用内存,给垃圾回收带来压力,并在竞争cpu资源时产生性能开销。 稳定性。可创建线程数据存在一个限制。受JVM启动参数、Thread构造函数中请求栈大小、底层操作系统对线程的限制等。 在一定范围内,增加线程可以提高系统吞吐率,超过这个范围,在创建更多的线程只会降低程序的执行速度,甚至系统崩溃。 二、Executor框架 Executor提供了一种标准的方法将任务的提交过程与执行过程解耦,并用Runnable来表示任务。 public interface Executor { void execute (Runnbale command); } 提供了对生命周期的支持,以及统计信息收集、应用程序管理机制和性能监视等机制。Executor基于生产者-消费者模式,提交任务相当于生产者,执行任务的线程相当于消费者。 1、线程池 管理一组同构工作线程的资源池。比“为每个任务分配一个线程”优势更: 通过重用现有的线程而不是创建新线程, 可以在处理多个请求时分摊创建线程和销毁的开销。不会等待线程创建而延迟任务执行。 创建足够的线程使处理器保持忙绿,防止过多线程相互竞争资源而使应用程序耗尽内存或失败 newSingleThreadPool:单线程的Executor,创建单个工作者线程来执行任务,如果这个线程异常结束,会创建另一个线程来替代。 可以确保任务在队列中串行执行。 newFixedThreadPool:创建一个固定大小的线程池,每当提交一个任务时就创建一个线程,直到达到线程池的最大数量。 newCachedThreadPool:创建一个可缓存的线程池,如果线程池当前规模超过了处理需求时,将回收空闲线程;当需求增加时,课添加新的线程,线程池规模无限制 newScheduledThreadPool:创建一个固定大小的线程池,而且以延迟或定时的方式来执行任务,类似Timer public static ExecutorService newFixedThreadPool(int nThreads) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>()); }public static ExecutorService newSingleThreadExecutor() { return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>())); }public static ExecutorService newCachedThreadPool() { return new ThreadPoolExecutor(0, Integer.MAX_VALUE, 60L, TimeUnit.SECONDS, new SynchronousQueue<Runnable>()); } 2、Executor的生命周期 ExecutorService接口添加了生命周期管理方法。ExecutorService的生命周期有三种状态:运行、关闭、已终止。在初始化创建时处于运行状态。shutdown方法将执行平缓关闭过程:不再接受新任务,同时等待已久提交的任务执行完成,包括还未开始执行的任务。shutdownNow方法执行粗暴关闭过程:长手取消所有运行中的任务,并且不再启动队列中尚未开始执行的任务。 3、延迟任务与周期任务 三、找出可以利用的并行性 如果要使用Executor,必须将任务表述为一个Runnable。 1、携带结果的任务Callbale与Future Executor框架使用Runnable作为其基本任务的表示形式。 Runnable存在问题:虽然run能写入到日志文件或者将结果放入某个共享的数据结构,但不能返回一个值或抛出一个受检查的异常。许多任务实际上都是存在延迟计算--执行数据库查询、从网络上获取资源或计算某个复杂功能。对于这种任务,Callable是一种更好的抽象:它认为主入口点将返回一个值,并可能抛出一个异常。 public interface Callable<V> { /** * Computes a result, or throws an exception if unable to do so. * * @return computed result * @throws Exception if unable to compute a result */ V call() throws Exception; } Executor执行任务有4个生命周期阶段:创建、提交、开始、完成。在Executor框架中,已提交尚未开始的任务可以取消,对于已经开始执行的任务,只有当它们能响应中断时,才能取消。 Future表示一个任务的生命周期,并提供了相应的方法来判断是否已经完成或取消,以及获取任务的结果和取消任务等。

优秀的个人博客,低调大师

Java并发编程实战系列10之避免活跃性危险

10.1 死锁 哲学家问题 有环 A等B,B等A 数据库往往可以检测和解决死锁//TODO JVM不行,一旦死锁只有停止重启。 下面分别介绍了几种典型的死锁情况: 10.1.1 Lock ordering Deadlocks 下面是一个经典的锁顺序死锁:两个线程用不同的顺序来获得相同的锁,如果按照锁的请求顺序来请求锁,就不会发生这种循环依赖的情况。 public class LeftRightDeadlock { private final Object left = new Object(); private final Object right = new Object(); public void leftRight() { synchronized (left) { synchronized (right) { doSomething(); } } } public void rightLeft() { synchronized (right) { synchronized (left) { doSomethingElse(); } } } void doSomething() { } void doSomethingElse() { } } 10.1.1 Dynamic Lock Order Deadlocks 下面的转账例子,如果一个线程X向Y转,而另外一个线程Y向X也转,那么就会发生死锁。 public class DynamicOrderDeadlock { // Warning: deadlock-prone! public static void transferMoney(Account fromAccount, Account toAccount, DollarAmount amount) throws InsufficientFundsException { synchronized (fromAccount) { synchronized (toAccount) { if (fromAccount.getBalance().compareTo(amount) < 0) throw new InsufficientFundsException(); else { fromAccount.debit(amount); toAccount.credit(amount); } } } } static class DollarAmount implements Comparable<DollarAmount> { // Needs implementation public DollarAmount(int amount) { } public DollarAmount add(DollarAmount d) { return null; } public DollarAmount subtract(DollarAmount d) { return null; } public int compareTo(DollarAmount dollarAmount) { return 0; } } static class Account { private DollarAmount balance; private final int acctNo; private static final AtomicInteger sequence = new AtomicInteger(); public Account() { acctNo = sequence.incrementAndGet(); } void debit(DollarAmount d) { balance = balance.subtract(d); } void credit(DollarAmount d) { balance = balance.add(d); } DollarAmount getBalance() { return balance; } int getAcctNo() { return acctNo; } } static class InsufficientFundsException extends Exception { } } 解决办法还是顺序话锁,考虑针对两种情况取hashcode然后判断if-else里面决定锁顺序。 class Helper { public void transfer() throws InsufficientFundsException { if (fromAcct.getBalance().compareTo(amount) < 0) throw new InsufficientFundsException(); else { fromAcct.debit(amount); toAcct.credit(amount); } } } int fromHash = System.identityHashCode(fromAcct); int toHash = System.identityHashCode(toAcct); if (fromHash < toHash) { synchronized (fromAcct) { synchronized (toAcct) { new Helper().transfer(); } } } else if (fromHash > toHash) { synchronized (toAcct) { synchronized (fromAcct) { new Helper().transfer(); } } } else { synchronized (tieLock) { synchronized (fromAcct) { synchronized (toAcct) { new Helper().transfer(); } } } } 10.1.3 在协作对象之间发生死锁Deadlocks Between Cooperating Objects 下面的例子setLocation和getImage都会获取两把锁,会存在两个线程按照不同的顺序获取锁的情况。 public class CooperatingDeadlock { // Warning: deadlock-prone! class Taxi { @GuardedBy("this") private Point location, destination; private final Dispatcher dispatcher; public Taxi(Dispatcher dispatcher) { this.dispatcher = dispatcher; } public synchronized Point getLocation() { return location; } public synchronized void setLocation(Point location) { this.location = location; if (location.equals(destination)) dispatcher.notifyAvailable(this); } public synchronized Point getDestination() { return destination; } public synchronized void setDestination(Point destination) { this.destination = destination; } } class Dispatcher { @GuardedBy("this") private final Set<Taxi> taxis; @GuardedBy("this") private final Set<Taxi> availableTaxis; public Dispatcher() { taxis = new HashSet<Taxi>(); availableTaxis = new HashSet<Taxi>(); } public synchronized void notifyAvailable(Taxi taxi) { availableTaxis.add(taxi); } public synchronized Image getImage() { Image image = new Image(); for (Taxi t : taxis) image.drawMarker(t.getLocation()); return image; } } class Image { public void drawMarker(Point p) { } } } 10.1.4 开放调用 减小锁的力度,锁不嵌套。 class CooperatingNoDeadlock { @ThreadSafe class Taxi { @GuardedBy("this") private Point location, destination; private final Dispatcher dispatcher; public Taxi(Dispatcher dispatcher) { this.dispatcher = dispatcher; } public synchronized Point getLocation() { return location; } public synchronized void setLocation(Point location) { boolean reachedDestination; synchronized (this) { this.location = location; reachedDestination = location.equals(destination); } if (reachedDestination) dispatcher.notifyAvailable(this); } public synchronized Point getDestination() { return destination; } public synchronized void setDestination(Point destination) { this.destination = destination; } } @ThreadSafe class Dispatcher { @GuardedBy("this") private final Set<Taxi> taxis; @GuardedBy("this") private final Set<Taxi> availableTaxis; public Dispatcher() { taxis = new HashSet<Taxi>(); availableTaxis = new HashSet<Taxi>(); } public synchronized void notifyAvailable(Taxi taxi) { availableTaxis.add(taxi); } public Image getImage() { Set<Taxi> copy; synchronized (this) { copy = new HashSet<Taxi>(taxis); } Image image = new Image(); for (Taxi t : copy) image.drawMarker(t.getLocation()); return image; } } class Image { public void drawMarker(Point p) { } } } 1.0.15 资源死锁 数据库连接池,A持有数据库D1连接,等待与D2连接,B持有D2的连接,等待与D1连接。 线程饥饿死锁,如8.1.1小节的例子。 10.2 死锁的避免与诊断 10.2.1 支持定时的锁 tryLock 10.2.2 kill -3 发信号给JVM dump线程 10.3 其他活跃性危险 10.3.1 饥饿 10.3.3 活锁Livelock 他不会阻塞线程,但是也不能继续执行,因为线程在不断的重复执行相同的操作,而且总会失败。 例如处理事务消,回滚后再次重新把任务放在队头。 又例如发送数据包,都选择1s后重试,那么总会冲突,所以可以考虑一个随机数时间间隔。

优秀的个人博客,低调大师

Java并发编程实战系列8之线程池的使用

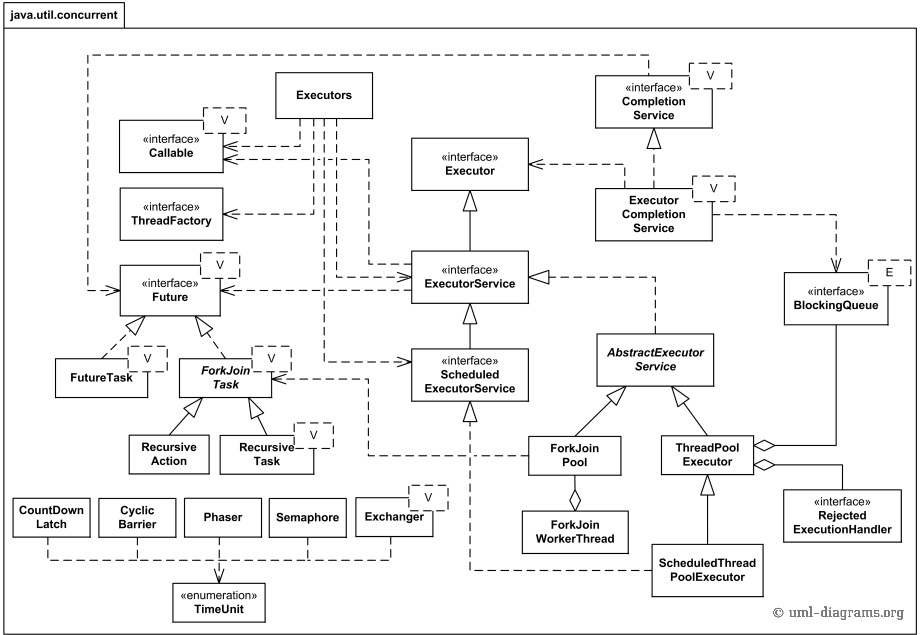
ThreadPoolExecutor UML图: image image 8.1 在任务和执行策略之间隐形耦合 避免Thread starvation deadlock 8.2 设置线程池大小 8.3 配置ThreadPoolExecutor image 构造函数如下: public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, ThreadFactory threadFactory, RejectedExecutionHandler handler) { ... } 核心和最大池大小:如果运行的线程少于 corePoolSize,则创建新线程来处理请求(即一个Runnable实例),即使其它线程是空闲的。如果运行的线程多于 corePoolSize 而少于 maximumPoolSize,则仅当队列满时才创建新线程。 保持活动时间:如果池中当前有多于 corePoolSize 的线程,则这些多出的线程在空闲时间超过 keepAliveTime 时将会终止。 排队:如果运行的线程等于或多于 corePoolSize,则 Executor 始终首选将请求加入队列BlockingQueue,而不添加新的线程。 被拒绝的任务:当 Executor 已经关闭,或者队列已满且线程数量达到maximumPoolSize时(即线程池饱和了),请求将被拒绝。这些拒绝的策略叫做Saturation Policy,即饱和策略。包括AbortPolicy, CallerRunsPolicy, DiscardPolicy, and DiscardOldestPolicy. 另外注意: 如果运行的线程少于 corePoolSize,ThreadPoolExecutor 会始终首选创建新的线程来处理请求;注意,这时即使有空闲线程也不会重复使用(这和数据库连接池有很大差别)。 如果运行的线程等于或多于 corePoolSize,则 ThreadPoolExecutor 会将请求加入队列BlockingQueue,而不添加新的线程(这和数据库连接池也不一样)。 如果无法将请求加入队列(比如队列已满),则创建新的线程来处理请求;但是如果创建的线程数超出 maximumPoolSize,在这种情况下,请求将被拒绝。 newCachedThreadPool使用了SynchronousQueue,并且是无界的。 线程工厂ThreadFactory 8.4 扩展ThreadPoolExecutor 重写beforeExecute和afterExecute方法。 8.5 递归算法的并行化 实际就是类似Number of Islands或者N-Queens等DFS问题的一种并行处理。 串行版本如下: public class SequentialPuzzleSolver <P, M> { private final Puzzle<P, M> puzzle; private final Set<P> seen = new HashSet<P>(); public SequentialPuzzleSolver(Puzzle<P, M> puzzle) { this.puzzle = puzzle; } public List<M> solve() { P pos = puzzle.initialPosition(); return search(new PuzzleNode<P, M>(pos, null, null)); } private List<M> search(PuzzleNode<P, M> node) { if (!seen.contains(node.pos)) { seen.add(node.pos); if (puzzle.isGoal(node.pos)) return node.asMoveList(); for (M move : puzzle.legalMoves(node.pos)) { P pos = puzzle.move(node.pos, move); PuzzleNode<P, M> child = new PuzzleNode<P, M>(pos, move, node); List<M> result = search(child); if (result != null) return result; } } return null; } } 并行版本如下: public class ConcurrentPuzzleSolver <P, M> { private final Puzzle<P, M> puzzle; private final ExecutorService exec; private final ConcurrentMap<P, Boolean> seen; protected final ValueLatch<PuzzleNode<P, M>> solution = new ValueLatch<PuzzleNode<P, M>>(); public ConcurrentPuzzleSolver(Puzzle<P, M> puzzle) { this.puzzle = puzzle; this.exec = initThreadPool(); this.seen = new ConcurrentHashMap<P, Boolean>(); if (exec instanceof ThreadPoolExecutor) { ThreadPoolExecutor tpe = (ThreadPoolExecutor) exec; tpe.setRejectedExecutionHandler(new ThreadPoolExecutor.DiscardPolicy()); } } private ExecutorService initThreadPool() { return Executors.newCachedThreadPool(); } public List<M> solve() throws InterruptedException { try { P p = puzzle.initialPosition(); exec.execute(newTask(p, null, null)); // block until solution found PuzzleNode<P, M> solnPuzzleNode = solution.getValue(); return (solnPuzzleNode == null) ? null : solnPuzzleNode.asMoveList(); } finally { exec.shutdown(); } } protected Runnable newTask(P p, M m, PuzzleNode<P, M> n) { return new SolverTask(p, m, n); } protected class SolverTask extends PuzzleNode<P, M> implements Runnable { SolverTask(P pos, M move, PuzzleNode<P, M> prev) { super(pos, move, prev); } public void run() { if (solution.isSet() || seen.putIfAbsent(pos, true) != null) return; // already solved or seen this position if (puzzle.isGoal(pos)) solution.setValue(this); else for (M m : puzzle.legalMoves(pos)) exec.execute(newTask(puzzle.move(pos, m), m, this)); } } }

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册