首页 文章 精选 留言 我的

精选列表

搜索[实体项目],共10013篇文章
优秀的个人博客,低调大师

FFMPEG相关开源项目

1.FFmpeg build for android random architectures with example jnihttps://github.com/appunite/AndroidFFmpeg2.ijkplayer - Android/iOS 基于FFMPEG库的播放器http://git.oschina.net/bbcallen/ijkplayergit下载地址: http://git.oschina.net/bbcallen/ijkplayer.git git@git.oschina.net:bbcallen/ijkplayer.git https://github.com/bbcallen/ijkplayer 3. KxMovie - IOS平台基于FFMPEG播放器https://github.com/kolyvan/kxmovie4.Vitamio - Android/IOS平台上的多媒体框架,带有硬件加速解码和渲染.https://github.com/yixia/VitamioBundle5.YUV2RGB - 顾名思义,YUV转RGB http://wss.co.uk/pinknoise/yuv2rgb/ 6.TSDemux - 将TS流解码为PES或ES 下载这个源码需要FQ。 http://code.google.com/p/tsdemuxer/ 7.MPlayer - 跨平台的视频播放器,可在Linux和其他类Unix系统、Windows及Mac OS X系统使用 http://www.mplayerhq.hu/design7/dload.html 8.VLC - 跨平台的视频播放器。现在也有安卓版本。也可以作为流媒体服务器。 http://www.videolan.org/vlc/index.html 9.FFDshow - 免费的编解码软件,基于windows平台。原因就是directshow就是微软开发的,只能用于windows平台。 http://sourceforge.NET/projects/ffdshow-tryout/ 这是笔者目前接触到的,等以后遇到了,再整理。

优秀的个人博客,低调大师

apache开源项目--HBase

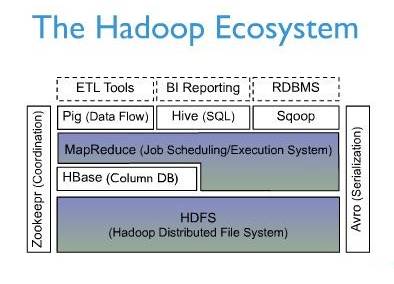
HBase – Hadoop Database,是一个高可靠性、高性能、面向列、可伸缩的分布式存储系统,利用HBase技术可在廉价PC Server上搭建起大规模结构化存储集群。 HBase是Google Bigtable的开源实现,类似Google Bigtable利用GFS作为其文件存储系统,HBase利用Hadoop HDFS作为其文件存储系统;Google运行MapReduce来处理Bigtable中的海量数据,HBase同样利用Hadoop MapReduce来处理HBase中的海量数据;Google Bigtable利用 Chubby作为协同服务,HBase利用Zookeeper作为对应。 上图描述了Hadoop EcoSystem中的各层系统,其中HBase位于结构化存储层,Hadoop HDFS为HBase提供了高可靠性的底层存储支持,Hadoop MapReduce为HBase提供了高性能的计算能力,Zookeeper为HBase提供了稳定服务和failover机制。 此外,Pig和Hive还为HBase提供了高层语言支持,使得在HBase上进行数据统计处理变的非常简单。 Sqoop则为HBase提供了方便的RDBMS数据导入功能,使得传统数据库数据向HBase中迁移变的非常方便。 HBase访问接口 1. Native Java API,最常规和高效的访问方式,适合Hadoop MapReduce Job并行批处理HBase表数据 2. HBase Shell,HBase的命令行工具,最简单的接口,适合HBase管理使用 3. Thrift Gateway,利用Thrift序列化技术,支持C++,PHP,Python等多种语言,适合其他异构系统在线访问HBase表数据 4. REST Gateway,支持REST 风格的Http API访问HBase, 解除了语言限制 5. Pig,可以使用Pig Latin流式编程语言来操作HBase中的数据,和Hive类似,本质最终也是编译成MapReduce Job来处理HBase表数据,适合做数据统计 6. Hive,当前Hive的Release版本尚没有加入对HBase的支持,但在下一个版本Hive 0.7.0中将会支持HBase,可以使用类似SQL语言来访问HBase HBase数据模型 Table & Column Family Row Key Timestamp Column Family URI Parser r1 t3 url=http://www.taobao.com title=天天特价 t2 host=taobao.com t1 r2 t5 url=http://www.alibaba.com content=每天… t4 host=alibaba.com Ø Row Key: 行键,Table的主键,Table中的记录按照Row Key排序 Ø Timestamp: 时间戳,每次数据操作对应的时间戳,可以看作是数据的version number Ø Column Family:列簇,Table在水平方向有一个或者多个Column Family组成,一个Column Family中可以由任意多个Column组成,即Column Family支持动态扩展,无需预先定义Column的数量以及类型,所有Column均以二进制格式存储,用户需要自行进行类型转换。 Table & Region 当Table随着记录数不断增加而变大后,会逐渐分裂成多份splits,成为regions,一个region由[startkey,endkey)表示,不同的region会被Master分配给相应的RegionServer进行管理: -ROOT- && .META. Table HBase中有两张特殊的Table,-ROOT-和.META. Ø .META.:记录了用户表的Region信息,.META.可以有多个regoin Ø -ROOT-:记录了.META.表的Region信息,-ROOT-只有一个region Ø Zookeeper中记录了-ROOT-表的location Client访问用户数据之前需要首先访问zookeeper,然后访问-ROOT-表,接着访问.META.表,最后才能找到用户数据的位置去访问,中间需要多次网络操作,不过client端会做cache缓存。 MapReduce on HBase 在HBase系统上运行批处理运算,最方便和实用的模型依然是MapReduce,如下图: HBase Table和Region的关系,比较类似HDFS File和Block的关系,HBase提供了配套的TableInputFormat和TableOutputFormat API,可以方便的将HBase Table作为Hadoop MapReduce的Source和Sink,对于MapReduce Job应用开发人员来说,基本不需要关注HBase系统自身的细节。 HBase系统架构 Client HBase Client使用HBase的RPC机制与HMaster和HRegionServer进行通信,对于管理类操作,Client与HMaster进行RPC;对于数据读写类操作,Client与HRegionServer进行RPC Zookeeper Zookeeper Quorum中除了存储了-ROOT-表的地址和HMaster的地址,HRegionServer也会把自己以Ephemeral方式注册到 Zookeeper中,使得HMaster可以随时感知到各个HRegionServer的健康状态。此外,Zookeeper也避免了HMaster的 单点问题,见下文描述 HMaster HMaster没有单点问题,HBase中可以启动多个HMaster,通过Zookeeper的Master Election机制保证总有一个Master运行,HMaster在功能上主要负责Table和Region的管理工作: 1. 管理用户对Table的增、删、改、查操作 2. 管理HRegionServer的负载均衡,调整Region分布 3. 在Region Split后,负责新Region的分配 4. 在HRegionServer停机后,负责失效HRegionServer 上的Regions迁移 HRegionServer HRegionServer主要负责响应用户I/O请求,向HDFS文件系统中读写数据,是HBase中最核心的模块。 HRegionServer内部管理了一系列HRegion对象,每个HRegion对应了Table中的一个Region,HRegion中由多 个HStore组成。每个HStore对应了Table中的一个Column Family的存储,可以看出每个Column Family其实就是一个集中的存储单元,因此最好将具备共同IO特性的column放在一个Column Family中,这样最高效。 HStore存储是HBase存储的核心了,其中由两部分组成,一部分是MemStore,一部分是StoreFiles。MemStore是 Sorted Memory Buffer,用户写入的数据首先会放入MemStore,当MemStore满了以后会Flush成一个StoreFile(底层实现是HFile), 当StoreFile文件数量增长到一定阈值,会触发Compact合并操作,将多个StoreFiles合并成一个StoreFile,合并过程中会进 行版本合并和数据删除,因此可以看出HBase其实只有增加数据,所有的更新和删除操作都是在后续的compact过程中进行的,这使得用户的写操作只要 进入内存中就可以立即返回,保证了HBase I/O的高性能。当StoreFiles Compact后,会逐步形成越来越大的StoreFile,当单个StoreFile大小超过一定阈值后,会触发Split操作,同时把当前 Region Split成2个Region,父Region会下线,新Split出的2个孩子Region会被HMaster分配到相应的HRegionServer 上,使得原先1个Region的压力得以分流到2个Region上。下图描述了Compaction和Split的过程: 在理解了上述HStore的基本原理后,还必须了解一下HLog的功能,因为上述的HStore在系统正常工作的前提下是没有问题的,但是在分布式 系统环境中,无法避免系统出错或者宕机,因此一旦HRegionServer意外退出,MemStore中的内存数据将会丢失,这就需要引入HLog了。 每个HRegionServer中都有一个HLog对象,HLog是一个实现Write Ahead Log的类,在每次用户操作写入MemStore的同时,也会写一份数据到HLog文件中(HLog文件格式见后续),HLog文件定期会滚动出新的,并 删除旧的文件(已持久化到StoreFile中的数据)。当HRegionServer意外终止后,HMaster会通过Zookeeper感知 到,HMaster首先会处理遗留的 HLog文件,将其中不同Region的Log数据进行拆分,分别放到相应region的目录下,然后再将失效的region重新分配,领取 到这些region的HRegionServer在Load Region的过程中,会发现有历史HLog需要处理,因此会Replay HLog中的数据到MemStore中,然后flush到StoreFiles,完成数据恢复。 HBase存储格式 HBase中的所有数据文件都存储在Hadoop HDFS文件系统上,主要包括上述提出的两种文件类型: 1. HFile, HBase中KeyValue数据的存储格式,HFile是Hadoop的二进制格式文件,实际上StoreFile就是对HFile做了轻量级包装,即StoreFile底层就是HFile 2. HLog File,HBase中WAL(Write Ahead Log) 的存储格式,物理上是Hadoop的Sequence File HFile 下图是HFile的存储格式: 首先HFile文件是不定长的,长度固定的只有其中的两块:Trailer和FileInfo。正如图中所示的,Trailer中有指针指向其他数 据块的起始点。File Info中记录了文件的一些Meta信息,例如:AVG_KEY_LEN, AVG_VALUE_LEN, LAST_KEY, COMPARATOR, MAX_SEQ_ID_KEY等。Data Index和Meta Index块记录了每个Data块和Meta块的起始点。 Data Block是HBase I/O的基本单元,为了提高效率,HRegionServer中有基于LRU的Block Cache机制。每个Data块的大小可以在创建一个Table的时候通过参数指定,大号的Block有利于顺序Scan,小号Block利于随机查询。 每个Data块除了开头的Magic以外就是一个个KeyValue对拼接而成, Magic内容就是一些随机数字,目的是防止数据损坏。后面会详细介绍每个KeyValue对的内部构造。 HFile里面的每个KeyValue对就是一个简单的byte数组。但是这个byte数组里面包含了很多项,并且有固定的结构。我们来看看里面的具体结构: 开始是两个固定长度的数值,分别表示Key的长度和Value的长度。紧接着是Key,开始是固定长度的数值,表示RowKey的长度,紧接着是 RowKey,然后是固定长度的数值,表示Family的长度,然后是Family,接着是Qualifier,然后是两个固定长度的数值,表示Time Stamp和Key Type(Put/Delete)。Value部分没有这么复杂的结构,就是纯粹的二进制数据了。 HLogFile 上图中示意了HLog文件的结构,其实HLog文件就是一个普通的Hadoop Sequence File,Sequence File 的Key是HLogKey对象,HLogKey中记录了写入数据的归属信息,除了table和region名字外,同时还包括sequence number和timestamp,timestamp是“写入时间”,sequence number的起始值为0,或者是最近一次存入文件系统中sequence number。 HLog Sequece File的Value是HBase的KeyValue对象,即对应HFile中的KeyValue,可参见上文描述。 结束 本文对HBase技术在功能和设计上进行了大致的介绍,由于篇幅有限,本文没有过多深入地描述HBase的一些细节技术。目前一淘的存储系统就是基于HBase技术搭建的,后续将介绍“一淘分布式存储系统”,通过实际案例来更多的介绍HBase应用。 本文转自二郎三郎博客园博客,原文链接:http://www.cnblogs.com/haore147/p/5103090.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

apache开源项目--Ignite

Apache Ignite 内存数组组织框架是一个高性能、集成和分布式的内存计算和事务平台,用于大规模的数据集处理。Ignite 为应用和不同的数据源之间提供一个高性能、分布式内存中数据组织管理的框架。 集群计算特性: 动态集群 Fork-Join & MapReduce 处理 分布式闭包执行 负载均衡和容错 分布式消息和事件 线性可伸缩 内存缓存和数据网格关键特性: 分布式内存中缓存 优雅的伸缩方案 高性能 分布式内存中事务支持 分布式内存队列和其他数据结构 Web 会话集群 Hibernate L2 缓存集成 分布式 SQL 联合查询 内存数据流: 本文转自二郎三郎博客园博客,原文链接:http://www.cnblogs.com/haore147/p/5103006.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

apache开源项目 -- tez

为了更高效地运行存在依赖关系的作业(比如Pig和Hive产生的MapReduce作业),减少磁盘和网络IO,Hortonworks开发了DAG计 算框架Tez。Tez是从MapReduce计算框架演化而来的通用DAG计算框架,可作为MapReduceR/Pig/Hive等系统的底层数据处理 引擎,它天生融入Hadoop 2.0中的资源管理平台YARN,且由Hadoop 2.0核心人员精心打造,势必将会成为计算框架中的后起之秀。本文将重点介绍Tez的最新进展。 在阅读本文之前,读者可先阅读我之前写的三篇文章了解Tez有关背景、设计原理等: (1)浅谈Apache Tez中的优化技术 (2)Apache Tez:一个运行在YARN之上支持DAG作业的计算框架 (3)Tez:运行在YARN上的DAG计算框架 总结起来,Tez有以下几个特色: (1) 丰富的数据流(dataflow,NOT Streaming!)编程接口; (2) 扩展性良好的“Input-Processor-Output”运行模型; (3) 简化数据部署(充分利用了YARN框架,Tez本身仅是一个客户端编程库,无需事先部署相关服务) (4) 性能优于MapReduce (5) 优化的资源管理(直接运行在资源管理系统YARN之上) (6) 动态生成物理数据流(dataflow) 声明:本文大部分内容源自Apache Tez官方主页中的说明文档,有兴趣的读者可进入http://tez.incubator.apache.org/了解更多内容,你也可以根据文档说明安装Tez(需要apache最新版本2.1.0-beta或者3.0.0,CDH暂不支持,版本太老),进而对它有一个更加直观的理解。 1. 优化举例 为了方便大家理解Tez的优化效果,接下来给出两个例子 予以说明。 (1)MRR*应用 比如以下Hive SQL会翻译成两个MR作业,而采用Tez则生成一个DAG作业,可大大减少磁盘IO: SELECT DeptName, COUNT(*) as c FROM EmployeeTable GROUP BY DeptName ORDER BY c; (2)Join应用 比如以下Hive SQL会翻译成四个MR作业,而采用Tez则生成一个DAG作业,可大大减少磁盘IO: SELECT a.state, COUNT(*), AVERAGE(c.price) FROM a JOIN b ON(a.id = b.id) JOIN c ON(a.itemId = c.itemId) GROUP BY a.state 2.术语介绍 可类比数据库中的概念理解这些术语,比如数据库中的逻辑计划和物理计划:Job Vertex、Job Edge和Static Plan属于逻辑计划概念;Vertex、Edge和Dynamic Plan属于物理计划概念。 (1)Job Vertex:作业规划中的一个阶段(Stage); (2) Job Edge:两个不同Job Vertex之间的逻辑关联; (3) Vertex: 运行时生成的物化阶段,由若干个可以执行的Task构成; (4) Edge: Task之间数据移动方式; (5) Task: 能够完成计算任务的线程,实际运行在YARN Container中; (6) Task cardinality: 任务基数,即Vertex产生的Task数目 (7) Static plan: 作业提交时确定的逻辑执行计划 (8) Dynamic plan:在ApplicationMaster执行时产生的物理执行计划 3. Tez中的通信类型 (1)1对于1 第一阶段中的任务按照1:1的映射关系将数据传递给下一个阶段中的任务,典型应用是hash join,如下图所示: (2) 1对于N 第一阶段中的每个任务会产生N份数据(N是下一个阶段中的任务数目),每份数据由下一个阶段的一个任务读取,这类似与MapReduce的Shuffle阶段,具体有两种实现方式: 方式1:每个任务产生的N份数据放到N个文件中,供下一个阶段的任务直接获取,这种方式可能产生过多的文件,可能难以扩展到上千个任务的场景; 方式2:每个任务产生的N份数据放放到一个文件中,并增加一个索引文件记录每份数据中偏移量,这种方式的扩展性非常好,Hadoop MapReduce正是采用了这种实现(设计之初,Hadoop MapReduce层采用方式1中的方案)。 4. Tez新引入的优化机制 (1) 动态确定任务基数 DAG中每个Vertex需启动一定数目的任务并行处理对应的数据,Tez可根据用户设置的策略动态确定每个Vertex需启动的任务数,比如根据数据量、最大并发数等。 (2)解决数据倾斜问题 数据倾斜是分布式计算中影响数据处理效率的最大顽疾之一,很多工作在这方面开展但一直没有非常好的解决方案。目前看来,比较有效的方案是在应用程序层解决,即用户根据实际数据特点编写最有效的应用程序,尽可能避免数据倾斜问题。 数据倾斜的一种典型场景是大批量的数据的key值是相同的,这使得按key划分数据后,大量数据落到一个任务上,从而使得该任务成为“拖后腿”任 务,甚至导致运行失败。为了解决该问题,在数据引擎层面,Tez可根据每个任务的处理数据量调整占用的资源,对于那些处理数据量大的任务,可多分配一些资 源。 5. Tez未来发展 在将来,Tez将增加以下几个特性: (1) 任务抢占,即可通过资源抢占的方式,让优先级更高的任务优先运行; (2) 任务执行断点检查,通过对任务执行过程记录断点,可在任务失败时从断点恢复运行,以避免任务重算(这个功能难度很大); (3) ApplicationMaster执行断点检查,这个可借鉴MapReduce ApplicationMaster实现,就目前YARN的架构设计而言,只能做到(ApplicationMaster失败后)已经完成的任务不重新计 算,对于正在运行的任务需重新计算; (4) 应用程序的Container重用,同一个应用程序的多个任务可重用一个Container中,该功能是一个非常重要的feature,很多YARN上框架都在做! (5) 不同应用程序的Container重用,即不同应用程序的多个任务可重用一个Container,这个功能难度较大! 本文转自二郎三郎博客园博客,原文链接:http://www.cnblogs.com/haore147/p/5105262.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

apache开源项目 -- tajo

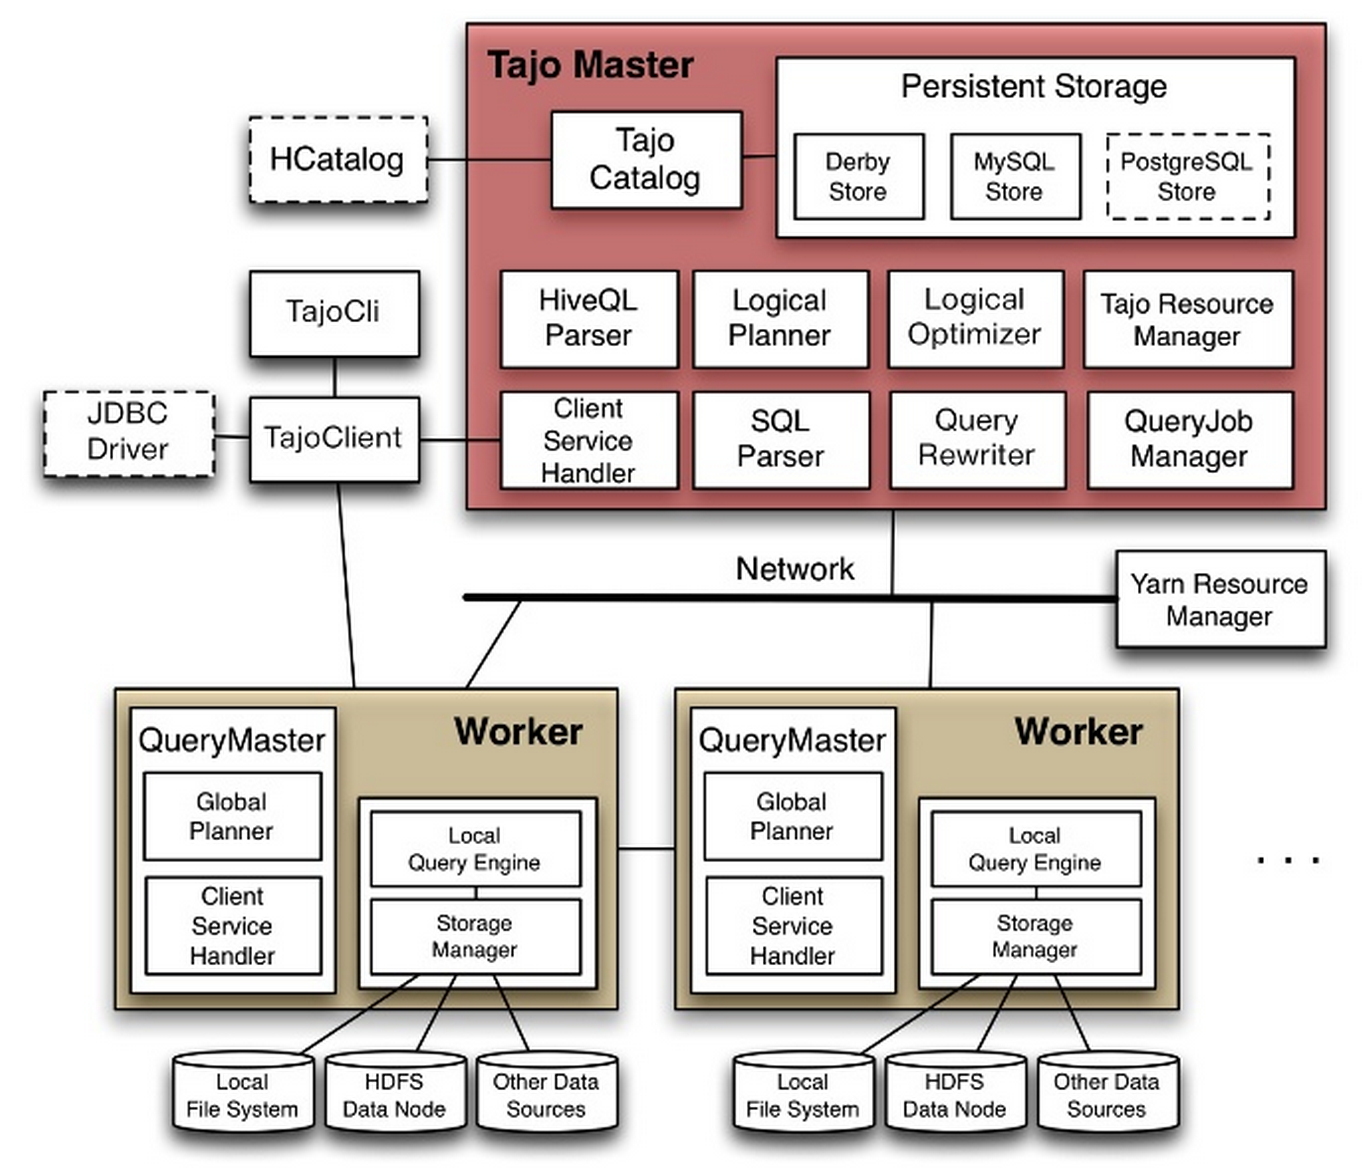
一、体系架构 Tajo采用了Master-Worker架构(下图虚线框目前还在计划中),Master-Worker-Client之间的RPC通信是使用Protocol buffer + Netty来实现的,具体如下: (1)TajoMaster:为客户端提供查询服务和管理各个QueryMaster(也可以说是 Tajo Worker),解析Query并协调QueryMaster,目前还内置了catalog服务器。大致可以分为四个组件:Cluster Manager、Catalog、Global Query Engine以及History Manager。 Catalog的工作是管理诸如tables、schemas、 partitions,functions,indices及statistics等各种metadata。这些元数据信息一般都是Global Query Engine来操作,为了低延迟考虑跟hive一样都是存在RDBMS(目前支持Derby和MySQL),默认是保存在内置的Derby数据库中。后面 可能会考虑使用hive的HCatalog来完成这块功能。 Cluster Manager主要是管理集群中各个节点之间的通信信息及资源(内存/CPU/Disk)信息,每个节点定期发送资源信息,交给Master来管理将用于查询计划的分配等,这一块是依赖Yarn的ResourceManager来管理。 Global Query Engine当一条query提交到master,GQE就会依据表的metadata以及集群资源信息(依赖于Catalog和Cluster Manager两个模块提供的信息)生成一个全局的查询计划。对于一个分布式执行环境,全局的查询计划将会被分片,划分成各个查询单元分配给各个worker去执行,在这些worker执行过程中GQE会监控每一个查询单元的运行状况并实时去优化和容错。在这一块目前的语法解析是用ANTLR 4生成AST(抽象语法树),这个以后可能会使用Tenzing的SQL Query Engine。 History Manager收集各个query job状态信息包括查询语句,划分的查询单元等,通过web ui(默认端口号:26080)可以查询。 (2)QueryMaster:负责一个query的解析、优化与执行,它参与多个task runner worker协同工作,完成一个query的计算。每个Query Master可以生成多个TaskRunner来执行master的查询单元,这些task runner都是由yarn中的NodeManager来管理。 (3)Tajo Worker每个节点就是一个worker角色,每个worker包含存储模块管理和一个Local模式的Query Engine,这个local模式的Query Engine就是来接受master分配的查询单元。每个查询单元包含一个逻辑查询计划和一个分片(输入数据关系的信息块),在执行过程中worker定期向master汇报查询进度和资源信息,master可以很灵活地面对非异常的错误。 图 1 Tajo体系架构 如图1所示,Tajo采用传统数据库技术开发了SQL解析器,包括SQL解析、生成查询计划、优化查询计划、执行查询技术等。但与传统的数据库技术 不同,Tajo最终执行查询技术时借鉴了MapReduce的设计思想,它将查询计划转化为一系列任务,这样,执行查询计划实际上就是执行这些任务,而每 一个任务就是一个计算单位,同时Map Task和Reduce Task一样。 二、查询请求的处理 Tajo定义了一套类SQL的查询语言(Tajo Query Language TQL),支持大多数的DML,如:select, from, where, join, group-by, order-by, union, and cube。TQL支持可以用两种变量来表示Scala value(应该是一种内存对象)和Temporary table, 可以为它们赋值。这种特性,可以让用户很容易地处理复杂查询中间结果是生成Scala value还是临时表。处理流程和Tenzing都差不多,都是先生成查询计划,然后再分到各个worker上去执行,都省去了hive在map之后对生 成的数据进行shuffle和sort的过程,而且对无需写文件的中间结果支持直接放内存中交给下一个流程去处理,这应该就是它性能高出hive的主要优 化吧。 查询计划 将一个查询语句解析成若干个底层的物理执行计划有以下几个步骤,如下图所示。首先是Global Query Engine将语句转化成一个抽象语法树AST(使用Antlr 4实现)并且编译成一个逻辑计划。根据catalog中的信息,查询优化器使用基于cost的算法(贪婪方式)处理join找到一种最优的逻辑计划等同于 原始的查询计划,同时使用基于规则的算法处理其他方式,最终会生成一种优化后的全局查询计划。下一步就是将全局查询计划划分成若干个查询单元提交到 worker上去执行。 图 2查询转化流程图 执行查询 针对执行过程中的输入输出,Tajo提供了一系列的Scanners和Appenders。Scanner负责从HDFS或者本地读取数据,而 Appender将数据写入HDFS或者本地磁盘。当前版本支持csv和基于行的二进制文件格式,系统设计的时候开放了Scanner和Appender 接口,用户可以针对不同的文件格式自定义Scanner和Appender来应对不同的应用场景。 容错 Tajo的容错机制是与MapReduce中的容错类似,将失败的任务分配给其他的worker,也就是说,当master检测到一个查询单元失败了就会将该查询单元分配到其他的worker节点重新执行。与 三、官方实验结果 作者在一次官方的演讲中汇报了tajo-0.8 vs. Impala1.1.1 vs.hive0.10的比较结果。 实验说明 实验数据:TPC-H 数据集 100G 硬件设备:10G network、6 cluster nodes、each machine: Intel Xeon CPU E5 2640 2.5GHZ x 4,64G内存,6 SATA2 磁盘。 实验结果 图 3 tajo vs. impala vs. hive结果对比图 四、目前存在的问题 下面介绍一下目前还存在哪些问题: metric 系统 目前还没有metric系统,系统监控和状态信息还不能很好地收集 异常处理 对于错误处理机制还不够健全,一个query job挂了之后,中间的工作目录还有job都不能很好地退出。Master不能处理down的worker等等。 文档不健全 Java Api、系统使用文档、支持的SQL示例、代码压根就没有什么注释,也没有什么trouble shotting之类的,不过在jira上还是能及时得到回复的。 活跃度 目前社区活跃度太低,发展状况还是不错的,一直再更新,不断会有其他业余的加入。前景个人感觉还是良好的,是死是活还要看Tajo的造化了。 五、发展规划 根据官方文档和jira上总结了一下Tajo几个核心模块未来的发展规划(部分属于个人的一点点看法): 主目录服务 目前是tajo自开发的catalog管理服务器,分为catalog client和catalog server两个模块。目前支持Derby和MySQL数据存储,后续会支持对PostgresQL的支持。开发计划中会将Hive的HCatalog集 成进来,来做Tajo的数据表和存储管理服务。 数据存储 Tajo目前是以hdfs作为主要存储模块,对于一个数据仓库系统来说,应该支持各种各样的存储数据源,下一个开发计划会支持HBase和其他的数据源。 查询引擎 Tajo自己开发的SQL执行引擎包括SQL解析成抽象语法树(AntLR 4)、生成执行计划、执行计划的优化器、代价评估等模块。目前支持绝大部分的SQL92的操作,以后会考虑Tenzing的实现方案,支持更多的数据源。 表partition 目前的版本没有对表做partition,后续会参照hive的方式对表进行分区分表。 本文转自二郎三郎博客园博客,原文链接:http://www.cnblogs.com/haore147/p/5105252.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

iOS - Frame 项目架构

前言 iOS 常见的几种架构: 标签式 Tab Menu 列表式 List Menu 抽屉式 Drawer 瀑布式 Waterfall 跳板式 Springborad 陈列馆式 Gallery 旋转木马式 Carousel 点聚式 Plus 1、标签式 优点: 1、清楚当前所在的入口位置 2、轻松在各入口间频繁跳转且不会迷失方向 3、直接展现最重要入口的内容信息 缺点: 功能入口过多时,该模式显得笨重不实用 2、列表式 优点: 1、层次展示清晰 2、可展示内容较长的标题 3、可展示标题的次级内容 缺点: 1、同级内容过多时,用户浏览容易产生疲劳 2、排版灵活性不是很高 3、只能通过排列顺序、颜色来区分各入口重要程度 3、抽屉式 优点: 1、兼容多种模式 2、扩展性好 缺点: 1、隐藏框架中其他入口 2、对入口交互的功能可见性(affordance)要求高 3.1 抽屉式架构简单实现 ViewController.m #import "ViewController.h" #import "QCMainViewController.h" #import "QCDrawerViewController.h" // 设定抽屉视图的宽度 #define DRAWER_VC_WIDTH ((self.view.bounds.size.width * 3) / 4) @interface ViewController () @property (nonatomic, strong) QCMainViewController *mainVC; @property (nonatomic, strong) UINavigationController *mainNVC; @property (nonatomic, strong) QCDrawerViewController *drawerVC; @end @implementation ViewController - (void)viewDidLoad { [super viewDidLoad]; // 添加主视图 self.mainVC = [[QCMainViewController alloc] init]; self.mainNVC = [[UINavigationController alloc] initWithRootViewController:self.mainVC]; [self addChildViewController:self.mainNVC]; [self.view addSubview:self.mainNVC.view]; // 添加抽屉视图 self.drawerVC = [[QCDrawerViewController alloc] init]; self.drawerVC.view.frame = CGRectMake(-DRAWER_VC_WIDTH, 0, DRAWER_VC_WIDTH, self.view.bounds.size.height); [self addChildViewController:self.drawerVC]; [self.view addSubview:self.drawerVC.view]; // 抽屉视图显示/隐藏回调 __weak typeof(self) weakSelf = self; self.mainVC.myBlock = ^(BOOL isPush){ CGRect mainNVCFrame = weakSelf.self.mainNVC.view.bounds; CGRect drawerVCFrame = weakSelf.self.drawerVC.view.bounds; mainNVCFrame.origin.x = isPush ? DRAWER_VC_WIDTH : 0; drawerVCFrame.origin.x = isPush ? 0 : -DRAWER_VC_WIDTH; [UIView animateWithDuration:0.5 animations:^{ weakSelf.mainNVC.view.frame = mainNVCFrame; weakSelf.drawerVC.view.frame = drawerVCFrame; }]; }; } @end QCMainViewController.h #import <UIKit/UIKit.h> @interface QCMainViewController : UIViewController @property (nonatomic, copy) void (^myBlock)(BOOL); @end QCMainViewController.m #import "QCMainViewController.h" @interface QCMainViewController () @property (nonatomic, assign, getter = isPush) BOOL push; @end @implementation QCMainViewController - (void)viewDidLoad { [super viewDidLoad]; self.view.backgroundColor = [UIColor yellowColor]; self.navigationItem.leftBarButtonItem = [[UIBarButtonItem alloc] initWithTitle:@"抽屉" style:UIBarButtonItemStylePlain target:self action:@selector(pushDrawer)]; // 功能测试 for (NSUInteger i = 0; i < 5; i++) { UIButton *btn = [[UIButton alloc] init]; [self.view addSubview:btn]; btn.frame = CGRectMake(20, 200 + i * 60, 100, 50); btn.tag = i +1; [btn setTitle:[NSString stringWithFormat:@"按钮 %li", i + 1] forState:UIControlStateNormal]; [btn setTitleColor:[UIColor redColor] forState:UIControlStateNormal]; [btn addTarget:self action:@selector(btnClick:) forControlEvents:UIControlEventTouchUpInside]; } } // 功能测试 - (void)btnClick:(UIButton *)btn { NSLog(@"按钮 %li", btn.tag); } // 抽屉视图显示/隐藏 - (void)pushDrawer { self.push = !self.isPush; if (self.myBlock != nil) { self.myBlock(self.isPush); } } // 触摸手势抽屉视图显示/隐藏 - (void)touchesBegan:(NSSet<UITouch *> *)touches withEvent:(UIEvent *)event { if (self.isPush) { [self pushDrawer]; } } @end QCDrawerViewController.m #import "QCDrawerViewController.h" @interface QCDrawerViewController () @end @implementation QCDrawerViewController - (void)viewDidLoad { [super viewDidLoad]; self.view.backgroundColor = [UIColor blueColor]; // 功能测试 for (NSUInteger i = 0; i < 5; i++) { UIButton *btn = [[UIButton alloc] init]; [self.view addSubview:btn]; btn.frame = CGRectMake(20, 200 + i * 60, 100, 50); btn.tag = i +1; [btn setTitle:[NSString stringWithFormat:@"功能 %li", i + 1] forState:UIControlStateNormal]; [btn addTarget:self action:@selector(btnClick:) forControlEvents:UIControlEventTouchUpInside]; } } // 功能测试 - (void)btnClick:(UIButton *)btn { NSLog(@"功能 %li", btn.tag); } @end 效果 3.2 抽屉式架构第三方框架实现 第三方框架 GitHub 地址 效果 4、瀑布式 优点: 1、浏览时产生流畅体验 缺点: 1、缺乏对整体内容的体积感,容易发生空间位置迷失 2、浏览一段时间后,容易产生疲劳感 5、跳板式 优点: 1、清晰展现各入口 2、容易记住各入口位置,方便快速找到 缺点: 1、无法在多入口间灵活跳转,不适合多任务操作 2、容易形成更深的路径 3、不能直接展现入口内容 4、不能显示太多入口次级内容 6、陈列馆式 优点: 1、直观展现各项内容 2、方便浏览经常更新的内容 缺点: 1、不适合展现顶层入口框架 2、容易形成界面内容过多,显得杂乱 3、设计效果容易呆板 7、旋转木马式 优点: 1、单页面内容整体性强 2、线性的浏览方式有顺畅感、方向感 缺点: 1、不适合展示过多页面 2、不能跳跃性地查看间隔的页面,只能按顺序查看相邻的页面 3、由于各页面内容结构相似,容易忽略后面的内容 8、点聚式 优点: 1、灵活 2、展示方式有趣 3、使界面更开阔 缺点: 1、隐藏框架中其他入口 2、对入口交互的功能可见性(affordance)要求高

优秀的个人博客,低调大师

开源项目Git地址

 1.陈明、李建勋、邓覃思 fog-aliyun https://git.oschina.net/dengqinsi/fog-aliyun.git 2.吴俊、骆仲军、袁良福 CDN的H5助手工具 https://git.oschina.net/langford/cdn-assistant.git 3.熊亮、王翔、林瑶 基于阿里云的H5 页面生成工具 https://git.oschina.net/chylvina/open5.git.git 4.靳云飞、彭伟 OTS的.NET实现 https://git.oschina.net/ProgP/PnJ.Aliyun.git 5.周双全 oss的fuse模块 http://git.oschina.net/weiweibaba2007/cloudfs 6.迟晓强 jenkins的oss模块 https://git.oschina.net/chixq/aliyun-oss-plugin 7.唐微南 flysystem的oss模块 http://git.oschina.net/twn39/flysystem-aliyun-oss 8.郝敬龙 oss的C的sdk http://git.oschina.net/weather/oss_sdk 9.吕洋 一个开源的Java博客,使用了阿里云的oss和opensearch功能 http://git.oschina.net/hhfate/FateCMS 10.卢耀瑛 taobao - 阿里云的php SDK http://git.oschina.net/horseluke/AlibabaSDK 11.张兆原提供ruby语言的sdk http://git.oschina.net/doraemon/aliyun-openapi-ruby-sdk 12.卢耀瑛 一个放在内网的安全监测模块【安全组】 http://git.oschina.net/horseluke/content-guard-microsrv-aliyun 13.孔令河 基于安全API的监测系统【安全组】 https://git.oschina.net/Fvckyou/Ali.git 14.柯帆、张利刚 安全助手APP【安全组】 https://git.oschina.net/darren300/assistant.git

优秀的个人博客,低调大师

集装箱项目

集装箱体本身的特征有三,一是图片中的需要识别的文字比较大;二是需要识别的文字色彩鲜艳;三是文字周围的干扰比较多,所以直接识别,即使是使用finereader这种软件都无法完成。 所以,第一步需要做的就是更换图片区域,强调联通。比如这样的结果 再强化 这个时候即使是识别成这样,都无法ocr,因为 细节太多了。 怎么办?缩放,把字母缩放到和它训练的时候差不多时候的样子。 得到结果,下一步就是自己写这个OCR步骤,这也是可以做到的。 再举一个例子,这种竖直的shib 来自为知笔记(Wiz) 目前方向:图像拼接融合、图像识别 联系方式:jsxyhelu@foxmail.com

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册