首页 文章 精选 留言 我的

精选列表

搜索[后台控制台],共10006篇文章
优秀的个人博客,低调大师

网站前端和后台性能优化2

使用内容分布式网络 (Use a Content Delivery Network) tag:server 用户连接你的网站服务器的速度影响响应的快慢。把你的网站布置在多台分布于不同地域的服务器上,会让用户觉得你的页面加载速度更快。那么我们应该从哪里开始呢? 不要一开始就把重新设计你的网站使其能够适应分布式结构作为实现网站地域分布的第一步。根据你的网站的复杂程度不同,更新网站结构的过程也许会包含诸如同步会话状态、在服务器间复制数据库等一系列复杂的步骤。这样你提高用户访问速度的目的反而会被更新网站架构的工作耽误。 记住,用户80-90%的访问时间被花费在下载页面中的图片、样式表、脚本、Flash这些组件上。这是网站展示的黄金法则。那么与其重新设计网站的结构,不如先实现这些静态组件的分布。这不仅仅可以大幅减少响应时间,而且由于内容分布式网络(content delivery networks)的存在,这将是个很简单的工作。 内容分布式网络(CDN)是一系列分布在不同地域的服务器的集合,能够更有效的给用户发送信息。它会根据一种衡量网域距离的方法,选取为某个用户发送数据的服务器。比如,到达用户最少跳或者最快相应速度的服务器会被选中。 一些大型Internet公司拥有他们自己的CDN,但使用公用的CDN服务提供商更为划算,比如 Akamai Technologies, Mirror Image Internet, 或者Limelight Networks。对于刚起步的公司和个人网站来说,CDN服务的花费也许会偏高。但当你的目标用户越来越多而且趋于国际化,用CDN来降低响应时间就很必要了。在Yahoo!,把静态的内容从自己的网络服务器移到CDN提高了用户20%甚至更多的访问速度。转向CDN会是一个只需要相对简单的代码更新的工作,而且那将会显著的提高你的网站访问速度。

优秀的个人博客,低调大师

网站前端和后台性能优化8

使用外部的JavaScript和CSS (Make JavaScript and CSS External) tag:javascript,css 很多性能规则都是解决怎样处理独立的组件的问题的。但是,考虑这些之前,你应该先考虑一个更基本的问题:JavaScript和CSS应该被放于外部的文件,还是内联在页面里? 在实际应用中使用外部的文件往往产生更快的页面,因为浏览器会缓存JavaScript和CSS文件。而内联在页面里的JavaScript和CSS会在每次请求页面时下载。这会减少所需的HTTP请求数,但增大HTML文档的体积。而另一方面,如果放在外部文件里的JavaScript和CSS被浏览器缓存,则既不用增加HTTP请求的数量,HTML文档的体积也会减少。 关键的问题是,外部的JavaScript和CSS的组件被缓存的频率和HTML文档被请求的次数相关。虽然很难去量化,但可以被用很多指标衡量。如果你的网站的用户在每个会话中浏览了很多网页而且很多页面重用了相同的JavaSctipt和样式表,缓存外部文件是有很大潜在的好处的。 很多网站都符合这样的指标。对于这些网站来说,最好的解决方案是把JavaScript和CSS发布为单独的文件。唯一的例外,对于主页,内联的文件更好一些,例如 Yahoo!'s front page 和 My Yahoo!。主页在每个会话中只有很少浏览(也许只有一次),你会发现内联的 JavaScript和CSS会让终端用户的响应更快。 对于有很多页面浏览量的首页来说,有很多能平衡内联文件所提供的HTTP请求减少的效果与外部文件缓存获得的好处的技巧。一种这样的技巧就是把JavaScript和CSS内联在说夜里,但在页面完成加载时动态下载外部文件。随后的页面会调用浏览器中已经缓存的外部文件。

优秀的个人博客,低调大师

网站前端和后台性能优化7

不使用CSS表达式 (Avoid CSS Expressions) tag:css CSS表达式是一种有力的(同时也很危险的)动态设置CSS属性的方法。从IE5开始支持CSS表达式。比如,使用CSS表达式可以实现背景颜色每小时变换的效果。 background-color: expression_r( (new Date()).getHours()%2 ? "#B8D4FF" : "#F08A00" ); 如上所示,表达式方法采用了 Javascript的表达。CSS属性则被设为Javascript表达式的结果。其它的浏览器会忽略CSS表达式,所以对于设置专属IE的属性以便在不同浏览器间能有一致的体验是有用的。、 而CSS表达式的问题是它比大多数人期望的执行次数更频繁。表达式不仅仅在页面展现和重新设置大小的时候执行,在页面滚动,甚至用户在页面上挪动鼠标时都会执行。给CSS表达式添加一个计数器可以跟踪CSS在什么时候和怎样执行。在页面上移动鼠标可以轻易的产生一万次以上的执行。 使用一次性的表达式是减少CSS表达式的执行次数的一个方法,当表达式第一次执行时,CSS表达式会被一个确定的值代替。如果在页面生命周期中,样式属性必须动态的设定,使用事件处理替代CSS表达式是一个可选的方法。如果必须使用CSS表达式,要记得它们会执行上千次并影响页面的性能。

优秀的个人博客,低调大师

网站前端和后台性能优化6

把脚本放在最后(Put Scripts at the Bottom) tag:javascript 脚本可能会堵塞并发的下载。HTTP/1.1规范建议浏览器在每个域名下只进行两个并发下载。如果你把图片放在多个域名下,可以实现多于两个的并发下载。当脚本被下载时,即使使用不同的域名。浏览器也不会进行任何其它的下载。 有些情况下把脚本放到底部并不太容易。比如,脚本使用了document.write 来添加部分页面中的内容,就不能放到页面中更后面的位置。还可能有作用域的问题。很多情况下,还有一些变通的方法。 通常的建议是使用延迟脚本。DEFER属性表明脚本不包含document.write,而且提示浏览器继续展现。不幸的是,Firefox不支持DEFER属性。IE中,脚本可以被延迟,但并不如你期望的那么久。如果一个脚本可以被延迟,那么它也可以被放在页面的底部。这会让你的页面加载的更快。

优秀的个人博客,低调大师

网站前端和后台性能优化10

缩小JavaScript和CSS (Minify JavaScript and CSS) tag:javascript,css 缩小是指从代码中删除不必要的字母,减少文件体积从而提高加载速度。缩减代码时需要移除所有的注释,以及不需要的空白(空格,新行和tab)。这样处理JavaScript之后,会由于下载文件的体积被减少而提高响应的性能。两个常用的缩减JavaScript代码的工具是JSMin 和YUI Compressor。YUI compressor也可以压缩CSS。 代码混淆是另一个可用于源代码的优化方案。它比压缩更为复杂,而且在混淆的过程中更容易产生 Bug。纵观U.S.的前十大网站,压缩获得了21%的体积减小而代码混淆达到了25%。虽然代码混淆的压缩程度更高,但压缩JavaScript的风险更小。 不仅仅要压缩外部的脚本和样式表,内敛的

优秀的个人博客,低调大师

java后台创建url连接,获取接口数据

版权声明:本文为博主原创文章,如需转载,请标明出处。 https://blog.csdn.net/alan_liuyue/article/details/78982905 简介 1. 在实践中,当项目不断进行新功能开发的时候,我们就不可能将所有的方法、功能点全部都写在同一个项目里面,这样也不符合脱耦的趋势; 2. 那么,在项目中,我们既要增加新的功能点,又要最大限度地降低耦合度,我们就要不断地对接口进行深入发掘; 3. 像阿里的分布式服务框架dubbo,也是一种基于接口开发的服务框架,它不仅能松耦合,而且功能点都是通过不断增加接口来不断增加; 4. 本篇博客不讲述接口如何开发,而是简单地介绍,如何通过java创建url连接,获取接口返回来的json数据; 项目实践 /** * 获取接口数据,返回json格式字符串,方法1 * @param url 接口路径 * @param params 传递参数,自定义 * @param key 传递参数标识,自定义 * @return */ public String getData1(String url,String params,String key){ String rs = null; CloseableHttpClient httpClient = HttpClient.createDefault(); try{ //拼接参数,转义参数 String connUrl = url+"?params="+URLEncoder.encode(params,HTTP.UTF-8)+"&key="+key; //创建连接 HttpGet get = new HttpGet(connUrl); //获取以及解析数据 CloseableHttpResponse resp = httpClient.execute(get); rs = EntityUtils.toString(resp.getEntity(),HTTP.UTF-8); }catch(IOException e){ System.out.println("出错了") } return rs; } /** * 获取接口数据,返回json格式字符串,方法2 * @param url 接口路径 * @param params 传递参数,自定义 * @param key 传递参数标识,自定义 * @return */ public String getData2(String url,String params,String key){ HttpURLConnection conn = null; BufferedReader reader = null; String rs = null; try { //拼接参数,转义参数 String connUrl = url+"?params="+URLEncoder.encode(params,HTTP.UTF-8)+"&key="+key; //创建连接 URL url = new URL(connUrl); conn = (HttpURLConnection) url.openConnection(); conn.setUseCaches(false); conn.setConnectTimeout(30000); conn.setReadTimeout(30000); conn.setInstanceFollowRedirects(false); conn.connect(); //获取并解析数据 InputStream is = conn.getInputStream(); reader = new BufferedReader(new InputStreamReader(is, "UTF-8")); StringBuffer sb = new StringBuffer(); String strRead = null; while ((strRead = reader.readLine()) != null) { sb.append(strRead); } rs = sb.toString(); } catch (IOException e) { e.printStackTrace(); } finally { if (reader != null) { reader.close(); } if (conn != null) { conn.disconnect(); } } return rs; } 总结 1. 上面提供了两种方法来创建连接,获取接口数据,可自选比较合适的方法; 2. 返回的rs都是json格式的字符串,可直接使用JSONObject object = JSONObject.fromObject(rs)来转换成json对象,然后进行多层次的解析; 3. 实践是检验认识真理性的唯一标准,试一试就知道好不好用了;

优秀的个人博客,低调大师

后台(40)——MyBatis输出映射resultType以及resultMap

探索Android软键盘的疑难杂症 深入探讨Android异步精髓Handler 详解Android主流框架不可或缺的基石 站在源码的肩膀上全解Scroller工作机制 Android多分辨率适配框架(1)— 核心基础 Android多分辨率适配框架(2)— 原理剖析 Android多分辨率适配框架(3)— 使用指南 自定义View系列教程00–推翻自己和过往,重学自定义View 自定义View系列教程01–常用工具介绍 自定义View系列教程02–onMeasure源码详尽分析 自定义View系列教程03–onLayout源码详尽分析 自定义View系列教程04–Draw源码分析及其实践 自定义View系列教程05–示例分析 自定义View系列教程06–详解View的Touch事件处理 自定义View系列教程07–详解ViewGroup分发Touch事件 自定义View系列教程08–滑动冲突的产生及其处理 版权声明 本文原创作者:谷哥的小弟 作者博客地址:http://blog.csdn.net/lfdfhl 我们知道:MyBatis通过resultType对sql的输出参数进行定义,参数的类型可以是:基本类型、HashMap、pojo。在此分别介绍为resultType传入三种类型的不同处理方式。 基本类型 在此,请看一个小例子:统计学生的女同学 先看mapper.xml <select id="countStudent" parameterType="String" resultType='int'> SELECT count(*) from student where gender=#{value} </select> 此处,resultType的类型是int 再来看mapper.java public int countStudent(String string); 最后来看一下测试代码: @Test public void countStudent() throws IOException { SqlSession sqlSession = sqlSessionFactory.openSession(); StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); int count = studentMapper.countStudent("female"); System.out.println("count="+count); sqlSession.commit(); sqlSession.close(); } HashMap 把resultType的类型指定为hashmap时在执行完sql之后MyBatis将输出的字段名称作为map的key,value为字段值。现在,我们在上个例子的基础上稍加改造。 先看mapper.xml <select id="countStudentByHashMap" parameterType="String" resultType='hashmap'> SELECT count(*) as total from student where gender=#{value} </select> 此处,resultType的类型是hashmap。我们将查询的结果放在total列中 再来看mapper.java public HashMap<String, Object> countStudentByHashMap(String string); 嗯哼,返回的类型是一个HashMap 最后来看一下测试代码: @Test public void countStudentByHashMap() throws IOException { SqlSession sqlSession = sqlSessionFactory.openSession(); StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); HashMap<String, Object> hashMap = studentMapper.countStudentByHashMap("female"); System.out.println("total="+hashMap.get("total")); sqlSession.commit(); sqlSession.close(); } 我们从查询的结果hashmap中取出key为total对应的值 pojo 我们可将resultType指定为pojo,从而查询出对应的结果。比如,我们可以将resultType的类型指定为Student,从而查询出单个Student或者一个List,在此以查询单个Student为例 先来看mapper.xml <select id="selectStudentByID" parameterType="int" resultType="cn.com.Student"> SELECT * from student where id=#{value} </select> 在此指定resultType的类型是Student 再来看mapper.java public Student selectStudentByID(int id); 最后请看测试 @Test public void selectStudentByID() throws IOException { SqlSession sqlSession = sqlSessionFactory.openSession(); StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); Student student = studentMapper.selectStudentByID(13); System.out.println(student); sqlSession.commit(); sqlSession.close(); } 在此请注意: 使用resultType进行输出映射时务必将查询的列名与pojo中的属性名保持一致! 看到这里,或许有人会问了:如果如果查询出来的列名和pojo的属性名不一致又怎么办呢?嗯哼,此时最好就不要再用resultType了,可以考虑使用resultMap,请继续往下看 resultMap 为了便于说明,我们来创建一个新的类_Student /** * 本文作者:谷哥的小弟 * 博客地址:http://blog.csdn.net/lfdfhl */ package cn.com; import java.util.Date; public class _Student { private int _id; private String _name; private String _gender; private Date _birthday; public int get_id() { return _id; } public void set_id(int _id) { this._id = _id; } public String get_name() { return _name; } public void set_name(String _name) { this._name = _name; } public String get_gender() { return _gender; } public void set_gender(String _gender) { this._gender = _gender; } public Date get_birthday() { return _birthday; } public void set_birthday(Date _birthday) { this._birthday = _birthday; } @Override public String toString() { return "_Student [_id=" + _id + ", _name=" + _name + ", _gender=" + _gender + ", _birthday=" + _birthday + "]"; } } 首先在mapper.xml中定义一个resultMap <resultMap type="cn.com._Student" id="studentResultMap"> <id column="id" property="_id" /> <result column="name" property="_name" /> <result column="gender" property="_gender" /> <result column="birthday" property="_birthday" /> </resultMap> <resultMap>标签中的type属性表示pojo,请参见代码第1行 <resultMap>标签中的id属性表示resultMap的名字,请参见代码第1行 <id>标签表示数据库表中的主键与pojo的属性的映射关系;比如,此处,将表中的id字段映射为pojo中的_id,请参见代码第2行 <restult>标签表示数据库表中除了主键以外的其他字段与pojo的属性的映射关系,请参见代码第3-5行 然后请看mapper.xml中的SQL语句 <select id="_selectStudentByID" parameterType="int" resultMap="studentResultMap"> SELECT * from student where id=#{value} </select> 此处利用resultMap指定了返回的类型为我们刚才定义的studentResultMap 再来看mapper.java public Student _selectStudentByID(int id); 最后来瞅瞅测试代码 @Test public void _selectStudentByID() throws IOException { SqlSession sqlSession = sqlSessionFactory.openSession(); StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); _Student _student = studentMapper._selectStudentByID(13); System.out.println(_student); sqlSession.commit(); sqlSession.close(); } 输出结果: _Student [_id=13, _name=大泽玛利亚, _gender=female, _birthday=Thu Mar 16 00:00:00 CST 2017]

优秀的个人博客,低调大师

后台(37)——MyBatis的Mapper开发方式

探索Android软键盘的疑难杂症 深入探讨Android异步精髓Handler 详解Android主流框架不可或缺的基石 站在源码的肩膀上全解Scroller工作机制 Android多分辨率适配框架(1)— 核心基础 Android多分辨率适配框架(2)— 原理剖析 Android多分辨率适配框架(3)— 使用指南 自定义View系列教程00–推翻自己和过往,重学自定义View 自定义View系列教程01–常用工具介绍 自定义View系列教程02–onMeasure源码详尽分析 自定义View系列教程03–onLayout源码详尽分析 自定义View系列教程04–Draw源码分析及其实践 自定义View系列教程05–示例分析 自定义View系列教程06–详解View的Touch事件处理 自定义View系列教程07–详解ViewGroup分发Touch事件 自定义View系列教程08–滑动冲突的产生及其处理 版权声明 本文原创作者:谷哥的小弟 作者博客地址:http://blog.csdn.net/lfdfhl 使用Mybatis开发Dao,通常有两个方法:原始Dao开发方式和Mapper接口开发方式。 在本篇文章中,我们在前两篇博客的基础上来一起完成Mapper接口开发方式。 开发规范 Mapper接口开发方式比原始的DAO的方式要简便许多,但是这种简便是建立在规范之上的,所以在采用该方式时务必严格遵守开发规范. 在Mapper接口开发方式中有两个核心的东西:mapper.xml和mapper.java mapper接口开发需要遵循以下规范: 1、mapper.xml文件中的namespace与mapper.java接口的类的全路径相同。 2、mapper.java接口中的方法名和mapper.xml中定义的每个sql的id相同 3、mapper.java接口中的方法的输入参数类型和mapper.xml中定义的每个sql的parameterType的类型保持一致 4、mapper.java接口中方法的输出参数类型和mapper.xml中定义的每个sql的resultType的类型保持一致 好了,我们现在就按照此规范来改造之前的例子 StudentMapper.java /** * 本文作者:谷哥的小弟 * 博客地址:http://blog.csdn.net/lfdfhl */ package cn.com; import java.util.List; public interface StudentMapper { public Student findStudentById(int id); public List<Student> findStudentByName(String name); public void insertStudent(Student student); public void deleteStudent(int id); public void updateStudent(Student student); } StudentMapper.xml <?xml version="1.0" encoding="UTF-8" ?> <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd"> <mapper namespace="cn.com.StudentMapper"> <select id="findStudentById" parameterType="int" resultType="cn.com.Student"> SELECT * FROM student WHERE id=#{value} </select> <select id="findStudentByName" parameterType="java.lang.String" resultType="cn.com.Student"> SELECT * FROM student WHERE name LIKE '%${value}%' </select> <insert id="insertStudent" parameterType="cn.com.Student"> <selectKey keyProperty="id" order="AFTER" resultType="java.lang.Integer"> SELECT LAST_INSERT_ID() </selectKey> INSERT INTO student (name,gender,birthday) value (#{name},#{gender},#{birthday}) </insert> <delete id="deleteStudent" parameterType="java.lang.Integer"> DELETE FROM student where id=#{id} </delete> <update id="updateStudent" parameterType="cn.com.Student"> UPDATE student set name=#{name},gender=#{gender},birthday=#{birthday} where id=#{id} </update> </mapper> 嗯哼,对照着这两个文件看就会发现:我们在书写的过程中严格遵守了开发规范。 TestCRUD.java /** * 本文作者:谷哥的小弟 * 博客地址:http://blog.csdn.net/lfdfhl */ package cn.com; import java.io.IOException; import java.io.InputStream; import java.util.Date; import java.util.List; import org.apache.ibatis.io.Resources; import org.apache.ibatis.session.SqlSession; import org.apache.ibatis.session.SqlSessionFactory; import org.apache.ibatis.session.SqlSessionFactoryBuilder; import org.junit.Before; import org.junit.Test; public class TestCRUD { private SqlSessionFactory sqlSessionFactory; @Before public void intiSqlSessionFactory() throws Exception { String resource = "SqlMapConfig.xml"; InputStream inputStream = Resources.getResourceAsStream(resource); sqlSessionFactory = new SqlSessionFactoryBuilder().build(inputStream); } @Test public void findStudentById() throws IOException{ SqlSession sqlSession=sqlSessionFactory.openSession(); StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); Student student = studentMapper.findStudentById(5); System.out.println(student); } @Test public void findStudentByName() throws IOException { SqlSession sqlSession = sqlSessionFactory.openSession(); StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); List<Student> list = studentMapper.findStudentByName("木"); for (Student student : list) { System.out.println(student); } } @Test public void insertStudent() throws IOException { SqlSession sqlSession = sqlSessionFactory.openSession(); StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); Student student=new Student(); student.setName("小小木希"); student.setGender("female"); student.setBirthday(new Date()); studentMapper.insertStudent(student); sqlSession.commit(); sqlSession.close(); System.out.println(student.getId()); } @Test public void deleteStudent() throws IOException { SqlSession sqlSession = sqlSessionFactory.openSession(); StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); studentMapper.deleteStudent(5); sqlSession.commit(); sqlSession.close(); } @Test public void updateStudent() throws IOException { SqlSession sqlSession = sqlSessionFactory.openSession(); StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); Student student=new Student(); student.setId(5); student.setName("空空姐姐"); student.setGender("female"); student.setBirthday(new Date()); studentMapper.updateStudent(student); sqlSession.commit(); sqlSession.close(); } } 这些测试用例中,最重要的就是: StudentMapper studentMapper = sqlSession.getMapper(StudentMapper.class); 得到Mapper,再调用它定义的增删改查方法 最后,按照惯例还是附上项目的结构图:

优秀的个人博客,低调大师

后台(20)——数据库连接池

探索Android软键盘的疑难杂症 深入探讨Android异步精髓Handler 详解Android主流框架不可或缺的基石 站在源码的肩膀上全解Scroller工作机制 Android多分辨率适配框架(1)— 核心基础 Android多分辨率适配框架(2)— 原理剖析 Android多分辨率适配框架(3)— 使用指南 自定义View系列教程00–推翻自己和过往,重学自定义View 自定义View系列教程01–常用工具介绍 自定义View系列教程02–onMeasure源码详尽分析 自定义View系列教程03–onLayout源码详尽分析 自定义View系列教程04–Draw源码分析及其实践 自定义View系列教程05–示例分析 自定义View系列教程06–详解View的Touch事件处理 自定义View系列教程07–详解ViewGroup分发Touch事件 自定义View系列教程08–滑动冲突的产生及其处理 版权声明 本文原创作者:谷哥的小弟 作者博客地址:http://blog.csdn.net/lfdfhl 数据库连接池简介 在前面的文章中我们已经介绍了Web开发和数据库。现在来想这么一个问题:在同一时间段有大量用户访问我们的服务端,那么此时的服务器数据库它忙得过来么?诚然,它是需要一个好帮手的——数据库连接池 数据库连接池负责分配、管理和释放数据库连接。它允许程序重复使用一个现有的数据库连接,而不是再重新建立一个。数据库连接池可自动释放闲置时间超过最大空闲时间的数据库连接从而避免因为没有释放数据库连接而引起的数据库连接遗漏。这些技术均能明显提高数据库操作性能。目前,常见的数据库连接池有DBCP、C3P0等,现分别介绍他们。 DBCP DBCP(DataBase Connection Pool)由Apache研发,而且Tomcat的连接池也正是采用DBCP实现的,该数据库连接池既可与应用服务器整合使用,也可由应用程序独立使用。 在此,以完整示例介绍DBCP的使用 第一步:添加jar包 commons-dbcp.jar commons-pool.jar mysql-connector-java-5.0.8-bin.jar 第二步:编写DBCP的配置文件dbcpconfig.properties #<!-- 连接设置 --> driverClassName=com.mysql.jdbc.Driver url=jdbc:mysql://localhost:3306/db1 username=root password=root #<!-- 初始化连接 --> initialSize=10 #<!-- 最大连接数量 --> maxActive=50 #<!-- 最大空闲连接 --> maxIdle=20 #<!-- 最小空闲连接 --> minIdle=5 #<!-- 超时等待时间(单位毫秒) --> maxWait=50000 #<!-- 编码方式 --> connectionProperties=useUnicode=true;characterEncoding=utf8 ##<!-- 指定由连接池所创建的连接自动提交 --> defaultAutoCommit=true #<!-- 指定由连接池所创建的连接的事务级别 --> defaultTransactionIsolation=REPEATABLE_READ 第三步:编写操作DBCP的工具类DBCPUtil /** * 本文作者:谷哥的小弟 * 博客地址:http://blog.csdn.net/lfdfhl */ package cn.com; import java.sql.Connection; import java.sql.ResultSet; import java.sql.SQLException; import java.sql.Statement; import java.util.Properties; import javax.sql.DataSource; import org.apache.commons.dbcp.BasicDataSourceFactory; public class DBCPUtil { private static DataSource dataSource = null; //创建数据库连接池 static{ Properties properties = new Properties(); try { ClassLoader classLoader=DBCPUtil.class.getClassLoader(); properties.load(classLoader.getResourceAsStream("dbcpconfig.properties")); dataSource = BasicDataSourceFactory.createDataSource(properties); } catch (Exception e) { throw new ExceptionInInitializerError("DBCP始化错误,请检查配置文件"); } } //创建连接 public static Connection getConnection(){ try { return dataSource.getConnection(); } catch (SQLException e) { throw new RuntimeException("数据库连接错误"); } } //释放连接 public static void releaseConnection(Connection conn, Statement stmt, ResultSet rs) { if (rs != null) { try { rs.close(); } catch (Exception e) { e.printStackTrace(); } rs = null; } if (stmt != null) { try { stmt.close(); } catch (Exception e) { e.printStackTrace(); } stmt = null; } if (conn != null) { try { conn.close(); } catch (Exception e) { e.printStackTrace(); } conn = null; } } } 第四步:测试DBCP的使用 /** * 本文作者:谷哥的小弟 * 博客地址:http://blog.csdn.net/lfdfhl */ package cn.com; import java.sql.Connection; import java.sql.PreparedStatement; import java.sql.ResultSet; import java.sql.SQLException; import org.junit.Test; public class TestDBCP { @Test public void testDBCP(){ Connection connection = null; PreparedStatement preparedStatement = null; ResultSet resultSet=null; try { connection = DBCPUtil.getConnection(); preparedStatement = connection.prepareStatement("select * from student"); resultSet = preparedStatement.executeQuery(); while (resultSet.next()) { Student student = new Student(); int id = resultSet.getInt("studentid"); String name = resultSet.getString("studentname"); student.setStudentID(id); student.setStudentName(name); System.out.println(student); } } catch (SQLException e) { e.printStackTrace(); }finally{ DBCPUtil.releaseConnection(connection, preparedStatement, resultSet); } } } 运行结果如下图所示: C3P0 C3P0是一个开源的JDBC连接池,目前有Hibernate,Spring等框架也使用该数据库连接池。 在此,以完整示例介绍C3P0的使用 第一步:添加jar包 c3p0-0.9.1.2.jar mysql-connector-java-5.0.8-bin.jar 第二步:编写C3P0的配置文件c3p0-config.xml <?xml version="1.0" encoding="UTF-8"?> <c3p0-config> <default-config> <property name="driverClass">com.mysql.jdbc.Driver</property> <property name="jdbcUrl">jdbc:mysql://localhost:3306/db1</property> <property name="user">root</property> <property name="password">root</property> <property name="initialPoolSize">15</property> <property name="maxIdleTime">40</property> <property name="maxPoolSize">150</property> <property name="minPoolSize">20</property> </default-config> </c3p0-config> 第三步:编写操作C3P0的工具类C3P0Util /** * 本文作者:谷哥的小弟 * 博客地址:http://blog.csdn.net/lfdfhl */ package cn.com; import java.sql.Connection; import java.sql.ResultSet; import java.sql.SQLException; import java.sql.Statement; import javax.sql.DataSource; import com.mchange.v2.c3p0.ComboPooledDataSource; public class C3P0Util { //创建数据库连接池 private static DataSource dataSource = new ComboPooledDataSource(); //创建连接 public static Connection getConnection(){ try { return dataSource.getConnection(); } catch (SQLException e) { throw new RuntimeException("获取数据库连接失败"); } } //释放连接 public static void releaseConnection(Connection conn, Statement stmt, ResultSet rs) { if (rs != null) { try { rs.close(); } catch (Exception e) { e.printStackTrace(); } rs = null; } if (stmt != null) { try { stmt.close(); } catch (Exception e) { e.printStackTrace(); } stmt = null; } if (conn != null) { try { conn.close(); } catch (Exception e) { e.printStackTrace(); } conn = null; } } } 第四步:测试C3P0的使用 /** * 本文作者:谷哥的小弟 * 博客地址:http://blog.csdn.net/lfdfhl */ package cn.com; import java.sql.Connection; import java.sql.PreparedStatement; import java.sql.ResultSet; import java.sql.SQLException; import org.junit.Test; public class TestC3P0 { @Test public void testC3P0(){ Connection connection = null; PreparedStatement preparedStatement = null; ResultSet resultSet=null; try { connection = C3P0Util.getConnection(); preparedStatement = connection.prepareStatement("select * from student"); resultSet = preparedStatement.executeQuery(); while (resultSet.next()) { Student student = new Student(); int id = resultSet.getInt("studentid"); String name = resultSet.getString("studentname"); student.setStudentID(id); student.setStudentName(name); System.out.println(student); } } catch (SQLException e) { e.printStackTrace(); }finally{ C3P0Util.releaseConnection(connection, preparedStatement, resultSet); } } } 运行结果如下图所示:

优秀的个人博客,低调大师

Docker一键部署UpSnap:打造专属的局域网设备唤醒控制台

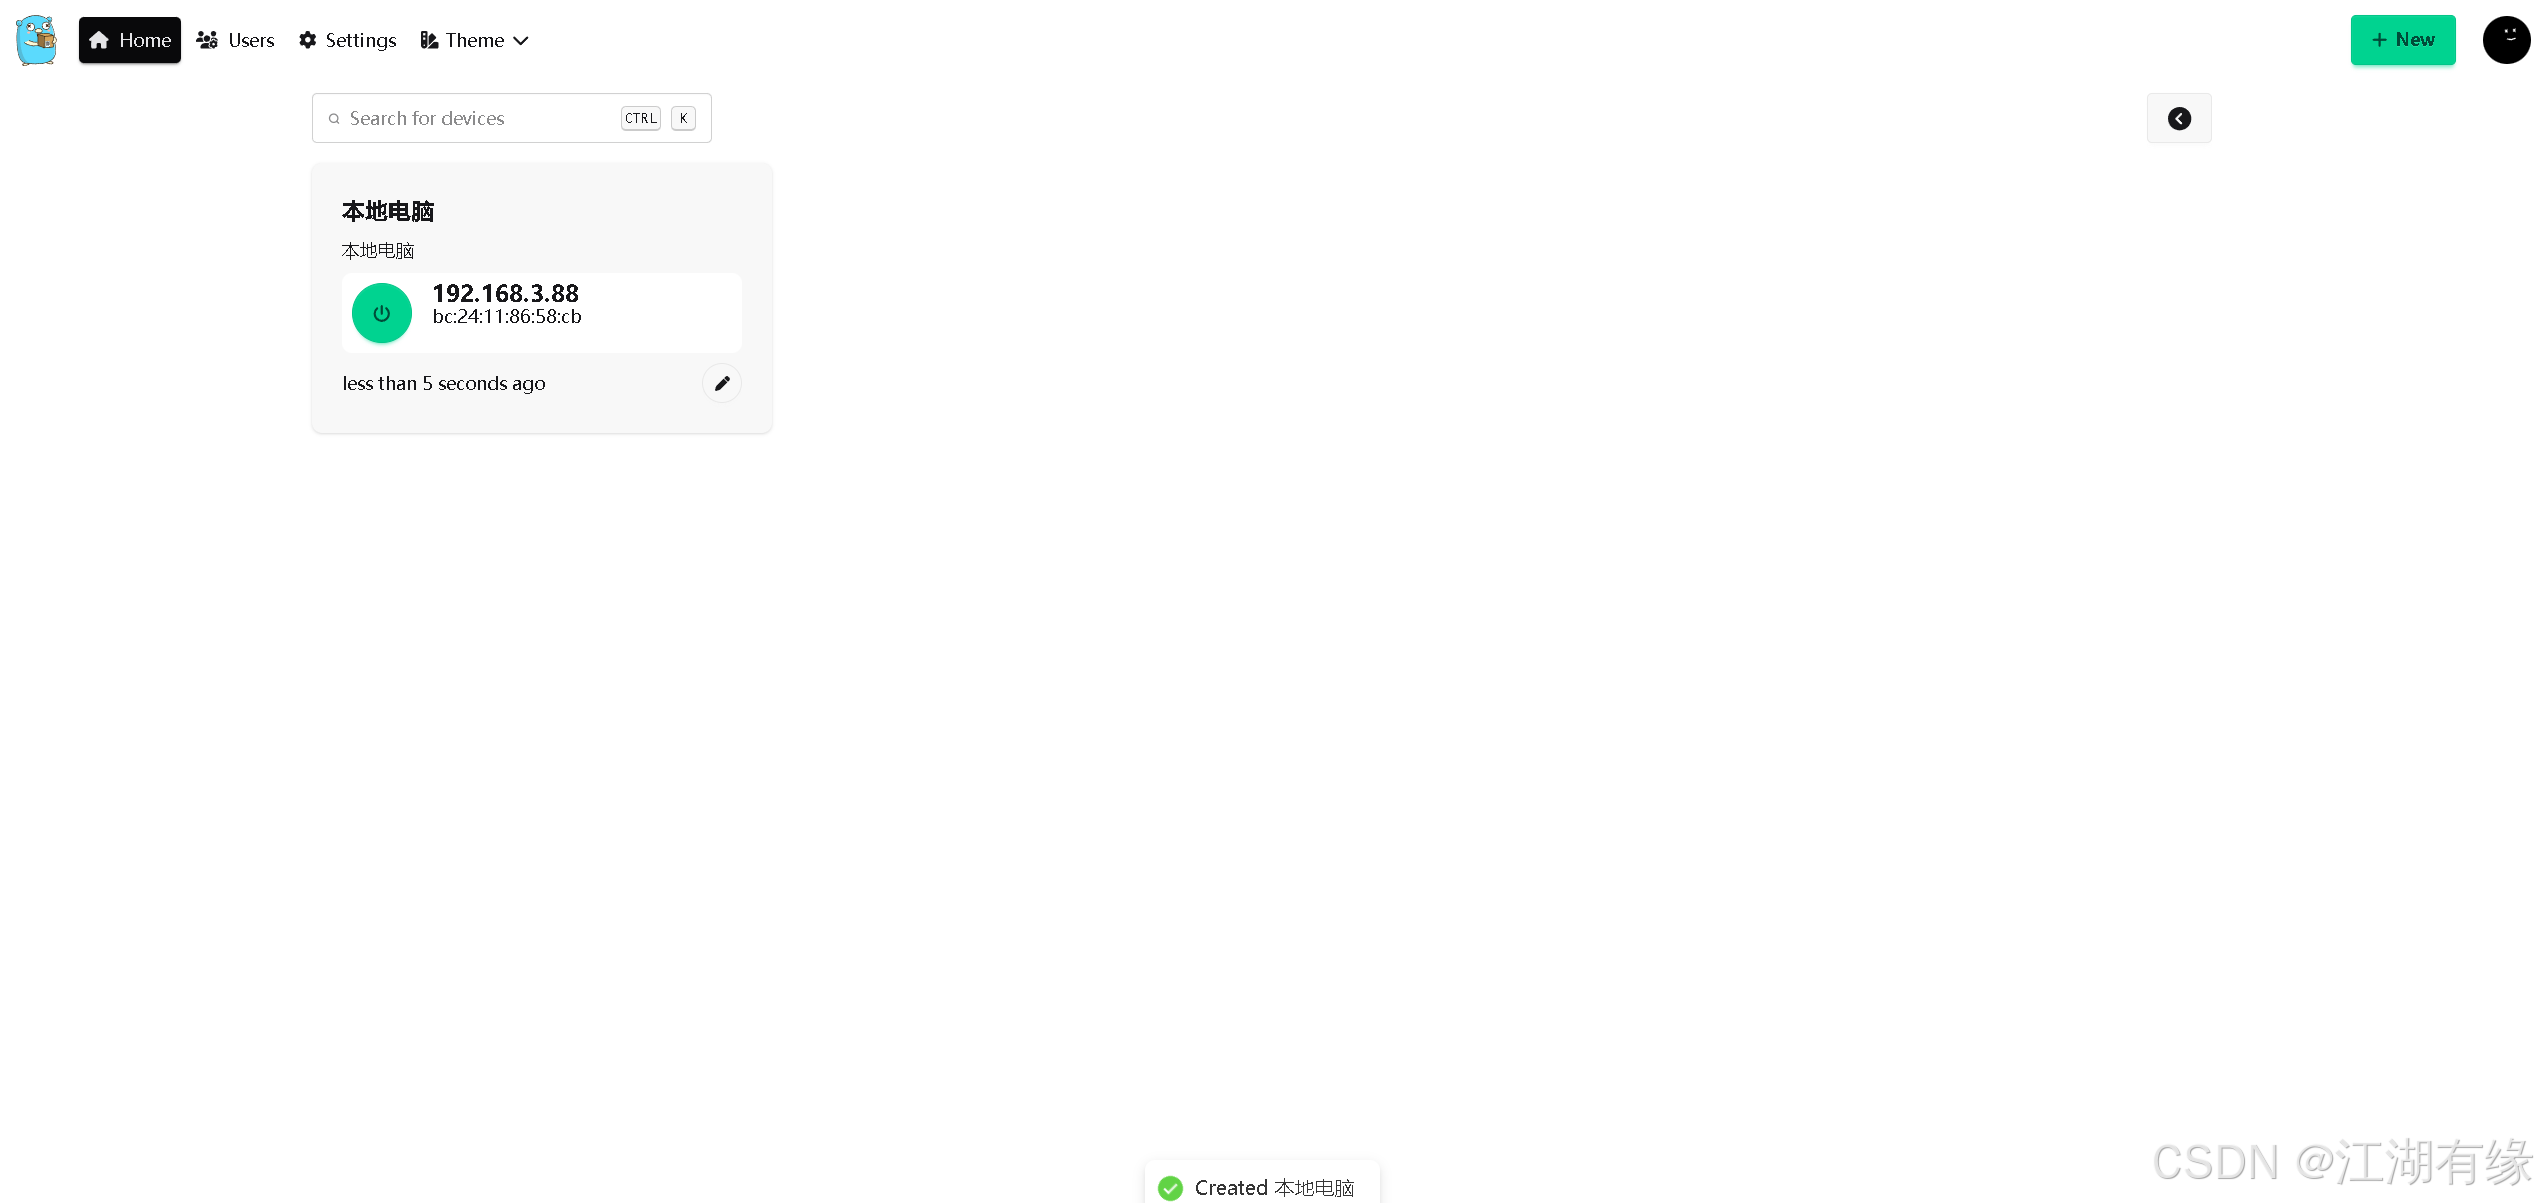
# 一、UpSnap介绍 ## 1.1 UpSnap简介 > `UpSnap`是一款基于 SvelteKit、Go 和 PocketBase 构建的免费开源网络唤醒(Wake-on-LAN)Web 应用,旨在让用户通过直观的界面轻松远程唤醒局域网内的设备。它完全免费、可自托管,并始终以开放源代码的形式提供。 ## 1.2 UpSnap主要特点 - **一键唤醒设备**:通过简洁的仪表盘实现单击唤醒指定设备。 - **定时唤醒任务**:支持通过 Cron 表达式设置自动化唤醒计划。 - **自定义端口 Ping 检测**:可对任意端口执行连通性检测,判断设备状态。 - **网络设备发现**:集成 nmap 实现局域网内设备自动扫描与识别。 - **安全用户管理**:基于 PocketBase 提供多用户认证与权限控制。 - **多语言支持(i18n)**:内置多种语言界面,提升全球用户使用体验。 - **35 种主题样式**:提供丰富的视觉主题,满足个性化外观需求。 - **全平台 Docker 支持**:官方提供 amd64、arm64、arm/v7、arm/v6 架构的 Docker 镜像。 - **完全自托管**:用户可自由部署在私有服务器上,保障数据隐私与控制权。 # 二、本次实践规划 ## 2.1 本地环境规划 > 本次实践为个人测试环境,操作系统版本为 Ubuntu 24.04.2 LTS。 |hostname|IP地址 |操作系统版本 |Docker版本 |部署项目|备注| | --- | --- | --- | --- | --- | --- | |jeven|192.168.3.88 |Ubuntu 24.04.2 LTS|28.5.0 |UpSnap |——| ## 2.2 本次实践介绍 > 1.本次实践部署环境为个人测试环境,生产环境请谨慎; > 2.在Docker环境下部署UpSnap开源局域网唤醒工具。 # 三、本地环境检查 ## 3.1 检查Docker服务状态 > 检查Docker服务是否正常运行,确保Docker正常运行。 ``` root@jeven:~# systemctl status docker ● docker.service - Docker Application Container Engine Loaded: loaded (/usr/lib/systemd/system/docker.service; enabled; preset: enabled) Active: active (running) since Tue 2025-12-02 00:51:31 CST; 1min 11s ago TriggeredBy: ● docker.socket Docs: https://docs.docker.com Main PID: 75393 (dockerd) Tasks: 32 Memory: 34.1M (peak: 34.8M) CPU: 1.248s CGroup: /system.slice/docker.service ``` ![](https://developer.qcloudimg.com/http-save/4995888/abb255efc952dabcb17c36c31c1cd133.png) ## 3.2 检查Docker版本 > 检查Docker版本 ``` root@jeven:~# docker -v Docker version 28.5.0, build 887030f ``` ## 3.3 检查docker compose 版本 > 检查Docker compose版本,确保2.0以上版本。 ``` root@jeven:~# docker compose version Docker Compose version v2.39.4 ``` # 四、拉取UpSnap文件传输工具镜像 > 下载UpSnap镜像,执行以下命令: ``` docker pull ghcr.io/seriousm4x/upsnap:5 ``` ![](https://developer.qcloudimg.com/http-save/4995888/42d29ed56633cef16841ce09a853b16f.png) # 五、部署UpSnap服务 ## 5.1 创建部署目录 - 创建部署目录 ``` mkdir -p /data/upsnap/ && cd /data/upsnap/ ``` ## 5.2 docker compose方式部署 > 新建及编辑docker-compose.yaml文件,由于使用host模式,注意防止宿主机8090端口冲突。 ``` vim docker-compose.yaml ``` ``` services: upsnap: container_name: upsnap image: ghcr.io/seriousm4x/upsnap:5 # images are also available on docker hub: seriousm4x/upsnap:5 network_mode: host restart: unless-stopped volumes: - ./data:/app/pb_data # # To use a non-root user, create the mountpoint first (mkdir data) so that it has the right permission. # user: 1000:1000 # environment: # - TZ=Europe/Berlin # Set container timezone for cron schedules # - UPSNAP_INTERVAL=*/10 * * * * * # Sets the interval in which the devices are pinged # - UPSNAP_SCAN_RANGE=192.168.1.0/24 # Scan range is used for device discovery on local network # - UPSNAP_SCAN_TIMEOUT=500ms # Scan timeout is nmap's --host-timeout value to wait for devices (https://nmap.org/book/man-performance.html) # - UPSNAP_PING_PRIVILEGED=true # Set to false if you don't have root user permissions # - UPSNAP_WEBSITE_TITLE=Custom name # Custom website title # # dns is used for name resolution during network scan # dns: # - 192.18.0.1 # - 192.18.0.2 # # you can change the listen ip:port inside the container like this: # entrypoint: /bin/sh -c "./upsnap serve --http 0.0.0.0:5000" # healthcheck: # test: curl -fs "http://localhost:5000/api/health" || exit 1 # interval: 10s # # or install custom packages for shutdown # entrypoint: /bin/sh -c "apk update && apk add --no-cache && rm -rf /var/cache/apk/* && ./upsnap serve --http 0.0.0.0:8090" ``` ## 5.3 创建UpSnap容器 > 执行以下命令,创建UpSnap容器。 ``` docker compose up -d ``` ![](https://developer.qcloudimg.com/http-save/4995888/501b279761c4adaed7caa4d051a94dd6.png) ## 5.4 查看UpSnap容器状态 > 检查UpSnap容器运行状态,确保UpSnap容器正常启动。 ``` root@jeven:/data/upsnap# docker compose ps NAME IMAGE COMMAND SERVICE CREATED STATUS PORTS upsnap ghcr.io/seriousm4x/upsnap:5 "./upsnap serve --ht…" upsnap 22 seconds ago Up 22 seconds (healthy) ``` ## 5.5 检查UpSnap容器日志 > 检查容器运行日志,确保UpSnap服务正常运行。 ``` root@jeven:/data/upsnap# docker compose logs upsnap | [INFO] 2025/12/22 11:11:49 pb.go:272: Ping interval set to */3 * * * * * upsnap | 2025/12/22 11:11:49 Server started at http://0.0.0.0:8090 upsnap | ├─ REST API: http://0.0.0.0:8090/api/ upsnap | └─ Dashboard: http://0.0.0.0:8090/_/ ``` ![](https://developer.qcloudimg.com/http-save/4995888/580ae0c70e0522792c80e68b8e374d1e.png) # 六、访问UpSnap服务 ## 6.1 访问UpSnap首页 > 浏览器地址: `http://:8090`,访问UpSnap初始页。如果无法访问,请确保宿主机的防火墙已关闭或已放行相关端口,对于云服务器还需配置相应的安全组规则。 ![](https://developer.qcloudimg.com/http-save/4995888/97cad92c4d8ae57fcafed48a30f930a8.png) ## 6.2 创建账户 > 我们点击“Next”下一步,进入账号设置页面。 ![](https://developer.qcloudimg.com/http-save/4995888/9c61ea00d5a32de80395f2e15d3820fa.png) > 自行设置账号密码,确认创建。 ![](https://developer.qcloudimg.com/http-save/4995888/612f0945a11cd32ddfc0926253b6e81f.png) > 点击“Lets go!”,进入UpSnap首页。 ![](https://developer.qcloudimg.com/http-save/4995888/b3e42ea983a377324670d2ccc6309476.png) ![](https://developer.qcloudimg.com/http-save/4995888/af7ce13d095a096afd781fbbd49dba25.png) ## 6.3 添加设备 > 添加设备的IP地址和MAC地址等信息,保存即可。 ![](https://developer.qcloudimg.com/http-save/4995888/34a89ec94dadc3931326160ea985fd37.png) ![](https://developer.qcloudimg.com/http-save/4995888/99d7572d2d79598f6e58be387208e981.png) # 七、总结 > 本次实践成功通过 Docker Compose 在本地环境中部署了 UpSnap 开源局域网唤醒工具,验证了其一键部署与跨平台兼容性。整个流程操作简洁,依赖明确,尤其适合家庭或小型办公网络环境使用。UpSnap 提供的 Web 界面友好、功能丰富,结合定时任务与设备发现能力,极大提升了远程管理设备的便利性。作为完全免费且可自托管的开源项目,UpSnap 是实现 Wake-on-LAN 自动化运维的理想选择。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册