Linux上性能异常定位以及性能监控
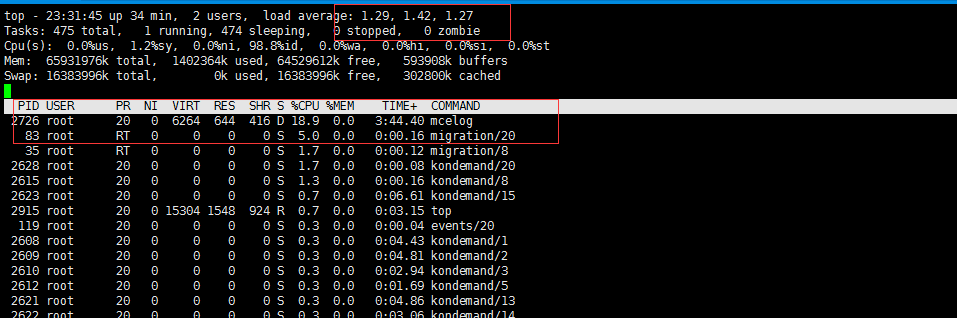
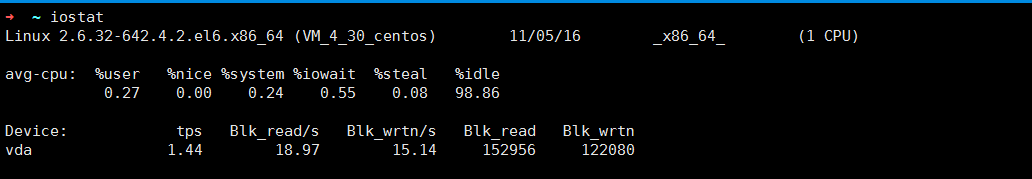
引言:大多数的服务都是跑在Linux上的,Linux现在也已经到了一个很广泛的应用,但是仍然会有很多问题出现,我们就来讨论下我们性能监控的指标,性能监控无非就是从I/O,内存,CPU,TCP连接数,网络,进程或者线程来出发,使用到的命令有iostat,vmstat,sar,mpstat,netstat,ss,iftop,free,pstree/ps,pidstat,top,(uptime)下面来进一步深入下吧. 一,磁盘I/O(iostat) 我们的机器上有很多的数据是存储在磁盘上的,我们读取的很多数据都是要和磁盘交互的,但是磁盘同时又是一个低速设备,很多时候会发生阻塞,所以磁盘I/O的监控很重要。我们使用iostat来诊断磁盘的情况。使用的机器是腾讯云主机。 tps:该设备每秒的传输次数,表示每秒多少个I/O请求 Blk_read/s:每秒从设备读取到的数据量 Blk_wrtn/s:每秒向设备写入的数据量 Blk_read:读取的总数据量 Blk_wrtn:写入的总数据量 %user:代表用户态进程使用CPU的负载 %nice:代表优先级进程使用的CPU负载 %system:代表内核态进程使用的CPU负载 %iowait:代表CPU等待I/O时,CPU的负载 %steal:代表被偷走的CPU负载情况,这个在虚拟化技术中会用到 %idle:代表空闲的所占用的CPU负载情况 iostat还有一个常用的参数选项-x,表示扩展的信息 rrqm/s:每秒这个设备相关的读取请求有多少被Merge(多个I/O合并的操作)了 wrqm/s:每秒这个设备相关的写入请求有多少被Merge了 r/s:每秒发送到设备的读请求数 w/s:每秒发送到设备的写请求数 rsec/s:每秒读取设备扇区的次数 wsec/s:每秒写入设备扇区的次数 avgrq-sz:平均请求扇区的大小 avgqu-sz:平均请求队列的长度 await:每一个I/O请求的处理的平均时间(等待时间) r_await:每一个读I/O请求的处理的平均时间 w_await:每一个写I/O请求的处理的平均时间 svctm:表示平均每次I/O操作的服务时间。如果svctm值和await值很接近,则表示I/O几乎没有等待,如果await的值远高于svctm的值,则表示I/O队列等待太长 %util:在统计的时间内总共有多少的时间用于处理I/O操作,即被消耗的CPU的百分比。例如统计时间间隔是1s,那么这个设备有0.65s在处理I/O,有0.35s处于空闲。那么这个设备的%util=0.65/1=65%,一般地,如果该参数是100%表示设备已经接近满负荷运行了(当然如果是多磁盘,即使%util是100%,因为磁盘的并发能力,所以磁盘使用未必就到了瓶颈) 二,内存(free) 在Linux系统中我们查看内存使用情况。使用free命令来查看 第一行的信息(我们可以认为从操作系统层面看待) total:总物理内存大小 used:已经分配的大小 free:没有被分配的大小 shared:共享内存的大小,主要用于IPC通信 buffers:用于块设备的缓冲 cached:用于文件内容缓冲,也就是缓存 "缓存"就是在内存中划分一块区域,作为进程和硬盘之间的缓冲区,进程将数据写入缓存中,当那些数据需要读取的时候,就直接去"高速路"缓存中读取,而不会去"土路"硬盘中读取,这样大大的加快性能 这里buffer实际上是存储了我们数据的元数据(包括目录名字,文件大小,文件存储块,修改时间,权限等),而cache则存放了我们最近读取过的文件。 第三行信息(我们可以认为从应用程序层面看待) 这里的-/+ buffers/cache分别为 -buffers/cache 和 +buffers/cache 两部分 -buffers/cache = used(第一行)-buffers-cached 实际上是当前程序上"真实使用"的"物理内存" +buffers/cache = buffers+cached 意思就是暂时"借给"系统作为"缓冲区"使用的内存大小 used=(+buffers/cached)+(-buffers/cached) 所以从应用程序层面看,可用内存=free memory+buffers+cached 详细信息我们可以通过下面这种方式查看. ~ cat /proc/meminfo MemTotal: 1020128 kB MemFree: 670772 kB Buffers: 97780 kB Cached: 100980 kB SwapCached: 0 kB Active: 164988 kB Inactive: 117296 kB Active(anon): 83536 kB Inactive(anon): 160 kB Active(file): 81452 kB Inactive(file): 117136 kB Unevictable: 0 kB Mlocked: 0 kB SwapTotal: 0 kB SwapFree: 0 kB Dirty: 92 kB Writeback: 0 kB AnonPages: 83504 kB Mapped: 17500 kB Shmem: 172 kB Slab: 46696 kB SReclaimable: 28652 kB SUnreclaim: 18044 kB KernelStack: 1744 kB PageTables: 2636 kB NFS_Unstable: 0 kB Bounce: 0 kB WritebackTmp: 0 kB CommitLimit: 510064 kB Committed_AS: 343800 kB VmallocTotal: 34359738367 kB VmallocUsed: 7112 kB VmallocChunk: 34359727304 kB HardwareCorrupted: 0 kB AnonHugePages: 36864 kB HugePages_Total: 0 HugePages_Free: 0 HugePages_Rsvd: 0 HugePages_Surp: 0 Hugepagesize: 2048 kB DirectMap4k: 8184 kB DirectMap2M: 1040384 kB 三,CPU(dstat,mpstat) 首先我们使用dstat命令来查看下我们的CPU情况,他能够实时的输出我们的信息, 每2秒输出一次,一共输出10次 cpu:hiq、siq分别为硬中断和软中断次数 system:int、csw分别为系统的中断次数(interrupt)和上下文切换次数(contextswitch)。 -c:表示只显示我们的CPU信息 -m:表示只显示我们的内存信息 -p:表示只显示我们的进程信息 -n:表示只显示我们的网络信息 我们想以什么为什么优先顺序查看,可以在后面加下列参数 mpstat %user 在internal时间段里,用户态的CPU时间(%),不包含nice值为负进程 (usr/total)*100%nice 在internal时间段里,nice值为负进程的CPU时间(%) (nice/total)*100%sys 在internal时间段里,内核时间(%) (system/total)*100%iowait 在internal时间段里,硬盘IO等待时间(%) (iowait/total)*100%irq 在internal时间段里,硬中断时间(%) (irq/total)*100%soft 在internal时间段里,软中断时间(%) (softirq/total)*100%idle 在internal时间段里,CPU除去等待磁盘IO操作外的因为任何原因而空闲的时间闲置时间(%) (idle/total)*100 四,TCP连接数(ss,netstat) ss是Socket Statistics的缩写,顾名思义ss命令就是用来获取sockets的信息,他可以显示和netstat类似的内容,但是他比netstat更快更高效,而且显示更为详细的有关TCP连接信息。当我们的sockets连接数非常大的时候,无论是我们使用netstat命令还是在内核中查看连接数cat /proc/net/tcp的时候都会很缓慢。 ss快速的原因就是他利用了TCP协议中的tcp_diag,tcp_diag是一个用于分析和统计的模块,他可以获取到Linux内核中的第一手信息,这个就确保了ss的高效性。 我们可以对netstat和ss做个对比,有图有真相嘛 netstat命令的时间显然比ss命令的时间慢多了 netstat命令 我们可以看到系统中守护进程的连接状态信息以及监听到的端口号 -t:表示TCP的连接 -u:表示UDP的连接 -n:表示以数字的形式显示信息 -p:表示显示监听的端口号 查看系统中守护进程的监听状态 我们可以看到State状态显示 ss命令 查看当前服务器的网络连接统计: ss -s 其他ss的用法和netstat用法相同 五,网络(iftop) 使用iftop -i eth0 使用Ctrl+c退出,退出显示 我们可以使用-i参数监听不同的网卡流量信息,在iftop的哪个界面我们可以使用按p来查看端口流量信息 六,进程信息(ps/pstree,top,pidstat) 我们使用pstree来查看下我们的进程树,所有的进程都是init进程的子进程 ps命令 查看具体的进程,比如MySQL进程我们可以使用ps aux mysqld或者ps -elf mysqld这种方式,这两种本质上没有什么区别,因为Linux继承的是Unix的一些思想,一个是Unix的Sys-v风格,一个是BSD的风格 我们可以详细的看到他的信息 pidstat命令 我们可以使用pidstat来查看每一个进程的pid的状态信息,以及他所占的CPU信息 六,综合显示(vmstat,top,sar) 我们看到内存,交换分区,I/O,CPU,以及进程上下文切换次数 top命令 在这个界面下: 按m按照内存使用大小排序显示 按P按照CPU使用大小排序显示 按M按照常驻留内存大小排序 按k表示杀死某个进程 sar命令 有时候我们可能需要统计下我们的Linux启动了多长时间,我们可以使用uptime命令来显示这个信息,top也可以显示 uptime命令 top命令显示