企业用Agent的三大死穴,YC这个开源项目全堵上了
A 项目的 Agent 把 B 项目的数据库表删了。 不是开玩笑,这是真实发生过的事。因为 Agent 的记忆、凭证、文件系统全都混在一起,它们根本分不清哪个项目该做什么,不该做什么。 更糟的是,你发现被一家模型厂商绑死了。想换模型?可以,但所有 Agent 的配置都要重写。而且,Agent 执行高危命令时没有任何审批和审计,出了事你都不知道是谁干的。 这不是 Agent 不好用,是缺了一个 **企业级底座**。 Y Combinator 最近开源了一个项目叫 **`QM**`(全称 `multiplayer agent harness for work`),`MIT` 协议,就是一套给企业多人协作场景用的 Agent 运行时底座。它不是大模型,而是把多厂商的编码 Agent 统一管起来的调度系统。 今天这篇文章,我就拆一拆它的架构,看看它是怎么解决上面三个致命问题的。 ## 1 **死穴一:上下文和凭证混在一起,像在公共澡堂办公** 先说一个最痛的问题。 我在一家公司做技术顾问时,他们同时用 Agent 跑三个项目:一个做后端重构,一个做前端自动化测试,一个做数据分析。三个 Agent 用同一个环境,结果有一天,做测试的 Agent 把生产环境的某张表 truncate 了。 为什么?因为 Agent 的「记忆」是共享的,它记得自己之前连过数据库,但没记住那只是测试环境。 `QM` 的核心解法是 `Scope` 隔离。 每个 `Scope`(人、频道、项目、组织)都有自己的独立沙箱: - 独立的文件目录 - 独立的记忆和知识库 - 独立的凭证视图(A 项目看不到 B 项目的密钥) - 独立的环境变量和工具链 每个 Agent 都有自己独立的「办公室」,而不是大家挤在公共澡堂里办公。 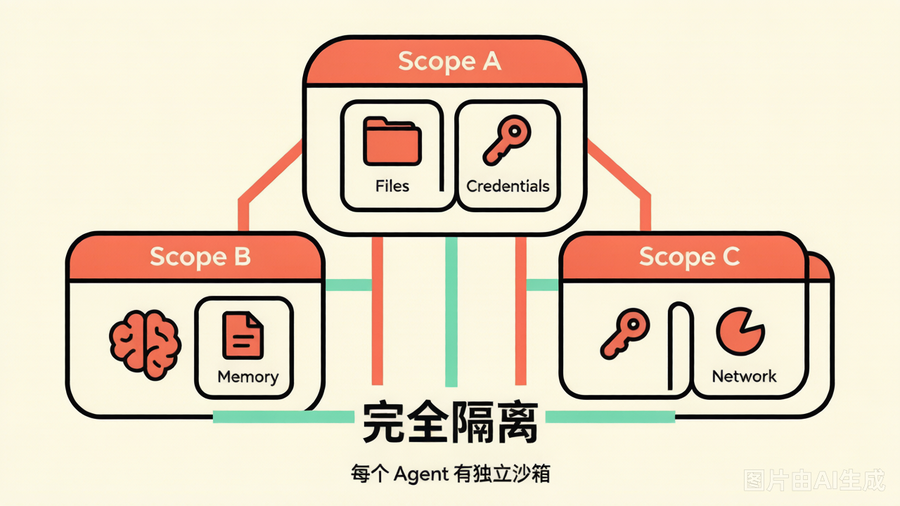 `Scope` 还有层级:个人 < 项目/频道 < 组织。一个 Skill 可以授权给某个 `Scope` 使用,管理员审批后可以全组织开放。这样既保证了隔离,又保留了协作的灵活性。 ## 2 **死穴二:被一家模型厂商绑架,想换都换不了** 第二个问题,我估计不少团队都遇到过。 一开始用 `Claude Code` 跑得挺好,后来发现某些场景 `OpenCode` 更合适。但团队已经深度绑定了 `Claude Code` 的 `API` 和工具链,想换?代码层面改动量太大,项目经理直接否决。 `QM` 的解法是模型厂商抽象层。 它的内核不硬编码任何大模型的 `API`,而是通过一个统一的 `Harness` 驱动接口来适配不同的编码 Agent。目前支持: - `Pi` - `OpenCode` - `Codex` - `Claude Code` 在运行时可以切换,不需要改业务逻辑。组织管理员在后台配置允许的模型列表,用户在 `Web UI` 上选择即可,模型白名单由管理员控制。 一套业务逻辑,兼容所有主流编码 Agent。部署的时候不绑定任何单一厂商,想换就换。 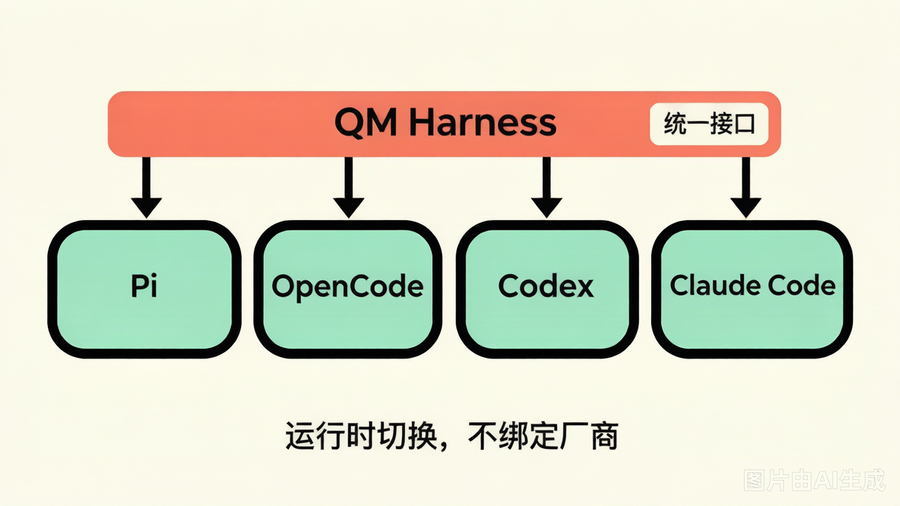 ## 3 **死穴三:Agent 执行高危命令,没人审批没审计** 第三个问题,可能是最被忽视的。 Agent 帮你做事,但做的事不一定都是对的。`rm -rf /`、`DROP TABLE`、`DELETE FROM users` 这些命令,你让 Agent 执行过吗?出了事谁负责? **`QM` 的三层安全管控体系** 1. **`Strict`(严格模式)** 所有工具调用必须人工确认,只有无副作用的收尾动作自动放行 1. **`Auto`(默认模式)** 内置内容分类器自动筛查外部数据和工具返回内容,可以对接自定义代理筛查 1. **`Dangerous`(宽松模式)** 无内容筛查、无人工弹窗,但仍然保留硬编码的高危命令拦截 所有 `Scope` 共享同一个高危命令黑名单(比如递归删除、高危 `SQL` 被永久禁止)。全操作有完整审计日志,所有 Agent 动作可追溯。 说实话,我第一次看到 `Strict` 模式觉得太严格了,但后来想想——如果你的 Agent 要操作生产数据库,你不希望它先问我一句吗? 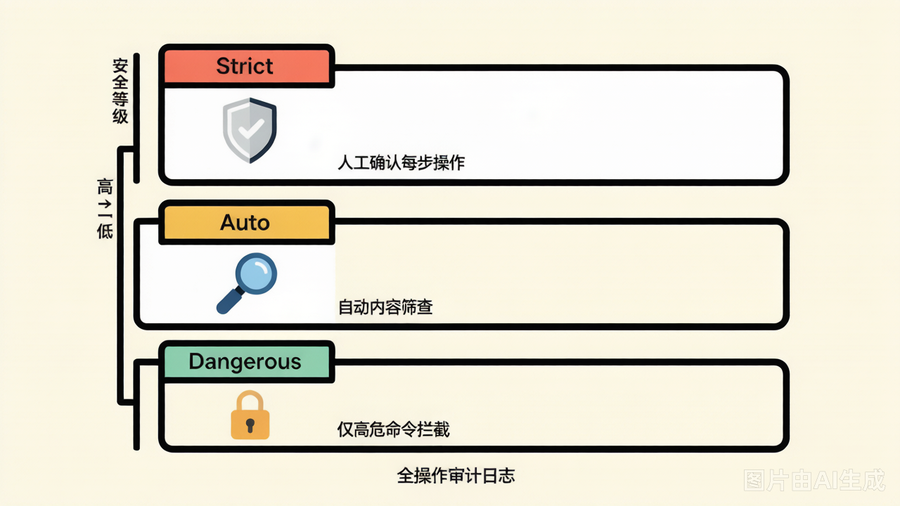 ## 4 **QM 的四层架构,每一层解决一个痛点** 上面三个死穴,`QM` 用四层架构来兜底: **第一层:`Postgres` 持久存储层** 所有状态、会话、记忆、权限配置、审计日志,全部落 `PostgreSQL`。没有缓存中间件,保证多实例一致性。 **第二层:`Headless Core` 通用内核(`TypeScript`/`Node.js`/`Fastify`)** 这是项目的核心,与业务无关。包含 `API` 网关、权限策略、定时调度,以及上面说的 `Agent Loop` 抽象层。内置工具集非常精简,核心工具只有一个 `execute`,用于在沙箱中执行命令。 **第三层:`Per-Scope Sandbox` 作用域专属沙箱** 每个 `Scope` 有独立的持久化沙箱环境,不是临时容器。工具装一次永久留存,文件系统完全隔离。`execute` 命令强制在对应沙箱内运行。 **第四层:前端/协作接入插件层**`Slack` 机器人(`Bolt` 协议)、`Web UI`(`Vite`+`Lit`)、管理后台都是可插拔的插件,全部基于 Core 的 `HTTPAPI` 构建。 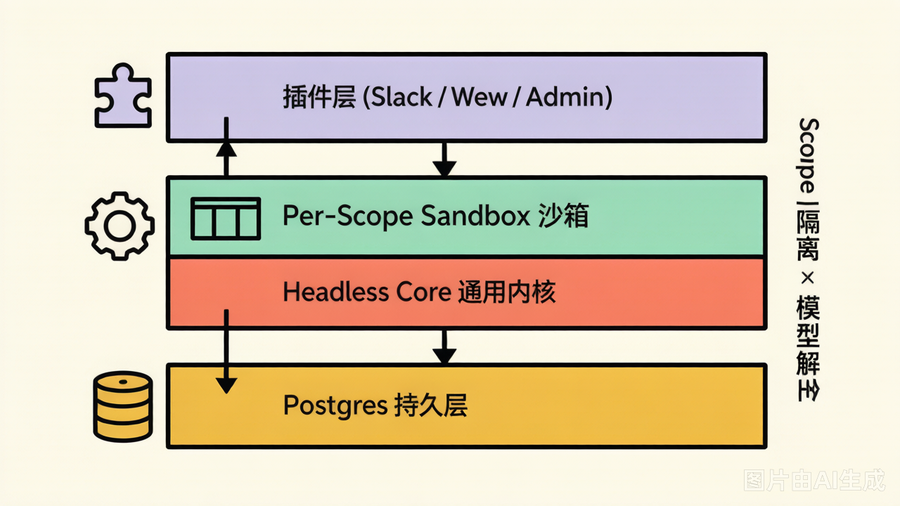 ## 5 **什么场景该用,什么场景慎用** **适合的场景** - 团队里有多个 Agent 并行工作,需要隔离不同项目的上下文和凭证 - 不想被一家模型厂商绑定,希望灵活切换 - 对安全有高要求,需要高危命令审批和全审计(工程、财务、法务等敏感部门) - 希望内核代码和业务配置分离,便于升级维护 **慎用的场景** - 个人开发者单机使用(杀鸡用牛刀) - 需要轻量化部署(强依赖 `Postgres`,没有 SQLite 方案) - 高不可信代码场景(沙箱基于进程/目录隔离,不是内核级容器) - 需要国内 `IM` 集成(目前只原生支持 `Slack` 和 Web,微信/飞书需自己开发插件) ## 6 **总结** 回到开头的问题:企业用 Agent 的三个致命死穴——上下文污染、模型绑定、安全失控——`QM` 都用工程化的方式给出了答案。 它的核心设计思路其实很简单: 1. **`Scope` 隔离** 给每个 Agent 一个独立办公室 1. **模型抽象** 不绑定任何厂商,想换就换 1. **三层安全** 从严格审批到高危拦截,分层保护 1. **内核/业务分离** 升级开源核心不影响业务代码 如果你团队正在用 Agent,或者正准备引入 Agent,我建议你去看看 `QM` 的架构。不一定非要用它,但它的设计思路值得借鉴。 **另外,多说一句**`QM` 和另一个开源项目 `Hermes` 是互补关系。`Hermes` 解决的是模型网关转发和负载均衡,`QM` 解决的是企业级权限、隔离和协作。两者可以组合部署——`QM` 对接 `Hermes` 作为模型底层,把路由和底座分开管。 **你在团队里遇到过 Agent 搞乱环境的经历吗?欢迎留言聊聊。**