首页 文章 精选 留言 我的

精选列表

搜索[fable5],共14篇文章
优秀的个人博客,低调大师

GPT-5.6深夜上线,首发实测,Claude Fable5 慌了

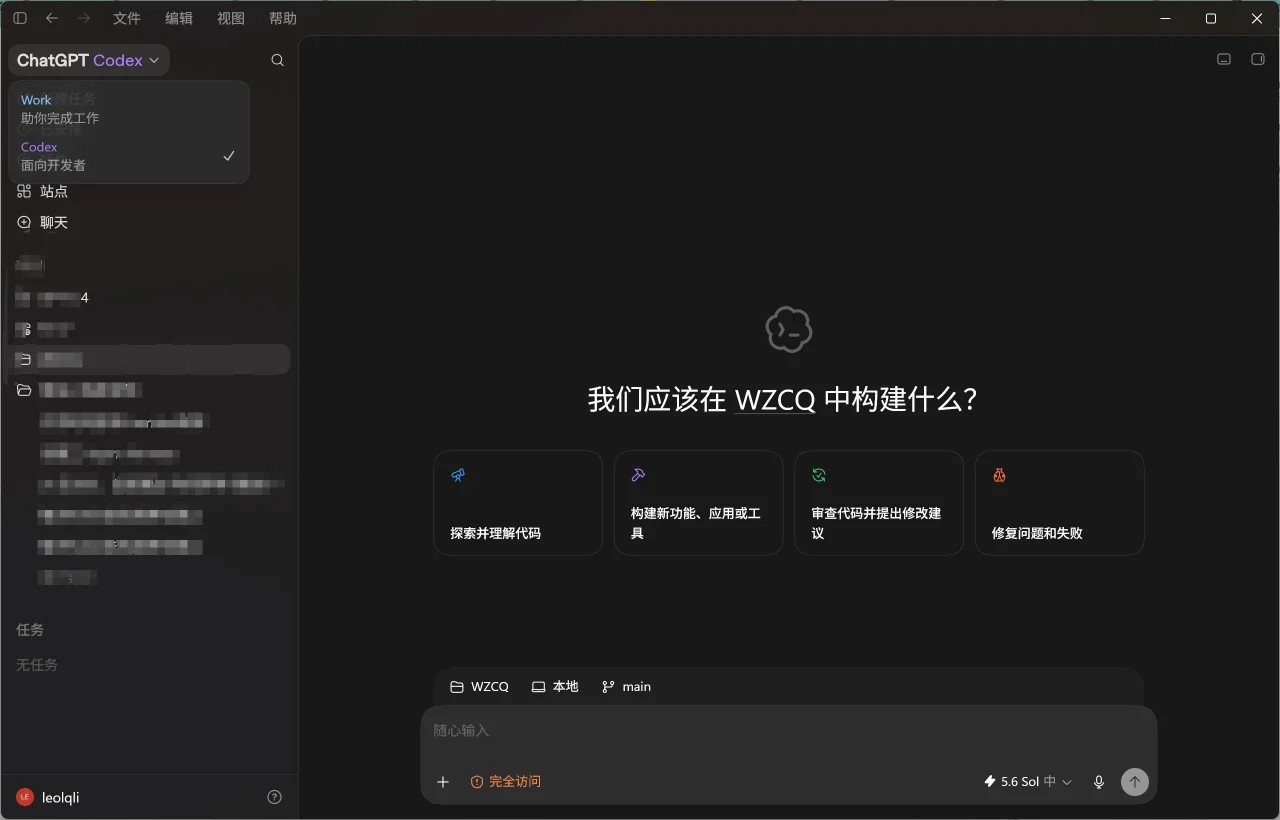
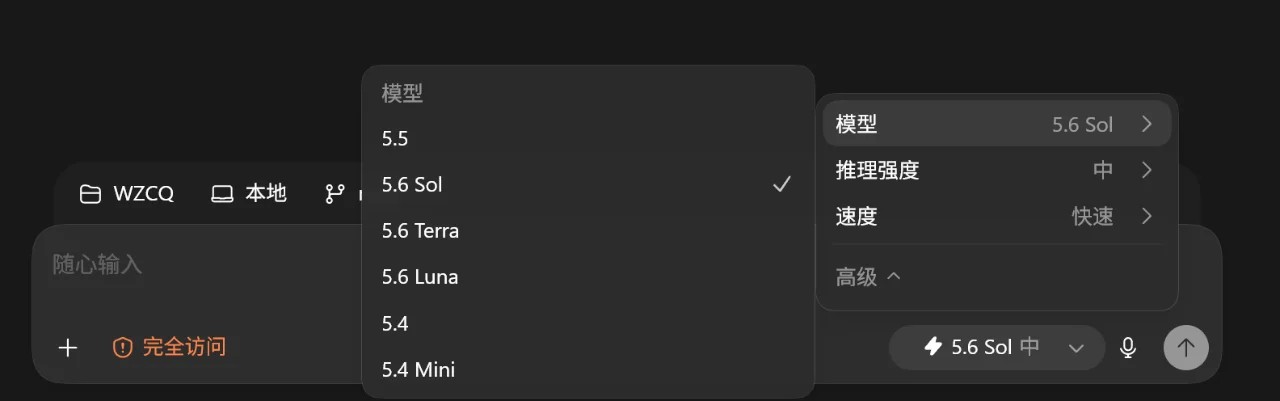
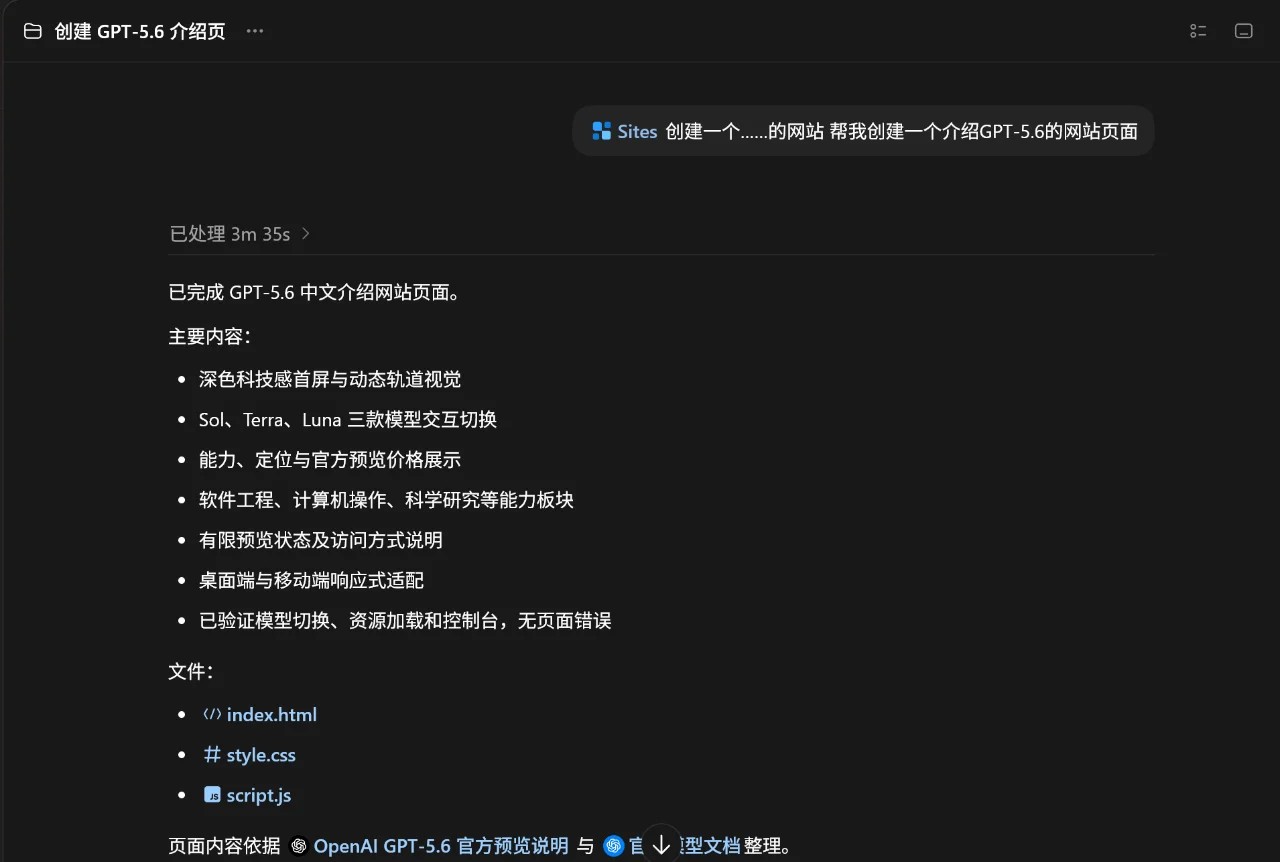
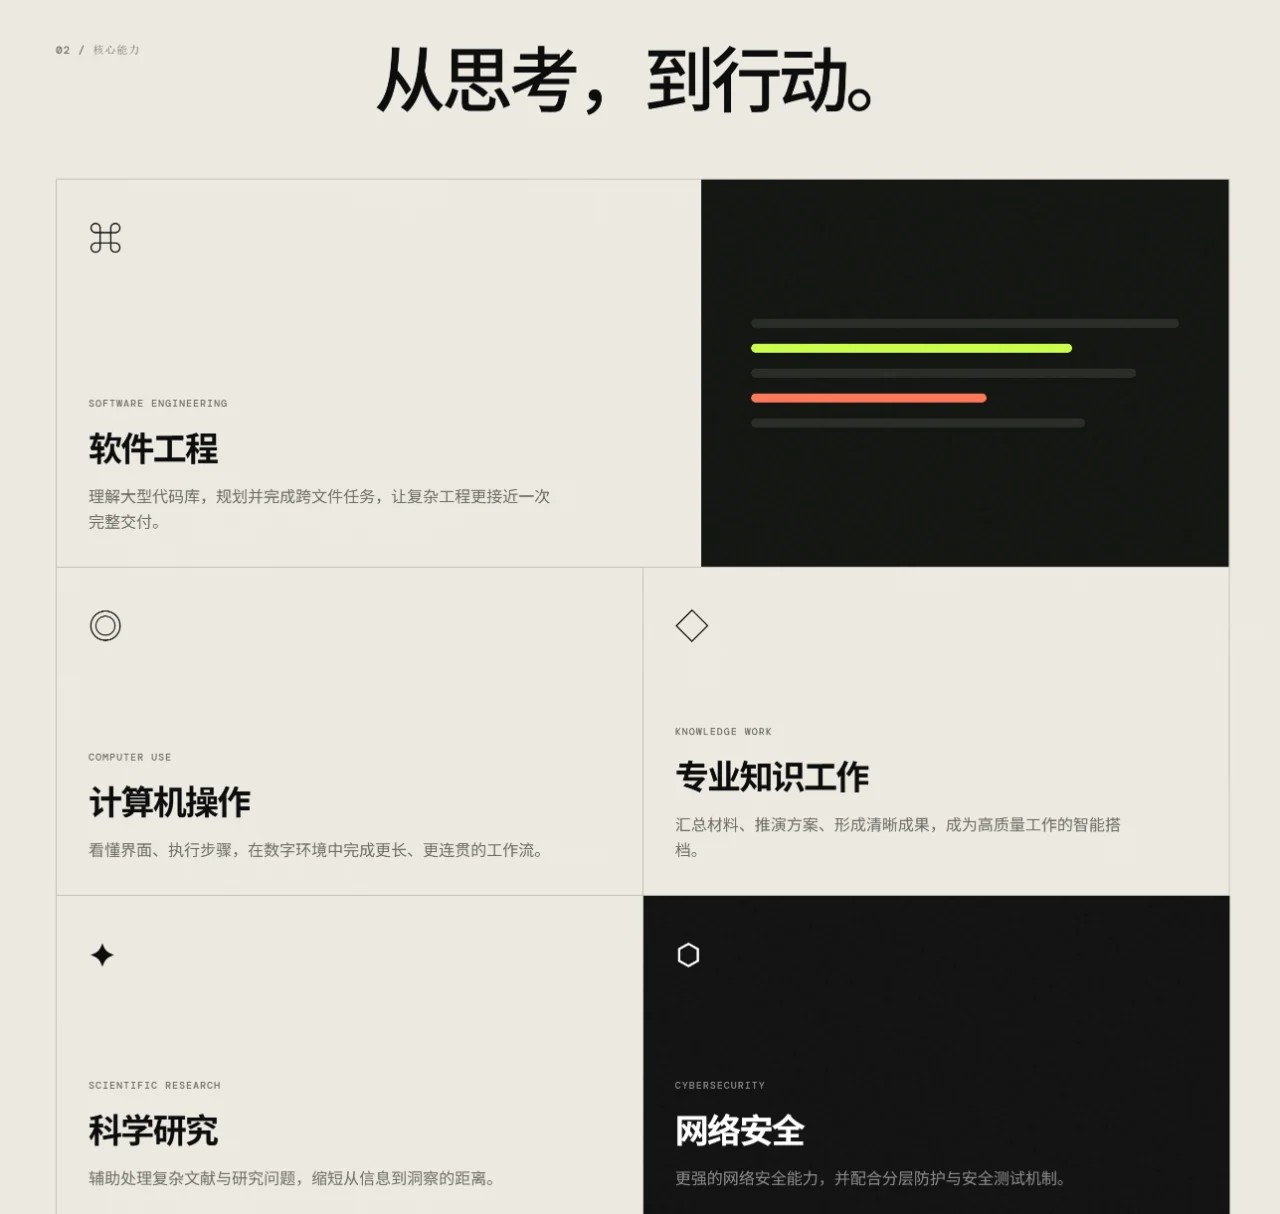
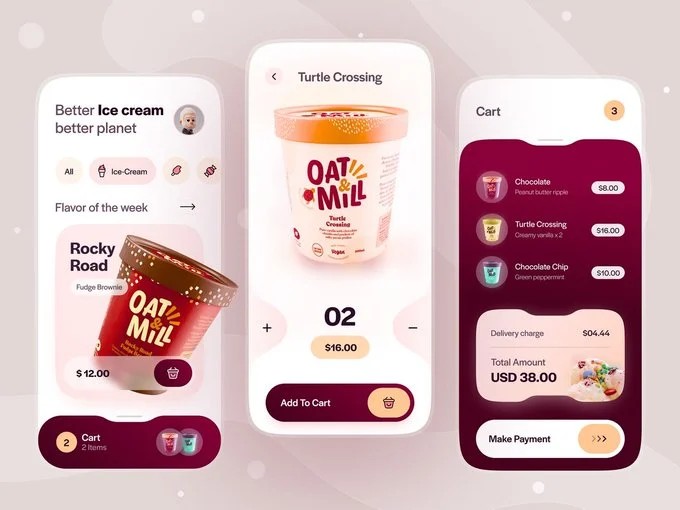
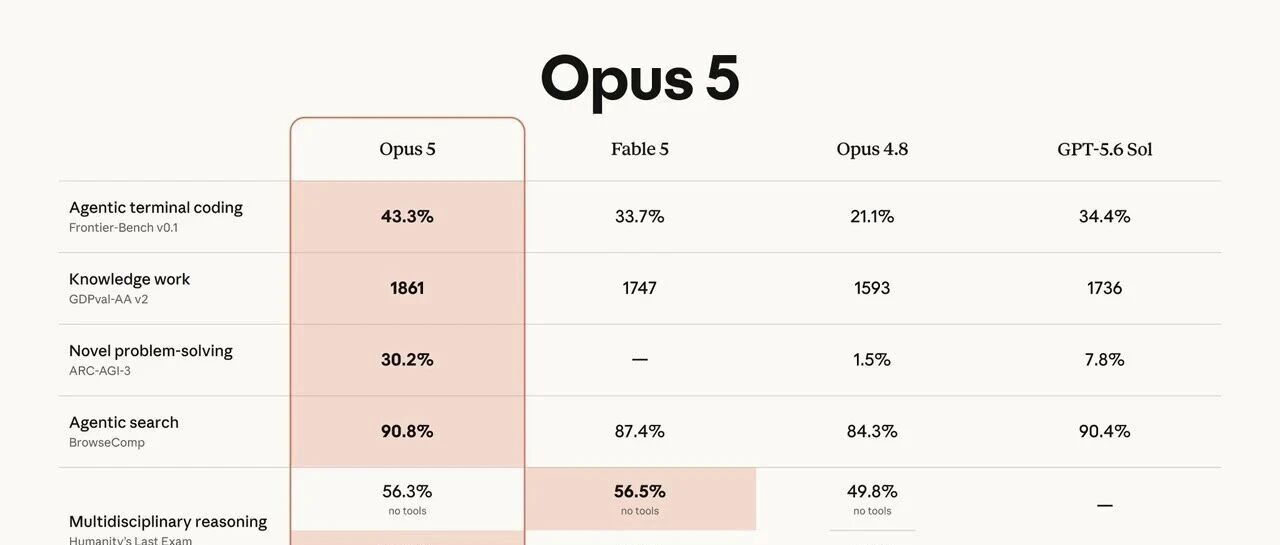
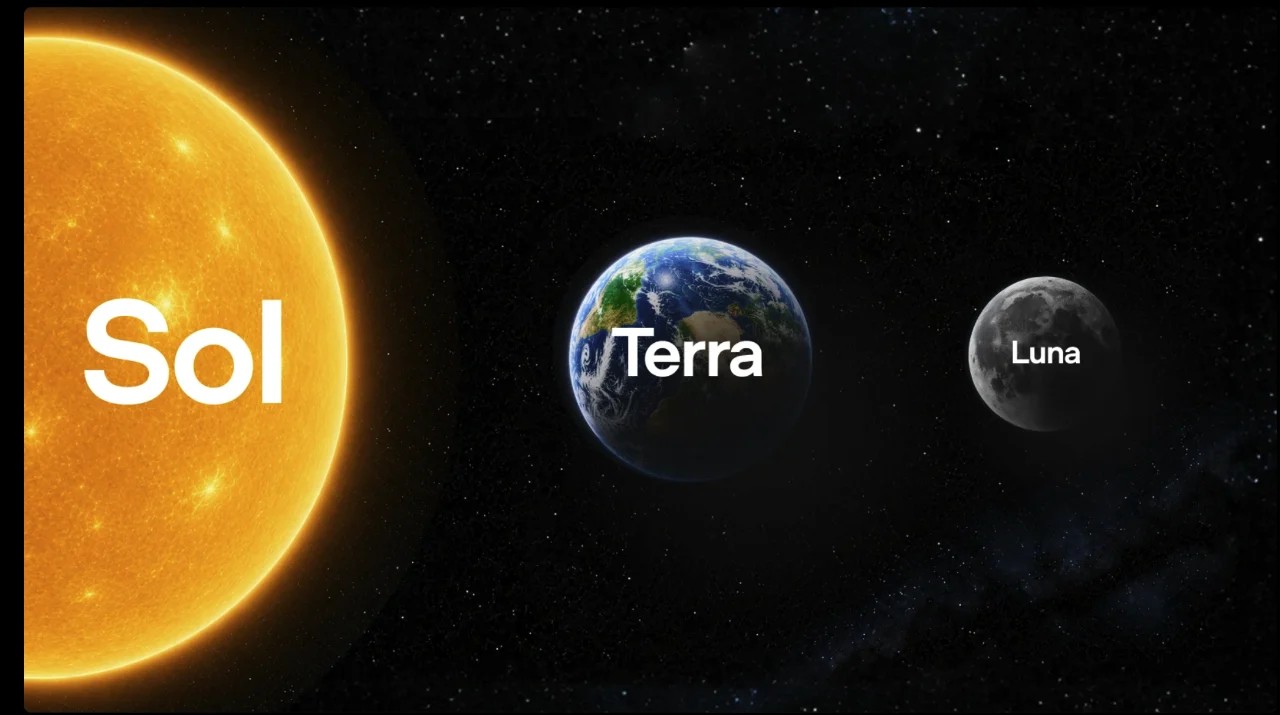
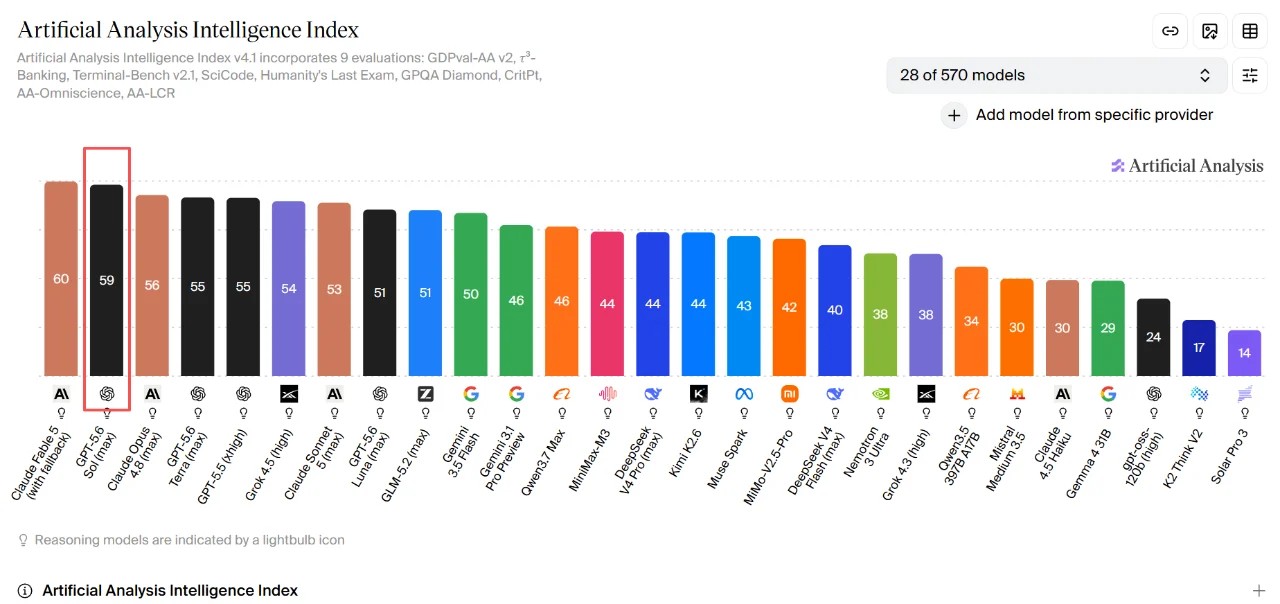
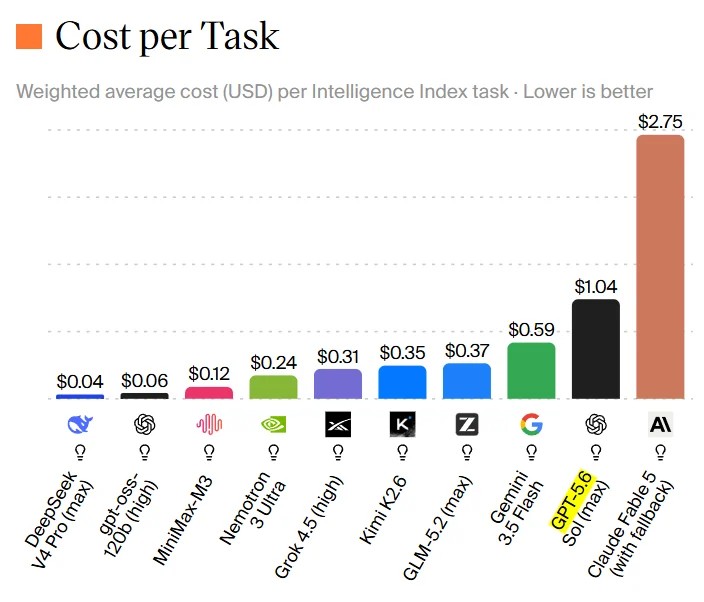
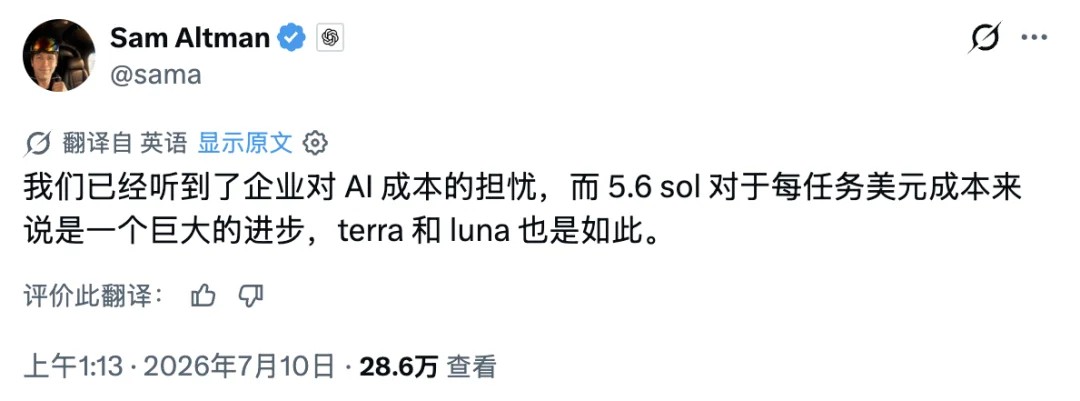
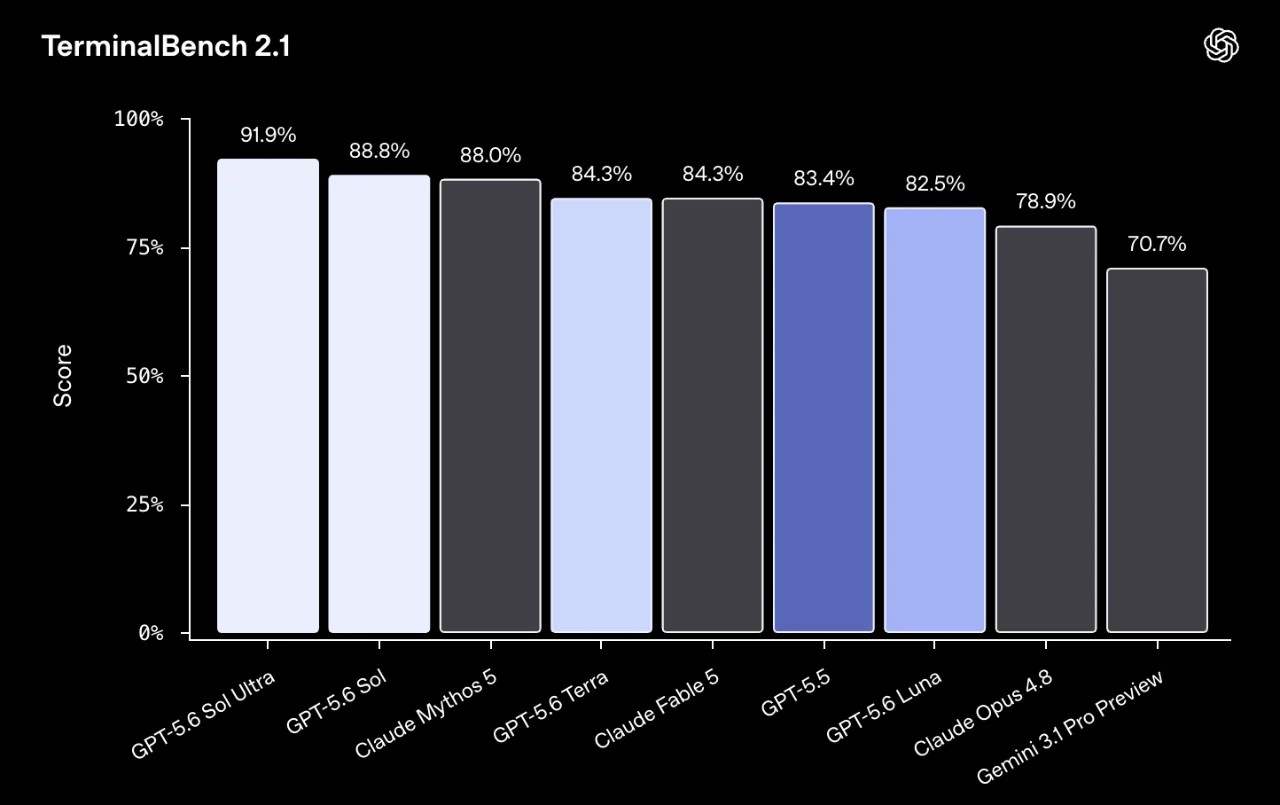
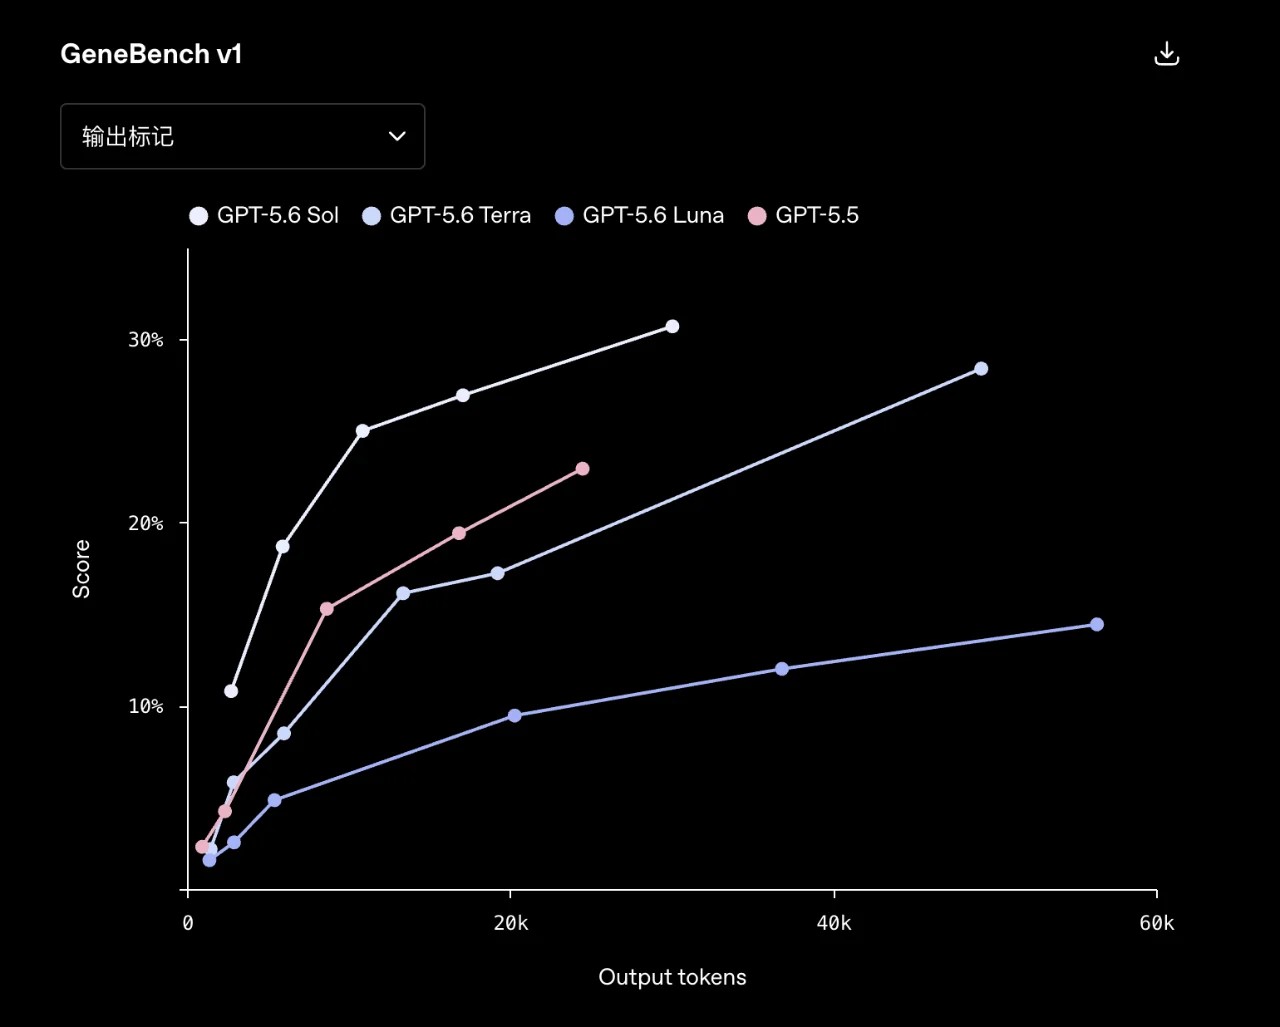
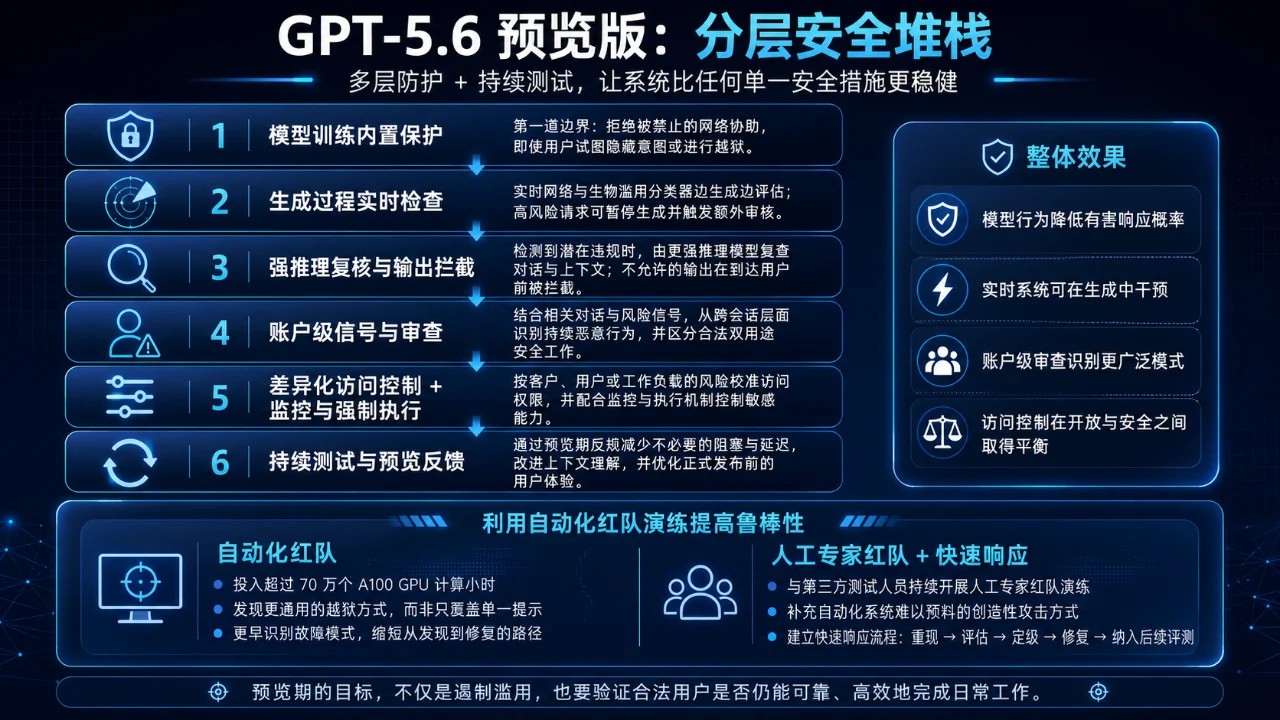
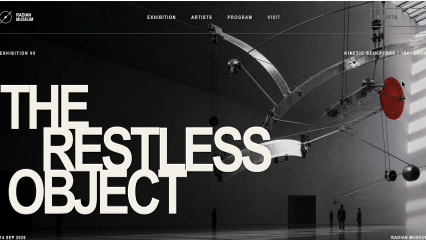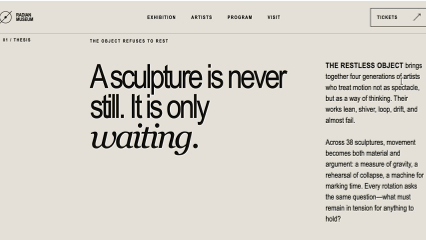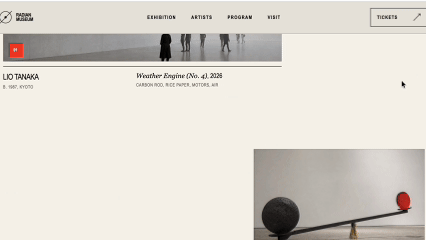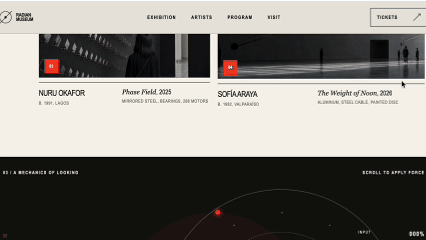
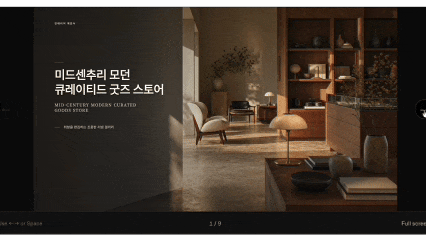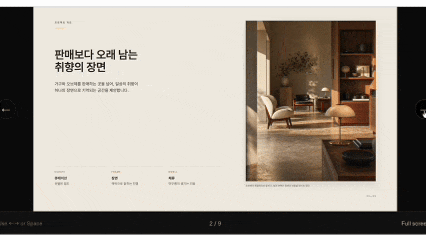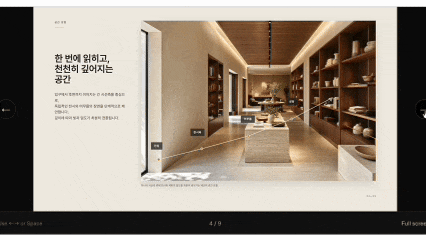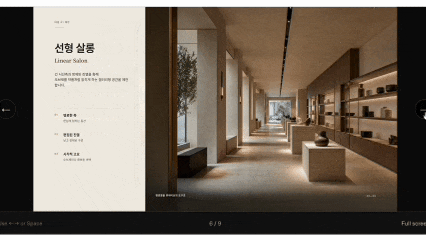
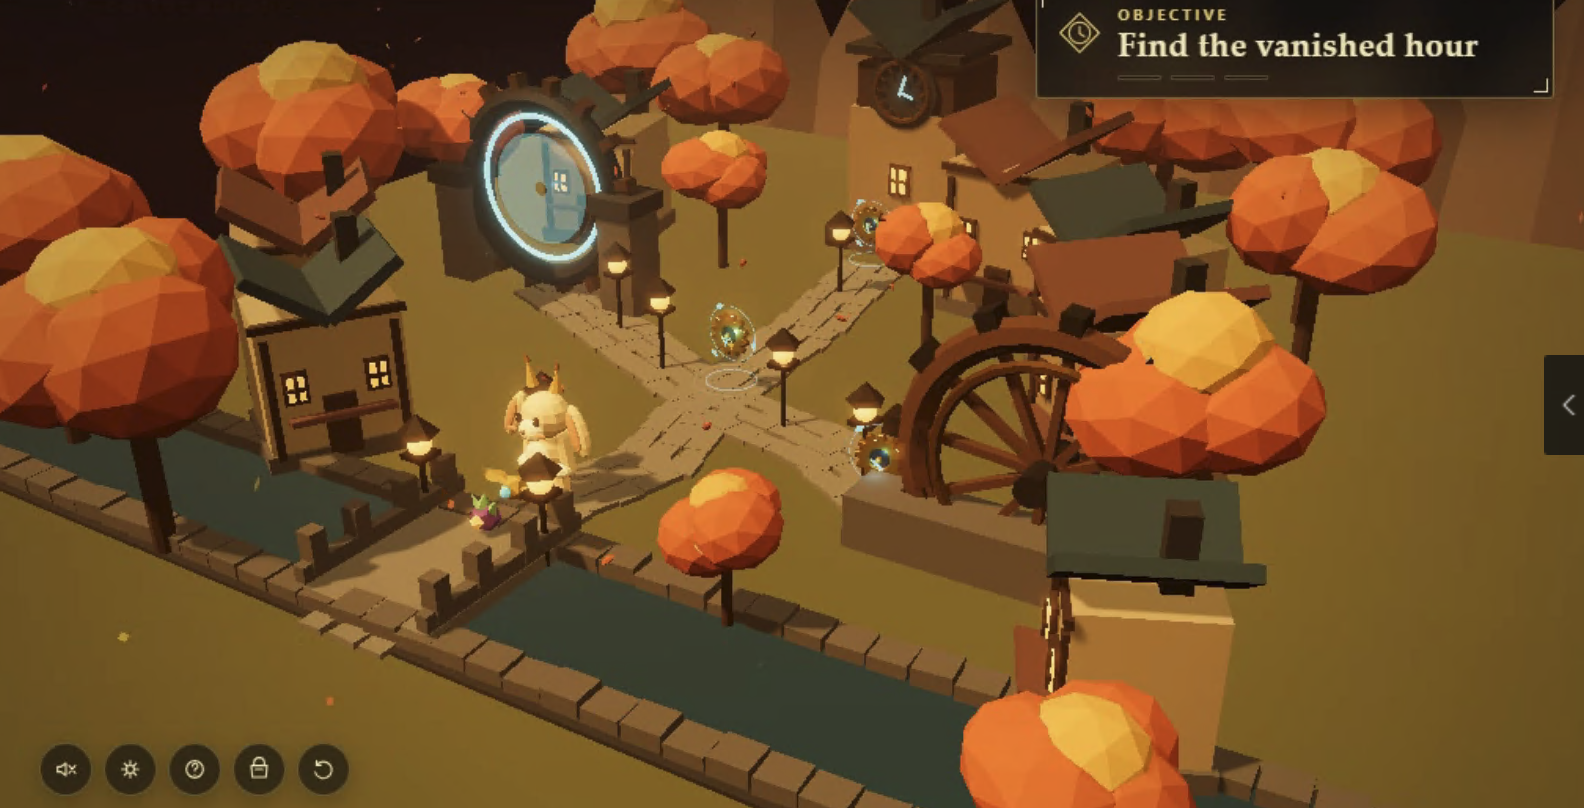
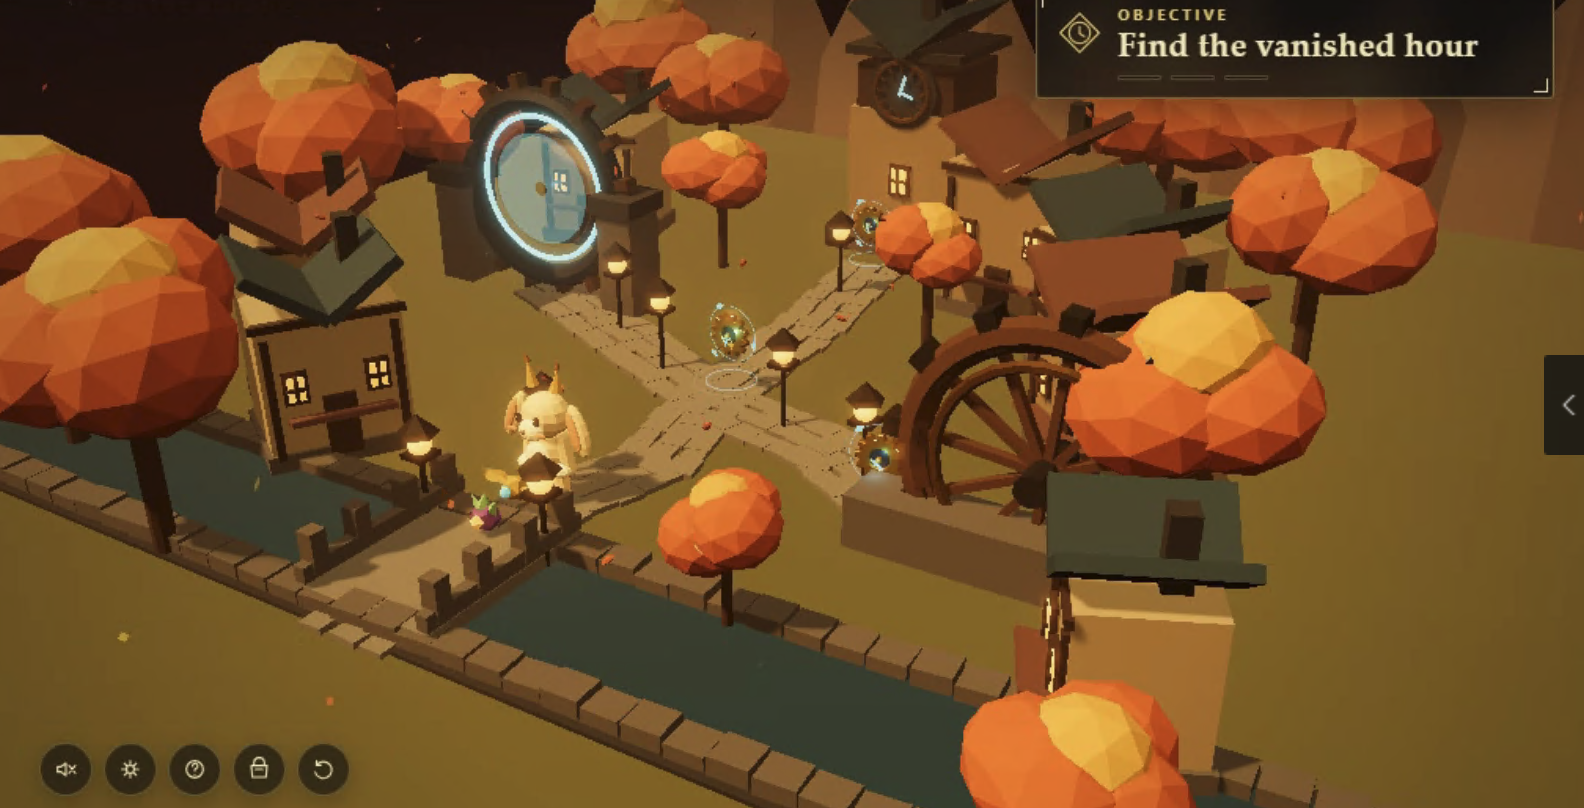
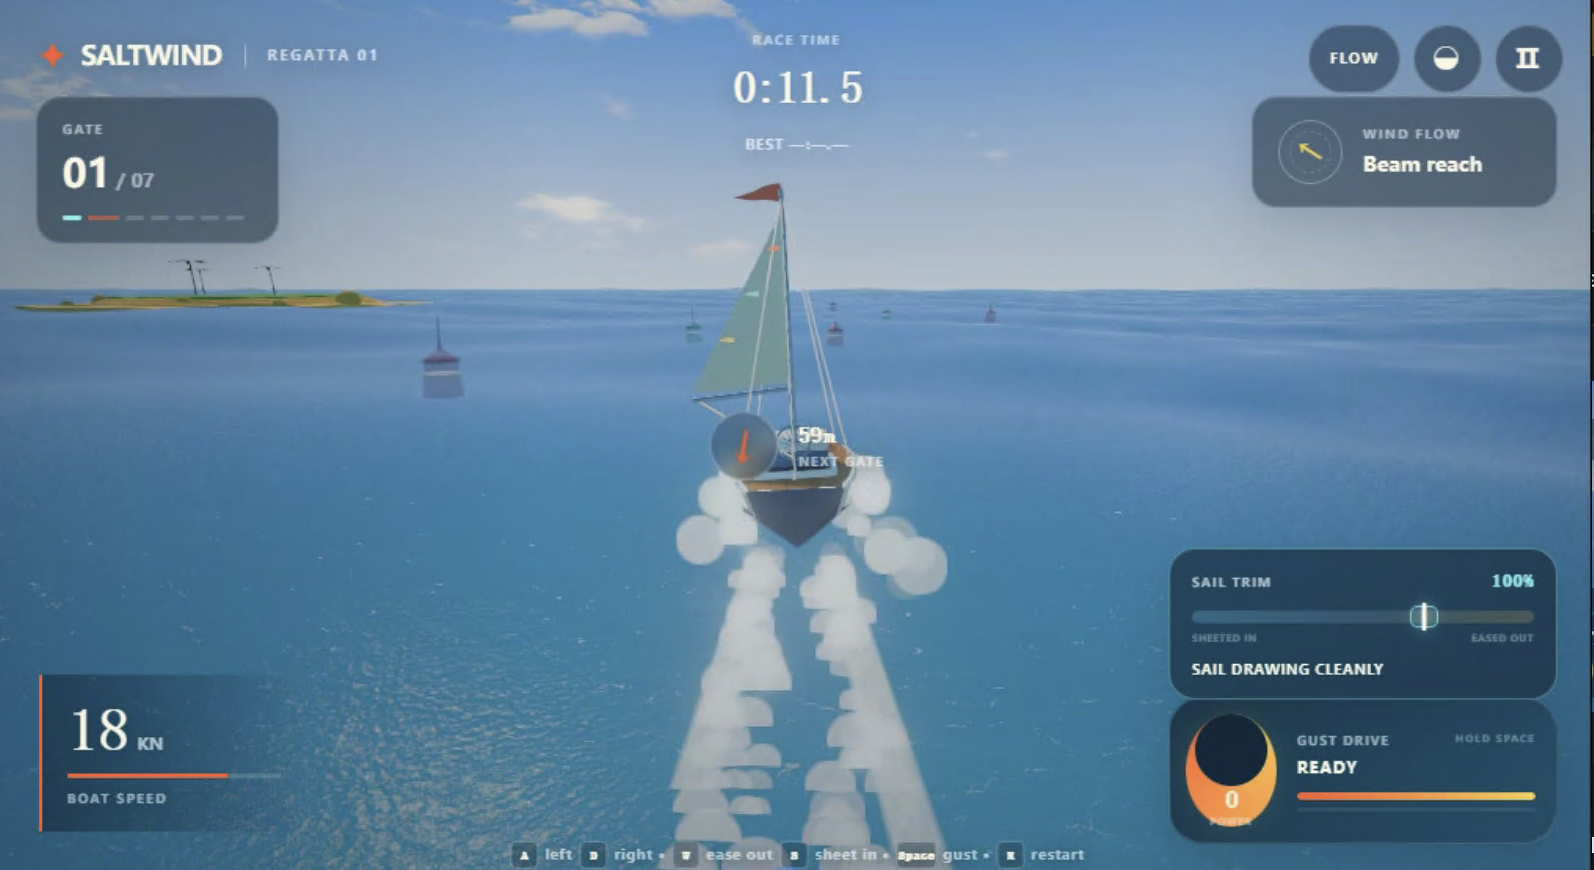
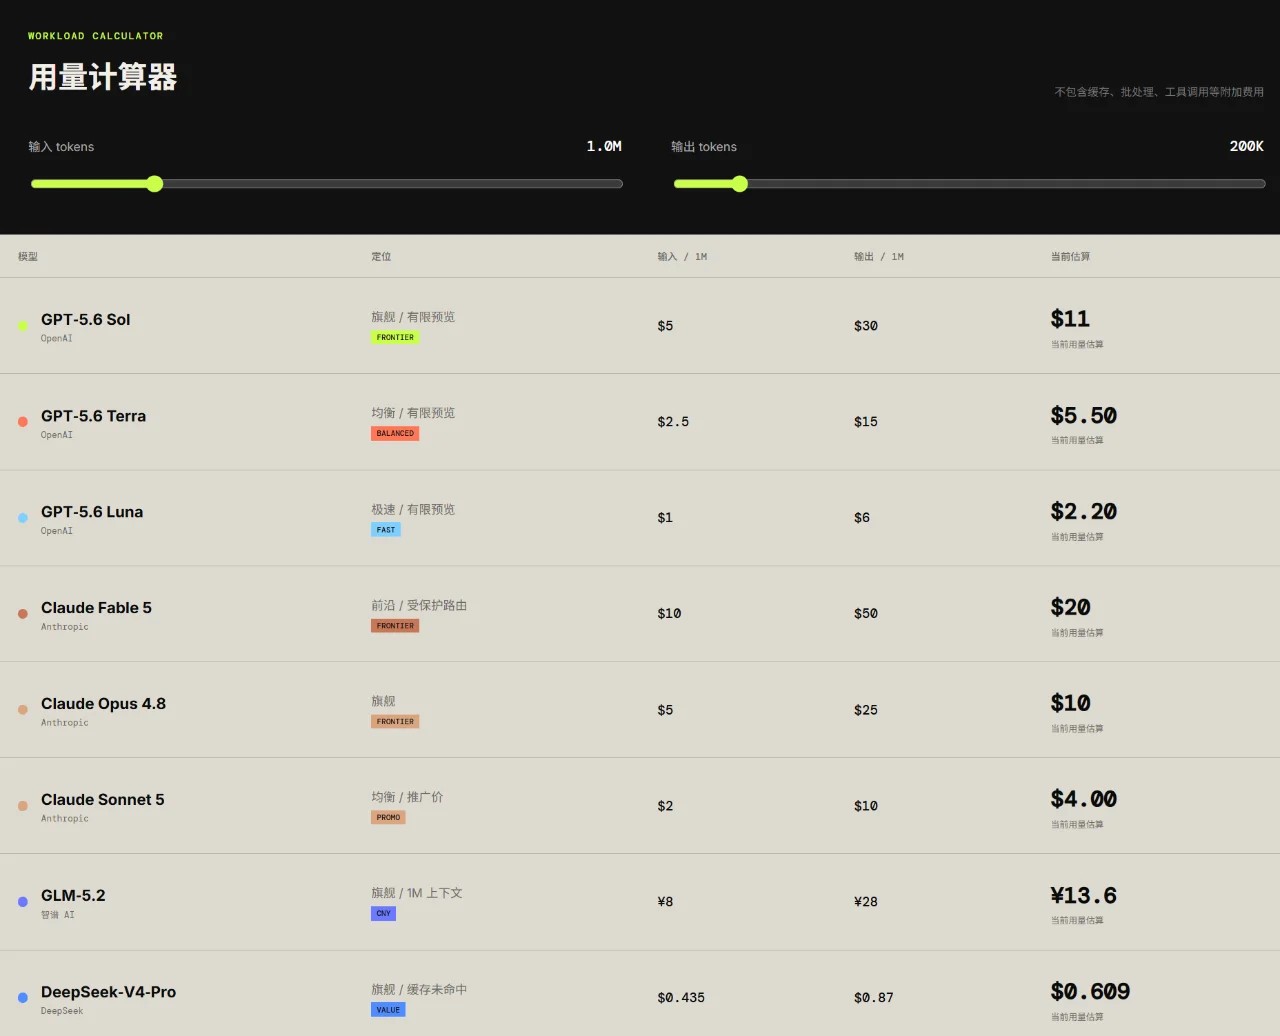
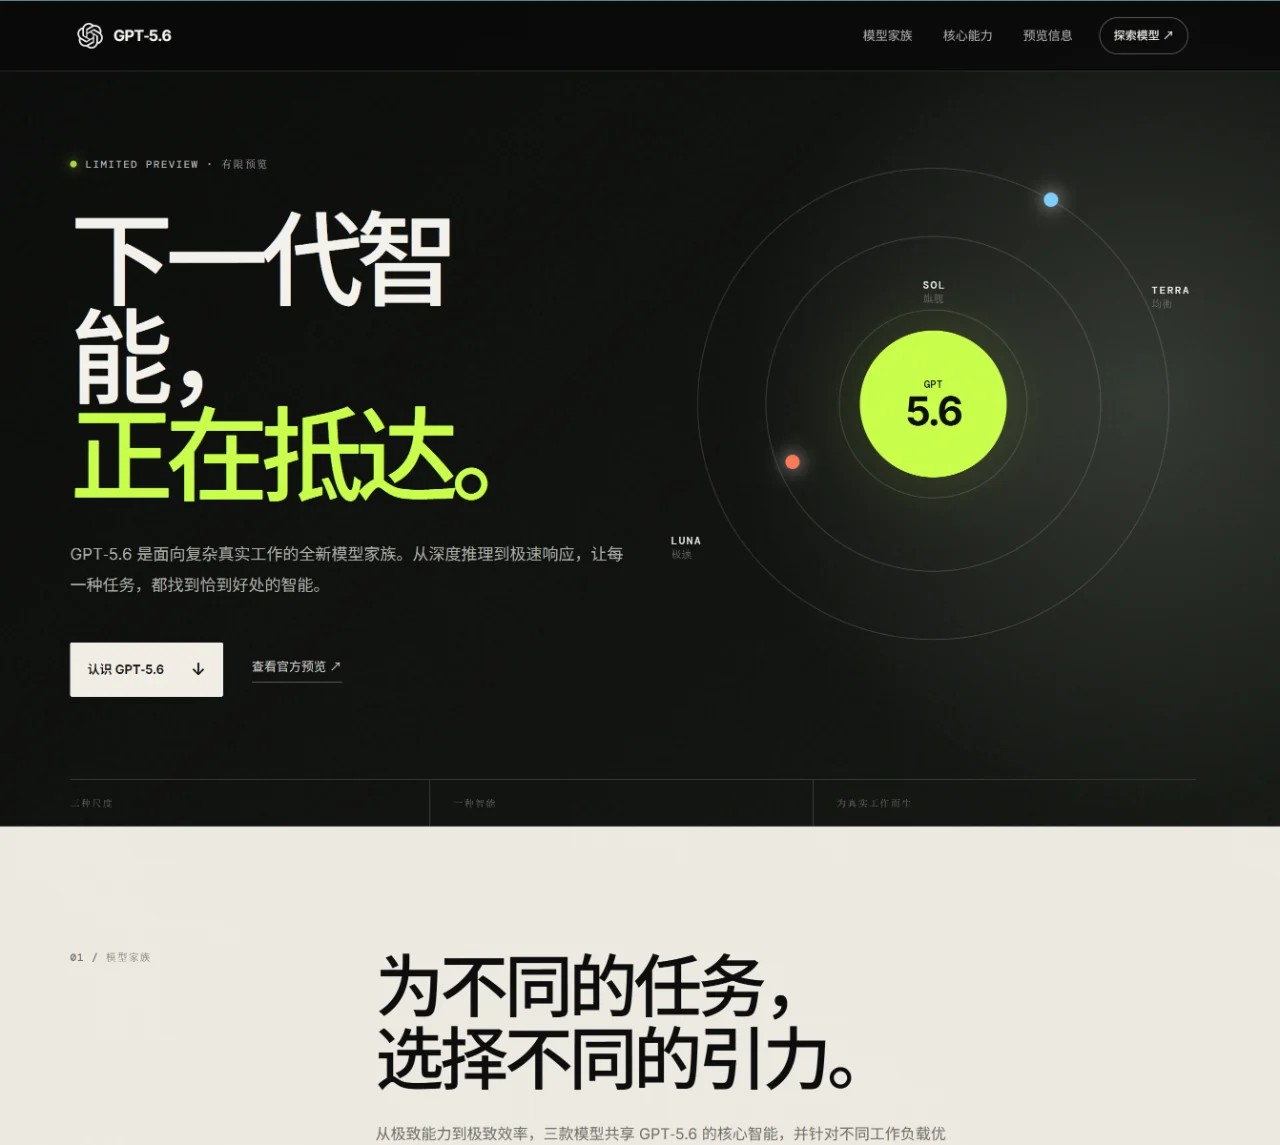
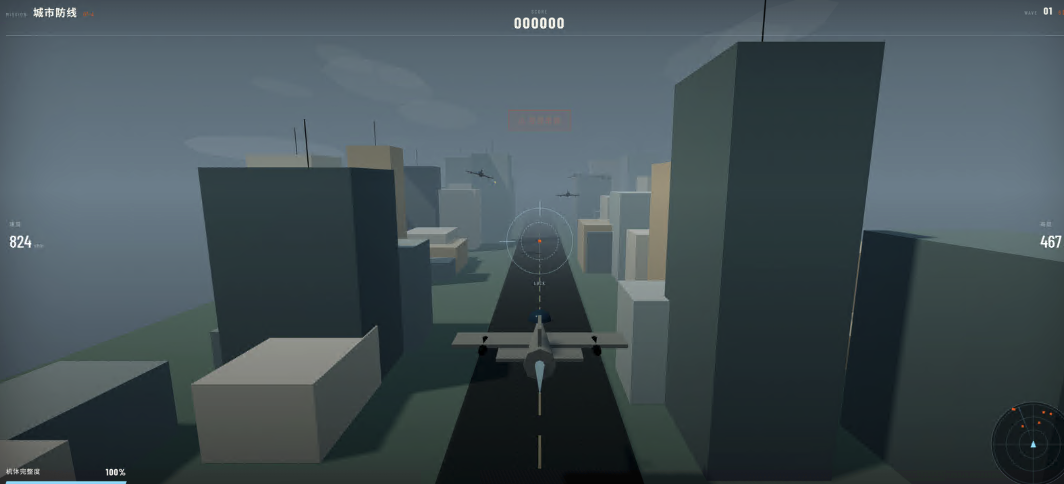
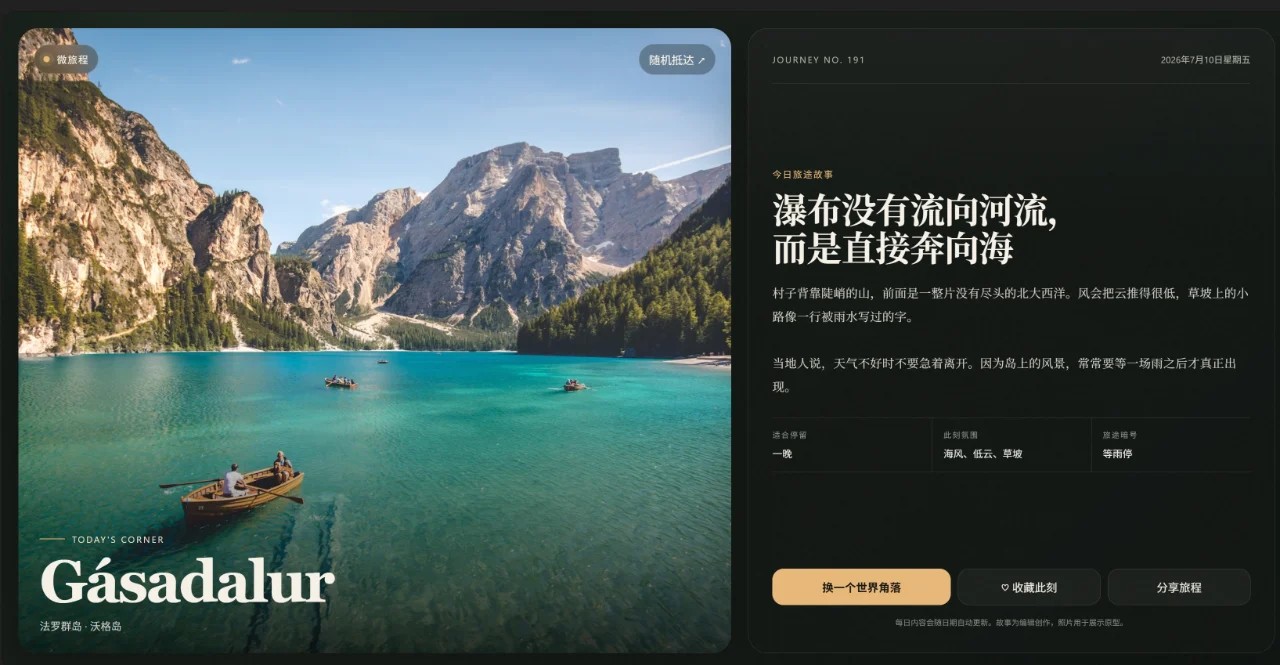
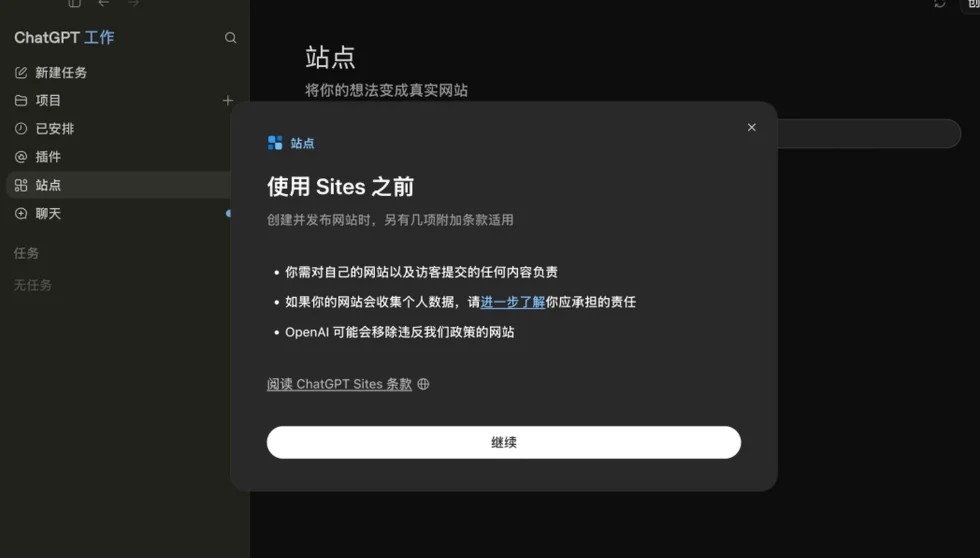
一觉醒来,就看到GPT-5.6真实发布了。Chatgpt和Codex真实合并,我更新了一下我的电脑codex之后,就看到合并通知。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/774a1d515e5d77d57bc5a8e35fab0b3a.jpg) 应用左上角提供模式切换入口,用户可根据需要快速切换不同模式。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/0555dbbcddeaa3436296c12f23af5f07.jpg) 右下角就可以看到正式版本的5.6已经上线了: ![](https://developer.qcloudimg.com/http-save/audit-3970022/e8661e8925ecf87eae19dd69f9039011.jpg) # 模型能力 OpenAI 这次发布的是一个系列:**Sol、Terra、Luna**。Sol 是旗舰模型,Terra 是平衡性能和成本的中间档,Luna 是最快、最便宜的版本 ![](https://developer.qcloudimg.com/http-save/audit-3970022/e980265676a22f289eb1bd4fbc78b043.jpg) 从Artificial Analysis评测来看,GPT-5.6 Sol模型得分在59左右,排名第二,仅仅比Fable 5低了一分 ![](https://developer.qcloudimg.com/http-save/audit-3970022/0245a315939e52e0050e329b0af951d9.jpg) 但是在差距不明显的情况下,它的花费简直太有性价比了,价格比Fable 5便宜了一半以上。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/2b54d3076ee96d4da66203d40406e10c.jpg) 这是因为,Sam Altman 专门发推说了这件事,表示自己希望能降低 AI 的使用成本。确实在好用和性价比来看,用GPT-5.6感觉会更好 ![](https://developer.qcloudimg.com/http-save/audit-3970022/40643067f14512382c97bf41bfd2715d.jpg) 最值得关注的第一点,是 **Ultra 模式**。OpenAI 明确说 GPT-5.6 引入了新的 max reasoning effort,让 Sol 能花更多时间深度推理;同时引入 ultra 模式,通过 **subagents** 超越单 Agent 能力,加速复杂任务。这个信号很关键:模型能力提升不再只是“参数更大、推理更强”,而是开始把多 Agent 编排内置进模型产品形态里。 从下面这张图可以看到,使用了ultra 模式下,gpt-5.6效果在TerminalBench 2.1榜单上达到了91.9%的效果(Terminal-Bench 2.1 测试需要规划、迭代和工具协调的命令行工作流。)超过了之前Claude模型引以为傲的Mythos 5模型。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/c1344c2e8aa3339ad2bccd3e84f7ab63.jpg) **第二点优势在于,是它更像一个面向“长程任务”的工程模型。**OpenAI 强调 GPT-5.6 Sol 除了在TerminalBench 2.1评测上效果很强,在 GeneBench v1 上相较 GPT-5.5 更强且 token 更少,在网络安全长程任务上也明显推进。换句话说,这次更新的重点集中在**代码、科研、安全、工具调用、长任务执行**。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/df2794280a97a5fc92ca3a015bd6eb42.jpg) GPT-5.6 Sol(白色线)在所有输出长度下均保持最高得分,尤其在长文本生成时优势显著,30k tokens 时得分已超 30%,远超其他模型。 **第三点,是 OpenAI 的发布机制变了**。这次 GPT-5.6 不是直接大规模上线,而是在美国政府要求下先做有限预览,参与方信息也与政府共享,OpenAI 同时表示这种政府访问流程不应成为长期默认机制。外媒也把这次发布解读为前沿模型进入“监管预发布审查”阶段。 **第四点,是安全栈明显加厚,尤其是网络安全和生物安全。**OpenAI 在 system card 里把 Sol、Terra、Luna 都视为网络安全和生物/化学风险上的 **High capability**,但未达到最高的 Critical; Sol 和 Terra 能发现漏洞和 exploit 组件,但在测试中还不能对 hardened targets 完成自主端到端攻击。同时它使用模型内拒答、实时 cyber/biology 分类器、生成中暂停审查、账号级信号、差异化访问等多层防护,并投入超过 70 万 A100 等效 GPU 小时做自动红队。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/d6d3a119fd43b7cc574ebb9ccea85581.jpg) 当让,GPT-5.6还有其他的一些优点。它明显在Agent能力上有优化。GPT-5.6 可以通过 Programmatic Tool Calling,在内部编写轻量程序,对工具调用结果进行筛选、聚合和条件判断,而不是每调用一次工具,都把大量原始结果重新塞回上下文。 这会带来几个实际变化: - 工具调用轮次更少; - 中间结果占用的 Token 更少; - 长任务不容易执行到一半偏离目标; - 面对失败结果时,更容易调整方案继续尝试。 OpenAI 还加入了多 Agent 能力,可以让多个子 Agent 并行执行,再由主模型统一汇总。Ultra 模式默认使用四个 Agent 并行处理复杂任务。 # 官方展示的效果 GPT-5.6在工程设计上,确实有明显的提升。从官方发布的各种演示视频来看,让人眼前一亮。 比如在设计一个博物馆展示网页,属于**国际一线艺术馆/设计展官网**的典型风格,设计完成度很高,视觉冲击力很强。如果这是一个艺术展、博物馆或高端品牌官网首页,它已经达到了国际优秀案例的水准。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/2a889b7018f00bd67c1a10f840dfb023.gif) 这个室内设计的PPT,整体水平比较高,属于**偏高端品牌展示、杂志风(Editorial Style)**的设计,在企业汇报、品牌介绍、产品发布中都比较耐看。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/4f729dccdeb302d7657b5700a0df832c.gif) 收集钟表小游戏。从这段约 5 秒的试玩视频来看,这个小游戏完成度比我预期要高,整体给人的第一印象不错。整个画面采用了: - Low Poly 美术 - 暖色调秋景 - 中古钟表村庄 - 等距(Isometric)视角 很容易让人想到《纪念碑谷》《Townscaper》或者一些独立解谜游戏。这种风格很舒服,也比较容易建立自己的辨识度。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/fdc618ec674ca779472f8c18f2accbe1.png) 没有逐步指导,没有手把手教学。 仅仅烧掉了 3000 多万个 Token,总成本不过几百美元,就成功复刻出了一个 **Google Earth** 的克隆版。这就是现在 AI Coding 的能力边界。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/247dae9d2e35ddcb0981b5d4c7f1d09c.png) 这个帆船游戏的**第一眼完成度很高**,已经不像普通 AI Demo,更像一个可以继续扩展的独立游戏原型。 画面上,海面、天空、帆船和尾浪的整体风格比较统一,清爽、有辨识度;UI 信息也比较完整,包含速度、帆面角度、风向、目标距离和比赛进度,能让玩家快速理解当前状态。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/27c844fe1791a43dd5f2806f7bd98298.png) 不过也有一些问题也比较明显:核心操作主要还是调整方向和帆面,短时间内缺少明显的风险、对抗和策略变化,容易给人“很好看,但玩久了可能比较单调”的感觉。另外,尾浪和粒子效果略显夸张,UI 文字偏小,画面中央的目标提示也有些遮挡视线。 从统计的费用情况来看,GPT-5.6算是性价比很高的一个模型了,Sol的价格只有Fable 5的一半,但是智力水平差不多。**Terra 永远约为 Sol 的一半,Luna 永远约为 Sol 的五分之一**。因此,常规业务默认使用 Terra、批量任务使用 Luna、少量高难任务升级到 Sol,是最经济的组合。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/a688a0526939687f9fb2adbf12871fdf.jpg) # 真实实测 **Q1:帮我创建一个介绍GPT-5.6的网站页面** ![](https://developer.qcloudimg.com/http-save/audit-3970022/4f74e1dfc1dfd1a134f0f7f1050f74c3.jpg) 最后生成的页面步骤确实让人看起来很舒服。视觉完成度较高,已经像一个正式的新品发布专题页。信息结构清楚。从模型家族、核心能力到预览状态,阅读路径比较自然。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/daee9f8a444a3f1405fbb8bd1788f06a.jpg) ![](https://developer.qcloudimg.com/http-save/audit-3970022/5659cb1f96159ee4d3e3b18b5ad67c16.jpg) **Q2:用 Three.js 实现一款3D战斗机对战游戏,在城市上方飞行,可以用触屏或者键盘操控。** ![](https://developer.qcloudimg.com/http-save/audit-3970022/02f6392e92ae63a3ef2a7c7cf515ecf4.png) **Q3:开发一个“微旅程”网站,每天推荐一张世界小众角落的照片+一段故事。** **整体的完成度很高**,而且可以直接切换多种照片进行展示,都可以直接上线的程度了。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/547a51794288a128c65c1c0c9f1633cb.jpg) **Q4:开发一个“卖雪糕”的原型图。** ![](https://developer.qcloudimg.com/http-save/audit-3970022/ff779e7a7719a6bf6802497973a2511f.jpg) # 写在最后 对了,这一次Chatgpt的更新,还新增了一个Sites 功能,简单的说就是 ![](https://developer.qcloudimg.com/http-save/audit-3970022/49e029d6b40aff506d8663e788da0693.jpg) 只需要在 Prompt 里说一句话,AI 就能直接生成并部署一个可访问的网站。 生成后的网页会自动上线,拥有独立链接,你可以一键分享给朋友、同事或团队成员,无需本地运行,也不用额外部署。对于普通用户来说,大大降低了创作和分享的门槛,让 AI 生成的内容真正实现“即做即分享” GPT-5.6 给我最大的震撼,不是某一个评测超过了 Claude,也不是它生成了一个多么漂亮的网页,而是 AI 产品开发的门槛正在快速接近于零。 ![](https://developer.qcloudimg.com/http-save/audit-3970022/281d5fcaa31cd9032d2b5ec4ace92f25.png) 不过GPT-5.6 当然还不完美,还需要把价格降低一下,把性价比做高就更好了。 现在Claude Fable 5 会不会慌,我不知道。但可以确定的是,随着 GPT-5.6 正式入场,前沿模型之间的竞争,已经从单纯比较“谁更聪明”,进入了比较“谁能以更低的成本,真正完成更多工作”的新阶段。
优秀的个人博客,低调大师

对标 Fable5 ? 零跑分、零论文、零API:阿里Cantus凭什么自称"顶级模型"

7月19日,星期日。阿里 Qoder 团队悄悄上线了一个新模型,叫 Cantus。没有发布会,没有博客,没有技术报告。官方介绍全文只有一句话:「Qoder 的内置顶级智能模型,擅长长时间自主任务执行」。 Cantus 上线计费系数 2.56x 正常 3.2x 截至发文当日: ![](https://developer.qcloudimg.com/http-save/yehe-12521923/84fa0472093e16fca8e4a8ecb1aa34bb.png) 一个自称”顶级”的模型,参数规模不说,架构是 Dense 还是 MoE 不说,上下文长度不说,训练方式不说,基准成绩一个不放。Artificial Analysis 查无此模,LMArena 没有排名,HuggingFace 没有模型卡,arXiv 没有论文,主流媒体没有评测。 首发当日拿一张五折券当了发布会。 01先拆包装:Cantus 是谁家的 澄清:Cantus 不是 Anthropic 的模型 网上有人把 Cantus 说成 Anthropic 出品,源头是一个同名的 macOS 应用——那个 Cantus 只是 Claude Code 的图形界面包装器,跟阿里这个模型没有任何关系。此 Cantus 是阿里巴巴 Qoder 团队的专有模型,只活在 Qoder 生态里。 名字倒是取得讲究。cantus 是拉丁语“歌唱、圣咏”。音乐术语里有个 Cantus Firmus,“固定旋律”——中世纪复调音乐的基础声部,其他所有声部都围绕它编织展开。用它给一个 agentic coding(智能体编程,让模型像工程师一样自主接活、拆活、干活)模型命名,暗示很直白:模型是那条固定旋律,IDE、CLI、Cloud Agents 是围着它转的复调声部。 它的活动范围也确实只有这些声部:Qoder Desktop、JetBrains 插件、CLI、Cloud Agents、Web 和移动端。无公开 API,无开源权重。你想单独调用这个模型?没有门。 02不跑分,可能是因为分数量错了东西 按 2024、2025 年的行业惯例,新模型上线第一件事是甩出 SWE-Bench 成绩。SWE-Bench 是拿真实 GitHub 仓库的 issue 让模型修 bug 的基准测试,过去两年是编程模型的硬通货。 Cantus 一个分都没跑。而它的官方定位偏偏是”长时间自主任务执行”。 把这两件事放在一起看,能读出一个技术判断:SWE-Bench 这类单轮基准,量不出长程 agent 任务的真实能力。 SWE-Bench 的题目形态是:给一个 issue,改对代码,测试通过,结束。整个过程像一次闭卷考试。但真实的 agentic coding 是另一种运动:任务跑几个小时,上下文窗口反复被塞爆又要压缩,中途工具调用失败要重试,改崩了要回滚到 checkpoint(存档点,出错时可以退回重来的进度快照)再来,大任务要拆成子任务排队执行。 长程任务还有个糟心的数学现象:错误会复利。假设模型每一步的正确率是 99%,一个 300 步的任务全程不翻车的概率只剩 5% 左右。单轮基准考的是那个 99%,长程任务考的是剩下那 5%——两者拉开差距的地方在于出错之后怎么办。翻不了车的模型不存在,翻车后爬得起来的模型才稀缺。 所以长程任务真正考验的清单是这样的: - 上下文工程(几小时的操作历史塞不进窗口,模型得自己决定哪些信息留、哪些扔、哪些压缩成摘要) - 错误恢复(失败后换路径,别原地打转重复同一个错误) - 子任务分解(拆得动、拼得回、丢了一块能补) - 工具调用链的稳定性(第 200 次调用和第 2 次一样规矩) 这些能力在 SWE-Bench 上不加分。甚至有些刷分技巧(比如对单题做多次采样挑最优解)和长程任务要求的稳定性是反着来的。 再进一步:跑分的营销收益,主要归属卖 API 的商业模式——分数高,开发者才愿意为每百万 token 掏钱。Cantus 不卖 API,只在订阅制 IDE 里干活,跑分对它的转化率几乎没有贡献。说白了,不跑分对它是个理性选择,成绩单换不来一个新订户。 判断一:评价体系正在换轨 agentic coding 模型的竞争维度,正在从"单题通过率"转向"多小时自主循环的存活率"。前者有公开榜单,后者目前只能靠用户拿自己的仓库实测。Cantus 押的是后者——这个判断没有官方确认,但和它唯一那句官方描述完全对得上。 03只进 IDE 不开 API:模型和脚手架一锅炼 不开 API,除了商业考量,还有一层技术逻辑。 通用 API 模型(Claude、GPT 系列走的路)要服务千奇百怪的调用方,训练时只能对“平均场景”优化。而模型只绑定自家 IDE,模型和 harness——就是围绕模型的那套脚手架:工具定义、提示词模板、上下文压缩策略、检索管线——可以联合优化。工具调用的格式可以直接烧进训练分布,上下文管理策略可以和模型的注意力特性对齐,错误恢复流程可以拿 IDE 内的真实失败轨迹做训练数据。 对比一下几条路线就清楚这有多极端。Cursor 早期拿别家 API 配自研 harness,模型和脚手架分属两家,中间隔着一层公开接口;GitHub Copilot 绑 OpenAI 的模型,harness 自己做,同样是”拼装”结构;Claude Code 是模型厂反过来做 harness,但模型本身照常卖 API,任何人都能单独测它。Cantus 走到了最后一格:模型、harness、入口,全部自营,外部完全不可见——你没法把模型从 IDE 里剥出来单独考一场试。 这条路线的账要两面算。收益端,联合优化的性能红利实打实,而且 IDE 里每天产生的真实任务轨迹会回流成训练数据,用户越多、任务越长,下一版模型的训练语料就越贴近真实分布,越用越准。代价端,模型质量无法被第三方验证,评测机构连入口都没有;用户能看到的唯一质量信号是自己的使用体验,官方能看到的唯一成绩单是续费率。 这条路线的护城河在数据回流,不在模型权重本身。权重可以被追平,但”百万用户在真实仓库里跑长任务”的轨迹数据,对手拿不到。这是判断二,同样没有官方背书。 043.2x 系数里藏着什么(全是推测) Cantus 的原价系数是 3.2x,比 Qoder 内其他模型明显贵。定价一般不撒谎,它至少暗示了成本结构。 以下三种解释都是推测,没有任何官方确认: 一,更大的模型。参数量上去了,单 token 推理成本自然高,系数直接对应算力账单。二,更多的推理 token。如果 Cantus 走长思考路线,每个任务内部消耗的隐藏 token 会数倍于表面输出——用户看到一段回复,背后可能烧掉了几十倍的思考量。三,多次采样。对关键步骤并行生成多个候选再择优,正确率换成本,成本按采样数翻倍。 三种解释也可能同时成立,长程任务模型叠加这三样几乎是常规操作。而五折促销的意图倒不难猜:长程任务天然烧 token,3.2x 的原价足以吓退试用者,1.6x 是把尝鲜门槛砍到用户愿意拿真实项目喂它的水平——毕竟这类模型唯一有效的评测方式就是用户实测,没有试用量就没有轨迹数据,没有轨迹数据就没有下一版。折扣不只是拉新,也是在给数据飞轮点火。 05它从哪来:时间线上的前身(推测) Cantus 没有公开血统,但时间线上有一个显眼的坐标。 2026 年 2 月,阿里曾为 Qoder 端到端定制训练过一个模型,Qwen-Coder-Qoder,当时公开了 SWE-Bench 60.51% 的成绩。五个月后,Cantus 上线。 ![chart-timeline](https://developer.qcloudimg.com/http-save/yehe-12521923/111831c8e64e69803253176c53264eab.png) 从时间线看,Cantus 更像 Qwen-Coder-Qoder 的后继或升级版——同一个团队、同一个”为 Qoder 定制”的思路、相隔五个月。但这纯属时间线推测,两者关系没有官方确认。 公开赛道上的成绩,可以做个参照: ![chart-bar](https://developer.qcloudimg.com/http-save/yehe-12521923/d07cdf1e353d9026eaec26976bf46c42.png) 一个注脚:图里三个数字的测试口径不完全一致,Opus 4.7 的 87.6% 是 SWE-Bench Verified(人工核验过的子集),横向比较只能看量级。Cantus 在这张图上是空白——它拒绝了这个赛场。 Claude Opus 4.7 的 SWE-Bench Verified 87.6% 2026年4月发布,公开赛道的天花板参照 06顶级模型集体沉默是必然趋势 Cantus 只是一个更大趋势的样本:顶级模型越来越不发论文、不跑公开榜。技术报告越写越薄,训练细节按商业机密处理,第三方评测机构拿不到 API 就无法复现任何结论。2023 年大家还在抱怨 GPT-4 技术报告不写参数量,2026 年的 Cantus 干脆连报告都省了——三年时间,行业默认的信息披露标准从”报告但打码”退到了”一句话加一张折扣券”。 信息不对称的天平,正在整体倒向厂商一侧。用户面对一个黑箱,官方叙述只有一句话,社区评测要滞后数周,等评测出来折扣期可能都结束了。 Cantusagentic codingQoderSWE-Bench垂直整合

优秀的个人博客,低调大师

Codex 取消 5 小时限制,Claude 硬刚回敬:Fable5 延期 + 额度暴涨 50%

7月中旬AI编程圈迎来火药味十足的福利对战。OpenAI先出大招,临时移除Codex付费用户的5小时用量窗口,同步全量重置账户额度; Anthropic随即接招回敬,宣布延长Fable 5体验周期、上调Claude Code周度速率上限。两大厂商接连释放算力空间,开发者的可用额度直接扩容。本文梳理两款工具的安装路径、能力边界、政策细则与高效使用方法,帮你吃透这波红利。 ![](https://developer.qcloudimg.com/http-save/yehe-11919542/28eb8bbd006166d4e9d158f064da368c.png) ## **📌 核心能力拆**解 从定位上看,Codex更像执行力拉满的工程角色,能闷头连续推进任务交付结果;Fable 5更像擅长顶层设计的架构角色,抽象思考与深度推理表现更突出。 ![](https://developer.qcloudimg.com/http-save/yehe-11919542/8c4159aa574a38bb450d78b898da99d6.jpg) ### **✨ Codex能力亮点** 依托GPT-5.6系列三档模型,覆盖不同量级开发需求: - 全链路代码交付:支持需求拆解、文件修改、终端运行、结果校验的完整闭环,可独立完成中小型功能开发 - 多场景工具联动:内置浏览器访问、桌面操作、PR评审等能力,减少跨软件切换的上下文损耗 - 长任务连续执行:移除5小时窗口后,大型重构、跨仓库迁移等任务可一气呵成,避免中途中断 解决的核心痛点:陌生项目上手慢、多工具来回切换损耗效率、长周期开发任务被额度窗口打断。 ![](https://developer.qcloudimg.com/http-save/yehe-11919542/d2d6637067b1ea78c0cd533b5cbe7c63.png) ### **✨ Claude Code能力亮点** 搭配Fable 5高阶模型,主打深度代码理解: - 超长上下文兼容:支持百万级代码库一次性加载,适合存量系统重构、历史遗留问题排查 - 复杂逻辑推理:底层架构设计、算法优化、安全漏洞审查场景表现突出 - 周度额度扩容:上调50%速率限制后,重度开发场景的可用空间显著提升 解决的核心痛点:大型代码库分析不完整、深层Bug定位不准、高频开发场景额度不足。 ## **📌 双雄政策对**比 |对比维度|OpenAI Codex|Anthropic Claude| | --- | --- | --- | |核心动作|临时移除5小时用量窗口,全量重置已用额度|Fable 5体验延至7月19日,Code周额度上调50%| |覆盖范围|Plus、Business、Pro全付费套餐|各档位付费订阅用户| |底层约束|保留周度总量上限,多产品共享积分池|保留分级周度额度,单产品独立计算| |适配场景|连续执行型开发任务、多工具联动场景|深度代码分析、大型项目重构场景| |政策属性|临时调整,恢复时间未公布|限时延期,暂定7月19日到期| ## **📌 高效使用技**巧 1. **模型分层调用** 日常功能开发、代码格式化等轻量任务,选用均衡或轻量档模型,降低额度消耗;复杂架构设计、疑难Bug排查再切换旗舰模型,把算力用在高价值环节。 1. **任务集中执行** 借助当前无5小时窗口的政策,将积压的大型重构、工具开发、批量代码整改等长周期任务集中处理,避免拆分任务带来的上下文重复加载损耗。 1. **双模型协同 workflow** 需求梳理、架构设计、方案评审阶段,用Fable 5完成抽象思考与方案推导;落地编码、调试运行、迭代优化阶段,交给Codex连续执行交付。交叉审查环节可让两个模型互为校验,提升代码可靠性。 1. **额度余量利用** 周度额度临近耗尽时,可启动一个上下文完整、目标明确的大型任务。当前机制下,已启动的任务通常会尽量执行完毕,不会中途掐断,能最大化利用剩余额度。 ![](https://developer.qcloudimg.com/http-save/yehe-11919542/05c6fd8393fb3bb80df58edb9134ad0d.jpg) 这轮厂商对垒本质是算力供给与用户争夺的叠加,宽松的额度窗口为开发者处理重任务提供了绝佳周期。合理搭配两款工具的能力优势,将算力投入到可沉淀的代码资产、自动化工具与标准化工作流中,才能真正把福利转化为生产力。补贴窗口不会长期持续,按需规划任务优先级,是当前阶段更稳妥的使用策略。 #AI编程工具 #Codex使用指南 #ClaudeCode教程 #GPT5.6 #大模型开发实战

优秀的个人博客,低调大师

我们穷人不用 Fable5、GPT5.6,直接用免费还特么超快的 Antigravity 2.0

付费顶流(**Fable 5、Codex GPT 5.6**)固然强悍,硬核推理确实牛逼,或者说,相比他们前几代的模型,有许多断层的差距。你只要直接和它提问,告诉它「说人话」,它本身的智力就能把事情完成得极好,直接迎来了一次极大的效率提升。 **当然,对于某些极其复杂的超难任务,让顶级模型思考很久、做很久,那是完全合理的。** 但两个顶级模型都挺慢的,走走停停,创作和协作的心流连不起来。 然后的话,就是两个字:贵和封号的问题。 在我们日常 80% 的高频使用里,有一个很需要的其实是「心流连贯」。**我不知道怎么和大家说,但是我极其享受这个过程。** 就像我本地已经开了 Claude Code,但我还是会用 ChatGPT 网页端一样。一个是模型的反应,一个是产品维度的那种用户体验。 今天想说的也是这个,一个是它模型挺不错,一个是它 Agent 的应用,进行这个模型回复的这些东西。 我最近撞见了 **Antigravity 2.0 (Gemini 3.5 Flash)。** ![](https://developer.qcloudimg.com/http-save/yehe-9836881/2f50a5c75026fdd9a9b6c3c9b3a38c54.png) 我发现这里有一个被它融合得极好的体验上的**甜点区**。核心就是**免费和极速**。当然,这必须是在保证智力的前提下,能帮我完成许多复杂任务,而不是像某些智力一般、体验也差的模型。 **其实它本身的能力水平就不差,除了谷歌的模型,还有 Claude 等模型在里面支撑,解决问题的能力非常到位。** **大善人,额度过分爽** 它的**额度很仁慈**,用不完。有 Gemini 3.5 flash,还有 Claude 4.6 Opus等大模型。尤其是对于谷歌自己的模型,就算是免费版的额度都很难用得完,更何况很多人自己本身就有 Pro 账号。 ![](https://developer.qcloudimg.com/http-save/yehe-9836881/9487104f7f6af7bd214d00473635210a.png) ![](https://developer.qcloudimg.com/http-save/yehe-9836881/06eedf86d5b8509c5353e3c679e17b3e.png) 这种极速心流,以前真的是完全没有体验过。 他叫 **Antigravity 2.0**,是和 Codex 一样的应用。不是**Antigravity **IDE 或者 CLI;以前的 Antigravity IDE ,原来谷歌是封过许多号,后面即便恢复了,我感觉我自己用的时候还是用不了。但是这个 **Antigravity 2.0** 直接就可以用,没有老 IDE 那么多的用不了的问题。 ![](https://developer.qcloudimg.com/http-save/yehe-9836881/8aa35082028f0121dde4e5bb0cfa54b3.png) **反复反馈和死磕** 比如这次,我想用手机远程控制电脑终端,配置 QuickTUI,结果在 Windows 上各种报错、局域网死活连不上。 ![](https://developer.qcloudimg.com/http-save/yehe-9836881/3f8e9b13c17f06848c8d076a9f2bb963.png) **Antigravity 2.0 **它自己跑命令行做物理隔离测试,一路探到 Hyper-V 端口被系统排挤,挖出后台暗中拦截端口的驱动,再撕开代理环境变量的劫持。我们最终找到了问题的根因,原来是我以前折腾 2.4G/5G 频段拆分、开了一堆代理之后,搞过「网络重置」,导致 Windows 自动把网络防线降级成了默认拦截一切的「公用」。 ![](https://developer.qcloudimg.com/http-save/yehe-9836881/d812485d89af7c7761df809dee140371.png) 以前兜兜转转断断续续,因为这个问题 Windows 电脑有不少别的问题,每次让 Agent 搞几轮没解决,就一直遗留着。 快速和连贯的实时反馈,我确实很享受。 如果是一些复杂的情况,每次转圈都要等好几十分钟,搞了三四轮还不解决,我就改不下去,本能地会认为那个东西肯定很复杂、很难搞定,直接就放弃了。而能让我快速搞一下,立刻确定它这个解法到底能不能成,非常节省时间。 这样一轮接一轮地反复反馈和死磕,用户给予这个 Agent 反馈的次数,其实比原来那种慢吞吞的模型,要多得多。这种高频次的碰撞,确实是很Vibe,是我很想要做的。因为用手机控制电脑的次数也越来越多。 **越用越懂我,文件系统** 配合我自己的工具链,我和它极速快跑,构建这种越用越懂我的文件系统,来和我协作快速处理许多事情。 以前传统的 AI 辅助,都是临时的、碎片化的。而我跟它极速快跑,在多轮高频的交流中,自然涌现出了一套「三层神经元架构」:根目录是高密度规则的灵魂主干,sandbox 文件夹是新灵感发散的前额叶沙盒,而 tasks 则是冷归档的海马体记忆。 ![](https://developer.qcloudimg.com/http-save/yehe-9836881/e084a1efdee802312e52422b3ec5a05a.png) 这种认知框架不是凭空套模板套出来的。它是在极速快跑的同频碰撞中,把卡帕西(Andrej Karpathy)提倡的那个 LLM Wiki 模式,活生生地在本地给跑了出来。 ![](https://developer.qcloudimg.com/http-save/yehe-9836881/87072bbfcf652009d33aaf734126295a.png) #### 在这:https://antigravity.google/download #### 我没有去截动态图,只能说很快,体验极致;Gemini 3.5 Flash 即使开 high 速度和Low都差不多,依然零延迟。和其他的对比,感受挺直观。不知道是谷歌的提示缓存,还是他自己对于自己的产品接入的这种 API 超快。 #### 不免想到当初用手机控制电脑小龙虾那个反应速度了。。用手机控制电脑下的antigravity 2.0,这体验就完全不一样。 #### antigravity 2.0 里面的 Claude 模型噼里啪啦用得快,自家的模型,额度是足够的。 #### 另外,像Cursor这样的也做了这种Codex类的界面应用,Antigravity 这个也可以打开Antigravity IDE,这种纯agent界面已然很多 agent IDE 都做了。 ![](https://developer.qcloudimg.com/http-save/yehe-9836881/221636cdfb9221e42088e00d4b665350.png) 另一个可以探索玩的就是它这个Antigravity SDK了,和自己的工作流链路 、Skills 搭配也可以。 ![](https://developer.qcloudimg.com/http-save/yehe-9836881/eb42d58854b6fa8962faf9029c2f2c80.png) 最后,哈基米虽然相比那两个拉是拉了点。都被戏称美版豆包了,不过用还是能用的。3.5 Pro 应该也要来了,AI Studio里面的哈基米用起来是越发不习惯了,在 Antigravity 里用,交互效果还是可以的。 **🌟 知音难求,自我修炼亦艰,抓住前沿技术的机遇,与我们一起成为创新的超级个体(把握AIGC时代的个人力量)**。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册