首页 文章 精选 留言 我的

精选列表

搜索[about],共2047篇文章
优秀的个人博客,低调大师

About MapReduce

MapReduce:一种可用于数据处理的编程模型。Hadoop可以运行各种语言版本的MapReduce程序。接下来可能看到Java、Ruby、Python和C++语言版本的同一个程序。MapReduce程序本质上是并行运行的,因此可以将大规模的数据分析任务分发给任何一个拥有足够多机器的数据中心。MapReduce 的优势在于处理大规模的数据集。 书中以气象数据集为例,此不作改变 取例气象数据中:每一行是一条记录。 每年的数据再拼接成一个单独的文件。 使用Unix工具分析数据:下面小程序提取某一个值并进行比较取最大值 awk:非常强大的文本操纵工具,sed,awk,grep 这个三个命令 都是操作文本文件的 unix系统有几个非常命令的特点: 1. 对于内核而言,unix文件都是字节序列。io设备也是文件。 2. 至于文件的含义交由应用程序来解释。其中文本文件非常重要,因为unix提供 很多了实用程序(utility),这些程序功能相对独立,但可以通过管道来实现进程间通信(IPC),这样松散的耦合可以完成复杂的操作。那么进程间的通信的数据格式是怎样的呢? 其实对于实用程序而言,这个数据格式就是简单的文本文件。此外,还有IO重定向,也是一个不错的创意。至于文本文件中的内容采用什么格式呢?这个很具体的命令有关,那么操作文本就变得非常重要。grep,sed和awk就是三个操纵文本文件的命令 grep搜索 sed 修改和编辑文本文件中某些行 awk 是访问文本文件,操纵文本文件中某些数据 明白了吗? 摘自:https://zhidao.baidu.com/question/301782640.html?fr=iks&word=awk&ie=gbk #! /usr/bin/env bash for year in all/* do echo -ne `basename $year .gz`"\t" gunzip -c $year | \ awk`{temp = substr($0, 88, $) + 0; q = substr($0, 93, 1); if(temp != 9999 && q - /[01459]/&& temp > max) max = temp} End{print max}' done 这个脚本循环遍历按年压缩的数据文件,首先是显示年份,然后使用awk处理每一个文件。awk从数据中提取两个字段气温和质量代码。气温值加0后转换为整数。接着测试气温值是否有效(用9999替代NCDC数据集中的缺失的值),通过质量代码来检测读取的数据值是否有疑问或错误。如果数据读取正确,那么该值将于目前读取到的最大气温值进行比较,如果该值比原先的最大值大,就替换目前的最大值。处理完问价那种所有的行后,在执行END块中的代码并在屏幕上输出最大气温值。 使用Hadoop来分析数据 map和recude MapReduce任务过程分为两个处理阶段:map阶段和reduce阶段。每个阶段都以键值对作为输入和输出。其类型由程序员来选择。程序员还需要写两个函数:map 函数和reduce函数。 map阶段的输入是原始数据。选择文本格式作为输入格式,将数据集的每一行作为文本输入。键是某一行起始位置相对于文件起始位置的偏移量,不过我们不需要这个信息,所以将其忽略。 2.3.2

优秀的个人博客,低调大师

About me

I love reading books and exploring the real/true side of the issues from my very different perspectives. My professional experiences are around OOAD&UML, ASP.NET, C#,.NET Debugging, CLR, in particular .NET architecture. I have been working for .NET related jobs for more than six years, and I would love to share my thoughts and experiences with people who are interested in the same sorts of area. I am keen to exchange some ideas and exploring technical issues with you together, please feel free to contact me via my personal technology blog site http://justinw.cnblogs.com or email me through justinw@live.cn.I am looking forward to hearing your feedback. 嗜书如命,精于OOAD/UML、ASP.NET、C#、.NET Debugging、CLR,喜欢探索问题的本质,尤其是.NET的底层架构。我从事.NET相关的工作已经7年有余,喜欢通过技术文章跟同仁交流和分享技术心得,你可以通过我的个人技术博客(http://justinw.cnblogs.com/)联系我。 本文转自Justin博客园博客,原文链接:http://www.cnblogs.com/justinw/archive/2009/05/17/AboutMe.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

About the Mean Shift

Mean Shift算法,一般是指一个迭代的过程。即先算出当前点的偏移均值,移动该点到其偏移均值,然后以此为新的起始点,继续移动,直到满足一定的条件结束。 meanshift可以被用来做目标跟踪和图像分割。 参考《Mean Shift:A Robust Approach Toward Feature Space Analysis》 公式就不写了。meanshift其实原理挺简单的,就是随便找个种子点,然后开始在该种子点邻域内寻找其目标点的密度中心,那么种子点到密度中心点的向量方向就是密度上升方向了,更新密度中心点为种子点,迭代,直到到达截止条件(opencv里的meanshift把截止条件定为迭代次数和截止精度,当然这两者可以随意组合)。 改进的meanshift使用了核函数(区别种子点附近和远处点的权重)和权重系数(区别不同样本的权重),但基本原理还是一样的。 这篇论文很长,在实现该方法的同时,同时系统地证明了meanshift算法是沿着最大密度梯度方向搜索的,并且随着多次迭代,种子点趋于稳定。 其实在上面讲述的时候去掉了一个背景,就是所有样本都采样自概率密度函数,但这并不影响我们理解其原理。 通过分析meanshift的原理,其目的就是寻找局部最优点,这样很容易联想到它在图像分割或聚类上的应用。 对于图像处理方面的应用,其样本可认为是(x,y),x值二维坐标,y是颜色空间(p维,maybe 1or3),那么总维数是p+2。 meanshift也可用作图像平滑,但是对每一个像素点操作用迭代截止值代替,算法复杂度肯定很高了。 用meanshift算法做目标跟踪时,先预先取一个目标矩形框,在目标移动的时候,就会迭代更新密度中心点到当前目标的密度中心,这样只是一个固定的矩形框的局部范围搜索,算法复杂度肯定可以接受,实时性就不错了。但是通过分析发现用meanshift做跟踪的话,目标突然消失又突然出现,这个算法就凉凉了,所以换句话说,目标必须连续移动。 关于用meanshift做图像分割,后面详细介绍: 一、Mean Shift算法概述 Mean Shift算法又称均值漂移算法,Mean Shift的概念最早是由Fukunage在1975年提出的,在后来又由Yzong Cheng对其进行扩充,主要提出了两点改进: 定义了核函数; 增加了权重系数。 核函数的定义使得偏移向量的贡献随着样本与被偏移点的距离的不同而不同。 权重系数使得不同样本的权重不同。Mean Shift算法在聚类,图像平滑,分割以及视频跟踪等方面有广泛的应用。 二、算法原理 2.1、核函数 核函数性质参见:http://www.cnblogs.com/liqizhou/archive/2012/05/11/2495788.html 在Mean Shift算法中引入核函数的目的是:随着样本与被偏移点距离的不同,其偏移量对均值偏移向量的贡献也不同。核函数是机器学习中常用的一种方式,核函数的定义如下: 常用的核函数有高斯核函数。高斯核函数如下所示: 其中,h称为带宽(bandwidth),不同带宽的核函数如下图所示: 附上画出上图的python代码: import matplotlib.pyplot as plt import math def cal_Gaussian(x, h=1): molecule = x * x denominator = 2 * h * h left = 1 / (math.sqrt(2 * math.pi) * h) return left * math.exp(-molecule / denominator) x = [] for i in range(-40,40): x.append(i * 0.5); score_1 = [] score_2 = [] score_3 = [] score_4 = [] for i in x: score_1.append(cal_Gaussian(i,1)) score_2.append(cal_Gaussian(i,2)) score_3.append(cal_Gaussian(i,3)) score_4.append(cal_Gaussian(i,4)) plt.plot(x, score_1, 'b--', label="h=1") plt.plot(x, score_2, 'k--', label="h=2") plt.plot(x, score_3, 'g--', label="h=3") plt.plot(x, score_4, 'r--', label="h=4") plt.legend(loc="upper right") plt.xlabel("x") plt.ylabel("N") plt.show() 2.2、Mean Shift算法的核心思想 2.2.1、基本原理 对于Mean Shift算法,是一个迭代的过程,即先算出当前点的偏移均值,将该点移动到此偏移均值,然后以此为新的起始点,继续移动,直到满足最终的条件。 以上是官方的说法,即书上的定义,个人理解就是,在d维空间中,任选一个点,然后以这个点为圆心,h为半径做一个高维球,因为有d维,d可能大于2,所以是高维球。落在这个球内的所有点和圆心都会产生一个向量,向量是以圆心为起点落在球内的点位终点。然后把这些向量都相加。相加的结果就是Meanshift向量。 步骤1:在指定的区域内计算偏移均值(下图中黄色的圈) 步骤2:移动该点到偏移均值点处(如图,其中黄色箭头就是Mh(meanshift向量)) 再以meanshift向量的终点为圆心,再做一个高维的球。如下图所以,重复以上步骤,就可得到一个meanshift向量。如此重复下去,meanshift算法可以收敛到概率密度最大得地方。也就是最稠密的地方。 步骤3: 重复上述的过程(计算新的偏移均值,移动) 步骤4:满足最终的条件,即退出。下图便是最终的结果! 从上述过程可以看出,在Mean Shift算法中,最关键的就是计算每个点的偏移均值,然后根据新计算的偏移均值更新点的位置。 2.2.2、基本的Mean Shift向量形式 2.2.3、改进的Mean Shift向量形式 2.3、Mean Shift算法的解释 在Mean Shift算法中,实际上是利用了概率密度,求得概率密度的局部最优解。 2.3.1、概率密度梯度 2.3.2、Mean Shift向量的修正 2.4、Mean Shift算法流程 --------------------------------------------------------------------------------------------------------------------------------分割线(始)---------------------------------------------------------------------------------------------------------------------------------- 附: 关于Mean Shift的推导,再来一个版本。总结在这里便于对比。也可以去看原文:http://www.cnblogs.com/liqizhou/archive/2012/05/12/2497220.html 首先,通过核函数等,将meanshift算法变形为: (1) K()是核函数,h为半径,Ck,d/nhd为单位密度,要使得上式f得到最大,最容易想到的就是对上式进行求导,的确meanshift就是对上式进行求导: (2) 令: K(x)叫做g(x)的影子核,名字听上去挺深奥的,也就是求导的负方向,那么上式可以表示为: 对于上式,如果才用高斯核,那么,第一项就等于fh,k 第二项就相当于一个meanshift向量的式子: 那么(2)就可以表示为 下图分析的构成,如图,可以很清晰的表达其构成。 要使得=0,当且仅当=0,可以得出新的圆心坐标: (3) 上面介绍了meanshift的流程,下面具体给出它的算法流程。 选择空间中x为圆心,以h为半径为半径,做一个高维球,落在所有球内的所有点xi 计算,如果<ε(人工设定),推出程序。如果>ε, 则利用(3)计算x,返回1。 下面介绍meashift算法怎样运用到图像上的聚类和跟踪: 一般一个图像就是个矩阵,像素点均匀的分布在图像上,就没有点的稠密性。所以怎样来定义点的概率密度,这才是最关键的。 如果我们就算点x的概率密度,采用的方法如下:以x为圆心,以h为半径。落在球内的点位xi定义二个模式规则。 (1)x像素点的颜色与xi像素点颜色越相近,我们定义概率密度越高。 (2)离x的位置越近的像素点xi,定义概率密度越高。 所以定义总的概率密度,是二个规则概率密度乘积的结果,可以用公式(4)表示: (4) 其中:代表空间位置的信息,离远点越近,其值就越大,表示颜色信息,颜色越相似,其值越大。如图左上角图片,按照(4)计算的概率密度如图右上。利用meanshift对其聚类,可得到左下角的图。 --------------------------------------------------------------------------------------------------------------------------------分割线(末)---------------------------------------------------------------------------------------------------------------------------------- 三、实验 3.1、实验数据 附上画图的python代码(注意,需要相应路径存放data): import matplotlib.pyplot as plt f = open("data") x = [] y = [] for line in f.readlines(): lines = line.strip().split("\t") if len(lines) == 2: x.append(float(lines[0])) y.append(float(lines[1])) f.close() plt.plot(x, y, 'b.', label="original data") plt.title('Mean Shift') plt.legend(loc="upper right") plt.show() 3.2 实验源码 import math import sys import numpy as np MIN_DISTANCE = 0.000001#mini error def load_data(path, feature_num=2): f = open(path) data = [] for line in f.readlines(): lines = line.strip().split("\t") data_tmp = [] if len(lines) != feature_num: continue for i in range(feature_num): data_tmp.append(float(lines[i])) data.append(data_tmp) f.close() return data def gaussian_kernel(distance, bandwidth): m = np.shape(distance)[0] right = np.mat(np.zeros((m, 1))) for i in range(m): right[i, 0] = (-0.5 * distance[i] * distance[i].T) / (bandwidth * bandwidth) right[i, 0] = np.exp(right[i, 0]) left = 1 / (bandwidth * math.sqrt(2 * math.pi)) gaussian_val = left * right return gaussian_val def shift_point(point, points, kernel_bandwidth): points = np.mat(points) m,n = np.shape(points) #计算距离 point_distances = np.mat(np.zeros((m,1))) for i in range(m): point_distances[i, 0] = np.sqrt((point - points[i]) * (point - points[i]).T) #计算高斯核 point_weights = gaussian_kernel(point_distances, kernel_bandwidth) #计算分母 all = 0.0 for i in range(m): all += point_weights[i, 0] #均值偏移 point_shifted = point_weights.T * points / all return point_shifted def euclidean_dist(pointA, pointB): #计算pointA和pointB之间的欧式距离 total = (pointA - pointB) * (pointA - pointB).T return math.sqrt(total) def distance_to_group(point, group): min_distance = 10000.0 for pt in group: dist = euclidean_dist(point, pt) if dist < min_distance: min_distance = dist return min_distance def group_points(mean_shift_points): group_assignment = [] m,n = np.shape(mean_shift_points) index = 0 index_dict = {} for i in range(m): item = [] for j in range(n): item.append(str(("%5.2f" % mean_shift_points[i, j]))) item_1 = "_".join(item) print(item_1) if item_1 not in index_dict: index_dict[item_1] = index index += 1 for i in range(m): item = [] for j in range(n): item.append(str(("%5.2f" % mean_shift_points[i, j]))) item_1 = "_".join(item) group_assignment.append(index_dict[item_1]) return group_assignment def train_mean_shift(points, kenel_bandwidth=2): #shift_points = np.array(points) mean_shift_points = np.mat(points) max_min_dist = 1 iter = 0 m, n = np.shape(mean_shift_points) need_shift = [True] * m #cal the mean shift vector while max_min_dist > MIN_DISTANCE: max_min_dist = 0 iter += 1 print ("iter : " + str(iter)) for i in range(0, m): #判断每一个样本点是否需要计算偏置均值 if not need_shift[i]: continue p_new = mean_shift_points[i] p_new_start = p_new p_new = shift_point(p_new, points, kenel_bandwidth) dist = euclidean_dist(p_new, p_new_start) if dist > max_min_dist:#record the max in all points max_min_dist = dist if dist < MIN_DISTANCE:#no need to move need_shift[i] = False mean_shift_points[i] = p_new #计算最终的group group = group_points(mean_shift_points) return np.mat(points), mean_shift_points, group if __name__ == "__main__": #导入数据集 path = "./data" data = load_data(path, 2) #训练,h=2 points, shift_points, cluster = train_mean_shift(data, 2) for i in range(len(cluster)): print( "%5.2f,%5.2f\t%5.2f,%5.2f\t%i" % (points[i,0], points[i, 1], shift_points[i, 0], shift_points[i, 1], cluster[i])) 3.3 实验结果 经过Mean Shift算法聚类后的数据如下所示: import matplotlib.pyplot as plt f = open("data_mean") cluster_x_0 = [] cluster_x_1 = [] cluster_x_2 = [] cluster_y_0 = [] cluster_y_1 = [] cluster_y_2 = [] center_x = [] center_y = [] center_dict = {} for line in f.readlines(): lines = line.strip().split("\t") if len(lines) == 3: label = int(lines[2]) if label == 0: data_1 = lines[0].strip().split(",") cluster_x_0.append(float(data_1[0])) cluster_y_0.append(float(data_1[1])) if label not in center_dict: center_dict[label] = 1 data_2 = lines[1].strip().split(",") center_x.append(float(data_2[0])) center_y.append(float(data_2[1])) elif label == 1: data_1 = lines[0].strip().split(",") cluster_x_1.append(float(data_1[0])) cluster_y_1.append(float(data_1[1])) if label not in center_dict: center_dict[label] = 1 data_2 = lines[1].strip().split(",") center_x.append(float(data_2[0])) center_y.append(float(data_2[1])) else: data_1 = lines[0].strip().split(",") cluster_x_2.append(float(data_1[0])) cluster_y_2.append(float(data_1[1])) if label not in center_dict: center_dict[label] = 1 data_2 = lines[1].strip().split(",") center_x.append(float(data_2[0])) center_y.append(float(data_2[1])) f.close() plt.plot(cluster_x_0, cluster_y_0, 'b.', label="cluster_0") plt.plot(cluster_x_1, cluster_y_1, 'g.', label="cluster_1") plt.plot(cluster_x_2, cluster_y_2, 'k.', label="cluster_2") plt.plot(center_x, center_y, 'r+', label="mean point") plt.title('Mean Shift 2') #plt.legend(loc="best") plt.show() 推荐链接: https://blog.csdn.net/ttransposition/article/details/38514127 https://spin.atomicobject.com/2015/05/26/mean-shift-clustering/ https://github.com/mattnedrich/MeanShift_py

优秀的个人博客,低调大师

Some about JBOSS dir

前言 Jboss4.X与Jboss5.x在架构、原理、目录上都有很大的不同,本文主要是对其中一些目录和文件进行注释,以辅助当前项目中定制Jboss的技术难点的解决。 文中使用版本为: Jboss-4.2.3.GA Jboss-5.0.1-GA 自定义版jboss(原型为4.X) %JBOSS_HOME%目录 1、目录基本一致,5.x的多了一个comom目录,为各个server的共有lib,而各个server仅保留其特有的jar,减少了冗余度,结构更加合理! 2、client目录: 保存 Java 客户端应用或外部 web 容器(在Jboss 之外运行),所需的配置文件和 Jar 文件。 %JBOSS_HOME%/server/default目录 1、相同目录为:conf、deploy、lib,这也是4.2.3的目录。 2、不同目录: 5.X目录多了一个deployer目录,作用待了解。 自定义版为jboss运行以后的目录结构故会多出data、log、tmp、work四个目录。 %JBOSS_HOME%/server/default/conf目录部分文件及目录解析 jboss-service.xml:定义核心服务及其配置。 jndi.properties :InitialContext属性,InitialContext被无参数构造函数创建时会被使用到。 props目录 :这个目录包含了jmx-console所需的用户和角色配置文件。 standardjboss.xml :提供了JBoss默认容器配置。 standardjbosscmp-jdbc.xml:这个文件提供了JBossCMP引擎的默认配置文件。 xmdesc目录 :包含了JBoss-service.xml中定义的服务的XMBean描述文件。 5.X多出的文件: jbossjta-properties.xml、bootstrap.xml、jax-ws-catalog.xml、java.policy、bootstrap目录 %JBOSS_HOME%/server/default/deploy目录部分文件及目录解析 待续。。。 本文转自danni505 51CTO博客,原文链接:http://blog.51cto.com/danni505/146411,如需转载请自行联系原作者

优秀的个人博客,低调大师

Know about Oracle RAC Heartbeat

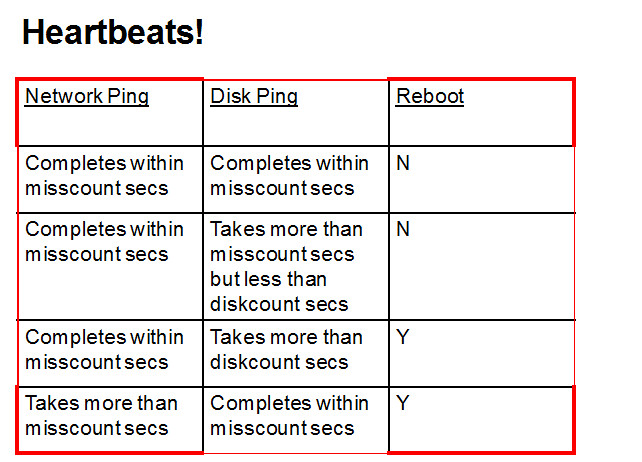
Oracle CRS的心跳主要分为Disk和Network Heartbeat,不同种类的心跳超时会对RAC造成不同的影响。 Heartbeat Mechanisms Disk Heartbeat ( Voting device ) – IOT Network Heartbeat ( across the interconnect ) – misscount Misscount – max time a heartbeat can be missed before entering into a cluster reconfig to evict a node IOT – internal I/O timeout, in seconds where an I/O to the disk must complete IOT = misscount [ during initial cluster formation time] IOT = disktimeout [ all other times ] Hardware Storage timeout Software Storage timeout OCFS Heartbeat timeouts disktimeout > max(O2CB_HEARTBEAT_THRESHOLD * 2, HW_STORAGE_TIMEOUT, SW_STORAGE_TIMEOUT) 本文转自maclean_007 51CTO博客,原文链接:http://blog.51cto.com/maclean/1277852

优秀的个人博客,低调大师

Everything you should know about etcd

前言 etcd 是一个在Docker相关场景中使用非常流行的服务发现组件,在分布式的场景中,服务发现组件起着重要的作用,通常服务发现服务会扮演如下几种不同的角色。 服务发现 在分布式系统的中,以松耦合的方式提供不同组件之间的访问、配置等信息。在某些微服务框架中例如springcloud也可以用来封装进行负载均衡的软实现。 分布式锁在分布式系统中,锁的实现需要依赖中间件进行,而服务发现系统最大的特点在于对小规模、热数据的处理,读写高频。在某些系统中需要有主从节点的场景中,可以借助分布式锁的方式,快速高效的实现。 消息订阅 在分布式系统中,系统的水平伸缩依赖于状态的剥离,而状态的剥离是基于数据的分布式共享,通常情况下数据会通过中间件的方式进行存储、传输,,例如:缓存类(例如:redis)、存储类(例如:mysql)、消息类(例如:ra

优秀的个人博客,低调大师

(zhuan) Some Talks about Dual Learning

研究|对偶学习:一种新的机器学习范式 this blog copy from:http://www.msra.cn/zh-cn/news/blogs/2016/12/dual-learning-20161207.aspx 秦涛 作者简介 秦涛博士,现任微软亚洲研究院主管研究员。他和他的小组的研究领域是机器学习和人工智能,研究重点是深度学习和强化学习的算法设计、理论分析及在实际问题中的应用。他在国际顶级会议和期刊上发表学术论文80余篇,曾任SIGIR、ACML、AAMAS领域主席,担任多个国际学术大会程序委员会成员,包括ICML、NIPS、KDD、IJCAI、AAAI、WSDM、EC、SIGIR、AAMAS、WINE,曾任多个国际学术研讨会联合主席。他是IEEE、ACM会员,中国科学技术大学兼职教授和博士生导师。 问题:如何降低对大规模标注数据的依赖性 近年来,以深度学习为代表的人工智能技术取得了长足的进步,在很多应用取得了巨大的成功。在图像识别中,深度学习已经超过了人类的水平,最近微软刚刚宣布在语音识别中也超过了人类的平均水平,在机器翻译中基于深度学习的模型也超过了以前的统计机器翻译,另外基于深度学习的阿法狗也打败了围棋世界冠军李世石。 深度学习之所以能够取得巨大的成功,一个非常重要的因素就是大数据,特别是大规模的带标签的数据。例如在图像识别中,深度神经网络使用上百万的带标签的图像进行训练,在机器翻译中我们会用上千万的双语句对进行训练,在围棋中我们会用上千万的专业棋手的落子进行训练……这种做法有两个局限性。首先,人工标注获取标签的代价很高。例如我们考虑机器翻译这个任务:现在市场人工翻译一个单词的价格差不多是5到10美分,如果一个句子的平均长度为三十个单词,那么1000万个句子人工翻译的代价差不多是7.5美分×30×1000万,约等于2200万美元。现在一个商业公司的翻译引擎通常支持上百种语言的相互翻译,为了训练这样规模的翻译模型,人工标注的代价就会达到上千亿美元。其次,在很多任务中,我们没办法收集到大规模的标注数据,例如在医疗中或在小语种的相互翻译。为了使深度学习能够取得更广泛的成功,我们需要降低其对大规模标注数据的依赖性。为了解决这个问题,我们提出了一种新的学习范式,我们把它称作对偶学习。 另辟蹊径,将未标注数据用起来 我们注意到,很多人工智能的应用涉及两个互为对偶的任务,例如机器翻译中从中文到英文翻译和从英文到中文的翻译互为对偶、语音处理中语音识别和语音合成互为对偶、图像理解中基于图像生成文本和基于文本生成图像互为对偶、问答系统中回答问题和生成问题互为对偶,以及在搜索引擎中给检索词查找相关的网页和给网页生成关键词互为对偶。这些互为对偶的人工智能任务可以形成一个闭环,使从没有标注的数据中进行学习成为可能。 对偶学习的最关键一点在于,给定一个原始任务模型,其对偶任务的模型可以给其提供反馈;同样的,给定一个对偶任务的模型,其原始任务的模型也可以给该对偶任务的模型提供反馈;从而这两个互为对偶的任务可以相互提供反馈,相互学习、相互提高。 下面我们还是以机器翻译为例子来说明对偶学习的基本思想。 考虑一个对偶翻译游戏,里面有两个玩家小明和爱丽丝,如下图所示。小明只能讲中文,爱丽丝只会讲英文,他们两个人一起希望能够提高英文到中文的翻译模型f和中文到英文的翻译模型g。给定一个英文的句子x,爱丽丝首先通过f把这个句子翻译成中文句子y1,然后把这个中文的句子发给小明。因为没有标注,所以小明不知道正确的翻译是什么,但是小明可以知道,这个中文的句子是不是语法正确、符不符合中文的语言模型,这些信息都能帮助小明大概判断翻译模型f是不是做的好。然后小明再把这个中文的句子y1通过翻译模型g翻译成一个新的英文句子x1,并发给爱丽丝。通过比较x和x1是不是相似,爱丽丝就能够知道翻译模型f和g是不是做得好,尽管x只是一个没有标注的句子。因此,通过这样一个对偶游戏的过程,我们能够从没有标注的数据上获得反馈,从而知道如何提高机器学习模型。 ​ 实际上这个对偶游戏和强化学习的过程比较类似。在强化学习中,我们希望提高我们的策略以最大化长远的回报,但是没有标注的样本告诉我们在某个状态x哪个动作y是正确的。我们只有通过使用这个策略在不同的状态下执行不同的动作,观测该动作带来的回报,从而改善我们的策略。在以上这个翻译对偶游戏中,两个翻译模型就是我们的策略,因为没有标注的双语句对,所以我们不能直接改善它们。这个对偶游戏把一个没有标注的句子x,先翻译成另外一种语言的句子y1,再翻译回来为x1,这里x就是强化学习中的状态,y1和x1就是我们的策略所执行的动作,x和x1的相似度就是我们获得的回报。 我们可以用已有的强化学习的算法来训练我们这两个翻译模型,比如策略梯度方法。策略梯度方法的基本思想非常简单:如果我们在执行某个动作之后,观测到了一个很大的回报,我们就通过调整策略(在当前策略函数的参数上加上它的梯度)来增加这个状态下执行这个动作的概率;相反,如果我们在执行某个动作之后,观测到了一个很小的回报,甚至是负的回报,那么我们就需要调整策略(在当前策略函数的参数上减去它的梯度),以降低在这个状态下执行这个动作的概率。 实测与展望 我们在一个英语-法语翻译的公共数据集上测试了对偶学习的有效性,并和当前最好的算法(NMT,基于深度神经网络算法)进行了对比。这个数据集的训练集有1200万个英法的双语句对,NMT用了所有的1200万个双语句对训练模型。我们的对偶算法只用了不到10%的双语句对初始化两个翻译模型f和g,再用没有标注的英法语句进行训练。如下图所示,我们的对偶学习算法只用10%的标注数据就达到了和NMT用上所有标注数据而取得的相似的甚至更好的翻译准确度,也就是说我们可以把数据标注的代价从2000万美元降到200万美元左右。这个结果说明了我们提出的对偶学习方法能够非常有效地利用未标注的数据。 ​ 对偶学习的基本思想是两个对偶的任务能形成一个闭环反馈系统,使我们得以从未标注的数据上获得反馈信息,进而利用该反馈信息提高对偶任务中的两个机器学习模型。该思想具有普适性,可以扩展到多个相关任务上面,前提是只要它们能形成一个闭环反馈系统。例如,从中文翻译到英文,然后从英文翻译到日文,再从日文翻译到中文。另外一个例子是从图片转化成文字,然后从文字转成语音,再从语音转化成图片。 对偶学习(dual learning)和已有的学习范式有很大的不同。首先,监督学习(supervised learning)只能从标注的数据进行学习,只涉及一个学习任务;而对偶学习涉及至少两个学习任务,可以从未标注的数据进行学习。其次,半监督学习(semi-supervised learning)尽管可以对未标注的样本生成伪标签,但无法知道这些伪标签的好坏,而对偶学习通过对偶游戏生成的反馈(例如对偶翻译中x和x1的相似性)能知道中间过程产生的伪标签(y1)的好坏,因而可以更有效地利用未标注的数据。我们甚至可以说,对偶学习在某种程度上是把未标注的数据当作带标签的数据来使用。第三,对偶学习和多任务学习(multi-task learning)也不相同。尽管多任务学习也是同时学习多个任务共的模型,但这些任务必须共享相同的输入空间,而对偶学习对输入空间没有要求,只要这些任务能形成一个闭环系统即可。第四,对偶学习和迁移学习(transfer learning)也很不一样。迁移学习用一个或多个相关的任务来辅助主要任务的学习,而在对偶学习中,多个任务是相互帮助、相互提高,并没有主次之分。因此,对偶学习是一个全新的学习范式,我们预计其会对机器学习领域产生很大的影响,特别是考虑到以下两个点。 第一, 很多深度学习的研究人员认为人工智能和深度学习的下一个突破是从未标注的数据进行学习。由于未标注的数据没有标签信息,无监督学习主要聚焦在聚类、降维等问题,因此,如何从未标注的数据进行端到端的学习(把数据映射到标签,如分类、预测等任务)一直没有很好方法。我们提出的对偶学习提供了一个利用未标注数据进行端到端学习的有效方式。 第二, 近年来强化学习取得了很大的成功,吸引了众多的研究人员和工业界人员的关注。但是到目前为止,强化学习的成功主要是在各种游戏上,因为在游戏中规则定义得非常清楚,并且很容易通过玩大量的游戏获取回报信息(例如Atari游戏中每一步的得分,围棋中最后的输赢),从而改善游戏策略。然而在游戏以外的实际应用中并没有规范定义的规则,也很难获得回报信息(或者获取的代价很高),因而强化学习在复杂的实际应用中的成功还是比较有限。而对偶学习提供了一种为强化学习获取奖励信息的方式,并证实了强化学习在复杂应用(如翻译)中成功的可能。 更多详细信息可参见我们NIPS 2016 论文。Di He, Yingce Xia, Tao Qin, Liwei Wang, Nenghai Yu, Tie-Yan Liu, and Wei-Ying Ma, Dual Learning for Machine Translation, NIPS 2016. (https://papers.nips.cc/paper/6469-dual-learning-for-machine-translation ) 对偶学习推动人工智能的新浪潮 刘铁岩 this blog from:http://weibo.com/ttarticle/p/show?id=2309404055907557312894 谢谢大家,感谢组委会的邀请,让我有这个机会与大家分享我们的研究工作。我刚才坐在台下聆听了孙茂松老师和 David 的报告,都获益匪浅。首先,老师非常全面的回顾了机器翻译的历史,又有高屋建瓴的讨论,让我们从中学到了很多的东西。其次,很荣幸我的报告排在 David 之后,做优化和机器学习的同事们应该都非常熟悉 David 的 No Free Lunch Theory,尤其在今天全世界都希望用神经网络这「一招鲜」来解决所有问题的时候,更应该仔细琢磨一下这个定理,对大家会有很大的启示。 今天我分享的主题是对偶学习。在对这个主题进行深入讨论之前,我想同大家一起回顾一下最近这段时间人工智能领域的一些飞速发展。我举几个例子,首先是语音识别。 ​ 可能很多同学都看到过这则新闻,微软研究院在语音识别方面取得了重大突破,第一次机器学习算法在日常对话场景下取得了和人一样好的语音识别能力,词错误率降低至 5.9%。 第二个例子是有关图像识别和物体分割,在这方面微软研究院同样也有世界领先的研究成果。 ​ 2015 年,我们研究院发明的 ResNet 算法在 ImageNet 比赛中力拔头筹,超过了人类的识别水平。人眼辨识图像的错误率大概为 5.1%,而 ResNet 的错误率低至 3.5%。今年,在 COCO 物体分割竞赛中,我们研究院同样获得了第一名,和第二名拉开了很大的差距。物体分割比图像分类更难,不但要识别出图片里有什么,还要能够把它的轮廓勾勒出来。 第三个例子是机器翻译,最近相关产业界的发展突飞猛进。这一方向微软同样有着世界领先的技术。 ​ 比如在微软的 Skype Translator 软件里,对话双方可以用不同语言进行交流,系统实现实时语音翻译。如果今天会场上大家使用 Skype Translator 的话,可能就不需要聘请同声传译公司了。 第四个例子,最近这段时间人工智能之所以吸引了那么多的眼球,一个重要原因就是它在一些需要极高智商的比赛中取得了关键性胜利。比如 AlphaGo 4:1 战胜了围棋世界冠军李世石。在这场人机大战之后,DeepMind 的科学家没有停止他们的训练,据说今天的 AlphaGo 已经达到了人类专业围棋十三段的水平,十三段对决九段那简直就是秒杀。 人工智能的这些成果非常令人振奋,那么这些成果背后又是怎样的技术呢?这就不得不提到深度学习和增强学习。 ​ 深度学习使用的是非常复杂,层次很深,容量很大的非线性模型,如深层神经网络,这样的模型可以很好的拟合大量的训练数据,从而在很多识别任务中表现突出。增强学习是一种持续学习技术,它不断地和环境进行交互,根据环境的反馈更新模型。这两种技术还可以相互结合,我们称之为深度增强学习。AlphaGo 背后的核心技术就是深度增强学习。那么,到底深度学习和增强学习是不是真的已经非常完美,可以解决我们面临的所有人工智能问题呢? 其实答案是否定的。仔细分析一下,就会发现这两项技术都存在本质的弱点。首先,目前深度学习的成功离不开大量的有标签训练数据。但是获得海量有标签数据的代价是非常高的,在某些特定的邻域甚至是不可能完成的任务。比如医疗领域的疑难杂症,本身样本就非常少,有钱也无法取得大量的有标签数据。正所谓成也萧何,败也萧何,大数据推动了深度学习的成功,但也成为了深度学习进一步发展的瓶颈。其次,增强学习虽然不需要利用传统意义上的有标签数据,但是它的学习效率并不高,需要跟环境进行大量交互从而获得反馈用以更新模型。然而,有时和环境的频繁交互并不现实。比如,在我们学开车的时候,依赖于频繁地和环境(周围的路况,其他的车辆)进行交互是很危险的,可能还没学会开车就已经发生交通事故了。这就解释了为什么增强学习取得成功的领域很多都是模拟环境,比如说打电子游戏、下围棋等等,它们规则明确,可以无限次重复。但当把增强学习应用到一些实际场景里,需要和实际用户进行交互,还可能带有无法挽回的风险,是不是还能取得同样的效果呢?目前还没有被证实。 ​ 了解了深度学习和增强学习的弱点以后,我们不禁要问:有没有一种新的学习范式可以克服他们的弱点?能否可以不依赖于那么多有标签的数据,能否不需要跟真实环境做那么多次交互,就可以学到有效的模型?为了回答这个问题,我们首先来对现有的人工智能任务做一个仔细的分析。 ​ 通过分析,我们发现了一个非常重要的现象:现实中,有意义、有实用价值的人工智能任务,往往是成对出现的。比如在做机器翻译的时候,我们关心从英语翻译到汉语,我们同样也关心从汉语翻译回英语。再比如,在语音领域,我们既关心语音识别的问题,也关心语音合成的问题(TTS)。图像领域,我们既关心图像识别,也关心图像生成。类似这样的对偶任务还有很多,比如在对话引擎、搜索引擎等场景中都有对偶任务。这种现象给了我们什么启示呢? 第一点,由于存在特殊的对偶结构,两个任务可以互相提供反馈信息,而这些反馈信息可以用来训练深度学习模型。也就是说,即便没有人为标注的数据,有了对偶结构,我们也可以做深度学习了。第二,这两个对偶任务,可以互相充当对方的环境,这样我们就不必跟真实的环境做交互,这两个对偶任务之间的交互就可以产生有效的反馈信号了。总而言之,如果我们能充分地利用对偶结构,就有望解决刚才提到的深度学习和增强学习的瓶颈——训练数据从哪里来、和环境的交互怎么持续进行下去。 基于以上的思考,我们提出了一个新的学习范式,叫做对偶学习。它的思路非常简单。我们假设学习过程中有两个智能体,其中一个智能体从事的是原任务,就是从 X 到 Y 的学习任务;而另外一个智能体从事的是对偶任务,也就是从 Y 到 X 的学习任务。假如我们把 X 用第一个智能体的模型 F 映射成 Y,再利用第二个智能体的模型 G 把它反映射成 X’。通过比较 X 和 X'我们其实就可以获得非常有用的反馈信号。 ​ 其实这个做法在刚才孙茂松老师的演讲中已经提到过,有人曾经用这种翻过去再翻回来的方式判断机器翻译模型的好坏。如果 X 和 X'的差异很大,就说明这个翻译系统不靠谱,说明模型 F 和 G 至少有一个不好;如果 X 和 X'很接近,就给了我们一个利好的消息,就是这两个模型都不错。除了比较 X 和 X'的差异,其实还有很多其他的反馈信息可以被利用。下面我们以机器翻译为例,做个详细的说明。 ​ 假设我们有一个英文的句子 X,通过翻译模型 F 的作用,得到一个中文句子 Y。那么 Y 作为一个中文句子是不是符合语法,是不是顺畅,X 到 Y 之间的关系是否和英汉词典一致等等,都可以作为反馈信息。同样,当我们用模型 G 把 Y 再变成英文句子 X'以后,也可以去衡量 X'是不是符合语法,是否顺畅、X'与 Y 的关系是否与英汉词典一致,以及 X'和 X 是否相似等等,都可以作为反馈信息。利用这些反馈信息,我们可以使用包括 Policy Gradient 在内的方法,来一轮一轮地更新我们的模型,直到最终得到两个满意的模型。 上面的这个过程可以无限循环下去,每次随机地抽选一个单语语句,做对偶学习,更新模型,然后再抽选下一个单语语句,进行对偶学习。那么这个过程会不会收敛呢?其答案是肯定的,以机器翻译为例,我们可以证明,只要机器翻译模型 F 和 G 的解码部分都使用的是随机算法,比如 beam search,这个对偶学习过程就一定是收敛的,也就是说你最终会学到两个稳定的模型 F 和 G。 那么接下来,我们就来看看这样的稳定模型是否有效。我们对比的算法是一个非常经典的神经机器翻译方法,而且用的是他们自己开源的代码。为了训练这个对比算法,我们使用了全部的双语标注数据。而我们自己提出的对偶学习算法并不需要双语标注数据,用单语数据就可以进行学习和迭代了。不过万事开头难,我们还是要给这个学习过程一个初始化。在初始化过程中,我们使用了 10% 的双语语料训练了一个相对比较弱的模型,然后用对偶学习的迭代过程不断提高它。也就是说,在初始化完成之后,我们就不再使用任何双语的标注语料了,而是靠两个对偶任务互相提供反馈信息进行模型训练。好,那我们来看看实验结果如何。 ​ 这两张图展示了法英和英法翻译的实验结果。以第一张图为例,最左边这根柱子对应的是用 10% 双语语料训练的初始模型;最右边这根柱子对应的是用 100% 双语语料训练的翻译模型。可以看出,初始模型确实比较弱。当我们使用对偶学习的方法,虽然不再利用任何有标注的双语数据,我们仍可以很快的接近甚至超过用百分之百的双语语料训练出来的模型。这个结果非常令人振奋。不仅如此,我们的实验发现,对偶学习更不容易饱和,因为无标签的单语数据非常丰富、非常多样化,因此通过不断调节单语数据源和调整反馈信息,可以持续提高模型的有效性。相反,使用双语语料比较容易饱和,过几遍数据以后,当信息被挖掘得足够充分,想要再提升模型精度就变得非常困难了。 如上这种振奋人心的结果是否只局限在机器翻译领域呢?其他领域是否也可以使用类似的方法得到提升呢?答案是肯定的,前面我提到的很多人工智能的任务都具有对偶结构,因此都可以用对偶学习来解决。 ​ ​ 这张 PPT 展示了在语音识别和语音合成方面如何定义反馈信号,从而进行对偶学习。 ​ 同样,这张 PPT 展示了在图像识别和图像生成方面如何定义反馈信号,从而进行对偶学习。 ​ 而这张 PPT 则展示了在对话引擎方面如何定义反馈信号,从而进行对偶学习。 说到这里,可能很多人会有疑问,虽然我们说对偶学习应用很宽泛,但是我们举的例子都有一个共同特点,就是真实的物理世界里确实存在两个对偶的任务。那么,如果我们要解决的问题并不存在一个天然的对偶任务怎么办?其实这个也没关系,即使没有物理上的对偶性,也可以通过虚拟的对偶性来完成对偶学习。我举两个例子。第一个是在深度神经网络领域常用的 Auto Encoder,仔细分析一下,它其实是对偶学习的一个特例。 ​ Auto Encoder 原本的任务是要学习从输入层到隐层的一个映射(即编码),为了有效地学习这种映射,我们人为添加了一个虚拟任务:就是从隐层到输入层的逆映射(即解码,请注意图中的输出跟输入是一样的数据),这样就形成了机器学习的闭环。如果用对偶学习的语言描述一下,就是这张图:通过人为增加解码回路,使虚拟的对偶性得以成立,从而实现对偶学习。不过需要指出的是,Auto Encoder 和对偶学习有一些小差别,Auto Encoder 只关心单边任务的模型(也就是编码器),而在标准的对偶学习中,我们同时关心两个模型,想把它们都学好。 ​ 另一个例子是最近这两年特别火的——Generative Adversarial Nets(GAN)。它的目标是学习一个图像生成器,为此通过一个鉴别器不断给生成器提供反馈信息(也就是判别生成器生成的东西是真是假)。这样的博弈过程可以获得一个非常有效的图像生成器,用它可以自动制造训练样本来进行深度学习。很显然,GAN 也可以用对偶学习的语言进行描述,并且它也只是对偶学习的一个特例:它只关心单边生成器的有效性,而标准的对偶学习会同时关心生成器和鉴别器的有效性。 到此为止,无论是天然的对偶学习,还是虚拟的对偶学习,都是用来解决无监督学习问题的。那么,如果实际中我们的训练数据已经非常多了,对偶学习的思想还有用吗?我们的答案是:有用,而且非常有用。 让我们来看一下监督学习的例子。我们有一个样本 X,原任务是要预测它的标签 Y。为此,我们可以使用已有的很多监督学习技术加以实现。但如果我们再给它人为增加一条对偶回路会怎样呢?假设存在一个对偶任务,是从标签 Y 到 X 的预测。那么原任务和对偶任务其实存在着非常内在的联系。利用全概率公式和贝叶斯公式我们可以很容易知道,这两个任务背后的条件概率是互相约束的,利用这一点可以构造一个非常强的正则项来提高模型的学习效率。我们在机器翻译上的实验表明,加入这个对偶正则项,翻译模型的 BLEU score 有大幅度的提升。 ​ 同样的道理,对偶学习的思想甚至可以提高 inference 的性能。假设我们的模型已经训练好了,原任务是要用它来做预测。传统的做法是,给定一个样本 X,基于已有模型,寻找能够使其条件概率 P(Y|X) 最大化的 Y 作为 inference 的结果。如果我们运用对偶学习的思想,就会发现问题还可以反过来看。从对偶任务的模型出发,利用贝叶斯公式,同样也可以导出条件概率 P(Y|X) 来。按理说这两个条件概率应该是一致的,但是因为原任务和对偶任务是独立进行的,实际中它们可能并不完全一致,那么如果综合考虑这两个条件概率,我们的置信度会得到提升。相应地,inference 的结果也会得到明显的提升。 到此为止我们介绍了对偶学习在无监督学习上的应用、在没有天然对偶结构时如何使用虚拟回路实现对偶学习、以及如何把对偶学习的思想延展到有监督学习和 inference 之中。 事实上,对偶学习是一个新的学习范式,而不单是一个技巧。它和我们熟知的很多学习范式,如无监督学习、半监督学习、co-training、多任务学习、迁移学习都有联系,又有显著不同。它提供了一个看待这个世界的不同视角,对很多难题提供了新的解题思路。我们非常有信心对偶学习在更多的领域将会取得成功。我们组的同事们正在这个方向上积极探索,也希望在座的各位能够加入我们,一起去推动对偶学习的发展,掀起人工智能的新浪潮,谢谢大家! Reference: 1. http://www.msra.cn/zh-cn/news/blogs/2016/12/dual-learning-20161207.aspx 2.http://weibo.com/ttarticle/p/show?id=2309404055907557312894 3.https://zhuanlan.zhihu.com/p/26996066 4.http://blog.csdn.net/liuyuemaicha/article/details/71698837

优秀的个人博客,低调大师

openstack G Version about snapshot , create ,delete

def create_snapshot(disk_path, snapshot_name): """Create a snapshot in a disk image :param disk_path: Path to disk image :param snapshot_name: Name of snapshot in disk image """ qemu_img_cmd = ('qemu-img', 'snapshot', '-c', snapshot_name, disk_path) # NOTE(vish): libvirt changes ownership of images execute(*qemu_img_cmd, run_as_root=True) def delete_snapshot(disk_path, snapshot_name): """Create a snapshot in a disk image :param disk_path: Path to disk image :param snapshot_name: Name of snapshot in disk image """ qemu_img_cmd = ('qemu-img', 'snapshot', '-d', snapshot_name, disk_path) # NOTE(vish): libvirt changes ownership of images execute(*qemu_img_cmd, run_as_root=True) def extract_snapshot(disk_path, source_fmt, snapshot_name, out_path, dest_fmt): """Extract a named snapshot from a disk image :param disk_path: Path to disk image :param snapshot_name: Name of snapshot in disk image :param out_path: Desired path of extracted snapshot """ # NOTE(markmc): ISO is just raw to qemu-img if dest_fmt == 'iso': dest_fmt = 'raw' qemu_img_cmd = ('qemu-img', 'convert', '-f', source_fmt, '-O', dest_fmt) # Conditionally enable compression of snapshots. if CONF.libvirt_snapshot_compression and dest_fmt == "qcow2": qemu_img_cmd += ('-c',) # When snapshot name is omitted we do a basic convert, which # is used by live snapshots. if snapshot_name is not None: qemu_img_cmd += ('-s', snapshot_name) qemu_img_cmd += (disk_path, out_path) execute(*qemu_img_cmd) waring: execute subprocess.Popen('',shell=True) 本文转自 swq499809608 51CTO博客,原文链接:http://blog.51cto.com/swq499809608/1214702

优秀的个人博客,低调大师

About Cast in C++(C++中的类型转换)

原文:http://hi.baidu.com/_%E2d_%B7%B3_%DE%B2%C2%D2/blog/item/b46a27d9dc50c0ed39012f8f.html C风格(C-style)强制转型如下: (T) exdivssion // cast exdivssion to be of type T 函数风格(Function-style)强制转型使用这样的语法: T(exdivssion) // cast exdivssion to be of type T 这两种形式之间没有本质上的不同,它纯粹就是一个把括号放在哪的问题。我把这两种形式称为旧风格(old-style)的强制转型。 使用标准C++的类型转换符:static_cast、dynamic_cast、reinterdivt_cast、和const_cast。 3.1 static_cast 用法:static_cast < type-id > ( exdivssion ) 该运算符把exdivssion转换为type-id类型,但没有运行时类型检查来保证转换的安全性。它主要有如下几种用法: ①用于类层次结构中基类和子类之间指针或引用的转换。 进行上行转换(把子类的指针或引用转换成基类表示)是安全的; 进行下行转换(把基类指针或引用转换成子类表示)时,由于没有动态类型检查,所以是不安全的。 ②用于基本数据类型之间的转换,如把int转换成char,把int转换成enum。这种转换的安全性也要开发人员来保证。 ③把空指针转换成目标类型的空指针。 ④把任何类型的表达式转换成void类型。 注意:static_cast不能转换掉exdivssion的const、volitale、或者__unaligned属性。 3.2 dynamic_cast 用法:dynamic_cast < type-id > ( exdivssion ) 该运算符把exdivssion转换成type-id类型的对象。Type-id必须是类的指针、类的引用或者void *; 如果type-id是类指针类型,那么exdivssion也必须是一个指针,如果type-id是一个引用,那么exdivssion也必须是一个引用。 dynamic_cast主要用于类层次间的上行转换和下行转换,还可以用于类之间的交叉转换。 在类层次间进行上行转换时,dynamic_cast和static_cast的效果是一样的; 在进行下行转换时,dynamic_cast具有类型检查的功能,比static_cast更安全。 class B{ public: int m_iNum; virtual void foo(); }; class D:public B{ public: char *m_szName[100]; }; void func(B *pb){ D *pd1 = static_cast(pb); D *pd2 = dynamic_cast(pb); } 在上面的代码段中,如果pb指向一个D类型的对象,pd1和pd2是一样的,并且对这两个指针执行D类型的任何操作都是安全的; 但是,如果pb指向的是一个B类型的对象,那么pd1将是一个指向该对象的指针,对它进行D类型的操作将是不安全的(如访问m_szName), 而pd2将是一个空指针。 另外要注意:B要有虚函数,否则会编译出错;static_cast则没有这个限制。 这是由于运行时类型检查需要运行时类型信息,而这个信息存储在类的虚函数表( 关于虚函数表的概念,详细可见)中,只有定义了虚函数的类才有虚函数表, 没有定义虚函数的类是没有虚函数表的。 另外,dynamic_cast还支持交叉转换(cross cast)。如下代码所示。 class A{ public: int m_iNum; virtual void f(){} }; class B:public A{ }; class D:public A{ }; void foo(){ B *pb = new B; pb->m_iNum = 100; D *pd1 = static_cast(pb); //compile error D *pd2 = dynamic_cast(pb); //pd2 is NULL delete pb; } 在函数foo中,使用static_cast进行转换是不被允许的,将在编译时出错;而使用dynamic_cast的转换则是允许的,结果是空指针。 3.3 reindivter_cast 用法:reindivter_cast (exdivssion) type-id必须是一个指针、引用、算术类型、函数指针或者成员指针。 它可以把一个指针转换成一个整数,也可以把一个整数转换成一个指针(先把一个指针转换成一个整数, 在把该整数转换成原类型的指针,还可以得到原先的指针值)。 该运算符的用法比较多。 3.4 const_cast 用法:const_cast (exdivssion) 该运算符用来修改类型的const或volatile属性。除了const或volatile修饰之外,type_id和exdivssion的类型是一样的。 常量指针被转化成非常量指针,并且仍然指向原来的对象; 常量引用被转换成非常量引用,并且仍然指向原来的对象;常量对象被转换成非常量对象。 Voiatile和const类试。举如下一例: class B{ public: int m_iNum; } void foo(){ const B b1; b1.m_iNum = 100; //comile error B b2 = const_cast(b1); b2. m_iNum = 200; //fine } 上面的代码编译时会报错,因为b1是一个常量对象,不能对它进行改变; 使用const_cast把它转换成一个常量对象,就可以对它的数据成员任意改变。注意:b1和b2是两个不同的对象。 == =========================================== == dynamic_cast .vs. static_cast == =========================================== class B { ... }; class D : public B { ... }; void f(B* pb) { D* pd1 = dynamic_cast(pb); D* pd2 = static_cast(pb); } If pb really points to an object of type D, then pd1 and pd2 will get the same value. They will also get the same value if pb == 0. If pb points to an object of type B and not to the complete D class, then dynamic_cast will know enough to return zero. However, static_cast relies on the programmer’s assertion that pb points to an object of type D and simply returns a pointer to that supposed D object. 即dynamic_cast可用于继承体系中的向下转型,即将基类指针转换为派生类指针,比static_cast更严格更安全。dynamic_cast在执行效率上比static_cast要差一些,但static_cast在更宽上范围内可以完成映射,这种不加限制的映射伴随着不安全性。static_cast覆盖的变换类型除类层次的静态导航以外,还包括无映射变换、窄化变换(这种变换会导致对象切片,丢失信息)、用VOID*的强制变换、隐式类型变换等... == =========================================== == static_cast .vs. reinterdivt_cast == ================================================ reinterdivt_cast是为了映射到一个完全不同类型的意思,这个关键词在我们需要把类型映射回原有类型时用到它。我们映射到的类型仅仅是为了故弄玄虚和其他目的,这是所有映射中最危险的。(这句话是C++编程思想中的原话) static_cast和reinterdivt_cast操作符修改了操作数类型。它们不是互逆的;static_cast在编译时使用类型信息执行转换,在转换执行必要的检测(诸如指针越界计算,类型检查).其操作数相对是安全的。另一方面;reinterdivt_cast仅仅是重新解释了给出的对象的比特模型而没有进行二进制转换,例子如下: int n=9; double d=static_cast < double > (n); 上面的例子中,我们将一个变量从int转换到double。这些类型的二进制表达式是不同的。要将整数9转换到双精度整数9,static_cast需要正确地为双精度整数d补足比特位。其结果为9.0。而reinterdivt_cast的行为却不同: int n=9; double d=reinterdivt_cast (n); 这次,结果有所不同.在进行计算以后, d包含无用值.这是因为reinterdivt_cast仅仅是复制n的比特位到d,没有进行必要的分析. 因此,你需要谨慎使用reinterdivt_cast. ============================================================================== 本文转自被遗忘的博客园博客,原文链接:http://www.cnblogs.com/rollenholt/articles/2420407.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Debugexperience about SQLite & LitePal:创建数据库闪退?注意小括号

参考资料:《第一行代码》 源码(码云): 今天在做一个SQLite的Demo,在Create一个数据库的时候居然闪退: UI: 还以为是权限问题结果看一下logcat,额。。。 发现了这一句, 其实就是SQL语句少了一个右括号(第18行): 嗯,编写程序的时候,要细心一点。 *****另外, 在添加表/更改onUpgrade()之后,记得在调用的代码那里(下图第16行),更改第四个参数(version): 不然创建数据库的时候: 一个关于LitePal的Error: 注意mapping标签下要写入正确的完整的类名: 下面是错误的示范: 对应会出现的bug: 正确写法: 另外注意: 1.litepal.xml文件要放在assets目录下; 2.文件须命名为“litepal.xml”,如下图。如果命名为“litepal(没有".xml")”,则会同上一般报错: 参考文档:Android Studio 使用litepal 无法创建数据库

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册