首页 文章 精选 留言 我的

精选列表

搜索[碰撞求解器],共10023篇文章
优秀的个人博客,低调大师

Dcoker安装(在线仓库),最新的服务器搭配容器使用

前言 什么是Docker Docker是一个开源的应用容器引擎,让开发者可以打包他们的应用以及依赖包到一个可移植的镜像中,然后发布到任何流行的Linux或Windows机器上,也可以实现虚拟化。容器是完全使用沙箱机制,相互之间不会有任何接口。 Docker与虚拟机对比 虚拟机 资源占用多,虚拟机会独占一部分内存和硬盘空间。它运行的时候,其他程序就不能使用这些资源了。哪怕虚拟机里面的应用程序,真正使用的内存只有 1MB,虚拟机依然需要几百 MB 的内存才能运行。 冗余步骤多,虚拟机是完整的操作系统,一些系统级别的操作步骤,往往无法跳过,比如用户登录。 启动慢,启动操作系统需要多久,启动虚拟机就需要多久。可能要等几分钟,应用程序才能真正运行。 Docker 启动快,容器里面的应用,直接就是底层系统的一个进程,而不是虚拟机内部的进程。所以,启动容器相当于启动本机的一个进程,而不是启动一个操作系统,速度就快很多。 资源占用少,容器只占用需要的资源,不占用那些没有用到的资源;虚拟机由于是完整的操作系统,不可避免要占用所有资源。另外,多个容器可以共享资源,虚拟机都是独享资源。 体积小,容器只要包含用到的组件即可,而虚拟机是整个操作系统的打包,所以容器文件比虚拟机文件要小很多。 学习注意事项 1.Centos6安装Docker和Centos7安装有所区别 2.本文讲解的是Centos7的安装,所以注意您的操作系统 3.学习Docker之前的知识储备(Linux、Maven) 4.官方安装文档 https://docs.docker.com/install/linux/docker-ce/centos 安装 环境准备 sh 复制代码 # 如果之前安装过Docker请先执行下面命令(当然为了保险起见你也可以执行下) yum remove docker docker-client docker-client-latest docker-common docker-latest docker-latest-logrotate docker-logrotate docker-engine # 安装必要依赖 yum install -y yum-utils 设置镜像仓库并安装 sh 复制代码 # 官方仓库 # yum-config-manager --add-repo https://download.docker.com/linux/centos/docker-ce.repo # 阿里云仓库 yum-config-manager --add-repo https://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo # 更新 # CentOS yum makecache fast # Rocky dnf makecache # 安装 yum install -y docker-ce docker-ce-cli containerd.io # 启动&开机启动 systemctl enable docker --now 常用命令 sh 复制代码 # 启动 systemctl start docker # 停止 systemctl stop docker # 开启自启 systemctl enable docker # 版本查看 docker version # 信息查看 docker info 容器设置 设置容器信息可参考Docker容器配置 一键安装 CentOS sh 复制代码 # 如果之前安装过Docker请先执行下面命令(当然为了保险起见你也可以执行下) yum remove docker docker-client docker-client-latest docker-common docker-latest docker-latest-logrotate docker-logrotate docker-engine # 安装必要依赖 yum install -y yum-utils # 阿里云仓库 yum-config-manager --add-repo https://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo # 更新 yum makecache fast # 安装 yum install -y docker-ce docker-ce-cli containerd.io # 启动&开机启动 systemctl enable docker --now # 版本查看 docker version # 创建配置目录 mkdir -p /etc/docker # 创建配置文件 tee /etc/docker/daemon.json <<-'EOF' { "registry-mirrors": [ "https://docker.m.daocloud.io", "https://uoxl1bwy.mirror.aliyuncs.com" ], "exec-opts":[ "native.cgroupdriver=systemd" ], "log-driver": "json-file", "log-opts": { "max-size": "100m", "max-file":"3" }, "insecure-registries": [ "image.xujun.org:80", "nexus.xujun.org:8088" ], "storage-driver": "overlay2" } EOF # 刷新配置文件 systemctl daemon-reload # 重启Docker systemctl restart docker # 查看信息 docker info Rocky sh 复制代码 # 如果之前安装过Docker请先执行下面命令(当然为了保险起见你也可以执行下) dnf remove docker docker-client docker-client-latest docker-common docker-latest docker-latest-logrotate docker-logrotate docker-engine # 安装必要依赖 dnf install -y yum-utils # 阿里云仓库 dnf config-manager --add-repo https://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo # 更新 dnf makecache # 安装 dnf install -y docker-ce docker-ce-cli containerd.io # 启动&开机启动 systemctl enable docker --now # 版本查看 docker version # 创建配置目录 mkdir -p /etc/docker # 创建配置文件 tee /etc/docker/daemon.json <<-'EOF' { "registry-mirrors": [ "https://docker.m.daocloud.io", "https://uoxl1bwy.mirror.aliyuncs.com" ], "exec-opts":[ "native.cgroupdriver=systemd" ], "log-driver": "json-file", "log-opts": { "max-size": "100m", "max-file":"3" }, "insecure-registries": [ "image.xujun.org:80", "nexus.xujun.org:8088" ], "storage-driver": "overlay2" } EOF # 刷新配置文件 systemctl daemon-reload # 重启Docker systemctl restart docker # 查看信息 docker info

优秀的个人博客,低调大师

spark rdd median 中位数求解

lookup(key) Return the list of values in the RDD for keykey. This operation is done efficiently if the RDD has a known partitioner by only searching the partition that the key maps to. >>> l = range(1000) >>> rdd = sc.parallelize(zip(l, l), 10) >>> rdd.lookup(42) # slow [42] >>> sorted = rdd.sortByKey() >>> sorted.lookup(42) # fast [42] >>> sorted.lookup(1024) [] >>> rdd2 = sc.parallelize([(('a', 'b'), 'c')]).groupByKey() >>> list(rdd2.lookup(('a', 'b'))[0]) ['c'] You need to sort RDD and take element in the middle or average of two elements. Here is example with RDD[Int]: import org.apache.spark.SparkContext._ val rdd: RDD[Int] = ??? val sorted = rdd.sortBy(identity).zipWithIndex().map { case (v, idx) => (idx, v) } val count = sorted.count() val median: Double = if (count % 2 == 0) { val l = count / 2 - 1 val r = l + 1 (sorted.lookup(l).head + sorted.lookup(r).head).toDouble / 2 } else sorted.lookup(count / 2).head.toDouble 实验: all_data = sc.parallelize([25,1,2,3,4,5,6,7,8,100]) all_data.sortBy(lambda x:x).zipWithIndex().map(lambda x: (x[1],x[0])).collect [(0, 1), (1, 2), (2, 3), (3, 4), (4, 5), (5, 6), (6, 7), (7, 8), (8, 25), (9, 100)] 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/7154234.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

python spark 求解最大 最小 平均

rdd=sc.parallelizeDoubles(testData); Now we’ll calculate the mean of our dataset. 1 LOGGER.info("Mean: "+rdd.mean()); There are similar methods for other statistics operation such as max, standard deviation, …etc. Every time one of this method is invoked , Spark performs the operation on the entire RDD data. If more than one operations performed, it will repeat again and again which is very inefficient. To solve this, Spark provides “StatCounter” class which executes once and provides results of all basic statistics operations in the same time. 1 StatCounterstatCounter=rdd.stats(); Now results can be accessed as follows, 1 2 3 4 5 6 7 LOGGER.info("Count:"+statCounter.count()); LOGGER.info("Min:"+statCounter.min()); LOGGER.info("Max:"+statCounter.max()); LOGGER.info("Sum:"+statCounter.sum()); LOGGER.info("Mean: "+statCounter.mean()); LOGGER.info("Variance: "+statCounter.variance()); LOGGER.info("Stdev:"+statCounter.stdev()); 摘自:http://www.sparkexpert.com/tag/rdd/ 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/7154042.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

暴力法求解“微信群覆盖”?

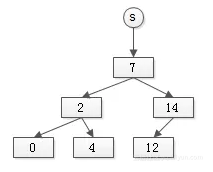
题目:求微信群覆盖 微信有很多群,现进行如下抽象: (1) 每个微信群由一个唯一的gid标识; (2) 微信群内每个用户由一个唯一的uid标识; (3) 一个用户可以加入多个群; (4) 群可以抽象成一个由不重复uid组成的集合,例如: g1{u1, u2, u3} g2{u1, u4, u5} 可以看到,用户u1加入了g1与g2两个群。 画外音,注意: gid和uid都是uint64; 集合内没有重复元素; 假设微信有M个群(M为亿级别),每个群内平均有N个用户(N为十级别). 现在要进行如下操作: (1)如果两个微信群中有相同的用户,则将两个微信群合并,并生成一个新微信群; 例如,上面的g1和g2就会合并成新的群: g3{u1, u2, u3, u4, u5}; 画外音:集合g1中包含u1,集合g2中包含u1,合并后的微信群g3也只包含一个u1。 (2) 不断的进行上述操作,直到剩下所有的微信群都不含相同的用户为止; 将上述操作称:求群的覆盖。 设计算法,求群的覆盖,并说明算法时间与空间复杂度。 画外音:58同城2013年校招笔试题。 对于一个复杂的问题,思路肯定是“先解决,再优化”,大部分人不是神,很难一步到位。先用一种比较“笨”的方法解决,再看“笨方法”有什么痛点,优化各个痛点,不断升级方案。 拿到这个问题,很容易想到的思路是: (1) 先初始化M个集合,用集合来表示微信群gid与用户uid的关系; (2) 找到哪两个(哪些)集合需要合并; (3) 接着,进行集合的合并; (4) 迭代步骤二和步骤三,直至所有集合都没有相同元素,算法结束; 第一步,如何初始化集合? set这种数据结构,大家用得很多,来表示集合: ● 新建 M个set 来表示M个微信群gid ● 每个set插入 N个元素 来表示微信群中的用户uid set有两种最常见的实现方式,一种是树型set,一种是哈希型set。 假设有集合: s={7, 2, 0, 14, 4, 12} 树型set的实现如下: 其特点是: ● 插入和查找的平均时间复杂度是 O(lg(n)) ● 能实现有序查找 ● 省空间 哈希型set实现如下: 其特点是: ● 插入和查找的平均时间复杂度是 O(1) 不能实现有序查找 画外音:求群覆盖,哈希型实现的初始化更快,复杂度是O(M*N)。 第二步,如何判断两个(多个)集合要不要合并? 集合对set(i)和set(j),判断里面有没有重复元素,如果有,就需要合并,判重的伪代码是: // 对set(i)和set(j)进行元素判断并合并 (1) foreach (element in set(i)) (2) if (element in set(j)) merge(set(i), set(j)); 第一行(1)遍历第一个集合set(i)中的所有元素element; 画外音:这一步的时间复杂度是O(N)。 第二行(2)判断element是否在第二个集合set(j)中; 画外音:如果使用哈希型set,第二行(2)的平均时间复杂度是O(1)。 这一步的时间复杂度至少是O(N)*O(1)=O(N)。 第三步,如何合并集合? 集合对set(i)和set(j)如果需要合并,只要把一个集合中的元素插入到另一个集合中即可: // 对set(i)和set(j)进行集合合并 merge(set(i), set(j)){ (1) foreach (element in set(i)) (2) set(j).insert(element); } 第一行(1)遍历第一个集合set(i)中的所有元素element; 画外音:这一步的时间复杂度是O(N)。 第二行(2)把element插入到集合set(j)中; 画外音:如果使用哈希型set,第二行(2)的平均时间复杂度是O(1)。 这一步的时间复杂度至少是O(N)*O(1)=O(N)。 第四步:迭代第二步与第三步,直至结束 对于M个集合,暴力针对所有集合对,进行重复元素判断并合并,用两个for循环可以暴力解决: (1)for(i = 1 to M) (2) for(j= i+1 to M) //对set(i)和set(j)进行元素判断并合并 foreach (element in set(i)) if (element in set(j)) merge(set(i), set(j)); 递归调用,两个for循环,复杂度是O(M*M)。 综上,如果这么解决群覆盖的问题,时间复杂度至少是: O(M*N) // 集合初始化的过程 + O(M*M) // 两重for循环递归 * O(N) // 判重 * O(N) // 合并 画外音:实际复杂度要高于这个,随着集合的合并,集合元素会越来越多,判重和合并的成本会越来越高。 基于“先解决,再优化”的思想,很多优化方向的问题,自然而然的从脑中蹦出: (1) 能不能快速通过元素定位集合? 画外音: 通过集合查元素,哈希型set时间复杂度是O(1); 通过元素查集合(句柄),如何来实现呢? (2) 能不能快速进行集合合并? (3) 能不能一次合并多个集合? 经典数据结构,分离集合(disjoint set),它有三类操作: Make-set(a):生成一个只有一个元素a的集合; Union(X, Y):合并两个集合X和Y; Find-set(a):查找元素a所在集合,即通过元素找集合; 特别适合用来解决这类集合合并与查找的问题,又称为并查集。 如何利用并查集来解决求“微信群覆盖”问题,是后文将要介绍的内容。 画外音:先介绍“并查集”这一种方案,后续再介绍其他方案。 知道并查集的思路和原理,比知道什么是并查集更重要。 算法,其实还是挺有意思的。 原文发布时间为:2018-11-13 本文作者:58沈剑 本文来自云栖社区合作伙伴“架构师之路”,了解相关信息可以关注“架构师之路”。

优秀的个人博客,低调大师

python spark 求解最大 最小 平均 中位数

rating_data_raw = sc.textFile("%s/ml-100k/u.data" % PATH) print rating_data_raw.first() num_ratings = rating_data_raw.count() print "Ratings: %d" % num_ratings # In[35]: rating_data = rating_data_raw.map(lambda line: line.split("\t")) ratings = rating_data.map(lambda fields: int(fields[2])) max_rating = ratings.reduce(lambda x, y: max(x, y)) min_rating = ratings.reduce(lambda x, y: min(x, y)) mean_rating = ratings.reduce(lambda x, y: x + y) / float(num_ratings) median_rating = np.median(ratings.collect()) ratings_per_user = num_ratings / num_users ratings_per_movie = num_ratings / num_movies print "Min rating: %d" % min_rating print "Max rating: %d" % max_rating print "Average rating: %2.2f" % mean_rating print "Median rating: %d" % median_rating print "Average # of ratings per user: %2.2f" % ratings_per_user print "Average # of ratings per movie: %2.2f" % ratings_per_movie # In[36]: # we can also use the stats function to get some similar information to the above ratings.stats() 上面是粗暴的做法 简单的做法: >>> all_data = sc.parallelize([1,2,3,4,5,6,7,8,100]) >>> all_data.mean() 15.11111111111111 >>> all_data.max() 100 >>> all_data.min() 1 >>> all_data.median() Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'RDD' object has no attribute 'median' >>> all_data.stats() (count: 9, mean: 15.1111111111, stdev: 30.0903987804, max: 100.0, min: 1.0) 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/7153889.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

SD 2.0——厂商与山寨的碰撞

因为奥运会的缘故,年底的技术大会扎堆,上周赶了两个技术会议的尾巴——WinHEC和SD 2.0都是最后一天才去。在金融危机的背景下,学习重要,但是客户似乎更重要……WinHEC我会有另外的帖子来说,的确很精彩。 本来计划参加SD 2.0周五和周六的会议,周五想听的课都计划好了——Google API和Map,还有云风的内存、周伟明的多核。Google技术专场里的一个看点就是栾跃老大,想听听这个当年将微软开发流程如庖丁解牛般剖析过的牛人,是如何向大家忽悠Google API的。不过,临时要去客户那里拜访,一切泡汤。 周六早晨早起,根据某不知名GPS指引的近路,从家里到九华,路上很顺利,不过还是跑到了十五区,注册完后,又想当然地去了二层(TechEd之前的会场在二层),耽误了二十分钟,到了会场去听iPhone的课程。平心而论,现场效果一般,不过我不认为是两位开发者技术的问题,可能是比较少讲现场,加上现场比较大,与听众互动比较困难,所以现场效果不好。我问了李亮一个很细节的问题,关于Muti-Touch,他回答的很好,所以我觉得两位以后多历练自己的现场讲演,以后会越来越好的。 下午实在无法忍受赞助商不着边际的忽悠,偶然跑到隔壁去听钱宏武的课。说实话,当时钱宏武在讲Linux+MySQL的Web性能优化,我这辈子估计也不会用着两种技术,吸引我的是那种气场。会场里每个人的头都是伸着的,眼睛都是瞪着的,不可否认,老钱的技术功底是原动力,而演讲的气势则是吸引一屋子人的原因。 当老钱讲到第一次产品升级时汗透衬衣的经历,我恍然觉得自己所在不是SD 2.0的会场,而是水泊梁山的聚义厅。一帮在刀尖上摸爬滚打过来的好汉终于可以在这里松一口气,分享自己在江湖上“杀人越货”的经验了。老钱的确有那种天煞星的气势,而且将自己经验总结得丝丝入扣,可见是下了不少功夫。加上一口一个“哥们”,完全颠覆了程序员那种白面书生的传统形象。 Google Android的压轴戏为厂商方面扳回了不少比分,听完课程之后,第一个感觉Google太像微软了,从Slides到演讲风格,甚至延伸到技术领域,Android也是在Linux之上封装了一个Framework层。总之很成功的演讲,如果没有对Windows的嘲弄就更好了,毕竟很多Windows程序员对Android没有恶意,毕竟大家用了某种操作系统不是罪过,只是习惯。 好了,总结一下,SD 2.0的最后一天,可以打80分。CSDN毕竟是一个本土的程序员社区,用现在通用的话来说“山寨”。比起厂商组织的技术会议,SD 2.0的最大好处是,可以在一个会场里听到不同技术的声音,这是非常好的一件事。CSDN应该更多突出山寨特色,多请一些钱宏武这样的好汉来讲讲他们的实际开发经验。比如iPhone的开发者,在厂商对中国开发者并不热心的背景下,“山寨”开发者们很好的弥补了厂商的技术盲点,这是SD 2.0的贡献,至于初次上台的经验不足,我觉得是瑕不掩瑜。在“山寨”这个部分,SD 2.0其实可以到90分的。 下边来说厂商,赞助商课程是我比较不满意的地方,我也知道如果没有赞助商,就不会有这样一次技术会议,但是组织者应该对赞助商课程进行必要的审核。某些赞助商的课程是由市场部门来讲,不但与开发者距离太远,而且讲师对PPT也不熟悉,经常要在台上想。Google同样是赞助商,但是讲课的都是一些技术人员,这样的话,不但可以让听众得到第一手的信息,而且还可以了解很多听众的反馈,一举多得。 本文转自马宁博客园博客,原文链接:http://www.cnblogs.com/aawolf/archive/2008/12/09/1351122.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

探讨求解:Android项目间如何实现资源复用?

我们开发项目时,通常不仅代码需要复用,很多资源也是经常重用的,比如: 按钮上的图标 交互时发出的声音 某种功能所需的Activity布局 控件样式 常见的文字及其对应的各语言版本 比如这样一个软件分享的布局: 其中的布局、标签及按钮文字都是可复用的,如果你分享的是作者软件列表链接,那么QR码图片也是可以复用的,每次调用时只需要传递进来不同的分享信息字符串就可以了。 现在问题就是我找不到办法在多项目间共享这些通用资源,目前只能很囧地在个项目间复制粘贴,总感觉很二啊…… 我尝试过将一个项目作为公共项目,存入资源,打包为Jar文件,其他项目引用,然后使用公共项目命名空间中的资源ID访问资源,但是这样做访问到的还是本项目中的和那个ID相同的(因为ID实际上只是一个int值)资源,这个问题肯定是因为上下文使用的仍然是本程序,所以就直接从本程序的资源里去找了。 那么我又尝试通过 this.createPackageContext("com.skyd.common", 0) 这样的形式获取公共项目的上下文,但是这样做是失败的,异常提示名称未找到,而这个办法在跨App调用时却是有效的。 大家有什么办法实现吗? 本文转自斯克迪亚博客园博客,原文链接:http://www.cnblogs.com/SkyD/archive/2011/01/09/1931048.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Dijkstra(迪杰斯特拉)算法求解最短路径

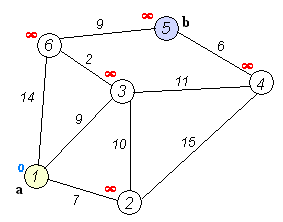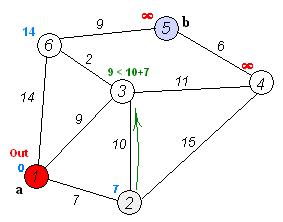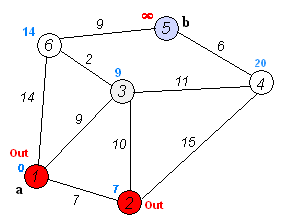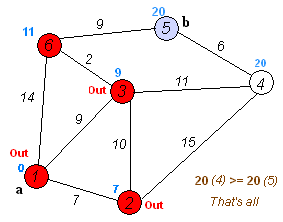
过程 首先需要记录每个点到原点的距离,这个距离会在每一轮遍历的过程中刷新。每一个节点到原点的最短路径是其上一个节点(前驱节点)到原点的最短路径加上前驱节点到该节点的距离。以这个原则,经过N轮计算就能得到每一个节点的最短距离。 第一轮,可以计算出,2、3、4、5、6到原点1的距离分别为:[7, 9, -1, -1, 14]。-1表示无穷大。取其中最小的,为7,即可以确定1的最短路径为0,2为下一轮的前驱节点。同时确定2节点的最短路径为7,路线:1->2。 第二轮,取2节点为前驱节点,按照前驱节点的最短距离加上该节点与前驱节点的距离计算新的最短距离,可以得到3,4,5,6节点到原点的距离为:[17, 22, -1, -1],此时需要将这一轮得到的结果与上一轮的比较,3节点:17 > 9,最短路径仍然为9;4节点:22 < 无穷大,刷新4节点的最短路径为22;5节点:不变,仍然为无穷大;6节点:14 < 无穷大,取14,不变。则可以得到本轮的最短距离为:[9, 22, -1, 14],取最短路径最小的节点,为3,作为下一轮的前驱节点。同时确定3节点的最短路径为9,路线:1->3。 第三轮,同上,以3为前驱节点,得到4,5,6的计算距离为:[20, -1, 11],按照取最短路径的原则,与上一轮的进行比较,刷新为:[20, –1, 11],选定6为下一轮的前驱节点。同时取定6的最短路径为11,路线:1->3->6。 第四轮,同上,以6为前驱节点,得到4和5的计算距离为[20, 20],与上一轮进行比较,刷新后为[20, 20],二者相等只剩下两个节点,并且二者想等,剩下的计算已经不需要了。则两个节点的最短路径都为20。整个计算结束。4的最短路径为20,路线:1->3->4。5的最短路径为20,路线:1->3->6->5。 如果二者不相等,则还需要进行第五轮,先确定二者中的一个的最短路径和路线,再取定剩下的。直到整个5次循环都完成。 伪代码 function Dijkstra(G, w, s) for each vertex v in V[G] //初始化 d[v] := infinity //将各点的已知最短距离先设成无穷大 previous[v] := undefined // 各点的已知最短路径上的前趋都未知 d[s] := 0 // 因为出发点到出发点间不需移动任何距离,所以可以直接将s到s的最小距离设为0 S := empty set Q := set of all vertices while Q is not an empty set // Dijkstra算法主体 u := Extract_Min(Q) S.append(u) for each edge outgoing from u as (u,v) if d[v] > d[u] + w(u,v) // 拓展边(u,v)。w(u,v)为从u到v的路径长度。 d[v] := d[u] + w(u,v) // 更新路径长度到更小的那个和值。 previous[v] := u // 记录前面顶点 Code public class Dijkstra { public static final int M = -1; public static void main(String[] args) { int[][] map1 = { { 0, 7, 9, M, M, 14 }, { 7, 0, 10, 15, M, M }, { 9, 10, 0, 11, M, 2 }, { M, 15, 11, 0, 6, M }, { M, M, M, 6, 0, 9 }, { 14, M, 2, M, 9, 0 } }; int orig = 0; int[] shortPath = Dijsktra(map1, orig); if (shortPath == null) { return; } for (int i = 0; i < shortPath.length; i++) { System.out.println("从" + (orig + 1) + "出发到" + (i + 1) + "的最短距离为:" + shortPath[i]); } } public static int[] Dijsktra(int[][] weight, int orig) { int n = weight.length; // 顶点个数 int[] shortest = new int[n]; // 存放从start到其他各点的最短路径 boolean[] visited = new boolean[n]; // 标记当前该顶点的最短路径是否已经求出,true表示已求出 // 初始化,第一个顶点求出 shortest[orig] = 0; visited[orig] = true; for (int count = 0; count != n - 1; count++) // 要加入n-1个顶点 { // 选出一个距离初始顶点最近的未标记顶点 int k = M; int dmin = M; for (int i = 0; i < n; i++) { if (!visited[i] && weight[orig][i] != M) { if (dmin == -1 || dmin > weight[orig][i]) { dmin = weight[orig][i]; k = i; } } } // 正确的图生成的矩阵不可能出现K == M的情况 if (k == M) { System.out.println("the input map matrix is wrong!"); return null; } shortest[k] = dmin; visited[k] = true; // 以k为中间点,修正从原点到未访问各点的距离 for (int i = 0; i < n; i++) { if (!visited[i] && weight[k][i] != M) { int callen = dmin + weight[k][i]; if (weight[orig][i] == M || weight[orig][i] > callen) { weight[orig][i] = callen; } } } } return shortest; } } 本文转自我爱物联网博客园博客,原文链接:http://www.cnblogs.com/yydcdut/p/4008180.html,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册