Claude Code 团队公开了一个数字:他们的代码大约 90% 由 Claude 编写和评审。
该团队工程师 Addy Osmani 在 claude.dev 上写了篇文章,讲这个规模下他们怎么让 agent 验证自己的工作。核心判断很直接——没有验证回路,你最多同时跑一两个 Claude,因为每个都得自己盯着;有了验证回路,可以同时跑几十上百个。
文章开头引了一处对比数据:让 Claude 按评分标准(rubric)工作,相比普通提示循环,任务成功率最高提升 10 个百分点,难题上的收益最大。
真正有价值的部分是三种测试的分工。
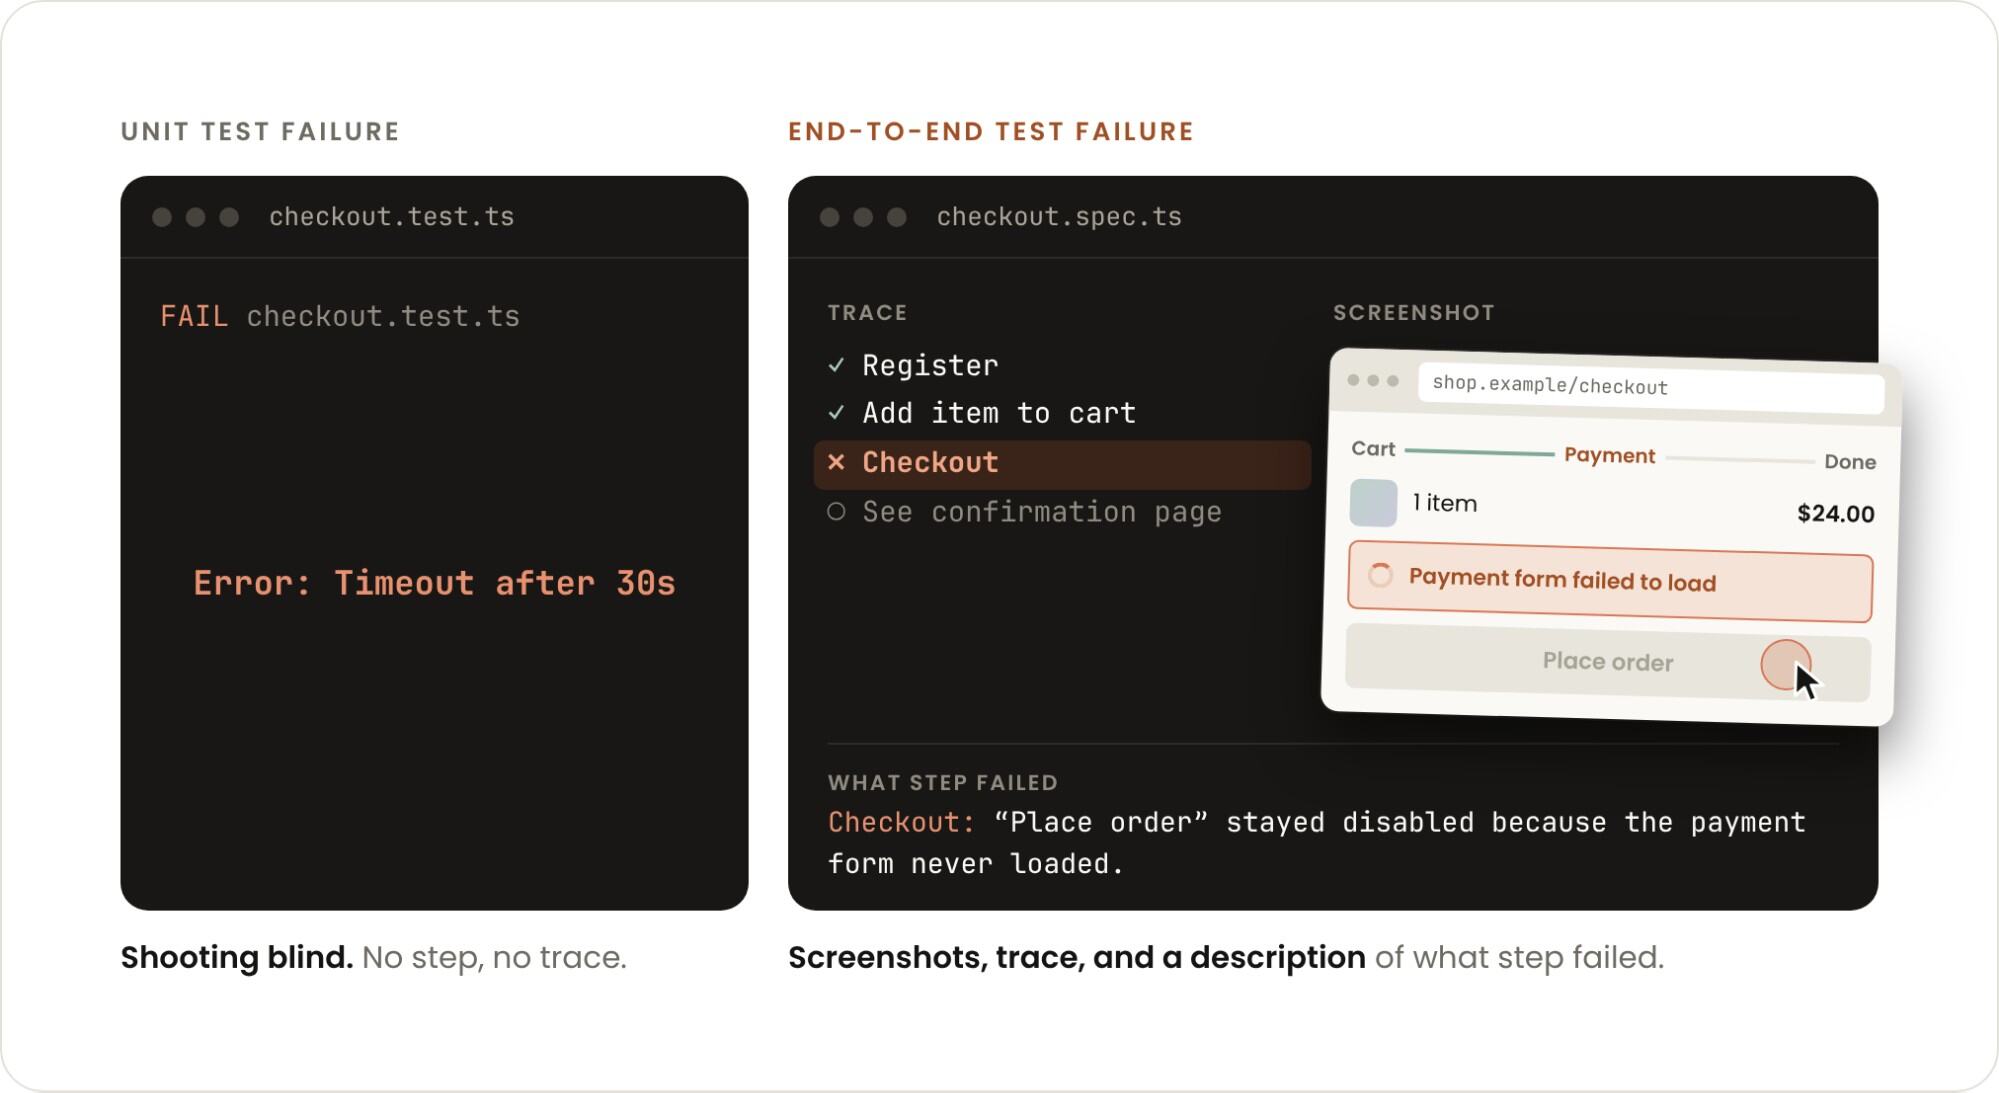
端到端测试优先级最高。 如果只能选一种,就选这个。理由是它难以作弊——功能要么能用要么不能用,完成标准明确,还能具体说出哪儿坏了。
文章配了一张对比图很有意思。同一个坏掉的功能,单元测试只报「Error: Timeout after 30s」,端到端测试给出的是一串步骤追踪:注册、加购物车、结算失败、没到达确认页,外加一张截图,上面「Place order」按钮是灰的,附一句「结算页的 Place order 一直是禁用状态,因为支付表单没加载出来」。
单元测试更快、更稳定,但可能全过而功能已经坏了。因为 agent 和测试都不理解完整任务。原文的说法是,让 agent 对真实运行的系统有「手和眼睛」——用 CDP、模拟器、API harness 这类工具去启动、驱动、检查应用。
属性测试(property tests)管的是人容易漏的边界。 先写一句你认为不可能失败的断言,然后用 fast-check(JS/TS)、Hypothesis(Python)、proptest(Rust)这类库生成几千个输入去试图证伪。
文章列了几类几乎所有项目都有的属性:往返编码(编码后解码应该回到原值)、不变量(账户余额不能变负)、幂等性(操作做两次和做一次结果相同)、等价性(优化后的代码和朴素但正确的代码结果一致)。
属性测试的价值在于,它用的边界用例不是被写代码的那个 agent 的偏见塑造出来的。原文特别提到,这在重写场景下很有用——当规格已经和生产行为漂移,规格本身不再是可靠的验证依据。
差分测试用旧系统当标准答案。 适合大规模迁移,功能预期保持不变的那种。同一批输入同时喂给新旧系统,结果不同就是有 bug 或者破坏性变更。关键是输入要随机生成或者取自生产流量样本,还要把空白字符这类无关因素归一化,另外维护一份「预期内差异」的白名单。
后面几段讲的是 Anthropic 团队自己怎么做事,有几条值得参考。
验证的意思是跑起来。 文章说跑通应用比跑测试更重要——你不会没在模拟器里试过就发一个 iOS 改动,Claude 也一样。他们让 Claude 用 Chrome 扩展测 web 改动、用 iOS 或 Android MCP 测移动端、用 computer use 测桌面端、本地起服务测后端。具体做法是建一个叫 verify 的 skill,放在仓库的 .claude/skills/ 目录里,尽量靠近相关代码。Claude 知道在提交改动前要用它。
失败的测试交给人。 没人能读完每一个改动,所以用失败来决定哪些需要人看。Claude 跑检查并尝试修复,如果三轮之后仍然失败就停下来找人。
改动不能修改评判自己的检查。 这条我觉得是最值得抄的。如果一次改动能修改评判它的那个检查,那这个检查就是坏的。所以他们让代码评审读基础分支或默认分支上的 REVIEW.md,永远不读 PR 里改过的那份。团队确保卡住改动的规则放在改动本身动不到的分支上。
还有一个细节:评审绑定到具体的 commit。如果评审进行中有人推了新代码,这次评审结果就作废了——一个过时 commit 上的通过结论没有任何意义。
一个评审人,多轮迭代。 他们不靠堆更多评审人来提升评审质量,认为在主评审之上再加一个更贵的评审,通常不如把主评审调好。每轮评审会带上上一轮的上下文和历史失败,而不是从头重新检查一遍。
这些做法里有一条隐含的判断值得留意:文章反复强调验证要「便宜到可以随时要求」。过去昂贵的验证手段——测试、基准、规格、真实的端到端运行——现在让 agent 生成同样便宜。而且生成出来的测试作为软件运行,可以高频重复跑而不额外消耗 token。
这个变化是整篇文章的地基。验证之所以能从奢侈品变成默认动作,是因为请求验证的成本被压到了接近零。
参考来源: