首页 文章 精选 留言 我的

文章列表

共 234351 篇
技术分享:AI 服务平台的分账系统架构设计与实现思路

技术分享:AI 服务平台的分账系统架构设计与实现思路

做支付系统架构这些年,接触过不少 AI 服务平台的技术团队,发现一个共性问题:大家的技术重心基本都在模型优化、产品体验、并发承载上,分账结算体系常常是 “凑合用” 的状态 —— 写个定时任务、对接下支付原生分账,就敢承接百万级日调用量。 等业务规模上来才发现,计费规则复杂、分账方多、海量小额对账、预付费合规、逆...

批次拆分合并后唯一码父子关系怎么存?边表设计与反查接口

批次拆分合并后唯一码父子关系怎么存?边表设计与反查接口

结论先说:批次在生产线上会被拆分重分,也会因为异常被合并重打,原始唯一码(LOT / SN)的父子关系如果在业务表里用一对多字段硬绑,拆分后再合并就会互相覆盖。稳妥的做法是把“谁包含谁”抽到一张边表,边表只追加、不改旧记录,父拆子用新边行表达,子合父用 direction 标记反查方向,查询侧通过边表一次递归或闭包把整条物料谱系拉出来...

追溯工单快照表怎么建模?wo_snapshot字段与版本固化

追溯工单快照表怎么建模?wo_snapshot字段与版本固化

结论先说:追溯场景里,工单执行到一半被改过数量、工序、优先级甚至产品料号,如果只在主表上 UPDATE,事后查“当时到底按什么生产的”就没有答案。工单快照表把“版本 + 变更点 + 固化时间”拆开存,wo_snapshot 不是对主表做深拷贝,而是把可追溯字段单独拎出来做成只追加的影像行。主表只管最新版本,快照...

基于向量检索与大模型的本地化RAG问答服务构建指南

基于向量检索与大模型的本地化RAG问答服务构建指南

随着大语言模型在自然语言处理领域的快速普及,企业在构建智能客服、内部知识助手等场景时,普遍面临两大痛点。首先是模型幻觉问题,通用大模型在缺乏实时或垂直领域数据支撑时,容易生成看似合理但事实错误的内容。其次是知识更新滞后,预训练数据的截止时间导致模型无法回答最新业务动态。传统微调方式成本高昂且难以灵活迭代,而检索增强生成技术通过外挂知识库的方式,将外部权威信息...

系统上线后的安全可证性:日志字段模型、鉴权边界与证据链的工程实现

系统上线后的安全可证性:日志字段模型、鉴权边界与证据链的工程实现

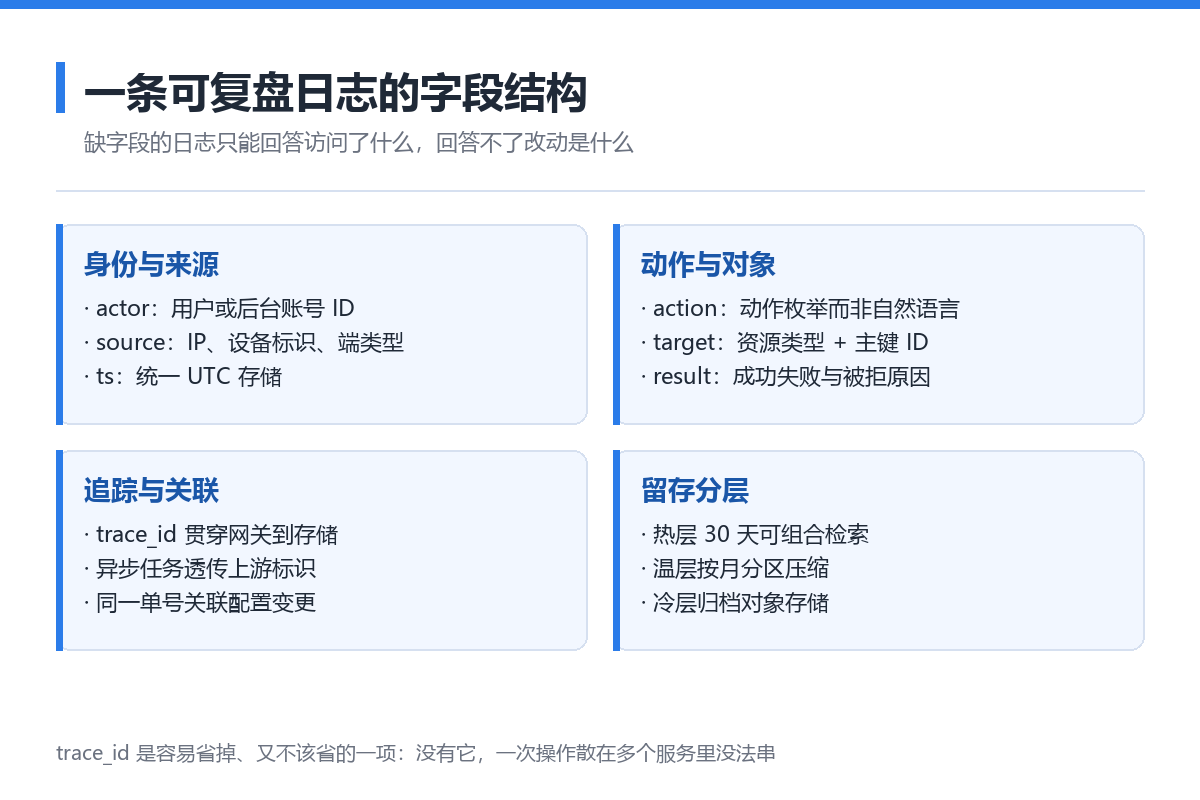
监管口径在 2026 年 10 月发生了一次结构性变化。《公安机关网络空间安全监督检查办法》施行后,监督检查的手段从翻阅制度台账扩展到线上巡查与远程漏洞探测、渗透性测试。对研发团队来说,这件事的技术含义很明确:系统能不能被"测",以及测完之后能不能拿出证据解释每一个动作,成了新的交付门槛。

Node.js 中流式处理大文件时内存暴涨的排查与修复

Node.js 中流式处理大文件时内存暴涨的排查与修复

处理大文件上传或日志分析时,很多 Node.js 服务在压力上来后内存会迅速上涨,直到触发 OOM 重启。问题往往不在业务逻辑本身,而是流的使用方式不对——把可读流的数据全部读进内存再处理,或者在高水位线已经触发时继续积压数据。这篇文章从一次实际排查出发,先还原内存增长的常见模式,再解释 highWaterMark、背压和 pipel...

Node.js 中 stream.pipeline 的错误处理与资源清理陷阱

Node.js 中 stream.pipeline 的错误处理与资源清理陷阱

在 Node.js 里处理文件上传、日志转发或数据转换时,stream 管道几乎是绕不开的。很多团队从 pipe() 迁移到 stream.pipeline(),是因为官方文档说它能自动处理错误和资源释放。但实际用起来,pipeline 的回调触发时机、错误对象传递方式,以及和 async/await 混用时的行为,经常让人踩坑。比如一个可读流在解析阶段抛错...

Go 服务里用 context 控制并发任务超时,为什么你的 goroutine 还在跑?

Go 服务里用 context 控制并发任务超时,为什么你的 goroutine 还在跑?

上线一个批量查询用户积分并调用第三方接口的场景时,给每个请求都套了 context.WithTimeout,接口响应确实在超时后返回了 context deadline exceeded,但后续观察日志发现第三方调用还在继续,goroutine 数量在流量高峰时明显上涨。这个问题通常来自两个地方:一是把 ctx 传给了 HTTP 请求,但底层 http.Cl...

Go 中如何正确实现带缓冲 channel 的优雅关闭以避免 goroutine 泄漏

Go 中如何正确实现带缓冲 channel 的优雅关闭以避免 goroutine 泄漏

写 Go 服务时经常需要把任务分发给一组 worker 并发处理。典型的做法是用一个带缓冲 channel 收集任务,再起若干 goroutine 消费,等所有任务处理完关闭 channel。但实际代码里常出现两种 goroutine 泄漏:一是生产者已经结束,消费者却因为 channel 没有关闭而永远阻塞在 range 上;二是关闭 channel 后,...

React useEffect 依赖数组导致无限重渲染的排查与修复

React useEffect 依赖数组导致无限重渲染的排查与修复

在 React 函数组件里用 useEffect 做数据请求或订阅时,依赖数组写错经常引发无限重渲染:组件刚挂载就触发 effect,effect 里又更新了 state,state 变化导致组件重渲染,依赖数组中的某个值因为每次渲染都生成新引用(对象、数组、内联函数)而被判定为变化,于是 effect 再次执行,循环往复。这类问题在列表加载、表单初始化、第...

Node.js 中处理 CPU 密集型任务时,为什么你的 worker_threads 没有生效?

Node.js 中处理 CPU 密集型任务时,为什么你的 worker_threads 没有生效?

在 Node.js 里跑图片处理、加密解密或者大 JSON 解析时,主线程被占满导致接口响应变慢是挺常见的事。很多人知道用 worker_threads 把计算挪到子线程,但实际写完之后发现 CPU 占用还是只在一个核上,或者任务反而更慢了。问题往往出在几个细节上:传过去的数据被结构化克隆了一遍、worker 启动开销被忽略、或者误以为 worker 里能直...

Node.js 中 Stream 的背压机制:为什么你的管道会内存暴涨

Node.js 中 Stream 的背压机制:为什么你的管道会内存暴涨

用 Node.js 处理大文件或高吞吐数据时,很多人第一反应是 fs.createReadStream 配合 pipe 写出去,代码看起来干净利落。但一旦上下游处理速度不匹配,比如读取本地文件很快、写入网络或压缩很慢,数据就会在内存里堆积。pipe 本身会处理背压,可一旦中间插入自定义的 Transform 流,或者手动监听 data 事件往可写流里 wri...

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

用户登录
用户注册