首页 文章 精选 留言 我的

精选列表

搜索[apache storm],共10000篇文章
优秀的个人博客,低调大师

字节跳动基于 Apache Hudi 的多流拼接实践方案

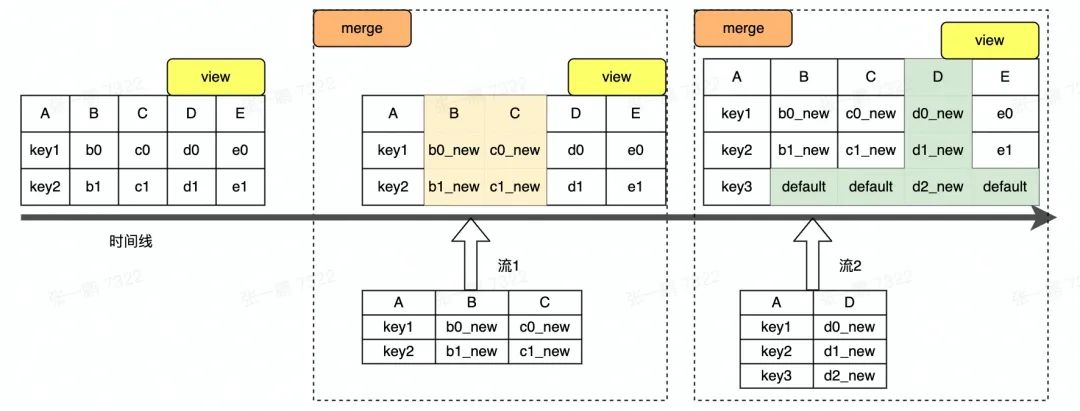
字节跳动数据湖团队在实时数仓构建宽表的业务场景中,探索实践出的一种基于 Hudi Payload 的合并机制提出的全新解决方案。 字节跳动数据湖团队在实时数仓构建宽表的业务场景中,探索实践出的一种基于 Hudi Payload 的合并机制提出的全新解决方案。 该方案在存储层提供对多流数据的关联能力,旨在解决实时场景下多流 JOIN 遇到的一系列问题。接下来,本文会详细介绍多流拼接方案的背景以及实践经验。 业务面临的挑战 字节跳动存在较多业务场景需要基于具有相同主键的多个数据源实时构建一个大宽表,数据源一般包括 Kafka 中的指标数据,以及 KV 数据库中的维度数据。 业务侧通常会基于实时计算引擎在流上做多个数据源的 JOIN 产出这个宽表,但这种解决方案在实践中面临较多挑战,主要可分为以下两种情况: 维表 JOIN 场景挑战:指标数据与维度数据进行关联,其中维度数据量比较大,指标数据 QPS 比较高,导致数据可能会产出延迟。 当前方案:将部分维度数据缓存起起来,缓解高 QPS 下访问维度数据存储引擎产生的任务背压问题。 存在问题:由于业务方的维度数据和指标数据时间差比较大,所以指标数据流无法设置合理的 TTL;而且存在 Cache 中维度数据没有及时更新,导致下游数据不准确的问题。 多流 JOIN 场景挑战:多个指标数据进行关联,不同指标数据可能会出现时间差比较大的异常情况。 当前方案:使用基于窗口的 JOIN,并且维持一个比较大的状态。 存在问题:维持大的状态不仅会给内存带来的一定的压力,同时 Checkpoint 和 Restore 的时间会变 得更长,可能会导致任务背压. 分析与对策 总结上述场景遇到的挑战,主要可归结为以下两点: 由于多流之间时间差比较大,需要维持大状态,同时 TTL 不好设置。 由于对维度数据做了 Cache,维度数据数据更新不及时,导致下游数据不准确。 针对这些问题,并结合业务场景对数据延迟有一定容忍,但对数据准确性要求比较高的背景,我们在不断的实践中探索出了基于 Hudi Payload 机制的多流拼接方案: 多流数据完全在存储层进行拼接,与计算引擎无关,因此不需要保留状态及其 TTL 的设置。 维度数据和指标数据作为不同的流独立更新,更新过程中不需要做多流数据合并,下游读取时再 Merge 多流数据,因此不需要缓存维度数据,同时可以在执行 Compact 时进行 Merge,加速下游查询。 此外,多流拼接方案还支持: 内置通用模板,支持数据去重等通用接口,同时可满足用户定制化数据处理需求。 支持离线场景和流批混合场景。 方案介绍 基本概念 首先简单介绍下本方案依赖 Hudi 的一些核心概念: Hudi MetaStore 这是一个中心化的数据湖元数据管理系统。它基于 Timeline 乐观锁实现并发写控制,可以支持列级别的冲突检查。这在 Hudi 多流拼接方案中能够实现并发写入至关重要,更多细节可参考字节跳动数据湖团队向社区贡献的 RFC-36。 MergeOnRead 表读写逻辑 MergeOnRead 表里面的文件包含两种, LogFile (行存) 和 BaseFile (列存),适用于实时高频更新场景,更新数据会直接写入 LogFile 中,读时再进行合并。为了减少读放大的问题,会定期合并 LogFile 到 BaseFile 中,此过程叫 Compact。 原理概述 针对上述业务场景,我们设计了一种完全基于存储层的多流拼接方案,支持多个数据流并发写入,读时按照主键合并多流数据,此外还支持异步 Compact 来加速下游读取数据。 图 1 Hudi 多流拼接概念图(本文所有图中示例数据均与图 1 一致) 现以一个简单的示例流程对方案原理进行阐述,图 1 为多流拼接示意图。图中的宽表包含 BCDE 五列,是由两个实时流和一个离线流拼接而成,其中 A 是主键列,实时流 1 负责写入 ABC 三列,实时 流 2 负责写入 AD 两列,离线流负责写入 AE 两列,此处仅对两个实时流的拼接过程进行介绍。 图 1 中显示两个流写入数据以 LogFile 形式存储,Merge 过程是合并 LogFile 和 BaseFile 中的数据。合并过程中,LogFile 中每一列的值被更新到 BaseFile 中对应的列上,BaseFile 中未被更新的列保持原来的值不变,如图 1 中 BCD 三列被更新成新值,E 列保持旧值不变。 写入过程 多流数据拼接方案支持多流并发写入,相互独立。对于单个流的写入,逻辑与 Hudi 原有写入流程一致,即数据以 Upsert 的方式写入 Hudi 表,以 LogFile 的形式存储,并在数据写入的过程中对数据去重。在多流写入的场景,核心点在于如何处理并发问题。 图 2 显示了数据并发写入的流程。流 1 和 流 2 是两个并发的任务,检查这两个任务写入的列除了主键以外是不是存在其它交集。例如: 流 1 的 Schema 包含三列 (A,B,C),流 2 的 Schema 包含两列 (A,D)。 在并发写入的时候,先在 Hudi MetaStore 对两个任务发起的 DeltaCommit 做列冲突检查,即除了主键列外的其它列是否存在交集,如图中的 (B,C) 和 (D): 如果有交集,则后发起的 DeltaCommit 失败。 如果没有交集,则两个任务继续后续的写入。 图 2 数据写入过程示意图 读取过程 接下来,介绍多流拼接场景下 Snapshot Query 的核心过程,即先对 LogFile 进行去重合并,然后再合并 BaseFile 和 去重后的 LogFile 中的数据。图 3 显示了整个数据合并的过程,具体可以拆分成以下 两个过程: Merge LogFile Hudi 现有逻辑是将 LogFile 中的数据读出来存放在 Map 中,对于 LogFile 中每条 Record,如果 Key 不存在 Map 中,则直接放入 Map,如果 Key 已经存在于 Map 中,则需要更新操作。 在多流拼接中,因为 LogFile 中存在不同数据流写入的数据,即每条数据的列可能不相同,所以在更新的时候需要判断相同 Key 的两个 Record 是否来自同一个流,是则做更新,不是则做拼接。 如图 3 所示,读到 LogFile2 中的主键是 key1 的 Record 时,key1 对应的 Record 在 Map 中已经存在,但这两个 Record 来自不同流,则需要拼接形成一条新的 Record (key1,b0_new,c0_new,d0_new) 放入 Map 中。 Merge BaseFile and LogFile Hudi 现有默认逻辑是对于每一条存在于 BaseFile 中的 Record,查看 Map 中是否存在 key 相同的 Record,如果存在,则用 Map 中的 Record 覆盖 BaseFile 中的 Record。在多流拼接中,Map 中的 Record 不会完整覆盖 BaseFile 中对应的 Record,可能只会更新部分列的值,即 Map 中的 Record 对应的列。 如图 3 所示,以最简单的覆盖逻辑为例,当读到 BaseFile 中的主键是 key1 的 Record 时,发现 key1 在 Map 中已经存在并且对应的 Record 有 BCD 三列的值,则更新 BaseFile 中的 BCD 列,得到新的 Record(key1,b0_new,c0_new,d0_new,e0),注意 E 列没有被更新,所以保持原来的值 e0。 对于新增的 Key 如 Key3 对应的 Record,则需要将 BCE 三列补上默认值形成一条完整的 Record。 图3 SnapShot Query 中数据合并过程 异步 Compaction 为了提升读取性能,某些数据源的写入任务会同步执行 Compaction,但实践过程中发现同步执行 Compaction 会阻塞写入任务,而且 Compaction 任务需要资源比较多,可能会抢占流式导入任务的资源。 针对这类场景,通过独立的 Compaction Service 来隔离 Compaction 任务和流式数据导入任务。与 Hudi 本身自带的异步 Compaction 不同的是,用户无需指定要执行的 Compaction Instant,且有一个独立的 Compaction Service 负责所有的表的 Compaction 操作。关于 Compaction Service 的细节就不在本文展开,详情可参考 RFC-43。 具体过程是流式导入任务同步生成 Schedule Compaction Plan,并将 Plan 存入 Hudi MetaStore。有一个独立于流式导入任务的 Async Compactor,它从 Hudi MetaStore 循环拉取 Compaction Plan 并执行。 场景实践与未来规划 最终,基于 Hudi 多流拼接的方案,在实时数仓的 DWS 层落地,单表支持了 3+ 数据流的并发导入,覆盖了数百 TB 的数据。 此外,在使用 Spark 对宽表数据进行查询时,在单次扫描量几十 TB 的查询中,性能相比于直接使用多表关联性能提升在 200% 以上,在一些更加复杂的查询下,也有 40-140% 的性能提升。 目前,基于 Hudi 多流拼接方案易用性不足,单个任务至少需要配置超过 10 个参数,为了进一步降低用户使用成本,后续会做部分列插入和更新的 SQL 的语法支持以及参数的收敛。 除此之外,为了进一步提升宽表数据查询性能,还计划在多流拼接场景下支持基于列存格式的 LogFile,提供列裁剪和过滤条件下推等功能。 数据湖团队正在招人, 欢迎关注字节跳动数据平台同名公众号 相关产品 火山引擎湖仓一体分析服务 LAS 面向湖仓一体架构的Serverless数据处理分析服务,提供一站式的海量数据存储计算和交互分析能力,完全兼容 Spark、Presto、Flink 生态,帮助企业轻松完成数据价值洞察。点击了解 火山引擎E-MapReduce 支持构建开源 Hadoop 生态的企业级大数据分析系统,完全兼容开源,提供 Hadoop、Spark、Hive、Flink 集成和管理,帮助用户轻松完成企业大数据平台的构建,降低运维门槛,快速形成大数据分析能力。点击了解

优秀的个人博客,低调大师

JeeSite V4.3.2 快速开发平台发布 Apache开源协议

升级内容 菜单主题风格,激活菜单圆润风格。 主题整体美化,标准14字号,色调细节。 Tab 页签增加关闭全部功能;Tab 增加图标。 dataGrid 列表设置,选择列全选按钮放左下角。 表单组件:增加 readonly 全局只读属性,支持整个表单只读。 文件预览:如果有预览文件就预览,不管是否安装office转换服务 代码生成模板:非字符串类型默认增加 isUpdateForce 访问日志:提交前后差异数据输出结果优化 安全升级:防登录信息过长攻击 SqlMap 增加 maxJoinTableNum 选项,可设置最大联表个数(-1 为不限制,n 为 JoinTable n张表,0 为 不进行 JoinTable 查询) layer 优化 msg 弹窗,超时时间比较长的加关闭创建按钮,全屏消息的增宽显示更多内容。 Select2 组件优化,当超过设置最大选择长度时,自动关闭下拉框 如果开启租户模式,登录未设置 corpCode 的不在在线列表中显示 代码生成优化,字段类型有精度的时候也可以返回数值 BPM 待办接口增加 identityLinks 的返回。 BPM 增加取消签收 unclaim 接口 微信接口工具升级 wxjava 4.2.2.B 在线文档UI升级 knife4j 2.0.9 大屏升级,修复已知问题 升级其它依赖库 修正左树右表的情况下,没有刷新树表的表格问题 修正ie9的上传问题,因为ie9的flash不能获取md5,所以不支持秒传 修正租户模式下,相同的表单Key,不同的流程Key,时缓存串的问题 v4.2.3+ 升级方法 修改pom.xml文件中的jeesite-parent版本号为4.3.2-SNAPSHOT 如果你导入了jeesite-common源码项目,请与git上的代码进行同步 如果你导入了jeesite-module-core源码项目,请与git上的代码进行同步 如果你是跨版本升级,请注意每一个版本的升级方法,业务上有调整的地方进行修改 执行root/package.bat(sh)打包脚本,强制更新依赖即可。 新品鉴赏 TS + Vue3+ Antdv: http://vue.jeesite.com

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册