首页 文章 精选 留言 我的

精选列表

搜索[高性能应用服务],共10005篇文章
优秀的个人博客,低调大师

BeeCP-3.1.9 发布,高性能 JDBC池

小蜜蜂连接池:一款轻量级JDBC连接池。 1:版本下载(java7) <dependency> <groupId>com.github.chris2018998</groupId> <artifactId>beecp</artifactId> <version>3.1.9</version> </dependency> 2:更新内容 调整配置项名 ‘ connectionTestSQL’ 为‘ connectionTestSql’ 增强连接检查时事务处理 在池化对象上增加onBeforeRemove方法 5:Springboot启动器同步更新 <dependency> <groupId>com.github.chris2018998</groupId> <artifactId>beecp-spring-boot-starter</artifactId> <version>1.5.5</version> </dependency> 6:项目地址 国内地址:https://gitee.com/mirrors/BeeCP 国外地址:https://github.com/Chris2018998/BeeCP

优秀的个人博客,低调大师

elton —— 简单高性能的 Go Web 框架

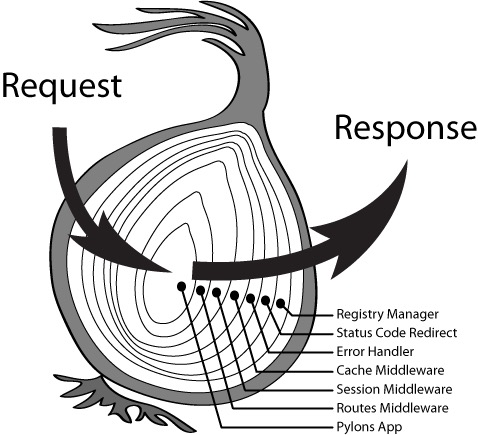
前言 开始接触后端开发是从 nodejs 开始,最开始使用的框架是 express,后来陆续接触了其它的框架,觉得最熟悉的还是koa。使用 golang 做后端开发时,对比使用过 gin,echo 以及 iris 三个框架,它们的用法都类似(都支持中间件,中间件的处理也类似),但是在开发过程中还是钟情于 koa 的处理方式,失败则 throw error,成功则将响应数据赋值至 ctx.body,简单易懂。 概述 造一个新的轮子的时候,首先考虑的是满足自己的需求,弱水三千只取一瓢饮,对我来说,新轮子的满足我所需要的一瓢则是重中之重。 请求经过中间件的处理方式为由外至内,响应时再由内至外 所有的处理函数都一致(参数、类型等),每个处理函数都有可以是其它处理函数的前置中间件 请求处理成功时,直接赋值至 Body(interface{}),由中间件将 interface{} 序列化(如 json,xml 等) 请求处理失败时,返回 error,由中间件将 error 转换为相应的 HTTP 响应(golang 中的 error 为 interface,可自定义相应的 Error 实例) elton 参考 koa 的实现,能够简单的添加各类中间件,中间件的执行也和 koa 一样,如下图所示的洋葱图,从外层往内层递进,再从内层返回外层(也可以未至最内层则直接往上返回)。 下面我们先看一下简单的处理成功与出错的例子: package main import ( "bytes" "errors" "github.com/vicanso/elton" ) func main() { d := elton.New() d.GET("/", func(c *elton.Context) (err error) { c.BodyBuffer = bytes.NewBufferString("hello world") return }) d.GET("/error", func(c *elton.Context) (err error) { err = errors.New("my error") return }) d.ListenAndServe(":7001") } 如代码所示,处理过程非常简单,响应数据由BodyBuffer中获取,如果流程出错,直接返回Error则可。不过例子中的与koa的处理还是有所差距,koa中返回数据时可以随意的指定各种Object(转换为json),而在golang中因为是强类型,所以需要使用interface{}的形式返回,再通过中间件将各类不同的struct转换至BodyBuffer,以及设置Content-Type。 中间件 在 elton 中有两类中间件是必须了解的,一是将 Context.Body(interface{}) 转换至对应的响应数据的 Responder 中间件,另外一个就是将 Error 转换至对应的响应数据的 Error 中间件。在详解这两类中间件之前,我们首先来了解一下 elton 的中间件的一些基本概念。 elton 中间件的处理函数是Handler func(*Context) error,可以通过Use方法添加至全局的中间件,也可单独添加至单一组或单一的路由处理。中间件处理也非常简单,如果出错,返回 Error(后续的处理函数不再执行)。在当前函数中已完成处理,则无需要调用Context.Next(),需要转至下一处理函数,则调用Context.Next()则可。 package main import ( "bytes" "log" "time" "github.com/vicanso/elton" ) func main() { d := elton.New() // logger d.Use(func(c *elton.Context) (err error) { err = c.Next() rt := c.GetHeader("X-Response-Time") log.Printf("%s %s - %s\n", c.Request.Method, c.Request.RequestURI, rt) return }) // x-response-time d.Use(func(c *elton.Context) (err error) { start := time.Now() err = c.Next() c.SetHeader("X-Response-Time", time.Since(start).String()) return }) d.GET("/", func(c *elton.Context) (err error) { c.BodyBuffer = bytes.NewBufferString("hello world") return }) d.ListenAndServe(":7001") } responder 中间件 HTTP 的响应主要分三部分,HTTP 响应状态码,HTTP 响应头以及 HTTP 响应体。前两部分比较简单,格式统一,但是 HTTP 响应体对于不同的应用有所不同。在 elton 的处理中,会将 BodyBuffer 的相应数据在响应时作为 HTTP 响应体输出。在实际应用中,有些会使用 json,有些是 xml 或者自定义的响应格式。因此在elton是提供了Body(interface{}) 属性,允许将响应数据赋值至此字段,再由相应的中间件转换为对应的 BodyBuffer 以及设置Content-Type。 在实际使用中,HTTP 接口的响应主要还是以json为主,因此elton-responder提供了将 Body 转换为对应的 BodyBuffer(json) 的处理,主要的处理如下: // New create a responder func New(config Config) elton.Handler { skipper := config.Skipper if skipper == nil { skipper = elton.DefaultSkipper } marshal := standardJSON.Marshal if config.Fastest { marshal = fastJSON.Marshal } return func(c *elton.Context) (err error) { if skipper(c) { return c.Next() } err = c.Next() if err != nil { return } // 如果已设置了BodyBuffer,则已生成好响应数据,跳过 if c.BodyBuffer != nil { return } if c.StatusCode == 0 && c.Body == nil { // 如果status eltone 与 body 都为空,则为非法响应 err = errInvalidResponse return } // 如果body是reader,则跳过 if c.IsReaderBody() { return } ct := elton.HeaderContentType hadContentType := false // 判断是否已设置响应头的Content-Type if c.GetHeader(ct) != "" { hadContentType = true } statusCode := c.StatusCode if statusCode == 0 { statusCode = http.StatusOK } var body []byte if c.Body != nil { switch c.Body.(type) { case string: if !hadContentType { c.SetHeader(ct, elton.MIMETextPlain) } body = []byte(c.Body.(string)) case []byte: if !hadContentType { c.SetHeader(ct, elton.MIMEBinary) } body = c.Body.([]byte) default: // 转换为json buf, err := marshal(c.Body) if err != nil { c.Cod().EmitError(c, err) statusCode = http.StatusInternalServerError he := hes.NewWithErrorStatusCode(err, statusCode) he.Exception = true c.SetHeader(ct, elton.MIMEApplicationJSON) body = he.ToJSON() err = nil } else { if !hadContentType { c.SetHeader(ct, elton.MIMEApplicationJSON) } body = buf } } } c.BodyBuffer = bytes.NewBuffer(body) c.StatusCode = statusCode return nil } } 代码的处理步骤如下: 1、前置判断是否跳过中间件,主要判断条件为:是否出错,或者已设置BodyBuffer(表示已完成响应数据的处理)或者 Body 为 Reader (以流的形式输出响应数据)。 2、如果 Body 的类型为 string,则将 string 转换为 bytes,如果未设置数据类型,则设置为text/plain; charset=UTF-8 3、如果 Body 的类型为 []byte,如果未设置数据类型,则设置为application/octet-stream 4、对于其它类型,则使用json.Marshal转换为对应的 []byte,如果未设置数据类型,则设置为application/json; charset=UTF-8 通过此中间件,在开发时可以简单的将各种 struct 对象,map 对象以json的形式返回,无需要单独处理数据转换,方便快捷。如果应用需要以 xml 等其它形式返回,则可自己编写自定义中间件来做转换处理。 error handler 中间件 elton 中默认的 Error 处理只是简单的输出err.Error(),而且状态码也只是简单的使用StatusInternalServerError,无法满足应用中的各类定制的出错方式。因此一般建议编写自定义的出错处理中间件,根据自定义的 Error 对象生成相应的出错响应数据。如elton-error-handler则针对返回的hes对象对应生成相应的状态码,响应类型以及响应数据(json): // New create a error handler func New(config Config) elton.Handler { skipper := config.Skipper if skipper == nil { skipper = elton.DefaultSkipper } return func(c *elton.Context) error { if skipper(c) { return c.Next() } err := c.Next() // 如果没有出错,直接返回 if err == nil { return nil } he, ok := err.(*hes.Error) if !ok { he = hes.Wrap(err) he.StatusCode = http.StatusInternalServerError he.Exception = true he.Category = errErrorHandlerCategory } c.StatusCode = he.StatusCode if config.ResponseType == "json" { buf := he.ToJSON() c.BodyBuffer = bytes.NewBuffer(buf) c.SetHeader(elton.HeaderContentType, elton.MIMEApplicationJSON) } else { c.BodyBuffer = bytes.NewBufferString(he.Error()) c.SetHeader(elton.HeaderContentType, elton.MIMETextPlain) } return nil } } 后记 elton提供更简单方便的 WEB 开发体验,主要实现的代码非常简单,更多的功能都依赖于各类中间件。需要查阅更多的中间件以及文档说明请查阅 github 项目中的说明。

优秀的个人博客,低调大师

高性能异步批量ping的golang实现

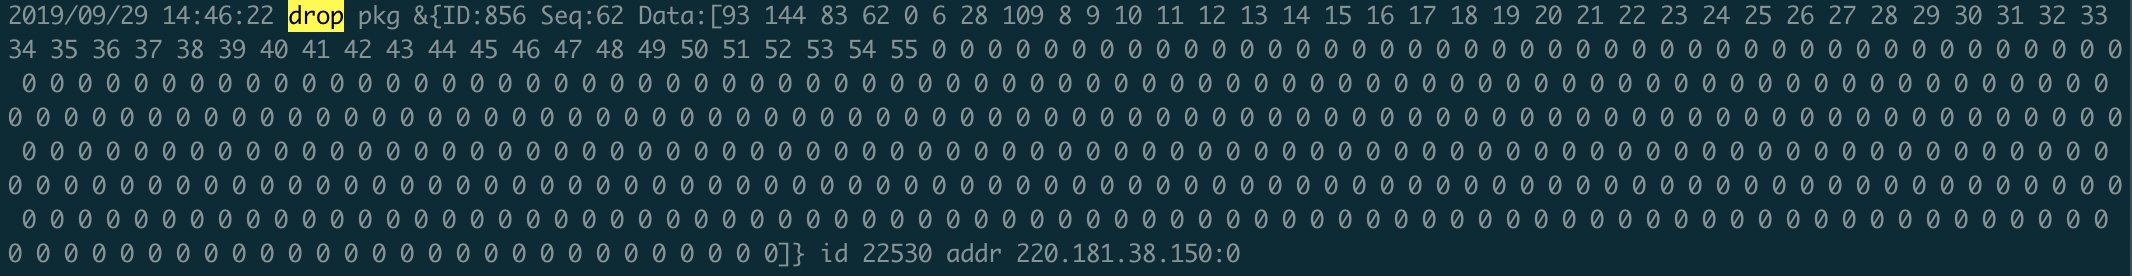
一个监控项目有个需求,会对一批域名全国的边缘节点进行探测,这里包括,丢包率,http 响应时间,探测频率大概时间是2min 一个周期。这里的域名大概有几百个甚至上千。由于是golang 写的调度和agent, 所以,这里探测丢包率是一个有意思的问题。由于目前git 上没有一个好用的支持multi-ping 的库包,或者多ping 有bug,我自己实现了一个。 git 地址:https://github.com/caucy/batch_ping 1,icmp 协议介绍 icmp 的报文头部一共是2+2+4+4+4 个字节。 type ICMP struct { Type uint8 Code uint8 CheckSum uint16 Identifier uint16 SequenceNum uint16 } 这里 type 是icmp 类型,常见有发送报文头 Echo, 回收报文头 Echo Reply 等,更多类型 见 https://tools.ietf.org/html/rfc792 。 Code 进一步划分ICMP的类型,该字段用来查找产生错误的原因;CheckSum 校验码部分,这个字段包含有从ICMP报头和数据部分计算得来的,用于检查错误的数据;而Identifier 通常为进程id,标识具体是哪个进程发送的icmp 包;SequenceNum 标识发送包的顺序id。 icmp 有个特点,listen 能收到其他进程ping 的结果,看下面例子: package main import ( "log" "github.com/caucy/batch_ping" ) func main() { ipSlice := []string{} // ip list should not more than 65535 ipSlice = append(ipSlice, "3g.qq.com") bp, err := ping.NewBatchPinger(ipSlice, false) // true will need to be root if err != nil { log.Fatalf("new batch ping err %v", err) } bp.SetDebug(true) // debug == true will fmt debug log bp.SetCount(100) bp.Run() } 启动上面的进程,会连续ping 3g.qq.com,同时,再启动一个进程ping www.baidu.com , 日志会显示,收到了220.181.38.150 的icmp 包。 2, 如何支持同时支持ping 多个addr 第一种是最简单的,也是大多数探针采用的方式:subprocess 。这个方式有个缺点,就是每个任务会fork 一个进程,非常耗费耗费资源。 第二种方式,我是这样想的,golang 有icmp 包,能够支持send and recive, 我直接起协程 去 收发,每个协程和subprocess 一样,先发后等,这样不就行了?然后起一组协程池,这样并发也能控制。然而,上面例子已经提到了,listen 后的conn 能收到其他进程 ping 的结果,这样实现挺麻烦。 第三种方式,一个协程收,一个协程发。最后选择的是这种方式。 一个协程收,一个协程发,有什么比较麻烦地方?因为icmp 层只能标识seq,所以会出现icmp 包头相同的情况,同时,批量收发,非常容易出现丢包的情况。 3,batch-ping 特性 支持原地址控制 支持ipv6 (操作系统本身支持“ip6:ipv6-icmp”,“udp6” dial ) 支持时间间隔控制 支持发送方式控制 支持多addr 控制 支持 mac, linux 使用示例: package main import ( "log" "github.com/caucy/batch_ping" ) func main() { ipSlice := []string{} // ip list should not more than 65535 ipSlice = append(ipSlice, "2400:da00:2::29") //support ipv6 ipSlice = append(ipSlice, "baidu.com") bp, err := ping.NewBatchPinger(ipSlice, false) // true will need to be root if err != nil { log.Fatalf("new batch ping err %v", err) } bp.SetDebug(true) // debug == true will fmt debug log bp.SetSource("") // if hava multi source ip, can use one isp bp.OnFinish = func(stMap map[string]*ping.Statistics) { for ip, st := range stMap { log.Printf("\n--- %s ping statistics ---\n", st.Addr) log.Printf("ip %s, %d packets transmitted, %d packets received, %v%% packet loss\n", ip, st.PacketsSent, st.PacketsRecv, st.PacketLoss) log.Printf("round-trip min/avg/max/stddev = %v/%v/%v/%v\n", st.MinRtt, st.AvgRtt, st.MaxRtt, st.StdDevRtt) log.Printf("rtts is %v \n", st.Rtts) } } err = bp.Run() if err != nil { log.Printf("run err %v \n", err) } bp.OnFinish(bp.Statistics()) } 4,可能问题 因为icmp 基于udp,时间间隔非常小,发送机器非常多的时候,会出现非常严重丢包,内核参数需要优化。 最后,文章不易,希望大家点个star,试用。 https://github.com/caucy/batch_ping 。

优秀的个人博客,低调大师

HAProxy高性能软负载均衡器

现在公司实现高可用已经成为必不可少的一环,在众多的负载均衡集群方案中,Haproxy是比较有名的一个。它可以实现TCP或Http的负载均衡。优点如下: 免费开源,与硬件负载均衡相比划算很多 最高可以维护40000~50000个并发,作为软件级别的负载均衡来说,实在强大 支持多种负载均衡算法,同时支持session保持 支持虚拟主机 拥有服务器监控页面,可以了解系统的实时运行状态 借用官网的图,图中的HA即为Haproxy软件,下面的PROXY为要代理的服务器,客户端只需要访问HA,相当于在访问PROXY。 image.png 演示 像这种软件的东西,直接动手比说理论有用的多。我还是基于Docker演示,明白其原理主要是配置文件,用虚拟机或容器都是类似的。 拉取Haproxy:1.8镜像 docker pull haproxy:1.8 拉取httpd镜像,并且准备web容器 docker pull httpd:2.4 docker run -it -d --name web1 httpd:2.4 docker run -it -d --name web2 httpd:2.4 docker run -it -d --name web-static httpd:2.4 docker exec -it web1 /bin/bash 进入容器之后分别修改其html页面 image.png 运行Haproxy容器,并且准备其配置文件 Haproxy的配置文件主要分为几部分 global 一些全局配置信息,主要和进程相关,注意如果涉及到目录相关的,要提前创建目录 defaults 默认的配置信息 frontend 前端的配置,暴露给用户的部分 backend 后端的配置,真实的提高服务的部分 在官方的网站中,所有的配置指令都有详细的解释,网址在文末的参考中。 我们的配置如下 image.png global log 127.0.0.1 local2 chroot /var/lib/haproxy pidfile /var/run/haproxy.pid maxconn 4000 user haproxy group haproxy daemon stats socket /var/lib/haproxy/stats defaults mode http log global option httplog option dontlognull option http-server-close option forwardfor except 127.0.0.0/8 option redispatch retries 3 timeout http-request 10s timeout queue 1m timeout connect 10s timeout client 1m timeout server 1m timeout http-keep-alive 10s timeout check 10s maxconn 3000 frontend main acl url_static path_beg -i /static /images /javascript /stylesheets acl url_static path_end -i .jpg .gif .png .css .js use_backend static if url_static default_backend app bind :80 backend static balance roundrobin server static 172.17.0.5:80 check backend app balance roundrobin server app1 172.17.0.3:80 check server app2 172.17.0.4:80 check 结果 在访问同一台服务器,可以看到响应的内容确实转发到后端不同的服务器上面 image.png 最后 纸上得来终觉浅,绝知此事要躬行。Haproxy一直在大脑中停留着,亲自配置一遍才知道其是怎么回事。中间遇到两个问题 Haproxy1.5版本与1.8版本的frontend配置稍有不同,学会参考文档 配置文件中的stats指定的目录在系统中如果不存在,会报错,指定的目录都要存在才行 让配置生效之前先用haproxy -c检查一下配置文件是否正确 参考 Haproxy官方配置参考

优秀的个人博客,低调大师

构建MySQL+DRBD+Keepalived高性能架构

前言*DRBD(DistributedReplicatedBlockDevice)是一个基于块设备级别在远程服务器直接同步和镜像数据的开源软件,类似于RAID1数据镜像,通常配合keepalived、heartbeat等HA软件来实现高可用性。这里简单记录仅供参考。 一、实施环境 1 2 3 4 5 系统版本:CentOS 5.8 DRBD版本:drbd- 8.3 . 15 Keepalived:keepalived- 1.1 . 15 Master: 192.168 . 149.128 Backup: 192.168 . 149.129 二、初始化配置 1) 在128、129两台服务器/etc/hosts里面都添加如下配置: 1 2 192.168 . 149.128 node1 192.168 . 149.129 node2 2) 优化系统kernel参数,直接上sysctl.conf配置如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 net.ipv4.ip_forward= 0 net.ipv4.conf. default .rp_filter= 1 net.ipv4.conf. default .accept_source_route= 0 kernel.sysrq= 0 kernel.core_uses_pid= 1 net.ipv4.tcp_syncookies= 1 kernel.msgmnb= 65536 kernel.msgmax= 65536 kernel.shmmax= 68719476736 kernel.shmall= 4294967296 net.ipv4.tcp_max_tw_buckets= 10000 net.ipv4.tcp_sack= 1 net.ipv4.tcp_window_scaling= 1 net.ipv4.tcp_rmem= 4096 87380 4194304 net.ipv4.tcp_wmem= 4096 16384 4194304 net.core.wmem_default= 8388608 net.core.rmem_default= 8388608 net.core.rmem_max= 16777216 net.core.wmem_max= 16777216 net.core.netdev_max_backlog= 262144 net.core.somaxconn= 262144 net.ipv4.tcp_max_orphans= 3276800 net.ipv4.tcp_max_syn_backlog= 262144 net.ipv4.tcp_timestamps= 0 net.ipv4.tcp_synack_retries= 1 net.ipv4.tcp_syn_retries= 1 net.ipv4.tcp_tw_recycle= 1 net.ipv4.tcp_tw_reuse= 1 net.ipv4.tcp_mem= 94500000 915000000 927000000 net.ipv4.tcp_fin_timeout= 1 net.ipv4.tcp_keepalive_time= 30 net.ipv4.ip_local_port_range= 1024 65530 net.ipv4.icmp_echo_ignore_all= 1 3) 两台服务器分别添加一块设备,用于DRBD主设备存储,我这里为/dev/sdb 30G硬盘; 执行如下命令: 1 mkfs.ext3/dev/sdb;dd if =/dev/zeroof=/dev/sdbbs=1Mcount= 1 ;sync 三、DRBD安装配置 1 yum-yinstalldrbd83*kmod-drbd83;modprobedrbd 安装完成并加载drbd模块后,vi修改/etc/drbd.conf配置文件,本文内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 global{ usage-countyes; } common{ syncer{rate100M;} } resourcer0{ protocolC; startup{ } disk{ on-io-errordetach; #size1G; } net{ } onnode1{ device/dev/drbd0; disk/dev/sdb; address 192.168 . 149.128 : 7898 ; meta-disk internal ; } onnode2{ device/dev/drbd0; disk/dev/sdb; address 192.168 . 149.129 : 7898 ; meta-disk internal ; } } 配置修改完毕后执行如下命令初始化: 1 drbdadmcreate-mdr0;/etc/init.d/drbdrestart;/etc/init.d/status 如下图: 以上步骤,需要在两台服务器都执行,两台都配置完毕后,在node2从上面执行如下命令:/etc/init.d/drbd status 看到如下信息,表示目前两台都为从,我们需要设置node1为master,命令如下: 1 2 3 drbdadm----overwrite-data-of-peerprimaryall mkfs.ext3/dev/drbd0 mkdir/app;mount/dev/drbd0/app 自此,DRBD配置完毕,我们可以往/app目录写入任何东西,当master出现宕机或者其他故障,手动切换到backup,数据没有任何丢失,相当于两台服务器做网络RAID1。 四、Keepalived配置 1 2 3 wgethttp: //www.keepalived.org/software/keepalived-1.1.15.tar.gz;tar-xzvfkeepalived-1.1.15.tar.gz;cdkeepalived-1.1.15;./configure;make;makeinstall DIR=/usr/local/;cp$DIR/etc/rc.d/init.d/keepalived/etc/rc.d/init.d/;cp$DIR/etc/sysconfig/keepalived/etc/sysconfig/; mkdir-p/etc/keepalived;cp$DIR/sbin/keepalived/usr/sbin/ 两台服务器均安装keepalived,并进行配置,首先在node1(master)上配置,keepalived.conf内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 !ConfigurationFile for keepalived global_defs{ router_idLVS_DEVEL } vrrp_scriptcheck_mysql{ script "/data/sh/check_mysql.sh" interval 5 } vrrp_instanceVI_1{ stateMASTER interface eth0 virtual_router_id 52 priority 100 advert_int 1 authentication{ auth_typePASS auth_pass 1111 } virtual_ipaddress{ 192.168 . 149.100 } track_script{ check_mysql } } 然后创建check_mysql.sh检测脚本,内容如下: 1 2 3 4 5 6 7 8 #!/bin/sh A=`ps-Cmysqld--no-header|wc-l` if [$A-eq 0 ];then /bin/umount/app/ drbdadmsecondaryr0 killallkeepalived fi 添加node2(backup)上配置,keepalived.conf内容如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 !ConfigurationFile for keepalived global_defs{ router_idLVS_DEVEL } vrrp_sync_groupVI{ group{ VI_1 } notify_master/data/sh/master.sh notify_backup/data/sh/backup.sh } vrrp_instanceVI_1{ stateBACKUP interface eth0 virtual_router_id 52 priority 90 advert_int 1 authentication{ auth_typePASS auth_pass 1111 } virtual_ipaddress{ 192.168 . 149.100 } } 创建master.sh检测脚本,内容如下: 1 2 3 4 #!/bin/bash drbdadmprimaryr0 /bin/mount/dev/drbd0/app/ /etc/init.d/mysqldstart 创建backup.sh检测脚本,内容如下: 1 2 3 4 #!/bin/bash /etc/init.d/mysqldstop /bin/umount/dev/drbd0 drbdadmsecondaryr0 发生脑裂恢复步骤如下: 1 2 3 4 5 Master执行命令: drbdadmsecondaryr0 drbdadm----discard-my-dataconnectr0 Backup上执行命令: drbdadmconnectr0 本文转自 wgkgood 51CTO博客,原文链接:http://blog.51cto.com/wgkgood/1408056

优秀的个人博客,低调大师

高性能elasticsearch ORM开发库使用介绍

bboss elasticsearch是一个不错的elasticsearch客户端工具包,采用类似于mybatis的方式,使用xml文件管理elasticsearch的query dsl脚本,在query dsl脚本中可以使用变量、foreach循环、逻辑判断;配置文件支持在线修改、自动热加载,开发和调试非常方便。 脚本中变量定义语法有三种:#[xxx],$xxx,@{pianduan} foreach循环语法:#foreach-#end 逻辑判断语法:#if-#else-#end, #if-#elseif-#else-#end 更详细内容请访问: https://my.oschina.net/bboss/blog/1556866 # 完整的demohttps://gitee.com/bboss/elasticsearchdemo # bboss elasticsearch特点https://www.oschina.net/p/bboss-elastic bboss elasticsearch技术交流群:21220580 bboss elasticsearch微信公众号:

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册