首页 文章 精选 留言 我的

精选列表

搜索[工程师],共10000篇文章
优秀的个人博客,低调大师

Python爬虫工程师常见面试题汇总

爬虫是Python的重要应用方向之一,也是学习Python的学员求职的主要方向。为了帮助学员更快更好的通过企业面试,小编悉心整理了5道Python爬虫面试题及答案,希望能够给大家提供帮助! 1、简要介绍下scrapy框架及其优势 scrapy是一个快速(fast)、高层次(high-level)的基于Python的Web爬虫构架,用于抓取Web站点并从页面中提取结构化的数据。scrapy使用了Twisted异步网络库来处理网络通讯。 scrapy框架的优点:1)更容易构建大规模的抓取项目;2)异步处理请求速度非常快;3)可以使用自动调节机制自动调整爬行速度。 2、爬虫使用多线程好?还是多进程好? 对于IO密集型代码(文件处理,网络爬虫),多线程能够有效提升效率(单线程下有IO操作会进行IO等待,会造成不必要的时间等待,而开启多线程后,A线程等待时,会自动切换到线程B,可以不浪费CPU的资源,从而提升程序执行效率)。在实际的采集过程中,既考虑网速和相应的问题,也需要考虑自身机器硬件的情况,来设置多进程或者多线程。 3、什么是栈溢出?怎么解决? 因为栈一般默认为1-2m,一旦出现死循环或者是大量的递归调用,在不断的压栈过程中,造成栈容量超过1m而导致溢出。 栈溢出的情况有两种:1)局部数组过大。当函数内部数组过大时,有可能导致堆栈溢出。2)递归调用层次太多。递归函数在运行时会执行压栈操作,当压栈次数太多时,也会导致堆栈溢出。 解决方法:1)用栈把递归转换成非递归。2)增大栈空间。 4、MySQL的索引在什么情况下失效? 1)如果条件中有or,即使其中有条件带索引也不会使用(这也是为什么尽量少用or的原因) 要想使用or,又想让索引生效,只能将or条件中的每个列都加上索引。 2)对于多列索引,不是使用的第一部分,则不会使用索引。 3)like查询以%开头。 4)如果列类型是字符串,那一定要在条件中将数据使用引号引用起来,否则不使用索引。 5)如果MySQL估计使用全表扫描要比使用索引快,则不使用索引。 5、HTTPS是如何实现安全传输数据的? 客户端(通常是浏览器)先向服务器发出加密通信的请求; 服务器收到请求,然后响应; 客户端收到证书之后会首先会进行验证; 服务器收到使用公钥加密的内容,在服务器端使用私钥解密之后获得随机数pre-master secret,然后根据radom1、radom2、pre-master secret通过一定的算法得出session Key和MAC算法秘钥,作为后面交互过程中使用对称秘钥。同时客户端也会使用radom1、radom2、pre-master secret,和同样的算法生成session Key和MAC算法的秘钥。 然后再后续的交互中就使用session Key和MAC算法的秘钥对传输的内容进行加密和解密。

优秀的个人博客,低调大师

写给前端工程师看的Docker教程-基础篇

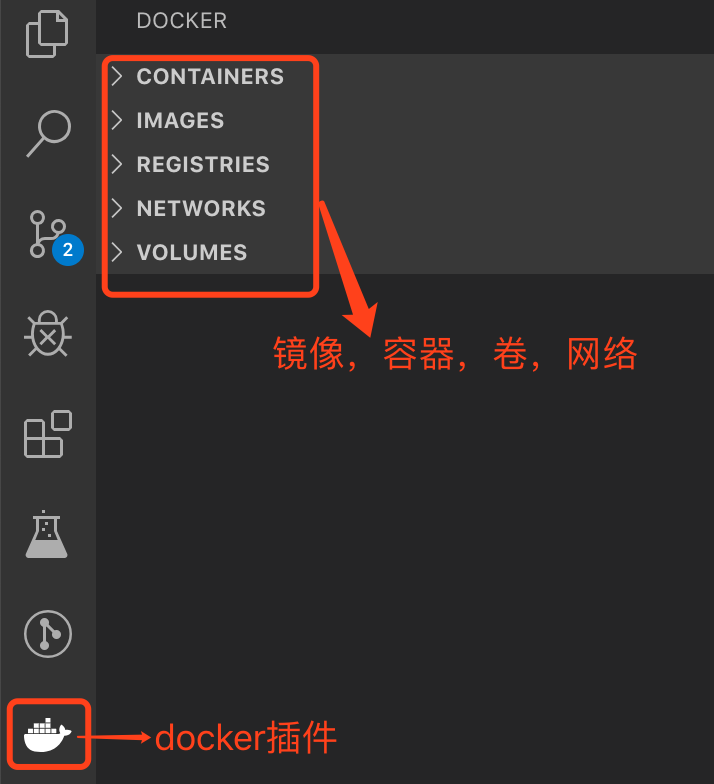
最近公司在推进容器化和k8s,项目都要改成Docker部署。负责的工程里有几个node项目,只能从零开始学习Docker了。 安装 Docker支持window, Mac, Linux, 教程参考Docker安装教程。 建议在Mac和Linux系统里使用Docker。 日常开发,我使用的是vscode编辑器,可以顺便安装docker插件。在插件商店搜索docker,安装完成后,我们可以很方便的管理Docker镜像和容器。 快速使用 首先我们来体验一下Docker。 平时工作中,如果我们电脑的开发环境是Windows, 有一天希望在Linux环境做一些事情,那该怎么办?(在没有云服务器的情况下)大多数人这时会选择去用虚拟机安装一个ubuntu系统。不过安装虚拟机前,你得先去下载几个G的镜像,然后在VMware里配置一些参数,最后还要等待最少十几分钟的系统安装。等你安装完一个ubuntu系统,估计已经浪费了几个小时。 然而使用Docker,你只需要几分钟! # 拉取ubuntu镜像 docker pull ubuntu # 创建一个ubuntu容器并且使用终端进行交互 docker run -it --name my-ubuntu --rm ubuntu /bin/bash 创建成功后,你就进入一个ubuntu系统里,现在你可以在其中进行任意的操作了。 注意:虽然当前容器里是ubuntu系统,但是你只能把它想象成一个精简版的ubuntu,因此有很多常用命令,需要自己去安装。 curl -v bilibili.com 直接运行curl命令会提示命令不存在 # 安装curl apt-get update apt-get install -y curl 安装完成后,才能使用curl命令 退出容器 exit 基本概念 镜像(Image):类似于虚拟机中的镜像。镜像有两种:基础镜像和个人镜像。基础镜像由各大厂商提供,比如ubuntu镜像,node镜像。个人镜像则是由个人开发者构建上传。 容器(Container):类似于一个轻量级的沙盒。容器是基于镜像来创建的,ubuntu镜像并不能和我们进行各种交互,我们希望有个环境能运行ubuntu,于是基于ubuntu镜像创建了一个容器。 仓库(Repository):类似于代码仓库,这里是镜像仓库,是Docker用来集中存放镜像文件的地方。 我们可以这样类比: # 下载源代码 git clone deepred5/app # 启动app npm run start # 拉取镜像 docker pull deepred5/app # 创建容器 docker run deepred5/app Docker是基于c/s架构:我们在Client中执行Docker命令,最后创建的Container和Image则会在Server中运行 # 可以查看server和client信息 docker info 镜像(Image) 常用命令 # 查找镜像 docker search ubuntu # 拉取特定tag版本的镜像(默认是latest) docker pull ubuntu:18.0.4 # 查看下载的所有本地镜像 docker images # 删除镜像 docker rmi ubuntu:18.0.4 构建镜像 我们一般都是基于基础镜像来构建个人镜像。镜像是由一条条指令构建出来(Dockerfile) 我们来构建一个node-pm2镜像,这个镜像自带node和pm2: 创建一个node-pm2目录,并新建一个Dockerfile文件 mkdir node-pm2 cd node-pm2 touch Dockerfile 编辑Dockerfile # 基于node11基础镜像 FROM node:11 # 一些元数据,比如作者信息 LABEL maintainer="deepred5 <deepred5@gamil.com>" # 安装pm2 RUN npm install pm2 -g --registry=https://registry.npm.taobao.org # 暴露容器的端口 EXPOSE 80 443 基于这个Dockerfile创建我们自己的镜像deepred5/node-pm2 docker build -t deepred5/node-pm2:1.0 . 注意最后有一个. 查看我们自己的镜像 # 可以看到deepred5/node-pm2镜像了 docker images 基于deepred5/node-pm2镜像启动一个容器 docker run -it deepred5/node-pm2:1.0 /bin/bash 进入容器后,我们运行pm2 -v,可以看见pm2已经安装成功了 上传镜像 我们本地构建的镜像如果希望可以被其他人使用,就需要把镜像上传到仓库。登录dockerhub,注册一个账户。 # 登入账户,输入用户名和密码 docker login # 上传镜像 docker push deepred5/node-pm2:1.0 注意:deepred5/node-pm2改成你的用户名/node-pm2,你需要重新构建一个你的用户名/node-pm2的镜像,然后才能上传到dockerhub 容器(Container) 我们平时基本都是在和容器打交道。 # 基于ubuntu镜像创建my-ubuntu容器。如果本地没有ubuntu镜像,会先去docker pull下载 docker run -it ubuntu:latest --name my-ubuntu /bin/bash 参数解释: -i: 允许你对容器内的标准输入 (STDIN) 进行交互 -t: 在新容器内指定一个伪终端或终端。 --name: 容器的名字,默认是随机的名字 /bin/bash: 启动容器后立即执行的命令 # 停止容器 docker stop my-ubuntu # 启动容器 docker start my-ubuntu # 删除容器 docker rm my-ubuntu # 删除所有容器 docker rm `docker ps -aq` # 查看正在运行的容器 docker ps # 查看所有创建过的容器(运行或者关闭) docker ps -a docker start my-ubuntu启动的容器,虽然容器运行着,但是我们无法进入到容器里。 如何再次进入到容器里? docker exec -it my-ubuntu /bin/bash 容器运行的两种方式 交互式运行(-it) 守护式运行(没有交互式会话,长期运行,适合运行应用程序和服务)(-d) 可以这样类比:node index.js: 交互式运行pm2 start index.js: 守护式运行 大部分情况都是运行守护式容器(daemonized container) # 启动了容器,然后容器立即关闭 docker run ubuntu /bin/bash # 启动了容器,并开启了交互式的终端,只有输入exit才退出终端,退出终端后,容器仍然在后台运行 docker run -it ubuntu /bin/bash # 启动了容器,并且在后台一直运行,每隔1s输出hello world docker run -d ubuntu /bin/sh -c "while true; do echo hello world; sleep 1; done" 查看容器日志 docker run -d --name my_container ubuntu /bin/sh -c "while true; do echo hello world; sleep 1; done" # 查看后台运行的日志 docker logs my_container # 实时监控(类似tail -f) docker logs -f my_container # 获取最后10行 docker logs --tail 10 my_container # 实时查看最近的日志 docker logs --tail 0 -f my_container # 加上时间戳 docker logs -t my_container Nginx 前端最常使用的静态服务器就是Nginx了。 docker run -d --name my-nginx -p 8888:80 nginx 访问 http://localhost:8888/ 即可看到熟悉的欢迎页面 参数解释:-d: 基础篇里已经解释过了,守护运行方式-p: 端口映射。8888:80表示把本地的8888端口映射到容器的80端口 为什么要映射端口?因为Docker里每个容器都是相对独立的,拥有自己的内部ip。容器里运行的一些网络应用,要让外部也可以访问,就需要将端口映射到宿主机上。 docker port my-nginx 80/tcp -> 0.0.0.0:8888即可看到映射的端口了 如果我们希望修改Nginx欢迎页的内容,怎么办? 最容易想到的方法是:我们进入到容器里,然后修改/usr/share/nginx/html目录里的index.html # 进入nginx容器里 docker exec -it my-nginx /bin/bash 不过这种方法拓展性不高,假如有多个Nginx容器,难道我们需要一个个的进入容器去修改? 这时就要引出数据卷(Volume)的概念了。 数据卷(Volume) 类似端口映射,我们可以把容器内部的目录映射到宿主机的目录,实现容器之间实现共享和重用。 新建my-nginx目录,新建index.html mkdir my-nginx cd my-nginx touch index.html index.html <!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8"> <meta name="viewport" content="width=device-width, initial-scale=1.0"> <meta http-equiv="X-UA-Compatible" content="ie=edge"> <title>Document</title> </head> <body> <h1>hello world</h1> </body> </html> docker run --name nginx-test \ --rm -p 8888:80 \ -v $PWD:/usr/share/nginx/html \ -d nginx 小技巧:如果命令行过长,可以使用符号多行书写 访问 http://localhost:8888/ 已经发生变化了! 参数解释:-v: $PWD:/usr/share/nginx/html表示把容器内的/usr/share/nginx/html映射到当前目录,也就是my-nginx目录。于是nginx返回的index.html也就变成了我们本地的index.html了。 我们可以试着在本地新建一个1.html,然后访问 http://localhost:8888/1.html 也可以看到输出了内容。 同理,如果我们希望修改容器里Nginx的配置,也可以把容器的/etc/nginx/conf.d/映射到本地,然后在本地新建配置mydefault.conf 为了复习一下基础篇的内容,我们希望构建一个本地的镜像,这个镜像基于Nginx,默认的欢迎页面内容就是我们刚刚新建的index.html 在my-nginx目录,新建Dockerfile FROM nginx # 将当前的index.html拷贝到容器的/usr/share/nginx/html/index.html COPY ./index.html /usr/share/nginx/html/index.html EXPOSE 80 docker build -t my-nginx .构建镜像docker run -d --rm -p 4445:80 my-nginx 创建容器,访问 http://localhost:4445 可以看到效果了。 Redis 我们也可以在Docker里运行Redis。 docker pull redis docker run -d --name my-redis -p 6389:6379 redis 进入容器并且连接到redis # 进入my-redis容器里,并且在容器里执行redis-cli命令 docker exec -it my-redis redis-cli 于是我们就连接到redis里了,并且可以执行相应的redis命令 # 设置name set name tc # 获取name get name 因为我们把容器的6379端口映射到了本机的6389,所以我们也可以直接在本地连接容器里的redis # 需要你本地安装了redis-cli redis-cli -h 127.0.0.1 -p 6389 # 返回tc get name 总结 我们主要学习了Docker里镜像和容器的基本概念,掌握了端口映射(-p)和目录映射(-v)的用法,同时学习了如何在Docker里使用Nginx和Redis。在下一篇文章里,会继续介绍Docker实战 参考 只要一小时,零基础入门Docker 10分钟看懂Docker和K8S

优秀的个人博客,低调大师

Java工程师成神之路(2019正式版)

主要版本 更新时间 备注 v1.0 2015-08-01 首次发布 v1.1 2018-03-12 增加新技术知识、完善知识体系 v2.0 2019-02-19 结构调整,更适合从入门到精通;进一步完善知识体系; 新技术补充; 一、基础篇 面向对象 什么是面向对象 面向对象、面向过程 面向对象的三大基本特征和五大基本原则 平台无关性 Java如何实现的平台无关 JVM还支持哪些语言(Kotlin、Groovy、JRuby、Jython、Scala) 值传递 值传递、引用传递 为什么说Java中只有值传递 封装、继承、多态 什么是多态、方法重写与重载 Java的继承与实现 构造函数与默认构造函数 类变量、成员变量和局部变量 成员变量和方法作用域 Java基础知识 基本数据类型 8种基本数据类型:整型、浮点型、布尔型、字符型 整型中byte、short、int、long的取值范围 什么是浮点型?什么

优秀的个人博客,低调大师

Java 工程师成神之路 | 2019正式版

基础篇 01面向对象 → 什么是面向对象面向对象、面向过程 面向对象的三大基本特征和五大基本原则 → 平台无关性Java 如何实现的平台无关 JVM 还支持哪些语言(Kotlin、Groovy、JRuby、Jython、Scala) → 值传递值传递、引用传递 为什么说 Java 中只有值传递 → 封装、继承、多态什么是多态、方法重写与重载 Java 的继承与实现 构造函数与默认构造函数 类变量、成员变量和局部变量 成员变量和方法作用域 02 Java 基础知识 → 基本数据类型7 种基本数据类型:整型、浮点型、布尔型、字符型 整型中 byte、short、int、long 的取值范围 什么是浮点型?什么是单精度和双精度?为什么不能用浮点型表示金额? → 自动拆装箱什么是包装类型、什么是基本类型、什么是自动拆装箱 Integer 的缓存机制 → String字符串的不可变性 JDK 6 和 JDK 7 中 substring 的原理及区别、 replaceFirst、replaceAll、replace 区别、 String 对“+”的重载、字符串拼接的几种方式和区别 String.valueOf 和 Integer.toString 的区别、 switch 对 String 的支持 字符串池、常量池(运行时常量池、Class 常量池)、intern → 熟悉 Java 中各种关键字transient、instanceof、final、static、volatile、synchronized、const 原理及用法 → 集合类常用集合类的使用、ArrayList 和 LinkedList 和 Vector 的区别 、SynchronizedList 和 Vector 的区别、HashMap、HashTable、ConcurrentHashMap 区别、 Set 和 List 区别?Set 如何保证元素不重复? Java 8 中 stream 相关用法、apache 集合处理工具类的使用、不同版本的 JDK 中 HashMap 的实现的区别以及原因 Collection 和 Collections 区别 Arrays.asList 获得的 List 使用时需要注意什么 Enumeration 和 Iterator 区别 fail-fast 和 fail-safe CopyOnWriteArrayList、ConcurrentSkipListMap → 枚举枚举的用法、枚举的实现、枚举与单例、Enum 类 Java 枚举如何比较 switch 对枚举的支持 枚举的序列化如何实现 枚举的线程安全性问题 → IO字符流、字节流、输入流、输出流、 同步、异步、阻塞、非阻塞、Linux 5 种 IO 模型 BIO、NIO 和 AIO 的区别、三种 IO 的用法与原理、netty → 反射反射与工厂模式、反射有什么用 Class 类、java.lang.reflect.* → 动态代理静态代理、动态代理 动态代理和反射的关系 动态代理的几种实现方式 AOP → 序列化什么是序列化与反序列化、为什么序列化、序列化底层原理、序列化与单例模式、protobuf、为什么说序列化并不安全 → 注解元注解、自定义注解、Java 中常用注解使用、注解与反射的结合 Spring 常用注解 → JMS什么是 Java 消息服务、JMS 消息传送模型 → JMXjava.lang.management.、 javax.management. → 泛型泛型与继承、类型擦除、泛型中 KTVE? object 等的含义、泛型各种用法 限定通配符和非限定通配符、上下界限定符 extends 和 super List 和原始类型 List 之间的区别? "> List<?> 和 List 之间的区别是什么?"> → 单元测试junit、mock、mockito、内存数据库(h2) → 正则表达式java.lang.util.regex.* → 常用的 Java 工具库commons.lang、commons.*...、 guava-libraries、 netty → API & SPIAPI、API 和 SPI 的关系和区别 如何定义 SPI、SPI 的实现原理 → 异常异常类型、正确处理异常、自定义异常 Error 和 Exception 异常链、try-with-resources finally 和 return 的执行顺序 → 时间处理时区、冬令时和夏令时、时间戳、Java 中时间 API 格林威治时间、CET,UTC,GMT,CST 几种常见时间的含义和关系 SimpleDateFormat 的线程安全性问题 Java 8 中的时间处理 如何在东八区的计算机上获取美国时间 → 编码方式Unicode、有了 Unicode 为啥还需要 UTF-8 GBK、GB2312、GB18030 之间的区别 UTF8、UTF16、UTF32 区别 URL 编解码、Big Endian 和 Little Endian 如何解决乱码问题 → 语法糖Java 中语法糖原理、解语法糖 语法糖:switch 支持 String 与枚举、泛型、自动装箱与拆箱、方法变长参数、枚举、内部类、条件编译、 断言、数值字面量、for-each、try-with-resource、Lambda 表达式 03阅读源代码 String、Integer、Long、Enum、 BigDecimal、ThreadLocal、ClassLoader & URLClassLoader、 ArrayList & LinkedList、 HashMap & LinkedHashMap & TreeMap & CouncurrentHashMap、HashSet & LinkedHashSet & TreeSet 04 Java 并发编程 → 并发与并行什么是并发、什么是并行 并发与并行的区别 → 什么是线程,与进程的区别线程的实现、线程的状态、优先级、线程调度、创建线程的多种方式、守护线程 线程与进程的区别 → 线程池自己设计线程池、submit() 和 execute()、线程池原理 为什么不允许使用 Executors 创建线程池 → 线程安全死锁、死锁如何排查、线程安全和内存模型的关系 → 锁CAS、乐观锁与**悲观锁、数据库相关锁机制、分布式锁、偏向锁、轻量级锁、重量级锁、monitor、 锁优化、锁消除、锁粗化、自旋锁、可重入锁、阻塞锁、死锁 → 死锁什么是死锁 死锁如何解决 → synchronizedsynchronized 是如何实现的? synchronized 和 lock 之间关系、不使用 synchronized 如何实现一个线程安全的单例 synchronized 和原子性、可见性和有序性之间的关系 → volatilehappens-before、内存屏障、编译器指令重排和 CPU 指令重 volatile 的实现原理 volatile 和原子性、可见性和有序性之间的关系 有了 symchronized 为什么还需要 volatile → sleep 和 wait→ wait 和 notify→ notify 和 notifyAll→ ThreadLocal→ 写一个死锁的程序→ 写代码来解决生产者消费者问题→ 并方包Thread、Runnable、Callable、ReentrantLock、ReentrantReadWriteLock、Atomic*、Semaphore、CountDownLatch、ConcurrentHashMap、Executors 2底层篇 01JVM → JVM 内存结构 class 文件格式、运行时数据区:堆、栈、方法区、直接内存、运行时常量池、 堆和栈区别 Java 中的对象一定在堆上分配吗? → Java 内存模型计算机内存模型、缓存一致性、MESI 协议 可见性、原子性、顺序性、happens-before、 内存屏障、synchronized、volatile、final、锁 → 垃圾回收GC 算法:标记清除、引用计数、复制、标记压缩、分代回收、增量式回收 GC 参数、对象存活的判定、垃圾收集器(CMS、G1、ZGC、Epsilon) → JVM 参数及调优-Xmx、-Xmn、-Xms、Xss、-XX:SurvivorRatio、 -XX:PermSize、-XX:MaxPermSize、-XX:MaxTenuringThreshold → Java 对象模型oop-klass、对象头 → HotSpot即时编译器、编译优化 → 虚拟机性能监控与故障处理工具jps, jstack, jmap, jstat, jconsole, jinfo, jhat, javap, btrace, TProfiler Arthas 02 类加载机制 classLoader、类加载过程、双亲委派(破坏双亲委派)、模块化(jboss modules、osgi、jigsaw) 03 编译与反编译 什么是编译(前端编译、后端编译)、什么是反编译 JIT、JIT 优化(逃逸分析、栈上分配、标量替换、锁优化) 编译工具:javac 反编译工具:javap 、jad 、CRF 3进阶篇 01 Java 底层知识 → 字节码、class 文件格式→ CPU 缓存,L1,L2,L3 和伪共享→ 尾递归→ 位运算用位运算实现加、减、乘、除、取余 02 设计模式设计模式的六大原则: 开闭原则(Open Close Principle)、里氏代换原则(Liskov Substitution Principle)、依赖倒转原则(Dependence Inversion Principle) 接口隔离原则(Interface Segregation Principle)、迪米特法则(最少知道原则)(Demeter Principle)、合成复用原则(Composite Reuse Principle) → 了解 23 种设计模式 创建型模式:单例模式、抽象工厂模式、建造者模式、工厂模式、原型模式。 结构型模式:适配器模式、桥接模式、装饰模式、组合模式、外观模式、享元模式、代理模式。 行为型模式:模版方法模式、命令模式、迭代器模式、观察者模式、中介者模式、备忘录模式、解释器模式(Interpreter 模式)、状态模式、策略模式、职责链模式(责任链模式)、访问者模式。 → 会使用常用设计模式单例的七种写法:懒汉——线程不安全、懒汉——线程安全、饿汉、饿汉——变种、静态内部类、枚举、双重校验锁 工厂模式、适配器模式、策略模式、模板方法模式、观察者模式、外观模式、代理模式等必会 → 不用 synchronized 和 lock,实现线程安全的单例模式→ 实现 AOP→ 实现 IOC→ nio 和 reactor 设计模式 03 网络编程知识 → tcp、udp、http、https 等常用协议 三次握手与四次关闭、流量控制和拥塞控制、OSI 七层模型、tcp 粘包与拆包 → http/1.0 http/1.1 http/2 之前的区别http 中 get 和 post 区别 常见的 web 请求返回的状态码 404、302、301、500分别代表什么 → http/3→ Java RMI,Socket,HttpClient→ cookie 与 sessioncookie 被禁用,如何实现 session → 用 Java 写一个简单的静态文件的 HTTP 服务器→ 了解 nginx 和 apache 服务器的特性并搭建一个对应的服务器→ 用 Java 实现 FTP、SMTP 协议→ 进程间通讯的方式→ 什么是 CDN?如果实现?→ DNS什么是 DNS 、记录类型: A 记录、CNAME 记录、AAAA 记录等域名解析、根域名服务器 DNS 污染、DNS 劫持、公共 DNS:114 DNS、Google DNS、OpenDNS → 反向代理正向代理、反向代理 反向代理服务器 04 框架知识 → Servlet 生命周期 线程安全问题 filter 和 listener web.xml 中常用配置及作用 → Hibernate什么是 OR Mapping Hibernate 的懒加载Hibernate 的缓存机制 Hibernate / Ibatis / MyBatis 之间的区别 → Spring Bean 的初始化AOP 原理实现 Spring 的IOCSpring 四种依赖注入方式→ Spring MVC什么是 MVC Spring mvc 与 Struts mvc 的区别 → Spring BootSpring Boot 2.0、起步依赖、自动配置、 Spring Boot 的 starter 原理,自己实现一个 starter → Spring Security→ Spring Cloud服务发现与注册:Eureka、Zookeeper、Consul 负载均衡:Feign、Spring Cloud Loadbalance 服务配置:Spring Cloud Config 服务限流与熔断:Hystrix 服务链路追踪:Dapper 服务网关、安全、消息 05 应用服务器知识 → JBoss→ tomcat→ jetty→ Weblogic 06 工具 → git & svn→ maven & gradle→ Intellij IDEA常用插件:Maven Helper 、FindBugs-IDEA、阿里巴巴代码规约检测、GsonFormat Lombok plugin、.ignore、Mybatis plugin 4高级篇 01 新技术 → Java 8 lambda 表达式、Stream API、时间 API → Java 9Jigsaw、Jshell、Reactive Streams → Java 10局部变量类型推断、G1 的并行 Full GC、ThreadLocal 握手机制 → Java 11ZGC、Epsilon、增强 var → Spring 5响应式编程 → Spring Boot 2.0→ HTTP/2→ HTTP/3 02 性能优化 使用单例、使用 Future 模式、使用线程池 选择就绪、减少上下文切换、减少锁粒度、数据压缩、结果缓存 03 线上问题分析 → dump 获取 线程 Dump、内存 Dump、gc 情况 → dump 分析分析死锁、分析内存泄露 → dump 分析及获取工具jstack、jstat、jmap、jhat、Arthas → 自己编写各种 outofmemory,stackoverflow 程序HeapOutOfMemory、 Young OutOfMemory、 MethodArea OutOfMemory、ConstantPool OutOfMemory、 DirectMemory OutOfMemory、Stack OutOfMemory Stack OverFlow → Arthasjvm 相关、class/classloader 相关、monitor/watch/trace 相关、 options、管道、后台异步任务 文档:https://alibaba.github.io/arthas/advanced-use.html → 常见问题解决思路内存溢出、线程死锁、类加载冲突 → 使用工具尝试解决以下问题,并写下总结当一个 Java 程序响应很慢时如何查找问题 当一个 Java 程序频繁 FullGC 时如何解决问题 如何查看垃圾回收日志 当一个 Java 应用发生 OutOfMemory 时该如何解决 如何判断是否出现死锁 如何判断是否存在内存泄露 使用 Arthas 快速排查 Spring Boot 应用404/401问题 使用 Arthas 排查线上应用日志打满问题 利用 Arthas 排查 Spring Boot 应用 NoSuchMethodError 04编译原理知识 → 编译与反编译→ Java 代码的编译与反编译→ Java 的反编译工具javap 、jad 、CRF → 即时编译器→ 编译过程词法分析,语法分析(LL 算法,递归下降算法,LR 算法)语义分析,运行时环境,中间代码,代码生成,代码优化 05 操作系统知识 → Linux 的常用命令→ 进程间通信→ 进程同步生产者消费者问题、哲学家就餐问题、读者写者问题 → 缓冲区溢出→ 分段和分页→ 虚拟内存与主存→ 虚拟内存管理→ 换页算法 06 数据库知识 → MySQL 执行引擎→ MySQL 执行计划如何查看执行计划,如何根据执行计划进行 SQL 优化 → 索引Hash 索引、B 树索引(B+树、和B树、R树) 普通索引、唯一索引 覆盖索引、最左前缀原则、索引下推 → SQL 优化→ 数据库事务和隔离级别事务的隔离级别、事务能不能实现锁的功能 → 数据库锁行锁、表锁、使用数据库锁实现乐观锁、 → 连接内连接,左连接,右连接 → 数据库主备搭建→ binlog→ redolog→ 内存数据库h2 → 分库分表→ 读写分离→ 常用的 NoSql 数据库redis、memcached → 分别使用数据库锁、NoSql 实现分布式锁→ 性能调优→ 数据库连接池 07 数据结构与算法知识 → 简单的数据结构 栈、队列、链表、数组、哈希表、 栈和队列的相同和不同之处 栈通常采用的两种存储结构 → 树二叉树、字典树、平衡树、排序树、 B 树、B+ 树、R 树、多路树、红黑树 → 堆大根堆、小根堆 → 图有向图、无向图、拓扑 → 排序算法稳定的排序:冒泡排序、插入排序、鸡尾酒排序、桶排序、计数排序、归并排序、原地归并排序、二叉排序树排序、鸽巢排序、基数排序、侏儒排序、图书馆排序、块排序 不稳定的排序:选择排序、希尔排序、Clover 排序算法、梳排序、堆排序、平滑排序、快速排序、内省排序、耐心排序 各种排序算法和时间复杂度 → 两个栈实现队列,和两个队列实现栈→ 深度优先和广度优先搜索→ 全排列、贪心算法、KMP 算法、hash 算法→ 海量数据处理分治,hash 映射,堆排序,双层桶划分,Bloom Filter,bitmap,数据库索引,mapreduce 等。 08大数据知识 → Zookeeper 基本概念、常见用法 → Solr,Lucene,ElasticSearch在 linux 上部署 solr,solrcloud,新增、删除、查询索引 → Storm,流式计算,了解 Spark,S4在 linux 上部署 storm,用 zookeeper 做协调,运行 storm hello world,local 和 remote 模式运行调试 storm topology。 → Hadoop,离线计算HDFS、MapReduce → 分布式日志收集 flume,kafka,logstash→ 数据挖掘,mahout 09 网络安全知识 → XSS XSS 的防御 → CSRF→ 注入攻击SQL 注入、XML 注入、CRLF 注入 → 文件上传漏洞→ 加密与解密对称加密、非对称加密、哈希算法、加盐哈希算法 MD5,SHA1、DES、AES、RSA、DSA 彩虹表 → DDOS攻击DOS 攻击、DDOS 攻击 memcached 为什么可以导致 DDos 攻击、什么是反射型 DDoS 如何通过 Hash 碰撞进行 DOS 攻击 → SSL、TLS,HTTPS→ 用 openssl 签一个证书部署到 apache 或 nginx 5架构篇 01分布式 数据一致性、服务治理、服务降级 → 分布式事务 2PC、3PC、CAP、BASE、 可靠消息最终一致性、最大努力通知、TCC → Dubbo服务注册、服务发现,服务治理 http://dubbo.apache.org/zh-cn/ → 分布式数据库怎样打造一个分布式数据库、什么时候需要分布式数据库、 mycat、otter、HBase → 分布式文件系统mfs、fastdfs → 分布式缓存缓存一致性、缓存命中率、缓存冗余 → 限流降级Hystrix、Sentinal → 算法共识算法、Raft 协议、Paxos 算法与 Raft 算法、 拜占庭问题与算法、2PC、3PC 02 微服务 SOA、康威定律 → ServiceMeshsidecar → Docker & Kubernets→ Spring Boot→ Spring Cloud 03 高并发 → 分库分表→ CDN 技术→ 消息队列ActiveMQ 04 监控 → 监控什么 CPU、内存、磁盘 I/O、网络 I/O 等 → 监控手段进程监控、语义监控、机器资源监控、数据波动 → 监控数据采集日志、埋点 → Dapper 05 负载均衡 tomcat 负载均衡、Nginx 负载均衡 四层负载均衡、七层负载均衡 06 DNS DNS 原理、DNS 的设计 07 CDN 数据一致性 6扩展篇 01 云计算 IaaS、SaaS、PaaS、虚拟化技术、openstack、Serverlsess 02 搜索引擎 Solr、Lucene、Nutch、Elasticsearch 03权限管理 Shiro 04 区块链 哈希算法、Merkle 树、公钥密码算法、共识算法、 Raft 协议、Paxos 算法与 Raft 算法、拜占庭问题与算法、消息认证码与数字签名 → 比特币挖矿、共识机制、闪电网络、侧链、热点问题、分叉 → 以太坊→ 超级账本 05人工智能 数学基础、机器学习、人工神经网络、深度学习、应用场景。 → 常用框架TensorFlow、DeepLearning4J 06 loT 07 量子计算 08 AR & VR 09其他语言 Groovy、Python、Go、NodeJs、Swift、Rust 7推荐书籍 《深入理解 Java 虚拟机》 《Effective Java》 《深入分析 Java Web 技术内幕》 《大型网站技术架构》 《代码整洁之道》 《架构整洁之道》 《Head First 设计模式》 《maven 实战》 《区块链原理、设计与应用》 《Java 并发编程实战》 《鸟哥的 Linux 私房菜》 《从Paxos 到 Zookeeper》 《架构即未来》 原文发布时间为:2019-02-18本文作者: Hollis 本文来自云栖社区合作伙伴“ Hollis ”,了解相关信息可以关注“ Hollis ”。

优秀的个人博客,低调大师

互联网 Java 工程师进阶知识完全扫盲

高并发架构 消息队列 为什么使用消息队列?消息队列有什么优点和缺点?Kafka、ActiveMQ、RabbitMQ、RocketMQ 都有什么优点和缺点? 如何保证消息队列的高可用? 如何保证消息不被重复消费?(如何保证消息消费时的幂等性) 如何保证消息的可靠性传输?(如何处理消息丢失的问题) 如何保证消息的顺序性? 如何解决消息队列的延时以及过期失效问题?消息队列满了以后该怎么处理?有几百万消息持续积压几小时,说说怎么解决? 如果让你写一个消息队列,该如何进行架构设计啊?说一下你的思路。 搜索引擎 es 的分布式架构原理能说一下么(es 是如何实现分布式的啊)? es 写入数据的工作原理是什么啊?es 查询数据的工作原理是什么啊?底层的 lucene 介绍一下呗?倒排索引了解吗? es 在数据量很大的情况下(数十亿级别)如何提高查询效率啊? es 生产集群的部署架构是什么?每个索引的数据量大概有多少?每个索引大概有多少个分片? 缓存 在项目中缓存是如何使用的?缓存如果使用不当会造成什么后果? Redis 和 Memcached 有什么区别?Redis 的线程模型是什么?为什么单线程的 Redis 比多线程的 Memcached 效率要高得多? Redis 都有哪些数据类型?分别在哪些场景下使用比较合适? Redis 的过期策略都有哪些?手写一下 LRU 代码实现? 如何保证 Redis 高并发、高可用?Redis 的主从复制原理能介绍一下么?Redis 的哨兵原理能介绍一下么? Redis 的持久化有哪几种方式?不同的持久化机制都有什么优缺点?持久化机制具体底层是如何实现的? Redis 集群模式的工作原理能说一下么?在集群模式下,Redis 的 key 是如何寻址的?分布式寻址都有哪些算法?了解一致性 hash 算法吗?如何动态增加和删除一个节点? 了解什么是 Redis 的雪崩和穿透?Redis 崩溃之后会怎么样?系统该如何应对这种情况?如何处理 Redis 的穿透? 如何保证缓存与数据库的双写一致性? Redis 的并发竞争问题是什么?如何解决这个问题?了解 Redis 事务的 CAS 方案吗? 生产环境中的 Redis 是怎么部署的? 分库分表 为什么要分库分表(设计高并发系统的时候,数据库层面该如何设计)?用过哪些分库分表中间件?不同的分库分表中间件都有什么优点和缺点?你们具体是如何对数据库如何进行垂直拆分或水平拆分的? 现在有一个未分库分表的系统,未来要分库分表,如何设计才可以让系统从未分库分表动态切换到分库分表上? 如何设计可以动态扩容缩容的分库分表方案? 分库分表之后,id 主键如何处理? 读写分离 如何实现 MySQL 的读写分离?MySQL 主从复制原理是啥?如何解决 MySQL 主从同步的延时问题? 高并发系统 如何设计一个高并发系统? 分布式系统 系统拆分 为什么要进行系统拆分?如何进行系统拆分?拆分后不用 Dubbo 可以吗? 分布式服务框架 说一下 Dubbo 的工作原理?注册中心挂了可以继续通信吗? Dubbo 支持哪些序列化协议?说一下 Hessian 的数据结构?PB 知道吗?为什么 PB 的效率是最高的? Dubbo 负载均衡策略和集群容错策略都有哪些?动态代理策略呢? Dubbo 的 spi 思想是什么? 如何基于 Dubbo 进行服务治理、服务降级、失败重试以及超时重试? 分布式服务接口的幂等性如何设计(比如不能重复扣款)? 分布式服务接口请求的顺序性如何保证? 如何自己设计一个类似 Dubbo 的 rpc 框架? 分布式锁 Zookeeper 都有哪些应用场景? 使用 Redis 如何设计分布式锁?使用 Zookeeper 来设计分布式锁可以吗?以上两种分布式锁的实现方式哪种效率比较高? 分布式事务 分布式事务了解吗?你们如何解决分布式事务问题的?TCC 如果出现网络连不通怎么办?XA 的一致性如何保证? 分布式会话 集群部署时的分布式 Session 如何实现? 高可用架构 Hystrix 介绍 电商网站详情页系统架构 高可用系统 如何设计一个高可用系统? 限流 如何限流?在工作中是怎么做的?说一下具体的实现? 熔断 如何进行熔断? 熔断框架都有哪些?具体实现原理知道吗? 降级 需要获取答案的亲们可以加架构交流学习群获取噢 点击:加入JAVA架构学习交流群:614478470 如何进行降级? ​ 高并发架构 消息队列 为什么使用消息队列?消息队列有什么优点和缺点?Kafka、ActiveMQ、RabbitMQ、RocketMQ 都有什么优点和缺点? 如何保证消息队列的高可用? 如何保证消息不被重复消费?(如何保证消息消费时的幂等性) 如何保证消息的可靠性传输?(如何处理消息丢失的问题) 如何保证消息的顺序性? 如何解决消息队列的延时以及过期失效问题?消息队列满了以后该怎么处理?有几百万消息持续积压几小时,说说怎么解决? 如果让你写一个消息队列,该如何进行架构设计啊?说一下你的思路。 搜索引擎 es 的分布式架构原理能说一下么(es 是如何实现分布式的啊)? es 写入数据的工作原理是什么啊?es 查询数据的工作原理是什么啊?底层的 lucene 介绍一下呗?倒排索引了解吗? es 在数据量很大的情况下(数十亿级别)如何提高查询效率啊? es 生产集群的部署架构是什么?每个索引的数据量大概有多少?每个索引大概有多少个分片? 需要获取答案的亲们可以加架构交流学习群获取噢 点击:加入JAVA架构学习交流群:614478470 缓存 在项目中缓存是如何使用的?缓存如果使用不当会造成什么后果? Redis 和 Memcached 有什么区别?Redis 的线程模型是什么?为什么单线程的 Redis 比多线程的 Memcached 效率要高得多? Redis 都有哪些数据类型?分别在哪些场景下使用比较合适? Redis 的过期策略都有哪些?手写一下 LRU 代码实现? 如何保证 Redis 高并发、高可用?Redis 的主从复制原理能介绍一下么?Redis 的哨兵原理能介绍一下么? Redis 的持久化有哪几种方式?不同的持久化机制都有什么优缺点?持久化机制具体底层是如何实现的? Redis 集群模式的工作原理能说一下么?在集群模式下,Redis 的 key 是如何寻址的?分布式寻址都有哪些算法?了解一致性 hash 算法吗?如何动态增加和删除一个节点? 了解什么是 Redis 的雪崩和穿透?Redis 崩溃之后会怎么样?系统该如何应对这种情况?如何处理 Redis 的穿透? 如何保证缓存与数据库的双写一致性? Redis 的并发竞争问题是什么?如何解决这个问题?了解 Redis 事务的 CAS 方案吗? 生产环境中的 Redis 是怎么部署的? 分库分表 为什么要分库分表(设计高并发系统的时候,数据库层面该如何设计)?用过哪些分库分表中间件?不同的分库分表中间件都有什么优点和缺点?你们具体是如何对数据库如何进行垂直拆分或水平拆分的? 现在有一个未分库分表的系统,未来要分库分表,如何设计才可以让系统从未分库分表动态切换到分库分表上? 如何设计可以动态扩容缩容的分库分表方案? 分库分表之后,id 主键如何处理? 读写分离 如何实现 MySQL 的读写分离?MySQL 主从复制原理是啥?如何解决 MySQL 主从同步的延时问题? 高并发系统 如何设计一个高并发系统? 需要获取答案的亲们可以加架构交流学习群获取噢 点击:加入JAVA架构学习交流群:614478470 分布式系统 系统拆分 为什么要进行系统拆分?如何进行系统拆分?拆分后不用 Dubbo 可以吗? 分布式服务框架 说一下 Dubbo 的工作原理?注册中心挂了可以继续通信吗? Dubbo 支持哪些序列化协议?说一下 Hessian 的数据结构?PB 知道吗?为什么 PB 的效率是最高的? Dubbo 负载均衡策略和集群容错策略都有哪些?动态代理策略呢? Dubbo 的 spi 思想是什么? 如何基于 Dubbo 进行服务治理、服务降级、失败重试以及超时重试? 分布式服务接口的幂等性如何设计(比如不能重复扣款)? 分布式服务接口请求的顺序性如何保证? 如何自己设计一个类似 Dubbo 的 rpc 框架? 分布式锁 Zookeeper 都有哪些应用场景? 使用 Redis 如何设计分布式锁?使用 Zookeeper 来设计分布式锁可以吗?以上两种分布式锁的实现方式哪种效率比较高? 分布式事务 分布式事务了解吗?你们如何解决分布式事务问题的?TCC 如果出现网络连不通怎么办?XA 的一致性如何保证? 分布式会话 集群部署时的分布式 Session 如何实现? 需要获取答案的亲们可以加架构交流学习群获取噢 点击:加入JAVA架构学习交流群:614478470 高可用架构 Hystrix 介绍 电商网站详情页系统架构 高可用系统 如何设计一个高可用系统? 限流 如何限流?在工作中是怎么做的?说一下具体的实现? 熔断 如何进行熔断? 熔断框架都有哪些?具体实现原理知道吗? 降级 如何进行降级?

优秀的个人博客,低调大师

程序媛成长纪:从DBA到研发工程师

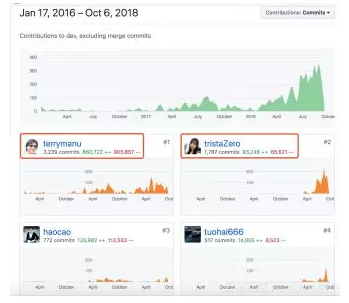
编者按:某日于X信偶遇张亮兄弟,已经跳槽到某东了。且开源项目Sharding-Sphere风声水起。开源这件事,做一年不难,难得的是持续投入和品质,包括生态的养成。为了表达对于开源项目的支持,收录张亮兄弟女弟子潘娟投稿一篇,作为程序媛可能获得某些优待如(妹子独有的沟通优势又能推动项目推广、与启荣老板畅谈人生),但仍然要经历无数的虐(P1级故障、投诉、争吵与被尊重)、无数的跨越式成长(数据库、运维、分布式技术...),成功没有捷径...... 十一的北京秋高气爽,坐在地铁上写下这些故事,愿与你产生共鸣,与我总结后,继续战斗。 起于DBA 契机 诚实讲,我一直不清楚自己想做什么。于是,研究生临近毕业,麻木游离在各大公司的面试中。感谢和启荣(刘启荣,现京东金融运维副总监)的相遇,让我开启了DBA的航程。启荣老大是个高情商、接地气的老板。我是第一次遇到面试谈人生问题,不告诉面试结果,一言不合就让我来听他讲课的面试官。当时他讲到的数据库与DBA的世界,以及那种自由又充满生机的互联网交流氛围,让我意识到有些人是与众不同的,有些地方是心之所向的。 日常 DBA的工作是严谨、有趣、辛苦的。一个初出茅庐的丫头,突然闯入一个全新数据库世界,又空降在京东这样量级的平台上,所谓的数据库技术、业务架构、系统的视野与互联网的眼界,就像山呼海啸一样奔腾而来,以至于产生了一种真的扛不住的无力感。但是,为我抉择的负责,为大家给予我信任的回报,持有这样心理的我,开始疯狂地像海绵一样吸收着这海洋般的知识,并不断提升着自己的认知。一整年的周末都躲到公司无人的会议室啃着《MySQL技术内幕:innodb存储引擎》、《高性能MySQL》、工作笔记、Shell编程技术,去培养自己的数据库知识及运维技能。因为我知道,当一个人没有足够实力的时候,只有时间和努力才能让她蜕变,以及获得别人的尊重。 作为组里唯一的妹子,感谢他们只是把我当汉子用,而不是当牲口用。很多夜间运维的活儿尽量不给我。不过我真心觉得,只有这些真刀真枪的工作才能见识真正的战场,只有这样的战场才能让战士迅速成长。所以我投入了这无尽的战斗中,看到过凌晨3点的月亮,也哭诉过整夜迁移无尽头的折磨和无奈。而第一次失误导致用户收到乱码短息、被投诉造成P1级别(最高P0)故障时,也终于知道什么叫电话被领导打爆。一个人自责地在冬天回龙观的大街上嚎啕大哭,不知所措,着急地想抽自己两嘴巴子!现在觉得,那场景非常类似电影里小姑娘被男朋友甩了的经典剧情。不过那种疼到骨子里的自责确实让我真切地感受到生产环境的重要性,以及DBA工作的极尽严谨,我输入的一条命令背后是千千万万与业务紧密相关的数据,是无数用户的使用与体验。好吧,更是我甩给老板的锅和整个部门战友们的KPI。感谢那一次次让我头破血流的南墙,因为它让我知道了做事的深浅与尺度,让我拥有了能够面对更大挑战的勇气和力量。 总结 这段时间让我成长为一个合格的DBA。除了掌握数据库知识体系及周围生态外,还积累了大规模数据库运维经验。此外,所谓的风险意识、快狠准和粗中有细的运维意识也开始慢慢建立。但我觉得有两个能力非常重要,那就是:作为下属对上级命令的绝对执行力,以及面对严苛环境的抗击打能力。 承于DevOps 契机 人工运维以及脚本运维已经无法满足激增的业务发展,对数据库运维要求出现多元化、多维度的需求。同时运维的边际效益日益凸显,于是整个运维部门开始向DevOps转变。而当时负责数据库工单系统自动化平台建设的前辈突然被借调,于是该项目基本停滞。那时,我心里小恶魔非常想让我主动请缨负责这个项目,但当时的我并没有多少项目开发经验,人微言轻。可是,依据当时部门发展风向,自动化是大势所趋,只有顺势而为,才能有机会获得大家的认可和肯定,此时若主动出击,便有可能危中求机。再静心分析,前期积累的大规模数据库运维经验,可以让我理解这个项目的核心需求和期望,而曾经和研发及运维同事的交往基础、妹子独有的沟通优势又能推动项目推广。于是在得到欢哥(周欢,现网联数据库负责人)鼓励和授权后,开始动手!正如那句话所说:并不是所有的比赛,都能允许你做好十足的准备。面对危机,有时候尝试放手一搏,可能会带来希望和转机。 日常 没有Python经验,我就死啃Python开发,并换工位到组里Python大神旁边,方便随时请教。大半年的时间基本处于封闭开发状态,实行小步迭代的敏捷开发方针。在地铁上分析需求、设计方案、构思代码。在公司跟老板明确需求、开发功能、解决Bug。周末则利用业务低谷,进行上线测试。此外,还要跨部门合作和推广。刚开始的时候,工作推动很难有进展。因为别人根本不听你说什么,任你焦急、愤怒,全都无济于事。越是想着如何说服对方,越只能得到升级版的争吵。后来渐渐意识到,不要尝试与他人争对错,因为根本没有对错。如何通过协商、退让达到双方共赢、双方满意的目的才是王道。同时,启荣哥告诉我互联网的三不要精神:不要钱、不要脸、不要命,我觉得很有道理。在一次次的沟通和打脸后,信任逐渐被建立起来了。对方尊重你,是尊重你的付出,尊重你的能力,尊重双方的利益。最终,数据库工单平均执行效率提高70%、非法工单拦截率为30%、工单正确执行率保持在99.99%的报告终于为这大半年的付出画上圆满的句号。 总结 这个阶段依据部门风向,从运维DBA转向数据库运维开发DBA,积累了项目开发经验,未卜先知的情况下,竟为后续转行打下基础。此外,跨部门沟通合作、推广也让我懂得了要学会选择和衡量、共赢与合作,并保持乐观平和的心态。 转于JAVA 契机 数据库自动化工单平台已取代人肉工单操作,发展趋于平稳,同时深感自己的圈子和视界太狭隘。就在这样浑水摸鱼的时候,启荣老板给我介绍了新的男神:张亮,原当当架构部负责人,热爱开源,怀揣着将Sharding-Sphere打造为业界一流的金融级开源分布式数据库中间件的梦想加入了京东金融。可能考虑到我DBA的知识积累和研究生英语水平,当然最重要的是我不要脸的人美心善。所以,让我协助亮哥将Sharding-Sphere官档翻译成英文。开源、数据库中间件、微服务、分布式事务、数据库治理……一大堆新鲜的名词冲进我贫困的大脑,打开了更广阔世界的天窗,并对我产生强大吸引力。此外,当时平滑的成长曲线让我迫切想打开自己狭隘视野的枷锁。于是,我开始仔细分析现状:开源、分布式、微服务、Java开发等对我来说又是个全新领域,转行可能将抛弃部分积累的数据库行业积淀。不过,这些数据库运维经验,对全是Java开发以及架构出身的团队来讲,未尝不是一种互补的优势。同时,前期数据库自动化工单平台项目也能帮我做跨行的平滑过渡。思及此时,我终于跟启荣探讨了人生问题和情感问题,并转向了金融级开源分布式数据库中间件Sharding-Sphere的开发。 日常 前期对官档的翻译工作,让我对Sharding-Sphere的核心功能,产品定位有了比较全面的理论层面认识。于是开始从源码层面入手,修改小的Bug,编写测试用例,到后来负责一整块的内核功能。在亮哥的指导下不断深入Sharding-Sphere,并对编码又了新的理解。它绝对不是故步自封,随心所欲地编写,而是存在规则和逻辑的简洁优雅编码之道以及重构迭代的价值意义。函数与函数之间的空行、段首多少空格、变量名字命名这些在常人眼里无足轻重的事情都会被亮哥格外重视,他对设计和代码120%的要求让我对细节有了100%的注重。从GitHub代码提交记录可以看出整个变化的步伐,从平缓的小步改造,到后期的模块开发(见下图)。坐在工位上看似发呆地进行思考设计、逻辑整理。获得对整套业务逻辑的深刻理解,便觉得酣畅淋漓;通过DBA视觉和亮哥交流需求,得到新的启示和想法,便觉得颇有意义;而更多时候是一个人进入所谓的”心流”,将脑子里勾画出架构用代码去渐渐实现,那种忘记周遭,沉迷于代码与音乐世界,又让人感觉时光飞逝。当真正想做一件事情、对其充满兴趣的时候,才会知道什么叫乐此不疲。 此外,也开始逐渐走向台前,对外分享,建立影响力。通过认识大牛,同样开阔了自己的眼界并培养行业灵敏度。京东在线平台的分享扩大了Sharding-Sphere内部影响力;参加火币、饿了么、贝壳金服的交流分享则了解大家对数据库中间件的认识和需求;担任2018ODF数据库大会的主持,重新看到数据库的行业发展;担任ServiceComb交流活动的主持,则能感受到开源的力量。一次次活动经验,也是一次次小小的积淀,慢慢让自己懂得了分享的价值,并建立对外影响力。感谢各位大牛的提携之恩,也感谢启荣总,亮哥给予的一次次分享交流的机会。其实,每个人都有自己独特的优势,多多分析总结,因地制宜,合理运用,才有可能百尺竿头更进一步。 部分分享照片 总结 这一阶段对内低头磨炼开发之道以及学习架构重构,并了解开源、分布式、中间件的架构体系。对外积极交流分享,培养行业影响力,锻炼表达能力。对时间自由掌控,对事情要求极致。 合于? 当下,仍需不断对所在行业的宽度、深度进行积累。在数据库中间件、DataBaseMesh、开源方面投入主要精力。在亮哥带领下将Sharding-Sphere做到理想高度(P.欢迎关注https://github.com/sharding-sphere!)。同时,也希望自己多思考,多磨砺下品性,把控前进方向,明确目标。然而现实很骨干,浅薄的我还在探索之中。对于未来,如果你的高度不足以支撑你当下的选择,不如借鉴下大牛和前辈的思考,站的在那个高度的他们的指点或许会给你打开新的天窗。 一路成长,总结其原因,我觉得主要有三大点。第一,感谢我上面提到的各位老板能给予我机会、能放权让我去做事情、能宽容我的傲慢与偏见;第二,感谢京东的大平台,能让我结识到这些大牛前辈,能让我看到不断变化进步的世界,并推动我不得不去自我提升;第三,则是感谢自己,懂得思考并及时按照发展调节方向,唯有全力以赴、放手一搏才能危中求机。 我会在这个领域走多远多高,我能拥怎样的生活,能写什么样的故事,又能和哪些人一路相伴?对于未来,现在的我也同样没有答案。只是,曾经一步步扎扎实实的探索确实让我有了更坚强的意志和勇气去面对必须要面对的现实。愿这一路的小小故事,能给正在阅读的你一些思考和想法,并引起你的共鸣。倘若如此,也不枉这个十一假期一次次的码字和修改,也不枉右军老师的邀请。我相信每个人都有自己的故事,每个人都是独特的你! 原文发布时间为:2018-10-18 本文作者:潘娟 本文来自云栖社区合作伙伴“技术琐话”,了解相关信息可以关注“技术琐话”。

优秀的个人博客,低调大师

Python全栈工程师 (类变量、方法、继承、覆盖)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 开局一张图 Python人工智能从入门到精通 补充: 实例方法都是操作实例对象的 属于此类对象的方法 实例变量 添加/修改属性: 对象.属性名 = 表达式 删除: del 对象.属性名 类 | 对象 | 实例 class object instance 类的本质上也是对象 类可以创建此类对象 ----------------------------------------------------------------------------------------------------------------- 类: 类变量: 类变量是类的属性, 此属性属于类, 不属于此类的实例 作用: 通常用来储存该类创建的对象的共同属性 说明: 类变量可以通过该类的实例直接访问 类变量可以通过类的实例间接访问 类变量可以通过此类的对象__class__属性间接访问示例: # -*- coding:utf-8 -*- # 类变量 class Human: total_count = 0 # 类变量 def __init__(self, name): print(name, '对象被创建') print(Human.total_count) # 0 h1 = Human("zhang") print(h1.total_count) # 0 用此类实例访问类变量 h1.total_count = 100 # 为对象添加实例变量 print(h1.total_count) # 100 优先访问实例变量 print(Human.total_count) # 0 访问类变量 class Human: total_count = 0 # 类变量 def __init__(self, name): print(name, '对象被创建') h1 = Human("zhang") print(Human.total_count) # 0 h1.__class__.total_count = 100 # 为类添加修改实例变量 print(h1.total_count) # 100 间接访问类变量 print(Human.total_count) # 100 访问类变量 # 类变量的应用 用类变量记录实例个数 class Human: total_count = 0 # 类变量 def __init__(self, name): print(name, '对象被创建') self.__class__.total_count += 1 # 每次创建对象调用__init__ 类变量加1 def __del__(self): self.__class__.total_count += 1 # 每次析构对象后类变量减1 h1 = Human("zhang") print("此时Human对象的个数是", Human.total_count) # 1 L = [] L.append(Human("li")) L.append(Human("zhao")) print("此时Human对象的个数是", Human.total_count) # 3 del h1 L.pop() print("此时Human对象的个数是", Human.total_count) # 1 类的文档字符串: 和函数等一样 用__doc__属性访问示例: >>> class Dog: ... '''这是小动物''' ... >>> help(Dog) >>> Dog.__doc__ '这是小动物' >>> 类 __slots__ 列表: 作用: 限定一个类的创建实例只能有固定的属性(实例变量) 不允许对象添加列表以外的属性(实例变量) 防止用户因错写属性的名称而发生错误 说明: 1.__slots__ 列表绑定一个字符串列表 2.含有__slots__列表的类所创建的实例对象没有__dict__属性 (不用字典储存对象的属性 __slots__限制) 示例: class Human: # 以下列表限制此类对象只能有这两个属性 防止出错 __slots__ = ["name", "age"] def __init__(self, name, age): self.name, self.age = name, age h1 = Human("Ta", 15) print(h1.age) # 15 h1.Age = 18 # 区分大小写 出错 没有Age属性,也不允许有 print(h1.age) # 15 类方法 @ classmethod 类方法是用于描述类的行为的方法 类方法属于类, 不属于类的实例 说明: 类方法需要使用 @classmethod装饰器定义 类方法至少有一个形参, 第一个形参用于绑定类, 约定写“cls” 类和该类的实例都可以调用类的方法 类方法不能访问此类创建的实例的属性示例: # 类方法的使用 class A: v = 0 @classmethod def get_v(cls): # cls 用来绑定调用此方法的类 return cls.v # 访问类变量 @classmethod def set_v(cls, value): cls.v = value print(A.get_v()) # 0 A.set_v(100) print(A.get_v()) # 100 a1 = A() # 创建实例 print("a1.get_v=", a1.get_v) # 100 a1.set_v(200) print("a1.get_v=", a1.get_v) # 200 print("A.get_v=", A.get_v) # 200 静态方法 @staticmethod 静态方法是定义在类内部的函数, 此函数的作用域是类的内部 说明: 静态方法需要使用 @staticmethod装饰器定义 静态方法与普通函数定义相同, 不需要传入self实例参数和cls参数 静态方法只能凭借该类的创建实例调用 静态方法不能访问变量和实例变量(属性)示例: # 静态方法 class A: @staticmethod def myadd(a, b): return a + b print(A.myadd(100, 200)) # 300 a = A() # 创建实例 print(a.myadd(300, 400)) # 700 # def myadd(a, b): # 和静态方法结果一样 # return a + b # class A: # pass # print(A.myadd(100, 200)) # 300 # a = A() # 创建实例 # print(a.myadd(300, 400)) # 700 实例方法, 类方法, 静态方法,函数, 小结: 1.不想访问 类内 的和 实例内 的变量, 用静态方法 2.只想访问类变量, 不想访问实例变量, 用类方法 3.既要访问类变量, 也想访问实例变量, 用实例方法 4.函数与静态方法相同, 只是静态方式的作用域定义在类内 继承inheritance/派生derive: 什么是继承/派生: 继承是从已有的类中派生出新的类, 新类具有原类的行为, 并能扩充新的行为 派生是从已有的类中衍生成新类, 在新类上可以添加新的属性和行为 作用: 用继承派生机制, 可以将一些共有的功能加在基类中, 实现代码的共享 在不改变基类的代码的基础上改变原有的功能 名词: 基类(base class) / 超类(super class)/父类(father class) 派生类(derived class)/子类(child class) 子类对象一定是父类对象的类型 父类对象不一定是子类对象的类型单继承: 语法: class 类名(基类名) 语句块 说明: 单继承是指由一各基类衍生出新的类 示例: # 单继承用法 class Human: # 人类的共性 def say(srlf, what): print("说:", what) def walk(self, distance): # 走路 print("走了", distance, "公里") class Student(Human): # 继承 # def say(srlf, what): # print("说:", what) # def walk(self, distance): # 走路 # print("走了", distance, "公里") def study(self, subject): # 派生 print("学习", subject) class Teacher(Student): def teach(self, subject): # 派生 print("教", subject) h1 = Human() h1.say("哈哈") h1.walk(500) s1 = Student() s1.walk(4) s1.say("666") s1.study("python") T1 = Teacher() T1.walk(4) T1.say("666") T1.teach("python") T1.study("Java") 继承说明: python3 任何类都可以直接或间接的继承object类 object类是一切类的超类(父类) class的继承参数不写, 默认继承object类 一般省略不写 object类的超类是None类的__base__属性: __base__ 属性用来记录此类的基类(父类)Python的内建类: help(__builtins__) 覆盖 override 覆盖是指在有继承关系的类中, 子类中实现了与基类同名的方法, 在子类 的实例调用该方法时, 实际调用的是子类的覆盖版本, 这种现象叫覆盖示例: # 覆盖 override class A: def works(self): print("A.works被调用") class B(A): '''B继承A类''' def works(self): print("B.works被调用") b = B() b.works() # B.works被调用 # B.works 覆盖 A.works 优先调用子类 # A派生B B继承A # 子类对象显示调用基类(被覆盖)方法的方式: # 基类.方法名(实例, 实际调用参数) A.works(b) # 用类名显示调用, A.works被调用 super 函数: super(cls, obj)返回绑定超类的实例(要求obj必须是cls类的实例) super() 返回绑定超类的实例, 等同于:super(__class__), 实例方法的第一个参数), 必须在方法内调用 作用: 借助于super()返回实例间接调用其父类的覆盖方法 # 用super函数返回的对象调用父类的覆盖方法 class A: def works(self): print("A.works被调用") class B(A): '''B继承A类''' def works(self): print("B.works被调用") def super_works(self): self.works() # B.works被调用 super(B, self).works() # A.works被调用 super().works() # A.works被调用 b = B() b.works() # B.works被调用 super(B, b).works() # A.works被调用 b = B() b.super_works() # B.works被调用 显示调用基类的初始化方法: 当子类中实现了__init__方法,基类的构造方法不会被调用 def __init__(self, ...) # 用super函数调用父类的覆盖__init__初始化方法 class Human: def __init__(self, n, a): self. name, self.age = n, a print("Human类的 __init__ 方法被调用") def infos(self): print("name:", self.name) print("age:", self.age) class Student(Human): def __init__(self, n, a, s=0): super().__init__(n, a) # 用siper 调用父类的__init__方法 self.score = s # 添加成绩属性 print("Student类的 __init__ 方法被调用") def info(self): super().infos() # 调用父类的方法 print("name:", self.name) print("age:", self.age) print("score:", self.score) # 不调用父类的方法也不会出错 但是尽量不要用 s1 = Student("小张", 20) s1.infos()

优秀的个人博客,低调大师

Python全栈工程师(函数嵌套、变量作用域)

ParisGabriel 感谢 大家的支持 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 Python人工智能从入门到精通 globals()/locals()函数: globals()返回当前全局作用域内变量的字典 locals() 返回当前局部作用域内变量的字典函数变量: 函数名是变量,它在def 语句创建时绑定函数 fa1 = fa 没有括号 绑定函数 fa1 = fa() 返回结果 函数的变量名可以序列交换算法一个函数可以作为另一个函数的实参传递:例如: def myinput(fn): L = [5, 3, 1, 9, 7] return fn(L) print(myinput(max)) print(myinput(min)) print(myinput(sum)) print(myinput(len)) 函数可以作为另一个函数的返回值:例如: def get_op(): s = input("qing shu ru cao zuo") if s == "zui da": return max elif s == "zui xiao": return min elif s == "he": return sum L = [2, 3, 4, 6,5, 6, 9, 1] print(L) f = get_op() print(f(L)) 函数的嵌套: 函数嵌套定义是指一个函数里用def语句来创建其他的函数 示例: def fn_outter(): print("fn_outter被调用") def fn_inner(): print("fn_inner被调用") fn_inner() fn_inner() print("fn_outter调用结束") fn_outter() Python的作用域: 作用域也叫名字空间,是访问变量时查找变量的范围空间 python的4个作用域: 作用域: 英文解释 缩写 局部作用域(函数内) Local(function) L 外部嵌套函数作用域 Enclosing functio loc E 函数定义所在模块(文件)作用域 Global(module) G python内建模块作用域 Builtin(python) B 包含关系(内建>模块>外部嵌套函数>函数内)变量名查找规则: 访问变量时,先查找本地变量,然后是包裹此函数外的函数内部的变量 ,之后是全局变量,最后是内建变量 L ---> E ---> G ---> B 在默认情况下,变量名赋值会创建或者改变当前作用域的变量global语句: 告诉解释执行器global语句声明一个或多个变量, 这些变量的作用域为模块级别的作用域,也称为全局变量全局声明(global) 将赋值语句操作的变量映射到模块文件内部的作用域 语法: global 变量1, 变量2, .... 说明: 1. 全局变量如果要在函数内部被赋值,则必须经过全局声明(否则会被认为是创建局部变量) 2. 全局变量在函数内部不经过声明就可以直接访问(变量已经存在并关联一个对象) 3. 不能先声明局部变量,再用global声明为全局变量,此做法不附合规则 4. global变量列表里的变量名不能出现在此作用域的形参列表里 nonlocal语句: 告诉解释执行器,nonlocal声明变量不是局部变量,也不是全局变量 它是外部嵌套函数变量 语法: nonlocal 变量名1,变量名2,... 说明: 1. nonlocal 语句只能在被嵌套的函数内部进行使用 2. 访问nonlocal变量将对外部嵌套函数作用域内的变量进行操作 3. 当有两层或两层以上函数嵌套时,访问nonlocal变量只对最近的一层变量进行操作 4. nonlocal语句的变量列表里的变量名,不能出现在此函数的参数列表中 lambda表达式(又称匿名函数)(希腊字母:入) 作用: 创建一个匿名函数对象 同def类似 但是不提供函数名 格式: lambda[ 参数1, 参数...]: 表达式 说明: 1. lambda 只是一个表达式,它用来创建一个函数对象 2. 当lambda表达式调用时,先执行冒号(:)后的表达式,并返回表达式的结果的引用关系 3. lambda 表达式创建的函数只能包含一条表达式 4. lambda 比函数简单且可以随时创建和销毁,有利于减少程序的偶合度 函数: eval () / exec() 函数 eval(source, globals=None, local=None) 把一个字符串 srouce 当成一个表达式来执行,返回表达式执行的结果 exec(source, globals=None, locals=None) 把一个字符串source 当成程序来执行 练习: 写一个函数叫hello(name),部分代码如下: count = 0 def hello(name): print('你好', name) ... 此处代码省略,需要同学们自己填写 ... 此处代码需要改变全局变量来记录此函数曾经被调用过多少次. hello('小张') hello('小李') print('hello 函数被调用', count, '次') # 2次 count = 0 def hello(name): global count count += 1 print("hello", name) hello("name") hello("xiaoli") hello("xiaoliu") hello("xiaowei") hello("xiaozhang") 1. 写一个lambda 表达式,判断这个数的2次方+1是否能被5整除,如果能被整除返回True, 否则返回False 例: fa = lambda x: ..... print(fa(2)) # True print(fa(4)) # False fa = lambda x: (x ** 2 + 1) % 5 == 0 print(fa(2)) # True print(fa(4)) # False 2. 写一个lambda表达式,求两个变量的最大值 例如: def mymax(x, y): ... mymax = lambda ... print(mymax(100, 200)) # 200 def mymax(x, y): if x > y: return x else: return y print(mymax(100, 200)) # 200 mymax = lambda x, y: x if x > y else y print(mymax(100, 200)) # 200 1. 给出一个整数n,写一个函数myfac来计算n!(n的阶乘) n! = 1 * 2 * 3 * 4 * ..... * n 如: print(myfac(5)) # 120 def myfac(n): x = 1 for i in range(1, n + 1): x = x * i return x print(myfac(5)) 2. 给出一个整数n,写一个函数计算myfn(n): 1 + 2**2 + 3**3 + .... + n**n的和 如: print(myfn(10)) # ??? def myfu(n): s = 0 for x in range(2, n + 1): s += x ** x return s print(myfu(10)) 3. 完全数: 1 + 2 + 3 = 6 (6为完全数) 1,2,3都为6的因数(因数是能被一个数x整除的整数为y,则y为x的因数) 1 x 6 = 6 2 x 3 = 6 完全数是指除自身以外的所有因数相加之和等于自身的数 求 4~5个完全数并打印出来 答案: 6 28 496 ...... def mywqs(x): s = 0 L = [] for i in range(1, x): if x % i == 0: L.append(i) for i in L: s += i if s == x: return True else: return False i = 0 wqs = 0 while wqs < 5: i += 1 if mywqs(i) == True: print(i) wqs += 1 咳咳 又到了吹NB环节 locals()、globals() 就是一个查询函数 以字典形式返回信息而已函数变量? 你就就把它看做一个全局变量 变量绑定数据 而它绑定语句块 就这么简单什么是作用域? 作用域就是变量的所属范围 超过范围就失效 在别的地方一般是3个作用域 而python有4个 内建变量 局部变量 模块全局变量 特殊那个就是两个函数嵌套之间的范围(外部嵌套) 分别都是包含关系(内建>模块>外部嵌套函数>函数内) 内建函数 不可删除或修改 其他作用域 不能与内建函数重名 否则内建函数失效 只作用于当前空间自定义函数 各作用域各不相干 同空间不可重名 global 不管在任何空间使用global都直接声明全局变量 nonlocal 只能在被嵌套函数内部使用 多层嵌套 只会跳一层 lambda 用表达式创建一个函数 和if一样

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册