首页 文章 精选 留言 我的

精选列表

搜索[小程序·云开发],共10036篇文章
优秀的个人博客,低调大师

Elasticsearch hadoop使用示例 & 运维实战之集群规划 &presto-elasticsearch connecto...

elasticsearch-hadoop使用示例 在elasticsearch-hadoop的具体使用中碰到了几个问题,有必要记录一下,避免下次遇到时又要重新研究。 利用spark读取es数据源的简单示例 import org.elasticsearch.spark.sql._ val esOptions = Map("es.nodes"->"192.168.1.2,192.168.1.3", "es.scroll.size"->"1000", "es.field.read.as.array.include"->"SampleField") val esDF = sqlContext.read.format("org.elasticsearch.spark.sql").options(esOptions).load("sampleindex/es-spark") esDF.registerTempTable("esdemotbl") es.scroll.size一次性读入的记录数,默认是10, 如果不设置为大一点的值,要从es中读取1亿条数据,那将是一个漫长的过程 es.field.read.as.array.include有的字段在es中是以string类型存储,但其中包含逗号(,), spark默认认为这是数组类型,如果读取这种字段的话,就会报错,怎么办,那就用es.field.read.as.array.include来显式指明 spark读取es中数据的时候,partition数目取决于es中指定index的shard数目,为了获得比较高的并发读取性能,建议适当设置shard数目,为什么是适当,因为具体取决于集群规模等多种因素。 字段名的大小写问题 在hive中,字段名是_大小写不敏感_的, 但在ES中是大小写敏感的 你说,这又怎么样。 呵呵, 这意味着不做特殊处理,永远无法读出es中大写字段名的内容,你看到的将是满屏的_NULL_ 这该怎么破,很简单,指定es.mapping.names 比如在es中,字段名为DemoField, 要读出其中的内容,hive表的字义就该这样写 create external table es_demo_tbl( demofield string) STORED BY 'org.elasticsearch.hadoop.hive.EsStorageHandler' TBLPROPERTIES('es.nodes'='192.168.1.2,192.168.1.3', 'es.resource'='demoindex/sample', 'es.mapping.names'='demofield:DemoField') 注意是先hive中的字段名,然后是es中的字段名 Elasticsearch 运维实战之集群规划 规划一个可用于生产环境的elasticsearch集群。 集群节点划分 整个集群的节点分为以下三种主要类型 Master nodes -- 负责维护集群状态,不保存index数据, 硬件要求: 一般性的机器就可以,给es进程分配16g内存 Data Nodes -- 只保存index的数据,不被选举为Master nodes 硬件要求: 配置要求越高越好,使用大硬盘,有条件可以上SSD硬盘 Client Nodes -- 主要用于负载均衡,不被选举为Master node, 也不保存index数据 硬件要求: 24核CPU, 64G内存或更高 一个合理的集群应该包含三个master nodes, 1到多个data nodes, 最少一个client node 安装与配置 通用配置,以centos为例,使用rpm安装包 sudo rpm -ivh elasticsearch-version.rpm sudo chkconfig --add elasticsearch 修改/etc/sysconfig/elasticsearch, 修改ES_HEAP_SIZE和JAVA_OPTS的内容,注意elasticsearch建议使用的最大内存是32G, ES_HEAP_SIZE=32g JAVA_OPTS="-Xms32g" 修改/etc/security/limits.conf, 添加如下内容 * hard memlock unlimited * soft memlock unlimited /etc/elasticsearch/elasticsearch.yml内容配置 master节点 node.master: true node.data: false discovery.zen.ping.unicast.hosts: ["master1","master2","master3"] network.host: ${HOSTNAME} data节点 node.master: false node.data: true discovery.zen.ping.unicast.hosts: ["master1","master2","master3"] network.host: ${HOSTNAME} 如果为elasticsearch配置了多块硬盘,可以修改DATA_DIR的值,多个目录使用逗号(,)分开 client节点 node.master: false node.data: false discovery.zen.ping.unicast.hosts: ["master1","master2","master3"] network.host: ${HOSTNAME} 启动elasticsearch sudo service elasticsearch start 需要注意的是elasticsearch在centos中使用service elasticsearch restart有时不能达到效果,需要分开来做 sudo kill -9 `pgrep -f elasticsearch` sudo service elasticsearch start nginx反向代理 为了记录针对集群的查询内容,建议使用nginx来做反向代理,nginx安装在client node上,conf.d/default.conf最简单的配置如下 upstream elasticsearch { server 127.0.0.1:9200; } server { gzip on; access_log /var/log/nginx/access.log combined; listen 80 default_server; server_name _; #charset koi8-r; #access_log logs/host.access.log main; # Load configuration files for the default server block. include /etc/nginx/default.d/*.conf; location / { root /usr/share/nginx/html; index index.html index.htm; proxy_set_header Host $http_host; proxy_set_header X-Real-IP $remote_addr; proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for; proxy_set_header X-Forwarded-Proto $scheme; proxy_pass http://elasticsearch; } error_page 404 /404.html; location = /404.html { root /usr/share/nginx/html; } # redirect server error pages to the static page /50x.html error_page 500 502 503 504 /50x.html; location = /50x.html { root /usr/share/nginx/html; } } 插件安装 建议安装如下插件 kopf 兼容es 1.x, 2.x kopf ./elasticsearch/bin/plugin install lmenezes/elasticsearch-kopf/{branch|version} head 兼容es 1.x bigdesk 兼容es 1.x presto-elasticsearch connector elasticsearch搜索功能强劲,就是查询语法复杂,presto提供了非常open的plugin机制,我改进了下原有的presto-elasticsearch connector,现发布于github 功能改进点 自动加载elasticsearch schema 支持分片数据加载 predication pushdown,注意由于presto spi接口的原因,目前只支持and类型的过滤器下推,对于OR表达式不支持,不支持like类型的过滤器下推 避免重复加载schema 运行办法 在etc/catalog目录下添加es.properties即可,内容如下 connector.name=elasticsearch elasticsearch-server=localhost elasticsearch-port=9300 elasticsearch-clustername=elasticsearch_demo 时间仓促,错误在所难免,欢迎批评指正。

优秀的个人博客,低调大师

Delta Lake Presto Integration & Manifests 机制

原文链接 该功能与我们之前平台化 Delta Lake 平台化实践(离线篇) 的很多工作都较为相似,比如与 metastore 的集成,直接通过 manifest 读取 delta 存活文件等。Delta Lake 在 0.5 之前只支持通过 Spark 读取数据,在新版本中增加了其他处理引擎通过 manifest 文件访问 Delta Lake 的能力。下文以Presto 为例说明如何通过 manifest 文件访问数据,manifest 文件的生成及其一些限制。 01 使用 Presto 使用 manifest 文件从 hive 外部表中读取数据,manifest文件是一个文本文件,包含该表/分区所有存活数据的路径列表。 当使用 manifest 文件在 Hive metastore 中定义外部表时,Presto 将会先读取 mani

优秀的个人博客,低调大师

Docker 上传镜像&拉取镜像

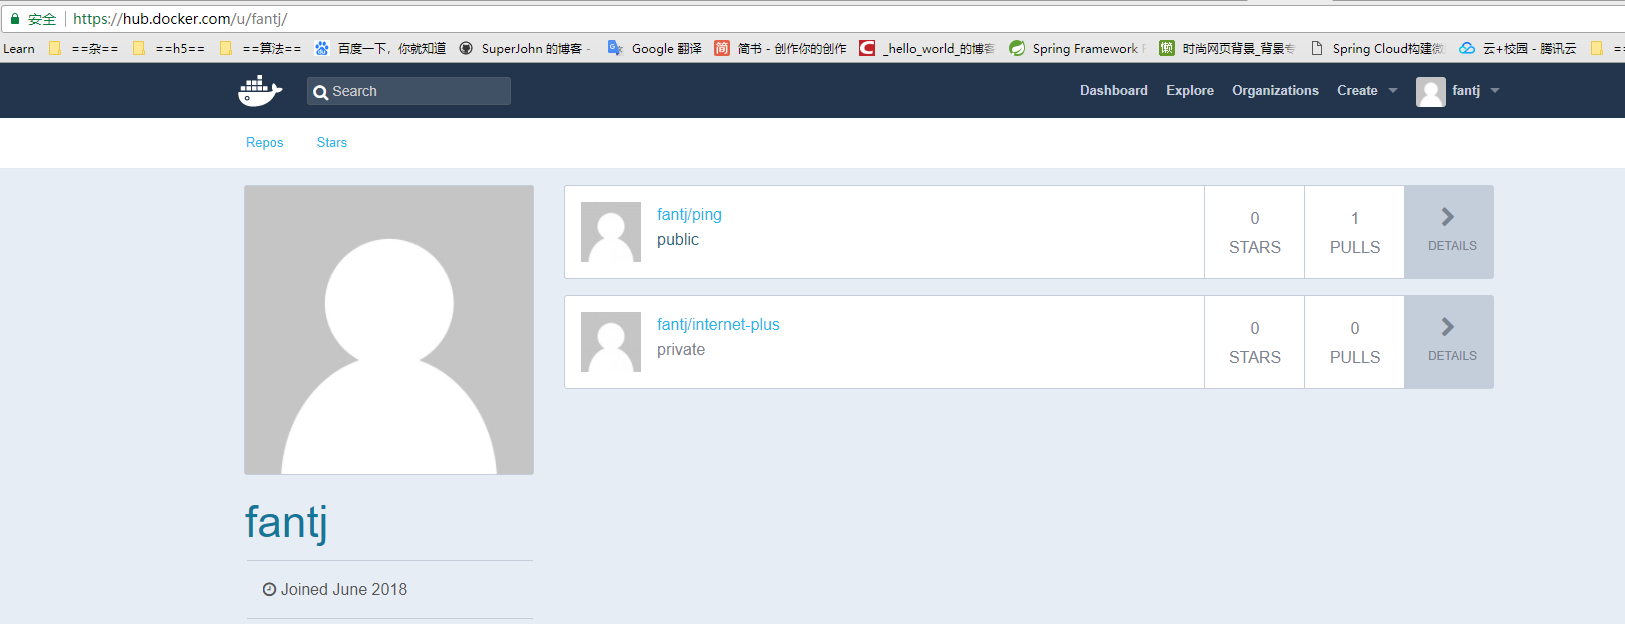
与git相似,docker也有自己的镜像仓库,官方仓库网站是https://hub.docker.com/,其实我们平时docker pull xxx就是从该仓库得到的镜像(在不设置国内镜像加速的情况下)。它和git仓库很相似。 创建账号 DockerHub:https://hub.docker.com/ 很多人在这里就出了问题,为什么都填完了但是不能点注册按钮呢?因为该网站目前来说注册是需要翻墙的,注册成功后再关闭翻墙。 我重新上传一个项目做示范,该镜像是从hub上pull到的一个nginx镜像,我把它上传到我的公开仓库。 上传镜像 先登录docker hub账号。 docker login [root@FantJ ~]# docker login Login with your Docker ID to push and pull images from Docker Hub. If you don't have a Docker ID, head over to https://hub.docker.com to create one. Username (fantj): fantj Password: Login Succeeded [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB [root@FantJ ~]# docker tag docker.io/nginx fantj/nginx [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB fantj/nginx latest ae513a47849c 4 weeks ago 109 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB [root@FantJ ~]# docker push fantj/nginx The push refers to a repository [docker.io/fantj/nginx] 7ab428981537: Mounted from library/nginx 82b81d779f83: Mounted from library/nginx d626a8ad97a1: Mounted from library/nginx latest: digest: sha256:e4f0474a75c510f40b37b6b7dc2516241ffa8bde5a442bde3d372c9519c84d90 size: 948 [root@FantJ ~]# 流程大概是:登录->tag操作->push注:tag 的第二个参数的前缀是你的hub账户名 拉取镜像 我先把服务器上的镜像删除掉,然后再从hub中拉取镜像。 # 删除本地fantj/nginx镜像 [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB fantj/nginx latest ae513a47849c 4 weeks ago 109 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB [root@FantJ ~]# docker rmi fantj/nginx Untagged: fantj/nginx:latest Untagged: fantj/nginx@sha256:e4f0474a75c510f40b37b6b7dc2516241ffa8bde5a442bde3d372c9519c84d90 [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB # 从hub中拉取fantj/nginx镜像 [root@FantJ ~]# docker pull fantj/nginx Using default tag: latest Trying to pull repository docker.io/fantj/nginx ... latest: Pulling from docker.io/fantj/nginx Digest: sha256:e4f0474a75c510f40b37b6b7dc2516241ffa8bde5a442bde3d372c9519c84d90 Status: Downloaded newer image for docker.io/fantj/nginx:latest [root@FantJ ~]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE docker.io/openjdk 8-jre bef23b4b9cac 2 weeks ago 443 MB docker.io/fantj/nginx latest ae513a47849c 4 weeks ago 109 MB docker.io/nginx latest ae513a47849c 4 weeks ago 109 MB [root@FantJ ~]#

优秀的个人博客,低调大师

第 1 章 Developer & Programming language

目录 1.1. System programming language 1.2. 编程语言热度排行榜 1.2.1. TIOBE Programming 编程语言排行榜 1.2.2. Programming Languages Reference Sheets - Hyperpolyglot 1.2.3. DB-Engines - DB-Engines Ranking 1.2.4. Web Framework Benchmarks 1.2.5. The 10 hottest JavaScript framework projects 1.2.6. 各种语言性能测试 1.2.7. IDE 横向比较 1.2.8. Top 10 Programming Languages 1.2.9. PYPL PopularitY of Programming Language 1.2.10. RedMonk 编程语言排行榜 1.2.11. Developer Survey Results 2017 1.3. 软件工程 (Software Engineering) 1.4. Open Source and License 1.5. 项目运作 1.6. 收集需求 1.7. 标准与规范 1.7.1. Release Notes 1.7.2. Project directory 1.7.3. 版本控制及如何运作 1.7.3.1. 版本库布局 1.7.3.2. 策略 1.7.3.3. nightly version 1.7.3.4. rc1,rc2,rc4 1.7.3.5. 怎样写注释信息 1.7.3.5.1. Fixed Bug 1.7.3.5.2. Implemented 1.7.3.5.3. Add 1.7.4. 代码审查 1.7.4.1. Coding workflow 1.7.5. Redis Key 1.7.6. 错误编码 1.7.7. HTML 标准 1.7.7.1. 校验 1.7.7.2. XHTML/HTML 1.7.7.3. CSS 1.7.7.4. Script 1.7.8. 编码风格 1.7.8.1. java 编程规范 1.7.8.1.1. Spring Data JPA 1.7.8.2. php 文件 1.7.8.2.1. 格式与 编码 1.7.8.2.2. 循环嵌套 1.7.8.2.3. 取出行尾的空格以及多余的换行符 1.7.8.2.4. php 标签 1.7.8.2.5. 头部注释 1.7.8.3. String 1.7.8.4. Database 1.7.8.4.1. 结果集使用注意事项 1.7.8.4.2. 索引 1.7.8.4.3. 缓存 1.7.9. 安全 1.7.9.1. Interface 1.7.9.2. SQL注入 1.1.System programming language A System programming language is usually used to mean "a language for system programming": that is, a language designed for writing system software as distinct from application software. http://en.wikipedia.org/wiki/System_programming_language 原文出处:Netkiller 系列 手札 本文作者:陈景峯 转载请与作者联系,同时请务必标明文章原始出处和作者信息及本声明。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册