首页 文章 精选 留言 我的

精选列表

搜索[Agent],共9665篇文章
优秀的个人博客,低调大师

Codex + Seed-2.1-pro 实测:多模态理解 + Coding Agent 能扛住真实仓库吗?

前阵子在改一个拖拽布局的问题——react-grid-layout 的 Issue #2161:开发者给新卡片设 y: Infinity,希望它排到最底下,结果在 horizontal 和 null 两种模式下,新卡片直接跑到了网格左上角,盖住了已有内容。页面上一眼就能看出问题,代码里却要绕好几步。正好看到火山方舟的 Seed-2.1-pro 推了 0915 这一版的升级,就想着把它接进 Codex CLI 试试,看这个真实 Issue 能不能修。

优秀的个人博客,低调大师

把四个 Agent 的历史并进 DSH 之后,检索和上下文变了什么

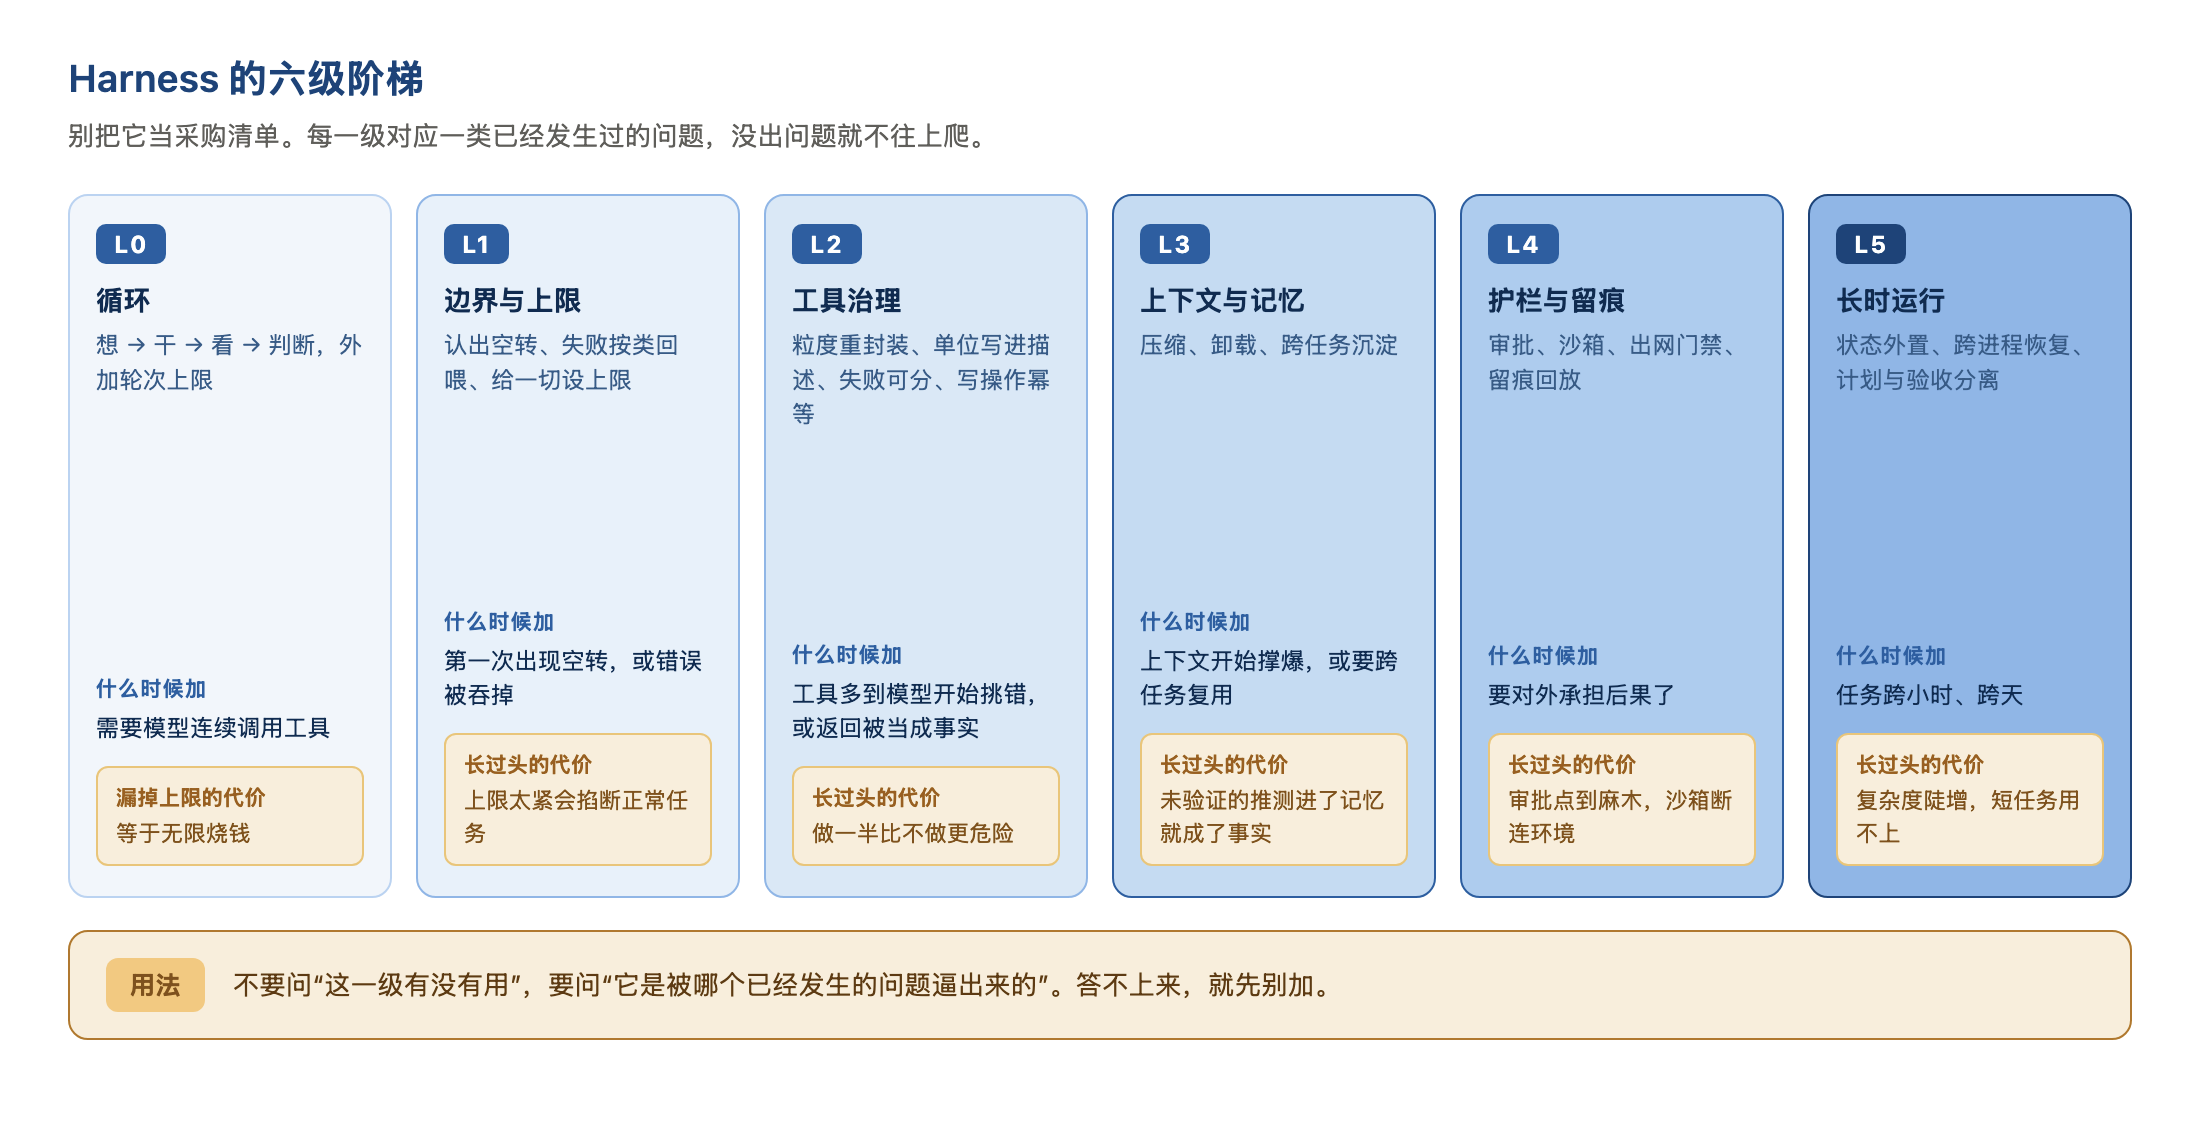
我的会话历史长期散在四处:Claude Code 在本地目录里攒着,Codex 留了一批,Cursor 的对话绑在项目上,ChatGPT 靠导出包存着。四份历史、四套检索方式,想找某次结论得挨个翻。后来我把它们统一并进一台腾讯云 CVM 上跑的 DeepSeek Harness(DSH),CVM 当收口点。下面是并进去之后真实发生的变化。用的是聊天记录导入器(Nwflower/dsh-chat-import,Star 198):README 称它能「一键导入外部 Agents 的聊天历史并在 DeepSeek Harness 中继续对话」,导入结果是 resumable sessions(可恢复会话),并支持全保真、反向导出/同步与 bundle 备份。站点标注「可直接安装」,L4 真实安装验证(2026/9/18),信任档位「已验证」,npm 包为 dsh-chat-import @ 0.19.3。

优秀的个人博客,低调大师

哑巴模型爆红:当 AI 不再生成文字,Agent 的"控制平面"正在独立

2026 年 9 月 15 日,TypeSafe AI 发布了一个新模型,叫 Jev。 它没有对话框,不能聊天,写不出一个完整的句子。你给它一段状态描述和几个问题,它不回答你,只回几个数字和一个选项。 就是这样一个"哑巴模型",在 Hacker News 上拿到了 1917 分、超过 500 条评论。LangChain 在两天后写了集成指南,Vercel 把它接进了 AI Gateway,社区里冒出一堆围绕它的实验项目。 一个不会说话的模型,为什么值得这么多人认真讨论? 它把"生成"这一步整个删掉了 我们先看现在的通行做法。假设要判断一条客服消息是不是紧急、该转给谁、用户情绪如何,常见写法是把消息丢给大语言模型,让它输出一段 JSON: ```json {"urgent": true, "department": "billing", "emotion": "frustrated"} ``` 程序拿到这段字符串,再解析、再校验 schema,然后才能用。TypeSafe 官方文档对这件事的说法很直接:我们在把一个擅长生成文本的系统,硬拗成输出结构化判断,然后再把结果解析回代码能依赖的形式——这本身就是一次错配。 Jev 的做法是把中间那步砍掉。调用方提交两块内容:`state`(需要判断的当前状态,可以是字符串、对象或数组)和 `questions`(针对状态提出的类型化问题)。返回的是结构化数值和概率分布,官方给自己的定义是一句话: Unstructured state in, typed probabilistic decisions out. 没有长文本生成,没有 JSON 解析,也不需要模型额外"写一句话解释一下"。它在文档里被称作 TypeSafe 的第一个 System One 模型——借用认知心理学里"快思考 / 慢思考"的比喻,生成式大模型负责慢思考,它负责毫秒级的直觉反应。 三种原语,都很小 Jev 目前只提供三种问题类型,官方叫 primitives: Choice:从调用方给出的候选项里选一个。返回 `choice`、`probabilities` 和 `confidence`。比如"这张工单该给哪个团队",候选是 billing / technical / human_review 三选一,它回你 `human_review 0.65`。 Score:按调用方给的评分标准(rubric)打分。比如风险等级 0 到 3,它返回分值和概率分布。 Noul:判断一个命题成立的程度,返回 0 到 1 的数值。你问"这个操作危险吗",它不回"我认为可能危险",而是直接给 `risk_probability = 0.87`,程序可以立刻写成 `if risk_probability > 0.8: require_confirmation()`。 三种问题可以在一次请求里混着问,彼此独立评估同一份 state,加问题几乎不增加响应时间。 这里有一个设计细节值得记下来:候选项不是模型在云端临时创造的,而是调用方给的。它们通常来自代码里的固定枚举、配置中心的规则、或者当前用户有权调用的工具集合。模型只在给定边界内判断"选哪个",而"能不能执行"仍然属于你自己的代码。 真正值得关注的不是快,是校准过的置信度 官方公布的典型推理延迟大约 70–500 毫秒,定价约每百万输入 token 0.042 美元,输出不收费——因为压根没有传统意义上的 output token 生成。相比一些传统模型,官方称在适合 System One 的任务上有几十倍到近两百倍的速度优势。 但速度其实不是重点。 重点是另一个词:Calibrated Confidence,校准过的置信度。 今天让大模型判断一件事,它很容易给你一句"我有 95% 的把握"。问题是,这个 95% 通常只是它生成出来的一段文本,不意味着它在长期上真的有约 95% 的正确率。Jev 用了一种叫 RLCD(Reinforcement Learning for Calibrated Decisions)的训练方式,训练目标除了"选对答案",还包括"知道自己有多确定"。 这件事对自动化的意义在于:成熟系统的控制流不该只有是 / 否两态,而应该是高置信自动执行、中置信再验证、低置信交给更强模型或人。置信度本身成为程序分支的一部分。 需要说清楚的是,这不解决"模型一定对"的问题。官方资料和多位实测者都强调过同一个边界:置信度阈值必须用你自己的数据去标定。有工程师在落地笔记里写得很直白——他把 0.9 设为本地采纳门槛,同时补了一句"0.9 是我们人为设定的门槛,绝不代表模型有九成的真实准确率"。 它不是替代 LLM,而是把 LLM 从一些位置上挪开 Jev 发布后,社区很快找到了几个稳定的落点,规律非常一致:大家几乎不让它写文

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。


用户登录
用户注册