首页 文章 精选 留言 我的

精选列表

搜索[AI Coding 全栈开发],共10014篇文章
优秀的个人博客,低调大师

Python全栈 Web(Django框架、模板继承、模型)

模板的继承: 语法: 在父模板中 必须要标识出那些内容在子模板中允许为修改 {% block 名称 %} {% endblock %} 在子模板中 指定继承自那个父模板 {% extends '父模板名称' %} 增加block标签 改写属于自的内容 {% block 名称 %} {% endblock %} block的作用: 在父模板中正常显示 在子模板中 如果不修改的话 则按父模板的内容显示 要是修改的话则按照子模板的内容显示 <!doctype html> &

优秀的个人博客,低调大师

Python全栈 Web(Django框架、概述、项目配置)

前言: Flask虽然是轻量级框架但是复杂操作需要自己写扩展和灵活性还是非常高的 基于Flask的项目 我就写在一个博客里了 持续更新。。。 Django众所周知的Pythonweb框架 之前写过一篇Django的博客 是1.11.8版本的 后来决定先写Flask 所以就没有持续更新 Django1.11.8版本 今天我们说的是Django2.xx版本 2.xx版本还是有所不同的 大概19年初中期就会出2.xx的长期支持版 Django Django 项目是一个Python定制框架,它源自一个在线新闻 Web 站点,于 2005 年以开源的形式被释放出来。 Django 框架的核心组件有: 用于创建模型的 对象关系映射 为最终用户设计的完美管理界面 一流的 URL 设计 设计者友好的模板语言 缓存系统 当前使用的版本是最新版 也就是

优秀的个人博客,低调大师

Python全栈工程师(文件操作、编码)

ParisGabriel 每天坚持手写一天一篇 决定坚持几年 为了梦想为了信仰 Python人工智能从入门到精通 最近简直要死了 发烧感冒 喉咙痛。。。。、 如何长期保存计算机中数据: 需要文件操作 文件 file: 文件是用于数据存储的单位 文件通常用来长期储存数据 文件中的数据是以字节为单位进行顺序储存的文件的操作流程: 1.打开文件 2.读/写文件 3.关闭文件 注: 任何操作系统, 一个应用程序同时打开文件的数量有最大数限制文件打开函数: open(file, mode=‘rt’) 用于打开一个文件, 返回此文件流对象, 如果打开文件失败, 则会触发osError错误文件的关闭方法: F.colse() #关闭问津, 释放系统资源 示例: # 此示例示意文件的打开和关闭操作 try: f = open('./aaa.txt') # 不存在此文件 # f = open('./myfile.txt') # 不存在此文件 print("打开文件成功") # 此处要进行读/写操作 f.close() # 半闭文件 except OSError: print("文件打开失败") 文件方法: 文件 mode 模式字符的含义 字符 含义 'r' 以只读方式打开(默认) 'w' 以只写方式打开,删除原有文件内容(如果文件不存在,则创建该文件并以只写方式打开) 'x' 创建一个新文件, 并以写模式打开这个文件,如果文件存在则会产生"FileExistsError"错误 'a' 以只写文件打开一个文件,如果有原文件则追加到文件末尾 'b' 用二进制模式打开 't' 文本文件模式打开 (默认) '+' 为更新内容打开一个磁盘文件 (可读可写) 缺省模式是 'rt' 'w+b' 可以实现二进制随机读写,当打开文件时,文件内容将被清零 'r+b' 以二进制读和更新模式打开文件,打开文件时不会清空文件内容 'r+' 以文本模式读和更新模式打开文件,打开文件时不会清空文件内容 python 文件常用方法: 方法 说明 F.close() 关闭文件(关闭后文件不能再读写会发生ValueError错误) F.readline() 读取一行数据, 如果到达文件尾则返回空行 F.readlines(max_chars=-1) 返回每行字符串的列表,max_chars为最大字符(或字节)数 F.writelines(lines) 将字符串的列表或字符串的列表中的内容写入文件 二进制文件操作方法 F.read(size=-1) 从一个文件流中最多读取size个字符(文本文件)或字节(二进制文件),如果不给出参数,则默认读取文件中全部的内容并返回 F.write(text) 写一个字符串到文件流中,返回写入的字符数(文本文件)或字节数(二进制文件) F.tell() 返回当前文件流读写指针的绝对位置(字节为单位) F.seek(offset, whence=0) 改变数据流读写指针的位置,返回新的绝对位置 F.flush() 把写入文件对象的缓存内容写入到磁盘 F.readable() 判断这个文件是否可读,可读返回True,否则返回False F.writable() 判断这个文件是否可写,可写返回True,否则返回False F.seekable() 返回这个文件对象是否支持随机定位 F.truncate(pos = None) 剪掉 自pos位置之后的数据,返回新的文件长度 文本文件操作: 操作模式: ‘t’ 说明: 1.默认文件中储存的都为字节数据, 在读写过程中会自动进行编解码操作 2.文本文件以行位单位进行分割, 在python内部统一用"\n"做为换行符进行分割 3.对文本文件的读写操作需要用字符串(str)进行数据操作 Linux换行符: '\n' Windows 换行符: '\r\n' 新的Mac OS 换行符: '\n' 旧的Macintosh换行符: '\r'(已不用了) 文件流对象是可迭代对象, 迭代过程中将换行符“\n”作为分隔符 f = open('phonenumber.txt') for line in f: print(line) # 打印每一行的数据 标准输入输出文件: sys.stdin 标准输入文件 Ctrl + D 输入文件结束符 sys.stdout 标准输出文件 sys.stderr 标准错误输出文件 标准文件绝对不能关闭 Linux系统内所有的硬件都会映射成文件 关闭文件会导致错误模块:sys 注: 标准文件不需要打开和关闭就可以使用 示例: import sys sys.stdout.write("我是标准输出\n") sys.stderr.write("我是一个错误\n") import sys s = sys.stdin.read() print("s=", s) print("程序结束") 二进制文件操作: 二进制文件操作模式字符:‘b’ 默认文件中存储的是以字节数据为单位, 通常有人为规定的格式 二进制文件操作需要用字节串进行读写 F.read()/F.readline() F.readlines()返回类型 对于文本操作 F.write() 对于二进制文件也需要用字节串进行操作 F.tell: 作用: 返回当前的读写位置(从文件头以字节为单位) F.seek方法: F.seek(偏移量,whence=相对位置) 偏移量 大于0的数代表向文件尾方向移动的字节数 小于0的数代表向文件头方向移动的字节数 相对位置 0代表从文件头开始偏移 1代表从文件当前位置开始偏移 2代表从文件尾开始偏移 (第一个参数必须是负的) 示例: # 此示例示意用seek改变文件的读写位置,用tell来得到读写位置 f = open('myseek.txt', 'rb') b = f.read(2) # b'AB' 读取出来 print(b) # b'AB # 从头开始向后走5个字节 # f.seek(5, 0) # 从当前位置向后走3个字节 # f.seek(3, 1) # 从文件尾向前数15个字节 f.seek(-15, 2) b = f.read(5) print(b) # b'abcde' f.close() 汉字编码(只讲两种) 国标系列: GB18030(二字节或四字节编码27553个字) GBk(二字节编码21003个字) GB2312(二字节编码6763个字) (Windows 常用) 国际标准: Unicode <---> UTF-8 (Ascii 占1字节 汉字占3字节) (Linux Mac OS X / IOS /Android) python编码字符串: ‘gb18030’ ‘gb2312’ ‘gbk’ ‘utf-8’ ‘ascii’ ....以上字符串用于encide和decode中编码注释: 在Python源文件中的第一行或第二行写入如下内容: # -*- codeing:gbk -*- #设置源文件编码格式为gbk 或 # -*- codeing:utf-8 -*- #设置源文件编码格式为utf-8 作用: 告诉解释执行器此文件的编码是什么 练习: 自己写一个文件 'info.txt' 内部存一些文字信息 如: 张三 20 100 李四 21 96 小王 22 98 写程序将这些数据读取出来,打印到终端上 答案: try: f = open("myfile.txt") L = f.readlines() for x in L: s = x.strip() n, a, s = s.split() print("姓名:", n, "年龄:", int(a), "成绩:", int(s)) except: print("打开文件是失败") 练习: 1. 写程序,循环输入很多个人的姓名,电话号码, 当输入结束后将这些信息存入到文件phonenumber.txt中 (建议先用列表暂存数据,格式自己定义) 2. 写程序,将phonenumber.txt文件中的数据读取出来. 再用以下格式打印出来: 如: 小张 的电话是 13888888888 小李 的电话是 13999999999 练习: 1. 写程序实现复制文件的功能 要求: 1. 要考虑特大文件问题 2. 要关闭文件 3. 要能复制二进制文件 如: 请输入源文件路径名: /home/tarena/xxx.tar.gz 请输入目标文件路径名: ./a.tar.gz 显示: 文件已成功复制 答案: def copy_myfile(): try: ypath = input("please inout raw path:") xpath = input("please inout new path:") f1 = open(xpath, "w+b") f = open(ypath, "r+b") for x in f: f1.write(x) f1.close() f.close() print("File copied") except: print("file not inexeistence") copy_myfile() 2. 修改学生信息管理程序,要求加入两个功能: 9) 保存信息到文件(si.txt) L = [{"name": "Tom", "age": 20, "score": 98}, {"name": "Lin", "age": 21, "score": 99}, {"name": "Garin", "age": 19, "score": 100}] def student_file(L): try: f = open("./si.txt", "x") for x in L: f.write(x["name"]) f.write(" ") f.write(str(x["age"])) f.write(" ") f.write(str(x["score"])) f.write("\n") except FileExistsError: f = open("./si.txt", "a") for x in L: f.write(x["name"]) f.write(" ") f.write(str(x["age"])) f.write(" ") f.write(str(x["score"])) f.write("\n") student_file(L) 10) 从文件中读取数据(si.tx def open_student_file(): f = open("./si.txt") L = [] for line in f.readlines(): s = line.strip() n, a, s = s.split() # 拆成列表 student = {"name": n, "age": a, "score": s} L.append(student) f.close() return L 源码: https://pan.baidu.com/s/1vVuH7OwNdn8vqaBKAivniQ异常还没处理...........

优秀的个人博客,低调大师

Python全栈工程师(每周总结:2)

ParisGabriel 感谢 大家的支持 每天坚持 一天一篇 点个订阅吧灰常感谢 当个死粉也阔以 week summer: Python人工智能从入门到精通 字符串 str # 不可变序列,只能存字符 列表 list # 可变的序列,可以存任意数据 元组 tuple # 不可变序列,可以存任意数据 字典dict # 可变无序,可以存任意数据 集合set #可变无序,只能存不可变数据 (可变就是id不变的情况下改变数据) 序列相关函数: len(x), max(x), min(x), sum(x), any(x), all(x) 序列有5种: star 字符串 list 列表 tuple 元组 bytes bytearray 列表 list: L = [ ] L = list() 创建函数 括号内放可迭代对象、可以空 L [ ] 括号内放下标 L [:: ] 第一个参数开始位置,第二个结束、第三个步长(步长决定方向) 列表推导式: [表达式 for 变量 in 可迭代对象](可以嵌套) del L[ ] 删除指定下表索引 列表可以索引下标 、切片 可以增、删、改、查 可以索引赋值、切片赋值(不是顺序切片时赋值一定要个数相等) 潜拷贝 浅拷贝是指在复制过程中,只复制一层变量,不会复制深层变量绑定的对象的复制过程 深拷贝 深拷贝通常只对可变对象进行复制,不可变对象通常不会复制 元组 type t = (1, ) 低于连个元素必须用, 号 t = type(x) 同列表一样 元组可以索引和切片和列表一样 但是但是不能赋值 T.index(v[, begin[, end]]) 返回对应元素的索引下标 T.count(x) 返回元组中对应的元素个数字典 dict: d = { } d = {“a”:1} 键值对形式存在 d[ ] 括号里放键 ,字典索引只索引键(key)索引赋值 : 只能修改值 ,存在修改 否者添加 dict() 生成一个字的字典 等同于 {} dict(iterable) 用可迭代对象初始化一个字典 dict(**kwargs) 用关键字传参形式创建一个字典 字典的键(key) 必须为不可变类型 且不能重复不可变类型:bool, int, float, complex, str, tuple, frozenset, bytes(后面再讲) in 在什么什么里面 not in 不在什么什么里面(判断键存在:只判断键) is 是 is not 不是 所有可迭代对象都可以用for 遍历 (字典只访问键)字典推导式 : d = {x : x ** 2 for x in range(10)} {键表达式 : 值表达式 for 变量 in 可迭代对象 if 真值表达式}(可嵌套) 字典 VS 列表 1. 都是可变对象 2. 索引方式不同,列表用整数索引,字典用键索引 3. 字典的插入,删除,修改数据的速度可能会快于列表(重要) 4. 列表的存储是有序的,字典的存储是无序的可变的数据类型有四种: list 列表、dict 字典 set 集合、bytearray 字节数组集合 set: s = set( ) s = set( ) 构造函数 数据不可重复 相当于只有键的字典 集合运算: & 生成两个集合的交集 | 生成两个集合的并集 - 生成两个集合的补集 ^ 生成两个集合的对称补集 > 判断一个集合是另一个集合的超集 < 判断一个集合是另一个集合的子集 (包含关系) == != 集合相同/不同 (与顺序无关)集合推导式:{表达式 for 变量 in 可迭代对象 [if 真值表达式]}(可嵌套)固定集合 frozenset: 固定集合是不可变的,无序的, 含有唯一元素的集合 (可以做字典键也可以做集合的值) frozenset() f = frozenset() 括号内放可迭代对象 相当于集合的全部方法(包括运算符)去掉修改集合的方法 常用字符串方法方法 说明S.isdigit() 判断字符串中的字符是否全为数字S.isalpha() 判断字符串是否全为英文字母S.islower() 判断字符串所有字符是否全为小写英文字母S.isupper() 判断字符串所有字符是否全为大写英文字母S.isspace() 判断字符串是否全为空白字符S.center(width[,fill]) 将原字符串居中,左右默认填充空格 width:所居中字符串的长度 fill:默认填充空格S.count(sub[, start[,end]]) 获取一个字符串中子串的个数 sub:所要获取的字符串 start:起始位置 end:结束位置S.find(sub[, start[,end]]) 获取字符串中子串sub的索引,失败返回-1 start:起始位置 end:结束位置S.strip() 返回去掉左右空白字符的字符串S.lstrip() 返回去掉左侧空白字符的字符串S.rstrip() 返回去掉右侧空白字符的字符串S.upper() 生成将英文转换为大写的字符串S.lower() 生成将英文转换为小写的字符串S.replace(old, new[, count]) 将原字符串的old用new代替,生成一个新的字符串 count:更换的次数S.startswith(prefix[, start[, end]]) 返回S是否是以prefix开头,如果以prefix开头返回True,否则返回False,S.endswith(suffix[, start[, end]]) 返回S是否是以suffix结尾,如果以suffix结尾返回True,否则返回False以下是不常用的 S.title() 生成每个英文单词的首字母大写字符串S.isnumeric() 判断字符串是否全为数字字符文本解析: S.split(sep=None) 拆分字符串 sep是拆分符号 S.join(iterable) S是分隔字符串 扩号内跟可迭代对象 列表的方法 :L.index(v [, begin[, end]]) 返回对应元素的索引下标, begin为开始索引,end为结束索引,当 value 不存在时触发ValueError错误L.insert(index, obj) 将某个元素插放到列表中指定的位置L.count(x) 返回列表中元素的个数L.remove(x) 从列表中删除第一次出现在列表中的值L.copy() 复制此列表(只复制一层,不会复制深层对象)L.append(x) 向列表中追加单个元素L.extend(lst) 向列表追加另一个列表L.clear() 清空列表,等同于 L[:] = []L.sort(reverse=False) 将列表中的元素进行排序,默认顺序按值的小到大的顺序排列L.reverse() 列表的反转,用来改变原列表的先后顺序L.pop([index]) 删除索引对应的元素,如果不加索引,默认删除最后元素,同时返回删除元素的引用关系 字典的方法 D代表字典对象 D.clear() 清空字典D.pop(key) 移除键,同时返回此键所对应的值D.copy() 返回字典D的副本,只复制一层(浅拷贝)D.update(D2) 将字典 D2 合并到D中,如果键相同,则此键的值取D2的值作为新值D.get(key, default) 返回键key所对应的值,如果没有此键,则返回defaultD.keys() 返回可迭代的 dict_keys 集合对象D.values() 返回可迭代的 dict_values 值对象D.items() 返回可迭代的 dict_items 对象 Python3 集合的方法: 方法 意义S.add(e) 在集合中添加一个新的元素e;如果元素已经存在,则不添加S.remove(e) 从集合中删除一个元素,如果元素不存在于集合中,则会产生一个KeyError错误S.discard(e) 从集合S中移除一个元素e,在元素e不存在时什么都不做;S.clear() 清空集合内的所有元素S.copy() 将集合进行一次浅拷贝S.pop() 从集合S中删除一个随机元素;如果此集合为空,则引发KeyError异常S.update(s2) 用 S与s2得到的全集更新变量SS.difference(s2) 用S - s2 运算,返回存在于在S中,但不在s2中的所有元素的集合S.difference_update(s2) 等同于 S = S - s2S.intersection(s2) 等同于 S & s2S.intersection_update(s2) 等同于S = S & s2S.isdisjoint(s2) 如果S与s2交集为空返回True,非空则返回FalseS.issubset(s2) 如果S与s2交集为非空返回True,空则返回FalseS.issuperset(...) 如果S为s2的子集返回True,否则返回FalseS.symmetric_difference(s2) 返回对称补集,等同于 S ^ s2S.symmetric_difference_update(s2) 用 S 与 s2 的对称补集更新 SS.union(s2) 生成 S 与 s2的全集 Python运算符优先级 运算符 描述(), [], {key: value}, {} 元组表达式、列表表达式、字典表达式、集合表达式x[index], x[index:index],x(arguments...), x.attribute 索引,切片,函数调用,属性引用** 指数 (最高优先级)~, +, - 按位翻转, 正号,负号*, /, %, // 乘,除,取模和地板除+, - 加法, 减法>>, << 右移, 左移运算符& 位与(AND)^ 位异或(XOR)| 位或(OR)<=, <, >, >=, ==, !=,is, is not, in, not in 比较,身份测试,成员资格测试not 布尔非and 布尔与or 布尔或if - else 条件表达式lambda lambda表达式 数据类型: 数值类型: int, float, complex, bool容器: 不可变的容器 str, tuple, frozenset, bytes(字节串) 可变的容器 list, dict, set, bytearray(字节数组)值: None, False, True 运算符 算术运算符 + - * / // % ** 比较运算符: < <= > >= == != in / not in is, is not 布尔运算: not, and, or +(正号) -(负号) & | ^ [] (索引,切片,键索引) 表达式: 1 1 + 2 max(1,2,3) # 函数调用是表达式 x if x > y else y, 条件表达式 三种推导式: 列表,字典,集合推导式(三种) 语句: 表达式语句: 所有的表达式都可以单独写在一行,形成一个语句,例: print("hello world") 1 + 2 赋值语句: a = 100 a = b = c = 100 x, y = 100, 200 a[0] = 100 dict['name'] = 'tarena' del 语句 if 语句 while 语句 for 语句 break 语句 continue语句 pass 语句 内建函数: len(x), max(x), min(x), sum(x), any(x), all(x)构造函数(用来创建同类型的数据对象) bool(x), int(x), float(x), complex(x), list(x), tuple(x), str(x), dict(x), set(x), frozenset(x) abs(x) round(x) pow(x, y, z=None) bin(x), oct(x), hex(x) chr(x), ord(x) range(start, stop, step) input(x), print(x) >>> help(__builtins__) 函数: 就是把语句块封装起来 形成一个语句块 利用函数变量直接调用语句块的方式 用户自定义级别的函数是为了提高代码的可用性 重用性 以及逻辑清晰 维护方便 (def 函数名(形参列表):冒号) 形参列表可以为空 函数是一个空间,空间内变量不重复就不会冲突 函数调用: 函数名(实参) return语句 用于返回非None对象语句 函数的参数传递: 传参方式:(2种) 位置传参(包含关系 ) 序列传参 关键字传参(包含关系) 字典关键字传参位置传参: 实参与形参的位置要对应序列传参: 用 * 将序列拆解 然后位置传参关键字传参 将字典用“**”拆解后 实参和形参必须按形参名复制 拆解后键名要在形参中存在必须一致 键名必须是字符串且标识符综合传参: 在能确定形参能唯一匹配到相应实参的情况下 所有传参方式可以任意组合 位置传参(序列传参)一定要在关键字传参(字典关键字传参)的左侧函数的缺省参数: 缺省参数必须从右至左依次存在的命名关键字形参: 语法: def 函数名(*, 命名关键字形参): 语句块 或 ef 函数名(*args, 命名关键字形参): 语句块 (关键字形参 必须用关键字传参) 作用: 收集多余关键字传参双星号字典传参: 语法: def 函数名(**字典形参名): 语句块 作用: 强制所有的参数都参数都必须用关键字传参或字典关键字传参函数的参数说明: 位置形参、星号元组形参、命名关键字形参、双星号字典形参可以混合使用函数自左到右的顺序为: 1.位置形参 2.星号元组形参 3.命名关键字形参 4.双星号字典形参 全局变量:global variable: 函数外,模块内的变量 全局变量所有函数都可以直接访问局部变量:local variable: 函数内的变量 调用时才被创建,在函数调用之后销毁传参的排序规则: 从左到右 1.位置形参 2.星号元组形参 3.命名关键字形参 4.双星号字典形参 函数: globals()/locals() globals()返回当前全局作用域内变量的字典 locals() 返回当前局部作用域内变量的字典 函数名是变量 创建时绑定函数 函数的变量名可以序列交换算法 函数可以作为另一个函数的实参 函数可以作为另一个函数返回值 函数可以嵌套python的4个作用域: 作用域: 英文解释 缩写 局部作用域(函数内) Local(function) L 外部嵌套函数作用域 Enclosing functio loc E 函数定义所在模块(文件)作用域 Global(module) G python内建模块作用域 Builtin(python) B 包含关系(内建>模块>外部嵌套函数>函数内)变量名查找规则: 访问变量时,先查找本地变量,然后是包裹此函数外的函数内部的变量 ,之后是全局变量,最后是内建变量 L ---> E ---> G ---> B 在默认情况下,变量名赋值会创建或者改变当前作用域的变量global语句: 声明一个全局变量nonlocal语句: 外部嵌套函数变量 调用不可修改外部嵌套函数作用域内的变量进行操作lambda表达式: 创建一个匿名函数对象 lambda[ 参数1, 参数...]: 表达式 函数: eval () / exec() 函数 eval(srouce,globals=None, locals=None) 把一个字符串srouce 当成一个表达式来执行,返回表达式结果 eval(source, globals=None, local=None) 把一个字符串 srouce 当成一个表达式来执行,返回表达式执行的结果 exec(source, globals=None, locals=None) 把一个字符串source 当成程序来执行 全部划重点 加粗 加长 加大 溜了 不吹NB了....


优秀的个人博客,低调大师

Python全栈工程师(每周总结:1)

ParisGabriel python今年9月份将被国家纳入计算机二级资格证 先学就是鼻祖 几年后你就是大牛 Python人工智能从入门到精通 week summer: 数字(整型int,浮点数float,复数complex,布尔型bool)字符串str 列表list 等bool(true=1、false=0)None 空值算数运算符:+ - * / // ** % 优先级:(), [], {key: value}, {} 元组表达式、列表表达式、字典表达式、集合表达式x[index], x[index:index],x(arguments...), x.attribute 索引,切片,函数调用,属性引用** 指数 (最高优先级)~, +, - 按位翻转, 正号,负号*, /, %, // 乘,除,取模和地板除+, - 加法, 减法>>, << 右移, 左移运算符& 位与(AND)^ 位异或(XOR)| 位或(OR)<=, <, >, >=, ==, !=, is, is not, in, not in 比较,身份测试,成员资格测试not 布尔非and 布尔与or 布尔或if - else 条件表达式lambda lambda 表达式变量命名:必须以字母或下划线开头(驼峰法则)序列赋值:a,b,c = 100, 200, 300变量交换:a,b = 200,100del 删除变量help(“__main__”) 查看变量 Q退出内存自动管理方式:引用计数is/is not 判断是否为同一个对象id(obj)函数: 返回对象在内纯中的id小整数对象值:-5 ~ 256比较运算符:< <= > >= == != 数值对象的构造函数:float(obj) 字符串转换浮点数 int 转换整数complex(r,i) 创建复数bool(true/false) 创建布尔值bool(obj) 所有0或 空值都会返回falseabs(x) 取x绝对值round(number,ndigits) 四舍五入 ndigits小数点个数(可以是负数:反向取整)help(函数对象) 函数或查看详细帮助“\” 折行符() [ ] {} 隐式折行符 sep 两个值之间的分隔符默认空格print(sep = “”,end = “”){ end行位默认换行符not 布尔非or 布尔或 { 短路运算and 布尔与+ 表达式只有一个数据参加(一元运算符)- 表达式 如:a = 5 ,b = -a ,c = +a转移符:\' 单引号\" 双引号\\ 单反斜杠\n 换行\r 返回光标至行首\t 水平制表符\v 垂直制表符\f 换页\b 倒退\0 空字符,字符值为0\xXX XX为两位16进制表示的自符\uXXXX XXXX为4个16进制的Unicode16字符\UXXXXXXXX 8个16进制表示的Unicode32字符man ASCII 查看帮助文档命令常用ASCII编码:字符 十进制 十六进制 0 48 0x30 A 65 0x41 a 97 0x61len() 返回字符串的个数raw 让转义符无效(原始字符)(r“hello world”)+= *= 与其他符合运算符相同in/not in 判断字符串是存在字符串的比较运算:> >= < <= == != 依次按照编码进行比较,直到最短字符串结束为止s[int] 索引 index Python的字符串是不可以改变字符序列的Python序列都可以用索引来访问序列中的对象Python的序列正向索引是从0开始的最后一个索引为len(s)-1Python序列的反向索引是从-1开始的 -1是最后一个 第一个是 -len(s)切片 slice :s[(开始索引b):(结束索引e):(步长s)] 步长等于偏移量默认1 索引从0开始 顾头不顾尾 步长为负时反向切片(步长决定方向)python3 中常用函数;len (s) 返回序列长度max(s) 返回序列最大值元素min(s) 返回序列最小值元素ord(a) 返回一个字符的Unicode值(10进制)chr(i) 返回一个整数的Unicode字符bin(i) 将整数转换为二进制字符串oct(i) 将整数转换为八进制字符串hex(i) 将整数转换为十六进制字符串常用的字符串方法:文档参见:对象.方法名(方法传参)"abc".isalpha() # 语法是对的123.isalpha() # 语法是错的方法 说明S.isdigit() 判断字符串中的字符是否全为数字S.isalpha() 判断字符串是否全为英文字母S.islower() 判断字符串所有字符是否全为小写英文字母S.isupper() 判断字符串所有字符是否全为大写英文字母S.isspace() 判断字符串是否全为空白字符S.center(width[,fill]) 将原字符串居中,左右默认填充空格 width:所居中字符串的长度 fill:默认填充空格S.count(sub[, start[,end]]) 获取一个字符串中子串的个数 sub:所要获取的字符串 start:起始位置 end:结束位置S.find(sub[, start[,end]]) 获取字符串中子串sub的索引,失败返回-1start:起始位置 end:结束位置S.strip() 返回去掉左右空白字符的字符串S.lstrip() 返回去掉左侧空白字符的字符串S.rstrip() 返回去掉右侧空白字符的字符串S.upper() 生成将英文转换为大写的字符串S.lower() 生成将英文转换为小写的字符串S.replace(old, new[, count]) 将原字符串的old用new代替,生成一个新的字符串 count:更换的次数S.startswith(prefix[, start[, end]]) 返回S是否是以prefix开头,如果以prefix开头返回True,否则返回False,S.endswith(suffix[, start[, end]]) 返回S是否是以suffix结尾,如果以suffix结尾返回True,否则返回False以下是不常用的 S.title() 生成每个英文单词的首字母大写字符串S.isnumeric() 判断字符串是否全为数字字符ASCII 用8个位表示 最高位一定是0Unicode用16位表示 最高位也一定是0占位符和其的类型码:%s 字符串 使用shr(obj)转为字符串%r 字符串 使用repr(obj)转为字符串%c 整数转为字符串,使用chr(i)函数%d 10进制整数%o 8进制整数%x 16进制整数(字符a-f)%X 16进制整数(字符A-F)%e 浮点数(e)如 2.9e+10%E 浮点数(E)如2.9E+10%f %F 浮点数10进制形式%g %G 进制进形式浮点数或指浮点数自动转换%% 等同于一个 % 字符 占位符与类型码之间的格式语法:%[- + 0 宽度.精度]类型码- 左对齐+ 右对齐0 左右空白位置补0宽度:整个数据输出的宽度精度:保留小数点后多少位,默认6位可迭代对象包括:字符串 str 列表 list元组 tuple字典 dictrange()函数: 可迭代对象创建 也叫整数序列生成器 (顾头不顾尾)列表 list:(列表的id是不可变的 除非重新定义)列表是一种容器(通常用来储存计算机的数据对象)列表是可以被改变的序列是由一系列特定元素组成的 元素与元素之间可能没有任何关联关系但他们有先后顺序关系列表的运算:+ 用于拼接列表+= 用于将右侧的可迭代对象的数据追加到原列表中* 用于生成重复列表*= L * = 2 (L = L * 2)列表的比较运算:< <= > >= == !=比较规则和字符串完全相同列表的in、notin:判断一个元素是否存在于列表中 如果纯在返true否则falsein 和 nat in 返回值相反(只能判断列表元素 不能判断元素内字符) week summerkey word: print: print(“hello world”) 输出打印语句 input: input(“plaese input :”) 输入函数 提示可以为空 if : if 1 >2 : print("1>2") elif 1>3: print("1>3") else: print("1<2") if:如果 else:否则 elif:否者如果 (单if不加else:如果真) while: i = 0 while i < 5: print(i) i += 1 else: print("6") i:循环变量 while可以加或不加else 条件不成时立执行else若条件成立 循环结束后将继续执行else for: for x in ramge(10): print(x) else: print(11) x:循环取出可迭代对象的值 for可以加或不加else 条件不成时立执行else若条件成立 循环结束后将继续执行else 死循环: while True; a = int(input()) print("123") if a = “” break 死循环: 无限循环 配合break跳出循环死循环不能加else break 终止循环一般配合if语句使用 终止循环 若循环套用是只会在本循环作用域有效不影响外部循环 若break跳出循环 else将不再执行continue 跳过本次循环一般配合if语句使用 跳过本次循环 若循环套用是只会在本循环作用域有效不影响外部循环 continue 用法需注意 细节不当将形成死循环复合语句的嵌套: for x in range(10) for y in range(5) print(x , y) if x == 10: break else: for x in range(50) print(x) i = 0 while i < 10: peint(i) x = 0 while x < 10: print(x) if i == 10: break else: while i <10: print(i * i) if a > 5: if a < 10: peint(a) else: if a > 0 : print(a) else: print(a) if while for 可以任意嵌套配合使用

优秀的个人博客,低调大师

Python全栈工程师(while、占位符)

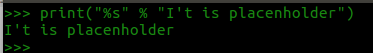
ParisGabriel Python 入门基础 UnicodeASCII 用8个位表示文字 ,最高位一定是零,低七位表示数值Unicode是由16个位组成的(65535) 最高位也是0x0000~0xfffhelp(str) 查看所有str函数 字符串的格式化表达式:生成一定格式的字符串格式字符串中以 % 开头的为占位符,占位符的位置将参数值替换语法:格式字符串 % 参数值格式字符串 % (参数值1,参数值2,...)占位符和其的类型码:%s 字符串 使用shr(obj)转为字符串%r 字符串 使用repr(obj)转为字符串%c 整数转为字符串,使用chr(i)函数%d 10进制整数%o 8进制整数%x 16进制整数(字符a-f)%X 16进制整数(字符A-F)%e 浮点数(e)如 2.9e+10%E 浮点数(E)如2.9E+10%f %F 浮点数10进制形式%g %G 进制进形式浮点数或指浮点数自动转换%% 等同于一个 % 字符 占位符与类型码之间的格式语法:%[- + 0 宽度.精度]类型码- 左对齐+ 右对齐0 左右空白位置补0 宽度:整个数据输出的宽度精度:保留小数点后多少位,默认6位"%10d" %123 #" 123""%+10d"%123 #" +123""%-10d"%123 #"123 ""%10s"%"abc" #" abc""%010d"%123 #"0000000123" "%f"%3.14159625358 # "3.141593""%7.2f"%3.14159265358#" 3.14" 循环语句:while:根据一定的条件,重复执行一些相同或相似的内容先判断真值表达式是否成立在执行执行完内容继续返回真值表达式判断是否成立 直到真值表达式为false时 判断是否有else有则执行else的内容没有则循环结束注意事项:要控制真值表达式的值来防止死循环通常用真值表达式内的循环变量来控制真值表达式的值通常在循环语句块内改变循环变量来控制循环次数和变量走向while的嵌套:while语句和其他语句一样,可以嵌套放入任何复合语句当中break:用于循环语句(while、for)中用来终止当前循环(跳出循环)当break语句执行后此循环以后的语句将不再执行break终止循环时 else语句块将不再执行break语句通常和if组合使用break只能终止当前作用域 如循环嵌套时,不会跳出外循环break只能在循环语句(while、for)内使用死循环:死循环是指循环条件一直成立的循环死循环通常用break语句来终止循环死循环的else语句块永远不会执行 练习:1.输入一行字符串,将字符串中Unicode编码值最大的一个字符打印出来(不允许用max函数)提示:while内可以嵌套if 答案: print("Answer to question 1:", "\n") s = input("plaese input at will string:") i = 0 top = s[0] while i < len(s): if ord(top) < ord(s[i]): top = s[i] i += 1 print("you input string in top1:", top, ord(top)) 2.打印 从零开始的浮点数,每个数增加0.5,打印出10以内的这样的数:0.00.51.00.52.0...10 答案: print("Answer to question 2:", "\n") i = 0 while i < 10: i += 0.5 print(i) 3.打印输出1~20在同一行内 结束后换行 答案: s = 0 while s < 20: s += 1 print(s, end = " ") else: print() 4.打印输出1~20在同一行内 打印10行 i = 0 while i < 10: s = 0 while s < 20: s += 1 print(s, end = " ") else: print() i += 1 5.当输入一些数字,输入负数时结束输入当完成输入完后,打印输入的数时多少 答案: s = 0 while True: a = int(input("plaese input at will integer:")) s += a if a < 0: break print(s) 6.Sn = 1/2+1/4+1/8....+1/(2**n)求当n等同于100时Sn的值是多少 答案: Sn = 1 i = 0 while i < 100: i += 1 Sn += 1 / 2 ** i print(Sn) 7.输入一个整数打印出矩形 若输入1则输出1个# 例如: 输入1:# 输入2:#### 输入6:####### ## ## ## ## ####### 答案: s = int(input("plaese input at will integer:")) if s > 1: print("#" * s) i = 2 while i < s: i += 1 print("#" + " " * (s - 2) + "#") print("#" * s) else: print("#") 8.用while语句实现打印三角形,输入一个整数表示三角形的宽度和高度,打印出相应的三角形如:1)**********2)******* ** *3) * *********4)********** 答案: a = int(input("plaese input at will ingeger:")) i = 0 b = a c = a d = a while i < a: i += 1 print("*" * i) print() i = 0 while i < d: print((a - d) * " " + "*" * d) d -= 1 print() i = 0 while i < c: i += 1 print((c - i) * " " + "*" * i) print() i = 0 while i < b: print("*" * b) b -= 1 a = int(input("plaese input at will ingeger:")) i = 0 d = a while i < a: while i < d: print((a - d) * " " + "*" * d) d -= 1 print("*" * (i + 1)) i += 1 print()

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册