hadoop2集群搭建过程
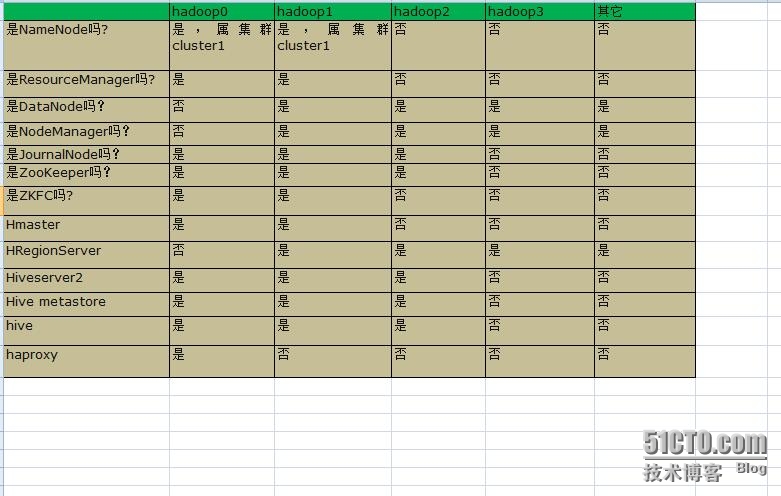
在这里我选用4台机器进行示范,各台机器的职责如下表格所示 (说明: 1. ZooKeepe使用其它节点的 2. Hadoop0节点安装所有的master, ha的matster全部是worker, 以达到较高的资源利用率,又对master的负载不会过高) Hadoop0 -> dchadoop206 Hadoop1 -> dchadoop207 Hadoop2 -> dchadoop208 Hadoop3 -> dchadoop209 1.搭建自动HA 1.1.复制编译后的hadoop项目到/usr/local目录下 1.2.修改位于etc/hadoop目录下的配置文件 1.1.1.hadoop-env.sh 1 export JAVA_HOME= /usr/local/jdk 1.1.1.core-site.xml 1 2 3 4 5 <configuration> <property> <name>fs.defaultFS< /name > <value>hdfs: //cluster1 < /value > < /property > 【这里的值指的是默认的HDFS路径。当有多个HDFS集群同时工作时,用户如果不写集群名称,那么默认使用哪个哪?在这里指定!该值来自于hdfs-site.xml中的配置。在节点hadoop0和hadoop1中使用cluster1,在节点hadoop2和hadoop3中使用cluster2】 1 2 3 4 <property> <name>hadoop.tmp. dir < /name > <value> /data0/hadoop/tmp < /value > < /property > 【这里的路径默认是NameNode、DataNode、JournalNode等存放数据的公共目录。用户也可以自己单独指定这三类节点的目录。】 1 2 3 4 <property> <name>ha.zookeeper.quorum< /name > <value>hadoop0:2181,hadoop1:2181,hadoop2:2181< /value > < /property > 【这里是ZooKeeper集群的地址和端口。注意,数量一定是奇数,且不少于三个节点】 1 < /configuration > 1.1.1.hdfs-site.xml 该文件只配置在hadoop0和hadoop1上。 1 2 3 4 5 <configuration> <property> <name>dfs.replication< /name > <value>2< /value > < /property > 【指定DataNode存储block的副本数量。默认值是3个,我们现在有4个DataNode,该值不大于4即可。】 1 2 3 4 <property> <name>dfs.namenode.name. dir < /name > <value> file : ///data0/hadoop2/hdfs/name < /value > < /property > 【指定namenode元数据信息存储位置】 1 2 3 <property> <name>dfs.datanode.data. dir < /name ><value> file : ///data0/hadoop2/hdfs/data , file : ///data1/hadoop2/hdfs/data , file : ///data2/hadoop2/hdfs/data , file : ///data3/hadoop2/hdfs/data , file : ///data4/hadoop2/hdfs/data , file : ///data5/hadoop2/hdfs/data , file : ///data6/hadoop2/hdfs/data , file : ///data7/hadoop2/hdfs/data , file : ///data8/hadoop2/hdfs/data , file : ///data9/hadoop2/hdfs/data , file : ///data10/hadoop2/hdfs/data < /value > < /property > 【指定datanode元数据信息存储位置,设置成所有的磁盘】 1 2 3 4 <property> <name>dfs.nameservices< /name > <value>cluster1< /value > < /property > 【设置cluster1的namenode id。】 1 2 3 4 <property> <name>dfs.ha.namenodes.cluster1< /name > <value>hadoop0,hadoop1< /value > < /property > 【指定NameService是cluster1时的namenode有哪些,这里的值也是逻辑名称,名字随便起,相互不重复即可】 1 2 3 4 <property> <name>dfs.namenode.rpc-address.cluster1.hadoop0< /name > <value>hadoop0:9000< /value > < /property > 【指定hadoop0的RPC地址】 1 2 3 4 <property> <name>dfs.namenode.http-address.cluster1.hadoop0< /name > <value>hadoop0:50070< /value > < /property > 【指定hadoop0的http地址】 1 2 3 4 <property> <name>dfs.namenode.rpc-address.cluster1.hadoop1< /name > <value>hadoop1:9000< /value > < /property > 【指定hadoop1的RPC地址】 1 2 3 4 <property> <name>dfs.namenode.http-address.cluster1.hadoop1< /name > <value>hadoop1:50070< /value > < /property > 【指定hadoop1的http地址】 1 2 3 4 <property> <name>dfs.namenode.shared.edits. dir < /name > <value>qjournal: //hadoop0 :8485;hadoop1:8485;hadoop2:8485 /cluster1 < /value > < /property > 【指定cluster1的两个NameNode共享edits文件目录时,使用的JournalNode集群信息】 1 2 3 4 <property> <name>dfs.ha.automatic-failover.enabled.cluster1< /name > <value> true < /value > < /property > 【指定cluster1是否启动自动故障恢复,即当NameNode出故障时,是否自动切换到另一台NameNode】 1 2 3 4 <property> <name>dfs.client.failover.proxy.provider.cluster1< /name > <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider< /value > < /property > 【指定cluster1出故障时,哪个实现类负责执行故障切换】 1 2 3 4 <property> <name>dfs.journalnode.edits. dir < /name > <value> /data0/hadoop2/hdfs/journal < /value > < /property > 【指定JournalNode集群在对NameNode的目录进行共享时,自己存储数据的磁盘路径】 1 2 3 4 <property> <name>dfs.ha.fencing.methods< /name > <value>sshfence< /value > < /property > 【一旦需要NameNode切换,使用ssh方式进行操作】 1 2 3 4 <property> <name>dfs.ha.fencing. ssh .private-key-files< /name > <value> /root/ . ssh /id_rsa < /value > < /property > 【如果使用ssh进行故障切换,使用ssh通信时用的密钥存储的位置】 1 < /configuration > 1.2.4. slaves hadoop1 hadoop2 hadoop2 1.3.把以上配置的内容复制到hadoop1、hadoop2、hadoop3节点上 1.4.修改hadoop1、hadoop2、hadoop3上的配置文件内容 1.4.1.修改hadoop2上的core-site.xml内容 1 fs.defaultFS的值改为hdfs: //cluster2 1.4.1.修改hadoop2上的hdfs-site.xml内容 把cluster1中关于journalnode的配置项删除,增加如下内容 1 2 3 4 <property> <name>dfs.namenode.shared.edits. dir < /name > <value>qjournal: //hadoop0 :8485;hadoop1:8485;hadoop2:8485 /cluster2 < /value > < /property > 1.4.3.开始启动 1.4.3.1.启动journalnode 在hadoop0、hadoop1、hadoop2上执行 1 sbin /hadoop-daemon .shstartjournalnode 1.4.3.1.格式化ZooKeeper 在hadoop0、hadoop2上执行 bin/hdfszkfc -formatZK zkCli.sh-->ls->/Hadoop-ha/cluster1 1.4.3.3.对hadoop0节点进行格式化和启动 1 bin /hdfs namenode- format 1 sbin /hadoop-daemon .shstartnamenode 1.4.3.4.对hadoop1节点进行格式化和启动 1 bin /hdfs namenode-bootstrapStandby 1 sbin /hadoop-daemon .shstartnamenode 1.4.3.5.在hadoop0、hadoop1上启动zkfc 1 sbin /hadoop-daemon .shstartzkfc 我们的hadoop0、hadoop1有一个节点就会变为active状态。 1.4.3.6.对于cluster2执行类似操作 1.4.4.启动datanode 在hadoop0上执行命令 1 sbin /hadoop-daemons .shstartdatanode 1.5.配置Yarn 1.5.1.修改文件mapred-site.xml 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 <property> <name>mapreduce.framework.name< /name > <value>yarn< /value > < /property > <property> <property> <name>mapreduce.jobhistory.address< /name > <value>hadoop0:10020< /value > < /property > <property> <name>mapreduce.jobhistory.webapp.address< /name > <value>hadoop0:19888< /value > < /property > <property> <name>mapreduce.task.io. sort .factor< /name > <value>20< /value > <description>Thenumberofstreamstomergeatonce while sorting files.Thisdeterminesthenumberof open file handles.< /description > < /property > <property> <name>mapreduce.reduce.shuffle.parallelcopies< /name > <value>40< /value > <description>Thedefaultnumberofparalleltransfersrunbyreduce duringthecopy(shuffle)phase. < /description > < /property > <property> <name>mapreduce.job.reduce.slowstart.completedmaps< /name > <value>0.80< /value > <description>Fractionofthenumberofmaps in thejobwhichshouldbe completebeforereducesarescheduled for thejob. < /description > < /property > <property> <name>mapreduce.task.io. sort .mb< /name > <value>300< /value > <description>Thetotalamountofbuffermemorytousewhilesorting files, in megabytes.Bydefault,giveseachmergestream1MB, which shouldminimizeseeks.< /description > < /property > <property> <name>mapreduce.map.output.compress< /name > <value> true < /value > <description>Shouldtheoutputsofthemapsbecompressedbeforebeing sentacrossthenetwork.UsesSequenceFilecompression. < /description > < /property > <property> <name>mapreduce.client.submit. file .replication< /name > <value>5< /value > <description>默认10,Thereplicationlevel for submittedjobfiles.This shouldbearoundthesquarerootofthenumberofnodes. < /description > < /property > 1.5.2.修改文件yarn-site.xml 1 2 3 4 <property> <name>yarn.resourcemanager.ha.enabled< /name > <value> true < /value > < /property > 【打开resourcemanager ha模式】 1 2 3 4 <property> <name>yarn.resourcemanager.cluster- id < /name > <value>yarn-ha-cluster< /value > < /property > 【打开resourcemanager ha的集群名称,这个名称可以在zookeeper中查看】 1 2 3 4 <property> <name>yarn.resourcemanager.ha. rm -ids< /name > <value>rm1,rm2< /value > < /property > 【设置resourcemanager的id,可以与主机同名】 1 2 3 4 <property> <name>yarn.resourcemanager. hostname .rm1< /name > <value>hadoop0< /value > < /property > 【指定rm1对应哪一台主机】 1 2 3 4 <property> <name>yarn.resourcemanager. hostname .rm2< /name > <value>hadoop1< /value > < /property > 【指定rm1对应哪一台主机】 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 <property> <name>yarn.resourcemanager.zk-address< /name > <value>zk1:2181,zk2:2181,zk3:2181< /value > < /property > <property> <name>yarn.nodemanager.aux-services< /name > <value>mapreduce_shuffle< /value > < /property > <!---用什么方式进行数据传递-> <property> <name>yarn.log-aggregation- enable < /name > <value> true < /value > < /property > 【设置日志合并】 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 <property> <name>yarn.application.classpath< /name > <value> /usr/local/hadoop-2 .5.0-cdh5.3.8 /etc/hadoop , /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/common/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/common/lib/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/hdfs/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/hdfs/lib/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/yarn/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /share/hadoop/yarn/lib/ *, /usr/local/hbase-0 .98.6-cdh5.3.8 /lib/ *, /usr/local/hadoop-2 .5.0-cdh5.3.8 /lib_dc/ *, /usr/local/hbase-0 .98.6-cdh5.3.8 /conf/ < /value > < /property > 【设置classpath,没有新增外部jar的话,不需要配这个】 1 2 3 4 5 6 7 8 9 10 <!--设置调度器类型为CapacityScheduler,默认是公平调度器--> <property> <name>yarn.resourcemanager.scheduler.class< /name ><value>org.apache.hadoop.yarn.server.resourcemanager.scheduler.capacity.CapacityScheduler< /value > < /property > <!--设置nodemanager节点内存大小,CPU个数--> <property> <name>yarn.nodemanager.resource.memory-mb< /name > <value>28672< /value > < /property > 【设置nodemanager节点内存大小 28G】 1 2 3 4 <property> <name>yarn.nodemanager.resource.cpu-vcores< /name > <value>14< /value > < /property > 【设置nodemanager节点内存大小 14个core】 1 2 3 4 <property> <name>yarn.timeline-service.enabled< /name > <value> true < /value > < /property > 【打开timeline服务】 1.5.3 修改环境变量(可以不改,使用默认配置) 1.5.3.1修改 yarn-env.sh 1 YARN_LOG_DIR= /data0/hadoop2/logs 【修改yarn的日志目录,默认在$HADOOP_HOME/logs下】 1.5.3.2 修改hadoop-env.sh 1 export JAVA_HOME= /usr/java/jdk1 .7.0_25 【修改jdk】 1 export HADOOP_LOG_DIR= /data0/hadoop2/logs 【修改hadoop的日志目录,默认在$HADOOP_HOME/logs下】 1 export HADOOP_PID_DIR= /data0/hadoop2/pid 【修改hadoop pid目录】 1.5.5修改capacity-scheduler.xml这个文件(可选 ,设置调度器为CapacityScheduler时,可以通过这个配置文件修改作业队列) 1 2 3 4 5 6 7 8 9 10 11 12 <configuration> <!--comparememroyonly--> <property> <name>yarn.scheduler.capacity.resource-calculator< /name > <value>org.apache.hadoop.yarn.util.resource.DefaultResourceCalculator< /value > < /property > <!-- more chance for appmasterthatwilllaunchMRjobs--> <property> <name>yarn.scheduler.capacity.maximum-am-resource-percent< /name > <value>0.9< /value > < /property > 【appMaster可以使用集群多少资源】 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 <!--打开异步调度--> <property> <name>yarn.scheduler.capacity.schedule-asynchronously. enable < /name > <value> true < /value > < /property > <!--定义队列名称queues,dev--> <property> <name>yarn.scheduler.capacity.root.queues< /name > <value>default,dev< /value > < /property > <property> <name>yarn.scheduler.capacity.root.dev.capacity< /name > <value>50< /value > < /property > 【设置队列dev的能力大小占集群的50%】 1 2 3 4 <property> <name>yarn.scheduler.capacity.root.default.capacity< /name > <value>50< /value > < /property > 【设置队列default的能力大小占集群的50%】 1 < /configuration > 1.5.4 启动yarn 在hadoop0上执行 1 sbin /start-yarn .sh 本文转自 zouqingyun 51CTO博客,原文链接:http://blog.51cto.com/zouqingyun/1754041,如需转载请自行联系原作者