首页 文章 精选 留言 我的

精选列表

搜索[MSA技术],共10000篇文章
优秀的个人博客,低调大师

技术分享 | Javaer 如何做单元测试

前言: 本文适用于 javaer,其他开发者或许可以借鉴。 写本文的主旨有两个,一是简单的给大家介绍下单元测试,二是通过一个简单的示例来介绍一些单元测试的技巧,希望以此来降低大家写单元测试的门槛。 1、单元测试的定义 单元测试通常是由软件开发人员编写和运营的自动化测试,以确保应用程序的一部分(称为“单元”符合其设计并按预期运行。在编程过程中,一个单元可以是一个完整的模块,但更常见的是一个单独的函数或过程。在面向对象编程中,一个单元通常是一个完整的接口,例如一个类,或者一个单独的方法。通过首先为最小的可测试单元编写测试,然后是它们之间的复合行为,可以为复杂的应用程序构建全面的测试。 Unit tests are typically automated tests written and run by software developers to ensure that a section of an application(known as the “unit”)meets its design and behaves as intended. In procedural programming,a unit could be an entire module, but it is more commonly an individual function or procedure. In object-oriented programming,a unit is often an entire interface,such as a class,or an individual method.By writing tests first for the smallest testable units,then the compound behaviors between those,one can build up comprehensive tests for complex applications. —Wikipedia,Unit testing 简单来说,单元测试是针对一个单元编写测试方法。其中的单元可以是一个很单纯的函数,也可以是一个完整的接口,该接口中可以包含各种其他函数的调用。 2、单元测试用例 该项目的 SpringBoot 版本是 2.2.5.RELEASE。 <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starters</artifactId> <version>2.2.5.RELEASE</version> </parent> ➮ 2-1.项目文件准备 假设有项目文件的目录结构如下: 其中依赖关系为: java-study-web-provider 依赖 java-study-web-api, java-study-common-provider java-study-web-api 依赖 java-study-common-api java-study-common-provider 依赖 java-study-web-api, java-study-common-api 在 java-study-web-api 包中有个rpc 包,其中有两个 rpc 接口,分别是 WebRpc.class & WebRpc2.class。然而,这两个接口的实现类在 java-study-web-provider 包中。 public interface WebRpc { ApiResult<String> get(); ApiResult<String> get2(String param); } public interface WebRpc2 { ApiResult<String> get(); ApiResult<String> get(String param); } @Service public class WebRpcImpl implements WebRpc { @Override public ApiResult<String> get() { return ApiResult.success("get success"); } @Override public ApiResult<String> get2(String param) { return ApiResult.success(param); } } @Service public class WebRpc2Impl implements WebRpc2 { @Override public ApiResult<String> get() { return ApiResult.success("get success"); } @Override public ApiResult<String> get(String param) { return null; } } 在 java-study-common-provider 包中有个 service 包,其中有两个 service 接口以及对应的实现类,分别是CommonEntityService.class,CommonEntityService2.class,CommonEntityServiceImpl.class, CommonEntityService2Impl.class,在两个实现类中都有引用 rpc 接口。 public interface CommonEntityService { ApiResult<Void> test(CommonEntity commonEntity); } public interface CommonEntityService2 { } @Service public class CommonEntityServiceImpl implements CommonEntityService { private final Logger logger = LoggerFactory.getLogger(this.getClass()); @Autowired private CommonEntityManager commonEntityManager; @Autowired private WebRpc webRpc; @Override public ApiResult<Void> test(CommonEntity commonEntity) { // webRpc 单元测试时可能为null ApiResult<String> getRpc = webRpc.get(); if (!getRpc.getSuccess()) { logger.info("getRpc fail: {}", getRpc); return ApiResult.error(getRpc); } ApiResult<String> getRpc2 = webRpc.get2("test"); if (!getRpc2.getSuccess()) { logger.info("getRpc2 fail: {}", getRpc2); return ApiResult.error(getRpc2); } // 依赖远程方法调用结果 Optional<String> remoteResultOpt = RmiUtil.getRemoteResult(); if (!remoteResultOpt.isPresent()) { logger.info("getRemoteResult fail"); return ApiResult.error(BizRespStatusEnum.SYS_ERR); } // 入库 int insertNo = commonEntityManager.insert(commonEntity); logger.info("insert {} common entity", insertNo); return ApiResult.success(null); } } @Service public class CommonEntityService2Impl implements CommonEntityService2 { @Autowired private WebRpc2 webRpc2; } ➮ 2-2.针对 CommonEntityService.class 编写单元测试 先加入 SpringBootTest 依赖。 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> <exclusions> <exclusion> <groupId>org.junit.vintage</groupId> <artifactId>junit-vintage-engine</artifactId> </exclusion> </exclusions> </dependency> 创建对应的单元测试类。 @ExtendWith(SpringExtension.class) @SpringBootTest(classes = CommonTestApplication.class) public class CommonEntityServiceTest { private final Logger logger = LoggerFactory.getLogger(this.getClass()); @Autowired private CommonEntityService commonEntityService; @Test public void test() { ApiResult<Void> testSuccess = commonEntityService.test(new CommonEntity()); Assert.isTrue(testSuccess.getSuccess(), "testSuccess fail"); logger.info("testSuccess: {}", JSON.toJSONString(testSuccess)); } } 当我们去执行单元测试的 test() 方法时,会出现 NoSuchBeanDefinitionException 异常。 Caused by: org.springframework.beans.factory.NoSuchBeanDefinitionException: No qualifying bean of type 'com.peng.java.study.web.api.rpc.WebRpc2' available: expected at least 1 bean which qualifies as autowire candidate. Dependency annotations: {@org.springframework.beans.factory.annotation.Autowired(required=true)} at org.springframework.beans.factory.support.DefaultListableBeanFactory.raiseNoMatchingBeanFound(DefaultListableBeanFactory.java:1695) at org.springframework.beans.factory.support.DefaultListableBeanFactory.doResolveDependency(DefaultListableBeanFactory.java:1253) at org.springframework.beans.factory.support.DefaultListableBeanFactory.resolveDependency(DefaultListableBeanFactory.java:1207) at org.springframework.beans.factory.annotation.AutowiredAnnotationBeanPostProcessor$AutowiredFieldElement.inject(AutowiredAnnotationBeanPostProcessor.java:640) ... 43 more 这是因为我们执行单元测试的这个模块虽然依赖了 java-study-web-api 包,能够调用 rpc 方法,但是没有依赖 java-study-web-provider 包,没办法注入对应的实现类。 有三种方法可以解决这个问题: I .将该单元测试类挪到 java-study-web-provider 包中,这样就能加载到所有的 bean 了。 这个方法有局限性,每次执行单元测试都需要加载所有模块的文件,大大的降低了单元测试的效率。 II .在注入rpc的注解 @Autowired 上加上 required = false @Autowired(required = false) private WebRpc2 webRpc2; 这个方法有局限性,假设每次新增的 service 类都需要注入同一个 rpc 时,那每个 rpc 的注解 @Autowired 都需要使用 required = false,不然就没办法启动单元测试,由此可见是比较麻烦的。 III.使用Mock,在执行单元测试前,将依赖但又没办法获取到实现类的 bean 注入进去。 将mokito包加入项目。 <!-- https://mvnrepository.com/artifact/org.mockito/mockito-inline --> <dependency> <groupId>org.mockito</groupId> <artifactId>mockito-inline</artifactId> <version>4.5.1</version> <scope>test</scope> </dependency> <!-- https://mvnrepository.com/artifact/org.mockito/mockito-core --> <dependency> <groupId>org.mockito</groupId> <artifactId>mockito-core</artifactId> <version>4.5.1</version> <scope>test</scope> </dependency> <!-- https://mvnrepository.com/artifact/net.bytebuddy/byte-buddy-agent --> <dependency> <groupId>net.bytebuddy</groupId> <artifactId>byte-buddy-agent</artifactId> <version>1.12.9</version> <scope>test</scope> </dependency> <!-- https://mvnrepository.com/artifact/net.bytebuddy/byte-buddy --> <dependency> <groupId>net.bytebuddy</groupId> <artifactId>byte-buddy</artifactId> <version>1.12.8</version> </dependency> 使用 @MockBean 和 MockitoAnnotations.openMocks(this) 可以将依赖的 bean 注入进去。 @ExtendWith(SpringExtension.class) @SpringBootTest(classes = CommonTestApplication.class) public class CommonEntityServiceTest { private final Logger logger = LoggerFactory.getLogger(this.getClass()); @Autowired private CommonEntityService commonEntityService; @MockBean public WebRpc webRpc; @MockBean public WebRpc2 webRpc2; @BeforeEach public void before(){ MockitoAnnotations.openMocks(this); } @Test public void test() { ApiResult<Void> testSuccess = commonEntityService.test(new CommonEntity()); Assert.isTrue(testSuccess.getSuccess(), "testSuccess fail"); logger.info("testSuccess: {}", JSON.toJSONString(testSuccess)); } } 此时再执行 test() 方法,不再出现 NoSuchBeanDefinitionException 异常,但会出现 NullPointerException 异常。这是因为我们虽然注入了 bean,但这个 bean 是个空的,因此在 commonEntityService.test 方法中执行 webRpc.get() 时,会报 NullPointerException 异常。为解决这个问题,我们可以继续使用 mock,Mockito.when(). thenReturn()。 @ExtendWith(SpringExtension.class) @SpringBootTest(classes = CommonTestApplication.class) public class CommonEntityServiceTest { private final Logger logger = LoggerFactory.getLogger(this.getClass()); @Autowired private CommonEntityService commonEntityService; @MockBean public WebRpc webRpc; @MockBean public WebRpc2 webRpc2; @BeforeEach public void before(){ MockitoAnnotations.openMocks(this); } @Test public void test() { Mockito.when(webRpc.get()).thenReturn(ApiResult.success("mock result 1")); Mockito.when(webRpc.get2("test")).thenReturn(ApiResult.success("mock result 2")); ApiResult<Void> testSuccess = commonEntityService.test(new CommonEntity()); Assert.isTrue(testSuccess.getSuccess(), "testSuccess fail"); logger.info("testSuccess: {}", JSON.toJSONString(testSuccess)); } } 再次执行 test() 方法,此时执行已经成功了,打印日志如下所示。 2022-05-21 22:23:23.094 INFO 3760 --- [ main] c.p.j.s.c.c.s.i.CommonEntityServiceImpl : insert 0 common entity 2022-05-21 22:23:23.161 INFO 3760 --- [ main] c.p.j.s.c.c.s.CommonEntityServiceTest : apiResult: {"code":"200","msg":"调用成功","success":true} 虽然已经成功执行了单元测试,但如果需要 mock 的 bean 很多的话,那不是每个测试类都需要写一遍 mock,很浪费时间啊,因此,我们可以把需要 mock 的 bean 全都放到一个类中进行管理。 @Component public class CommonMockFactory { @BeforeEach public void before(){ MockitoAnnotations.openMocks(this); } @MockBean public WebRpc webRpc; @MockBean public WebRpc2 webRpc2; } 然后在需要单元测试的类中进行注入即可。 @ExtendWith(SpringExtension.class) @SpringBootTest(classes = CommonTestApplication.class) public class CommonEntityServiceTest { private final Logger logger = LoggerFactory.getLogger(this.getClass()); @Autowired private CommonEntityService commonEntityService; @Autowired private CommonMockFactory commonMockFactory; @Test public void test() { Mockito.when(commonMockFactory.webRpc.get()).thenReturn(ApiResult.success("mock result 1")); Mockito.when(commonMockFactory.webRpc.get2("test")).thenReturn(ApiResult.success("mock result 2")); ApiResult<Void> testSuccess = commonEntityService.test(new CommonEntity()); Assert.isTrue(testSuccess.getSuccess(), "testSuccess fail"); logger.info("testSuccess: {}", JSON.toJSONString(testSuccess)); } } ➮ 2-3.提高单元测试覆盖率 使用idea自带的单元测试覆盖率工具可以查看相应的覆盖率。绿色的条代表已覆盖,红色的条代表未覆盖。 以下是单元测试的覆盖率文档,分别是类覆盖率、方法覆盖率、行覆盖率,从图中可以看出我们的行覆盖率只有64%,还有提升的空间。 如何提升呢?答案就是 mock。 先上改造后的代码: @ExtendWith(SpringExtension.class) @SpringBootTest(classes = CommonTestApplication.class) public class CommonEntityServiceTest { private final Logger logger = LoggerFactory.getLogger(this.getClass()); @Autowired private CommonEntityService commonEntityService; @Autowired private CommonMockFactory commonMockFactory; @Test public void test() { Mockito.when(commonMockFactory.webRpc.get()).thenReturn(ApiResult.success("mock result 1")); Mockito.when(commonMockFactory.webRpc.get2("test")).thenReturn(ApiResult.success("mock result 2")); ApiResult<Void> testSuccess = commonEntityService.test(new CommonEntity()); Assert.isTrue(testSuccess.getSuccess(), "testSuccess fail"); logger.info("testSuccess: {}", JSON.toJSONString(testSuccess)); } @Test public void testWithMock() { Mockito.when(commonMockFactory.webRpc.get()).thenReturn(ApiResult.success("mock result 1")); Mockito.when(commonMockFactory.webRpc.get2("test")).thenReturn(ApiResult.success("mock result 2")); ApiResult<Void> testSuccess = commonEntityService.test(new CommonEntity()); Assert.isTrue(testSuccess.getSuccess(), "testSuccess fail"); logger.info("testSuccess: {}", JSON.toJSONString(testSuccess)); // 模拟 webRpc.get() 失败 Mockito.when(commonMockFactory.webRpc.get()).thenReturn(ApiResult.error(BizRespStatusEnum.ILLEGAL_PARAM)); Mockito.when(commonMockFactory.webRpc.get2("test")).thenReturn(ApiResult.success("mock result 2")); ApiResult<Void> testFail1 = commonEntityService.test(new CommonEntity()); Assert.isTrue(!testFail1.getSuccess(), "testFail1 fail"); logger.info("testFail1: {}", JSON.toJSONString(testFail1)); Mockito.when(commonMockFactory.webRpc.get()).thenReturn(ApiResult.success("mock result 1")); // 模拟 webRpc.get2() 失败 Mockito.when(commonMockFactory.webRpc.get2("test")).thenReturn(ApiResult.error(BizRespStatusEnum.ILLEGAL_PARAM)); ApiResult<Void> testFail2 = commonEntityService.test(new CommonEntity()); Assert.isTrue(!testFail2.getSuccess(), "testFail1 fail"); logger.info("testFail2: {}", JSON.toJSONString(testFail2)); Mockito.when(commonMockFactory.webRpc.get()).thenReturn(ApiResult.success("mock result 1")); Mockito.when(commonMockFactory.webRpc.get2("test")).thenReturn(ApiResult.success("mock result 2")); try (MockedStatic<RmiUtil> rmiUtilMockedStatic = Mockito.mockStatic(RmiUtil.class)) { // 模拟 RmiUtil.getRemoteResult() 失败 rmiUtilMockedStatic.when(RmiUtil::getRemoteResult).thenReturn(Optional.empty()); ApiResult<Void> testFail3 = commonEntityService.test(new CommonEntity()); Assert.isTrue(!testFail3.getSuccess(), "testFail3 fail"); logger.info("testFail3: {}", JSON.toJSONString(testFail3)); } } } 单元测试的执行结果。 2022-05-21 23:23:46.516 INFO 35136 --- [ main] c.p.j.s.c.c.s.i.CommonEntityServiceImpl : insert 0 common entity 2022-05-21 23:23:46.589 INFO 35136 --- [ main] c.p.j.s.c.c.s.CommonEntityServiceTest : testSuccess: {"code":"200","msg":"调用成功","success":true} 2022-05-21 23:23:46.590 INFO 35136 --- [ main] c.p.j.s.c.c.s.i.CommonEntityServiceImpl : getRpc fail: ApiResult{success=false, code='400', msg='参数异常', result=null} 2022-05-21 23:23:46.590 INFO 35136 --- [ main] c.p.j.s.c.c.s.CommonEntityServiceTest : testFail1: {"code":"400","msg":"参数异常","success":false} 2022-05-21 23:23:46.591 INFO 35136 --- [ main] c.p.j.s.c.c.s.i.CommonEntityServiceImpl : getRpc2 fail: ApiResult{success=false, code='400', msg='参数异常', result=null} 2022-05-21 23:23:46.591 INFO 35136 --- [ main] c.p.j.s.c.c.s.CommonEntityServiceTest : testFail2: {"code":"400","msg":"参数异常","success":false} 2022-05-21 23:23:46.629 INFO 35136 --- [ main] c.p.j.s.c.c.s.i.CommonEntityServiceImpl : getRemoteResult fail 2022-05-21 23:23:46.629 INFO 35136 --- [ main] c.p.j.s.c.c.s.CommonEntityServiceTest : testFail3: {"code":"002","msg":"系统异常","success":false} 再来看看改造之后的覆盖率!从下图中可以看出单元测试的行覆盖率达到了100%,惊不惊喜,意不意外! 3、总结 在我们没用 mock 工具时,别说覆盖率了,执行一个单元测试都很麻烦。 使用 mock 工具之后,我们不仅可以很方便的执行单元测试,还能使用各种奇技淫巧来提升行覆盖率,强烈推荐! 写好单元测试一点都不简单,本文只是拿了一个简单的场景来举例,在单元测试的行覆盖率达到100%时,代码量就已经是源码的两倍还多了,害!但是 bug 和单元测试总要选一个的,看大家的选择了,哈哈哈。 了解更多敏捷开发、项目管理、行业动态等消息,关注我们 [LigaAI@oschina](https://my.oschina.net/u/5057806 "LigaAI@oschina") 或点击 LigaAI - 新一代智能研发协作平台,在线申请体验我们的产品。

优秀的个人博客,低调大师

逆向进阶,利用 AST 技术还原 JavaScript 混淆代码

什么是 AST AST(Abstract Syntax Tree),中文抽象语法树,简称语法树(Syntax Tree),是源代码的抽象语法结构的树状表现形式,树上的每个节点都表示源代码中的一种结构。语法树不是某一种编程语言独有的,JavaScript、Python、Java、Golang 等几乎所有编程语言都有语法树。 小时候我们得到一个玩具,总喜欢把玩具拆解成一个一个小零件,然后按照我们自己的想法,把零件重新组装起来,一个新玩具就诞生了。而 JavaScript 就像一台精妙运作的机器,通过 AST 解析,我们也可以像童年时拆解玩具一样,深入了解 JavaScript 这台机器的各个零部件,然后重新按照我们自己的意愿来组装。 AST 的用途很广,IDE 的语法高亮、代码检查、格式化、压缩、转译等,都需要先将代码转化成 AST 再进行后续的操作,ES5 和 ES6 语法差异,为了向后兼容,在实际应用中需要进行语法的转换,也会用到 AST。AST 并不是为了逆向而生,但做逆向学会了 AST,在解混淆时可以如鱼得水。 AST 有一个在线解析网站:https://astexplorer.net/ ,顶部可以选择语言、编译器、是否开启转化等,如下图所示,区域①是源代码,区域②是对应的 AST 语法树,区域③是转换代码,可以对语法树进行各种操作,区域④是转换后生成的新代码。图中原来的 Unicode 字符经过操作之后就变成了正常字符。 语法树没有单一的格式,选择不同的语言、不同的编译器,得到的结果也是不一样的,在 JavaScript 中,编译器有 Acorn、Espree、Esprima、Recast、Uglify-JS 等,使用最多的是 Babel,后续的学习也是以 Babel 为例。 AST 在编译中的位置 在编译原理中,编译器转换代码通常要经过三个步骤:词法分析(Lexical Analysis)、语法分析(Syntax Analysis)、代码生成(Code Generation),下图生动展示了这一过程: 词法分析 词法分析阶段是编译过程的第一个阶段,这个阶段的任务是从左到右一个字符一个字符地读入源程序,然后根据构词规则识别单词,生成 token 符号流,比如 isPanda('🐼'),会被拆分成 isPanda,(,'🐼',) 四部分,每部分都有不同的含义,可以将词法分析过程想象为不同类型标记的列表或数组。 语法分析 语法分析是编译过程的一个逻辑阶段,语法分析的任务是在词法分析的基础上将单词序列组合成各类语法短语,比如“程序”,“语句”,“表达式”等,前面的例子中,isPanda('🐼') 就会被分析为一条表达语句 ExpressionStatement,isPanda() 就会被分析成一个函数表达式 CallExpression,🐼 就会被分析成一个变量 Literal 等,众多语法之间的依赖、嵌套关系,就构成了一个树状结构,即 AST 语法树。 代码生成 代码生成是最后一步,将 AST 语法树转换成可执行代码即可,在转换之前,我们可以直接操作语法树,进行增删改查等操作,例如,我们可以确定变量的声明位置、更改变量的值、删除某些节点等,我们将语句 isPanda('🐼') 修改为一个布尔类型的 Literal:true,语法树就有如下变化: Babel 简介 Babel 是一个 JavaScript 编译器,也可以说是一个解析库,Babel 中文网:https://www.babeljs.cn/ ,Babel 英文官网:https://babeljs.io/ ,Babel 内置了很多分析 JavaScript 代码的方法,我们可以利用 Babel 将 JavaScript 代码转换成 AST 语法树,然后增删改查等操作之后,再转换成 JavaScript 代码。 Babel 包含的各种功能包、API、各方法可选参数等,都非常多,本文不一一列举,在实际使用过程中,应当多查询官方文档,或者参考文末给出的一些学习资料。Babel 的安装和其他 Node 包一样,需要哪个安装哪个即可,比如 npm install @babel/core @babel/parser @babel/traverse @babel/generator 在做逆向解混淆中,主要用到了 Babel 的以下几个功能包,本文也仅介绍以下几个功能包: @babel/core:Babel 编译器本身,提供了 babel 的编译 API; @babel/parser:将 JavaScript 代码解析成 AST 语法树; @babel/traverse:遍历、修改 AST 语法树的各个节点; @babel/generator:将 AST 还原成 JavaScript 代码; @babel/types:判断、验证节点的类型、构建新 AST 节点等。 @babel/core Babel 编译器本身,被拆分成了三个模块:@babel/parser、@babel/traverse、@babel/generator,比如以下方法的导入效果都是一样的: const parse = require("@babel/parser").parse; const parse = require("@babel/core").parse; const traverse = require("@babel/traverse").default const traverse = require("@babel/core").traverse @babel/parser @babel/parser 可以将 JavaScript 代码解析成 AST 语法树,其中主要提供了两个方法: parser.parse(code, [{options}]):解析一段 JavaScript 代码; parser.parseExpression(code, [{options}]):考虑到了性能问题,解析单个 JavaScript 表达式。 部分可选参数 options: 参数 描述 allowImportExportEverywhere 默认 import 和 export 声明语句只能出现在程序的最顶层,设置为 true 则在任何地方都可以声明 allowReturnOutsideFunction 默认如果在顶层中使用 return 语句会引起错误,设置为 true 就不会报错 sourceType 默认为 script,当代码中含有 import 、export 等关键字时会报错,需要指定为 module errorRecovery 默认如果 babel 发现一些不正常的代码就会抛出错误,设置为 true 则会在保存解析错误的同时继续解析代码,错误的记录将被保存在最终生成的 AST 的 errors 属性中,当然如果遇到严重的错误,依然会终止解析 举个例子看得比较清楚: const parser = require("@babel/parser"); const code = "const a = 1;"; const ast = parser.parse(code, {sourceType: "module"}) console.log(ast) {sourceType: "module"} 演示了如何添加可选参数,输出的就是 AST 语法树,这和在线网站 https://astexplorer.net/ 解析出来的语法树是一样的: @babel/generator @babel/generator 可以将 AST 还原成 JavaScript 代码,提供了一个 generate 方法:generate(ast, [{options}], code)。 部分可选参数 options: 参数 描述 auxiliaryCommentBefore 在输出文件内容的头部添加注释块文字 auxiliaryCommentAfter 在输出文件内容的末尾添加注释块文字 comments 输出内容是否包含注释 compact 输出内容是否不添加空格,避免格式化 concise 输出内容是否减少空格使其更紧凑一些 minified 是否压缩输出代码 retainLines 尝试在输出代码中使用与源代码中相同的行号 接着前面的例子,原代码是 const a = 1;,现在我们把 a 变量修改为 b,值 1 修改为 2,然后将 AST 还原生成新的 JS 代码: const parser = require("@babel/parser"); const generate = require("@babel/generator").default const code = "const a = 1;"; const ast = parser.parse(code, {sourceType: "module"}) ast.program.body[0].declarations[0].id.name = "b" ast.program.body[0].declarations[0].init.value = 2 const result = generate(ast, {minified: true}) console.log(result.code) 最终输出的是 const b=2;,变量名和值都成功更改了,由于加了压缩处理,等号左右两边的空格也没了。 代码里 {minified: true} 演示了如何添加可选参数,这里表示压缩输出代码,generate 得到的 result 得到的是一个对象,其中的 code 属性才是最终的 JS 代码。 代码里 ast.program.body[0].declarations[0].id.name 是 a 在 AST 中的位置,ast.program.body[0].declarations[0].init.value 是 1 在 AST 中的位置,如下图所示: @babel/traverse 当代码多了,我们不可能像前面那样挨个定位并修改,对于相同类型的节点,我们可以直接遍历所有节点来进行修改,这里就用到了 @babel/traverse,它通常和 visitor 一起使用,visitor 是一个对象,这个名字是可以随意取的,visitor 里可以定义一些方法来过滤节点,这里还是用一个例子来演示: const parser = require("@babel/parser"); const generate = require("@babel/generator").default const traverse = require("@babel/traverse").default const code = ` const a = 1500; const b = 60; const c = "hi"; const d = 787; const e = "1244"; ` const ast = parser.parse(code) const visitor = { NumericLiteral(path){ path.node.value = (path.node.value + 100) * 2 }, StringLiteral(path){ path.node.value = "I Love JavaScript!" } } traverse(ast, visitor) const result = generate(ast) console.log(result.code) 这里的原始代码定义了 abcde 五个变量,其值有数字也有字符串,我们在 AST 中可以看到对应的类型为 NumericLiteral 和 StringLiteral: 然后我们声明了一个 visitor 对象,然后定义对应类型的处理方法,traverse 接收两个参数,第一个是 AST 对象,第二个是 visitor,当 traverse 遍历所有节点,遇到节点类型为 NumericLiteral 和 StringLiteral 时,就会调用 visitor 中对应的处理方法,visitor 中的方法会接收一个当前节点的 path 对象,该对象的类型是 NodePath,该对象有非常多的属性,以下介绍几种最常用的: 属性 描述 toString() 当前路径的源码 node 当前路径的节点 parent 当前路径的父级节点 parentPath 当前路径的父级路径 type 当前路径的类型 PS:path 对象除了有很多属性以外,还有很多方法,比如替换节点、删除节点、插入节点、寻找父级节点、获取同级节点、添加注释、判断节点类型等,可在需要时查询相关文档或查看源码,后续介绍 @babel/types 部分将会举部分例子来演示,以后的实战文章中也会有相关实例,篇幅有限本文不再细说。 因此在上面的代码中,path.node.value 就拿到了变量的值,然后我们就可以进一步对其进行修改了。以上代码运行后,所有数字都会加上100后再乘以2,所有字符串都会被替换成 I Love JavaScript!,结果如下: const a = 3200; const b = 320; const c = "I Love JavaScript!"; const d = 1774; const e = "I Love JavaScript!"; 如果多个类型的节点,处理的方式都一样,那么还可以使用 | 将所有节点连接成字符串,将同一个方法应用到所有节点: const visitor = { "NumericLiteral|StringLiteral"(path) { path.node.value = "I Love JavaScript!" } } visitor 对象有多种写法,以下几种写法的效果都是一样的: const visitor = { NumericLiteral(path){ path.node.value = (path.node.value + 100) * 2 }, StringLiteral(path){ path.node.value = "I Love JavaScript!" } } const visitor = { NumericLiteral: function (path){ path.node.value = (path.node.value + 100) * 2 }, StringLiteral: function (path){ path.node.value = "I Love JavaScript!" } } const visitor = { NumericLiteral: { enter(path) { path.node.value = (path.node.value + 100) * 2 } }, StringLiteral: { enter(path) { path.node.value = "I Love JavaScript!" } } } const visitor = { enter(path) { if (path.node.type === "NumericLiteral") { path.node.value = (path.node.value + 100) * 2 } if (path.node.type === "StringLiteral") { path.node.value = "I Love JavaScript!" } } } 以上几种写法中有用到了 enter 方法,在节点的遍历过程中,进入节点(enter)与退出(exit)节点都会访问一次节点,traverse 默认在进入节点时进行节点的处理,如果要在退出节点时处理,那么在 visitor 中就必须声明 exit 方法。 @babel/types @babel/types 主要用于构建新的 AST 节点,前面的示例代码为 const a = 1;,如果想要增加内容,比如变成 const a = 1; const b = a * 5 + 1;,就可以通过 @babel/types 来实现。 首先观察一下 AST 语法树,原语句只有一个 VariableDeclaration 节点,现在增加了一个: 那么我们的思路就是在遍历节点时,遍历到 VariableDeclaration 节点,就在其后面增加一个 VariableDeclaration 节点,生成 VariableDeclaration 节点,可以使用 types.variableDeclaration() 方法,在 types 中各种方法名称和我们在 AST 中看到的是一样的,只不过首字母是小写的,所以我们不需要知道所有方法的情况下,也能大致推断其方法名,只知道这个方法还不行,还得知道传入的参数是什么,可以查文档,不过K哥这里推荐直接看源码,非常清晰明了,以 Pycharm 为例,按住 Ctrl 键,再点击方法名,就进到源码里了: function variableDeclaration(kind: "var" | "let" | "const", declarations: Array<BabelNodeVariableDeclarator>) 可以看到需要 kind 和 declarations 两个参数,其中 declarations 是 VariableDeclarator 类型的节点组成的列表,所以我们可以先写出以下 visitor 部分的代码,其中 path.insertAfter() 是在该节点之后插入新节点的意思: const visitor = { VariableDeclaration(path) { let declaration = types.variableDeclaration("const", [declarator]) path.insertAfter(declaration) } } 接下来我们还需要进一步定义 declarator,也就是 VariableDeclarator 类型的节点,查询其源码如下: function variableDeclarator(id: BabelNodeLVal, init?: BabelNodeExpression) 观察 AST,id 为 Identifier 对象,init 为 BinaryExpression 对象,如下图所示: 先来处理 id,可以使用 types.identifier() 方法来生成,其源码为 function identifier(name: string),name 在这里就是 b 了,此时 visitor 代码就可以这么写: const visitor = { VariableDeclaration(path) { let declarator = types.variableDeclarator(types.identifier("b"), init) let declaration = types.variableDeclaration("const", [declarator]) path.insertAfter(declaration) } } 然后再来看 init 该如何定义,首先仍然是看 AST 结构: init 为 BinaryExpression 对象,left 左边是 BinaryExpression,right 右边是 NumericLiteral,可以用 types.binaryExpression() 方法来生成 init,其源码如下: function binaryExpression( operator: "+" | "-" | "/" | "%" | "*" | "**" | "&" | "|" | ">>" | ">>>" | "<<" | "^" | "==" | "===" | "!=" | "!==" | "in" | "instanceof" | ">" | "<" | ">=" | "<=", left: BabelNodeExpression | BabelNodePrivateName, right: BabelNodeExpression ) 此时 visitor 代码就可以这么写: const visitor = { VariableDeclaration(path) { let init = types.binaryExpression("+", left, right) let declarator = types.variableDeclarator(types.identifier("b"), init) let declaration = types.variableDeclaration("const", [declarator]) path.insertAfter(declaration) } } 然后继续构造 left 和 right,和前面的方法一样,观察 AST 语法树,查询对应方法应该传入的参数,层层嵌套,直到把所有的节点都构造完毕,最终的 visitor 代码应该是这样的: const visitor = { VariableDeclaration(path) { let left = types.binaryExpression("*", types.identifier("a"), types.numericLiteral(5)) let right = types.numericLiteral(1) let init = types.binaryExpression("+", left, right) let declarator = types.variableDeclarator(types.identifier("b"), init) let declaration = types.variableDeclaration("const", [declarator]) path.insertAfter(declaration) path.stop() } } 注意:path.insertAfter() 插入节点语句后面加了一句 path.stop(),表示插入完成后立即停止遍历当前节点和后续的子节点,添加的新节点也是 VariableDeclaration,如果不加停止语句的话,就会无限循环插入下去。 插入新节点后,再转换成 JavaScript 代码,就可以看到多了一行新代码,如下图所示: 常见混淆还原 了解了 AST 和 babel 后,就可以对 JavaScript 混淆代码进行还原了,以下是部分样例,带你进一步熟悉 babel 的各种操作。 字符串还原 文章开头的图中举了个例子,正常字符被换成了 Unicode 编码: console['\u006c\u006f\u0067']('\u0048\u0065\u006c\u006c\u006f\u0020\u0077\u006f\u0072\u006c\u0064\u0021') 观察 AST 结构: 我们发现 Unicode 编码对应的是 raw,而 rawValue 和 value 都是正常的,所以我们可以将 raw 替换成 rawValue 或 value 即可,需要注意的是引号的问题,本来是 console["log"],你还原后变成了 console[log],自然会报错的,除了替换值以外,这里直接删除 extra 节点,或者删除 raw 值也是可以的,所以以下几种写法都可以还原代码: const parser = require("@babel/parser"); const generate = require("@babel/generator").default const traverse = require("@babel/traverse").default const code = `console['\u006c\u006f\u0067']('\u0048\u0065\u006c\u006c\u006f\u0020\u0077\u006f\u0072\u006c\u0064\u0021')` const ast = parser.parse(code) const visitor = { StringLiteral(path) { // 以下方法均可 // path.node.extra.raw = path.node.rawValue // path.node.extra.raw = '"' + path.node.value + '"' // delete path.node.extra delete path.node.extra.raw } } traverse(ast, visitor) const result = generate(ast) console.log(result.code) 还原结果: console["log"]("Hello world!"); 表达式还原 之前K哥写过 JSFuck 混淆的还原,其中有介绍 ![] 可表示 false,!![] 或者 !+[] 可表示 true,在一些混淆代码中,经常有这些操作,把简单的表达式复杂化,往往需要执行一下语句,才能得到真正的结果,示例代码如下: const a = !![]+!![]+!![]; const b = Math.floor(12.34 * 2.12) const c = 10 >> 3 << 1 const d = String(21.3 + 14 * 1.32) const e = parseInt("1.893" + "45.9088") const f = parseFloat("23.2334" + "21.89112") const g = 20 < 18 ? '未成年' : '成年' 想要执行语句,我们需要了解 path.evaluate() 方法,该方法会对 path 对象进行执行操作,自动计算出结果,返回一个对象,其中的 confident 属性表示置信度,value 表示计算结果,使用 types.valueToNode() 方法创建节点,使用 path.replaceInline() 方法将节点替换成计算结果生成的新节点,替换方法有一下几种: replaceWith:用一个节点替换另一个节点; replaceWithMultiple:用多个节点替换另一个节点; replaceWithSourceString:将传入的源码字符串解析成对应 Node 后再替换,性能较差,不建议使用; replaceInline:用一个或多个节点替换另一个节点,相当于同时有了前两个函数的功能。 对应的 AST 处理代码如下: const parser = require("@babel/parser"); const generate = require("@babel/generator").default const traverse = require("@babel/traverse").default const types = require("@babel/types") const code = ` const a = !![]+!![]+!![]; const b = Math.floor(12.34 * 2.12) const c = 10 >> 3 << 1 const d = String(21.3 + 14 * 1.32) const e = parseInt("1.893" + "45.9088") const f = parseFloat("23.2334" + "21.89112") const g = 20 < 18 ? '未成年' : '成年' ` const ast = parser.parse(code) const visitor = { "BinaryExpression|CallExpression|ConditionalExpression"(path) { const {confident, value} = path.evaluate() if (confident){ path.replaceInline(types.valueToNode(value)) } } } traverse(ast, visitor) const result = generate(ast) console.log(result.code) 最终结果: const a = 3; const b = 26; const c = 2; const d = "39.78"; const e = parseInt("1.89345.9088"); const f = parseFloat("23.233421.89112"); const g = "\u6210\u5E74"; 删除未使用变量 有时候代码里会有一些并没有使用到的多余变量,删除这些多余变量有助于更加高效的分析代码,示例代码如下: const a = 1; const b = a * 2; const c = 2; const d = b + 1; const e = 3; console.log(d) 删除多余变量,首先要了解 NodePath 中的 scope,scope 的作用主要是查找标识符的作用域、获取并修改标识符的所有引用等,删除未使用变量主要用到了 scope.getBinding() 方法,传入的值是当前节点能够引用到的标识符名称,返回的关键属性有以下几个: identifier:标识符的 Node 对象; path:标识符的 NodePath 对象; constant:标识符是否为常量; referenced:标识符是否被引用; references:标识符被引用的次数; constantViolations:如果标识符被修改,则会存放所有修改该标识符节点的 Path 对象; referencePaths:如果标识符被引用,则会存放所有引用该标识符节点的 Path 对象。 所以我们可以通过 constantViolations、referenced、references、referencePaths 多个参数来判断变量是否可以被删除,AST 处理代码如下: const parser = require("@babel/parser"); const generate = require("@babel/generator").default const traverse = require("@babel/traverse").default const code = ` const a = 1; const b = a * 2; const c = 2; const d = b + 1; const e = 3; console.log(d) ` const ast = parser.parse(code) const visitor = { VariableDeclarator(path){ const binding = path.scope.getBinding(path.node.id.name); // 如标识符被修改过,则不能进行删除动作。 if (!binding || binding.constantViolations.length > 0) { return; } // 未被引用 if (!binding.referenced) { path.remove(); } // 被引用次数为0 // if (binding.references === 0) { // path.remove(); // } // 长度为0,变量没有被引用过 // if (binding.referencePaths.length === 0) { // path.remove(); // } } } traverse(ast, visitor) const result = generate(ast) console.log(result.code) 处理后的代码(未使用的 b、c、e 变量已被删除): const a = 1; const b = a * 2; const d = b + 1; console.log(d); 删除冗余逻辑代码 有时候为了增加逆向难度,会有很多嵌套的 if-else 语句,大量判断为假的冗余逻辑代码,同样可以利用 AST 将其删除掉,只留下判断为真的,示例代码如下: const example = function () { let a; if (false) { a = 1; } else { if (1) { a = 2; } else { a = 3; } } return a; }; 观察 AST,判断条件对应的是 test 节点,if 对应的是 consequent 节点,else 对应的是 alternate 节点,如下图所示: AST 处理思路以及代码: 筛选出 BooleanLiteral 和 NumericLiteral 节点,取其对应的值,即 path.node.test.value; 判断 value 值为真,则将节点替换成 consequent 节点下的内容,即 path.node.consequent.body; 判断 value 值为假,则替换成 alternate 节点下的内容,即 path.node.alternate.body; 有的 if 语句可能没有写 else,也就没有 alternate,所以这种情况下判断 value 值为假,则直接移除该节点,即 path.remove() const parser = require("@babel/parser"); const generate = require("@babel/generator").default const traverse = require("@babel/traverse").default const types = require('@babel/types'); const code = ` const example = function () { let a; if (false) { a = 1; } else { if (1) { a = 2; } else { a = 3; } } return a; }; ` const ast = parser.parse(code) const visitor = { enter(path) { if (types.isBooleanLiteral(path.node.test) || types.isNumericLiteral(path.node.test)) { if (path.node.test.value) { path.replaceInline(path.node.consequent.body); } else { if (path.node.alternate) { path.replaceInline(path.node.alternate.body); } else { path.remove() } } } } } traverse(ast, visitor) const result = generate(ast) console.log(result.code) 处理结果: const example = function () { let a; a = 2; return a; }; switch-case 反控制流平坦化 控制流平坦化是混淆当中最常见的,通过 if-else 或者 while-switch-case 语句分解步骤,示例代码: const _0x34e16a = '3,4,0,5,1,2'['split'](','); let _0x2eff02 = 0x0; while (!![]) { switch (_0x34e16a[_0x2eff02++]) { case'0': let _0x38cb15 = _0x4588f1 + _0x470e97; continue; case'1': let _0x1e0e5e = _0x37b9f3[_0x50cee0(0x2e0, 0x2e8, 0x2e1, 0x2e4)]; continue; case'2': let _0x35d732 = [_0x388d4b(-0x134, -0x134, -0x139, -0x138)](_0x38cb15 >> _0x4588f1); continue; case'3': let _0x4588f1 = 0x1; continue; case'4': let _0x470e97 = 0x2; continue; case'5': let _0x37b9f3 = 0x5 || _0x38cb15; continue; } break; } AST 还原思路: 获取控制流原始数组,将 '3,4,0,5,1,2'['split'](',') 之类的语句转化成 ['3','4','0','5','1','2'] 之类的数组,得到该数组之后,也可以选择把 split 语句对应的节点删除掉,因为最终代码里这条语句就没用了; 遍历第一步得到的控制流数组,依次取出每个值所对应的 case 节点; 定义一个数组,储存每个 case 节点 consequent 数组里面的内容,并删除 continue 语句对应的节点; 遍历完成后,将第三步的数组替换掉整个 while 节点,也就是 WhileStatement。 不同思路,写法多样,对于如何获取控制流数组,可以有以下思路: 获取到 While 语句节点,然后使用 path.getAllPrevSiblings() 方法获取其前面的所有兄弟节点,遍历每个兄弟节点,找到与 switch() 里面数组的变量名相同的节点,然后再取节点的值进行后续处理; 直接取 switch() 里面数组的变量名,然后使用 scope.getBinding() 方法获取到它绑定的节点,然后再取这个节点的值进行后续处理。 所以 AST 处理代码就有两种写法,方法一:(code.js 即为前面的示例代码,为了方便操作,这里使用 fs 从文件中读取代码) const parser = require("@babel/parser"); const generate = require("@babel/generator").default const traverse = require("@babel/traverse").default const types = require("@babel/types") const fs = require("fs"); const code = fs.readFileSync("code.js", {encoding: "utf-8"}); const ast = parser.parse(code) const visitor = { WhileStatement(path) { // switch 节点 let switchNode = path.node.body.body[0]; // switch 语句内的控制流数组名,本例中是 _0x34e16a let arrayName = switchNode.discriminant.object.name; // 获得所有 while 前面的兄弟节点,本例中获取到的是声明两个变量的节点,即 const _0x34e16a 和 let _0x2eff02 let prevSiblings = path.getAllPrevSiblings(); // 定义缓存控制流数组 let array = [] // forEach 方法遍历所有节点 prevSiblings.forEach(pervNode => { let {id, init} = pervNode.node.declarations[0]; // 如果节点 id.name 与 switch 语句内的控制流数组名相同 if (arrayName === id.name) { // 获取节点整个表达式的参数、分割方法、分隔符 let object = init.callee.object.value; let property = init.callee.property.value; let argument = init.arguments[0].value; // 模拟执行 '3,4,0,5,1,2'['split'](',') 语句 array = object[property](argument) // 也可以直接取参数进行分割,方法不通用,比如分隔符换成 | 就不行了 // array = init.callee.object.value.split(','); } // 前面的兄弟节点就可以删除了 pervNode.remove(); }); // 储存正确顺序的控制流语句 let replace = []; // 遍历控制流数组,按正确顺序取 case 内容 array.forEach(index => { let consequent = switchNode.cases[index].consequent; // 如果最后一个节点是 continue 语句,则删除 ContinueStatement 节点 if (types.isContinueStatement(consequent[consequent.length - 1])) { consequent.pop(); } // concat 方法拼接多个数组,即正确顺序的 case 内容 replace = replace.concat(consequent); } ); // 替换整个 while 节点,两种方法都可以 path.replaceWithMultiple(replace); // path.replaceInline(replace); } } traverse(ast, visitor) const result = generate(ast) console.log(result.code) 方法二: const parser = require("@babel/parser"); const generate = require("@babel/generator").default const traverse = require("@babel/traverse").default const types = require("@babel/types") const fs = require("fs"); const code = fs.readFileSync("code.js", {encoding: "utf-8"}); const ast = parser.parse(code) const visitor = { WhileStatement(path) { // switch 节点 let switchNode = path.node.body.body[0]; // switch 语句内的控制流数组名,本例中是 _0x34e16a let arrayName = switchNode.discriminant.object.name; // 获取控制流数组绑定的节点 let bindingArray = path.scope.getBinding(arrayName); // 获取节点整个表达式的参数、分割方法、分隔符 let init = bindingArray.path.node.init; let object = init.callee.object.value; let property = init.callee.property.value; let argument = init.arguments[0].value; // 模拟执行 '3,4,0,5,1,2'['split'](',') 语句 let array = object[property](argument) // 也可以直接取参数进行分割,方法不通用,比如分隔符换成 | 就不行了 // let array = init.callee.object.value.split(','); // switch 语句内的控制流自增变量名,本例中是 _0x2eff02 let autoIncrementName = switchNode.discriminant.property.argument.name; // 获取控制流自增变量名绑定的节点 let bindingAutoIncrement = path.scope.getBinding(autoIncrementName); // 可选择的操作:删除控制流数组绑定的节点、自增变量名绑定的节点 bindingArray.path.remove(); bindingAutoIncrement.path.remove(); // 储存正确顺序的控制流语句 let replace = []; // 遍历控制流数组,按正确顺序取 case 内容 array.forEach(index => { let consequent = switchNode.cases[index].consequent; // 如果最后一个节点是 continue 语句,则删除 ContinueStatement 节点 if (types.isContinueStatement(consequent[consequent.length - 1])) { consequent.pop(); } // concat 方法拼接多个数组,即正确顺序的 case 内容 replace = replace.concat(consequent); } ); // 替换整个 while 节点,两种方法都可以 path.replaceWithMultiple(replace); // path.replaceInline(replace); } } traverse(ast, visitor) const result = generate(ast) console.log(result.code) 以上代码运行后,原来的 switch-case 控制流就被还原了,变成了按顺序一行一行的代码,更加简洁明了: let _0x4588f1 = 0x1; let _0x470e97 = 0x2; let _0x38cb15 = _0x4588f1 + _0x470e97; let _0x37b9f3 = 0x5 || _0x38cb15; let _0x1e0e5e = _0x37b9f3[_0x50cee0(0x2e0, 0x2e8, 0x2e1, 0x2e4)]; let _0x35d732 = [_0x388d4b(-0x134, -0x134, -0x139, -0x138)](_0x38cb15 >> _0x4588f1); 参考资料 本文有参考以下资料,也是比较推荐的在线学习资料: Youtube 视频,Babel 入门:https://www.youtube.com/watch?v=UeVq_U5obnE (作者 Nicolò Ribaudo,视频中的 PPT 资料可在 K 哥爬虫公众号后台回复 Babel 免费获取!) 官方手册 Babel Handbook:https://github.com/jamiebuilds/babel-handbook 非官方 Babel API 中文文档:https://evilrecluse.top/Babel-traverse-api-doc/ END Babel 编译器国内的资料其实不是很多,多看源码、同时在线对照可视化的 AST 语法树,耐心一点儿一层一层分析即可,本文中的案例也只是最基本操作,实际遇到一些混淆还得视情况进行修改,比如需要加一些类型判断来限制等,后续K哥会用实战来带领大家进一步熟悉解混淆当中的其他操作。

优秀的个人博客,低调大师

【技术干货】前端性能优化——快速定位代码bug

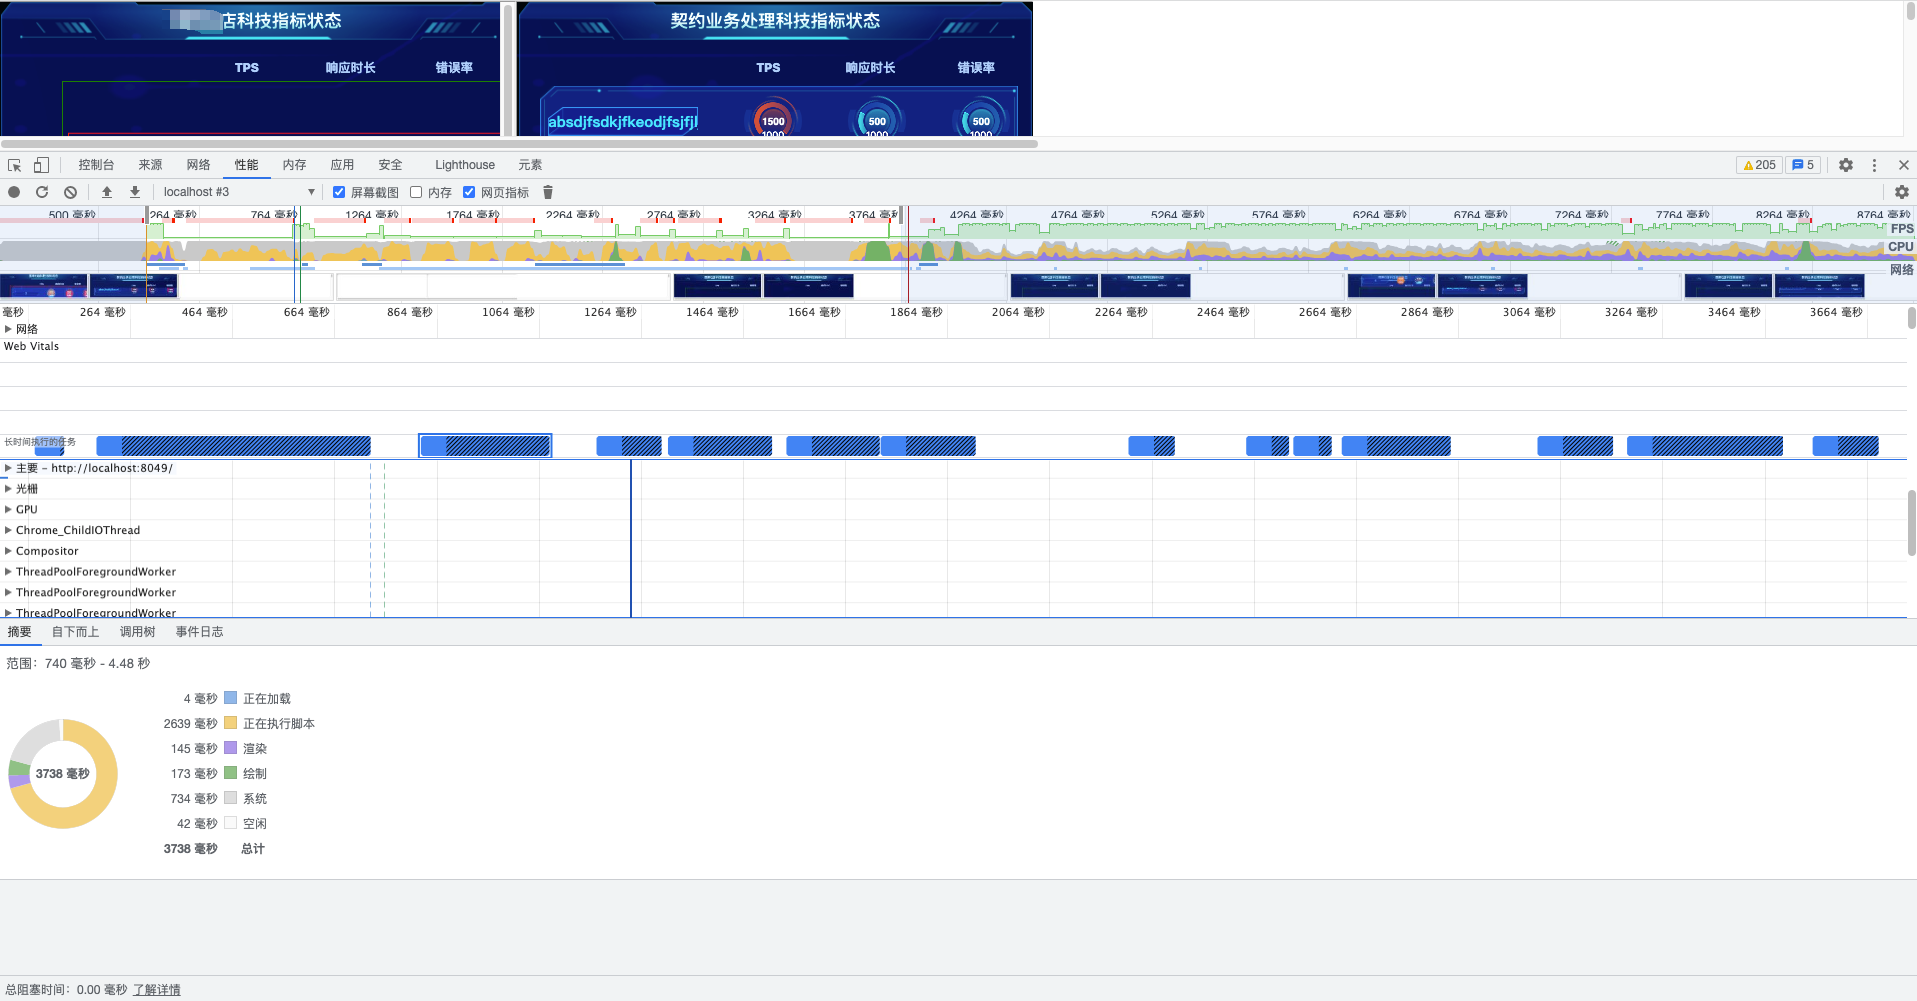
分享人:Mark Wu( 吴银波 )云智慧前端工程师,致力于云智慧大屏产品及ITSM、DOMM、DOEM等产品线定制化开发,拥有丰富的前端性能优化和开源项目经验。 背景介绍: 不知道你有没有碰到过这些情况: 被通知下周一前一定要解决某个bug,现在已经是周五下午了; 上线封版前一天被通知客户机器性能不行,打不开某个页面,当时已经是晚上10点了; 晚上2点接到电话,某个系统现在运行不起来,但是明天要给客户领导演示,然后你还没带电脑回家... 假如你也有这些情况,那么恭喜你,这只是开始... 假如没有,那么也恭喜你,你迟早会遇到的... 那么, 如果我们能够找到一些快速定位问题的方法,那大概率可以避免这样的问题,大幅提高效率。 结合具体的示例来分享一下我是如何利用Performance性能面板和console面板来定位问题的,末尾也和大家分享一个使用这个方法优化后造出的轮子。 一、Performance性能分析面板 现在看一下Performance性能分析报告: 可以看到时间轴下面包含FPS、CPU、网络等;这一块主要 关注FPS,观察有没有飘红的区域,可定位到下面的Main指标对应的js执行过程,观察程序哪部分影响了页面性能,这能帮助我们快速确定需要优化的代码位置; 还应关注总 阻塞时间,这是对当前页面运行是否流畅的一个总体评价,应尽可能减少阻塞时间; 最后关注 摘要部分,对比正在执行脚本与渲染时间,确定JS执行和页面渲染哪个为主要优化对象(优化往往是两者并行)。 下面两个示例分别侧重JS执行效率和页面渲染效率进行优化,JS执行效率主要降低代码空间复杂度,减少不必要的内存开销,避免深拷贝,及时清除定时器等;页面渲染效率主要减少页面重排次数,尽量同步页面动画与显示器帧数刷新。 二、JS执行性能优化示例 出现问题 DOMM定制化项目:现场某场景内G6拓扑组件节点数量一多,浏览器假死,开发环境无法重现。 分析:页面假死通常是js线程阻塞、栈内存溢出,或者是页面动画过于复杂导致css线程卡死、频繁布局抖动等造成的。 Performance分析: 从上图可以看到js执行时间比较长,渲染时间占用比较短。这种情况先排除css线程以及布局抖动的影响,确定问题是在JS执行上。并且在页面性能优化时针对这种情况想要再去较大地优化页面渲染效率是很难也是不划算的,这个时候的重点也是在JS执行效率上。 使用console打印各环节时间消耗,确定问题代码 通过对于Performance的Main进行分析并结合代码分析,确定问题代码区域,在代码执行主要节点上打印时间消耗,针对耗时较大的区域代码进行细化,最终确定问题代码。 计算耗时打印 耗时打印情况: 分析:可以看到这部分JS代码总执行时长1027ms,其中计算节点、计算连线耗时最长,而且重复执行了两次,设置防抖函数。 分析:设置防抖后,此段JS总执行时长599ms,继续细化“计算连线”部分耗时打印。 细化耗时打印: a、 “ 连线计算 ” 耗时过长 分析:“计算连线”段JS代码被多次引用,继续细化这部分耗时打印; b、单次连线耗时 分析:“连线耗时”为计算单次节点间连线耗时,大量执行且单次耗时不短,对此部分代码继续细化,发现存在可疑的代码--深拷贝。 c、深拷贝耗时 分析:“克隆耗时”的打印规律和“连线耗时”相当,且存在耗时较长问题,使用累加计时打印深拷贝总体耗时。 分析:深拷贝累加有三次打印,总耗时679ms,占比很大。 耗时定位:每次深拷贝耗时较长,深拷贝算法需要优化或者连线计算逻辑避开深拷贝 分析:拷贝层级过深,造成耗时较长,使用浅拷贝代替。 优化深拷贝耗时后打印 分析:使用浅拷贝打印总耗时6ms,相对于原来的679ms耗时很短。 动画渲染分析 现在不能确定现场部署就没有问题,再来看看拓扑节点数量对于JS执行以及页面渲染效率的影响。 i 加载200个节点前端渲染耗时 ii 加载1个节点前端渲染耗时 分析:可以看到200节点与单节点页面渲染耗时相差不大,主要是执行JS脚本多了25ms,因为现场最大会有800多个节点的情况,简单计算了下,发现耗时对比原先的1027ms仍有很大提升。 三、动画渲染性能优化示例 遇到问题:之前开发一张大屏,本地跑没有问题,但是联调测试发现右侧的滚动组件模块(有4个)中有一个模块没有东西,接口正常返回,字段也是正常的。最后发现是接口返回了190多条数据,前端全部渲染了这些组件,致使模块假死。 先看下现场效果图。左侧分别是地图、轮播图、饼图、轮播图,中间上面是两个拓扑链路图轮播,下面是4个echarts图表,右侧是4个滚动模块(图片不全)。现在除了要解决上述问题还得做好整张大屏的加载同步。 现场大屏的展示效果↓ 分析:现在来看这个问题,既然全部加载会导致模块假死,那就不加载全部,而是采用过一条渲染一条(onebyone)方式,现在演示单个效果: onebyone模式 单模块效果 注:绿框为可视区域,红框为滚动组件,渲染固定数量的滚动单位,利用css控制页面动画,定时刷新对应的滚动单位。 onebyone模式 单模块Performance分析面板 分析:单组件运行已产生JS线程阻塞,执行JS脚本、渲染耗时相当。 onebyone模式 4模块 Performance分析面板 分析:执行JS脚本、渲染耗时相当,产生较长JS线程阻塞,且页面会发生布局抖动、掉帧。 代码分析:由于每次一个滚动单位过场后会被替换,引发重排,然后每个模块如此,4个模块叠加,会一直连续引发页面重排,然后这里用的是js控制布局导致间距不一致。当时的改进方案是要减少重排次数以及替换布局方案,怎么减少重排次数? “一次计算整个过场面板,每次过场面板过场后才去更新整个面板,替换为flex布局。” 现在来看一下这个方案的效果: twomove模式单模块情况 twomove模式单模块Performance分析面板 分析:单组件运行未产生JS线程阻塞,单个模块同屏产生的dom数量比onebyone模式多,所以优势并不明显。 twomove模式4模块 Performance分析面板 分析:执行JS脚本、渲染耗时相当,JS线程阻塞时间减少,页面未出现布局抖动、掉帧,多模块下优势突出。 四、总结 通过Performance性能分析确定主要优化方向,针对JS执行可以结合Main指标使用console对问题代码进行定位,针对页面渲染应减少页面重排降低页面渲染消耗,重点优化阻塞时间、页面掉帧问题。 继续对这个组件成果进行优化,增加了endWithNum属性,控制一轮循环完成之后隔开的单位数量,并且修复了一些bug,包括页面不可视后raf停止,css继续运行造成的不同调问题,进行反复测试,确保稳定性,并新增了一些配置属性,做成了轮子react-rollfree。 最后:轮子分享 react-rollfree react-rollfree适用于各种滚动组件场景,包括文本、图片、动画等,支持大数据量动态更新,基本能够覆盖各种滚动动画场景,后面会增加弹幕模式,扩展更多应用场景。 下载方式:npm install react-rollfree 源码地址:https://github.com/Markuuuu/react-rollfree 具体配置: `* @animationDirection boolean --滚动方向,默认从下到上,从左到右` `* @animationTime number --过场时间 单位:S` `* [@children](https://my.oschina.net/children117cl) [<jsx>] --滚动组件,支持隐式传入` `* @childrenUpdateModel string --数据更新后更新列表,'now'立即更新,'later'跑完更新` `* @contextHeight number --单条轮播组件height` `* @contextWidth number --单条轮播组件width` `* @endWithNum number --结尾空置滚动单位数量` `* @height number --滚动外框height` `* @horizontal boolean --横纵向轮播`,默认横向 `* @pauseWithHover boolean --默认开启,鼠标hover组件滚动停止` `* @showBorder boolean --是否显示辅助设计边界` `* @width number --滚动外框width` 使用: `<RollFree` `animationTime={20}` `contextWidth={2036}` `contextHeight={2036}` `horizontal={false}` `width={2048}` `height={1583}` `>` `{滚动dom[]}` `</RollFree>` react-rollfree默认效果 1000个滚动模块效果图(实现黑客帝国特效) 写到最后: 更多智能运维方面资讯,请关注 云智慧AIOps社区 云智慧产品开源地址: Github: https://github.com/CloudWise-OpenSource Gitee: https://gitee.com/CloudWise

优秀的个人博客,低调大师

☕【Java技术指南】教你如何使用异步神器CompletableFuture

前提概要 在java8以前,我们使用java的多线程编程,一般是通过Runnable中的run方法来完成,这种方式,有个很明显的缺点,就是,没有返回值。这时候,大家可能会去尝试使用Callable中的call方法,然后用Future返回结果,如下: public static void main(String[] args) throws Exception { ExecutorService executor = Executors.newSingleThreadExecutor(); Future<String> stringFuture = executor.submit(new Callable<String>() { @Override public String call() throws Exception { Thread.sleep(2000); return "async thread"; } }); Thread.sleep(1000); System.out.println("main thread"); System.out.println(stringFuture.get()); } 通过观察控制台,我们发现先打印 main thread ,一秒后打印 async thread,似乎能满足我们的需求。但仔细想我们发现一个问题,当调用future的get()方法时,当前主线程是堵塞的,这好像并不是我们想看到的。 另一种获取返回结果的方式是先轮询,可以调用isDone,等完成再获取,但这也不能让我们满意. 很多个异步线程执行时间可能不一致,我的主线程业务不能一直等着,这时候我可能会想要只等最快的线程执行完或者最重要的那个任务执行完,亦或者我只等1秒钟,至于没返回结果的线程我就用默认值代替. 我两个异步任务之间执行独立,但是第二个依赖第一个的执行结果. java8的CompletableFuture,就在这混乱且不完美的多线程江湖中闪亮登场了.CompletableFuture让Future的功能和使用场景得到极大的完善和扩展,提供了函数式编程能力,使代码更加美观优雅,而且可以通过回调的方式计算处理结果,对异常处理也有了更好的处理手段. CompletableFuture源码中有四个静态方法用来执行异步任务: 创建任务 public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier){..} public static <U> CompletableFuture<U> supplyAsync(Supplier<U> supplier,Executor executor){..} public static CompletableFuture<Void> runAsync(Runnable runnable){..} public static CompletableFuture<Void> runAsync(Runnable runnable,Executor executor){..} 如果有多线程的基础知识,我们很容易看出,run开头的两个方法,用于执行没有返回值的任务,因为它的入参是Runnable对象。 而supply开头的方法显然是执行有返回值的任务了,至于方法的入参,如果没有传入Executor对象将会使用ForkJoinPool.commonPool() 作为它的线程池执行异步代码.在实际使用中,一般我们使用自己创建的线程池对象来作为参数传入使用,这样速度会快些. 执行异步任务的方式也很简单,只需要使用上述方法就可以了: CompletableFuture<String> future = CompletableFuture.supplyAsync(() -> { //....执行任务 return "hello"; }, executor) 接下来看一下获取执行结果的几个方法。 V get(); V get(long timeout,Timeout unit); T getNow(T defaultValue); T join(); 上面两个方法是Future中的实现方式,get()会堵塞当前的线程,这就造成了一个问题,如果执行线程迟迟没有返回数据,get()会一直等待下去,因此,第二个get()方法可以设置等待的时间. getNow()方法比较有意思,表示当有了返回结果时会返回结果,如果异步线程抛了异常会返回自己设置的默认值. 接下来以一些场景的实例来介绍一下CompletableFuture中其他一些常用的方法 thenAccept() public CompletionStage<Void> thenAccept(Consumer<? super T> action); public CompletionStage<Void> thenAcceptAsync(Consumer<? super T> action); public CompletionStage<Void> thenAcceptAsync(Consumer<? super T> action,Executor executor); 功能:当前任务正常完成以后执行,当前任务的执行结果可以作为下一任务的输入参数,无返回值. 场景:执行任务A,同时异步执行任务B,待任务B正常返回后,B的返回值执行任务C,任务C无返回值 CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> "任务A"); CompletableFuture<String> futureB = CompletableFuture.supplyAsync(() -> "任务B"); CompletableFuture<String> futureC = futureB.thenApply(b -> { System.out.println("执行任务C."); System.out.println("参数:" + b);//参数:任务B return "a"; }); thenRun(..) public CompletionStage<Void> thenRun(Runnable action); public CompletionStage<Void> thenRunAsync(Runnable action); public CompletionStage<Void> thenRunAsync(Runnable action,Executor executor); 功能:对不关心上一步的计算结果,执行下一个操作 场景:执行任务A,任务A执行完以后,执行任务B,任务B不接受任务A的返回值(不管A有没有返回值),也无返回值 CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> "任务A"); futureA.thenRun(() -> System.out.println("执行任务B")); thenApply(..) public <U> CompletableFuture<U> thenApply(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn) public <U> CompletableFuture<U> thenApplyAsync(Function<? super T,? extends U> fn, Executor executor) 功能:当前任务正常完成以后执行,当前任务的执行的结果会作为下一任务的输入参数,有返回值 场景:多个任务串联执行,下一个任务的执行依赖上一个任务的结果,每个任务都有输入和输出 异步执行任务A,当任务A完成时使用A的返回结果resultA作为入参进行任务B的处理,可实现任意多个任务的串联执行 CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> "hello"); CompletableFuture<String> futureB = futureA.thenApply(s->s + " world"); CompletableFuture<String> future3 = futureB.thenApply(String::toUpperCase); System.out.println(future3.join()); 上面的代码,我们当然可以先调用future.join()先得到任务A的返回值,然后再拿返回值做入参去执行任务B,而thenApply的存在就在于帮我简化了这一步,我们不必因为等待一个计算完成而一直阻塞着调用线程,而是告诉CompletableFuture你啥时候执行完就啥时候进行下一步. 就把多个任务串联起来了. thenCombine(..) thenAcceptBoth(..) runAfterBoth(..) public <U,V> CompletableFuture<V> thenCombine(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn) public <U,V> CompletableFuture<V> thenCombineAsync(CompletionStage<? extends U> other, BiFunction<? super T,? super U,? extends V> fn, Executor executor) 功能:结合两个CompletionStage的结果,进行转化后返回 场景:需要根据商品id查询商品的当前价格,分两步,查询商品的原始价格和折扣,这两个查询相互独立,当都查出来的时候用原始价格乘折扣,算出当前价格. 使用方法:thenCombine(..) CompletableFuture<Double> futurePrice = CompletableFuture.supplyAsync(() -> 100d); CompletableFuture<Double> futureDiscount = CompletableFuture.supplyAsync(() -> 0.8); CompletableFuture<Double> futureResult = futurePrice.thenCombine(futureDiscount, (price, discount) -> price * discount); System.out.println("最终价格为:" + futureResult.join()); //最终价格为:80.0 thenCombine(..)是结合两个任务的返回值进行转化后再返回,那如果不需要返回呢,那就需要 thenAcceptBoth(..),同理,如果连两个任务的返回值也不关心呢,那就需要runAfterBoth了,如果理解了上面三个方法,thenApply,thenAccept,thenRun,这里就不需要单独再提这两个方法了,只在这里提一下. thenCompose(..) public <U> CompletableFuture<U> thenCompose(Function<? super T,? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T,? extends CompletionStage<U>> fn) public <U> CompletableFuture<U> thenComposeAsync(Function<? super T,? extends CompletionStage<U>> fn, Executor executor) 功能:这个方法接收的输入是当前的CompletableFuture的计算值,返回结果将是一个新的CompletableFuture 这个方法和thenApply非常像,都是接受上一个任务的结果作为入参,执行自己的操作,然后返回.那具体有什么区别呢? thenApply():它的功能相当于将CompletableFuture<T>转换成CompletableFuture<U>,改变的是同一个CompletableFuture中的泛型类型 thenCompose():用来连接两个CompletableFuture,返回值是一个新的CompletableFuture CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> "hello"); CompletableFuture<String> futureB = futureA.thenCompose(s -> CompletableFuture.supplyAsync(() -> s + "world")); CompletableFuture<String> future3 = futureB.thenCompose(s -> CompletableFuture.supplyAsync(s::toUpperCase)); System.out.println(future3.join()); applyToEither(..) acceptEither(..) runAfterEither(..) public <U> CompletionStage<U> applyToEither(CompletionStage<? extends T> other,Function<? super T, U> fn); public <U> CompletionStage<U> applyToEitherAsync(CompletionStage<? extends T> other,Function<? super T, U> fn); public <U> CompletionStage<U> applyToEitherAsync(CompletionStage<? extends T> other,Function<? super T, U> fn,Executor executor); 功能:执行两个CompletionStage的结果,那个先执行完了,就是用哪个的返回值进行下一步操作 场景:假设查询商品a,有两种方式,A和B,但是A和B的执行速度不一样,我们希望哪个先返回就用那个的返回值. CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } return "通过方式A获取商品a"; }); CompletableFuture<String> futureB = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(2000); } catch (InterruptedException e) { e.printStackTrace(); } return "通过方式B获取商品a"; }); CompletableFuture<String> futureC = futureA.applyToEither(futureB, product -> "结果:" + product); System.out.println(futureC.join()); //结果:通过方式A获取商品a 同样的道理,applyToEither的兄弟方法还有acceptEither(),runAfterEither(),我想不需要我解释你也知道该怎么用了. exceptionally(..) public CompletionStage<T> exceptionally(Function<Throwable, ? extends T> fn); 功能:当运行出现异常时,调用该方法可进行一些补偿操作,如设置默认值. 场景:异步执行任务A获取结果,如果任务A执行过程中抛出异常,则使用默认值100返回. CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "futureA result:" + s) .exceptionally(e -> { System.out.println(e.getMessage()); //java.lang.ArithmeticException: / by zero return "futureA result: 100"; }); CompletableFuture<String> futureB = CompletableFuture. supplyAsync(() -> "执行结果:" + 50) .thenApply(s -> "futureB result:" + s) .exceptionally(e -> "futureB result: 100"); System.out.println(futureA.join());//futureA result: 100 System.out.println(futureB.join());//futureB result:执行结果:50 上面代码展示了正常流程和出现异常的情况,可以理解成catch,根据返回值可以体会下. whenComplete(..) public CompletionStage<T> whenComplete(BiConsumer<? super T, ? super Throwable> action); public CompletionStage<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action); public CompletionStage<T> whenCompleteAsync(BiConsumer<? super T, ? super Throwable> action,Executor executor); 功能:当CompletableFuture的计算结果完成,或者抛出异常的时候,都可以进入whenComplete方法执行,举个栗子 CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "apply result:" + s) .whenComplete((s, e) -> { if (s != null) { System.out.println(s);//未执行 } if (e == null) { System.out.println(s);//未执行 } else { System.out.println(e.getMessage());//java.lang.ArithmeticException: / by zero } }) .exceptionally(e -> { System.out.println("ex"+e.getMessage()); //ex:java.lang.ArithmeticException: / by zero return "futureA result: 100"; }); System.out.println(futureA.join());//futureA result: 100 根据控制台,我们可以看出执行流程是这样,supplyAsync->whenComplete->exceptionally,可以看出并没有进入thenApply执行,原因也显而易见,在supplyAsync中出现了异常,thenApply只有当正常返回时才会去执行.而whenComplete不管是否正常执行,还要注意一点,whenComplete是没有返回值的. 上面代码我们使用了函数式的编程风格并且先调用whenComplete再调用exceptionally,如果我们先调用exceptionally,再调用whenComplete会发生什么呢,我们看一下: 复制代码 CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "apply result:" + s) .exceptionally(e -> { System.out.println("ex:"+e.getMessage()); //ex:java.lang.ArithmeticException: / by zero return "futureA result: 100"; }) .whenComplete((s, e) -> { if (e == null) { System.out.println(s);//futureA result: 100 } else { System.out.println(e.getMessage());//未执行 } }) ; System.out.println(futureA.join());//futureA result: 100 代码先执行了exceptionally后执行whenComplete,可以发现,由于在exceptionally中对异常进行了处理,并返回了默认值,whenComplete中接收到的结果是一个正常的结果,被exceptionally美化过的结果,这一点需要留意一下. handle(..) public <U> CompletionStage<U> handle(BiFunction<? super T, Throwable, ? extends U> fn); public <U> CompletionStage<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn); public <U> CompletionStage<U> handleAsync(BiFunction<? super T, Throwable, ? extends U> fn,Executor executor); 功能:当CompletableFuture的计算结果完成,或者抛出异常的时候,可以通过handle方法对结果进行处理 CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "apply result:" + s) .exceptionally(e -> { System.out.println("ex:" + e.getMessage()); //java.lang.ArithmeticException: / by zero return "futureA result: 100"; }) .handle((s, e) -> { if (e == null) { System.out.println(s);//futureA result: 100 } else { System.out.println(e.getMessage());//未执行 } return "handle result:" + (s == null ? "500" : s); }); System.out.println(futureA.join());//handle result:futureA result: 100 通过控制台,我们可以看出,最后打印的是handle result:futureA result: 100,执行exceptionally后对异常进行了"美化",返回了默认值,那么handle得到的就是一个正常的返回,我们再试下,先调用handle再调用exceptionally的情况. CompletableFuture<String> futureA = CompletableFuture. supplyAsync(() -> "执行结果:" + (100 / 0)) .thenApply(s -> "apply result:" + s) .handle((s, e) -> { if (e == null) { System.out.println(s);//未执行 } else { System.out.println(e.getMessage());//java.lang.ArithmeticException: / by zero } return "handle result:" + (s == null ? "500" : s); }) .exceptionally(e -> { System.out.println("ex:" + e.getMessage()); //未执行 return "futureA result: 100"; }); System.out.println(futureA.join());//handle result:500 根据控制台输出,可以看到先执行handle,打印了异常信息,并对接过设置了默认值500,exceptionally并没有执行,因为它得到的是handle返回给它的值,由此我们大概推测handle和whenComplete的区别 都是对结果进行处理,handle有返回值,whenComplete没有返回值 由于1的存在,使得handle多了一个特性,可在handle里实现exceptionally的功能 allOf(..) anyOf(..) public static CompletableFuture<Void> allOf(CompletableFuture<?>... cfs) public static CompletableFuture<Object> anyOf(CompletableFuture<?>... cfs) allOf:当所有的CompletableFuture都执行完后执行计算 anyOf:最快的那个CompletableFuture执行完之后执行计算 场景二:查询一个商品详情,需要分别去查商品信息,卖家信息,库存信息,订单信息等,这些查询相互独立,在不同的服务上,假设每个查询都需要一到两秒钟,要求总体查询时间小于2秒. public static void main(String[] args) throws Exception { ExecutorService executorService = Executors.newFixedThreadPool(4); long start = System.currentTimeMillis(); CompletableFuture<String> futureA = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000 + RandomUtils.nextInt(1000)); } catch (InterruptedException e) { e.printStackTrace(); } return "商品详情"; },executorService); CompletableFuture<String> futureB = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000 + RandomUtils.nextInt(1000)); } catch (InterruptedException e) { e.printStackTrace(); } return "卖家信息"; },executorService); CompletableFuture<String> futureC = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000 + RandomUtils.nextInt(1000)); } catch (InterruptedException e) { e.printStackTrace(); } return "库存信息"; },executorService); CompletableFuture<String> futureD = CompletableFuture.supplyAsync(() -> { try { Thread.sleep(1000 + RandomUtils.nextInt(1000)); } catch (InterruptedException e) { e.printStackTrace(); } return "订单信息"; },executorService); CompletableFuture<Void> allFuture = CompletableFuture.allOf(futureA, futureB, futureC, futureD); allFuture.join(); System.out.println(futureA.join() + futureB.join() + futureC.join() + futureD.join()); System.out.println("总耗时:" + (System.currentTimeMillis() - start)); }

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册