首页 文章 精选 留言 我的

精选列表

搜索[审批流],共10003篇文章
优秀的个人博客,低调大师

Apache Flink 1.13.2 发布,处理框架

Apache Flink 1.13.2 现已发布,这是Apache Flink 1.13 系列的第二个错误修复版本,包括 127 个修复和小改进。 主要更新内容 ContinuousFileReaderOperator 不应在 close() 上关闭输出 HiveTableSourceITCase.testPartitionFilter 在 AZP 上失败 ParquetInputFormat 不应需要 Parquet 模式作为用户输入 应用程序模式在构建 PackagedProgram 时不设置配置 将所有 “Connection reset by peer” 异常包装为 RemoteTransportException 由于 ConcurrentModificationException,KafkaChangelogTableITCase.testKafkaCanalChangelogSource 失败 某些场景无法通过配置单元目录删除表 SequentialChannelStateReaderImpl 可能会回收缓冲区两次 在批处理模式下无法执行极长的 sql 在 flink-connector-kinesis 中升级 AWS SDK 以包含新区域 af-south-1 为 Python Table API 添加 TableResult.collect 的文档 支持模式注册表格式的 ssl 连接 实现 ParquetAvroInputFormat 记录状态访问的延迟跟踪指标 在对齐超时时保持通道阻塞 为 Kafka 新源添加文档 详情请查看更新公告。

优秀的个人博客,低调大师

Apache Flink 1.12.4 发布,处理框架

Apache Flink 1.12.4 现已发布,这是 Apache Flink 1.12 系列的bug 修复版本,包含 21 个修复和优化,因此官方强烈建议所有用户都升级到 1.12.4。 优化 在 DataStream API 文档中增加 10 分钟的阅读内容 为新的 Kafka 源添加端到端测试案例 在某些情况下,编译作业时遇到的异常的根本原因没有暴露给用户 重构 Python 依赖性管理文档 添加缺少的关于 PyFlink 的命令行选项的文档 过滤所有 jar 中的 maven 元数据 Bug 修复 无法通过使用 kinesis 消费者的 savepoint 停止流媒体工作 修复一些与 KafkaSource 相关的bug 修复取消通过定时器输出数据时,缓冲池被破坏的问题 如果嵌套函数的参数数不正确,会出现误导性的异常信息 修复 UnalignedCheckpointITCase 在 zure 上挂起的问题 写入已经释放的缓冲区可能会在工作故障转移/取消期间造成数据损坏 为 Async IO 添加 numRecordsOut 指标 使用 scala api 来改变 PatternStream 的 TimeCharacteristic 是无效的 修复 flink-python jars 中的 LGPL-2.1 文件 修复 Japicmp 在 1.12 分支上失效的问题 修复 KubernetesLeaderElectionAndRetrievalITCase 出现故障的问题 修复 JobMaster 不能被重启的问题 详情请查看更新公告。

优秀的个人博客,低调大师

Apache Flink 1.12.1 发布,处理框架

Apache Flink 1.12 系列的首个 bug 修复版本 1.12.1 已经发布。该版本包含 79 个修复和优化,因此官方强烈建议所有用户都升级到 1.12.1。 Maven 依赖 <dependency> <groupId>org.apache.flink</groupId> <artifactId>flink-java</artifactId> <version>1.12.1</version> </dependency> <dependency> <groupId>org.apache.flink</groupId> <artifactId>flink-streaming-java_2.11</artifactId> <version>1.12.1</version> </dependency> <dependency> <groupId>org.apache.flink</groupId> <artifactId>flink-clients_2.11</artifactId> <version>1.12.1</version> </dependency> 注意事项 Apache Flink 1.12.1 的 DockerHub 官方映像暂时丢失。作为替代,这些映像目前放在 Flink PMC 的托管仓库中。这也是目前 Native Kubernetes 部署的默认设置。 Flink PMC 将继续与 DockerHub 团队合作以提供官方映像。 由于项目空间限制,PyPI 上暂时缺少 Apache Flink 1.12.1 的源代码和 python 3.8 linux wheel 软件包。目前,有关增加空间限制的请求正在 PyPI 审核过程中。在这段时间内,用户可以根据需要手动构建软件包。 部分更新内容 Sub-task 添加有关 maxwell-json 格式的文档 重做命令行接口文档页面 重做PyFlink CLI 文档 Bug BlobClientTest.testGetFailsDuringStreamingForJobPermanentBlob 挂起 使用 Class.forName 时加载不同的驱动程序类时出现死锁 由于超时而无法初始化 logger:引发 LoggerInitializationException 修复 ignore-parse-errors 不适用于旧版 JSON 格式 ZooKeeper quorum 因缺少 log4j 库而无法开始 Improvement 日志开始/结束状态恢复 将 “Flink Architecture” 页面翻译成中文 默认情况下启用 log4j2 监视间隔 详情请查看更新公告。

优秀的个人博客,低调大师

Apache Carbondata接入Kafka实时数据

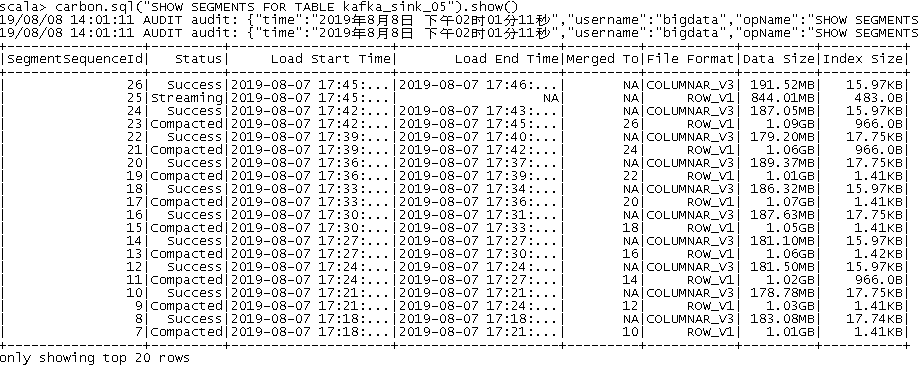
1.导入carbondata依赖的jar包 将apache-carbondata-1.5.3-bin-spark2.3.2-hadoop2.7.2.jar导入$SPARKHOME/jars;或将apache-carbondata-1.5.3-bin-spark2.3.2-hadoop2.7.2.jar导入在$SPARKHOME创建的carbondlib目录 2.导入kafka依赖的jar包 接入kafka数据需要依赖kafka的jars,将以下jars导入$SPARKHOME/jars kafka-clients-0.10.0.1.jarspark-sql-kafka-0-10_2.11-2.3.2.jar 3.spark-shell启动服务 ./bin/spark-shell --master spark://hostname:7077 --jars apache-carbondata-1.5.3-bin-spark2.3.2-hadoop2.7.2.jar a).导入依赖 import org.apache.spark.sql.SparkSession import org.apache.spark.sql.CarbonSession._ b).创建session 启动第一个目录是数据存储目录,第二个目录是元数据目录;都可以是hdfs目录 val carbon = SparkSession.builder().config(sc.getConf).getOrCreateCarbonSession("/home/bigdata/carbondata/data","/home/bigdata/carbondata/carbon.metastore") c).创建source表 carbon.sql( s""" | CREATE TABLE IF NOT EXISTS kafka_json_source( | id STRING, | name STRING, | age INT, | brithday TIMESTAMP) | STORED AS carbondata | TBLPROPERTIES( | 'streaming'='source', | 'format'='kafka', | 'kafka.bootstrap.servers'='hostname:9092', | 'subscribe'='kafka_json', | 'record_format'='json', | 'comment'='get kafka data') """.stripMargin).show() d).创建sink表 carbon.sql( s""" | CREATE TABLE IF NOT EXISTS kafka_json_sink( | id STRING, | name STRING, | age INT, | brithday TIMESTAMP) | STORED AS carbondata | TBLPROPERTIES( | 'streaming'='sink') """.stripMargin).show() e).创建job任务 carbon.sql( s""" | CREATE STREAM kafka_json_job ON TABLE kafka_json_sink( | STMPROPERTIES( | 'trigger'='ProcessingTime', | 'interval'='10 seconds') | AS SELECT * FROM kafka_json_source """.stripMargin).show() f).创建DATAMAP carbon.sql( s""" | CREATE DATAMAP agg_kafka_json_sink | ON TABLE kafka_json_sink( | USING "preaggregate" | AS | SELECT id,name,sum(age),max(age),min(age),avg(age) | FROM kafka_json_sink | GRPUP BY id,name """.stripMargin).show() 4.常用SQL命令 a).导入本地数据 carbon.sql("LOAD DATA INPATH '/home/bigdata/carbondata/sample.csv' INTO TABLE kafka_json_source").show() b).查看表结构 carbon.sql("DESC kafka_json_source").show() c).查看表数据 carbon.sql("SELECT * FROM kafka_json_source WHERE id=1").show() d).清理表数据 carbon.sql("TRUNCATE TABLE kafka_json_sink").show() e).删除表 carbon.sql("DROP TABLE IF EXISTS kafka_json_source").show() f).查看job任务状态 carbon.sql("SHOW STREAMS ON TABLE kafka_json_sink").show() g).删除job任务 carbon.sql("DROP STREAM kafka_json_job").show() h).查询DATAMAP表信息 carbon.sql("DESC agg_kafka_json_sink_kafka_json_sink").show() i).查询表Segments信息 carbon.sql("SHOW SEGMENTS FOR TABLE kafka_json_sink").show() j).条件查询 carbon.sql("SELECT * FROM kafka_json_sink WHERE agent_id=499 AND signature=''").show() k).聚合查询 carbon.sql("SELECT agent_id,signature,method_type,sum(elapse_time),max(elapse_time),min(elapse_time) FROM kafka_json_sink GROUP BY agent_id,signature,method_type").show() 5.注意事项 a).kafka使用配置 由于Carbondata的kafka-consumer反序列化配置如下,所以在kafka-producer应该使用对于配置,否则无法解析数据 key.deserializer = org.apache.kafka.common.serialization.ByteArrayDeserializer value.deserializer = org.apache.kafka.common.serialization.ByteArrayDeserializer

优秀的个人博客,低调大师

计算广告与处理技术综述

案例与解决方案汇总页:阿里云实时计算产品案例&解决方案汇总 1.计算广告背景 广告仍然是互联网公司的主要变现手段,其市场规模2017年已达3000亿元,据统计全球互联网市值前十的公司广告收入占比高达40%,可见其重要性。在这种情况下,与互联网广告相关的技术,我们称之为计算广告,也是最为成熟,市场规模最大的大数据应用领域。 互联网广告领域经过长期发展,分工逐渐精细化,除了各种代理商之外,还出现了ADN、SSP、ADX、DSP等各种平台,市场结构极为复杂,成为了一个巨大的生态。LUMA Partners针对北美市场绘制了一幅全景图,如下。 从经济学上看,上面复杂的市场结构可以认为是社会化大生产的产物,而广告的本质其实非常简单,无非是在合适的上下文中寻求受众与广告的匹配,追求媒体、用户和广告主的三方共赢。 2.计算广告技术架构 互联网广告从

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册