首页 文章 精选 留言 我的

精选列表

搜索[学习],共10005篇文章
优秀的个人博客,低调大师

ISIS学习笔记

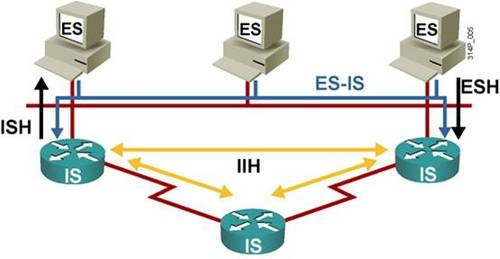
背景介绍 OSPF“表兄弟”,很另类,完全不同于OSI、TCP/IP协议栈,然而可以完全互相使用“双栈协议”。Intermediate system to intermediate system中间系统到中间系统 CLNS:ConnectionlessNetwork Service面向无连接的网络服务 IP ——àCLNS OSPF——àISIS ARP ——àESIS 链路状态路由协议,基于OSI七层模型设计 OSI参考模型确定了网络的标准,没有定义任何一个通信协议的细节但是提供了设计指导原则。 OSI网络层定义了两种服务:CONS与CLNS 基于CLNS的服务由以下网络层协议支持 – CLNP:无连接网络层协议 – ES-IS:终端系统-中间系统路由协议 – IS-IS :中间系统-中间系统路由协议 与OSPF拥有很多共同特性 – 维护一个链路状态数据库,使用SPF算法计算最短路径 – 使用Hello包形成和维护邻居关系 – 使用区域的概念来构建一个层次化的网络结构 – 支持手动汇总与VLSM – 在广播多路访问网络中都选举指定路由器 – 都具备认证功能 IS-IS基本术语 – IS:中间系统,相当于TCP/IP中的路由器 – ES:终端系统,相当于TCP/IP中的主机系统 – LSP:链路状态数据库报文 – NPDU:网络协议数据单元,ISO网络层报文,同IP包 – NSAP:网路服务接入点,即ISO中网络层地址 – (也称为CLNP地址) 地址格式 <8byte~20byte> DP:AFI、IDI DSP:High-order DSP、System-ID、NSEL Area:标识此IS端所在的区域 System:ID唯一标识次区域的IS 49.000x.0000.0000.000Y.00 AFI AreaID System-ID NSEI X->区域 Y->服务接口 基本原理 相同点 算法:SPF算法 特征:链路状态 无类:VLSM/CIDR 不相同 ①区域设计 OSPF:ABR链路两个区域 ISIS:没有明显的区域边界 ②分组类型 OSPF:非常多 ISIS:少,精简 ③路由器类型 OSPF 骨干路由器 常规路由器 ABR ISIS L1路由器 L2路由器 L1/2路由器 六种路由器是互相对应的 四种类型的路由 基本特征 属于网络层 链路状态协议 无类协议 最佳路径 AD:115àTCP/IP,115àOSI Metric:每跳,Metric为10 窄度量Narrow Metric接口2^6,总2^10 宽度量wide Metric接口2^24,总2^32 基本部署 接下去大都相同的,在开启clns路由,部署isis协议,在相应接口下部署isis 注意这个不同于osi模型,我们甚至查看不了路由 Ping的未知的地址回复也是不同的效果 然而仍然有表可查的 L1是常规区、L2骨干区 连通性测试 抓包之后发现不再是ICMP,这个也印证了ping不只是ICMP(其实TCP、ARP也可以~~) 修改区域类型 这里在L1,L1/2里面虽然都维护着R2的信息,但是对于R2来说根本没必要维护着R4的信息啊,所以就出现优化点。同理对于R4来说仅仅需要维护L2的信息即可 修改接口类型 我们知道R2是L1,R1、R3是L1/2,然而时不时R2会发送L2Hello包以维持R4的信息,所以需要相应的在接口下修改接口类型 结果 这里虽然没有路由信息竟然可以ping通!原因是什么?抓包可发现数据包的大小不同,但是在包里面却没有发现相应的路由信息啊。答案是,由于ISIS本身的算法,L1会寻找离它最近的L1/2(即默认路径)然后,通过该L1/2进行选路 修改度量值 双栈协议的体现 项目工程中很经常遇到的,集成ISIS,一般不会玩前面所说的纯ISIS。在这之前首先要给所有的路由器配上地址 结果 然而路由表、拓扑表中仍然没有信息 开始配置 根据拓扑,分别为其配置IP地址信息 不一一列举了,反正可以互相ping通就对了 提问 这两个命令意味着啥? ISIS路由分组 在R2与交换机之间进行抓包,可发现 从这个地方可以发现: 如果我们没有做优化,L1/2会向L1转发L2的hello事实上这些数据包对于R2来说是没有意义的,可以称之为垃圾包,这个就是需要进行链路优化的地方 Hello包发送非常密集,可以称之为”话痨“ Hello包 每3s发送一次,很消耗带宽,但可以很有效的报告当前的链路状态 CSNP包(DBD包) 每10s发送一次 PSNP 这个需要在串口状态下才能抓到,ISIS只认两种网络类型P2P、BMA ISIS DIS机制 vs OSPFDR机制 1、ISIS无备份机制 2、ISIS的DIS可抢占 3、ISIS默认优先级为64 4、ISIS的DIS hello间隔3.3s,Holdtime 10s R7R8一样的设置 LSP包 抓到这个包需要创建一个环回接口,然后才能抓到 虽然LSP是链路状态协议,但是完全可以说这个是EIGRP,因为几乎把所有的信息都公布出来了 ISIS路由算法 因为在OSPF的SPF算法的基础上多了PRC算法 ①算法优势:引入PRC,支持网络架构更大,网络更稳定; ②拓扑优势:区域设计不像OSPF有物理骨干区域的限制,ISIS的骨干区域相对比较灵活; ③分组优势:引入TLV 类型长度值的概念,可以更好的拓展新的特性和功能 ④迁移性:ISIS迁移到IPV4和IPV6,几乎无缝切换 路由汇总 汇总这个话题老生常谈~~ 汇总 需要在两个端口写,统一汇总信息,看效果 路由认证 跟EIGRP几乎没有区别 被动接口 跟前面的一样~~isis进程下使用passtive-interface 默认路由 ISIS路由泄露 根据ISIS的寻路算法,假如我们使用R2pingR7那么他们返回的路径是 因此需要相应的通过ACL人为的规定流量路径。哈?为啥要规定?不规定的话,路由拓扑就会被泄露啦 ISIS区域迁移 注意:由前面的配置经验可知,如果在相应进程下通告路由信息的话,原来的信息会被覆盖的,然而在ISIS里面却不会发生这样的情况 区域迁移的意义在于 OSPF与ISIS对比 共同之处 1 都是链路状态路由协议,都要求区域内的路由器交换链路状态信息,链路状态信息被收集到链路状态数据库中 2 都是用了一种实现路由选择信息交换相似机制 3 都在广播网络中选择指定路由器来控制扩散并降低这类介质中多对多邻接的系统资源需求 4 都是基于链路状态库中的信息,采用几乎相同的算法-SPF算法来计算最佳路由 5 都支持两个分层路由选择 6 都支持IP前缀的无类路由选择(支持VSLM) 7 都是共有协议 不同之处: ISIS OSPF 1 ISIS支持ISOCLNP和IP两种网络 仅支持IP网络 2 ISIS报文封装在数据链路层帧中 封装在IP包中 3 ISIS支持ISO无连接网络环境,注意数据链路是ISO协议(在以太网上数据链路类型为FEFE),在ISO协议栈中ISIS网络层协议ID是0x83 OSPF封装在IP报文当中,协议号89 4 ISIS路由器通告包含直连邻居及路由信息的TLV的LSP,使用LSP承载所有的路由选择信息 OSPF使用不同类型的LSA承载不同的路由信息,LSA被封装进LSU通告给邻居 5 ISIS数据包利用TLV字段承载所有易于扩散的信息 OSPF只有LSA可扩展,而LSA扩展性太差 6 ISIS可以忽略它所不支持的TLV 网络中的路由器为了进行适当的操作必须识别所有的LSA 7 ISIS数据包可以承载多个TLV,只有一个包头,节省带宽 1类,2类LSA可以承载多个IP前缀;3类,4类,5类LSA只能承载单个IP前缀,如果需要发送多个IP前缀信息,需要多个LSA 8 对于所有实际应用,ISIS仅支持广播和点对点链路。不支持NBMA链路。在NBMA环境下,可配置为p2p子接口或者广播链路(如果是全互联的连接方式)。 OSPF支持如下网络类型:p2p、广播、NMBA、点到多点和按需链路。 9 仅仅在广播链路实现3步邻接关系,IETF正在努力指定点到点链路的3步进程。 OSPF邻接关系的建立涉及到一个更加复杂的过程。 10 最初数据库同步在邻接关系建立后进行。 最初数据库同步在邻接关系形成前进行。 11 ISIS路由器只属于一个特定区域。 OSPF基于接口划分区域,路由器可属于不同的区域。 12 区域的边界在链路 区域的边界在路由器上。 13 默认情况下ISIS区域是stub区域,规定了level2到level1的路由泄漏 默认情况下,ospf区域不是stub,可以配置成为stub。 14 ISIS仅支持在点对点链路上可靠扩散,广播链路的扩散是不可靠的。然而通过DIS周期性的广播是可靠的。 OSPF确保所有链路上扩散的可靠性。 15 DIS无备份DIS,DIS可以被抢占,DIS以3被的频率发送HelloPDU 有BDR,DR不能被抢占,DR以正常的频率发送HelloPDU 16 默认情况下,ISIS的LSP最大生存时间为1200s刷新间隔为900s,而且定时器值可调。 OSPF的LSA的老化时间为3600s,刷新间隔为1800s,而且是固定值。 17 默认情况下,ISIS的接口cost值为10. 默认情况下,OSPF的保持时间(dead-interval)为40s,而且为了建立邻接关系,必须使双方的保持时间一致。 18 ISIS通过将HelloPDU的大小填充至接口MTU大小来检查双方MTU是否匹配。 OSPF通过在DBD报文中嵌入接口的MTU字段来检查MTU是否匹配。 19 由于ISIS区域中IP前缀是SPF数的叶子,故部分路由计算(PRC)较多,通常这就意味着在一个大的区域中路由处理器的负载较低。 部分SPF被限制用于域间和外部路由,任何要求较小的区域和分层拓扑扩展引起的域间链路动荡导致完全的SPF计算。 20 没有对IP组播路由选择的支持。 MOSPF扩展提供对IP组播路由选择的支持。

优秀的个人博客,低调大师

MapReduce 学习(一)

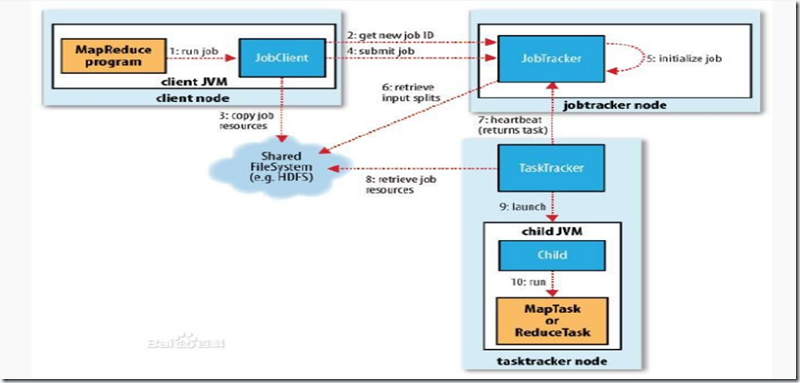
首先我们先来欣赏一下MapReduce的执行过程吧,如下图,自己看,不解释了。 Map 和 Reduce 的处理都是基于Key/Value来进行的,在Map中对文件的每一行进行处理,有两个输入参数,KeyInput,ValueInput,然后有两个输出,KeyOut,ValueOut,在Map执行之后有个Combiner,负责把多个Map传过来的Key相同的Value生成一个Iterable接口的集合,也可以自己指定一个Combiner,可以提高性能,要慎用,经过Combiner处理之后,就把处理过的内容传给Reduce,这是个一对一的过程,Reduce的输出也是KeyOut,ValueOut,最后是输出到文件,这里还有一个Partitiner,实现它可以把输出分别写到多个文件上,否则将会把所有reduce产生的文件输出到一个文件当中,好,我们来看一下下面这个图,大家就可以有一个更直观的感受了! 好啦,理论就讲到这里。

优秀的个人博客,低调大师

EmbossMaskFilter BlurMaskFilter 学习

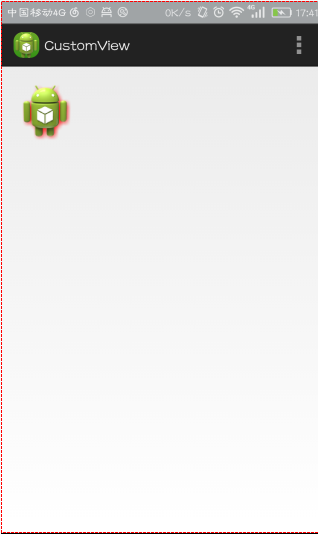
MaskFilter类可以为Paint分配边缘效果。对MaskFilter的扩展可以对一个Paint边缘的alpha通道应用转换。Android包含了下面几种MaskFilter: BlurMaskFilter 指定了一个模糊的样式和半径来处理Paint的边缘,让目标部分模糊不清。 EmbossMaskFilter 指定了光源的方向和环境光强度来添加浮雕效果,是让目标部分有凹凸的水印图案。 要应用一个MaskFilter,可以使用setMaskFilter方法,并传递给它一个MaskFilter对象 BlurMaskFilter.Blur 4个值: INNER:在目标内显示面具,从边缘向目标内到离边缘radius宽的地方显示,radius为初始化BlurMaskFilter的一个值 NORMAL:在目标内外显示面具,从边缘向目标内和目标外到离边缘radius宽的地方,向外显示面具时都会同时显示在目标边缘处获得的颜色。 OUTER:在目标外显示面具,从边缘向目标外到离边缘radius宽的地方,并且该部分会显示出从目标边缘获得的颜色,不显示目标 SOLID:在目标外显示面具,从边缘向目标外到离边缘radius宽的地方,并且该部分会显示出从目标边缘获得的颜色,显示目标 BlurMaskFilter: package com.soyoungboy.customview.widget; import android.annotation.TargetApi; import android.content.Context; import android.graphics.Bitmap; import android.graphics.BitmapFactory; import android.graphics.BlurMaskFilter; import android.graphics.Canvas; import android.graphics.Color; import android.graphics.Paint; import android.graphics.Rect; import android.os.Build; import android.util.AttributeSet; import android.view.View; import com.example.customview.R; @TargetApi(Build.VERSION_CODES.HONEYCOMB) public class BlurMaskFilterView extends View { private Paint mPaint; private Bitmap mBitmap; private Bitmap mAlphaBmp; public BlurMaskFilterView(Context context, AttributeSet attrs, int defStyleAttr) { super(context, attrs, defStyleAttr); init(); } public BlurMaskFilterView(Context context, AttributeSet attrs) { super(context, attrs); init(); } public BlurMaskFilterView(Context context) { super(context); init(); } /** * 进行初始化操作 */ private void init() { if (android.os.Build.VERSION.SDK_INT >= android.os.Build.VERSION_CODES.HONEYCOMB) { setLayerType(View.LAYER_TYPE_SOFTWARE, null); } mPaint = new Paint(); mBitmap = BitmapFactory.decodeResource(getResources(), R.drawable.ic_launcher); mAlphaBmp = mBitmap.extractAlpha(); } @Override protected void onDraw(Canvas canvas) { super.onDraw(canvas); // 宽度 int width = 200; // 高度 int height = width * mAlphaBmp.getHeight() / mAlphaBmp.getWidth(); // 绘制红色阴影,首先将画笔设置为红色 mPaint.setColor(Color.RED); // 就是添加内外发光效果 mPaint.setMaskFilter(new BlurMaskFilter(10, BlurMaskFilter.Blur.NORMAL)); // 绘制阴影在矩形框里面 左上角坐标 10,10,右下角坐标width,height canvas.drawBitmap(mAlphaBmp, null, new Rect(10, 10, width, height), mPaint); // 绘制原图像 mPaint.setMaskFilter(null); canvas.drawBitmap(mBitmap, null, new Rect(0, 0, width, height), mPaint); } } 效果图: mPaint.setMaskFilter(new BlurMaskFilter(10, BlurMaskFilter.Blur.INNER)); 效果图: mPaint.setMaskFilter(new BlurMaskFilter(10, BlurMaskFilter.Blur.OUTER)); 效果图: mPaint.setMaskFilter(new BlurMaskFilter(10, BlurMaskFilter.Blur.SOLID)); 使用EmbossMaskFilter 修改onDraw()里面方法: @Override protected void onDraw(Canvas canvas) { super.onDraw(canvas); // 宽度 int width = 200; // 高度 int height = width * mAlphaBmp.getHeight() / mAlphaBmp.getWidth(); //设置光源的方向 float[] direction = new float[] { 1, 1, -1 }; // 设置环境光亮度 float light = 1f; // 选择要应用的反射等级 float specular = 6; // 向mask应用一定级别的模糊 float blur = 3.5f; EmbossMaskFilter emboss = new EmbossMaskFilter(direction, light, specular, blur); mPaint.setMaskFilter(emboss); mPaint.setColor(Color.BLUE); // 绘制阴影在矩形框里面 左上角坐标 10,10,右下角坐标width,height canvas.drawBitmap(mAlphaBmp, null, new Rect(10, 10, width, height), mPaint); } 效果图:

优秀的个人博客,低调大师

Apache Drill学习

简介 Apache Drill is a low latency distributed query engine for large-scale datasets, including structured and semi-structured/nested data. 官网:http://drill.apache.org/ Apache Drill的用途:Drill是SQL查询引擎,可以构建在几乎所有的NoSQL数据库或文件系统(如:Hive, HDFS, mongo db, Amazon S3等)上,用来加速查询,比如,我们所熟知的Hive,用于在hdfs进行类SQL查询,但是利用Hive的速度比较慢,因此可以利用Drill一类的查询引擎加速查询,用于分布式大数据的实时查询等场景。 架构 drill 通过 Storage plugin interface 即插件的形式实现在不同的数据源上构建查询引擎。 安装,分为嵌入模式与分布模式。 这里介绍linux下嵌入模式的安装: 嵌入模式无需做相关配置,较简便,首先要安装JDK 7; 进入到待安装目录,打开shell; 下载安装包,运行以下命令中其中一条: wget http://getdrill.org/drill/download/apache-drill-1.1.0.tar.gz 或curl -o apache-drill-1.1.0.tar.gz http://getdrill.org/drill/download/apache-drill-1.1.0.tar.gz 下载文件到待安装目录后(或下载后移动至安装目录); 解压缩安装包,执行命令tar -xvzf <.tar.gz file name> 解压缩后,进入目录,此处解压过后的目录为apache-drill-1.1.0,执行命令 bin/drill,如图 此时可能会报错,显示内存不足,这里可以在子目录conf中修改drill-env.sh文件中的默认内存分配设置即可,默认是4G,对于一般家用机器,必然会报错。 即启动嵌入模式drill。 上图中最后一行表明drill已启动,可以开始执行查询,最后一行命令提示符的含义为,0表示连接数,jdbc表示连接类型,zk=local表示使用ZooKeeper本地节点。 退出命令 !quit drill web访问接口,在浏览器输入http://<IP address or host name>:8047 即可,访问效果如图: 以上我们安装好了drill工具,但是并未将其与我们的特定数据源关联,以下我们进行相关配置,使其可以对具体数据执行查询。 1. 内存配置,如上,修改,在drill-env.sh中修改参数 XX:MaxDirectMemorySize 即可。 2. 配置多用户设置 3. 配置用户权限与角色 4. 。。。待续 连接数据源 dril连接数据源,通过存储插件形式,这样增加了灵活性,对于不同的数据源,通过插件实现多数据源的兼容,drill可以连接数据库,文件,分布式文件系统,hive metastore等。 可以通过三种方式指定配置存储插件配置: (1) 通过查询中的FROM语句 (2) 在查询语句前使用USE命令 (3) 在启动drill时指定 Web配置方式 可以在http://<IP address>:8047/storage 查看和配置存储插件,存在以下选项, cp连接jar file dfs连接本地文件系统或任何分布式文件系统,如hadoop,amazon s3等 hbase连接Hbase hive连接hive metastore mongo连接MongoDB 点击进入update选项,可以配置数据格式等选项, 可以输入存储插件名字创建新的存储插件,如图 dfs插件配置示例,如图 drill插件可配置属性介绍 Attribute Example Values Required Description "type" "file" "hbase" "hive" "mongo" yes A valid storage plugin type name. "enabled" true false yes State of the storage plugin. "connection" "classpath:///" "file:///" "mongodb://localhost:27017/" "hdfs://" implementation-dependent The type of distributed file system, such as HDFS, Amazon S3, or files in your file system, and an address/path name. "workspaces" null "logs" no One or more unique workspace names. If a workspace name is used more than once, only the last definition is effective. "workspaces". . . "location" "location": "/Users/johndoe/mydata" "location": "/tmp" no Full path to a directory on the file system. "workspaces". . . "writable" true false no One or more unique workspace names. If defined more than once, the last workspace name overrides the others. "workspaces". . . "defaultInputFormat" null "parquet" "csv" "json" no Format for reading data, regardless of extension. Default = "parquet" "formats" "psv" "csv" "tsv" "parquet" "json" "avro" "maprdb" * yes One or more valid file formats for reading. Drill implicitly detects formats of some files based on extension or bits of data in the file; others require configuration. "formats" . . . "type" "text" "parquet" "json" "maprdb" * yes Format type. You can define two formats, csv and psv, as type "Text", but having different delimiters. formats . . . "extensions" ["csv"] format-dependent File name extensions that Drill can read. "formats" . . . "delimiter" "\t" "," format-dependent Sequence of one or more characters that serve as a record separator in a delimited text file, such as CSV. Use a 4-digit hex code syntax \uXXXX for a non-printable delimiter. "formats" . . . "quote" """ no A single character that starts/ends a value in a delimited text file. "formats" . . . "escape" "`" no A single character that escapes a quotation mark inside a value. "formats" . . . "comment" "#" no The line decoration that starts a comment line in the delimited text file. "formats" . . . "skipFirstLine" true no To include or omit the header when reading a delimited text file. Set to true to avoid reading headers as data. 也可以通过Drill Rest API进行插件配置,使用POST方式传递名字和配置两个属性,例如 curl -X POST -/json" -d '{"name":"myplugin", "config": {"type": "file", "enabled": false, "connection": "file:///", "workspaces": { "root": { "location": "/", "writable": false, "defaultInputFormat": null}}, "formats": null}}' https://localhost:8047/storage/myplugin.json 上面命令创建一个名为myplugin的插件,用于查询本地文件系统根目录的未知文件类型。 介绍连接hive的配置,首先确保hive metastore服务启动,hive.metastore.uris:hive --service metastore 进入Drill Web接口,进入Store选项卡,http://<IP address>:8047/storage 点击hive旁的update选项,进行配置,如图 进入配置界面,在默认内容上添加如下,

优秀的个人博客,低调大师

storm组件学习

场景 伴随着信息科技日新月异的发展,信息呈现出爆发式的膨胀,人们获取信息的途径也更加多样、更加便捷,同时对于信息的时效性要求也越来越高。举个搜索场景中的例子,当一个卖家发布了一条宝贝信息时,他希望的当然是这个宝贝马上就可以被卖家搜索出来、点击、购买啦,相反,如果这个宝贝要等到第二天或者更久才可以被搜出来,估计这个大哥就要骂娘了。再举一个推荐的例子,如果用户昨天在淘宝上买了一双袜子,今天想买一副泳镜去游泳,但是却发现系统在不遗余力地给他推荐袜子、鞋子,根本对他今天寻找泳镜的行为视而不见,估计这哥们心里就会想推荐你妹呀。其实稍微了解点背景知识的码农们都知道,这是因为后台系统做的是每天一次的全量处理,而且大多是在夜深人静之时做的,那么你今天白天做的事情当然要明天才能反映出来啦。 实现一个实时计算系统 全量数据处理使用的大多是鼎鼎大名的hadoop或者hive,作为一个批处理系统,hadoop以其吞吐量大、自动容错等优点,在海量数据处理上得到了广泛的使用。但是,hadoop不擅长实时计算,因为它天然就是为批处理而生的,这也是业界一致的共识。否则最近这两年也不会有s4,storm,puma这些实时计算系统如雨后春笋般冒出来啦。先抛开s4,storm,puma这些系统不谈,我们首先来看一下,如果让我们自己设计一个实时计算系统,我们要解决哪些问题。 低延迟。都说了是实时计算系统了,延迟是一定要低的。 高性能。性能不高就是浪费机器,浪费机器是要受批评的哦。 分布式。系统都是为应用场景而生的,如果你的应用场景、你的数据和计算单机就能搞定,那么不用考虑这些复杂的问题了。我们所说的是单机搞不定的情况。 可扩展。伴随着业务的发展,我们的数据量、计算量可能会越来越大,所以希望这个系统是可扩展的。 容错。这是分布式系统中通用问题。一个节点挂了不能影响我的应用。 好,如果仅仅需要解决这5个问题,可能会有无数种方案,而且各有千秋,随便举一种方案,使用消息队列+分布在各个机器上的工作进程就ok啦。我们再继续往下看。 容易在上面开发应用程序。亲,你设计的系统需要应用程序开发人员考虑各个处理组件的分布、消息的传递吗?如果是,那有点麻烦啊,开发人员可能会用不好,也不会想去用。 消息不丢失。用户发布的一个宝贝消息不能在实时处理的时候给丢了,对吧?更严格一点,如果是一个精确数据统计的应用,那么它处理的消息要不多不少才行。这个要求有点高哦。 消息严格有序。有些消息之间是有强相关性的,比如同一个宝贝的更新和删除操作消息,如果处理时搞乱顺序完全是不一样的效果了。 不知道大家对这些问题是否都有了自己的答案,下面让我们带着这些问题,一起来看一看storm的解决方案吧。 Storm是什么 如果只用一句话来描述storm的话,可能会是这样:分布式实时计算系统。按照storm作者的说法,storm对于实时计算的意义类似于hadoop对于批处理的意义。我们都知道,根据google mapreduce来实现的hadoop为我们提供了map, reduce原语,使我们的批处理程序变得非常地简单和优美。同样,storm也为实时计算提供了一些简单优美的原语。我们会在第三节中详细介绍。 我们来看一下storm的适用场景。 流数据处理。Storm可以用来处理源源不断流进来的消息,处理之后将结果写入到某个存储中去。 分布式rpc。由于storm的处理组件是分布式的,而且处理延迟极低,所以可以作为一个通用的分布式rpc框架来使用。当然,其实我们的搜索引擎本身也是一个分布式rpc系统。 说了半天,好像都是很玄乎的东西,下面我们开始具体讲解storm的基本概念和它内部的一些实现原理吧。 Storm的基本概念 首先我们通过一个 storm 和hadoop的对比来了解storm中的基本概念。 Hadoop Storm 系统角色 JobTracker Nimbus TaskTracker Supervisor Child Worker 应用名称 Job Topology 组件接口 Mapper/Reducer Spout/Bolt 表3-1 接下来我们再来具体看一下这些概念。 Nimbus:负责资源分配和任务调度。 Supervisor:负责接受nimbus分配的任务,启动和停止属于自己管理的worker进程。 Worker:运行具体处理组件逻辑的进程。 Task:worker中每一个spout/bolt的线程称为一个task. 在storm0.8之后,task不再与物理线程对应,同一个spout/bolt的task可能会共享一个物理线程,该线程称为executor。 下面这个图描述了以上几个角色之间的关系。 图3-1 Topology:storm中运行的一个实时应用程序,因为各个组件间的消息流动形成逻辑上的一个拓扑结构。 Spout:在一个topology中产生源数据流的组件。通常情况下spout会从外部数据源中读取数据,然后转换为topology内部的源数据。Spout是一个主动的角色,其接口中有个nextTuple()函数,storm框架会不停地调用此函数,用户只要在其中生成源数据即可。 Bolt:在一个topology中接受数据然后执行处理的组件。Bolt可以执行过滤、函数操作、合并、写数据库等任何操作。Bolt是一个被动的角色,其接口中有个execute(Tuple input)函数,在接受到消息后会调用此函数,用户可以在其中执行自己想要的操作。 Tuple:一次消息传递的基本单元。本来应该是一个key-value的map,但是由于各个组件间传递的tuple的字段名称已经事先定义好,所以tuple中只要按序填入各个value就行了,所以就是一个value list. Stream:源源不断传递的tuple就组成了stream。 10. stream grouping:即消息的partition方法。Storm中提供若干种实用的grouping方式,包括shuffle, fields hash, all, global, none, direct和localOrShuffle等 相比于s4, puma等其他实时计算系统,storm最大的亮点在于其记录级容错和能够保证消息精确处理的事务功能。下面就重点来看一下这两个亮点的实现原理。 Storm记录级容错的基本原理 首先来看一下什么叫做记录级容错?storm允许用户在spout中发射一个新的源tuple时为其指定一个message id, 这个message id可以是任意的object对象。多个源tuple可以共用一个message id,表示这多个源 tuple对用户来说是同一个消息单元。storm中记录级容错的意思是说,storm会告知用户每一个消息单元是否在指定时间内被完全处理了。那什么叫做完全处理呢,就是该message id绑定的源tuple及由该源tuple后续生成的tuple经过了topology中每一个应该到达的bolt的处理。举个例子。在图4-1中,在spout由message 1绑定的tuple1和tuple2经过了bolt1和bolt2的处理生成两个新的tuple,并最终都流向了bolt3。当这个过程完成处理完时,称message 1被完全处理了。 图4-1 在storm的topology中有一个系统级组件,叫做acker。这个acker的任务就是追踪从spout中流出来的每一个message id绑定的若干tuple的处理路径,如果在用户设置的最大超时时间内这些tuple没有被完全处理,那么acker就会告知spout该消息处理失败了,相反则会告知spout该消息处理成功了。在刚才的描述中,我们提到了”记录tuple的处理路径”,如果曾经尝试过这么做的同学可以仔细地思考一下这件事的复杂程度。但是storm中却是使用了一种非常巧妙的方法做到了。在说明这个方法之前,我们来复习一个数学定理。 A xor A = 0. A xor B…xor B xor A = 0,其中每一个操作数出现且仅出现两次。 storm中使用的巧妙方法就是基于这个定理。具体过程是这样的:在spout中系统会为用户指定的message id生成一个对应的64位整数,作为一个root id。root id会传递给acker及后续的bolt作为该消息单元的唯一标识。同时无论是spout还是bolt每次新生成一个tuple的时候,都会赋予该tuple一个64位的整数的id。Spout发射完某个message id对应的源tuple之后,会告知acker自己发射的root id及生成的那些源tuple的id。而bolt呢,每次接受到一个输入tuple处理完之后,也会告知acker自己处理的输入tuple的id及新生成的那些tuple的id。Acker只需要对这些id做一个简单的异或运算,就能判断出该root id对应的消息单元是否处理完成了。下面通过一个图示来说明这个过程。 图4-1 spout中绑定message 1生成了两个源tuple,id分别是0010和1011. 图4-2 bolt1处理tuple 0010时生成了一个新的tuple,id为0110. 图4-3 bolt2处理tuple 1011时生成了一个新的tuple,id为0111. 图4-4 bolt3中接收到tuple 0110和tuple 0111,没有生成新的tuple. 可能有些细心的同学会发现,容错过程存在一个可能出错的地方,那就是,如果生成的tuple id并不是完全各异的,acker可能会在消息单元完全处理完成之前就错误的计算为0。这个错误在理论上的确是存在的,但是在实际中其概率是极低极低的,完全可以忽略。 Storm的事务拓扑 事务拓扑(transactional topology)是storm0.7引入的特性,在最近发布的0.8版本中已经被封装为Trident,提供了更加便利和直观的接口。因为篇幅所限,在此对事务拓扑做一个简单的介绍。 事务拓扑的目的是为了满足对消息处理有着极其严格要求的场景,例如实时计算某个用户的成交笔数,要求结果完全精确,不能多也不能少。Storm的事务拓扑是完全基于它底层的spout/bolt/acker原语实现的,通过一层巧妙的封装得出一个优雅的实现。个人觉得这也是storm最大的魅力之一。 事务拓扑简单来说就是将消息分为一个个的批(batch),同一批内的消息以及批与批之间的消息可以并行处理,另一方面,用户可以设置某些bolt为committer,storm可以保证committer的finishBatch()操作是按严格不降序的顺序执行的。用户可以利用这个特性通过简单的编程技巧实现消息处理的精确。 Storm在淘宝 由于storm的内核是clojure编写的(不过大部分的拓展工作都是java编写的),为我们理解它的实现带来了一定的困难,好在大部分情况下storm都比较稳定,当然我们也在尽力熟悉clojure的世界。我们在使用storm时通常都是选择java语言开发应用程序。 在淘宝,storm被广泛用来进行实时日志处理,出现在实时统计、实时风控、实时推荐等场景中。一般来说,我们从类kafka的metaQ或者基于hbase的timetunnel中读取实时日志消息,经过一系列处理,最终将处理结果写入到一个分布式存储中,提供给应用程序访问。我们每天的实时消息量从几百万到几十亿不等,数据总量达到TB级。对于我们来说,storm往往会配合分布式存储服务一起使用。在我们正在进行的个性化搜索实时分析项目中,就使用了timetunnel + hbase + storm + ups的架构,每天处理几十亿的用户日志信息,从用户行为发生到完成分析延迟在秒级。 Storm的未来 Storm0.7系列的版本已经在各大公司得到了广泛使用,最近发布的0.8版本中引入了State,使得其从一个纯计算框架演变成了一个包含存储和计算的实时计算新利器,还有刚才提到的Trident,提供更加友好的接口,同时可定制scheduler的特性也为其针对不同的应用场景做优化提供了更便利的手段,也有人已经在基于storm的实时ql(query language)上迈出了脚本。在服务化方面,storm一直在朝着融入mesos框架的方向努力。同时,storm也在实现细节上不断地优化,使用很多优秀的开源产品,包括kryo, Disruptor, curator等等。可以想象,当storm发展到1.0版本时,一定是一款无比杰出的产品,让我们拭目以待,当然,最好还是参与到其中去吧,同学们。 参考文献 [1]storm官方wiki及code.https://github.com/nathanmarz/storm

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册