首页 文章 精选 留言 我的

精选列表

搜索[基础搭建],共10000篇文章
优秀的个人博客,低调大师

centos下利用LAMP免费搭建WordPress博客

WordPress是使用PHP语言开发的博客平台,用户可以在支持PHP和MySQL数据库的服务器上架设属于自己的网站。也可以把 WordPress当作一个内容管理系统(CMS)来使用。 WordPress是一款个人博客系统,并逐步演化成一款内容管理系统软件,它是使用PHP语言和MySQL数据库开发的。用户可以在支持 PHP 和 MySQL数据库的服务器上使用自己的博客。 环境说明: 在同一台主机上实现LAMP(Linux + Apache + MariaDB + PHP) CentOS 7.3、Apache 2.4.6、MariaDB 5.5.52、PHP 5.4.16 1 安装LAMP 采用yum方式进行安装httpd、MariaDB、php、php-mysql,php-mysql用来进行php和MariaDB数据库的连接。 [root@CentOS7 ~]# yum install httpd mariadb-server php php-mysql -y 2 创建新的虚拟主机 (1)新增虚拟主机配置文件 [root@CentOS7 ~]# vim /etc/httpd/conf.d/vhost.conf DocumentRoot "/var/www/wordpress" ServerName www.mywordpress.com <Directory "/var/www/wordpress"> AllowOverride None Require all granted (2)创建所需目录 [root@CentOS7 ~]# mkdir /var/www/wordpress 3 在虚拟主机主目录/var/www/wordpress下新建index.php文件 [root@CentOS7 ~]# vim /var/www/wordpress/index.php <!--?php phpinfo(); ?--> 4 检查语法并启动httpd服务 (1)检查语法 [root@CentOS7 ~]# httpd -t Syntax OK (2)启动httpd服务 [root@CentOS7 ~]# systemctl start httpd.service 5 测试 在浏览器中输入www.mywordpress.com 可以看到PHP默认页面已经成功显示,说明测试成功 6 下载wordpress压缩包,wordpress-4.7.4-zh_CN.tar.gz (1)解压缩 [root@CentOS7 ~]# tar -xf wordpress-4.7.4-zh_CN.tar.gz (2)把解压缩后得到的文件(wordpress)复制到DocumentRoot(/var/www/wordpress/)下 [root@CentOS7 ~]# cp -a wordpress /var/www/wordpress/ 7 启动MariaDB服务 [root@CentOS7 ~]# systemctl start mariadb 8 通过浏览器访问wordpress 在浏览器中输入http://www.mywordpress.com/wordpress 注意:配置DNS服务器解析www.test.com 为192.168.29.100 或者 修改windows 下的C:\Windows\Systeme32\drivers\etc\hosts文件 192.168.29.100 www.test.com 可以看到已经出了wordpress 页面,可以点击“现在就开始”就行配置,也可以手动修改配置文件 9 修改wordpress配置文件 (1)进入WordPress目录(/var/www/wordpress/wordpress/) [root@CentOS7 ~]# cd /var/www/wordpress/wordpress/ (2)复制cp wp-config-sample.php模板文件为 wp-config.php,然后编辑 [root@CentOS7 ~]# vim /var/www/wordpress/wordpress/wp-config.php // ** MySQL 设置 - 具体信息来自您正在使用的主机 ** // /** WordPress数据库的名称 */ define('DB_NAME', 'wordpress'); /** MySQL数据库用户名 */ define('DB_USER', 'test1'); /** MySQL数据库密码 */ define('DB_PASSWORD', '123456'); /** MySQL主机 */ define('DB_HOST', 'localhost'); 10 在数据库中创建数据库和用户 (1)创建数据库 MariaDB [(none)]> create database wordpress; Query OK, 1 row affected (0.00 sec) (2)创建用户 MariaDB [(none)]> create user 'test1'@'localhost' identified by '123456'; Query OK, 0 rows affected (0.00 sec) (3)给用户授权 MariaDB [(none)]> grant all on wordpress.* to 'test1'@'localhost'; Query OK, 0 rows affected (0.01 sec) 11 再次访问WordPress http://www.mywordpress.com/wordpress 填入相关信息,就可以正常访问博客了。

优秀的个人博客,低调大师

centos 7 minal 搭建ffmpeg+segmenter环境

在centos上安装软件 最方便的方式就是使用yum , 自动解决依赖关系, 没有那么麻烦! 需要手动添加yum源配置/etc/yum.repos.d/dag.repo: [dag] name=Dag RPM Repository forRed HatEnterprise Linux baseurl=http://apt.sw.be/RedHat/el$releasever/en/$basearch/dag gpgcheck=0 enabled=1 yum -y install ffmpeg 我这里使用源码编译安装, 需要耐心和细心点才能完成。 1.安装autoconf cd /App/src wget http://ftp.gnu.org/gnu/autoconf/autoconf-2.69.tar.xz tar xvf autoconf-2.69.tar.xz cd autoconf-2.69 ./configure make make install 2. 安装automake cd /App/src wget http://ftp.gnu.org/gnu/automake/automake-1.15.tar.xz tar xvf automake-1.15.tar.xz cd automake-1.15 ./configure make make install 3. 安装libtool(FAAC需要) cd /App/src wget http://ftp.gnu.org/gnu/libtool/libtool-2.4.6.tar.xz tar xvf libtool-2.4.6.tar.xz cd libtool-2.4.6 ./configure make make install 4. 安装yasm支持汇编优化(FFmpeg需要) cd /App/src wget http://www.tortall.net/projects/yasm/releases/yasm-1.3.0.tar.gz tar xvf yasm-1.3.0.tar.gz cd yasm-1.3.0 ./configure make make install 5. 添加动态链接库配置 echo '/usr/local/lib' >> /etc/ld.so.conf.d/local.conf 6. 安装MP3支持库LAME cd /App/src wgethttp://jaist.dl.sourceforge.net/project/lame/lame/3.99/lame-3.99.5.tar.gz tar xvf lame-3.99.5.tar.gz cd lame-3.99.5 ./configure make make install 7. 安装AAC支持库FAAC make时报错:mpeg4ip.h:126: 错误:对‘char* strcasestr(const char*, const char*)’的新声明 需要修改common/mp4v2/mpeg4ip.h第123行至129行内容: #ifdef __cplusplus extern "C" { #endif char *strcasestr(const char *haystack, const char *needle); #ifdef __cplusplus } #endif 修改为: 1 2 3 4 5 6 7 #ifdef __cplusplus extern "C++" { #endif const char *strcasestr(const char *haystack, const char *needle); #ifdef __cplusplus } #endif cd /App/src wgethttp://jaist.dl.sourceforge.net/project/faac/faac-src/faac-1.28/faac-1.28.tar.bz2 tar xvf faac-1.28.tar.bz2 cd faac-1.28 ./bootstrap ./configure --with-mp4v2 #按前文修改mpeg4ip.h内容 make make install 8. 安装AMR支持库opencore-amr cd /App/src wgethttp://jaist.dl.sourceforge.net/project/opencore-amr/opencore-amr/opencore-amr-0.1.3.tar.gz tar xvf opencore-amr-0.1.3.tar.gz cd opencore-amr-0.1.3 ./configure make make install 9. 安装通用音乐音频编码格式支持库libvorbis # libvorbis需要libogg,先安装libogg库 cd /App/src wgethttp://downloads.xiph.org/releases/ogg/libogg-1.3.2.tar.xz tar xvf libogg-1.3.2.tar.xz cd libogg-1.3.2 ./configure make make install cd /App/src wgethttp://downloads.xiph.org/releases/vorbis/libvorbis-1.3.5.tar.xz tar xvf libvorbis-1.3.5.tar.xz cd libvorbis-1.3.5 ./configure make make install 10. 安装x264库支持H.264视频转码 cd /App/src git clone git://git.videolan.org/x264.git cd x264 ./configure --enable-shared make make install 11. 安装Xvid库支持MPEG-4转码 cd /App/src wgethttp://downloads.xvid.org/downloads/xvidcore-1.3.3.tar.bz2 tar xvf xvidcore-1.3.3.tar.bz2 cd xvidcore/build/generic ./configure make make install 12. 安装Theora视频压缩支持库 cd /App/src wgethttp://downloads.xiph.org/releases/theora/libtheora-1.1.1.tar.xz tar xvf libtheora-1.1.1.tar.xz cd libtheora-1.1.1 ./configure make make install 13. 安装NUT支持库 安装时64位Linux系统需要修改文件config.mak 在最后一个CFLAGS下一行增加: CFLAGS += -fPIC 否则安装FFmpeg make时报错: /usr/local/lib/libnut.a: could not read symbols: Bad value cd /App/src svn co svn://svn.mplayerhq.hu/nut/src/trunk libnut cd libnut ./configure make make install 14. 安装VP8/VP9编解码支持库 cd /App/src git clonehttp://git.chromium.org/webm/libvpx.git cd libvpx ./configure --enable-shared make make install 15. 安装FFmpeg最新版 cd /App/src wgethttp://ffmpeg.org/releases/ffmpeg-2.6.3.tar.bz2 tar xvf ffmpeg-2.6.3.tar.bz2 cd ffmpeg-2.6.3 ./configure --enable-version3 --enable-libvpx --enable-libfaac --enable-libmp3lame --enable-libvorbis --enable-libx264 --enable-libxvid --enable-gpl --enable-postproc --enable-nonfree --enable-avfilter --enable-pthreads --enable-libnut --enable-libtheora --enable-libopencore-amrnb --enable-libopencore-amrwb --enable-shared make make install ldconfig 16. 安装segmenter git clonehttps://github.com/johnf/m3u8-segmenter cd m3u8-segmenter PKG_CONFIG_PATH=/usr/local/lib/pkgconfig ./configure make make install ln -s /usr/local/bin/m3u8-segmenter /usr/local/bin/segmenter 三、 编译安装注意事项 1. 可能发现编译FFmpeg或者其他支持库时,即使相关的所有依赖也编译安装上了,仍然make报错,主要的原因还是由于依赖的库版本冲突,编译时调用的是yum安装时自动下载安装的旧版本依赖库。此时的方法就是卸掉所有yum安装的旧版本FFmpeg和相关的依赖软件包或者重新找台新的纯净的系统重新开始安装,或者使用UbuntuServer最新版,一般Ubuntu Server最新版FFmpeg版本还是比较新的,直接执行命令 sudo apt-get install ffmpeg 会自动安装FFmpeg和相关依赖。 2. 有爱专研的或者受制于手头无多余机器的,只能老老实实得卸载旧软件,从头开始编译安装。如何去除旧版本yum安装的相关软件?我们可以借助yum deplist命令先找出所有相关依赖软件包,然后卸载除了公共软件包外的所有软件包。此方法也适用于安装其它软件时遇到类似同样的问题。 yum deplist ffmpeg | grep -v ffmpeg | grep provider | awk '{print $2}' | sort -u 从中挑出非公共软件包的软件包名卸载: rpm -e --nodeps a52dec dirac dirac-libs faac gsm lame libtheora opencore-amr SDL x264 rpm -e --nodeps $(rpm -qa | grep -i ffmpeg)

优秀的个人博客,低调大师

Windows上搭建Standalone模式的Spark环境

Java 安装Java8,设置JAVA_HOME,并添加 %JAVA_HOME%\bin 到环境变量PATH中 E:\java -version java version "1.8.0_60" Java(TM) SE Runtime Environment (build 1.8.0_60-b27) Java HotSpot(TM) 64-Bit Server VM (build 25.60-b23, mixed mode) Scala 下载解压Scala 2.11,设置SCALA_HOME,并添加 %SCALA_HOME%\bin 到PATH中 E:\ scala -verion Scala code runner version 2.11.7 -- Copyright 2002-2013, LAMP/EPFL Spark 下载解压Spark 2.1, 设置SPARK_HOME,并添加 %SPARK_HOME%\bin 到PATH中,此时尝试在控制台运行spark-shell,出现如下错误提示无法定位winutils.exe。 E:\>spark-shell Using Spark's default log4j profile: org/apache/spark/log4j-defaults.properties Setting default log level to "WARN". To adjust logging level use sc.setLogLevel(newLevel). For SparkR, use setLogLevel(newLevel). 17/06/05 21:34:43 ERROR Shell: Failed to locate the winutils binary in the hadoop binary path java.io.IOException: Could not locate executable null\bin\winutils.exe in the Hadoop binaries. at org.apache.hadoop.util.Shell.getQualifiedBinPath(Shell.java:379) at org.apache.hadoop.util.Shell.getWinUtilsPath(Shell.java:394) at org.apache.hadoop.util.Shell.<clinit>(Shell.java:387) at org.apache.hadoop.hive.conf.HiveConf$ConfVars.findHadoopBinary(HiveConf.java:2327) at org.apache.hadoop.hive.conf.HiveConf$ConfVars.<clinit>(HiveConf.java:365) at org.apache.hadoop.hive.conf.HiveConf.<clinit>(HiveConf.java:105) at java.lang.Class.forName0(Native Method) at java.lang.Class.forName(Class.java:348) at org.apache.spark.util.Utils$.classForName(Utils.scala:229) at org.apache.spark.sql.SparkSession$.hiveClassesArePresent(SparkSession.scala:991) at org.apache.spark.repl.Main$.createSparkSession(Main.scala:92) at $line3.$read $$ iw $$ iw.<init>(<console>:15) at $line3.$read $$ iw.<init>(<console>:42) at $line3.$read.<init>(<console>:44) at $line3.$read$.<init>(<console>:48) at $line3.$read$.<clinit>(<console>) at $line3.$eval$.$print$lzycompute(<console>:7) at $line3.$eval$.$print(<console>:6) at $line3.$eval.$print(<console>) at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62) at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43) at java.lang.reflect.Method.invoke(Method.java:497) at scala.tools.nsc.interpreter.IMain$ReadEvalPrint.call(IMain.scala:786) at scala.tools.nsc.interpreter.IMain$Request.loadAndRun(IMain.scala:1047) at scala.tools.nsc.interpreter.IMain$WrappedRequest $$ anonfun$loadAndRunReq$1.apply(IMain.scala:638) at scala.tools.nsc.interpreter.IMain$WrappedRequest $$ anonfun$loadAndRunReq$1.apply(IMain.scala:637) at scala.reflect.internal.util.ScalaClassLoader$class.asContext(ScalaClassLoader.scala:31) at scala.reflect.internal.util.AbstractFileClassLoader.asContext(AbstractFileClassLoader.scala:19) at scala.tools.nsc.interpreter.IMain$WrappedRequest.loadAndRunReq(IMain.scala:637) at scala.tools.nsc.interpreter.IMain.interpret(IMain.scala:569) at scala.tools.nsc.interpreter.IMain.interpret(IMain.scala:565) at scala.tools.nsc.interpreter.ILoop.interpretStartingWith(ILoop.scala:807) at scala.tools.nsc.interpreter.ILoop.command(ILoop.scala:681) at scala.tools.nsc.interpreter.ILoop.processLine(ILoop.scala:395) at org.apache.spark.repl.SparkILoop $$ anonfun$initializeSpark$1.apply$mcV$sp(SparkILoop.scala:38) at org.apache.spark.repl.SparkILoop $$ anonfun$initializeSpark$1.apply(SparkILoop.scala:37) at org.apache.spark.repl.SparkILoop $$ anonfun$initializeSpark$1.apply(SparkILoop.scala:37) at scala.tools.nsc.interpreter.IMain.beQuietDuring(IMain.scala:214) at org.apache.spark.repl.SparkILoop.initializeSpark(SparkILoop.scala:37) at org.apache.spark.repl.SparkILoop.loadFiles(SparkILoop.scala:105) at scala.tools.nsc.interpreter.ILoop $$ anonfun$process$1.apply$mcZ$sp(ILoop.scala:920) at scala.tools.nsc.interpreter.ILoop $$ anonfun$process$1.apply(ILoop.scala:909) at scala.tools.nsc.interpreter.ILoop $$ anonfun$process$1.apply(ILoop.scala:909) at scala.reflect.internal.util.ScalaClassLoader$.savingContextLoader(ScalaClassLoader.scala:97) at scala.tools.nsc.interpreter.ILoop.process(ILoop.scala:909) at org.apache.spark.repl.Main$.doMain(Main.scala:69) at org.apache.spark.repl.Main$.main(Main.scala:52) at org.apache.spark.repl.Main.main(Main.scala) at sun.reflect.NativeMethodAccessorImpl.invoke0(Native Method) at sun.reflect.NativeMethodAccessorImpl.invoke(NativeMethodAccessorImpl.java:62) at sun.reflect.DelegatingMethodAccessorImpl.invoke(DelegatingMethodAccessorImpl.java:43) at java.lang.reflect.Method.invoke(Method.java:497) at org.apache.spark.deploy.SparkSubmit$.org$apache$spark$deploy$SparkSubmit $$ runMain(SparkSubmit.scala:743) at org.apache.spark.deploy.SparkSubmit$.doRunMain$1(SparkSubmit.scala:187) at org.apache.spark.deploy.SparkSubmit$.submit(SparkSubmit.scala:212) at org.apache.spark.deploy.SparkSubmit$.main(SparkSubmit.scala:126) at org.apache.spark.deploy.SparkSubmit.main(SparkSubmit.scala) 从错误消息中可以看出Spark需要用到Hadoop中的一些类库(通过HADOOP_HOME环境变量,因为我们之前并未设置过,所以文件路径null\bin\winutils.exe里面出现了null),但这并不意味这我们一定要安装Hadoop,我们可以直接下载所需要的winutils.exe到磁盘上的任何位置,比如C:\winutils\bin\winutils.exe,同时设置 HADOOP_HOME=C:winutils 。 现在我们再次运行spark-shell,又有一个新的错误: java.lang.IllegalArgumentException: Error while instantiating 'org.apache.spark.sql.hive.HiveSessionState': at org.apache.spark.sql.SparkSession$.org$apache$spark$sql$SparkSession $$ reflect(SparkSession.scala:981) at org.apache.spark.sql.SparkSession.sessionState$lzycompute(SparkSession.scala:110) at org.apache.spark.sql.SparkSession.sessionState(SparkSession.scala:109) at org.apache.spark.sql.SparkSession$Builder $$ anonfun$getOrCreate$5.apply(SparkSession.scala:878) at org.apache.spark.sql.SparkSession$Builder $$ anonfun$getOrCreate$5.apply(SparkSession.scala:878) at scala.collection.mutable.HashMap $$ anonfun$foreach$1.apply(HashMap.scala:99) at scala.collection.mutable.HashMap $$ anonfun$foreach$1.apply(HashMap.scala:99) at scala.collection.mutable.HashTable$class.foreachEntry(HashTable.scala:230) at scala.collection.mutable.HashMap.foreachEntry(HashMap.scala:40) at scala.collection.mutable.HashMap.foreach(HashMap.scala:99) at org.apache.spark.sql.SparkSession$Builder.getOrCreate(SparkSession.scala:878) at org.apache.spark.repl.Main$.createSparkSession(Main.scala:96) ... 47 elided Caused by: java.lang.reflect.InvocationTargetException: java.lang.IllegalArgumentException: Error while instantiating 'org.apache.spark.sql.hive.HiveExternalCatalog': at sun.reflect.NativeConstructorAccessorImpl.newInstance0(Native Method) at sun.reflect.NativeConstructorAccessorImpl.newInstance(NativeConstructorAccessorImpl.java:62) at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java:45) at java.lang.reflect.Constructor.newInstance(Constructor.java:422) at org.apache.spark.sql.SparkSession$.org$apache$spark$sql$SparkSession $$ reflect(SparkSession.scala:978) ... 58 more Caused by: java.lang.IllegalArgumentException: Error while instantiating 'org.apache.spark.sql.hive.HiveExternalCatalog': at org.apache.spark.sql.internal.SharedState$.org$apache$spark$sql$internal$SharedState $$ reflect(SharedState.scala:169) at org.apache.spark.sql.internal.SharedState.<init>(SharedState.scala:86) at org.apache.spark.sql.SparkSession $$ anonfun$sharedState$1.apply(SparkSession.scala:101) at org.apache.spark.sql.SparkSession $$ anonfun$sharedState$1.apply(SparkSession.scala:101) at scala.Option.getOrElse(Option.scala:121) at org.apache.spark.sql.SparkSession.sharedState$lzycompute(SparkSession.scala:101) at org.apache.spark.sql.SparkSession.sharedState(SparkSession.scala:100) at org.apache.spark.sql.internal.SessionState.<init>(SessionState.scala:157) at org.apache.spark.sql.hive.HiveSessionState.<init>(HiveSessionState.scala:32) ... 63 more Caused by: java.lang.reflect.InvocationTargetException: java.lang.reflect.InvocationTargetException: java.lang.RuntimeException: java.lang.RuntimeException: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- at sun.reflect.NativeConstructorAccessorImpl.newInstance0(Native Method) at sun.reflect.NativeConstructorAccessorImpl.newInstance(NativeConstructorAccessorImpl.java:62) at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java:45) at java.lang.reflect.Constructor.newInstance(Constructor.java:422) at org.apache.spark.sql.internal.SharedState$.org$apache$spark$sql$internal$SharedState $$ reflect(SharedState.scala:166) ... 71 more Caused by: java.lang.reflect.InvocationTargetException: java.lang.RuntimeException: java.lang.RuntimeException: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- at sun.reflect.NativeConstructorAccessorImpl.newInstance0(Native Method) at sun.reflect.NativeConstructorAccessorImpl.newInstance(NativeConstructorAccessorImpl.java:62) at sun.reflect.DelegatingConstructorAccessorImpl.newInstance(DelegatingConstructorAccessorImpl.java:45) at java.lang.reflect.Constructor.newInstance(Constructor.java:422) at org.apache.spark.sql.hive.client.IsolatedClientLoader.createClient(IsolatedClientLoader.scala:264) at org.apache.spark.sql.hive.HiveUtils$.newClientForMetadata(HiveUtils.scala:358) at org.apache.spark.sql.hive.HiveUtils$.newClientForMetadata(HiveUtils.scala:262) at org.apache.spark.sql.hive.HiveExternalCatalog.<init>(HiveExternalCatalog.scala:66) ... 76 more Caused by: java.lang.RuntimeException: java.lang.RuntimeException: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- at org.apache.hadoop.hive.ql.session.SessionState.start(SessionState.java:522) at org.apache.spark.sql.hive.client.HiveClientImpl.<init>(HiveClientImpl.scala:188) ... 84 more Caused by: java.lang.RuntimeException: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- at org.apache.hadoop.hive.ql.session.SessionState.createRootHDFSDir(SessionState.java:612) at org.apache.hadoop.hive.ql.session.SessionState.createSessionDirs(SessionState.java:554) at org.apache.hadoop.hive.ql.session.SessionState.start(SessionState.java:508) ... 85 more <console>:14: error: not found: value spark import spark.implicits._ ^ <console>:14: error: not found: value spark import spark.sql ^ Welcome to ____ __ / __/__ ___ _____/ /__ _\ \/ _ \/ _ `/ __/ '_/ /___/ .__/\_,_/_/ /_/\_\ version 2.1.1 /_/ Using Scala version 2.11.8 (Java HotSpot(TM) 64-Bit Server VM, Java 1.8.0_60) Type in expressions to have them evaluated. Type :help for more information. scala> 错误消息中提示零时目录 /tmp/hive 没有写的权限: The root scratch dir: /tmp/hive on HDFS should be writable. Current permissions are: --------- 所以我们需要更新E:/tmp/hive的权限(我在E盘下运行的spark-shell命令,如果在其他盘运行,就改成对应的盘符+/tmp/hive)。运行如下命令: E:\>C:\winutils\bin\winutils.exe chmod 777 E:\tmp\hive 再次运行spark-shell,spark启动成功。此时可以通过 http://localhost:4040 来访问Spark UI

优秀的个人博客,低调大师

Linux平台Swift语言开发学习环境搭建

1.序言 这两天一直忙,没来得及记录东西,周三12月4日凌晨1点多看到苹果正式开源了Swift,国外各大媒体资讯动作超级快。我也兴奋的起来看了一遍关于Swift开源的最新消息。众所周知,苹果平台的Swift语言已经出来了一年半了,一直在成长,经历了好几个版本。许多人盼望的swift开源是希望可以在除了苹果平台之外的平台可以运用这个新语言。比如有人希望将来可以用swift也可以撸一撸后台开发之类,理论上是没问题的,但是同样也有人会喷这么一个愿景,但是开源一出后,多多少少社区人员会去往这个方面去努力的。苹果官方为swift新搞了个网站swift.org,也放出来了Ubuntu Linux平台的预编译好的swift工具链的打包文件以及Linux下的编译指南。我今天写这么一博客的目的就是为了介绍和推广Swift语言在初学者或者低年级大学生群体中的运用。 2.Swift+Ubuntu环境配置 首先假定我们已经安装好Ubuntu Linux操作系统了,这个系统安装很简单,网上很多的步骤教程,虚拟机的话推荐用VirtualBox。Swift支持Ubuntu 14.04和15.10两个发型版,我这选择15.10版本的包。 第一步:下载 Swift 2.2 工具链压缩包,打开终端,输入命令新建目录并下载 diveinedu@diveinedu-VirtualBox:~$ mkdir swift && cd swift; diveinedu@diveinedu-VirtualBox:~/swift$ wget https://swift.org/builds/ubuntu1510/swift-2.2-SNAPSHOT-2015-12-01-b/swift-2.2-SNAPSHOT-2015-12-01-b-ubuntu15.10.tar.gz 第二步:用tar命令解压 Swift 2.2 工具链压缩包到当前目录,并配置环境变量 先解压,再进入目录,目录下会有usr/bin和usr/lib等等子目录: diveinedu@diveinedu-VirtualBox:~/swift$ tar xvf swift-2.2-SNAPSHOT-2015-12-01-b-ubuntu15.10.tar.gz diveinedu@diveinedu-VirtualBox:~/swift$ cd swift-2.2-SNAPSHOT-2015-12-01-b-ubuntu15.10/ 然后配置用户级别的环境变量,编辑$HOME/.bashrc配置文件 diveinedu@diveinedu-VirtualBox:~/swift/swift-2.2-SNAPSHOT-2015-12-01-b-ubuntu15.10$ gedit $HOME/.bashrc 上面命令会调出图形界面文本编辑器GEdit来编辑这个配置文件,在文件的最后输入如下配置行并保存退出编辑器 export SWIFT_HOME=$HOME/swift/swift-2.2-SNAPSHOT-2015-12-01-b-ubuntu15.10 export PATH=$SWIFT_HOME/usr/bin:$PATH export LD_LIBRARY_PATH=$SWIFT_HOME/usr/lib:$LD_LIBRARY_PATH export LIBRARY_PATH=$SWIFT_HOME/usr/lib:$LIBRARY_PATH 这样环境变量就配置OK啦。这个时候我们只需要关闭我们的Shell终端重新打开终端就生效了。 3.Swift+Ubuntu初次体验 搞过iOS开发的都知道,2014年6月Swift刚出世时就随Xcode带了Playground功能,可以边写边看运行结果,辣么在Ubuntu Linux下有没有类似的呢,也有,只是没那么强大的IDE支持,我们一样可以运行类似Pyhton脚本解析器一样的Swift解析器,同步输入Swift代码来“解析”运行。这个命令就是swift,在上面的环境变量设置完后重开终端就可以直接使用了,如下所示。 diveinedu@diveinedu-VirtualBox:~$ swift Welcome to Swift version 2.2-dev (LLVM 46be9ff861, Clang 4deb154edc, Swift 778f82939c). Type :help for assistance. 1> let hello = "hello"; hello: String = "hello" 2> let world = "diveinedu" world: String = "diveinedu" 3> let space = " " space: String = " " 4> print(hello+space+world); hello diveinedu 5>hello. Available completions: append(c: Character) -> Void append(x: UnicodeScalar) -> Void appendContentsOf(newElements: S) -> Void appendContentsOf(other: String) -> Void characters: String.CharacterView debugDescription: String endIndex: Index hashValue: Int insert(newElement: Character, atIndex: Index) -> Void insertContentsOf(newElements: S, at: Index) -> Void isEmpty: Bool lowercaseString: String nulTerminatedUTF8: ContiguousArray<CodeUnit> removeAll() -> Void removeAll(keepCapacity: Bool) -> Void removeAtIndex(i: Index) -> Character removeRange(subRange: Range<Index>) -> Void replaceRange(subRange: Range<Index>, with: C) -> Void replaceRange(subRange: Range<Index>, with: String) -> Void reserveCapacity(n: Int) -> Void startIndex: Index unicodeScalars: String.UnicodeScalarView uppercaseString: String utf16: String.UTF16View utf8: String.UTF8View withCString(f: UnsafePointer<Int8> throws -> ResultUnsafePointer<Int8> throws -> Result) -> Result withMutableCharacters(body: (inout String.CharacterView) -> R(inout String.CharacterView) -> R) -> R write(other: String) -> Void writeTo(&target: Target) -> Void 6> hello.isEmpty $R0: Bool = false 在这个解析执行界面还有自动提示补全功能!简直四国矣.上面第五行是输入hello后再输入一点.然后按tab键,一下就出来这么多关于字符串的方法,妈妈再也不担心我在终端模式下不记得方法名了。 上面这特简单的几行代码还没包含类和对象,下面看看在swift解析器中直接输入类的定义和对象创建和简单使用。 diveinedu@diveinedu-VirtualBox:~$ swift Welcome to Swift version 2.2-dev (LLVM 46be9ff861, Clang 4deb154edc, Swift 778f82939c). Type :help for assistance. 1> struct Resolution { 2. var width = 0 3. var height = 0 4. } 5. class VideoMode { 6. var resolution = Resolution() 7. var interlaced = false 8. var frameRate = 0.0 9. var name: String? 10. func description() 11. { 12. print("name:\(name) frameRate:\(frameRate)") 13. } 14. } 15> let mode = VideoMode() mode: VideoMode = { resolution = { width = 0 height = 0 } interlaced = false frameRate = 0 name = nil } 16> mode.name = "1080p HD" 17> mode.frameRate = 30.0 18> mode.description() name:Optional("1080p HD") frameRate:30.0 19> 这些都只是在swift解析器中临时性的运行一些代码,如果我们需要新建.swift格式文件然后编译成可执行二进制文件形式又要怎样做呢,同样很简单,我们可以用swiftc这个命令来编译。 我们可以新建一个目录来存放swift代码文件,然后编辑一个test.swift: diveinedu@diveinedu-VirtualBox:~$ mkdir -p $HOME/swift/swiftcode diveinedu@diveinedu-VirtualBox:~$ cd $HOME/swift/swiftcode diveinedu@diveinedu-VirtualBox:~/swift/swiftcode$ gedit test.swift 当打开gedit文本编辑器后,输入上面的类和对象创建以及方法调用的代码,列出在下面 struct Resolution { var width = 0 var height = 0 } class VideoMode { var resolution = Resolution() var interlaced = false var frameRate = 0.0 var name: String? func description() { print("name:\(name) frameRate:\(frameRate)") } } let mode = VideoMode() mode.name = "1080p HD" mode.frameRate = 30.0 mode.description() 保存后关闭编辑器,然后执行swiftc test.swift来编译源文件,会出现如下链接错误: diveinedu@diveinedu-VirtualBox:~/swift/swiftcode$ swiftc test.swift <unknown>:0: error: link command failed with exit code 127 (use -v to see invocation) diveinedu@diveinedu-VirtualBox:~/swift/swiftcode$ 解决办法是安装编译依赖clang libicu-dev,输入下面命令回车(会询问当前用户密码) diveinedu@diveinedu-VirtualBox:~/swift/swiftcode$ sudo apt-get install clang libicu-dev 安装完成后再次执行编译命令swiftc test.swift就顺利编译成功,再当前目录下输出test可执行文件。 diveinedu@diveinedu-VirtualBox:~/swift/swiftcode$ swiftc test.swift diveinedu@diveinedu-VirtualBox:~/swift/swiftcode$ ./test name:Optional("1080p HD") frameRate:30.0 而且执行ldd ./test查看此二进制文件依赖的动态库可知,它链接了libswiftCore,这是所有swift程序都会需要的。 diveinedu@diveinedu-VirtualBox:~/swift/swiftcode$ ldd ./test linux-vdso.so.1 => (0x00007ffcef3f5000) libswiftCore.so => /home/diveinedu/swift/swift-2.2-SNAPSHOT-2015-12-01-b-ubuntu15.10/usr/lib/swift/linux/libswiftCore.so (0x00007f1cd2f75000) libstdc++.so.6 => /usr/lib/x86_64-linux-gnu/libstdc++.so.6 (0x00007f1cd2bdd000) libm.so.6 => /lib/x86_64-linux-gnu/libm.so.6 (0x00007f1cd28d5000) libgcc_s.so.1 => /lib/x86_64-linux-gnu/libgcc_s.so.1 (0x00007f1cd26be000) libc.so.6 => /lib/x86_64-linux-gnu/libc.so.6 (0x00007f1cd22f3000) libpthread.so.0 => /lib/x86_64-linux-gnu/libpthread.so.0 (0x00007f1cd20d5000) libdl.so.2 => /lib/x86_64-linux-gnu/libdl.so.2 (0x00007f1cd1ed1000) libicuuc.so.55 => /usr/lib/x86_64-linux-gnu/libicuuc.so.55 (0x00007f1cd1b3c000) libicui18n.so.55 => /usr/lib/x86_64-linux-gnu/libicui18n.so.55 (0x00007f1cd16d9000) libbsd.so.0 => /lib/x86_64-linux-gnu/libbsd.so.0 (0x00007f1cd14c9000) /lib64/ld-linux-x86-64.so.2 (0x0000556e488b7000) libicudata.so.55 => /usr/lib/x86_64-linux-gnu/libicudata.so.55 (0x00007f1ccfa11000) 细心的读者会发现好像不见main函数或者main相关的函数,程序照样可以运行,不管是脚本还是编译成二进制可执行文件,这个我以后再细说了。 文章转载自 开源中国社区[https://www.oschina.net]
优秀的个人博客,低调大师

用本机电脑搭建网站

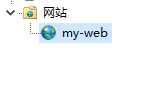
最近又准备瞎捣鼓一下个人网站。本来呢,如果是自己玩玩的话,用花生壳或者NAT123这样的动态DNS解析就可以了。但是最近花生壳这个吊玩意不知道怎么又没办法解析了。而且这货给的域名用的是我的手机号,如此一来个人隐私也暴露了。所以今天我就来研究一下自己购买域名并设置解析。 本机网站 这一部分其实非常自由,用你最喜欢、最熟悉的技术,想怎么来就怎么来。不管是Java、Python、PHP、ASP.NET还是什么的,只要你电脑能运行起来就行。 这里我为了测试就直接用IIS新建了一个空网站,里面只放了一个index.html。然后在浏览器中测试一下,看看是否能够访问。如果显示缺少什么权限的话,可能需要在网站文件夹的属性中添加IIS_IUSRS用户的读取权限。 IIS网站 购买域名 如果你想正式运营一个网站的话,最好购买一个cn域名,这样审核、备案什么的都很方便。如果只是瞎玩玩,那么可以随便买个顺眼的域名。需要注意好像只有cn和com的域名才能备案,所以如果你购买了其他域名的话,只能自己瞎搞了。 现在国内主流的云厂商都可以方便的购买域名。我为了省事就直接在阿里云上买了一个me域名,直接用支付宝付款就行了。反正也不备案了,自己瞎玩玩。 设置DNS解析 域名也有了,下面就可以设置DNS解析了。由于国内政策比较严格,所以好像大部分DNS解析都需要备案才行。如果你使用云主机来做网站,那么必须进行备案。如果是自己的电脑的话,好像暂时不用备案。这里我用阿里云的解析,发现可以成功解析,但是不知道可以使用多长时间。 如果过几天网站不能访问了,那么只能使用外国的DNS解析服务了。我查了一下,下面两篇文章列出了一些免费的外国DNS解析服务,如果有需要的话可以参考一下。 8个国外免费DNS域名解析网站 免费域名解析服务 由于我国IPv4地址资源非常紧张,所以基本上没办法向美国那样奢侈的使用IP地址。如果电脑没有公网IP地址的话,是没办法直接进行DNS解析的。所以第一步就是在路由器中设置端口转发或者是DMZ功能。 所谓端口转发,就是将经过路由器某个端口的请求全部转发到内部局域网中某台电脑上。如果只需要开启这么一个端口,使用端口转发是很方便的。DMZ则相反,它是将内部的主机暴露到了公网中,对公网IP地址的访问会全部代理到内部的主机上。为了省事,我就直接把自己的电脑用DMZ暴露了出来。 需要注意,路由器设置DMZ的话,自己的电脑就暴露到了互联网上了。所以最好保持防火墙始终开启的状态。 设置完成之后,我们就有了可以添加到DNS解析中的公网IP地址。我们进入阿里云解析,根据需求,设置www解析或者@解析。等待几分钟之后,打开浏览器,输入申请好的域名,即可看到相应的网站。 申请免费SSL证书 有了个人网站,最好在申请一个免费的SSL证书,增加安全性。我查了一下对于个人用户来说,腾讯云提供的服务就非常不错,免费的,而且时长为一年。申请方法很简单,进入腾讯云SSL,然后点击这里的申请证书。 腾讯云SSL 然后选择左边的免费版DVSSL证书,按照提示在阿里云DNS设置中添加一个TXT解析。服务器会自动读取DNS解析并验证。验证完成之后,就可以下载生成的SSL证书了。 免费SSL 下载好的证书有Apache、IIS和Nginx三种版本的。按照所用的服务器设置相应的SSL即可。需要注意,浏览器会对域名进行验证。所以如果域名不匹配的话,是不会出现绿色的HTTPS标志的。 未经过浏览器验证的SSL证书 只有使用申请证书时使用的域名进行访问,浏览器才能确认这个SSL证书是可信的。 验证通过 设置完成之后,我们就拥有了一个安全的个人网站。如果懂得一点Web技术的话,现在就可以做一个个人网站,然后发布出来,让别人看到。是一件很有成就感的事情哦!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册