首页 文章 精选 留言 我的

精选列表

搜索[SQL构建],共10000篇文章
优秀的个人博客,低调大师

构建基于Spark的推荐引擎(Python)

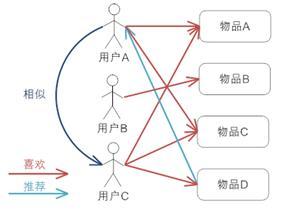
在学习Spark机器学习时,书上用scala完成,自己不熟悉遂用pyshark完成,更深入的理解了spark对协同过滤的实现 在这里我们的推荐模型选用协同过滤这种类型,使用Spark的MLlib中推荐模型库中基于矩阵分解(matrix factorization)的实现。 协同过滤(Collaborative Filtering) 协同过滤简单来说是利用某兴趣相投、拥有共同经验之群体的喜好来推荐用户感兴趣的信息,个人通过合作的机制给予信息相当程度的回应(如评分)并记录下来以达到过滤的目的进而帮助别人筛选信息,回应不一定局限于特别感兴趣的,特别不感兴趣信息的纪录也相当重要。 很简单的例子来介绍就是日常我们生活中经常找电影会通过向和自己品味类似的朋友要求推荐,这就是协同过滤的思想 基于用户的协同过滤推荐机制的基本原理 基于用户或物品的方法的得分取决于若干用户或是物品之间依据相似度所构成的集合(即邻居),故它们也常被称为最邻近模型。 矩阵分解 这里我们要处理的数据是用户提供的自身偏好数据,即用户对物品的打分数据。 这些数据可以被转换成用户为行,物品为列的二维矩阵,即评分矩阵A(m*n)表示m个用户对n个物品的打分情况 UI i1 i2 i3 u1 3.0 3.0 ? u2 ? 2.0 4.0 u3 ? 5.0 ? 这个矩阵A很多元素都是空的,我们称其为缺失值(missing value) 协同过滤提出了一种支持不完整评分矩阵的矩阵分解方法,不用对评分矩阵进行估值填充。 在推荐系统中,我们希望得到用户对所有物品的打分情况,如果用户没有对一个物品打分,那么就需要预测用户是否会对该物品打分,以及会打多少分。这就是所谓的矩阵补全(矩阵分解) 对于这个矩阵分解的方式就是找出两个低维度的矩阵,使得他们的乘积是原始的矩阵。 因此这也是一种降维技术。要找到和‘用户-物品’矩阵近似的k维矩阵,最终要求得出表示用户的m x k维矩阵,和一个表示物品的k x n维矩阵。 这两个矩阵也称作因子矩阵。 对于k的理解为对于每个产品,这里已电影为例,可以从k个角度进行评价,即k个特征值 由于是对‘用户-物品’矩阵直接建模,用这些模型进行预测也相对直接,要计算给定用户对某个物品的预计评级,就从用户因子矩阵和物品因子矩阵分别选取对应的行与列,然后计算两者的点积。 假设对于用户A,该用户对一部电影的综合评分和电影的特征值存在一定的线性关系, 即电影的综合评分=(a1d1+a2d2+a3d3+a4d4) 其中a1-4为用户A的特征值,d1-4为之前所说的电影的特征值 最小二乘法实现协同 最小二乘法(Alternating Least Squares, ALS)是一种求解矩阵分解问题的最优化方法。它功能强大、效果理想而且被证明相对容易并行化。这使得它很适合如Spark这样的平台。 使用用户特征矩阵U(m∗k) 中的第i个用户的特征向量ui 和产品特征矩阵V(n∗k)第j个物品的特征向量vi来预测打分矩阵A(m∗n)中的aij, 得出矩阵分解模型的损失函数如下: C=∑(i,j)∈R[(aij−uivTj)2+λ(u2i+v2j)] 通常的优化方法分为两种:交叉最小二乘法(alternative least squares)和随机梯度下降法(stochastic gradient descent)。Spark使用的是交叉最小二乘法(ALS)来最优化损失函数。 算法的思想就是:我们先随机生成然后固定它求解,再固定求解,这样交替进行下去,直到取得最优解min(C) 使用PySpark实现 我们这里的数据集是Movielens 100k数据集,包含了多个用户对多部电影的10万次评级数据 读取评级数据集,该数据包括用户ID,影片ID,星级和时间戳等字段,使用/t分隔 通过sc.textFile()读取数据为RDD,通过分隔符取前3个属性分别为用户ID,影片ID,星级 rawData=sc.textFile('/home/null/hadoop/data/ml-100k/u.data') rawData.first() type(rawData) pyspark.rdd.RDD rawRatings=rawData.map(lambdaline:line.split("\t")[:3]) rawRatings.first() ['196','242','3'] #导入spark中的mllib的推荐库 importpyspark.mllib.recommendationasrd 生成Rating类的RDD数据 #由于ALS模型需要由Rating记录构成的RDD作为参数,因此这里用rd.Rating方法封装数据 ratings=rawRatings.map(lambdaline:rd.Rating(int(line[0]),int(line[1]),float(line[2]))) ratings.first() Rating(user=196,product=242,rating=3.0) 训练ALS模型 rank: 对应ALS模型中的因子个数,即矩阵分解出的两个矩阵的新的行/列数,即A≈UVT,k<<m,nm,n中的k iterations: 对应运行时的最大迭代次数 lambda: 控制模型的正则化过程,从而控制模型的过拟合情况。 #训练ALS模型 model=rd.ALS.train(ratings,50,10,0.01) model #对用户789预测其对电影123的评级 predictedRating=model.predict(789,123) predictedRating 3.1740832151065774 #获取对用户789的前10推荐 topKRecs=model.recommendProducts(789,10) topKRecs [Rating(user=789,product=429,rating=6.302989890089658), Rating(user=789,product=496,rating=5.782039583864358), Rating(user=789,product=651,rating=5.665266358968961), Rating(user=789,product=250,rating=5.551256887914674), Rating(user=789,product=64,rating=5.5336980239740186), Rating(user=789,product=603,rating=5.468600343790217), Rating(user=789,product=317,rating=5.442052952711695), Rating(user=789,product=480,rating=5.414042111530209), Rating(user=789,product=180,rating=5.413309515550101), Rating(user=789,product=443,rating=5.400024900653429)] 检查推荐内容 这里首先将电影的数据读入,讲数据处理为电影ID到标题的映射 然后获取某个用户评级前10的影片同推荐这个用户的前10影片进行比较 #检查推荐内容 movies=sc.textFile('/home/null/hadoop/data/ml-100k/u.item') movies.first() '1|ToyStory(1995)|01-Jan-1995||http://us.imdb.com/M/title-exact?Toy%20Story%20(1995)|0|0|0|1|1|1|0|0|0|0|0|0|0|0|0|0|0|0|0' titles_data=movies.map(lambdaline:line.split("|")[:2]).collect() titles=dict(titles_data) titles moviesForUser=ratings.keyBy(lambdarating:rating.user).lookup(789) type(moviesForUser) list moviesForUser=sorted(moviesForUser,key=lambdar:r.rating,reverse=True)[0:10] moviesForUser [Rating(user=789,product=127,rating=5.0), Rating(user=789,product=475,rating=5.0), Rating(user=789,product=9,rating=5.0), Rating(user=789,product=50,rating=5.0), Rating(user=789,product=150,rating=5.0), Rating(user=789,product=276,rating=5.0), Rating(user=789,product=129,rating=5.0), Rating(user=789,product=100,rating=5.0), Rating(user=789,product=741,rating=5.0), Rating(user=789,product=1012,rating=4.0)] [(titles[str(r.product)],r.rating)forrinmoviesForUser] [('Godfather,The(1972)',5.0), ('Trainspotting(1996)',5.0), ('DeadManWalking(1995)',5.0), ('StarWars(1977)',5.0), ('Swingers(1996)',5.0), ('LeavingLasVegas(1995)',5.0), ('Bound(1996)',5.0), ('Fargo(1996)',5.0), ('LastSupper,The(1995)',5.0), ('PrivateParts(1997)',4.0)] [(titles[str(r.product)],r.rating)forrintopKRecs] [('DaytheEarthStoodStill,The(1951)',6.302989890089658), ("It'saWonderfulLife(1946)",5.782039583864358), ('Glory(1989)',5.665266358968961), ('FifthElement,The(1997)',5.551256887914674), ('ShawshankRedemption,The(1994)',5.5336980239740186), ('RearWindow(1954)',5.468600343790217), ('IntheNameoftheFather(1993)',5.442052952711695), ('NorthbyNorthwest(1959)',5.414042111530209), ('ApocalypseNow(1979)',5.413309515550101), ('Birds,The(1963)',5.400024900653429)] 推荐模型效果的评估 均方差(Mean Squared Error,MSE) 定义为各平方误差的和与总数目的商,其中平方误差是指预测到的评级与真实评级的差值平方 直接度量模型的预测目标变量的好坏 均方根误差(Root Mean Squared Error,RMSE) 对MSE取其平方根,即预计评级和实际评级的差值的标准差 #evaluationmetric usersProducts=ratings.map(lambdar:(r.user,r.product)) predictions=model.predictAll(usersProducts).map(lambdar:((r.user,r.product),r.rating)) predictions.first() ((316,1084),4.006135662882842) ratingsAndPredictions=ratings.map(lambdar:((r.user,r.product),r.rating)).join(predictions) ratingsAndPredictions.first() ((186,302),(3.0,2.7544572973050236)) #使用MLlib内置的评估函数计算MSE,RMSE frompyspark.mllib.evaluationimportRegressionMetrics predictionsAndTrue=ratingsAndPredictions.map(lambdaline:(line[1][0],line[1][3])) predictionsAndTrue.first() (3.0,2.7544572973050236) #MSE regressionMetrics=RegressionMetrics(predictionsAndTrue) regressionMetrics.meanSquaredError 0.08509832708963357 #RMSE regressionMetrics.rootMeanSquaredError 0.2917161755707653 本文地址https://segmentfault.com/a/1190000012494851 推荐内容《大数据全栈高手速成--Spark2.0精讲(全场景项目实战) 》http://www.roncoo.com/course/view/c4e0130ea2354c71a2cb9ba24348746c


优秀的个人博客,低调大师

centos7之Java开发环境构建

CensOS7环境 我个人的博客环境如下: 希望这个教程可以帮助到linux新手朋友们或者其他在安装软件时遇到问题的朋友们 当然了,百度上也有很多类似这样的教程,我个人贴出来,一来为分享,二来以后自己用到时,上手就有,不必担心为此耗费比较长的时间。 该教程是我个人使用xmind写的,只是通过导出工具导出为html,才会显示如下,不过导出的显示信息,不会影响正常阅读。 本人亲自实践过,有任何问题可以留言 Java开发基本环境 1.jdk的安装 rpm安装 获取rpm安装包 wget --no-check-certificate --no-cookies --header "Cookie: oraclelicense=accept-securebackup-cookie" http://download.oracle.com/otn-pub/java/jdk/8u131-b11/d54c1d3a095b4ff2b6607d096fa80163/jdk-8u131-linux-x64.rpm jdk官网:http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html 安装rpm rpm -ivh jdk-8u131-linux-x64.rpm java -version 显示对应的Java版本信息 2.tomcat安装 首先在浏览器输入tomcat,进入tomcat官网 https://tomcat.apache.org/ 选择对应的版本,将链接复制下来,然后再Linux上执行wget命令进行下载 wget http://mirrors.hust.edu.cn/apache/tomcat/tomcat-8/v8.0.52/bin/apache-tomcat-8.0.52.tar.gz 解压tomcat tar -xzvf apache-tomcat-8.0.52.tar.gz 3.mysql安装 获得tar包 wget http://dev.mysql.com/get/Downloads/MySQL-5.7/mysql-5.7.16-1.el7.x86_64.rpm-bundle.tar 解压tar包 tar -xvf mysql-5.7.16-1.el7.x86_64.rpm-bundle.tar 安装(存在依赖关系,依次安装) rpm -ivh mysql-community-common-5.7.16-1.el7.x86_64.rpm rpm -ivh mysql-community-libs-5.7.16-1.el7.x86_64.rpm rpm -ivh mysql-community-client-5.7.16-1.el7.x86_64.rpm rpm -ivh mysql-community-server-5.7.16-1.el7.x86_64.rpm 在安装这个的时候可能会报错,通过这个方法可以解决 获取相关依赖包并安装 下载 wget http://mirror.centos.org/centos/6/os/x86_64/Packages/libaio-0.3.107-10.el6.x86_64.rpm 安装 rpm -ivh libaio-0.3.107-10.el6.x86_64.rpm yum安装相关包 yum install net-tools 数据库初始化 mysqld --initialize --user=mysql 获得随机密码 cat /var/log/mysqld.log 启动数据库 systemctl start mysqld.service 进入mysql mysql -uroot -p 修改密码 ALTER USER 'root'@'localhost' IDENTIFIED BY 'new_password'; 4. maven安装 安装命令 yum install maven 安装成功 mvn -v 显示对应的版本信息 5.git安装 安装命令 yum install git 6.nginx安装 准备相关的依赖库 yum install gcc gcc-c++ autoconf automake yun -y install zlib zlib-devel openssl openssl-devel pcre pcre-devel wget http://downloads.sourceforge.net/project/pcre/pcre/8.35/pcre-8.35.tar.gz 解压 tar-xzvf pcre-8.35.tar.gz ./configure make && make install 编译安装 获取安装包 wget http://nginx.org/download/nginx-1.6.2.tar.gz 解压该包 tar xzvf nginx-1.6.2.tar.gz /configure --prefix=/usr/local/nginx --with-http_stub_status_module --with-http_ssl_module --with-pcre=/home/yc/pcre-8.35

优秀的个人博客,低调大师

Docker 构建自己的容器(学习笔记二)

Dockerfile --------------------------------------------------------------------------------------------------------------------- 首先需要的包和dockerfile放在一起 [root@localhost docker-file]# ls Dockerfile nginx-1.9.3.tar.gz pcre-8.37.tar.gz [root@localhost docker-file]# pwd /opt/docker-file [root@localhost docker-file]# --------------------------------------------------------------------------------------------------------------------- 创建dockerfile [root@localhost docker-file]# vim Dockerfile #base images,name or id 可以是镜像名字或者镜像ID FROM 3bee3060bfc8 #maintainer 作者 MAINTAINER wangzz #add 把包添加到容器的指定目录,如果是tar包会自动解压 ADD pcre-8.37.tar.gz /usr/local/src ADD nginx-1.9.3.tar.gz /usr/local/src #run 在容器里运行命令安装nginx需要软件 RUN yum install -y wget gcc gcc-c++ make openssl-devel #run 在容器里运行命令创建用户 RUN useradd -s /sbin/nologin -M www #workdir 相当于cd到这个目录 WORKDIR /usr/local/src/nginx-1.9.3 #run 在容器里运行命令进行编译安装 RUN ./configure --prefix=/usr/local/nginx --user=www --group=www --with-http_ssl_module --with-http_stub_status_module --with-pcre=/usr/local/src/pcre-8.37 && make && make install #run 在容器里运行命令更改nginx配置文件,使其前台运行 RUN echo "daemon off;" >> /usr/local/nginx/conf/nginx.conf #env 将nginx启动命令加到环境变量里 ENV PATH /usr/local/nginx/sbin:$PATH #映射80端口 EXPOSE 80 执行nginx命令 CMD ["nginx"] --------------------------------------------------------------------------------------------------------------------- 执行dockerfile [root@localhost docker-file]# docker build -t my-nginx-1:v1 /opt/docker-file/ 当成功后会出现这个,说明执行成功 Successfully built 21273b8e163a --------------------------------------------------------------------------------------------------------------------- 查看镜像 [root@localhost docker-file]# docker images REPOSITORY TAG IMAGE ID CREATED SIZE my-nginx-1 v1 21273b8e163a 14 minutes ago 429.1 MB --------------------------------------------------------------------------------------------------------------------- 使用创建好的镜像启动容器 [root@localhost docker-file]# docker run -dit --name mynginx 21273b8e163a --------------------------------------------------------------------------------------------------------------------- 查看运行的容器 [root@localhost docker-file]# docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES aa30accbfc06 21273b8e163a "nginx" 3 seconds ago Up 2 seconds 80/tcp mynginx --------------------------------------------------------------------------------------------------------------------- 访问这个容器的80端口,看nginx是否安装启动成功 [root@localhost docker-file]# curl 172.17.0.3 Welcome to nginx! body { width: 35em; margin: 0 auto; font-family: Tahoma, Verdana, Arial, sans-serif; } Welcome to nginx! If you see this page, the nginx web server is successfully installed and working. Further configuration is required. For online documentation and support please refer to nginx.org. Commercial support is available at nginx.com. Thank you for using nginx.

优秀的个人博客,低调大师

docker私有仓库构建,上传,下载 push,pull

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq_34173549/article/details/80415332 1、下载私有仓库镜像 docker pull registry docker registry 启动 docker run -d -p 5001:5000 registry 默认端口5000我虚拟机占用5000所以改5001 上传 docker push localhost:5001/test/es:v1 另一台机器下载 docker pulldocker pull 47.106.154.105:5001/test/e:v1 ip为机器1公网ip 后面仓库位置要一样 docker pull 报错:Get https://registry:5000/v1/_ping: http: server gave HTTP response to HTTPS client 下载成功

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册