首页 文章 精选 留言 我的

精选列表

搜索[记忆机制],共10008篇文章
优秀的个人博客,低调大师

tomcat类加载机制

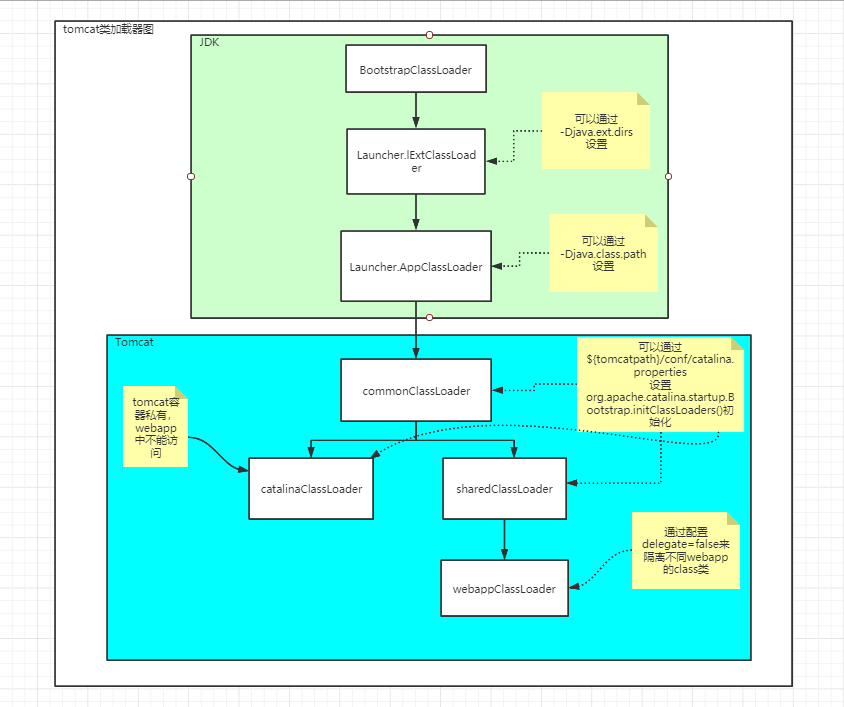
一、tomcat类加载器继承图 tomcat类加载器的集成体系,包含两部分: 1.上半部分是jdk自带的,包含:启动类加载器,扩展类加载器,应用类加载器,这里不展开讲解。如果想了解,可以查看sun.misc.Launcher.Launcher()和java.lang.ClassLoader.loadClass(String, boolean)源码 2.下半部分是tomcat的自定义类加载器,包含: a)commonClassLoader:通过${tomcatpath}/conf/catalina.properties中的common.loader配置,通常加载tomcat和webapp共享的class b) catalinaClassLoader:通过${tomcatpath}/conf/catalina.properties中的server.loader配置,加载tomcat需要的class,对webapp不可见 c) sharedClassLoader:通过${tomcatpath}/conf/catalina.properties中的shared.loader配置, 加载webapp们共享的class,对tomcat容器不可见 d) webappClassLoader: 这个类加载器,就是加载我们写的应用程序class的。通常说的tomcat打破双亲委派就是说的它 二、源码 1.初始化自定义加载器 // org.apache.catalina.startup.Bootstrap.initClassLoaders() private void initClassLoaders() { try { commonLoader = createClassLoader("common", null); if (commonLoader == null) { // no config file, default to this loader - we might be in a 'single' env. commonLoader = this.getClass().getClassLoader(); } catalinaLoader = createClassLoader("server", commonLoader); sharedLoader = createClassLoader("shared", commonLoader); } catch (Throwable t) { handleThrowable(t); log.error("Class loader creation threw exception", t); System.exit(1); } } 2.初始化webappclassloader org.apache.catalina.loader.WebappLoader.startInternal() protected void startInternal() throws LifecycleException { if (log.isDebugEnabled()) log.debug(sm.getString("webappLoader.starting")); if (context.getResources() == null) { log.info("No resources for " + context); setState(LifecycleState.STARTING); return; } // Construct a class loader based on our current repositories list try { // 创建classloader,并将父classloader设置成sharedClassLoader classLoader = createClassLoader(); classLoader.setResources(context.getResources()); // 设置委派模式 classLoader.setDelegate(this.delegate); // Configure our repositories setClassPath(); setPermissions(); // 开始类加载 ((Lifecycle) classLoader).start(); String contextName = context.getName(); if (!contextName.startsWith("/")) { contextName = "/" + contextName; } ObjectName cloname = new ObjectName(context.getDomain() + ":type=" + classLoader.getClass().getSimpleName() + ",host=" + context.getParent().getName() + ",context=" + contextName); Registry.getRegistry(null, null) .registerComponent(classLoader, cloname, null); } catch (Throwable t) { t = ExceptionUtils.unwrapInvocationTargetException(t); ExceptionUtils.handleThrowable(t); log.error( "LifecycleException ", t ); throw new LifecycleException("start: ", t); } setState(LifecycleState.STARTING); } private WebappClassLoaderBase createClassLoader() throws Exception { Class<?> clazz = Class.forName(loaderClass); WebappClassLoaderBase classLoader = null; if (parentClassLoader == null) { parentClassLoader = context.getParentClassLoader(); } else { context.setParentClassLoader(parentClassLoader); } Class<?>[] argTypes = { ClassLoader.class }; Object[] args = { parentClassLoader }; Constructor<?> constr = clazz.getConstructor(argTypes); classLoader = (WebappClassLoaderBase) constr.newInstance(args); return classLoader; } 3.装配应用class文件 // org.apache.catalina.loader.WebappClassLoaderBase.start() public void start() throws LifecycleException { state = LifecycleState.STARTING_PREP; // 扫描 /WEB-INF/classes 下的class WebResource[] classesResources = resources.getResources("/WEB-INF/classes"); for (WebResource classes : classesResources) { if (classes.isDirectory() && classes.canRead()) { localRepositories.add(classes.getURL()); } } // 扫描 /WEB-INF/lib 下的jar WebResource[] jars = resources.listResources("/WEB-INF/lib"); for (WebResource jar : jars) { if (jar.getName().endsWith(".jar") && jar.isFile() && jar.canRead()) { localRepositories.add(jar.getURL()); // 记录jar的修改时间,用于热更新 jarModificationTimes.put( jar.getName(), Long.valueOf(jar.getLastModified())); } } state = LifecycleState.STARTED; } 4.tomcat热更新: // org.apache.catalina.loader.WebappLoader.backgroundProcess() public void backgroundProcess() { // reloadable:是否开启热更新 // modified():判断jar和class是否有修改(这里会导致cpu瞬间高) if (reloadable && modified()) { try { Thread.currentThread().setContextClassLoader (WebappLoader.class.getClassLoader()); if (context != null) { context.reload(); } } finally { if (context != null && context.getLoader() != null) { Thread.currentThread().setContextClassLoader (context.getLoader().getClassLoader()); } } } } 5.加载一个class文件的过程: // org.apache.catalina.loader.WebappClassLoaderBase.loadClass(String) public Class<?> loadClass(String name, boolean resolve) throws ClassNotFoundException { synchronized (getClassLoadingLock(name)) { Class<?> clazz = null; // Log access to stopped class loader checkStateForClassLoading(name); // (0) Check our previously loaded local class cache // 从本地缓存查找 clazz = findLoadedClass0(name); if (clazz != null) { if (log.isDebugEnabled()) log.debug(" Returning class from cache"); if (resolve) resolveClass(clazz); return clazz; } // (0.1) Check our previously loaded class cache // 从父类类加载器缓存查找 clazz = findLoadedClass(name); if (clazz != null) { if (log.isDebugEnabled()) log.debug(" Returning class from cache"); if (resolve) resolveClass(clazz); return clazz; } // (0.2) Try loading the class with the system class loader, to prevent // the webapp from overriding Java SE classes. This implements // SRV.10.7.2 String resourceName = binaryNameToPath(name, false); ClassLoader javaseLoader = getJavaseClassLoader(); boolean tryLoadingFromJavaseLoader; try { // Use getResource as it won't trigger an expensive // ClassNotFoundException if the resource is not available from // the Java SE class loader. However (see // https://bz.apache.org/bugzilla/show_bug.cgi?id=58125 for // details) when running under a security manager in rare cases // this call may trigger a ClassCircularityError. // See https://bz.apache.org/bugzilla/show_bug.cgi?id=61424 for // details of how this may trigger a StackOverflowError // Given these reported errors, catch Throwable to ensure any // other edge cases are also caught URL url; if (securityManager != null) { PrivilegedAction<URL> dp = new PrivilegedJavaseGetResource(resourceName); url = AccessController.doPrivileged(dp); } else { url = javaseLoader.getResource(resourceName); } tryLoadingFromJavaseLoader = (url != null); } catch (Throwable t) { // Swallow all exceptions apart from those that must be re-thrown ExceptionUtils.handleThrowable(t); // The getResource() trick won't work for this class. We have to // try loading it directly and accept that we might get a // ClassNotFoundException. tryLoadingFromJavaseLoader = true; } // 尝试用加载String类(即启动类加载器)的类加载器加载 if (tryLoadingFromJavaseLoader) { try { clazz = javaseLoader.loadClass(name); if (clazz != null) { if (resolve) resolveClass(clazz); return clazz; } } catch (ClassNotFoundException e) { // Ignore } } // (0.5) Permission to access this class when using a SecurityManager if (securityManager != null) { int i = name.lastIndexOf('.'); if (i >= 0) { try { securityManager.checkPackageAccess(name.substring(0,i)); } catch (SecurityException se) { String error = "Security Violation, attempt to use " + "Restricted Class: " + name; log.info(error, se); throw new ClassNotFoundException(error, se); } } } // 判断是否委派给父类加载器 boolean delegateLoad = delegate || filter(name, true); // (1) Delegate to our parent if requested // 委派给父类加载器(sharedClassLoader),符合委派双亲 if (delegateLoad) { if (log.isDebugEnabled()) log.debug(" Delegating to parent classloader1 " + parent); try { clazz = Class.forName(name, false, parent); if (clazz != null) { if (log.isDebugEnabled()) log.debug(" Loading class from parent"); if (resolve) resolveClass(clazz); return clazz; } } catch (ClassNotFoundException e) { // Ignore } } // (2) Search local repositories // 在本地存储库查找并加载 if (log.isDebugEnabled()) log.debug(" Searching local repositories"); try { clazz = findClass(name); if (clazz != null) { if (log.isDebugEnabled()) log.debug(" Loading class from local repository"); if (resolve) resolveClass(clazz); return clazz; } } catch (ClassNotFoundException e) { // Ignore } // (3) Delegate to parent unconditionally // 即使没有委派,最后也执行一次委派 if (!delegateLoad) { if (log.isDebugEnabled()) log.debug(" Delegating to parent classloader at end: " + parent); try { clazz = Class.forName(name, false, parent); if (clazz != null) { if (log.isDebugEnabled()) log.debug(" Loading class from parent"); if (resolve) resolveClass(clazz); return clazz; } } catch (ClassNotFoundException e) { // Ignore } } } throw new ClassNotFoundException(name); }

优秀的个人博客,低调大师

#Caffeine 实现缓存机制

简介 前面刚说到Guava Cache,他的优点是封装了get,put操作;提供线程安全的缓存操作;提供过期策略;提供回收策略;缓存监控。当缓存的数据超过最大值时,使用LRU算法替换。这一篇我们将要谈到一个新的本地缓存框架:Caffeine Cache。它也是站在巨人的肩膀上-Guava Cache,借着他的思想优化了算法发展而来。 按 Caffeine Github 文档描述,Caffeine 是基于 JAVA 8 的高性能缓存库。并且在 spring5 (springboot 2.x) 后,spring 官方放弃了 Guava,而使用了性能更优秀的 Caffeine 作为默认缓存组件。 Caffine Cache Caffeine Cache:https://github.com/ben-manes/caffeine 1. 缓存填充策略 Caffeine Cache提供了三种缓存填充策略:手动、同步加载和异步加载。 手动加载 在每次get key的时候指定一个同步的函数,如果key不存在就调用这个函数生成一个值。 /** * 手动加载 * @param key * @return */ public Object manulOperator(String key) { Cache<String, Object> cache = Caffeine.newBuilder() .expireAfterWrite(1, TimeUnit.SECONDS) .expireAfterAccess(1, TimeUnit.SECONDS) .maximumSize(10) .build(); //如果一个key不存在,那么会进入指定的函数生成value Object value = cache.get(key, t -> setValue(key).apply(key)); cache.put("hello",value); //判断是否存在如果不存返回null Object ifPresent = cache.getIfPresent(key); //移除一个key cache.invalidate(key); return value; } public Function<String, Object> setValue(String key){ return t -> key + "value"; } 同步加载 构造Cache时候,build方法传入一个CacheLoader实现类。实现load方法,通过key加载value。 /** * 同步加载 * @param key * @return */ public Object syncOperator(String key){ LoadingCache<String, Object> cache = Caffeine.newBuilder() .maximumSize(100) .expireAfterWrite(1, TimeUnit.MINUTES) .build(k -> setValue(key).apply(key)); return cache.get(key); } public Function<String, Object> setValue(String key){ return t -> key + "value"; } 异步加载 AsyncLoadingCache是继承自LoadingCache类的,异步加载使用Executor去调用方法并返回一个CompletableFuture。异步加载缓存使用了响应式编程模型。 如果要以同步方式调用时,应提供CacheLoader。要以异步表示时,应该提供一个AsyncCacheLoader,并返回一个CompletableFuture。 /** * 异步加载 * @param key * @return */ public Object asyncOperator(String key){ AsyncLoadingCache<String, Object> cache = Caffeine.newBuilder() .maximumSize(100) .expireAfterWrite(1, TimeUnit.MINUTES) .buildAsync(k -> setAsyncValue(key).get()); return cache.get(key); } public CompletableFuture<Object> setAsyncValue(String key){ return CompletableFuture.supplyAsync(() -> { return key + "value"; }); } 2. 回收策略 Caffeine提供了3种回收策略:基于大小回收,基于时间回收,基于引用回收。 基于大小的过期方式 基于大小的回收策略有两种方式:一种是基于缓存大小,一种是基于权重。 // 根据缓存的计数进行驱逐 LoadingCache<String, Object> cache = Caffeine.newBuilder() .maximumSize(10000) .build(key -> function(key)); // 根据缓存的权重来进行驱逐(权重只是用于确定缓存大小,不会用于决定该缓存是否被驱逐) LoadingCache<String, Object> cache1 = Caffeine.newBuilder() .maximumWeight(10000) .weigher(key -> function1(key)) .build(key -> function(key)); maximumWeight与maximumSize不可以同时使用。 基于时间的过期方式 // 基于固定的到期策略进行退出 LoadingCache<String, Object> cache = Caffeine.newBuilder() .expireAfterAccess(5, TimeUnit.MINUTES) .build(key -> function(key)); LoadingCache<String, Object> cache1 = Caffeine.newBuilder() .expireAfterWrite(10, TimeUnit.MINUTES) .build(key -> function(key)); // 基于不同的到期策略进行退出 LoadingCache<String, Object> cache2 = Caffeine.newBuilder() .expireAfter(new Expiry<String, Object>() { @Override public long expireAfterCreate(String key, Object value, long currentTime) { return TimeUnit.SECONDS.toNanos(seconds); } @Override public long expireAfterUpdate(@Nonnull String s, @Nonnull Object o, long l, long l1) { return 0; } @Override public long expireAfterRead(@Nonnull String s, @Nonnull Object o, long l, long l1) { return 0; } }).build(key -> function(key)); Caffeine提供了三种定时驱逐策略: expireAfterAccess(long, TimeUnit):在最后一次访问或者写入后开始计时,在指定的时间后过期。假如一直有请求访问该key,那么这个缓存将一直不会过期。 expireAfterWrite(long, TimeUnit):在最后一次写入缓存后开始计时,在指定的时间后过期。 expireAfter(Expiry):自定义策略,过期时间由Expiry实现独自计算。 缓存的删除策略使用的是惰性删除和定时删除。这两个删除策略的时间复杂度都是O(1)。 基于引用的过期方式 // 当key和value都没有引用时驱逐缓存 LoadingCache<String, Object> cache = Caffeine.newBuilder() .weakKeys() .weakValues() .build(key -> function(key)); // 当垃圾收集器需要释放内存时驱逐 LoadingCache<String, Object> cache1 = Caffeine.newBuilder() .softValues() .build(key -> function(key)); 注意:AsyncLoadingCache不支持弱引用和软引用。 Caffeine.weakKeys(): 使用弱引用存储key。如果没有其他地方对该key有强引用,那么该缓存就会被垃圾回收器回收。由于垃圾回收器只依赖于身份(identity)相等,因此这会导致整个缓存使用身份 (==) 相等来比较 key,而不是使用 equals()。 Caffeine.weakValues() :使用弱引用存储value。如果没有其他地方对该value有强引用,那么该缓存就会被垃圾回收器回收。由于垃圾回收器只依赖于身份(identity)相等,因此这会导致整个缓存使用身份 (==) 相等来比较 key,而不是使用 equals()。 Caffeine.softValues() :使用软引用存储value。当内存满了过后,软引用的对象以将使用最近最少使用(least-recently-used ) 的方式进行垃圾回收。由于使用软引用是需要等到内存满了才进行回收,所以我们通常建议给缓存配置一个使用内存的最大值。 softValues() 将使用身份相等(identity) (==) 而不是equals() 来比较值。 Caffeine.weakValues()和Caffeine.softValues()不可以一起使用。 3.移除事件监听 Cache<String, Object> cache = Caffeine.newBuilder() .removalListener((String key, Object value, RemovalCause cause) -> System.out.printf("Key %s was removed (%s)%n", key, cause)) .build(); 4.写入外部存储 CacheWriter 方法可以将缓存中所有的数据写入到第三方。 LoadingCache<String, Object> cache2 = Caffeine.newBuilder() .writer(new CacheWriter<String, Object>() { @Override public void write(String key, Object value) { // 写入到外部存储 } @Override public void delete(String key, Object value, RemovalCause cause) { // 删除外部存储 } }) .build(key -> function(key)); 如果你有多级缓存的情况下,这个方法还是很实用。 注意:CacheWriter不能与弱键或AsyncLoadingCache一起使用。 5.统计 与Guava Cache的统计一样。 Cache<String, Object> cache = Caffeine.newBuilder() .maximumSize(10_000) .recordStats() .build(); 通过使用Caffeine.recordStats(), 可以转化成一个统计的集合. 通过 Cache.stats() 返回一个CacheStats。CacheStats提供以下统计方法: hitRate(): 返回缓存命中率 evictionCount(): 缓存回收数量 averageLoadPenalty(): 加载新值的平均时间 实例分享 SpringBoot 1.x版本中的默认本地cache是Guava Cache。在2.x(Spring Boot 2.0(spring 5))版本中已经用Caffine Cache取代了Guava Cache。毕竟有了更优的缓存淘汰策略。 下面我们来说在SpringBoot2.x版本中如何使用cache。 Caffeine常用配置说明: initialCapacity=[integer]: 初始的缓存空间大小 maximumSize=[long]: 缓存的最大条数 maximumWeight=[long]: 缓存的最大权重 expireAfterAccess=[duration]: 最后一次写入或访问后经过固定时间过期 expireAfterWrite=[duration]: 最后一次写入后经过固定时间过期 refreshAfterWrite=[duration]: 创建缓存或者最近一次更新缓存后经过固定的时间间隔,刷新缓存 weakKeys: 打开key的弱引用 weakValues:打开value的弱引用 softValues:打开value的软引用 recordStats:开发统计功能 注意: expireAfterWrite和expireAfterAccess同时存在时,以expireAfterWrite为准。 maximumSize和maximumWeight不可以同时使用 weakValues和softValues不可以同时使用 需要说明的是,使用配置文件的方式来进行缓存项配置,一般情况能满足使用需求,但是灵活性不是很高,如果我们有很多缓存项的情况下写起来会导致配置文件很长。所以一般情况下你也可以选择使用bean的方式来初始化Cache实例。 SpringBoot 有俩种使用 Caffeine 作为缓存的方式: 直接引入 Caffeine 依赖,然后使用 Caffeine 方法实现缓存。 引入 Caffeine 和 Spring Cache 依赖,使用 SpringCache 注解方法实现缓存。 1.直接引入 Caffeine 依赖 Pom <!-- caffeine cache --> <dependency> <groupId>com.github.ben-manes.caffeine</groupId> <artifactId>caffeine</artifactId> <version>2.5.5</version> </dependency> Conf package com.spring.master.spring.caffeine.conf; import com.github.benmanes.caffeine.cache.Cache; import com.github.benmanes.caffeine.cache.Caffeine; import org.springframework.context.annotation.Bean; import org.springframework.context.annotation.Configuration; import java.util.concurrent.TimeUnit; /** * @author Huan Lee * @version 1.0 * @date 2020-09-30 15:54 * @describtion 业精于勤,荒于嬉;行成于思,毁于随。 */ @Configuration public class CaffeineCacheConfig { @Bean public Cache<String, Object> caffeineCache() { return Caffeine.newBuilder() // 设置最后一次写入或访问后经过固定时间过期 .expireAfterWrite(60, TimeUnit.SECONDS) // 初始的缓存空间大小 .initialCapacity(100) // 缓存的最大条数 .maximumSize(1000) .build(); } } Bean package com.spring.master.spring.caffeine.bean; import lombok.Data; import lombok.ToString; /** * @author Huan Lee * @version 1.0 * @date 2020-09-30 15:56 * @describtion 业精于勤,荒于嬉;行成于思,毁于随。 */ @Data @ToString public class UserInfo { private Integer id; private String name; } Service package com.spring.master.spring.caffeine.service; import com.spring.master.spring.caffeine.bean.UserInfo; /** * @author Huan Lee * @version 1.0 * @date 2020-09-30 15:57 * @describtion 业精于勤,荒于嬉;行成于思,毁于随。 */ public interface UserInfoService { /** * 增加用户信息 * * @param userInfo 用户信息 */ void addUserInfo(UserInfo userInfo); /** * 获取用户信息 * * @param id 用户ID * @return 用户信息 */ UserInfo getByName(Integer id); /** * 删除用户信息 * * @param id 用户ID */ void deleteById(Integer id); } Impl package com.spring.master.spring.caffeine.impl; import com.github.benmanes.caffeine.cache.Cache; import com.spring.master.spring.caffeine.bean.UserInfo; import com.spring.master.spring.caffeine.service.UserInfoService; import lombok.extern.slf4j.Slf4j; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.stereotype.Service; import java.util.HashMap; /** * @author Huan Lee * @version 1.0 * @date 2020-09-30 15:57 * @describtion 业精于勤,荒于嬉;行成于思,毁于随。 */ @Service @Slf4j public class UserInfoServiceImpl implements UserInfoService { /** * 模拟数据库存储数据 */ private HashMap<Integer, UserInfo> userInfoMap = new HashMap<>(); @Autowired Cache<String, Object> caffeineCache; @Override public void addUserInfo(UserInfo userInfo) { userInfoMap.put(userInfo.getId(), userInfo); // 加入缓存 caffeineCache.put(String.valueOf(userInfo.getId()),userInfo); } @Override public UserInfo getByName(Integer id) { // 先从缓存读取 caffeineCache.getIfPresent(id); UserInfo userInfo = (UserInfo) caffeineCache.asMap().get(String.valueOf(id)); if (userInfo != null){ System.out.println("Hello, 我来自Caffeine Cache"); return userInfo; } // 如果缓存中不存在,则从库中查找 userInfo = userInfoMap.get(id); System.out.println("Hello, 我来自DataBase"); // 如果用户信息不为空,则加入缓存 if (userInfo != null){ caffeineCache.put(String.valueOf(userInfo.getId()),userInfo); } return userInfo; } @Override public void deleteById(Integer id) { userInfoMap.remove(id); // 从缓存中删除 caffeineCache.asMap().remove(String.valueOf(id)); } } Controller package com.spring.master.spring.caffeine.controller; import com.spring.master.spring.caffeine.bean.UserInfo; import com.spring.master.spring.caffeine.service.UserInfoService; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.http.MediaType; import org.springframework.web.bind.annotation.*; /** * @author Huan Lee * @version 1.0 * @date 2020-09-30 15:59 * @describtion 业精于勤,荒于嬉;行成于思,毁于随。 */ @RequestMapping(value = "/caffeine") @RestController public class CaffeineCacheController { @Autowired private UserInfoService userInfoService; @GetMapping("/userInfo/{id}") public Object getUserInfo(@PathVariable Integer id) { UserInfo userInfo = userInfoService.getByName(id); if (userInfo == null) { return "没有该用户"; } return userInfo; } @RequestMapping(value = "/userInfo") public Object createUserInfo() { UserInfo userInfo = new UserInfo(); userInfo.setId(1); userInfo.setName("HLee"); userInfoService.addUserInfo(userInfo); return "SUCCESS"; } @GetMapping(value = "/delete/{id}") public Object deleteUserInfo(@PathVariable Integer id) { userInfoService.deleteById(id); return "SUCCESS"; } } 启动服务: localhost:2000/spring-master/caffeine/userInfo localhost:2000/spring-master/caffeine/userInfo/1 localhost:2000/spring-master/caffeine/delete/1 2. 引入 Caffeine 和 Spring Cache 依赖 Pom <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-cache</artifactId> </dependency> <dependency> <groupId>com.github.ben-manes.caffeine</groupId> <artifactId>caffeine</artifactId> </dependency> Conf @Configuration public class CacheConfig { /** * 配置缓存管理器 * * @return 缓存管理器 */ @Bean("caffeineCacheManager") public CacheManager cacheManager() { CaffeineCacheManager cacheManager = new CaffeineCacheManager(); cacheManager.setCaffeine(Caffeine.newBuilder() // 设置最后一次写入或访问后经过固定时间过期 .expireAfterAccess(60, TimeUnit.SECONDS) // 初始的缓存空间大小 .initialCapacity(100) // 缓存的最大条数 .maximumSize(1000)); return cacheManager; } } Bean package com.spring.master.spring.caffeine.bean; import lombok.Data; import lombok.ToString; /** * @author Huan Lee * @version 1.0 * @date 2020-09-30 15:56 * @describtion 业精于勤,荒于嬉;行成于思,毁于随。 */ @Data @ToString public class UserInfo { private Integer id; private String name; } Service package com.spring.master.spring.caffeine.service; import com.spring.master.spring.caffeine.bean.UserInfo; /** * @author Huan Lee * @version 1.0 * @date 2020-09-30 15:57 * @describtion 业精于勤,荒于嬉;行成于思,毁于随。 */ public interface UserInfoService { /** * 增加用户信息 * * @param userInfo 用户信息 */ void addUserInfo(UserInfo userInfo); /** * 获取用户信息 * * @param id 用户ID * @return 用户信息 */ UserInfo getByName(Integer id); /** * 删除用户信息 * * @param id 用户ID */ void deleteById(Integer id); } Impl import lombok.extern.slf4j.Slf4j; import mydlq.club.example.entity.UserInfo; import mydlq.club.example.service.UserInfoService; import org.springframework.cache.annotation.CacheConfig; import org.springframework.cache.annotation.CacheEvict; import org.springframework.cache.annotation.CachePut; import org.springframework.cache.annotation.Cacheable; import org.springframework.stereotype.Service; import org.springframework.util.StringUtils; import java.util.HashMap; @Slf4j @Service @CacheConfig(cacheNames = "caffeineCacheManager") public class UserInfoServiceImpl implements UserInfoService { /** * 模拟数据库存储数据 */ private HashMap<Integer, UserInfo> userInfoMap = new HashMap<>(); @Override @CachePut(key = "#userInfo.id") public void addUserInfo(UserInfo userInfo) { userInfoMap.put(userInfo.getId(), userInfo); } @Override @Cacheable(key = "#id") public UserInfo getByName(Integer id) { return userInfoMap.get(id); } @Override @CachePut(key = "#userInfo.id") public UserInfo updateUserInfo(UserInfo userInfo) { if (!userInfoMap.containsKey(userInfo.getId())) { return null; } // 取旧的值 UserInfo oldUserInfo = userInfoMap.get(userInfo.getId()); // 替换内容 if (!StringUtils.isEmpty(oldUserInfo.getAge())) { oldUserInfo.setAge(userInfo.getAge()); } if (!StringUtils.isEmpty(oldUserInfo.getName())) { oldUserInfo.setName(userInfo.getName()); } if (!StringUtils.isEmpty(oldUserInfo.getSex())) { oldUserInfo.setSex(userInfo.getSex()); } // 将新的对象存储,更新旧对象信息 userInfoMap.put(oldUserInfo.getId(), oldUserInfo); // 返回新对象信息 return oldUserInfo; } @Override @CacheEvict(key = "#id") public void deleteById(Integer id) { userInfoMap.remove(id); } } Controller @RestController @RequestMapping public class UserInfoController { @Autowired private UserInfoService userInfoService; @GetMapping("/userInfo/{id}") public Object getUserInfo(@PathVariable Integer id) { UserInfo userInfo = userInfoService.getByName(id); if (userInfo == null) { return "没有该用户"; } return userInfo; } @PostMapping("/userInfo") public Object createUserInfo(@RequestBody UserInfo userInfo) { userInfoService.addUserInfo(userInfo); return "SUCCESS"; } @PostMapping("/updateInfo") public Object updateUserInfo(@RequestBody UserInfo userInfo) { UserInfo newUserInfo = userInfoService.updateUserInfo(userInfo); if (newUserInfo == null){ return "不存在该用户"; } return newUserInfo; } @GetMapping("/delete/{id}") public Object deleteUserInfo(@PathVariable Integer id) { userInfoService.deleteById(id); return "SUCCESS"; } }

优秀的个人博客,低调大师

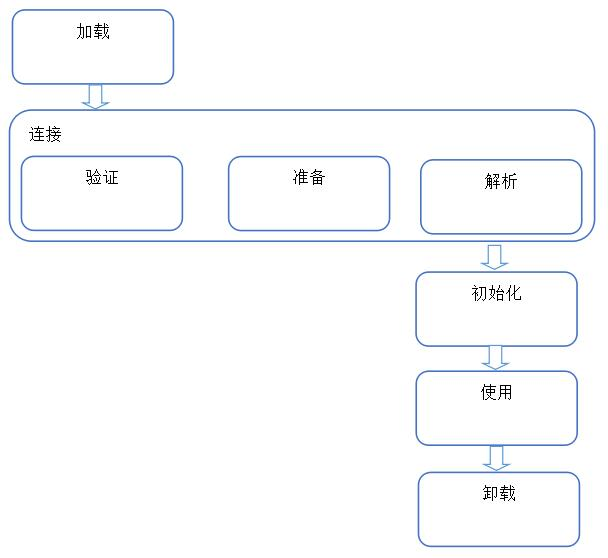
类的加载机制

目录介绍 01.Java对象的创建过程 1.0 看下创建类加载过程 1.1 对象的创建 1.2 对象的内存布局 02.Java内存区域 2.0 运行时数据区域 2.1 程序计数器 2.2 虚拟机栈 2.3 本地方法栈 2.4 Java堆 2.5 方法区 2.6 运行时常量池 2.7 直接内存 03.Java对象的访问定位方式 3.1 句柄 3.2 直接指针 04.Java对象销毁分析 4.1 JVM内存分配与回收 4.2 判断对象是否死亡 4.3 不可达的对象并非“非死不可” 4.4 如何判断一个常量是废弃常量 4.5 如何判断一个类是无用的类 4.6 GC回收算法详解 05.String类和常量池 5.1 String对象的两种创建方式 5.2 String类型的常量池 好消息 博客笔记大汇总【16年3月到至今】,包括Java基础及深入知识点,Android技术博客,Python学习笔记等等,还包括平时开发中遇到的bug汇总,当然也在工作之余收集了大量的面试题,长期更新维护并且修正,持续完善……开源的文件是markdown格式的!同时也开源了生活博客,从12年起,积累共计47篇[近20万字],转载请注明出处,谢谢! 链接地址:https://github.com/yangchong211/YCBlogs 如果觉得好,可以star一下,谢谢!当然也欢迎提出建议,万事起于忽微,量变引起质变! 问题思考答疑 说一下创建一个对象,类的加载过程。类信息,常量,变量,方法分别放到内存中哪里? 对于运行时数据区域,哪些是私有的,哪些是共享的,为什么要这样设计? 程序计数器会出现OOM吗?它的生命周期是怎么样的? 本地方法栈和Java虚拟机栈有什么区别?本地方法栈在什么情况下会造成OOM? java堆主要是做什么作用的? 什么是类的加载检查,主要检查什么,如何检查呢? Java对象访问定位方式有哪些?主要有什么区别?为什么说使用指针效率更高? String类可以new吗?直接new和赋值的内容有什么区别,分别放在内存中什么地方? 如何判断对象是否死亡(两种方法)。如果有不同方法,那么之间有什么区别? 简单的介绍一下强引用、软引用、弱引用、虚引用(虚引用与软引用和弱引用的区别、使用软引用能带来的好处)。 如何判断一个常量是废弃常量,如何判断一个类是无用的类? 垃圾收集有哪些算法,各自的特点?常见的垃圾回收器有那些? HotSpot为什么要分为新生代和老年代? 介绍一下CMS,G1收集器。Minor Gc和Full GC 有什么不同呢? 01.Java对象的创建过程 1.1 看下创建类加载过程 Person p = new Person()请写一下类的加载过程? 1).因为new用到了Person.class,所以会先找到Person.class文件,并加载到内存中; 2).执行该类中的static代码块,如果有的话,给Person.class类进行初始化; 3).在堆内存中开辟空间分配内存地址; 4).在堆内存中建立对象的特有属性,并进行默认初始化; 5).对属性进行显示初始化; 6).对对象进行构造代码块初始化; 7).对对象进行与之对应的构造函数进行初始化; 8).将内存地址付给栈内存中的p变量 1.1 对象的创建 Java对象的创建过程,我建议最好是能默写出来,并且要掌握每一步在做什么。 1.类加载检查 2.分配内存 3.初始化零值 4.设置对象头 5.执行init方法 ①类加载检查: 虚拟机遇到一条 new 指令时,首先将去检查这个指令的参数是否能在常量池中定位到这个类的符号引用,并且检查这个符号引用代表的类是否已被加载过、解析和初始化过。如果没有,那必须先执行相应的类加载过程。 ②分配内存: 在类加载检查通过后,接下来虚拟机将为新生对象分配内存。对象所需的内存大小在类加载完成后便可确定,为对象分配空间的任务等同于把一块确定大小的内存从 Java 堆中划分出来。分配方式有 “指针碰撞” 和 “空闲列表” 两种,选择那种分配方式由 Java 堆是否规整决定,而Java堆是否规整又由所采用的垃圾收集器是否带有压缩整理功能决定。 内存分配的两种方式: 选择以上两种方式中的哪一种,取决于 Java 堆内存是否规整。而 Java 堆内存是否规整,取决于 GC 收集器的算法是"标记-清除",还是"标记-整理"("标记-压缩"),值得注意的是,复制算法内存也是规整的 内存分配并发问题 在创建对象的时候有一个很重要的问题,就是线程安全,因为在实际开发过程中,创建对象是很频繁的事情,作为虚拟机来说,必须要保证线程是安全的,通常来讲,虚拟机采用两种方式来保证线程安全: CAS+失败重试: CAS 是乐观锁的一种实现方式。所谓乐观锁就是,每次不加锁而是假设没有冲突而去完成某项操作,如果因为冲突失败就重试,直到成功为止。虚拟机采用 CAS 配上失败重试的方式保证更新操作的原子性。 TLAB: 为每一个线程预先在Eden区分配一块儿内存,JVM在给线程中的对象分配内存时,首先在TLAB分配,当对象大于TLAB中的剩余内存或TLAB的内存已用尽时,再采用上述的CAS进行内存分配 ③初始化零值: 内存分配完成后,虚拟机需要将分配到的内存空间都初始化为零值(不包括对象头),这一步操作保证了对象的实例字段在 Java 代码中可以不赋初始值就直接使用,程序能访问到这些字段的数据类型所对应的零值。 ④设置对象头: 初始化零值完成之后,虚拟机要对对象进行必要的设置,例如这个对象是那个类的实例、如何才能找到类的元数据信息、对象的哈希吗、对象的 GC 分代年龄等信息。 这些信息存放在对象头中。 另外,根据虚拟机当前运行状态的不同,如是否启用偏向锁等,对象头会有不同的设置方式。 ⑤执行 init 方法: 在上面工作都完成之后,从虚拟机的视角来看,一个新的对象已经产生了,但从 Java 程序的视角来看,对象创建才刚开始,<init> 方法还没有执行,所有的字段都还为零。所以一般来说,执行 new 指令之后会接着执行 <init> 方法,把对象按照程序员的意愿进行初始化,这样一个真正可用的对象才算完全产生出来。 1.2 对象的内存布局 在 Hotspot 虚拟机中,对象在内存中的布局可以分为3快区域:对象头、实例数据和对齐填充。 Hotspot虚拟机的对象头包括两部分信息,第一部分用于存储对象自身的自身运行时数据(哈希吗、GC分代年龄、锁状态标志等等),另一部分是类型指针,即对象指向它的类元数据的指针,虚拟机通过这个指针来确定这个对象是那个类的实例。 实例数据部分是对象真正存储的有效信息,也是在程序中所定义的各种类型的字段内容。 对齐填充部分不是必然存在的,也没有什么特别的含义,仅仅起占位作用。 因为Hotspot虚拟机的自动内存管理系统要求对象起始地址必须是8字节的整数倍,换句话说就是对象的大小必须是8字节的整数倍。而对象头部分正好是8字节的倍数(1倍或2倍),因此,当对象实例数据部分没有对齐时,就需要通过对齐填充来补全。 02.Java内存区域 2.0 运行时数据区域 Java 虚拟机在执行 Java 程序的过程中会把它管理的内存划分成若干个不同的数据区域。 这些组成部分一些事线程私有的,其他的则是线程共享的。 线程私有的: 程序计数器 虚拟机栈 本地方法栈 线程共享的: Java堆 方法区 运行时常量池 直接内存 2.1 程序计数器 程序计数器:是一个数据结构,用于保存当前正常执行的程序的内存地址。Java虚拟机的多线程就是通过线程轮流切换并分配处理器时间来实现的,为了线程切换后能恢复到正确的位置,每条线程都需要一个独立的程序计数器,互不影响,该区域为“线程私有”。 程序计数器是一块较小的内存空间,可以看作是当前线程所执行的字节码的行号指示器。字节码解释器工作时通过改变这个计数器的值来选取下一条需要执行的字节码指令,分支、循环、跳转、异常处理、线程恢复等功能都需要依赖这个计数器来完。 程序计数器主要有两个作用: 1.字节码解释器通过改变程序计数器来依次读取指令,从而实现代码的流程控制,如:顺序执行、选择、循环、异常处理。 2.在多线程的情况下,程序计数器用于记录当前线程执行的位置,从而当线程被切换回来的时候能够知道该线程上次运行到哪儿。 注意:程序计数器是唯一一个不会出现OutOfMemoryError的内存区域,它的生命周期随着线程的创建而创建,随着线程的结束而死亡。 2.2 虚拟机栈 Java虚拟机栈:线程私有的,与线程生命周期相同,用于存储局部变量表,操作栈,方法返回值。局部变量表放着基本数据类型,还有对象的引用。 Java 内存可以粗糙的区分为堆内存(Heap)和栈内存(Stack),其中栈就是现在说的虚拟机栈,或者说是虚拟机栈中局部变量表部分。(实际上,Java虚拟机栈是由一个个栈帧组成,而每个栈帧中都拥有:局部变量表、操作数栈、动态链接、方法出口信息。) 局部变量表主要存放了编译器可知的各种数据类型(boolean、byte、char、short、int、float、long、double)、对象引用(reference类型,它不同于对象本身,可能是一个指向对象起始地址的引用指针,也可能是指向一个代表对象的句柄或其他与此对象相关的位置)。 Java 虚拟机栈会出现两种异常:StackOverFlowError 和 OutOfMemoryError。 StackOverFlowError: 若Java虚拟机栈的内存大小不允许动态扩展,那么当线程请求栈的深度超过当前Java虚拟机栈的最大深度的时候,就抛出StackOverFlowError异常。 OutOfMemoryError: 若Java虚拟机栈的内存大小允许动态扩展,且当线程请求栈时内存用完了,无法再动态扩展了,此时抛出OutOfMemoryError异常。 Java 虚拟机栈也是线程私有的,每个线程都有各自的Java虚拟机栈,而且随着线程的创建而创建,随着线程的死亡而死亡。 2.3 本地方法栈 本地方法栈:跟虚拟机栈很像, 虚拟机栈为虚拟机执行 Java 方法 (也就是字节码)服务,而本地方法栈则为虚拟机使用到的 Native 方法服务。 在 HotSpot 虚拟机中和 Java 虚拟机栈合二为一。 本地方法被执行的时候,在本地方法栈也会创建一个栈帧,用于存放该本地方法的局部变量表、操作数栈、动态链接、出口信息。 方法执行完毕后相应的栈帧也会出栈并释放内存空间,也会出现 StackOverFlowError 和 OutOfMemoryError 两种异常。 2.4 Java堆 Java堆:所有线程共享的一块内存区域,此内存区域的唯一目的就是存放对象实例,对象实例几乎都在这分配内存。在虚拟机启动时创建。 Java 堆是垃圾收集器管理的主要区域,因此也被称作GC堆(Garbage Collected Heap).从垃圾回收的角度,由于现在收集器基本都采用分代垃圾收集算法,所以Java堆还可以细分为:新生代和老年代:在细致一点有:Eden空间、From Survivor、To Survivor空间等。进一步划分的目的是更好地回收内存,或者更快地分配内存。 在 JDK 1.8中移除整个永久代,取而代之的是一个叫元空间(Metaspace)的区域(永久代使用的是JVM的堆内存空间,而元空间使用的是物理内存,直接受到本机的物理内存限制)。 2.5 方法区 方法区:各个线程共享的区域,储存虚拟机加载的类信息,常量,静态变量,编译后的代码。 虽然Java虚拟机规范把方法区描述为堆的一个逻辑部分,但是它却有一个别名叫做 Non-Heap(非堆),目的应该是与 Java 堆区分开来。 相对而言,垃圾收集行为在这个区域是比较少出现的,但并非数据进入方法区后就“永久存在”了。如何理解这句话? 2.6 运行时常量池 运行时常量池:代表运行时每个class文件中的常量表。包括几种常量:编译时的数字常量、方法或者域的引用。 。Class 文件中包括类的版本、字段、方法、接口等描述信息 既然运行时常量池时方法区的一部分,自然受到方法区内存的限制,当常量池无法再申请到内存时会抛出 OutOfMemoryError 异常。JDK1.7及之后版本的 JVM已经将运行时常量池从方法区中移了出来,在Java堆(Heap)中开辟了一块区域存放运行时常量池。 2.7 直接内存 直接内存并不是虚拟机运行时数据区的一部分,也不是虚拟机规范中定义的内存区域,但是这部分内存也被频繁地使用。而且也可能导致OutOfMemoryError异常出现。 JDK1.4中新加入的 NIO(New Input/Output) 类,引入了一种基于通道(Channel) 与缓存区(Buffer) 的 I/O 方式,它可以直接使用Native函数库直接分配堆外内存,然后通过一个存储在 Java 堆中的 DirectByteBuffer 对象作为这块内存的引用进行操作。这样就能在一些场景中显著提高性能,因为避免了在 Java 堆和 Native 堆之间来回复制数据。 本机直接内存的分配不会收到 Java 堆的限制,但是,既然是内存就会受到本机总内存大小以及处理器寻址空间的限制。 03.Java对象的访问定位方式 建立对象就是为了使用对象,我们的Java程序通过栈上的 reference 数据来操作堆上的具体对象。对象的访问方式有虚拟机实现而定 目前主流的访问方式有 ①使用句柄 ②直接指针 这两种对象访问方式各有优势。 使用句柄来访问的最大好处是 reference 中存储的是稳定的句柄地址,在对象被移动时只会改变句柄中的实例数据指针,而 reference 本身不需要修改。 使用直接指针访问方式最大的好处就是速度快,它节省了一次指针定位的时间开销。 3.1 句柄 如果使用句柄的话,那么Java堆中将会划分出一块内存来作为句柄池,reference 中存储的就是对象的句柄地址,而句柄中包含了对象实例数据与类型数据各自的具体地址信息; 3.2 直接指针 如果使用直接指针访问,那么 Java 堆对像的布局中就必须考虑如何放置访问类型数据的相关信息,而reference 中存储的直接就是对象的地址。 04.Java对象销毁分析 思考一下,更多可以参考我的博客:https://github.com/yangchong211/YCBlogs 4.1 JVM内存分配与回收 Java 的自动内存管理主要是针对对象内存的回收和对象内存的分配。同时,Java 自动内存管理最核心的功能是 堆 内存中对象的分配与回收。 JDK1.8之前的堆内存示意图: 从上图可以看出堆内存的分为新生代、老年代和永久代。新生代又被进一步分为:Eden 区+Survior1 区+Survior2 区。值得注意的是,在JDK1.8中移除整个永久代,取而代之的是一个叫元空间(Metaspace)的区域(永久代使用的是JVM的堆内存空间,而元空间使用的是物理内存,直接受到本机的物理内存限制)。 分代回收算法 目前主流的垃圾收集器都会采用分代回收算法,因此需要将堆内存分为新生代和老年代,这样我们就可以根据各个年代的特点选择合适的垃圾收集算法。 大多数情况下,对象在新生代中 eden 区分配。当 eden 区没有足够空间进行分配时,虚拟机将发起一次Minor GC。 Minor Gc和Full GC 有什么不同呢? 新生代GC(Minor GC):指发生新生代的的垃圾收集动作,Minor GC非常频繁,回收速度一般也比较快。 老年代GC(Major GC/Full GC):指发生在老年代的GC,出现了Major GC经常会伴随至少一次的Minor GC(并非绝对),Major GC的速度一般会比Minor GC的慢10倍以上。 4.2 判断对象是否死亡 堆中几乎放着所有的对象实例,对堆垃圾回收前的第一步就是要判断那些对象已经死亡(即不能再被任何途径使用的对象)。 4.2.1 引用计数法 给对象中添加一个引用计数器,每当有一个地方引用它,计数器就加1;当引用失效,计数器就减1;任何时候计数器为0的对象就是不可能再被使用的。 这个方法实现简单,效率高,但是目前主流的虚拟机中并没有选择这个算法来管理内存,其最主要的原因是它很难解决对象之间相互循环引用的问题。 所谓对象之间的相互引用问题,如下面代码所示:除了对象objA和objB相互引用着对方之外,这两个对象之间再无任何引用。但是他们因为互相引用对方,导致它们的引用计数器都不为0,于是引用计数算法无法通知 GC 回收器回收他们。 public class Test { Object instance = null; public static void main(String[] args) { Test objA = new Test(); Test objB = new Test(); objA.instance = objB; objB.instance = objA; objA = null; objB = null; } } 4.2.2 可达性分析算法 这个算法的基本思想就是通过一系列的称为 “GC Roots” 的对象作为起点,从这些节点开始向下搜索,节点所走过的路径称为引用链,当一个对象到 GC Roots 没有任何引用链相连的话,则证明此对象是不可用的。 4.2.3 再谈引用 无论是通过引用计数法判断对象引用数量,还是通过可达性分析法判断对象的引用链是否可达,判定对象的存活都与“引用”有关。 JDK1.2以后,Java对引用的概念进行了扩充,将引用分为强引用、软引用、弱引用、虚引用四种(引用强度逐渐减弱) 关于四种引用以及源代码分析,可以看我的这篇文章:https://blog.csdn.net/m0_37700275/article/details/79820814 4.3 不可达的对象并非“非死不可” 即使在可达性分析法中不可达的对象,也并非是“非死不可”的,这时候它们暂时处于“缓刑阶段”,要真正宣告一个对象死亡,至少要经历两次标记过程;可达性分析法中不可达的对象被第一次标记并且进行一次筛选,筛选的条件是此对象是否有必要执行 finalize 方法。当对象没有覆盖 finalize 方法,或 finalize 方法已经被虚拟机调用过时,虚拟机将这两种情况视为没有必要执行。 被判定为需要执行的对象将会被放在一个队列中进行第二次标记,除非这个对象与引用链上的任何一个对象建立关联,否则就会被真的回收。 4.4 如何判断一个常量是废弃常量 4.5 如何判断一个类是无用的类 方法区主要回收的是无用的类,那么如何判断一个类是无用的类的呢?要判定一个类是否是“无用的类”的条件则相对苛刻许多。类需要同时满足下面3个条件才能算是 “无用的类” : 该类所有的实例都已经被回收,也就是 Java 堆中不存在该类的任何实例。 加载该类的 ClassLoader 已经被回收。 该类对应的 java.lang.Class 对象没有在任何地方被引用,无法在任何地方通过反射访问该类的方法。 虚拟机可以对满足上述3个条件的无用类进行回收,这里说的仅仅是“可以”,而并不是和对象一样不使用了就会必然被回收。 4.6 GC回收算法详解 这个可以看我的另外一篇文章:https://blog.csdn.net/m0_37700275/article/details/78493364 05.String类和常量池 5.1 String对象的两种创建方式 1 String 对象的两种创建方式: String str1 = "abcd"; String str2 = new String("abcd"); System.out.println(str1==str2);//false 这两种不同的创建方法是有差别的【记住:只要使用new方法,便需要创建新的对象】 第一种方式是在常量池中拿对象 第二种方式是直接在堆内存空间创建一个新的对象。 5.2 String类型的常量池 String 类型的常量池比较特殊。它的主要使用方法有两种: 直接使用双引号声明出来的 String 对象会直接存储在常量池中。 如果不是用双引号声明的 String 对象,可以使用 String 提供的 intern 方String.intern() 是一个 Native 方法,它的作用是:如果运行时常量池中已经包含一个等于此 String 对象内容的字符串,则返回常量池中该字符串的引用;如果没有,则在常量池中创建与此 String 内容相同的字符串,并返回常量池中创建的字符串的引用。 String s1 = new String("yc"); String s2 = s1.intern(); String s3 = "yc"; System.out.println(s2);//yc System.out.println(s1 == s2);//false,因为一个是堆内存中的String对象一个是常量池中的String对象, System.out.println(s3 == s2);//true,因为两个都是常量池中的String对 关于其他内容介绍 01.关于博客汇总链接 1.技术博客汇总 2.开源项目汇总 3.生活博客汇总 4.喜马拉雅音频汇总 5.其他汇总 02.关于我的博客 我的个人站点:www.yczbj.org,www.ycbjie.cn github:https://github.com/yangchong211 知乎:https://www.zhihu.com/people/yang-chong-69-24/pins/posts 简书:http://www.jianshu.com/u/b7b2c6ed9284 csdn:http://my.csdn.net/m0_37700275 喜马拉雅听书:http://www.ximalaya.com/zhubo/71989305/ 开源中国:https://my.oschina.net/zbj1618/blog 泡在网上的日子:http://www.jcodecraeer.com/member/content_list.php?channelid=1 邮箱:yangchong211@163.com 阿里云博客:https://yq.aliyun.com/users/article?spm=5176.100- 239.headeruserinfo.3.dT4bcV segmentfault头条:https://segmentfault.com/u/xiangjianyu/articles

优秀的个人博客,低调大师

RocketMQ底层通信机制

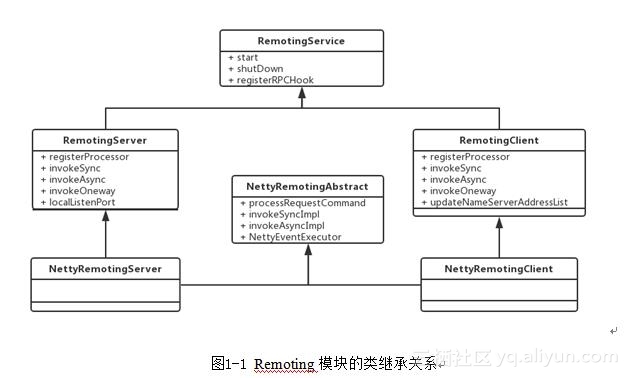
分布式系统各个角色间的通信效率很关键,通信效率的高低直接影响系统性能,基于Socket实现一个高效的Tcp通信协议是个很有挑战的事情,本节说明RocketMQ是如何解决这个问题的 1.1.1 Remoting模块RocketMQ的通信相关代码在Remoting模块里,先来看看主要类结构。 RemotingService为最上层接口,定义了三个方法:void start();void shutdown();void registerRPCHook(RPCHook rpcHook);RemotingClient,RemotingServer继承RemotingService接口, 并增加了自己特有的方法。代码清单1-1 RemotingClient主要函数定义void registerProcessor(final int requestCode, final NettyRequestProcessor processor,final ExecutorService executor);RemotingCommand invokeSync(final String addr, final RemotingCommand request, final long timeoutMillis);void invokeAsync(final String addr, final RemotingCommand request, final long timeoutMillis,final InvokeCallback invokeCallback);void invokeOneway(final String addr, final RemotingCommand request, final long timeoutMillis);void updateNameServerAddressList(final List addrs); 然后看看具体的实现类,NettyRemotingClient和NettyRemotingServer分别实现了RemotingClient和RemotingServer, 而且都继承了NettyRemotingAbstract类. 通过上面的封装,RocketMQ各个模块间的通信,可以通过发送统一格式的自定义消息(RemotingCommand)来完成的,各个模块间的通信实现简洁明了。比如NameServer模块中,NameServerController有个remotingServer变量,NameServer在启动时初始化好各个变量,然后启动remotingServer即可,剩下NameServer要做的是专心实现好处理RemotingCommand的逻辑。代码清单1-2 NameServer处理主流程代码@Overridepublic RemotingCommand processRequest(ChannelHandlerContext ctx, RemotingCommand request) throws RemotingCommandException { if (log.isDebugEnabled()) { log.debug("receive request, {} {} {}", request.getCode(), RemotingHelper.parseChannelRemoteAddr(ctx.channel()), request); } switch (request.getCode()) { case RequestCode.PUT_KV_CONFIG: return this.putKVConfig(ctx, request); case RequestCode.GET_KV_CONFIG: return this.getKVConfig(ctx, request); case RequestCode.DELETE_KV_CONFIG: return this.deleteKVConfig(ctx, request); case RequestCode.REGISTER_BROKER: Version brokerVersion = MQVersion.value2Version(request.getVersion()); if (brokerVersion.ordinal() >= MQVersion.Version.V3_0_11.ordinal()) { return this.registerBrokerWithFilterServer(ctx, request); } else { return this.registerBroker(ctx, request); } case RequestCode.GET_HAS_UNIT_SUB_UNUNIT_TOPIC_LIST: return this.getHasUnitSubUnUnitTopicList(ctx, request); case RequestCode.UPDATE_NAMESRV_CONFIG: return this.updateConfig(ctx, request); case RequestCode.GET_NAMESRV_CONFIG: return this.getConfig(ctx, request); default: break; } return null; }在Consumer的源码中,获取消息的底层的通信部分也是发送一个RemotingComand 请求,返回的response也是个RemotingCommand类型。代码清单1-3 Consumer请求消息底层实现代码private PullResult pullMessageSync(// final String addr, // 1 final RemotingCommand request, // 2 final long timeoutMillis// 3 ) throws RemotingException, InterruptedException, MQBrokerException { RemotingCommand response = this.remotingClient.invokeSync(addr, request, timeoutMillis); assert response != null; return this.processPullResponse(response); }从源码中可以看出,RocketMQ中复杂的通信过程,被RemotingCommand统一起来,大部分的逻辑都是通过发送Command,接受并处理Command完成。1.1.2 协议设计和编解码RocketMQ自己定义了一个通信协议,使得模块间传输的二进制消息和有意义的内容之间互相转换。协议格式如图4-2所示。 图1-2 RocketMQ的通信协议 (1)第一部分是大端4个字节整数,值等于第二,三,四部分长度总和 (2)第二部分是大端4个字节整数,值等于第三部分的长度 (3)第三部分是通过json 序列化的数据 (4)第四部分是通过应用自定义二进制序列化的数据 消息的解码过程在RomotingCommand的decode函数里。 代码清单1-4 消息解码函数 public static RemotingCommand decode(final ByteBuffer byteBuffer) { int length = byteBuffer.limit(); int oriHeaderLen = byteBuffer.getInt(); int headerLength = getHeaderLength(oriHeaderLen); byte[] headerData = new byte[headerLength]; byteBuffer.get(headerData); RemotingCommand cmd = headerDecode(headerData, getProtocolType(oriHeaderLen)); int bodyLength = length - 4 - headerLength; byte[] bodyData = null; if (bodyLength > 0) { bodyData = new byte[bodyLength]; byteBuffer.get(bodyData); } cmd.body = bodyData; return cmd; }对应的消息编码过程在RemotingCommand的encode函数中。代码清单1-5 消息编码函数public ByteBuffer encode() { // 1> header length size int length = 4; // 2> header data length byte[] headerData = this.headerEncode(); length += headerData.length; // 3> body data length if (this.body != null) { length += body.length; } ByteBuffer result = ByteBuffer.allocate(4 + length); // length result.putInt(length); // header length result.put(markProtocolType(headerData.length, serializeTypeCurrentRPC)); // header data result.put(headerData); // body data; if (this.body != null) { result.put(this.body); } result.flip(); return result; } 1.1.3 Netty库RocketMQ是基于Netty库来完成RemotingServer和RemotingClient具体的通信实现的,Netty是个事件驱动的网络编程框架,它屏蔽了Java Socket,Nio等复杂细节,用户只需用好Netty,就可以实现一个网络编程专家+并发编程专家水平的Server、Client网络程序。应用Netty有一定的门槛,需要了解它的EventLoopGroup,Channel,Handler模型以及各种具体的配置。RocketMQ利用Netty实现的通信类是NettyRemotingServer和NettyRemotingClient,用户也可以参考这两个类的实现来学习使用Netty。 推荐阅读: 云栖社区官方出品 RocketMQ实战与原理解析作者:杨开元定价:59.00元•RocketMQ由阿里开源,Apache开源项目,经受多年流量峰值考验,在多个性能指标上远超同类产品•作者是阿里资深数据专家,有多年RocketMQ使用经验,深入研究RocketMQ源代码,写作前与RocketMQ官方团队有深入沟通•云栖社区官方出品,得到RocketMQ官方研发团队以及业界的多位专家的肯定和推荐 阅读原文:http://product.dangdang.com/25290633.html

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册