首页 文章 精选 留言 我的

精选列表

搜索[腾讯极客挑战赛],共10001篇文章
优秀的个人博客,低调大师

牛客网学习笔记-day01

Java修饰符大小 public>protected>default>private final方法不等同于private方法 虽然类中的private方法都隐式地指定为final,但是二者并不是等同的。private是访问权限修饰符,用于控制外界对类内部成员的访问,private方法只能在类的内部访问,而final方法可以在类外部访问 final修饰类,表示类不可被继承 final修饰变量,表示变量不可更改 final修饰方法,表示方法不可被覆盖 方法重写原则(两同两小一大) 方法名相同,参数类型相同 子类返回类型小于等于父类方法返回类型 子类抛出异常小于等于父类方法抛出异常 子类访问权限大于等于父类方法访问权限 IO流 System.out.println含义 System是java.lang包下的一个类 out是System类的一个final静态成员(public final static PrintStream out = null;) println()是PrintStream类的实例方法 静态代码块、构造方法、代码块执行顺序 父类静态代码块->子类静态代码块->父类非静态代码块->父类构造方法->子类非静态代码块->子类构造方法 原因分析:当实例化子类对象是,首先加载父类的class文件到内存中,静态代码块随着类的创建而执行,所以父类静态代码块最先被执行,子类class文件再被加载,子类静态代码块被执行;实例化子类对象要先调用父类的构造方法,而调用父类构造方法前会先调用父类的非静态代码块 匿名内部类 创建格式: new 父类构造器(参数列表)|实现接口() { //匿名内部类的类体部分 } 使用匿名内部类时,必须继承一个类或实现一个接口 匿名内部类由于没有名字,因此不能定义构造函数 匿名内部类不能含有静态成员变量和静态方法 匿名内部类的方法不能是抽象的

优秀的个人博客,低调大师

传智播客C++学习感悟

楼主在本文中将说到C++的学习方式以及亲身经历。本文内容不仅仅限于C++学员,对于那些有意向来学习技术的、或刚来不久、或处在迷茫期的同学可以一同看下,希望在这里楼主能帮到你们什么。 [目录]:1、作为一个程序员必备的心理素质2、学习中的困扰与技能提高方式3、生活中你可能会遇到的一些困扰4、楼主接触过的讲师以及对老师的个人见解5、楼主个人在传智所遇到的一些事与感悟 1、作为一个程序员必备的心理素质 楼主在准备做程序员之前是做游戏工作室的,看着身边的大牛写个程序月入几万、几十万,很是羡慕。所以在15年中旬解散了工作室,前来传智学习。当然,要准备做一个程序员,你要考虑好自己是否能成为一个合格的程序员(入门级)。 1)忍耐与毅力 你是否已经准备好面对熬夜、加班、咖啡、手机24小时开机、天书一样枯燥的代码?做程序员不是一件轻松的事,你可能只看到了程序员整天面对电脑就能有着丰富的薪水,舒服的工作环境,但是!如果想成为一个标准的程序员,你必须付出比这些多N倍的付出。 要学会如何去阅读英文文档(不要说你不用,有时候英文文档是救你一命的稻草); 要在别人愉快玩耍的时候自己依然在电脑前反复的去调试BUG; 当女朋友要求你逛街、过节、看电影时,你却离不开工作岗位; 当别人三四十岁满面红光时,你却秃了头顶白了头发(说严重了,但是有可能); 当你的朋友愉快的打游戏时,还要一遍遍的巩固知识,提高自己; 熬到半夜你突然发现身边陪你的只有香烟、咖啡、代码。 2)学习能力与解决问题的能力 诚然,一个普通的程序员只要知道代码怎么写就可以了,但是做一个好的程序员,你务必要有良好的学习能力,在职场生涯中你所做的并不会如你所想的去做你精通的事。这时候就需要你强大的学习能力,在这个每天一个新概念的社会,如果你放弃了学习,那么你离离职也就不远了。 在学习过程中以及职场生涯中你会遇到一系列奇葩的问题,你要知道怎么去解决,遇到BUG怎么去解决,遇到一个新的知识体系你如何去接触、去理解。 3)心理素质 程序员是枯燥的,是乏味的(如果不信的话可以去搜程序员冷笑话),同时程序员也是寂寞的。 当你真正学完的时候,你会发现你可能跟以前的朋友完全交流不了,而不管你做到什么位置,在长辈眼里你也只是一个修电脑的。 在熬夜、调BUG、攻克项目的时候,你累成狗却没人能知道。 当然,我这里可能说的比较严重了,但是想要成为一个程序员,请务必要对以上有所准备。毕竟好多事是无法避免的,你要学会如何去接受。 2、学习中的困扰与技能提高方式 在传智的学习生涯中,楼主也遇到了一系列的困扰,在这里跟大家分享一下: 1)代码看不懂 很多时候,当老师行云流水一般的敲出代码,然而,自己却像看天书一样,请不要怀疑自己,传智填鸭式教学,你只需要记住代码就好了。在晚自习的时候,拿出代码,把老师讲的东西,打开画图工具去理一理。比如:链表是如何连接的,程序是怎么循环的......一般的问题在画图中就会解决,如果遇到了画图都解决不了的问题,请直接背代码,背住了,在以后有闲暇之余就拿出来看看,通过知识的积累去慢慢的消化,一口气吃不了一个胖子。当你脑容量不够的时候,你自然无法理解(千万不要钻牛角尖!)(千万不要钻牛角尖!)(千万不要钻牛角尖!)如果你钻牛角尖了,那么你会崩溃的一塌涂地。 2)我明明按照老师代码抄下来的,怎么就无法运行呢? 你要知道,老师的水准比你高出N多倍,如果在你字符没有敲错的情况下,请查看你代码的先后顺序是否正确,抄的是否是正确代码(老师上课有时候会举错误代码作为警告示范),如果你确定你的字符抄正确了,那么请检查你的缩进、空格、与标点符号吧。 楼主在学python的时候,少了一个缩进,得到的结果天差地别。 3)为什么别人好多东西都知道,自己像个白痴一样? 学生之间水平参差不齐,请不要有自卑感,努力学就行了,有的同学计算机科班出身,自然懂得多,只要你努力,你自然会超过他。 如果说你们学的知识是一样的,那么,请闲暇时间给自己来一次大的复习吧。学的东西太多,不复习你会忘光的。 4)我该看什么书,该买什么书? 在学习中,老师会推荐你一些书籍,但是相信我,请不要老师说什么,你就去买什么。 你买了会看么?你看了会懂么?你手头有PDF么?你会把这本书看上三遍以上么? 如果达不到,请找PDF格式的自己偶尔看吧,毕竟学习时间那么紧张,你看书,似懂不懂会让你很迷茫很迷茫很迷茫。 老师推荐的书,都是好书,这个世界上没有坏书,只有分什么人看,但是,把老师教的全都掌握了再去考虑这些,可OK? 太过激进反而不是什么好事,踏踏实实的先消化眼前知识才是最重要的。当你毕业了,放假了,你可以说看看书。上学时候,请抛弃这个念头,如果你是情怀主义者,请无视以上的话。 5)要开新课程了,我学这个会找到高薪么? 在学习期间,请不要考虑薪水这个问题。你学的好,有自信、有信心,自然能跟企业要出你期待的薪水,如果你学的渣渣的话,那么就算给你一个月一万八,你确定自己能干的长久么? 想这个不如多去想想老师今天讲什么知识了。 6)如何提高自己的能力<一> 老师在授课期间,你会发现一个问,每个老师写代码方式不一样啊!!! 有的变量全是英文名,有的变量就是a,有的变量竟然还有中文拼音呢! 请注意老师的代码风格,一个好老师带出来的学生必然有良好的代码风格,这个问题很多老师不会去提,楼主在这里推荐两本书,一本是<<高质量C、C++编程指南>>、一本是<<像程序员一样思考>> 尽快找到你的代码风格并固定下来,这对你是一件帮助特别大的事情.。(用合理的英文名去定义一个变量,让你看到这个变量的时候你就能知道它是用来做什么的。) 7)如何提高自己的能力<二> 当你准备提高自己的能力的时候,请先问问自己,当前的知识掌握了没有,如果没有,请先抛弃你的兴趣,不要把知识浪费了。 如果你掌握了的话,那么就狂敲代码,敲不一样的代码,盲敲代码,让代码达到你想就出的程度,这样你就成功了。如果你都已经可以去很顺畅的教别人了,那么你还会怀疑自己么? 3、生活中你可能会遇到的一些困扰 一个人出门在外,最重要的是什么?衣!食!住!行! 楼主刚来传智的时候学校推荐的是福林公寓,楼主去看了看,感觉太挤,八个人或六个人一间寝室,暗无天日,楼主跟女朋友住习惯了。实在是怕最后怀疑自己的性取向,所以楼主毅然决然的出去找房子了,楼主跟几个小伙伴去朱辛庄那边找的公寓,价格挺便宜的。就是吃饭不方便,楼主住了三个月搬来了九克拉,唯一好处就是,吃饭方便了! 怎么说呢,其实找房子这件事,楼主没什么太多的经验,找房子一定要找几个熟悉的小伙伴一起,最好是一个班的,到时候有什么事有个照应,谁有困难了、或者病了,可以互相照看着点。 另外呢,北京最不缺的是什么?黑心商人、骗子、各位找房子的时候一定要看好合同,如果找中介最好找正规中介。不要相信什么乱七八糟的个人中介。 个人推荐:金燕龙周边的小区,远一点的,朱辛庄,史各庄那边。小伙伴都不少。 4、楼主接触过的讲师以及对老师的个人见解 总体来说,传智的教学水平还是一流的。如果你觉得你的老师不好,请结合你的课表当前课程难度,问问自己,是自己不够努力,还是真的老师不好。 楼主来说说在C++基础班以及就业班所认识的以及有所耳闻的几位老师吧! 老师 C++基础班讲师-->朱景尧 为人厚道、慈善,是个不折不扣的人才。知识之丰富,社会经验之充足,是你无法想到的。吹拉弹唱样样精通,代码滴水不漏。C++学院院长一职与首席架构师的称号不是白说的。关于朱老师的社会事迹我就不说了,太丰富, 讲课方式、通俗易懂、通过形象化的讲解让你能轻松的进入C语言的大门。变量、变量名物化,而不是职业化,让不懂C的人也能很快的理解C语言基础。 C++基础与C提高-->王桂林 华为项目经理出身,代码职业化,代码风格清晰,讲课丝丝不漏,听他的课就好比你真的进入到了公司里。公司给你下达任务后的文档需求分析一样,而且底蕴丰厚,讲课时就公司内部所遇到的事有时候也会说一说,让大家不会成为呆子一般的盲目的学,,号召力强、亲民, 外号大哥。学员面试时如果有什么问题,找他第一句话就是:大哥救我 ,C++学院副院长(目前已离职),大哥是个有梦想的文艺青年,对生活、对遇到的事有着自己独特的见解,爱好分享,博客一堆精品文章,大师级程序员。 C++提高STL-->刘丹冰 东北人,说话风趣幽默,讲课有激情,上他的课你不会感到昏昏欲睡,你会觉得有嗷嗷的求知欲望。做网络安全出身,由于课程原因,接触的不是很多,但是的确是个好老师,让你对学习有激情,让你学起来枯燥的STL也不会产生厌恶感。 C++数据结构-->苏丙榅 地道的码农,在他身上我看到了我以后可能会遇到的,感觉更像是朋友一样,生活的压力、工作的压力、四天课程,讲的还算可以的。毕竟是刚刚接手课程,接手别人的课表,可以理解。但是为人的确不错,像常见问题都挺乐意给你解答,还有工作中遇到的很多事,他都会去说,包括自身经历,以及个人求职的艰辛。让我们在茫然之中也有面对挫折的应对方法,而不是像某些培训机构一样,只能喊高薪。 一个人挺一个家,苏老师挺不容易的的,他让我们从北漂一族的梦里边醒过来面对事实。 linux基础&SQL数据库-->王飞 王老师是一个特别负责任的老师,传智那么多老师中,没有几个像他一样,每天下课到七点才走。班里很多同学反映王老师讲的不是那么好,我感觉跟课程有关系,就像苏老师一样,摊上了这个摊子,换成别人也就讲成那样了。挺注重互动的,我不知道我是什么情况,我看王老师加速的视屏跟看他本人亲身讲课,感觉完全不一样。或许以为我看视频都是加速看的原因,看视频就感觉讲的真的是棒棒哒,亲身听课,为啥说话这么慢呢。 linux提高-->邢文鹏 Linux大牛,十年工作经验,为人和善,善于开发学生的学习能力与问题的应对能力。给你指点一个方向能让你快速入门那种,给他几个人,他能迅速的给你组成一个团队的一个人。领导能力强,讲课内功扎实的不要不要的。他是一个能给你指引方向的老师。 QT-->江文聪 讲课风趣幽默,从事QT出身。一口流利的广东普通话,让课堂的气氛不是那么压抑。快速开发能力强、接触不是过多,不做过多评论。 班主任 基础班-->毛兆军(大猫) 逗逼!!!十足的逗逼!!!!!! 不过很多事都是为学员考虑,像朋友多过像班主任。 就业班-->柳叶 好说话,脾气挺好的一大姐。 作为一个不常回家的母亲,也是挺不容易的。 学弟班-->吕冬雪 直来直去,完事好说话,平时该玩玩该闹闹,遇到事能看事。 听闻过的老师 张孝祥(已逝) 传智创始人,张老师的JAVA教程算是业内最经典的JAVA教程了,没能听张老师现场的课挺遗憾的。 王宝明 技术大牛一枚,马上要上王老师的项目课了,对于真人不做评论,不过视频好的不要不要的!!! 5、楼主个人在传智所遇到的一些事与感悟 先来说两个身边实际的事情: 一起找房子的小伙伴之一,被游戏坑害的不轻,两度重听基础班,感觉有时候就像看到了迷茫期的自己一样。其实挺惋惜的,学了之后的知识感觉基础班的知识并没有那么重要,但是入门还是要懂得。希望大家能不重读尽量不要重读。毕竟,一个月,三十天,你可以做的事很多很多很多。 同班小伙伴之一,爱钻牛角尖,爱研究为什么,在一个点上死磕经常出不来。现在已经放弃,准备年后继续来重读。楼主挺惋惜,也劝过,但是每个人有每个人独特的想法。不过挺年轻,才十八岁。还有时间能浪费。但是,时间就是金钱,也是希望大家,遇到事别怕,抗抗就过去了。没什么大不了的,就当是锻炼自己。 楼主作为一个同样被游戏坑害不轻的少年,对游戏是痛恨的不要不要的。学习的时候有过迷茫、有过冲动,半年也经历了很多,楼主也是有家室的人,跟女朋友分居两地这半年过得也很是不易。劝大家一句,没事闲下来就给家里打个电话,报个平安。问问女朋友,父母怎么样。别玩疯了,偏激了忘了自己是谁。 楼主毕业第一志愿是留在学校做技术辅导,毕竟,教别人是提高自己最快捷的路径。可惜,知道是自己学的不好,还是别的,听说技术辅导人满了,挺惋惜的。 毕业之后,对于方向选择,感觉如果能有提高自己的职位,即使薪水低点也能干,毕竟发展自己才是第一位的。 对于求职,挺迷茫的,在家做了三年的个体,也没怎么给别人打工。码农可以说是自己人生的第一份正式职业,这个敲门砖,自己还真没有力道的把握与信心,同时劝各位学员一句,有人给你开,合适就干。但是薪水低的,你要考虑回报值得不值得,千万不要凑合了事。宁愿多找俩月也要找到自己喜欢的,,毕竟爱好是学习最大的动力。 ============================================================================= 原文链接网址:http://tieba.baidu.com/p/4255766507我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

IBM 又出黑科技,使 AI 极简高效

HCI,SDS,两手抓两手硬 IBM 计划推出全新容器原生软件定义存储解决方案 IBM Spectrum Fusion HCI;新发布的 IBM ESS 3200 提供先前型号 2倍的数据访问性能。 新时代企业需要敏捷性、多样性和可扩展性来确保竞争力 根据麦肯锡咨询,超过 70% 的顶级CEO表示,提升企业整体敏捷性、缩短上市时间有助于提升其市场竞争力,而这些也是他们的当务之急。 当下,企业希望比自己的同业更加敏捷,同样也希望通过AI技术获得更好的洞察力。我们聆听到三种客户心声: 希望应用和数据能够根据市场需求动态进行调整和变化 希望能够随处构建多样化工具和数据,能够更好地获得洞察力 希望应用和数据能够动态地扩展,实现最高性能,同时保持安全合规 企业需要具备使其能够在任何地方开展工作的敏捷性:这意味着能够使用支持不同开发工具的云环境,能够进行动态扩展来满足客户需求,同时能够更精细地控制成本。容器应用开发平台可为企业提供在新时代确保竞争力和成功所需的全部敏捷性、多样性和可扩展性。 企业对于数据的关注点已经从容器转变到应用 然而,面向容器化和混合云的转型并非易事。Gartner《2020 年影响基础架构和运维的十大趋势》报告显示:安全、混合云和容器是完成数据转型的基础。58% 的企业认为网络安全保护是一个非常重要的优先事项,50% 的企业用户是在数据中心或者是在云端之外创建和处理的,71% 以上的企业认为需要一致的方式,在本地基础架构和公有云中来部署云原生应用,50% 企业已经部署了容器。 今天,容器应用更加注重数据,有超过一半的企业认为基于容器构建的有状态应用,容器的持久数据保护已经变得非常普遍。企业对于数据的关注点已经从容器技术的本身转变到了对应用的关注。5年前,企业更关注的是支持容器的存储,即如何利用已经投资在数据中心的块存储、对象存储或者文件存储来支持容器化的应用。从2018年至今,越来越多的企业关注的是容器原生存储的技术,即能否够通过统一的容器管理和调度平台来进行存储的管理。随着时间的推移,越来越多的企业在思考,面向存储的服务,应用如何可以更好地去感知,而不是每次都需要进行大量的调度,调用运维管理人员来管理存储服务。 企业在构建一个混合云和人工智能的数据基础的时候,无论来自于边缘、核心的数据中心,还是混合的云端,都需要专门为人工智能优化而且为各种各样的应用提供一个单一的数据存储库。 构建面向应用(而非容器)的基础架构,包括必要的存储底层,例如不可变性与加密、同步多协议访问、高性能存储缓存、归档到磁带/云以及数据优化等。在此基础上,还需要针对 HA/DR、数据保护、容量和性能管理、发现和编排、安全和迁移,优化面向混合云的存储服务。企业需要构建一个坚实的数据基础,打通存储底层、存储服务和应用运行的管理。 容器原生的 IBM Spectrum Fusion 应运而生 IBM Spectrum Fusion是业界第一个面向 OpenShift 混合云容器的原生数据平台,计划于 2021 年下半年上市,其第一个版本采用超融合基础架构 (HCI) ,将计算、存储和网络整合为单一解决方案。配备 Red Hat OpenShift,使企业能够支持虚拟机和容器环境,并为云端、边缘和容器化数据中心提供软件定义存储。 该平台专为需要全局混合云数据访问和企业存储服务的企业而设计,满足任务关键数据的严苛要求,其功能包括: 全局数据访问:创建混合云灵活性,同时通过从核心到边缘再到公有云的流畅数据和全局访问消除数据孤岛。 OpenShift 基础,企业级全局数据服务:通过单个 YB 级可扩展的数据基础来保护和优化您的数据。 简化 OpenShift 部署:综合性的计算、网络和软件定义存储平台,提供集成的管理界面和监控工具。 Spectrum Fusion提供单一的管理门户,从而简化管理。企业可以任意构建,随处运行容器化的应用和服务,同时随时随地访问、保护数据。该平台面向应用和人工智能,企业可以轻松管理基础架构(存储、计算、网络),轻松管理存储的服务、轻松构建和运行应用、轻松部署 Red Hat OpenShift 容器平台,快速敏捷地完成一系列的工作,我们称之为“交钥匙”工程。 软硬一体,专为高性能 AI 和混合云打造的下一代存储 IBM Elastic Storage Ssystem(ESS) 是一款以现代化方式实施的软件定义存储,它结合了IBM Spectrum Scale 软件,基于 IBM POWER 处理器的I/O 密集型服务器以及强大的双端口存储机柜。IBM Spectrum Scale并行文件系统是 IBM ESS的核心,可随需扩展系统吞吐量,同时提供单个命名空间,有助于消除数据孤岛、简化存储管理并提供高性能。新发布的ESS 3200堪比 AI 时代的数据加速器: 业界领先的数据访问性能 - 两倍于上一代 ESS 3000 单个模块高达 80GB/s 无论是边缘、数据中心还是云端,可线性扩展到 TB/s 级的性能和 YB 级的容量 从外观上来看,ESS 3200和上一代的 ESS 3000几乎是相同的,同样在一个 2U的空间里面,可支持最多 8 个 InfiniBand HDR-200 或 Ethernet-100 端口,实现了高吞吐量和低延迟;可以为每个 2U 节点提供最多 367TB 的存储容量,支持12-24个NVMe的高速存储模块,同时提供了两个Active的双控制器。和上一代的3000相比,3200的最大的一个改进就是都全面了支持了 PCIe 4.0,无论是控制器里面的芯片,还是外部的存储模块。 此外,IBM ESS 5000 也做了更新,支持的密度比之前高出了 10%,总存储容量达到 15.2PB。所有 ESS 系统现在还具备了简化的容器化部署功能,并借助最新版本的 Red Hat Ansible 实现了自动化。 升级到 ESS 3200可以保护您的现有投资,帮助您构成一个统一的、整合的数据湖。您可以在单个命名空间中整合 ESS 3000、3200、5000 及IBM Spectrum Scale SDS 节点,全局可访问容量高达 8YB! Spectrum Scale/COS 增强功能不容错过 伴随着 ESS 3200新品发布,我们还发布了 Spectrum Scale 5.1.1 GPUDirect 存储技术预览,让 NVIDIA 开发者能够实现 GPU 内存与存储之间的直接内存访问 (DMA),同时减少延迟并增加带宽。 Spectrum Scale 在过去数年当中,一直和 NVIDIA 有着非常紧密的合作,无论是基于NVIDIA提供的GPU卡,还是它的 Work Station、DGX 的服务器平台、SuperPOD 集群的平台,IBM Spectrum Scale都有非常完善的参考架构。 目前全球的最大的基于NVIDIA的GPU的系统,曾经位列世界第一和第二的超级计算机 Summit和Sierra,都采用了ESS作为数据存储平台。在2018、2019年NIVIDIA推出的每一套的SuperPOD的后面支持的存储也用到基于 SSD 的 ESS。 此外,针对云对象存储 Cloud Object Storage 的用户,还发布了一个新的适用于所有的机柜的存储模块型号 —— Slicestor 92,可帮助客户实现相当于之前 4 倍的密度,无需额外的空间来部署超深机架。这有助于客户降低运营开支,满足不同物理数据中心条件的用户来实现一个更高容量、更高存储密度的一个扩展。 结合新发布的ESS 3200、ESS 5000 或者对象存储的新功能,用户可以把现有的一些投资:不同地点、不同架构、不同类型的存储,通过 Spectrum Scale按照应用的需求组合成一个现代化的数据存储平台,满足数据在收集、组织、分析等阶段所需的访问便捷性、容量、性能、单位容量成本等需求。通过和 Red Hat OpenShift 集成,所有这些能力都可以同时运行在数据中心,也可以运行在混合云环境,从而帮助用户真正降低复杂性、降低成本,同时通过提升整合度,提升数据使用效率,获得更高的数据价值。 简化数据管理,提升存储价值,加速 AI研发 地平线,一家AI 领域的独角兽公司,在AI模型训练中所累积的数据量超过数十PB,且每年以若干PB的增量继续高速增长,这些数据分散在多中心、多云环境里。起初,地平线使用基于开源GlusterFS、Ceph、以及HDFS所构建的数据基础架构,面临着竖井林立,存取性能下降,数据调度困难,管理复杂、数据存放成本高等难题,因此亟需改造和升级,以满足业务发展。 基于IBM Spectrum Scale,地平线构建了高性能海量数据分布式存储架构,统一数据平台,消除竖井,更好地利用资源,让业务迭代更加快速。具体而言: 第一,统一数据平台,提升开发效率。利用Spectrum Scale 在多云之间形成统一的全局命名空间,将不同数据访问接口的数据方便地接入进来统一管理,消除竖井,实现高效开发迭代和系统管理。 第二,数据随需调度,快速响应需求。Spectrum Scale 让数据得以统一调度,数据可以自动透明地在多云间自由流动,大大节省了人工成本、降低了误操作的风险,访问速度达到毫秒级,加速训练任务日程。 第三,运维自动完成,提升数据安全。Spectrum Scale 自带管理功能,提供简单易用的图形界面、操作简便,原有的很多需要人工干预的操作变为自动完成,在降低管理难度的同时,提升了数据安全性。 最后,数据自动分层,降低存储成本。依托Spectrum Scale 统一管理磁盘和磁带,实现多样的扩容方式和数据自动分层,把冷数据如访问量不高的大文件自动地归档到磁带系统中,形成低成本的长期存储池,且磁带数据实时随机读取,冷数据存储降低了大约 80% 的成本,同时满足合规需求。 “依托于Spectrum Scale 统一管理磁盘和磁带,透明地把数据从磁盘迁移到磁带,也可以从磁带回迁回来,这一过程完全不需要我们干预,也无需应用进行任何访问方式的改变。一方面,通过灵活的冷热分层策略,地平线每年可以节省数千万的存储成本;另一方面,高效的分布式数据存储管理,也使得上层的数据管理中台与前台业务无需关心存储本身,而更加专注于业务系统的研发与优化。” 地平线的 VP水冰先生说道。 值得一提的是,基于Spectrum Scale存储,地平线利用端侧软件产品的优势,开发了一套高效、规模化、安全可控的数据驱动闭环迭代系统,打通了端云链路,赋能合作伙伴实现从数据筛选、采集标注、模型训练优化、仿真评测,到模型OTA部署,端到端的数据迭代闭环,帮助合作伙伴充分挖掘利用数据价值,实现智能驾驶软件自动化迭代,加速产品用户体验的提升。 耳听为虚、眼见为实。IBM系统中心面向客户,提供体验式服务的技术互动平台,可以为客户提供从参观、演示、真机体验到产品概念验证、方案性能测试等端到端的硬核技术支持服务。 为简化流程,最大化便捷访问,系统中心推出远程但同时零距离接触的在线实验室平台。您只需要一个IBM ID,就可以通过互联网方便地连线到在线实验室平台,访问位于系统中心机房内的真实物理设备,体验IBM企业级系统的最新黑科技。 即便天南海北,只需一杯咖啡的时间,即可轻松完成一个在线的技术实验。与其坐而论道,不如起而行之,码上开始实验吧! 更多信息,访问 IBM 面向 AI 与大数据的存储解决方案 立即前往了解IBM现代化IT基础架构:面向混合云的数据优先基础结构 【责任编辑:张燕妮 TEL:(010)68476606】

优秀的个人博客,低调大师

SQL 优化极简法则,还有谁不会?

点击上方蓝色“ 方志朋 ”,选择“设为星标” 回复“666”获取独家整理的学习资料! 文章目录 法则一:只返回需要的结果 法则二:确保查询使用了正确的索引 法则三:尽量避免使用子查询 法则四:不要使用 OFFSET 实现分页 法则五:了解 SQL 子句的逻辑执行顺序 总结 SQL 作为关系型数据库的标准语言,是 IT 从业人员必不可少的技能之一。SQL 本身并不难学,编写查询语句也很容易,但是想要编写出能够高效运行的查询语句却有一定的难度。 查询优化是一个复杂的工程,涉及从硬件到参数配置、不同数据库的解析器、优化器实现、SQL 语句的执行顺序、索引以及统计信息的采集等,甚至应用程序和系统的整体架构。本文介绍几个关键法则,可以帮助我们编写高效的 SQL 查询;尤其是对于初学者而言,这些法则至少可以避免我们写出性能很差的查询语句。 以下法则适用于各种关系型数据库,包括但不限于:MySQL、Oracle、SQL Server、PostgreSQL 以及 SQLite 等。如果觉得文章有用,欢迎评论📝、点赞👍、推荐🎁 法则一:只返回需要的结果 一定要为查询语句指定 WHERE 条件,过滤掉不需要的数据行。通常来说,OLTP 系统每次只需要从大量数据中返回很少的几条记录;指定查询条件可以帮助我们通过索引返回结果,而不是全表扫描。绝大多数情况下使用索引时的性能更好,因为索引(B-树、B+树、B*树)执行的是二进制搜索,具有对数时间复杂度,而不是线性时间复杂度。以下是 MySQL 聚簇索引的示意图: Clustered index 举例来说,假设每个索引分支节点可以存储 100 个记录,100 万(1003)条记录只需要 3 层 B-树即可完成索引。通过索引查找数据时需要读取 3 次索引数据(每次磁盘 IO 读取整个分支节点),加上 1 次磁盘 IO 读取数据即可得到查询结果。 相反,如果采用全表扫描,需要执行的磁盘 IO 次数可能高出几个数量级。当数据量增加到 1 亿(1004)时,B-树索引只需要再增加 1 次索引 IO 即可;而全表扫描则需要再增加几个数量级的 IO。 同理,我们应该避免使用 SELECT * FROM, 因为它表示查询表中的所有字段。这种写法通常导致数据库需要读取更多的数据,同时网络也需要传输更多的数据,从而导致性能的下降。 📝关于B-树索引的原理以及利用索引优化各种查询条件、连接查询、排序和分组以及 DML 语句的介绍,可以参考:https://tonydong.blog.csdn.net/article/details/104020721 法则二:确保查询使用了正确的索引 如果缺少合适的索引,即使指定了查询条件也不会通过索引查找数据。因此,我们首先需要确保创建了相应的索引。一般来说,以下字段需要创建索引: 经常出现在 WHERE 条件中的字段建立索引可以避免全表扫描; 将 ORDER BY 排序的字段加入到索引中,可以避免额外的排序操作; 多表连接查询的关联字段建立索引,可以提高连接查询的性能; 将 GROUP BY 分组操作字段加入到索引中,可以利用索引完成分组。 即使创建了合适的索引,如果 SQL 语句写的有问题,数据库也不会使用索引。导致索引失效的常见问题包括: 在 WHERE 子句中对索引字段进行表达式运算或者使用函数都会导致索引失效,这种情况还包括字段的数据类型不匹配,例如字符串和整数进行比较; 使用 LIKE 匹配时,如果通配符出现在左侧无法使用索引。对于大型文本数据的模糊匹配,应该考虑数据库提供的全文检索功能,甚至专门的全文搜索引擎(Elasticsearch 等); 如果 WHERE 条件中的字段上创建了索引,尽量设置为 NOT NULL;不是所有数据库使用 IS [NOT] NULL 判断时都可以利用索引。 执行计划(execution plan,也叫查询计划或者解释计划)是数据库执行 SQL 语句的具体步骤,例如通过索引还是全表扫描访问表中的数据,连接查询的实现方式和连接的顺序等。如果 SQL 语句性能不够理想,我们首先应该查看它的执行计划,通过执行计划(EXPLAIN)确保查询使用了正确的索引。 📝关于各种主流数据库中执行计划的查看和解释,可以参考:https://tonydong.blog.csdn.net/article/details/103579177 https://blog.csdn.net/horses/article/details/106905110 法则三:尽量避免使用子查询 以 MySQL 为例,以下查询返回月薪大于部门平均月薪的员工信息: EXPLAINANALYZESELECTemp_id,emp_nameFROMemployeeeWHEREsalary>(SELECTAVG(salary)FROMemployeeWHEREdept_id=e.dept_id);->Filter:(e.salary>(select#2))(cost=2.75rows=25)(actualtime=0.232..4.401rows=6loops=1)->Tablescanone(cost=2.75rows=25)(actualtime=0.099..0.190rows=25loops=1)->Select#2(subqueryincondition;dependent)->Aggregate:avg(employee.salary)(actualtime=0.147..0.149rows=1loops=25)->Indexlookuponemployeeusingidx_emp_dept(dept_id=e.dept_id)(cost=1.12rows=5)(actualtime=0.068..0.104rows=7loops=25) 从执行计划可以看出,MySQL 中采用的是类似 Nested Loop Join 实现方式;子查询循环了 25 次,而实际上可以通过一次扫描计算并缓存每个部门的平均月薪。以下语句将该子查询替换为等价的 JOIN 语句,实现了子查询的展开(Subquery Unnest): EXPLAINANALYZESELECTe.emp_id,e.emp_nameFROMemployeeeJOIN(SELECTdept_id,AVG(salary)ASdept_averageFROMemployeeGROUPBYdept_id)tONe.dept_id=t.dept_idWHEREe.salary>t.dept_average;->Nestedloopinnerjoin(actualtime=0.722..2.354rows=6loops=1)->Tablescanone(cost=2.75rows=25)(actualtime=0.096..0.205rows=25loops=1)->Filter:(e.salary>t.dept_average)(actualtime=0.068..0.076rows=0loops=25)->Indexlookupontusing<auto_key0>(dept_id=e.dept_id)(actualtime=0.011..0.015rows=1loops=25)->Materialize(actualtime=0.048..0.057rows=1loops=25)->Groupaggregate:avg(employee.salary)(actualtime=0.228..0.510rows=5loops=1)->Indexscanonemployeeusingidx_emp_dept(cost=2.75rows=25)(actualtime=0.181..0.348rows=25loops=1) 改写之后的查询利用了物化(Materialization)技术,将子查询的结果生成一个内存临时表;然后与 employee 表进行连接。通过实际执行时间可以看出这种方式更快。 以上示例在 Oracle 和 SQL Server 中会自动执行子查询展开,两种写法效果相同;在 PostgreSQL 中与 MySQL 类似,第一个语句使用 Nested Loop Join,改写为 JOIN 之后使用 Hash Join 实现,性能更好。 另外,对于 IN 和 EXISTS 子查询也可以得出类似的结论。由于不同数据库的优化器能力有所差异,我们应该尽量避免使用子查询,考虑使用 JOIN 进行重写。 搜索公众号Java笔记虾,回复“后端面试”,送你一份面试题大全.pdf 法则四:不要使用 OFFSET 实现分页 分页查询的原理就是先跳过指定的行数,再返回 Top-N 记录。分页查询的示意图如下: 分页查询 数据库一般支持 FETCH/LIMIT 以及 OFFSET 实现 Top-N 排行榜和分页查询。当表中的数据量很大时,这种方式的分页查询可能会导致性能问题。以 MySQL 为例: --MySQLSELECT*FROMlarge_tableORDERBYidLIMIT10OFFSETN; 以上查询随着 OFFSET 的增加,速度会越来越慢;因为即使我们只需要返回 10 条记录,数据库仍然需要访问并且过滤掉 N(比如 1000000)行记录,即使通过索引也会涉及不必要的扫描操作。 对于以上分页查询,更好的方法是记住上一次获取到的最大 id,然后在下一次查询中作为条件传入: --MySQLSELECT*FROMlarge_tableWHEREid>last_idORDERBYidLIMIT10; 如果 id 字段上存在索引,这种分页查询的方式可以基本不受数据量的影响。 📝关于 Top-N 排行榜和分页查询的详细介绍,可以参考:https://tonydong.blog.csdn.net/article/details/108729112 法则五:了解 SQL 子句的逻辑执行顺序 以下是 SQL 中各个子句的语法顺序,前面括号内的数字代表了它们的逻辑执行顺序: (6)SELECT[DISTINCT|ALL]col1,col2,agg_func(col3)ASalias(1)FROMt1JOINt2(2)ON(join_conditions)(3)WHEREwhere_conditions(4)GROUPBYcol1,col2(5)HAVINGhaving_condition(7)UNION[ALL]...(8)ORDERBYcol1ASC,col2DESC(9)OFFSETmROWSFETCHNEXTnum_rowsROWSONLY; 也就是说,SQL 并不是按照编写顺序先执行 SELECT,然后再执行 FROM 子句。从逻辑上讲,SQL 语句的执行顺序如下: 首先,FROM 和 JOIN 是 SQL 语句执行的第一步。它们的逻辑结果是一个笛卡尔积,决定了接下来要操作的数据集。注意逻辑执行顺序并不代表物理执行顺序,实际上数据库在获取表中的数据之前会使用 ON 和 WHERE 过滤条件进行优化访问; 其次,应用 ON 条件对上一步的结果进行过滤并生成新的数据集; 然后,执行 WHERE 子句对上一步的数据集再次进行过滤。WHERE 和 ON 大多数情况下的效果相同,但是外连接查询有所区别,我们将会在下文给出示例; 接着,基于 GROUP BY 子句指定的表达式进行分组;同时,对于每个分组计算聚合函数 agg_func 的结果。经过 GROUP BY 处理之后,数据集的结构就发生了变化,只保留了分组字段和聚合函数的结果; 如果存在 GROUP BY 子句,可以利用 HAVING 针对分组后的结果进一步进行过滤,通常是针对聚合函数的结果进行过滤; 接下来,SELECT 可以指定要返回的列;如果指定了 DISTINCT 关键字,需要对结果集进行去重操作。另外还会为指定了 AS 的字段生成别名; 如果还有集合操作符(UNION、INTERSECT、EXCEPT)和其他的 SELECT 语句,执行该查询并且合并两个结果集。对于集合操作中的多个 SELECT 语句,数据库通常可以支持并发执行; 然后,应用 ORDER BY 子句对结果进行排序。如果存在 GROUP BY 子句或者 DISTINCT 关键字,只能使用分组字段和聚合函数进行排序;否则,可以使用 FROM 和 JOIN 表中的任何字段排序; 最后,OFFSET 和 FETCH(LIMIT、TOP)限定了最终返回的行数。 了解 SQL 逻辑执行顺序可以帮助我们进行 SQL 优化。例如 WHERE 子句在 HAVING 子句之前执行,因此我们应该尽量使用 WHERE 进行数据过滤,避免无谓的操作;除非业务需要针对聚合函数的结果进行过滤。 除此之外,理解 SQL 的逻辑执行顺序还可以帮助我们避免一些常见的错误,例如以下语句: --错误示例SELECTemp_nameASempnameFROMemployeeWHEREempname='张飞'; 该语句的错误在于 WHERE 条件中引用了列别名;从上面的逻辑顺序可以看出,执行 WHERE 条件时还没有执行 SELECT 子句,也就没有生成字段的别名。 另外一个需要注意的操作就是 GROUP BY,例如: --GROUPBY错误示例SELECTdept_id,emp_name,AVG(salary)FROMemployeeGROUPBYdept_id; 由于经过 GROUP BY 处理之后结果集只保留了分组字段和聚合函数的结果,示例中的 emp_name 字段已经不存在;从业务逻辑上来说,按照部门分组统计之后再显示某个员工的姓名没有意义。如果需要同时显示员工信息和所在部门的汇总,可以使用窗口函数。扩展:SQL 语法速成手册 📝如果使用了 GROUP BY 分组,之后的 SELECT、ORDER BY 等只能引用分组字段或者聚合函数;否则,可以引用 FROM 和 JOIN 表中的任何字段。 还有一些逻辑问题可能不会直接导致查询出错,但是会返回不正确的结果;例如外连接查询中的 ON 和 WHERE 条件。以下是一个左外连接查询的示例: SELECTe.emp_name,d.dept_nameFROMemployeeeLEFTJOINdepartmentdON(e.dept_id=d.dept_id)WHEREe.emp_name='张飞';emp_name|dept_name|--------|---------|张飞|行政管理部|SELECTe.emp_name,d.dept_nameFROMemployeeeLEFTJOINdepartmentdON(e.dept_id=d.dept_idANDe.emp_name='张飞');emp_name|dept_name|--------|---------|刘备|[NULL]|关羽|[NULL]|张飞|行政管理部|诸葛亮|[NULL]|... 第一个查询在 ON 子句中指定了连接的条件,同时通过 WHERE 子句找出了“张飞”的信息。 第二个查询将所有的过滤条件都放在 ON 子句中,结果返回了所有的员工信息。这是因为左外连接会返回左表中的全部数据,即使 ON 子句中指定了员工姓名也不会生效;而 WHERE 条件在逻辑上是对连接操作之后的结果进行过滤。 总结 SQL 优化本质上是了解优化器的的工作原理,并且为此创建合适的索引和正确的语句;同时,当优化器不够智能的时候,手动让它智能。 来源:blog.csdn.net/horses/article/details/105695431 热门内容: 看看人家那后端API接口写得,那叫一个优雅! 给IDEA换个酷炫的主题,这个有点哇塞啊! 你还在用Swagger?试试这个神器! 一个 SpringBoot 项目该包含哪些? 最近面试BAT,整理一份面试资料《Java面试BAT通关手册》,覆盖了Java核心技术、JVM、Java并发、SSM、微服务、数据库、数据结构等等。获取方式:点“在看”,关注公众号并回复666领取,更多内容陆续奉上。 明天见(。・ω・。)ノ♡ 本文分享自微信公众号 - 方志朋(walkingstory)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

C语言之const和volatile"究极"学习

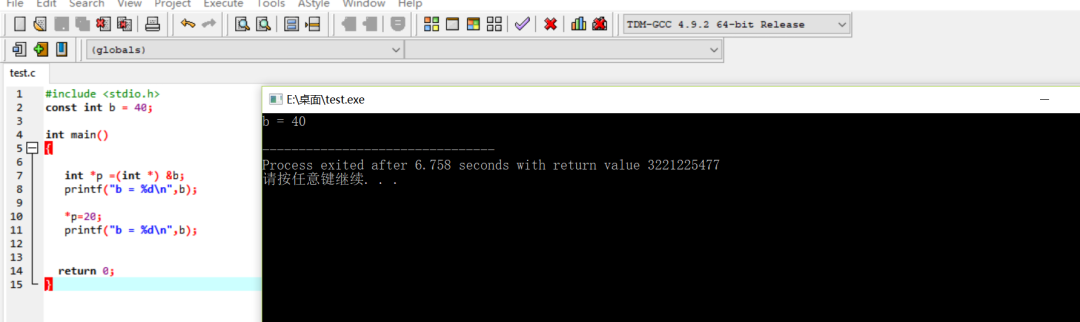
关于const的用法,现在大概前前后后应该写了有两篇文章,以前学习的时候,用法体会不是那么深刻,为啥这么说呢,因为在学习c++的时候,会发现const关键字有新的玩法,关于这个新的玩法,大家可以去看最近学习总结写的c++文章专辑。 一、const的用法: 1、const只读变量: const修饰的变量是只读的,本质上还是变量 const修饰的局部变量在栈上分配空间 const修饰的全局变量在全局数据区分配空间 const只在编译期有用,在运行期没有用 注:const修饰的变量不是真的常量,它只是告诉编译器该变量不能出现在赋值符号的左边 2、const全局变量的分歧: 在现代c语言编译器中,修改const全局变量将导致程序崩溃 标准c语言编译器不会将const修饰的全局变量存储于只读存储区中,而是存储于可修改的全局数据区,其值依然可以改变 3、代码示例: (1)只读变量代码示例: #include<stdio.h>intmain(){constinta=10;printf("a=%d\n",a);a=20;printf("a=%d\n",a);return0;} 运行结果: test.c:Infunction‘main’:test.c:8:4:error:assignmentofread-onlyvariable‘a’a=20;^ 注解:显示这个结果很正常,变量a被const修饰了,它就成了只读的。 (2)如果对变量a的值进行修改: #include<stdio.h>intmain(){constinta=10;int*p=(int*)&a;printf("a=%d\n",a);*p=20;printf("a=%d\n",a);return0;} 运行结果: root@txp-virtual-machine:/home/txp#./a.outa=10a=20 注解:通过指针的方式,就能够把a的值进行修改,这也论证了“const修饰的变量是只读的,本质上还是变量”这句话 (3)const修饰全局变量: 代码版本一 #include<stdio.h>constintb=40;intmain(){printf("b=%d\n",b);b=20;printf("b=%d\n",b);return0;} 输出结果: root@txp-virtual-machine:/home/txp#gcctest.ctest.c:Infunction‘main’:test.c:10:4:error:assignmentofread-onlyvariable‘b’b=20;^ 注解:跟const修饰栈上的变量用法一样 代码版本二 #include<stdio.h>constintb=40;intmain(){int*p=(int*)&b;printf("b=%d\n",b);*p=20;printf("b=%d\n",b);return0;} 运行结果: root@txp-virtual-machine:/home/txp#./a.outb=40Segmentationfault(coredumped) 注解:这里出现了段错误,这也验证了我们上面所说的“修改const全局变量将导致程序崩溃”。 同时为了验证“标准c语言编译器不会将const修饰的全局变量存储于只读存储区中,而是存储于可修改的全局数据区,其值依然可以改变”这句话,我把这段代码放到dev c++上进行试验: 说明:我这个版本的编译器支持标准c语言,所以没导致程序崩溃,能够正常运行 4、const的本质 c语言中的const使得变量具有只读属性 现代c编译器中的const将具有全局生命周期的变量存储于只读存储区,不是放在全局数据区 注:const不能定义真正意义上的常量;同时这里注意static关键字修饰的变量,它的生命周期和全局变量一样。 代码示例: #include<stdio.h>constintArray[5]={0};voidfun(int*p,intv){*p=v;}intmain(){intconsti=1;conststaticintj=2;intconstarray[5]={0};fun((int*)&i,1);fun((int*)&j,2);fun((int*)&array[2],3);fun((int*)&Array[1],4);return0;} 输出结果: root@txp-virtual-machine:/home/txp#./a.outSegmentationfault(coredumped) 注解:这里会有段错误,错误出现在const+static修饰的j变量对其进行修改,还有const修饰的全局数组。 5、const修饰函数参数和返回值 const修饰函数参数表示在函数体内不希望改变参数的值 const修饰函数返回值表示返回值不可改变,多用于返回指针的情形 在c语言中的字符串字面量存储于只读存储区中,在程序中需要使用const char* 指针,例如: constchar*s="TXP嵌入式";//字符串字面量 代码示例: #include<stdio.h>constchar*fun(constinti){i=8;return"TXP";}intmain(){constchar*p=fun(0);printf("%s\n",p);p[1]='_';printf("%s\n",p);return0;} 输出结果: root@txp-virtual-machine:/home/txp#gcctest.ctest.c:Infunction‘fun’:test.c:5:4:error:assignmentofread-onlyparameter‘i’i=8;^test.c:Infunction‘main’:test.c:12:5:error:assignmentofread-onlylocation‘*(p+1u)’p[1]='_';^ 注解:上面这样写,肯定有问题。 代码进化: #include<stdio.h>constchar*fun(constinti){//i=8;return"TXP";}intmain(){constchar*p=fun(0);printf("%s\n",p);//p[1]='_';//printf("%s\n",p);return0;} 输出结果: root@txp-virtual-machine:/home/txp#./a.outTXP 二、volatile的用法 老实说,这个关键字在面试题目里面经常会出现,但是平时学习的时候,如果你没有真正理解这其中的含义,在笔试的时候,脑袋里面可能依稀是记得有那么几个结论,但是有时候吧,一紧张就把结论给忘了,也不是不可能,所以说,咋们还是老实一点,得真正把它原理搞明白才行,这样上来战场就不怕了,以后写代码也就少一点bug。 1、volatile的常用结论(volatile英文本意就是易变的意思) 这里我先给结论,然后再给一个例子,把这个例子的讲明白,所有结论就都明白了。 volatile可理解为“编译器警告指示字” volatile告诉编译器必须每次去内存中取变量值 volatile主要修饰可能被多个线程访问的变量 volatile也可以修饰可能被未知因素更改的变量 volatile可以修饰一个中断子程序中会访问到的非自动变量 2、分析原理 大家可能平时在博客学习,都会发现讲解编译器优化的,然后加了volatile关键来修饰变量,就告诉编译器不要去优化这个变量了,那么这里的优化到底是什么意思呢? 从字面上来理解优化两个字,意思就是最优值(变量的值不会改变),这里我用一个简单代码来说明一下: #include<stdio.h>intmain(){inta=1;//volatileinta=0;while(a){}} 说明:上面的代码,如果变量a没有加volatile修饰的话,编译器就会优化它(也就是a的值一直不变),所以while就一直死循环;然后我如果加了volatile来修饰的话,编译器就不会去优化变量a,不优化的意思就是说,变量a的值可能就会改变,while就不会一直死循环。 当然这里为了好理解,我说的不是很专业,没有从寄存器和内存的角度去说。(我也不想那么去讲解,简单理解了就行) 总之一句话:上面的结论中,volatile修饰的都是变量,变量就可能改变,不会被编译器优化;只是说我们上面的结论应用场景不同而已。 三、总结 const使得变量具有只读属性 const不能定义真正意义上的常量 const将具有全局生命周期的变量存储于只读存储区 volatile强制编译器减少优化,必须每次从内存中取值 好了,今天的分享就到这里,如果文章中有错误或者不理解的地方,可以交流互动,一起进步。我是txp,下期见! 本文分享自微信公众号 - TXP嵌入式(txp1121518wo-)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

CodeMirror 代码渲染神器的极简入门实例

效果: image.png HTML: <script src="https://codemirror.net/lib/codemirror.js"></script> <script src="https://codemirror.net/mode/javascript/javascript.js"></script> <link rel="stylesheet" href="https://codemirror.net/lib/codemirror.css"> <div id="fn"></div> <button class="btn btn-sm btn-success offset2" id="fn-save-btn">保存</button> <button class="btn btn-sm btn-success" id="fn-eval-btn">运行</button> <div id="eval-result" class="eval-result"></div> JS 代码示例: // 渲染代码: var editor = CodeMirror.fromTextArea(document.getElementById("fnBody"), { lineNumbers: true, mode: "javascript", matchBrackets: true }); // 获取代码的文本值 var fnBody = editor.doc.getValue(); // 运行脚本,预览结果 $('#fn-eval-btn').unbind().bind('click', () => { console.dir(editor); var fnBody = editor.doc.getValue(); var postData = { js: fnBody }; $.ajax({ url: '/datafactory/evalJs.json' , data: postData , type: 'POST' , success: (result) => { if (result.success == true) { $('#eval-result').html(`<div>运行结果:</div><code>${result.data}</code>`) } else { alert(result.errorMessage) } } , error: (err) => { alert(JSON.stringify(err)) } }); });// fn-eval-btn 后端代码 Kotlin: @PostMapping("/evalJs.json") @ResponseBody fun evalJs(js: String): ResultVo<String> { println("js=${js}") val result = ResultVo( data = "", isSuccess = false, errorCode = "1", errorMessage = "", state = "1" ) try { val data = NashornUtil.evalJs(js) result.data = data result.isSuccess = true result.errorCode = "0" result.errorMessage = "" result.state = "" } catch (e: Exception) { result.errorMessage = e.message ?: "" } return result } 其中,evalJs() 的函数实现如下: package com.alibaba.xxpt.qa.adt.util import javax.script.ScriptEngineManager object NashornUtil { private val scriptEngineManager = ScriptEngineManager() private val nashorn = scriptEngineManager.getEngineByName("nashorn") fun evalJs(js: String): String { try { return nashorn.eval(js).toString() } catch (e: Exception) { e.printStackTrace() return "" } } } 使用的是 Java 8 中的nashorn 引擎(支持 ES5 的语法)。 参考文档:https://codemirror.net/

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册