首页 文章 精选 留言 我的

精选列表

搜索[腾讯极客挑战赛],共10001篇文章
优秀的个人博客,低调大师

手机取名极简史 快来学习下

上 今天跟大家聊聊手机名字的那些事儿,尝试从手机取名这个角度来探讨智能机行业的变革。 说起手机名字,大家可能会说出一大堆来,比如小米1,2,3……10,华为P1,2,6,7,10,苹果3,4,5,6,7。这些手机名字取得既简单又好记。 但是在功能机诺基亚和摩托罗拉称雄的时代,手机名字那是另一番场景。手机名字跟入网名字有点像,又“臭”又“长”。主要有三种取名方式: 一是纯数字型,比如诺基亚1110,3310,5700 二是字母加一串数字,比如诺基亚N97,摩托罗拉A1200,三星E1100 三是字母加单个数字,比如摩托罗拉刀锋系列v3 在这一阶段,手机取名字一般是按照产品高中低端、客户群体定位以及功能支持情况,加上厂商产品迭代型号,然后取名的。换句话说,这个阶段取名字的主体其实是厂商,凸出的是厂商品牌和某个系列,而非某个具体型号。 这个情况大家都差不多,国内外手机厂商一直沿用,直到iPhone的出现。iPhone的第一代命名为 iPhone,第二代为iPhone3G,第三代为iPhone3Gs,以此类推。 这个命名规则看似平平无奇,实际上暗藏玄机。首先,与功能机命名做了彻底区分。就像村里大家都叫赵铁柱,王二蛋、李狗剩,你突然叫梅长苏,自然给人一种与众不同的感觉。其次,命名更简单,容易记忆和传播。最后,产品有延续性。普通人都知道下一代手机叫什么名字,有一种期待感。 同期,国产手机并没有意识到这个问题,还是沿用老的命名规则,比如最初的神机中兴v880,华为C8500。当然,看到苹果取得的成就,国内外厂商还是比较眼热的,跟风命名也多,比如联想乐phone,庚phone。 不过跟风没有跟到点子上,直到小米的出现。单就命名来说,小米取名最切合苹果思路,第一代1,第二代1s,第三代2,等等。简单好记的名字,再加上极具性价比的价格配置,互联网的打法,使得小米迅速崛起。其他国产厂商一看,哟呵,原来应该这么玩。 接下来,一众国产厂商迅速跟进,先从命名开始,什么P1,d2,F1,x1,都有了。这时候大家都很忙,要学的师傅太多,一边要学苹果这个祖师爷,还要学习小米这个乔二代,另一边还要学习三星搞机海战术,难免会出错。 最典型的是华为ascend系列,也是华为p10系列的前身。华为本身的想法是打出ascend系列品牌来,ascend翻译过来是升高,寓意节节高升,又是a开头的字母,简直完美。唯一没考虑到的是,ascend这个名字太拗口。想象一下: 同事问你,你用什么手机? 你说,阿森得。 同事:啊什么得? 你:阿森得。 同事:什么森得? 你:阿森得。 同事:啊什么? 你:没什么,我没用手机,回头再聊。 这天就这么聊死了。 后来到了p10,就不提ascend了,直接叫p10了。不过,理工男的浪漫在于念念不忘,必有回响。ascend这么完美的名字肯定不能丢,于是这个ascend如今化身为华为�N腾,涵盖智能计算、AI芯片等业务,也算是物尽其用了。 下 除了华为,这个阶段还有些有意思的创新。别奇怪,从模仿到创新,这个我们很擅长。主要有以下几种: 一是粗粮派,这一派手机厂商主要学习小米品牌命名,典型代表小辣椒手机和红辣椒手机; 二是潮流派,这一派手机厂商理解的互联网就是潮流,于是手机取名字就贴向潮流热点,典型代表酷派大神; 三是新奇派,这一派手机厂商对互联网的理解就是新奇,越新奇越能吸引用户,典型代表360特供手机、联想乐檬、锤子手机; 创新归创新,但是结果不一定好。有句话:学我者生,似我者死。在手机这个赢家通吃的行业,学我者死,似我者也要死。以上几个流派,退的退,倒的倒,如今基本上已经销声匿迹。 到了库克执掌苹果的时代,他基本延续苹果此前命名。不过熟悉供应链管理的他,追求利益最大化,尽可能照顾更多的果粉,于是贴心的为他们增加了plus版和c/se廉价版。 国产厂商作为后学末进,看到前辈的变化,自然不甘人后,尽心尽力去学习。廉价版不用说,玩的透透的。plus版到了咱们这里,演化成plus和pro,名字不同,但是意义是一样的。 库克时代的苹果,相对来说,没什么引领性,颠覆性的创新,感觉是稳中求进。倒是在命名上创新不少,除了plus版和廉价版,到了第十代iPhone,创造性了引入了超大杯、大杯、中杯这种命名方法,简直石破天惊。 一众努力吆喝卖手机的厂商一看,还能这么玩?于是纷纷学习。把苹果当成师傅的华为率先推出p40 pro+,p40 pro,p40,超大杯、大杯、中杯给安排的明明白白。 小米不甘人后,推出小米10至尊纪念版、10pro版、10版、10青春版,不仅超大杯、大杯、中杯给安排的明明白白,连廉价版都给安排上了。顺便说下,小米至尊版叫Mi 10 Ultra ,而Ultra最先是用在三星手机上的。 纵观手机取名史,我们可以大略看到手机发展的变革: 一是,从以厂商为中心,转向以用户为中心,产品设计时,不再是我给用户什么,而是用户需要什么; 二是,由原来的品牌思维推动,转向爆款思维推动。即原来是从品牌整体进行建设,现在是通过打造爆款来推动品牌发展,但是需要注意的是,这并不意味着品牌意识变弱,反而是增强了; 总的来说,名字并非手机成败的决定性因素,大神手机没有让酷派成为大神,ascend没有让华为手机倒下,但是该倒闭还是倒闭,该成神依旧成神。诺基亚1110、摩托罗拉v3等名字照样是爆款,是全球历史销量最高的手机。 最关键的还是手机产品自身要过硬,赢得消费者的喜欢。当然,名字取得好听点,哪怕倒下了还能让人怀念下。 【责任编辑: 未丽燕 TEL:(010)68476606】

优秀的个人博客,低调大师

【Codelabs挑战赛—定制消息和配置】HarmonyOS定制告白消息

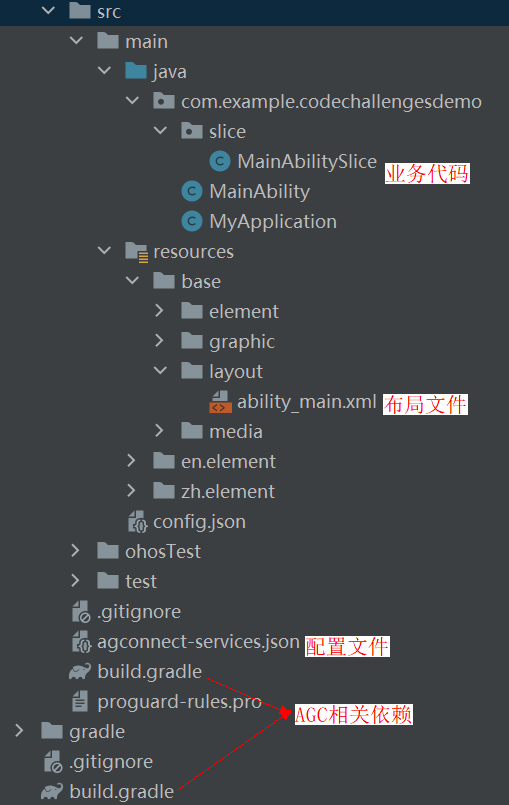
1.效果如下所示: 点击查看 2.项目介绍: 开发环境:DevEco Studio 3.0 Beta2 3.0.0.800 Empty Ability Template Java 通过此项目,主要是学习如何在HarmonyOS上集成远程配置、应用内消息、AppLinking链接、云存储和分析服务等技术。 3.项目结构: 4.在Gradle文件中设置AppGallery Connect的相关依赖和SDK包: a) 设置项目级 build.gradle: apply plugin: 'com.huawei.ohos.app' buildscript { repositories { maven { url 'https://repo.huaweicloud.com/repository/maven/' } maven { url 'https://developer.huawei.com/repo/' } } ... dependencies { classpath 'com.huawei.ohos:hap:3.0.5.2' classpath 'com.huawei.ohos:decctest:1.2.7.2' // 添加agconnect服务依赖 classpath 'com.huawei.agconnect:agcp-harmony:1.3.0.300' } } allprojects { repositories { maven { url 'https://repo.huaweicloud.com/repository/maven/' } maven { url 'https://developer.huawei.com/repo/' } } } b) 设置模块级 build.gradle: // Add the information to the bottom of the file. apply plugin: 'com.huawei.ohos.hap' apply plugin: 'com.huawei.agconnect' apply plugin: 'com.huawei.ohos.decctest' ... dependencies { implementation fileTree(dir: 'libs', include: ['*.jar', '*.har']) testImplementation 'junit:junit:4.13.1' ohosTestImplementation 'com.huawei.ohos.testkit:runner:2.0.0.200' // 添加分析服务依赖 implementation 'com.huawei.hms:hianalytics-harmony:6.3.2.301' // AGC基础SDK implementation 'com.huawei.agconnect:agconnect-core-harmony:1.3.0.300' // 调测设备AAID SDK implementation 'com.huawei.agconnect:agconnect-credential-harmony:1.3.0.300' // 集成应用内消息SDK implementation 'com.huawei.agconnect:agconnect-appmessaging-harmony:1.3.0.300' // 添加远程配置依赖 implementation 'com.huawei.agconnect:agconnect-remoteconfig-harmony:1.3.0.300' // 添加AppLinking SDK implementation 'com.huawei.agconnect:agconnect-applinking-harmony:1.3.0.300' } 5.云存储: 6.远程配置: 7.应用内消息: 8.App Linking: 9.添加配置文件: 在AGC管理平台打开“项目设置”,下载配置文件“agconnect-services.json”,将下载的JSON文件放到DevEco Studio 项目的应用级目录下: 10.分析服务: 由于应用集成了华为分析服务,完成相关配置后,打开应用,会弹出定制消息,此时会上报应用信息到AGC管理平台。 11.程序代码: ability_main.xml: <?xml version="1.0" encoding="utf-8"?> <DirectionalLayout xmlns:ohos="http://schemas.huawei.com/res/ohos" ohos:height="match_parent" ohos:width="match_parent" ohos:alignment="top" ohos:orientation="vertical"> <Image ohos:id="$+id:image" ohos:height="match_content" ohos:width="match_parent" ohos:image_src="$media:first" /> </DirectionalLayout> MainAbility: package com.example.codechallengesdemo; import com.example.codechallengesdemo.slice.MainAbilitySlice; import com.huawei.agconnect.AGConnectInstance; import com.huawei.hms.analytics.HiAnalytics; import com.huawei.hms.analytics.HiAnalyticsInstance; import com.huawei.hms.analytics.HiAnalyticsTools; import ohos.aafwk.ability.Ability; import ohos.aafwk.content.Intent; public class MainAbility extends Ability { @Override public void onStart(Intent intent) { super.onStart(intent); super.setMainRoute(MainAbilitySlice.class.getName()); // 初始化AGC SDK AGConnectInstance.initialize(getAbilityPackage()); // 打开SDK日志开关 HiAnalyticsTools.enableLog(); // 初始化hiAnalytics kit HiAnalyticsInstance instance = HiAnalytics.getInstance(this); } } MainAbilitySlice: package com.example.codechallengesdemo.slice; import com.example.codechallengesdemo.ResourceTable; import com.huawei.agconnect.appmessaging.AGConnectAppMessaging; import com.huawei.agconnect.appmessaging.AGConnectAppMessagingOnClickListener; import com.huawei.agconnect.appmessaging.model.Action; import com.huawei.agconnect.appmessaging.model.AppMessage; import com.huawei.agconnect.common.api.AGCInstanceID; import com.huawei.agconnect.remoteconfig.AGConnectConfig; import ohos.aafwk.ability.AbilitySlice; import ohos.aafwk.content.Intent; import ohos.agp.components.Image; import ohos.hiviewdfx.HiLog; import ohos.hiviewdfx.HiLogLabel; import ohos.media.audio.*; import ohos.media.codec.Codec; import ohos.media.common.BufferInfo; import ohos.media.common.Source; import java.nio.ByteBuffer; public class MainAbilitySlice extends AbilitySlice { private AGConnectAppMessaging appMessaging; private static final String TAG = MainAbilitySlice.class.getName(); private static final HiLogLabel LABEL_LOG = new HiLogLabel(3, 0xD000F00, TAG); private static final int SAMPLE_RATE = 44100; private static final int BUFFER_SIZE = 1024; private AudioRenderer audioRenderer; private Codec codec; long interval = 0; private String flag = "late"; @Override public void onStart(Intent intent) { super.onStart(intent); super.setUIContent(ResourceTable.Layout_ability_main); // 初始化音频播放相关参数 initAudioRenderer(); // 获取AAID getAAID(); //配置应用内消息 configAppMessage(); // 读取远程配置 readRemoteConfig(); } 安装应用后,打开应用程序,会播放音乐,更换应用内图片,同时弹出定制消息,点击按钮跳转到远程配置的链接。至此,HarmonyOS定制告白消息项目就结束了。

优秀的个人博客,低调大师

APP“梦游”欺客 法律不能“休眠”

即将开播:6月19日,互联网银行架构师魏生谈互联网开放银行实施路径的探索与思考 即将开播:4月29日,民生银行郭庆谈商业银行金融科技赋能的探索与实践--> 近来,一些手机App频繁强制跳转启动、自启动、关联启动,甚至高频次访问手机照片和文件,读取手机信息,让不少用户不堪其扰。这些App中,还不乏知名、常用的软件。这些“任性不服管”的App,不仅让用户无奈,也损害用户权益,造成安全隐患。 从PC端到移动端,很多人都习惯用浏览器阅读信息。但随着移动互联网迅速发展,部分互联网巨头正试图“去浏览器化”“去通道化”,筑牢自己的数据护城河。有网友表示,自己只想做个“安静的美男子”,却被各种强制跳转频频骚扰。“我的地盘”为何我做不了主? 如果说强制跳转启动只是转换了阅读媒介,无影无踪的自启动、关联启动,则令不少用户后怕。没有主动运行软件的手机,你以为App在睡觉,其实它却在“梦游”,甚至“搭伙梦游”——有的App一天自启动多达数百次,神不知鬼不觉间,个人信息被一览无余。 如此野蛮生长背后,还是商业利益在作祟。一方面,App频繁启动可以使App“日活跃用户”等流量数据变多,获得更高估值融资和广告投放收入。与此同时,App运营者也可通过获取用户信息,分析个人活动习惯与需求,实现精准营销。 针对“任性”App,实际上不少法律规章都做了相关规定。如工信部《移动智能终端应用软件预置和分发管理暂行规定》要求“未经明示且经用户同意,不得实施收集使用用户个人信息、开启应用软件”;《中华人民共和国网络安全法》规定,网络运营者不得收集与其提供的服务无关的个人信息等。 一些App打着“用户同意”的旗号,似乎你情我愿,但后台究竟在用户手机里用了什么、怎么用的,用户并不清楚。安装App基本都要授权,不同意就装不了,一些运营者利用和用户信息、地位的不对等,实现了“任性”闭环。有法律从业者表示,App用户协议上的格式条款,如果加重对方责任、排除对方主要权利等,该条款无效。 管住“任性”App,要有更硬核的举措。业内人士建议,整治App过度收集信息乱象,应从源头开始,从App上架环节着手,应用市场要堵住技术漏洞、加强管理,不满足安全标准者不得进入市场。广大App运营者也要知晓,保护用户个人信息,是法律强制性规定,莫让眼前商业利益冲昏头脑,捡了芝麻丢了西瓜。 作为全面依法治国的重要里程碑,民法典的出台让民事权利体系更加完备。手机作为用户的财产,其物权等相关民事权利也将受到更好地保护。移动互联网的硬技术日新月异,软环境也要与时俱进,各类市场主体应协同努力,让“任性”App尽职归位,带给用户便利,而非“安全恐慌”,营造积极、正面、清朗的网络环境,让科技创新真正造福民众。

优秀的个人博客,低调大师

ggwave —— 极简声音传输数据库

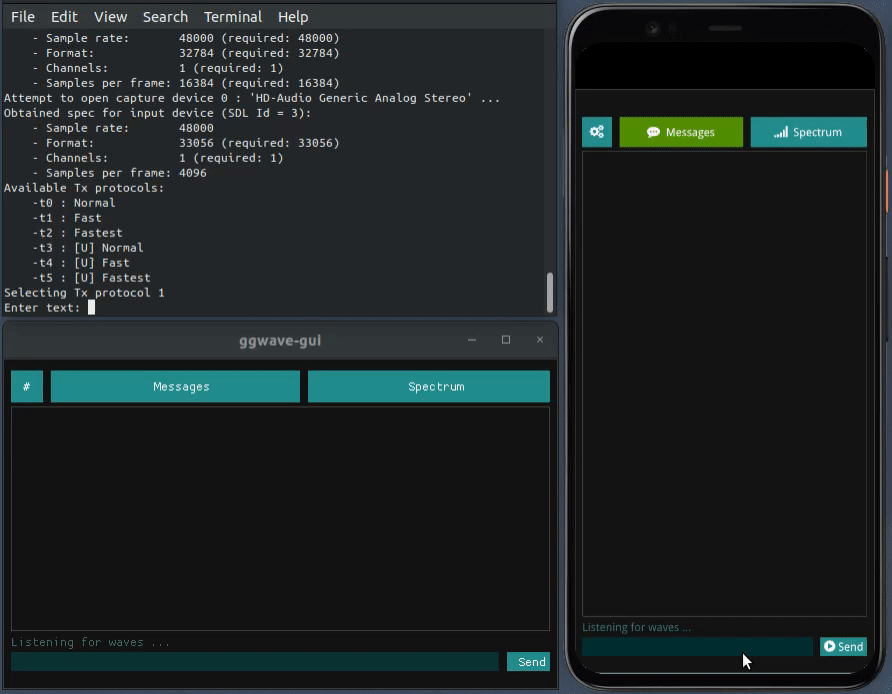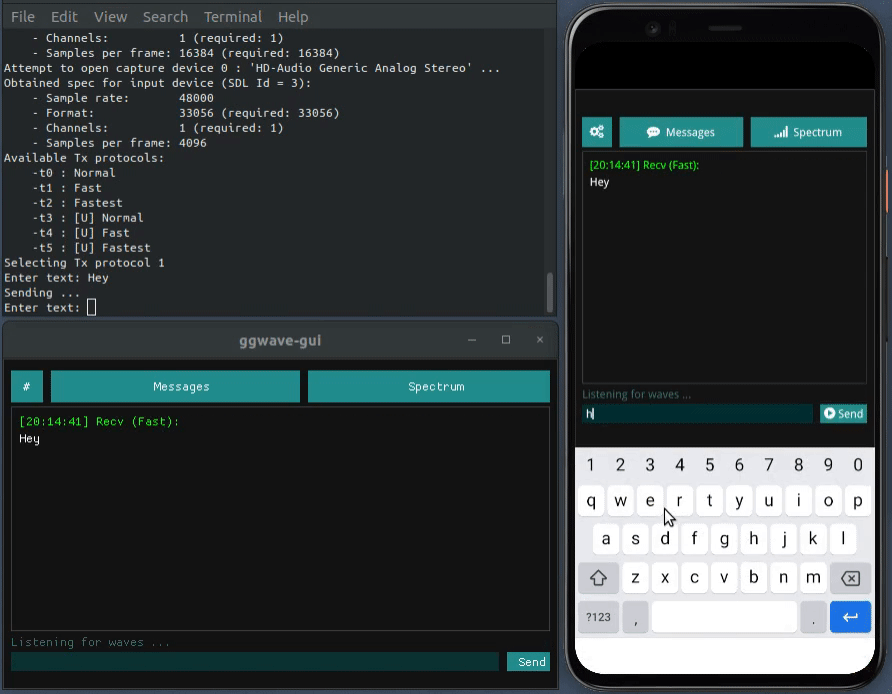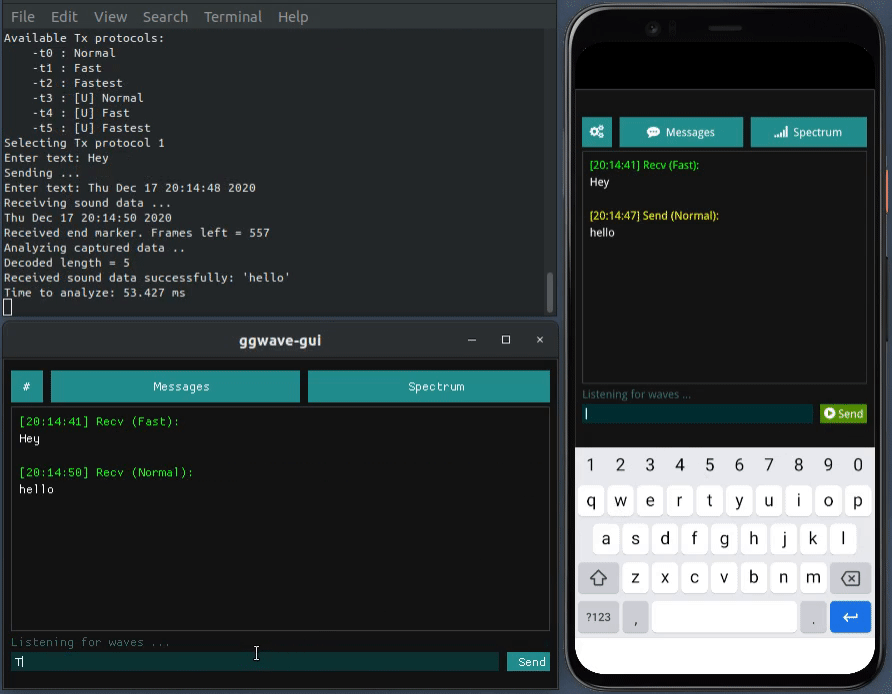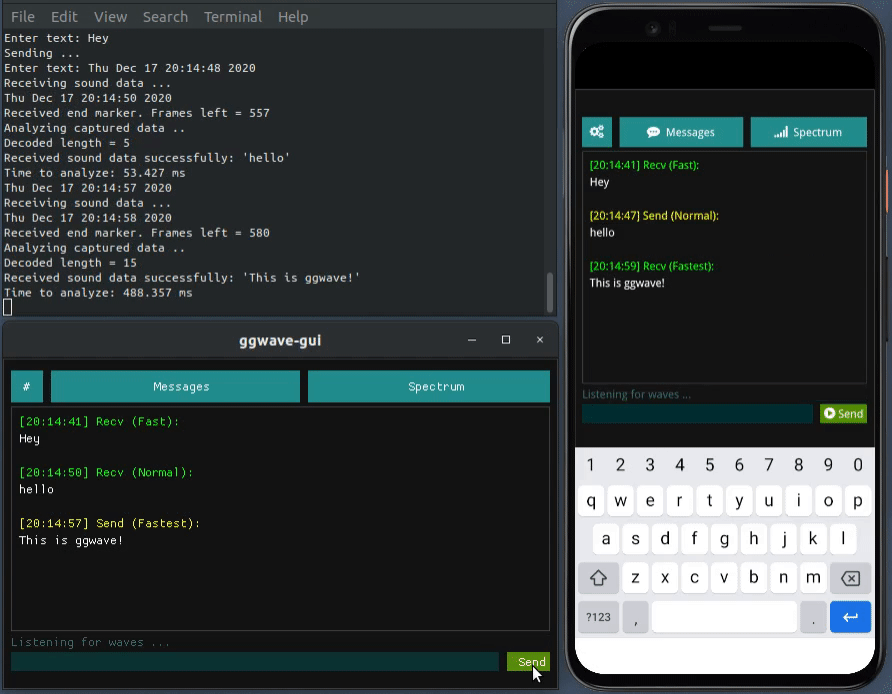
ggwave 是小型的声音传输数据 (data-over-sound) 库,用于生成和分析从音频设备(扬声器、麦克风等)播放和捕获的原始波形。只要提供用于音频样本排队和出队的回调,就可以自由使用任何音频后端(例如 PulseAudio、ALSA 等)。 该库支持使用声音在气隙设备之间传输少量数据。它实现了一个简单的基于 FSK 的传输协议,可以轻松集成到各种项目中。带宽速率在 8-16 字节/秒之间,具体取决于协议参数。纠错码 (ECC) 则用于提高解调稳定性。

优秀的个人博客,低调大师

极简 Java 工作流概念入门

关于 Flowable 松哥已经更新了好几篇文章了,不过考虑到有的小伙伴可能还从来没接触过流程引擎,因此有一些基础的内容我再来和小伙伴们梳理一下。 1. 为什么需要工作流 松哥将之前的文章转发到朋友圈后,有小伙伴评论说一直不理解为什么需要工作流,今天我们就先来说说这个话题。 假设我有一个请假需求,流程如下: 请假可以提交给我的上司,上司可以选择批准或者拒绝,无论批准还是拒绝,都会给我一个通知。 这个流程比较简单,我们很容易想到解决方案,不用工作流也能解决,有一个专门的请假表,当 A 要请假的时候,就往请假表中添加一条记录,这条记录的内容包含了请假的天数、原因、请假的审批人 B 以及一个名为 status 的字段,这个 status 字段表示这个请假申请目前的状态(待审批、已批准还是已拒绝),然后 B 登录系统之后,在请假表中查询到了 A 的请假信息,然后选择批准,此时将 status 字段的值改一下就行了。 这个流程很简单,相信小伙伴们都能想到。 然而,这是一个非常简单的流程,对于这样的流程,一般来说也确实没有必要使用工作流,但是现实中,我们涉及到的工作流往往都是非常复杂的,我举个例子,就说报销审批吧,这个可能很多小伙伴都经历过。 小伙伴们看到,这个流程相对来说还是比较复杂的,此时你再用一个 status 字段去描述,就很难说的请到底是怎么回事了。每一步审批,都有可能批准也有可能拒绝,拒绝并不意味着流程结束,员工修改报销资料之后,还可以继续提交。此时如果还用 status 去描述,那么 status 将有 N 多个值去表示不同的情况,这个维护起来非常不便。 这就复杂了吗?非也非也,我们再来看一个生产笔记本电脑的例子,假设公司研发了一款新型笔记本电脑,整个研发到生产的流程可能是这样: 相比上面两个,这个就更复杂一些了,不仅有串行任务还有并行任务,如何去设计这样一个系统?单纯的通过状态字段去描述显然已经不够用了,此时我们就得考虑一种通用的、更易维护的方案来实现这样的系统了,这种通用的、易维护的方案,也就是工作流。 2. 三大工作流 一个比较早的工作流是 jBPM,这是一个由 Java 实现的企业级流程引擎,是 JBoss 公司开发的产品之一。 jBPM 的创建者是 Tom Baeyens,这个大佬后来离开了 JBoss,并加入到 Alfresco,并推出了基于 jBPM4 的开源工作流系统 Activiti,而 jBPM 则在后续的代码中完全放弃了 jBPM4 的代码。从这个过程中也能看出来,jBPM 在发展过程中,由于意见相左,后来变成了两个 jBPM 和 Activiti。 然而戏剧的是,Activiti5 没搞多久,从 Activiti 中又分出来一个 Camunda,Activiti 继续发展,又从中分出来一个 Flowable。。。 由于开发 jBPM、Activiti、Camunda 以及 Flowable 的人多多少少有一些关联性,让人不得不猜测意见相左拉一票人出来单干是他们的企业文化。 所以现在市面上主流的流程引擎就一共有三个: Activiti Flowable Camunda 这三个各有特点: Activiti 目前是侧重云,他目前的设计会向 Spring Cloud、Docker 这些去靠拢。 Flowable 核心思想还是在做一个功能丰富的流程引擎工具,除了最最基础的工作流,他还提供了很多其他的扩展点,我们可以基于 Flowable 实现出许多我们想要的功能(当然这也是小伙伴们觉得 Flowable 使用复杂的原因之一)。 Camunda 相对于前两个而言比较轻量级,Camunda 有一个比较有特色的功能就是他提供了一个小巧的编辑器,基于 bpmn.io 来实现的(松哥之前已经发文讲过了)。如果你的项目需求是做一个轻巧的、灵活的、定制性强的编辑器,工作流是嵌入式的,那么可以选择 Camunda。 如果仔细比较起这三个的差异,能列一个长长的表格,这个网上也有不少人都总结过了,松哥这里也就不啰嗦了。 3. 流程图 既然有三个不同的工作流,那么三个不同的工作流画出来的流程图是否都各不相同呢? 不是的。 工作流程图这块其实有一个统一的标准,那就是 BPMN。BPMN 全称是 Business Process Model and Notation,中文译作业务流程模型和标记法,这个中文太绕口了,还是简称 BPMN 吧。 这是一套图形化表示法,用图形来表示业务流程模型。BPMN 最初由业务流程管理倡议组织(BPMI, Business Process Management Initiative)开发,BPMI 于 2005 年与对象管理组织(OMG, Object Management Group)合并,并于 2011 年 1 月 OMG 发布 2.0 版本,同时改为现在的名称。 一句话,就是流程图这块有一个特别古老的规范,那就是 BPMN,而我们前面所说的无论是 Activiti、Flowable 还是 Camunda,都是支持这个规范的,所以呢,无论你使用哪一个流程引擎,都可以使用同一套流程图。 那么这个规范究竟都说了些什么事情呢? 我们以上面生产笔记本的流程图为例,来和小伙伴们做一个简单介绍: 从上图中可以看到,一个流程图中主要包含四方面的内容: 事件 连线 任务 网关 我们一个一个来说。 事件 首先在一个流程图中应该有开始事件和结束事件,也就是上图大家看到的两个圆圈。另外还有一些中间事件、边界事件等。举个中间定时事件的例子,比如用户下单之后,可以有一个中间定时事件,延迟 5 分钟发货。 连线 连线就是将事件、任务、网关等连在一起的线条,一般情况下就是普通连线,有的时候连线会有一些条件,例如松哥之前文章和大家分享的请假,如果经理同意请假申请,就走哪一个线条,如果经理不同意请假申请,就走哪一个线条。对应上图的笔记本生产,如果经理审批通过,就载入图纸准备生产,如果经理审批不通过,就重新设计。 任务 任务这块其实有很多分类。 如果细分大致上可以分为如下几种: 接收任务 在上面的流程图中,等待准备工作完成这一项就是一个接收任务。这个任务里并不需要额外做什么事情,流程到这一步就自动停下来了,需要人工去点一下,推动流程继续向下执行。 发送任务 这个一般用来把消息发送给外部参与者。 服务任务 这个一般由系统自动完成,其实说白了就是我们的一个自定义类,可以在一个自定义类里边完成想要做的事情。 脚本任务 一个自动化活动。当流程执行到脚本任务时,自动执行相应的脚本。 业务规则任务 BPMN2.0 新引入用来对接业务规则引擎,业务规则任务用于同步执行一个或多个规则。 用户任务 用于为那些需要由人工参与者完成的工作建模。 虽然细分类别很多,但是仔细看,其实这几种又可以归为两大类: 用户任务:表示人工要介入做的事情。比如同意与否,或者输入一些参数,要让人工完成任务,就需要一个表单系统,让人工输入数据,或者显示数据给人看,这也是为什么用户任务和表单系统结合在一起的原因,用户任务需要用户向引擎提交一个完成任务的动作,否则流程会暂停在这里等待。 服务任务:表示机器自动做的事情。调用服务的任务,这个服务可以是一个 Spring JavaBean,也可以是一个远程 REST 服务,流程会自动执行服务任务。 活动 活动可以算是一种特殊的任务。活动可以调用另外一个流程使之作为当前流程的子流程去运行。活动也可以分为用户活动、脚本活动等等。从显示上来说,活动比任务边框深一些。仅此而已。 网关 网关要是细分起来,也有很多不同类型的网关。 互斥网关 这种网关也叫排他性网关,我们之前请假流程中的那个网关,就是互斥网关。这种网关有且仅有一个有效出口。 相容网关 这种网关会有多个出口,只要条件满足,都会执行。 事件网关 事件网关是通过中间事件驱动,它在等待的事件发生后才会触发决策。基于事件的网关允许基于事件作出决策。 并行网关 并行网关一般是成对出现的,上面生产笔记本的那个流程中,生产屏幕、键盘等并行操作,就是通过并行网关来实现的。 好啦,这就是关于流程引擎的一些基本概念,捋顺了这些基本概念,在回过头看我们前面几篇关于流程引擎的文章,应该会有一些不一样的理解: Spring Boot 整合流程引擎 Flowable,so easy! SpringBoot+Vue+Flowable,模拟一个请假审批流程! 49张图带领小伙伴们体验一把 Flowable-UI Spring Security + Vue + Flowable 怎么玩?

优秀的个人博客,低调大师

Agileutil v0.0.18 发布,极简 RPC

简介 Agileutil是一个Python3 RPC框架,client和server既可以直连,也可以通过Consul做服务注册发现。 特性 像本地函数一样调用 使用简单,用户只需要关注业务即可 HTTP/UDP/TCP 全协议支持 支持异步 async/await 安装 Python 版本 >= 3.6 pip install agileutil 快速开始 创建文件myservice.py from agileutil.rpc import rpc @rpc def hello(name): return 'hello ' + name 启动: agileutil --run myservice 详细介绍:https://gitee.com/lycclsltt/agileutil

优秀的个人博客,低调大师

每日一博 | 梯度下降极简入门

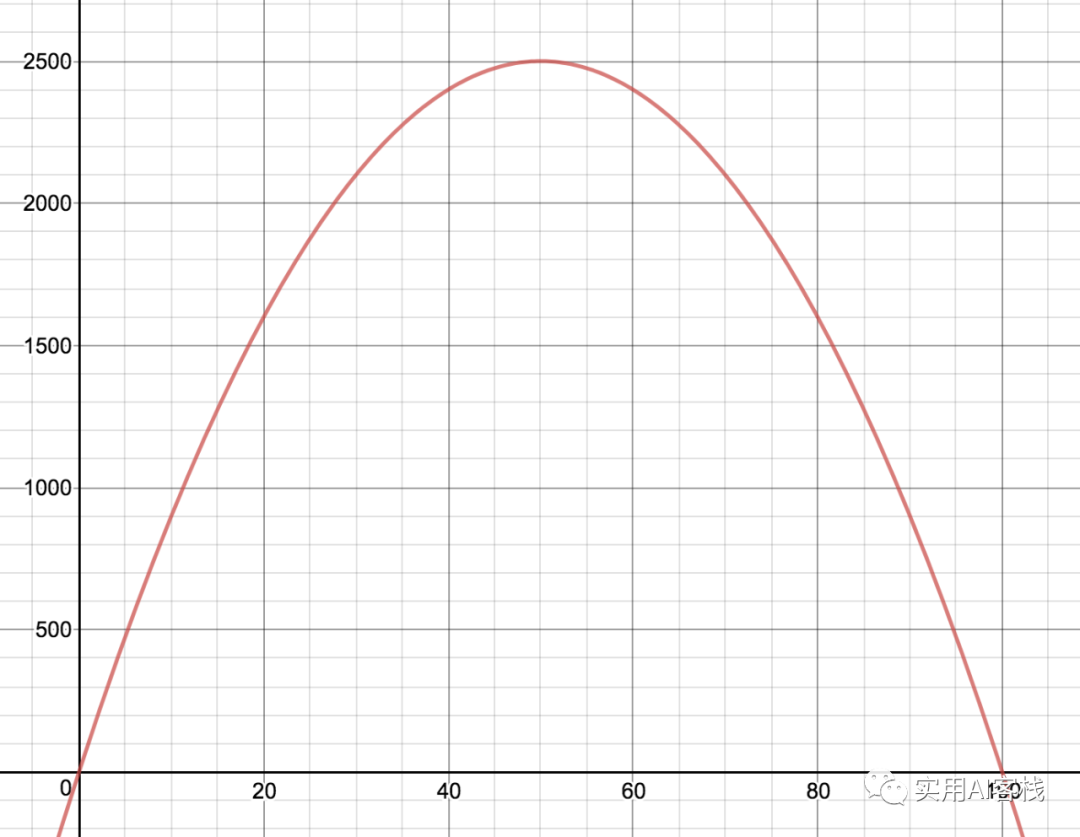
导 语 梯度下降及其变体被用作训练过程的关键部分在机器学习中广泛使用。梯度下降中的“梯度”是指单变量导数的推广形式,即多元变量求导。 梯度下降法是解决“优化问题”的迭代方法,其中优化问题是指围绕寻找函数的全局最小值或最大值而展开的数学问题。我们将很快看到,对于简单的优化问题可以不用梯度下降。当事情变得复杂时,我们则需要用诸如梯度下降之类的迭代法,当然和神经网络相关的优化问题确实足够复杂。 01 重新回顾优化问题 假设你已经购买了200米的铁丝网。您想使用此围栏为羊群创建一个矩形牧场。如何确定使牧场内部面积最大化时,牧场对应的长度和宽度? 使用标准的分析方法来解决这个问题,我们首先要写一个方程式来表示我们的问题。首先,我们知道两件事: area(面积)=length(长度)*width(宽度)(2 * length)+(2 * width)= 200 但是我们想用一个变量而不是两个变量来表示面积,所以我们可以求解这两个方程中的第二个变量的宽度: 2 * width = 200–2 * lengthwidth = [200-2 * length] / 2width = 100 - length 现在我们可以用100- length代替width,则: area= length * [100–length]area = f(length)=100 * length- length² 取面积的导数: area’=100-2*length;length=50 现在,我们找到了函数的“临界点”,即一阶导数等于零时对应的长度,当然函数在该点处的斜率也为零。我们关心这种值,因为它们是唯一能对应函数最小值或函数最大值的数。在临界点处,该点两侧的值可能都小于或都大于临界点处的值。因为函数中该点外的斜率都不为零,这意味着临界点上一边的点对应的面积将小于该临界点对应的面积,而另一边的点对应的面积将大于该临界点对应的面积。也就是说,该函数在非临界点处正在增加或减少,因此不能为最大值或最小值。 area’=100-2*length=0-->length=50 这表明如果存在全局最大值或最小值,则必须在长度= 50时发生。也就是说,如果矩形的长度存在最佳选择,则为50米。可能存在临界点既不是最小值也不是最大值,所以应该检测已发现的临界点确实是最值。在微积分课程中,有相关的检验方法(比如二阶导数检验),现在用更简单的方法(类似梯度下降法)来解决该问题,比如在临界点长度= 50的左右两侧测试2个点。 f(49)= 4900–2401 = 2499f(50)= 5000–2500 = 2500f(51)= 5100–2601 = 2499 这并不能确认矩阵面积最大时对应长度值就是50,或者某些时候有比50更好的点,不过这种近似的方法最终将应用于训练模型。对于这个简单的问题,通过绘制函数了解该方法和实际的误差: 02 梯度下降—迭代式猜测 那么这与梯度下降方法有什么关系呢?梯度下降方法比较粗糙,就像刚才所做的那些不精确的猜测一样。看上去它是比随机猜测稍强一点的显得杂乱的体系,不过它将最终成为我们解决围栏问题的方法: 猜测围栏的最佳长度 计算此时的梯度值 根据梯度的值,调整猜测 重复猜测直到满足条件则终止 假设我们随机选取57当作长度的第一个猜测值,在57处,面积函数的导数为: f(57)=100*57 - 57*57 = 2451f'(57)=100–2*(57)=-14 ‍ length = 57处的斜率不为0,因此不是临界点。此外斜率为-14表示如果将长度增加 1,则面积将减小 14(假设函数的斜率不变)。梯度下降使用此值作为进行下一个猜测的指导。比如要增加面积的值,因为斜率是负数,所以应该57基础上减小长度,以此增加面积的值。 然而即使知道当前应该减少length的值,也没有先验的方法可以确切地知道“合适”的数来调整我们的当前的猜测(length=57)。在像TensorFlow这样的软件包中,我们用来调整当前length的快慢将由一个称为“学习率”的超参数控制,可以在训练时设置该参数。提高学习率将导致梯度下降对当前当前length调整很快;减小学习率会导致梯度下降对当前当前length调整较慢。现在假设将当前length减少3,虽然有点武断,但实际上效果可以接受。 57–3 = 54f(54)= 5400–(54²)-->f(54)= 5400–2916 -->f(54)= 2484 2484大于2451,说明找到的面积比上次大。再次使用导数来检查是否处于临界点,如果不是,则调整猜测值: f'(54)= 100–2 * 54 = 100–108 = -8 我们的当前猜测值(54)仍然很大,斜率-8低于-14,应该适当减缓对当前猜测值的更改幅度,比如在54基础上减少2,则: f(52)= 5200–52² --> f(52)= 5200–2704 -->f(52)= 2496 我们将重复此过程,直到找到一个临界点。或者直到f'(length)的值非常接近零,才能认为length已足够接近临界点。手工完成此过程是重复且繁琐的,但是计算机善于解决重复繁琐的任务。通俗点说,将像在爬山和滚球,一直沿着抛物线上升,直到无法进一步上升为止。 请注意导数(蓝色),它在最大值的右边是负数,在最大值的左边是正数。在这种情况下,很容易找到最大值。 由于试图找到面积的最大值,上面的示例称之为“梯度上升”更好。在梯度下降中,每次计算梯度值时都将其相反数。 马上将提到的梯度下降和在神经网络里面用到的梯度下降有两个不一样的地方。首先,神经网络对应的函数比f(length)更复杂。我们的神经网络具有成千上万的可调参数,而其中f(length)只有一个。我们使用诸如梯度下降之类的迭代方法主要是因为神经网络模型非常复杂,而不是选用之前查找临界点时的分析过程。计算当前如此庞大规模的神经网络所表示的一般性的函数导数根本不可行。第二个区别是,在此示例中,有一个充当标准结果的实函数,并且发现了该函数的最佳值。在神经网络中,没有显式的函数;取而代之的是,我们尝试创建一个不存在标准结果的函数。 03 用于函数查找的梯度下降 在前面的示例中,使用梯度下降方法沿该曲线可以找到最佳值。在机器学习中,对于训练集中的数据,我们希望创建一条曲线来更好地拟合这些数据。回顾一下刚刚研究的围栏问题,将它转化为我们更倾向于用机器学习解决的问题。 我们从围栏数据库中收集了很多数据样本。我们数据集中的每个数据点的背景都是来自用100米围栏材料来建造矩形牧场。每个数据点有2个参数:围栏一侧的长度和围栏的面积。在这个问题中,不是尝试找到围栏的最佳长度,而是试图找到一个函数,该函数可以根据给定的边长来预测矩形围栏的面积。我们的输入数据如下所示: 看起来数据中有一个模式,我们可以使用机器学习来定义模式吗? 机器学习解决此问题的方法是认为:“看起来有点像某种数学函数,想知道到底是哪个函数?”,更进一步,我们猜测该函数是某种抛物线函数,则该函数的一般表达式是: F(x)=ax²+ bx 在数据集中已知x值和y值,现在我们将使用梯度下降法来找到a和b的最佳值。为此,我们引入了另一个函数--损失函数,并运行梯度下降以最小化损失函数。将F(x)当作“正在进行训练的函数”,其中x仍然是围栏一侧的长度,y是围栏的真实面积。单次预测的绝对误差为: L(x)= | F(x)- y | 我们需要给误差加上绝对值。如果不这样做且连续做两次预测,假设一次错了1000,另一次错了-1000,则两次错误刚好抵消,实际上这样一共错了两次。 最终我们会用这样的一个损失函数:平均绝对误差,它是数据集中所有的点对应L(x)的平均值。使用诸如均方误差之类的指标更为常见,但是不同的损失函数对不同的数据集。 假设我们随机选择权重的起始值:a = -2和b = 30。在对应的F(x)变为: L(x)= | -2x²+ 30x-y | 接下来的内容略带技巧性。我们想要调整a和b的值以最小化损失函数。因此我们需要计算损失函数对a和b的梯度(偏导数)。以前的函数中,x的值可以不断变化。但是这个问题里面,情况并非如此。x的值始终只是我们数据集中的某个固定值。因此单个数据点对应的损失函数为:L(a, b) = ax² + bx – y,其中x、y是常数。 使用平均绝对误差的损失函数为: L(a,b)=1/m*SUM(|F(a,b)—yi|)L(a,b)=(1 / m)* SUM(|axi²+ bxi — yi |) 其中xi和yi代表我们数据集中的单个数据点,而m是我们数据集中点的总数。这里有两个细节上的问题:一个是我们必须使用链式规则来计算涉及绝对值的梯度;另一个是绝对值函数在预测值恰好等于真实值的点上是不可求导的,并且。 如果平均绝对误差为0,可以通过停止计算梯度来解决不可导的问题。这是有实际意义的。如果我们在这个数据点上的预测值与实际值都符,那么就不需要用改善绝对误差的方式来调整模型: d | x |/ dx = 1,如果x为正d | x |/ dx = -1,如果x为负则损失函数对a、b求偏导数可以写成:L(a, b) = (1/m) * SUM( | axi² + bxi — yi | )L’_a(a, b) = (1 / m) * SUM( 1 * xi² ); F(xi) > yiL’_a(a, b) = (1 / m) * SUM( -1 * xi² ); F(xi) < yiL’_b(a, b) = (1 / m) * SUM( 1 * x ); F(xi) > yL’_b(a, b) = (1 / m) * SUM( -1 * x );F(xi) < yi 这些公式实际上为我们提供了一个非常简单的更新规则:如果我们的预测太小,则将a和b都增大。如果我们的预测太大,则将a和b都减小。 深刻地理解梯度下降以及优化损失函数的思路可以更好地理解过拟合之类的问题,同时它还可以帮助我们更好地了解神经网络训练的过程。 1 END 1 长 按 关 注 获取最新AI资讯与实战案例 实用AI客栈 小编微信号 : langu86 本文分享自微信公众号 - 实用AI客栈(gh_0b0b5e56231f)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

计算机极简发展史

点击蓝色“程序员cxuan”关注我哟 加个“星标”,欢迎来撩 这是程序员cxuan的第 29 篇原创分享 计算机自从 20 世纪 40 年代诞生以来,一直以史无前例的进步向前发展,如果说农业革命是第一次革命、工业革命是第二次革命的话,那么第三次革命就是 信息革命。 计算机技术的进步几乎影响着社会的方方面面,硬件的进步使得程序员可以编写出各种各样优秀的应用软件。也许不久的将来虚拟现实、无人驾驶、无现金支付就会成为现实。 1 计算机分类 计算机从用途上来讲主要分为三种: 个人计算机(Personal Computer) ,也称为 PC,这是人们最熟知的一种计算机,个人计算机强调用户体验,价格低廉,性价比高,个人计算机虽然出现时间很短,但是却大大推动了计算机历史的进程。 服务器(Server),服务器通常借助网络访问,用于执行大负载任务,可以处理复杂的应用,服务器相比个人计算机,有着更强的计算、存储和 I/O 能力。发生故障时,服务器比个人计算机恢复代价高。 服务器分为两种,一种用于处理简单小型的 web 服务,没有显示器和键盘。而另外一种是高端服务器,高端服务器通常称为超级计算机,一般由成千上万台处理器组成,内存非常大,同时价格也非常高。 嵌入式计算机(embedded computer) 是数量最多的一类计算机,应用和性能十分广泛,一般应用于汽车、电视中的微处理器,飞机、火车、家用冰箱、洗衣机等,嵌入式计算机系统是由单一应用程序或者一组相关联的应用程序组成,用户通常意识不到自己正在使用计算机。 技术的不断发展也让计算机在不断进步,对整个信息技术工业产生影响,自从个人计算机 PC 出现以来,计算机发展迅速,出现了一种个人移动设备(Personal Mobile Device, PMD),PMD 由锂电池供电,通过无线的方式访问网络,价格低廉。PMD 不再像 PC 一样拥有显示器和鼠标,作为替代的是一块触摸屏,甚至支持语音输入,PMD 的出现代表后 PC 时代的到来,而 PMD 将在未来生活中扮演更多角色。 云计算(cloud computing) 替代了传统的服务器,它依赖于一种仓储规模计算机(Warehouse Scale Computer, WSC) 的巨型数据中心,比如 AWS ,Google 这样的顶级科技公司,通过云计算实现 软件即服务(Software as a Service, Saas) 是软件工业的使命。 2 八个伟大设计思想 计算机世界的快速发展,离不开几个关键思想的影响,这些思想深刻影响着计算机设计人员 使用抽象简化设计 抽象真是一个牛逼的词汇,提高硬件和软件生产率的主要技术之一就是使用抽象(abstraction)来表示不同的设计层次,对高层次隐藏内部的实现细节,使其只看到一个大致简化版的模型。 摩尔定律 计算机设计者一个永恒的问题就是 摩尔定律(Moore's Law) 驱动的快速变化,它是由英特尔的创始人 摩尔 提出的,它的主要内容是:当价格不变时,集成电路上可容纳的元器件的数目,约每隔 18 - 24 个月便会增加一倍,性能也将提升一倍,这一定律揭示了信息进步的速度。 通过并行提高性能 并行处理是计算机的一大进步,并行指的是计算机系统中能同时执行两个或多个处理的一种计算方法,并行处理的主要目的是提高效率,缩短工作时间,但是会带来更大的复杂性。 通过流水线提高性能 在计算机结构设计中,一个特殊的并行场景是使用流水线,流水线也是一种硬件并行的设计。你一定见过大型车间或者制造厂中的流水线工业设计。 加速大概率事件 加速大概率事件要比优化小概率事件更能提高性能,大概率事件通常比小概率事件简单,大概率事件规则意味着设计者需要知道什么事件是经常发生的。 通过预测提高性能 古人通常讲一句话是 未雨绸缪,表明要做一件事情需要提前做好准备,才能更好的完成工作。预测也是一种提前做好准备的思想,通过预测的方式提前开始某些操作,会比等到确切知道这些操作启动时要快,通过另一方面提高系统性能。 存储器层次 存储器层次我在之前的文章中多次提到了,这是金字塔的层次设计模型,如下图所示 在存储器层次结构中,速度最快,容量最小的并且价格最昂贵的位于顶层,而速度最慢、容量最大而且价格便宜的位于底层。 通过冗余提高可靠性 计算机不仅要保证工作的速度、还要保证工作的可靠。由于任何一个物理器件都有可能会失效,因此可以通过使用冗余部件的方式提高系统的可靠性(dependable),冗余部件可以替代失效部件并且可以帮助其检测错误。 3 计算机程序 一个应用程序可能由数千万行代码组成,我们知道,计算机中的硬件只能提供最简单的低级指令,从复杂的应用程序到简单的指令需要经过软件的几个层次来逐步解释和翻译。下图展示了软件结构的几个层次 最外层是应用软件,最核心是硬件 ,系统软件(systems software)位于两者之间。 系统软件:通常提供服务性质的软件,包括操作系统、编译程序等。 操作系统和编译程序是对于所有计算机来说都是必须的,这两个系统软件是非常重要的,操作系统是计算机硬件和软件之间的接口;为用户提供各种调用和协调服务,操作系统主要的功能如下 处理用户输入和输出 协调内存和 CPU 为各种应用软件提供服务 而编译程序是完成另一项重要功能的程序:它把高级语言例如 C、Java、C++ 编写的程序翻译成为机器指令,这个翻译过程是非常复杂的。 编译程序 在计算机世界中,它能识别的只有两个信号:0 和 1,所以我们认为计算机只能识别二进制数。每个字母就代表计算机中的二进制位(binary digit) 或者 一位(bit)。八个二进制位成为一个字节(byte),字节是最小的寻址单元,一连串的二进制位构成了计算机术语中的 指令(instruction),即 01010101110110 等等。。。。。。 第一代程序员是直接使用二进制数与计算机通信的,这是一项非常乏味的工作,所以为了改善这种枯燥无聊的编写方式,程序员很快发明了助记符,最初助记符是通过手工翻译成为二进制的,这种转换过程过于浮躁无聊和繁琐,为了改善这种情况,程序员发明了一种 汇编程序(assembler) 的软件,可以将助记符自动转换为对应的二进制。比如我们使用助记符 add A,B ,这段代码就会自动的被二进制 0101011011。该指令告诉计算机将使用 A 和 B 进行相加操作。这种助记符使用的语言就是汇编语言(assembly language)。而机器可以理解的二进制语言称为 机器语言(machine language)。 汇编程序:将指令由助记符形式翻译成二进制形式的程序 汇编语言:以助记符形式表示的语言 机器语言:以二进制元形式表示的机器指令 然而,随着时代的发展,汇编语言也慢慢面的枯燥乏味,所以出现了像是 C、Java 这样的高级语言,也就是我们开发所使用的语言,高级语言的出现,大大提高了编程效率,但是,万变不离其宗,高级语言也要经过 这一个转换过程。高级编程语言和编译程序大大提高了软件的生产率。 使用高级语言有以下几个好处: 其一,可以让程序员使用更自然的语言来思考 其二,高级语言提高了程序员的生产率,加速程序的开发过程 其三,采用高级语言编写程序提高了程序对于计算机的独立性 4 硬件入门 看到这里你可能会有疑问,为什么要学硬件呢?换个角度来讲,凭什么培训三个月出来的程序员能够和科班学习四年的程序员一起竞争找工作?想过这个问题没有? 那是因为,培训机构不会为你的长远考虑,短期找到工作能够交差即可。把一个程序员的素养等价为找到工作即可,这本来就是这个行业的污点所在,CRUD 程序员不需要专业的程序素养,完成工作即可。为什么程序总有填不完的坑,不考虑程序健壮性、可拓展性、设计模式,写代码只为了自己,而不是以工程化的标准来要求自己就是培训班和科班的素养和差距。这也是我为什么最近在研究计算机基础的原因,因为我不够有素质。 为什么学硬件?就是能够让你从计算机的角度思考问题。好了不多说了,说多了该被培训班 diss 了。 任何一台计算机的基础硬件都需要完成最基本的功能:输入数据、输出数据、处理数据、存储数据。我们讨论的主题就是描述这些功能是怎样完成的。 下面我们就要探讨一下这些硬件 显示器 显示器是一个非常吸引人的输出设备,大多数个人移动设备都用 液晶显示(Liquid Crystal Display, LCD) 来获得轻巧、低功耗的显示效果。LCD 能够控制光的传输。今天,大多数 LCD 显示器都采用 动态矩阵显示(active matrix display) 技术,其每个像素(pixel) 都由一个晶体管精确的控制电流,从而使图像更加清晰。在彩色动态矩阵 LCD 中,还有一个 红 - 绿 - 蓝屏决定三种颜色分量的强度,每个点需要三个晶体管开关。 液晶显示,这是一种显示技术,用液体聚合物薄层的带电或者不带电来传输或者阻止光线的传输 动态矩阵显示,一种液态显示技术,使用晶体管控制单个像素上光线的传输 像素,图像元素的最小单位,屏幕由成千上万的像素来组成 图像由像素矩阵组成,可以表示成二进制位的矩阵,称为 位图(bit map)。不同分辨率所能够支持的矩阵大小不同,彩色显示器使用 8 位来表示每个三原色(红、绿和蓝),每个像素用 24 位表示,可以显示百万种不同的颜色。 计算机硬件使用光栅刷新缓冲区(又称为帧缓冲区)来保存位图以支持图像。 图中的 X0 Y0 ,X1 Y1 都表示像素 触摸屏 后 PC 时代,移动设备的高速发展,使触摸屏成为一种趋势,触摸屏有两种实现 电阻式触摸屏(Resistive touchscreens):电阻式触摸屏基于施加到屏幕上的压力来工作。电阻屏由许多层组成。当按下屏幕时,外部的后面板将被推到下一层,下一层会感觉到施加了压力并记录了输入。电阻式触摸屏用途广泛,可以用手指,指甲,手写笔或任何其他物体进行操作。 电容式触摸屏(capacitive touchscreen):电容式触摸屏通过感应物体(通常是指尖上的皮肤)的导电特性来工作。手机或智能手机上的电容屏通常具有玻璃表面,并且不依赖压力。当涉及到手势(如滑动和捏合)时,它比电阻式屏幕更具响应性。电容式触摸屏只能用手指触摸,而不能用普通的手写笔,手套或大多数其他物体来响应。 机箱 下面是一个 ipad2 的剖面图 这里面包括集成电路,也称为芯片(chip)、CPU、前置摄像头、后置摄像头、麦克风、耳机插孔、扬声器、加速计、陀螺仪、Wi-Fi 网络和蓝牙网络等。 为了进一步理解硬件,下面展示了一款苹果 A5 微处理器的实现细节,处理器从逻辑上包括两个主要部件:数据通路和控制器 数据通路主要用来执行算数运算 控制器主要负责指导数据通路、存储器和 I/O 设备按照正确的指令进行执行 除此之外,上述剖面图还包括 GPIO,通用型之输入输出的简称。 DDR SDRM 接口是内存条接口,通过提供多个隔行扫描的内存访问,从而提高内存带宽 内存是程序运行的存储空间,它同时用于保存程序运行时所使用的数据,内存由 DRAM 芯片组成。DRAM(Dynamic random access memory) 是动态随机访问存储器的缩写。在处理器内部使用的是另外一种存储器 - 缓存(cache memory) ,这是一种小而快的存储器,一般作为 DRAM 的缓冲。cache 使用的是 静态访问存储器(Static Random Access Memory, SRAM) ,它的速度要比 DRAM 更快,价格也更加昂贵。 我们上面探讨了影响计算机的几大设计思想,其中非常重要的一个思想就是 抽象,计算机硬件和软件的接口就是一种抽象,这种抽象又被叫做 指令集体系结构(instruction set architecture) ,或者简称为 体系结构(architecture)。提供给应用程序员基本指令集和操作系统接口称为 应用二进制接口(Application Binary Interface)。 这种抽象的好处是让程序员能够单独的实现应用程序,而不用考虑其内部的硬件,内部硬件和系统应用程序只提供对用户的服务。对程序员隐藏内部实现细节。 与其他计算机通信 上面我们已经基本介绍到了输入、输出、控制器、存储器,但是对于计算机,还有一项非常重要的功能我们没有介绍 - 计算机网络,通过计算机联网,可以实现与其他计算机通信,任何计算机都不能成为信息的 孤岛,计算机通信能为我们带来下面这些好处 信息交互:在联网的两台计算机之间实现信息交互 资源共享:有些 I/O 设备可以由网络上的计算机共享 远距离访问:用户可以通过远距离操作计算机 随着传输速度以及通信传输的距离,通信代价也在随之增长,网络的传输是多种多样的,最常见的就是 以太网,以太网是一种连接局域网的传统技术,它能够使设备通过协议(一组规则或通用网络语言)相互通信,以太网的接入设备可以相互识别对方,以太网中的一个例子就是 局域网(Local Area Network, LAN) ,局域网通过交换机进行组网。还有一种距离更远的网络是 广域网,广域网可支持万维网(World Wide Web)。 局域网:一种在一定的地理区域使用的传输数据的网络 广域网:一种可将区域扩展到几百几千米范围的网络 随着计算机的不断发展,通信速度和性能也在不断提升。 处理器和存储器制造技术 处理器和存储器在高速发展,计算机最初使用的是晶体管,然后后面慢慢出现了集成电路、超大规模集成电路。下表展示了这个演变过程 时间 计算机构造 1951 真空管 1965 晶体管 1975 集成电路 1995 超大规模集成电路 2013 更大规模集成电路 晶体管(transistor)是一种固体半导体器件,具有多种功能。晶体管作为一种可变电流开关,能够基于输入电压控制输出电流。集成电路(IC) 由成千上万的晶体管组成。后面不断的发展为更多晶体管组成的 超大规模集成电路(VLSL)。 性能 计算机的性能是很难评判的,我们将从以下几个方便来展开探讨 性能的定义 个人计算机用户比较感兴趣的就是 响应时间(response time),响应时间就是指一个任务从开始到完成所需要的时间,又称为执行时间。而数据中心感兴趣的常常是 吞吐率(throughput)。 响应时间:也叫 执行时间(execution time) ,是计算机完成某项任务所需要的总时间,包括硬盘访问、内存访问、I/O 活动、操作系统开销和 CPU 的执行时间等。 吞吐率:也叫 带宽(bandwidth) ,性能的另一种度量参数,表示单位时间内完成的任务数量。 性能的度量 如果使用时间来度量计算机,那么完成同样的任务,需要时间最少的计算机是最快的。程序的执行时间一般以秒为单位。我们可以使用 CPU 执行时间 来表示在 CPU 上花费的时间,而不包括其他 I/O 或应用程序的时间。CPU 时间可以进一步分为用于用户程序的时间和操作系统为用户服务花去的 CPU 时间,前者称为 CPU 时间,后者称为系统 CPU 时间。 CPU 执行时间:简称 CPU 时间,执行某一任务在 CPU 上花费的时间 用户 CPU 时间:为用户服务所花费的时间 系统 CPU 时间:为执行程序花费在操作系统上的时间。 为了一致性,我们使用 CPU 性能表示用户 CPU 时间,用系统性能表示系统空运行的响应时间。 几乎所有的计算机都会使用时钟来驱动硬件中的各种事件。时钟间隔的时间称为 时钟周期(clock cycle)。也可以用它的倒数来描述,称为 时钟频率(clock rate)。 CPU 性能及其因素 我们一般使用下面的公式来表示 CPU 的性能 CPU 执行程序的时间 = 程序 CPU 时钟周期数 * 时钟周期时间 由于时钟频率和时钟周期互为倒数的关系,所以也可以用 CPU 执行程序的时间 = 程序 CPU 时钟周期数 / 时钟频率 有了公式后,我们可以对各个指标进行描述,在时钟周期时间内,程序 CPU 时钟周期数越低,CPU 性能越高。在周期数相同的情况下,时钟频率越高,CPU 性能越高。 指令的性能 CPU 最终是要执行指令的,一个考虑指令执行时间的方法是:执行时间等于执行的指令 * 每条指令的平均时间。所以,一个程序需要的时钟周期数为 CPU 时钟周期数 = 程序指令数 * 每条指令的平均执行周期 我们一般使用 CPI(clock cycle per instruction) 表示执行每条指令所需的时钟周期的平均值。不同指令执行的周期可能不同,所以 CPI 表示的是一个平均值。 所以我们可以使用 CPU 时间 = 指令数 * CPI * 时钟周期时间 或者 CPU 时间 = 指令数 * CPI / 时钟频率 5 总结 本篇文章我们主要介绍了 计算应用分类、计算机发展的八大思想、计算机结构层次、基本硬件入门,还有计算机通信、处理器发展、性能的定义。 往期精彩回顾 cxuan 呕心沥血肝了四本 PDF。 小白如何学操作系统? Linux 进程必知必会 Linux 操作系统开篇! 感谢分享!!! 本文分享自微信公众号 - 程序员cxuan(cxuangoodjob)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册