首页 文章 精选 留言 我的

精选列表

搜索[笔记],共7229篇文章
优秀的个人博客,低调大师

vSphere笔记01~02

Vmware vsphere 虚拟化 云和大数据的底层!!!! 分类 1.开源:openstack:Linux:难(无图形化) nosqleasystack公司 2.企业版本:vsphere sdn!!!(基于openstack) vsphere套件6.5 esxi主机(vkernel) 装在物理服务器 基于Linux的系统(裁剪版)(严格意义上就叫系统而不叫操作体统) !!!!物理机——esxi——vm——os——app(openstack省掉了os) client web client Windows client vcenter 数据中心虚拟化需要 装在os上(有要求) DC域控制器(依赖)(Windows创造) 部署高级特性 vmotion:迁移HA高可用性:测量服务器性能使用率FT容错(镜像) sso hp公司 登录单点认证 清单服务器(任务服务器) 转换器:物理服务器的系统变虚拟机 vipsan vsphere 拓扑和网络 client管理esxiserver 容器的嵌套关系 端口组(类似vlan) vm-network vss虚拟标准交换机(包含端口组虚拟机 物理网卡) vds虚拟分布式交换机(需要vcenter高级特性) 作用:简化vss部署类似vtp 、简化端口组的管理 最底层物理,上面几层全是虚拟化 有时,vcenter上再装esxi,,,, 存储 sds!!!! nas网络区域存储(已经淘汰) ipsan IP存储 Linux中:lvm逻辑卷管理:pv物理卷(硬盘)vg卷组lv逻辑卷 DC 域控制器 域:计算机组成的可信任网络 域的结构 workstation创建esxi虚拟机,选择桥接模式::虚拟机和外机在同一网段!! 然后在外机上通过vsphereclient链接esxiserver!!!! vcenter部署流程 也是esxi? Dns 正向和反向的域名查找 udp dc vcenter上常规配置:(client(openfiler)远程登录vcenter主机?) 1.创建数据中心 2.添加esxi主机进入数据中心 3.利用ipsan实现共享存储 选择物理卷,添加逻辑卷文件系统:scasi esxi主机设置链接ipsan的接口 消耗物理接口1用于ipsan的连接 vcenter上设置存储适配器

优秀的个人博客,低调大师

Android Animation学习笔记

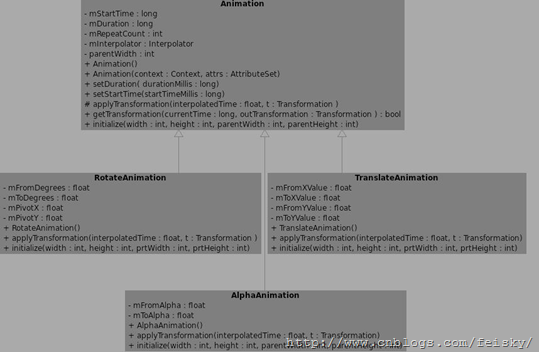
关于动画的实现,Android提供了Animation,在Android SDK介绍了2种Animation模式: 1. Tween Animation:通过对场景里的对象不断做图像变换(平移、缩放、旋转)产生动画效果,即是一种渐变动画; 2. Frame Animation:顺序播放事先做好的图像,是一种画面转换动画。 动画类型 下面先来看看Android提供的动画类型。Android的animation由四种类型组成 在XML文件中: alpha 渐变透明度动画效果 scale 渐变尺寸伸缩动画效果 translate 画面转换位置移动动画效果 rotate 画面转移旋转动画效果 在Java 源码中定义了相应的类,可以使用这些类的方法来获取和操作相应的属性: AlphaAnimation渐变透明度动画效果 ScaleAnimation渐变尺寸伸缩动画效果 TranslateAnimation画面转换位置移动动画效果 RotateAnimation画面转移旋转动画效果 Tween Animation 一个tween动画将对视图对象中的内容进行一系列简单的转换(位置,大小,旋转,透明性)。如果你有一个文本视图对象,你可以移动它,旋转它,让它变大或让它变小,如果文字下面还有背景图像,背景图像也会随着文件进行转换。 使用XML来定义Tween Animation 动画的XML文件在工程中res/anim目录,这个文件必须包含一个根元素,可以使<alpha><scale> <translate> <rotate>插值元素或者是把上面的元素都放入<set>元素组中,默认情况下,所以的动画指令都是同时发生的,为了让他们按序列发生,需要设置一个特殊的属性startOffset。动画的指令定义了你想要发生什么样的转换,当他们发生了,应该执行多长时间,转换可以是连续的也可以使同时的。例如,你让文本内容从左边移动到右边,然后旋转180度,或者在移动的过程中同时旋转,没个转换需要设置一些特殊的参数(开始和结束的大小尺寸的大小变化,开始和结束的旋转角度等等,也可以设置些基本的参数(例如,开始时间与周期),如果让几个转换同时发生,可以给它们设置相同的开始时间,如果按序列的话,计算开始时间加上其周期。 Tween Animation共同的节点属性 属性[类型] 功能 备注 Duration[long] 属性为动画持续时间 时间以毫秒为单位 fillAfter [boolean] 当设置为true ,该动画转化在动画结束后被应用 fillBefore[boolean] 当设置为true ,该动画转化在动画开始前被应用 interpolator 指定一个动画的插入器 有一些常见的插入器 accelerate_decelerate_interpolator 加速-减速 动画插入器 accelerate_interpolator 加速-动画插入器 decelerate_interpolator 减速- 动画插入器 其他的属于特定的动画效果 repeatCount[int] 动画的重复次数 RepeatMode[int] 定义重复的行为 1:重新开始 2:plays backward startOffset[long] 动画之间的时间间隔,从上次动画停多少时间开始执行下个动画 zAdjustment[int] 定义动画的Z Order的改变 0:保持Z Order不变 1:保持在最上层 -1:保持在最下层 表二 XML节点 功能说明 alpha 渐变透明度动画效果 <alpha android:fromAlpha=”0.1″ android:toAlpha=”1.0″ android:duration=”3000″ /> fromAlpha 属性为动画起始时透明度 0.0表示完全透明 1.0表示完全不透明 以上值取0.0-1.0之间的float数据类型的数字 duration为动画持续时间,ms单位 toAlpha 属性为动画结束时透明度 表三 scale 渐变尺寸伸缩动画效果 <scale android:interpolator= “@android:anim/accelerate_decelerate_interpolator” android:fromXScale=”0.0″ android:toXScale=”1.4″ android:fromYScale=”0.0″ android:toYScale=”1.4″ android:pivotX=”50%” android:pivotY=”50%” android:fillAfter=”false” android:startOffset=“700” android:duration=”700″ android:repeatCount=”10″ /> fromXScale[float] fromYScale[float] 为动画起始时,X、Y坐标上的伸缩尺寸 0.0表示收缩到没有 1.0表示正常无伸缩 值小于1.0表示收缩 值大于1.0表示放大 toXScale [float] toYScale[float] 为动画结束时,X、Y坐标上的伸缩尺寸 pivotX[float] pivotY[float] 为动画相对于物件的X、Y坐标的开始位置 属性值说明:从0%-100%中取值,50%为物件的X或Y方向坐标上的中点位置 表四 translate 画面转换位置移动动画效果 <translate android:fromXDelta=”30″ android:toXDelta=”-80″ android:fromYDelta=”30″ android:toYDelta=”300″ android:duration=”2000″ /> fromXDelta toXDelta 为动画、结束起始时 X坐标上的位置 fromYDelta toYDelta 为动画、结束起始时 Y坐标上的位置 表五 rotate 画面转移旋转动画效果 <rotate android:interpolator=”@android:anim/accelerate_decelerate_interpolator” android:fromDegrees=”0″ android:toDegrees=”+350″ android:pivotX=”50%” android:pivotY=”50%” android:duration=”3000″ /> fromDegrees 为动画起始时物件的角度 说明 当角度为负数——表示逆时针旋转 当角度为正数——表示顺时针旋转 (负数from——to正数:顺时针旋转) (负数from——to负数:逆时针旋转) (正数from——to正数:顺时针旋转) (正数from——to负数:逆时针旋转) toDegrees 属性为动画结束时物件旋转的角度 可以大于360度 pivotX pivotY 为动画相对于物件的X、Y坐标的开始位 说明:以上两个属性值 从0%-100%中取值 50%为物件的X或Y方向坐标上的中点位置 下面给出一个完整的XML定义(SDK提供) <set android:shareInterpolator="false" xmlns:android="http://schemas.android.com/apk/res/android"> <scale android:interpolator="@android:anim/accelerate_decelerate_interpolator" android:fromXScale="1.0" android:toXScale="1.4" android:fromYScale="1.0" android:toYScale="0.6" android:pivotX="50%" android:pivotY="50%" android:fillAfter="false" android:duration="700" /> <set android:interpolator="@android:anim/decelerate_interpolator"> <scale android:fromXScale="1.4" android:toXScale="0.0" android:fromYScale="0.6" android:toYScale="0.0" android:pivotX="50%" android:pivotY="50%" android:startOffset="700" android:duration="400" android:fillBefore="false" /> <rotate android:fromDegrees="0" android:toDegrees="-45" android:toYScale="0.0" android:pivotX="50%" android:pivotY="50%" android:startOffset="700" android:duration="400" /> </set> </set> Tween Animation如何使用 使用AnimationUtils类的静态方法loadAnimation()来加载XML中的动画XML文件 //main.xml中的ImageView ImageView spaceshipImage = (ImageView) findViewById(R.id.spaceshipImage); //加载动画 Animation hyperspaceJumpAnimation =AnimationUtils.loadAnimation(this, R.anim.hyperspace_jump); //使用ImageView显示动画 spaceshipImage.startAnimation(hyperspaceJumpAnimation); 如何在Java代码中定义动画 //在代码中定义 动画实例对象 private Animation myAnimation_Alpha; private Animation myAnimation_Scale; private Animation myAnimation_Translate; private Animation myAnimation_Rotate; //根据各自的构造方法来初始化一个实例对象 myAnimation_Alpha=new AlphaAnimation(0.1f, 1.0f); myAnimation_Scale =new ScaleAnimation(0.0f, 1.4f, 0.0f, 1.4f, Animation.RELATIVE_TO_SELF, 0.5f, Animation.RELATIVE_TO_SELF, 0.5f); myAnimation_Translate=new TranslateAnimation(30.0f, -80.0f, 30.0f, 300.0f); myAnimation_Rotate=new RotateAnimation(0.0f, +350.0f, Animation.RELATIVE_TO_SELF,0.5f,Animation.RELATIVE_TO_SELF, 0.5f); interpolator的解释 interpolator定义一个动画的变化率(the rate of change)。这使得基本的动画效果(alpha, scale, translate, rotate)得以加速,减速,重复等。 Interpolator 定义了动画的变化速度,可以实现匀速、正加速、负加速、无规则变加速等。Interpolator 是基类,封装了所有 Interpolator 的共同方法,它只有一个方法,即 getInterpolation (float input),该方法 maps a point on the timeline to a multiplier to be applied to the transformations of an animation。Android 提供了几个 Interpolator 子类,实现了不同的速度曲线,如下: AccelerateDecelerateInterpolator 在动画开始与介绍的地方速率改变比较慢,在中间的时候加速 AccelerateInterpolator 在动画开始的地方速率改变比较慢,然后开始加速 CycleInterpolator 动画循环播放特定的次数,速率改变沿着正弦曲线 DecelerateInterpolator 在动画开始的地方速率改变比较慢,然后开始减速 LinearInterpolator 在动画的以均匀的速率改变 Frame Animation Frame Animation是顺序播放事先做好的图像,跟电影类似。不同于animation package, Android SDK提供了另外一个类AnimationDrawable来定义、使用Frame Animation。 Frame Animation可以在XML Resource定义(还是存放到res\anim文件夹下),也可以使用AnimationDrawable中的API定义。由于Tween Animation与Frame Animation有着很大的不同,因此XML定义的格式也完全不一样,其格式是:首先是animation-list根节点,animation-list根节点中包含多个item子节点,每个item节点定义一帧动画,当前帧的drawable资源和当前帧持续的时间。下面对节点的元素加以说明: XML属性 说明 drawable 当前帧引用的drawable资源 duration 当前帧显示的时间(毫秒为单位) oneshot 如果为true,表示动画只播放一次停止在最后一帧上,如果设置为false表示动画循环播放。 variablePadding If true, allows the drawable’s padding to change based on the current state that is selected. visible 规定drawable的初始可见性,默认为flase; 下面就给个具体的XML例子,来定义一帧一帧的动画: <animation-list xmlns:android="http://schemas.android.com/apk/res/android" android:oneshot="true"> <item android:drawable="@drawable/rocket_thrust1" android:duration="200" /> <item android:drawable="@drawable/rocket_thrust2" android:duration="200" /> <item android:drawable="@drawable/rocket_thrust3" android:duration="200" /></animation-list> 上面的XML就定义了一个Frame Animation,其包含3帧动画,3帧动画中分别应用了drawable中的3张图片:rocket_thrust1,rocket_thrust2,rocket_thrust3,每帧动画持续200毫秒。 然后我们将以上XML保存在res/anim/文件夹下,命名为rocket_thrust.xml,显示动画的代码: AnimationDrawable rocketAnimation;public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.main); ImageView rocketImage = (ImageView) findViewById(R.id.rocket_image); rocketImage.setBackgroundResource(R.anim.rocket_thrust); rocketAnimation = (AnimationDrawable) rocketImage.getBackground();}public boolean onTouchEvent(MotionEvent event) { if (event.getAction() == MotionEvent.ACTION_DOWN) { rocketAnimation.start(); return true; } return super.onTouchEvent(event);} 代码运行的结果:3张图片按照顺序的播放一次. 有一点需要强调的是:启动Frame Animation动画的代码rocketAnimation.start();不能在OnCreate()中,因为在OnCreate()中AnimationDrawable还没有完全的与ImageView绑定,在OnCreate()中启动动画,就只能看到第一张图片。这里实在拖曳事件中实现的。 下面,阅读Android SDK中对AnimationDrawable的介绍,有个简单的了解: AnimationDrawable 获取、设置动画的属性 int getDuration() 获取动画的时长 int getNumberOfFrames() 获取动画的帧数 boolean isOneShot() Void setOneShot(boolean oneshot) 获取oneshot属性 设置oneshot属性 void inflate(Resurce r,XmlPullParser p, AttributeSet attrs) 增加、获取帧动画 Drawable getFrame(int index) 获取某帧的Drawable资源 void addFrame(Drawable frame,int duration) 为当前动画增加帧(资源,持续时长) 动画控制 void start() 开始动画 void run() 外界不能直接掉调用,使用start()替代 boolean isRunning() 当前动画是否在运行 void stop() 停止当前动画 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/01/11/1644482.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Service学习笔记

一 什么是Service 服务是运行在后台的一段代码。它可以运行在它自己的进程,也可以运行在其他应用程序进程的上下文(context)里面,这取决于自身的需要。其它的组件可以绑定到一个服务(Service)上面,通过远程过程调用(RPC)来调用这个方法。例如媒体播放器的服务,当用户退出媒体选择用户界面,仍然希望音乐依然可以继续播放,这时就是由服务(service)来保证当用户界面关闭时音乐继续播放的。 它跟Activity的级别差不多,但是他不能自己运行,需要通过某一个Activity或者其他Context对象来调用,Context.startService()和Context.bindService()。两种启动Service的方式有所不同。这里要说明一下的是如果你在Service的onCreate或者onStart做一些很耗时间的事情,最好在Service里启动一个线程来完成,因为Service是跑在主线程中,会影响到你的UI操作或者阻塞主线程中的其他事情。什么时候需要Service呢?比如播放多媒体的时候用户启动了其他Activity这个时候程序要在后台继续播放,比如检测SD卡上文件的变化,再或者在后台记录你地理信息位置的改变等等。 二 如何使用Service 1.第一种是通过调用Context.startService()启动,调用Context.stopService()结束,startService()可以传递参数给Service。 2.第二种方式是通过调用Context.bindService()启动,调用Context.unbindservice()结束,还可以通过ServiceConnection访问Service。 二者可以混合使用,比如说我可以先startService再bindservice。 三 service生命周期 startService后,即使调用startService的进程结束了,Service仍然还存在,直到有进程调用stopService,或者Service自己自杀(stopSelf())。bindService后,Service就和调用bindService的进程同生共死了,也就是说当调用bindService的进程死了,那么它bind的Service也要跟着被结束,当然期间也可以调用unbindservice让Service结束。 两种方式混合使用时,比如说你startService了,我bindService了,那么只有你stopService了而且也unbindservice了,这个Service才会被结束。 Android系统将会尝试保留那些启动了的或者是绑定了服务的进程。如果该服务正在进程的onCreate(), onStart(),或者onDestroy()这些方法中执行时,那么主进程将会成为一个前台进程,以确保此代码不会被停止。如果服务已经开始,那么它的主进程会就重要性而言低于所有可见的进程但高于不可见的进程,由于只有少数几个进程是用户可见的,所以只要不是内存特别低,该服务不会停止.。如果有多个客户端绑定了服务,只要客户端中的一个对于用户是可见的,即认为该服务可见。 如果Service还没有运行,则android先调用onCreate()然后调用onStart();如果Service已经运行,则只调用onStart(),所以一个Service的onStart方法可能会重复调用多次。 stopService的时候直接onDestroy,如果是调用者自己直接退出而没有调用stopService的话,Service会一直在后台运行。该Service的调用者再启动起来后可以通过stopService关闭Service。 所以调用startService的生命周期为:onCreate --> onStart(可多次调用) --> onDestroy 使用context.bindService()启动Service会经历: context.bindService()->onCreate()->onBind()->Service running onUnbind() -> onDestroy() ->Service stop onBind将返回给客户端一个IBind接口实例,IBind允许客户端回调服务的方法,比如得到Service运行的状态或其他操作。这个时候把调用者(Context,例如Activity)会和Service绑定在一起,Context退出了,Srevice就会调用onUnbind->onDestroy相应退出。 所以调用bindService的生命周期为:onCreate --> onBind(只一次,不可多次绑定) --> onUnbind --> onDestory。 所以,在Service每一次的开启关闭过程中,只有onStart可被多次调用(通过多次startService调用),其他onCreate,onBind,onUnbind,onDestory在一个生命周期中只能被调用一次。 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/archive/2010/06/14/1758336.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Python 学习笔记 - Memcached

Memcached是一个分布式内存对象缓存系统,他把数据缓存在内存里面来减少对数据库的访问,从而提高动态网页的访问速度。他的基本结构是key/value(键值对)。下面看看在Python里面如何使用。 首先来安装一下服务器端,豆子直接在一个CentOS7的机器上安装 [root@sydnagios~]#yuminstallmemcachedLoadedplugins:fastestmirror,langpacksRepodataisover2weeksold.Installyum-cron?Orrun:yummakecachefastbase|3.6kB00:00epel/x86_64/metalink|2.0kB00:00epel|4.3kB00:00extras|3.4kB00:00updates|3.4kB00:00(1/5):epel/x86_64/group_gz|170kB00:00(2/5):epel/x86_64/updateinfo|671kB00:00 然后服务器端跑起来,这个里面我指定的端口是12000,因此如果有防火墙别忘记打开对应端口 [root@sydnagios~]#memcached-d-m10-uroot-l10.2.1.107-p12000-c256-P/tmp/memcached.pid 参数说明: - d 是启动一个守护进程 - m 是分配给Memcache使用的内存数量,单位是MB - u 是运行Memcache的用户 - l 是监听的服务器IP地址 - p 是设置Memcache监听的端口,最好是 1024 以上的端口 - c 选项是最大运行的并发连接数,默认是 1024 ,按照你服务器的负载量来设定 - P 是设置保存Memcache的pid文件 打开防火墙端口 firewall-cmd--add-port=12000/tcp--permanent 接下来安装Python的客户端模块 从这里下载https://pypi.python.org/pypi/python-memcached 解压拷贝到sys.path对应的目录,就能直接用了 看看第一个例子,可以通过set来设置数据,get来获取数据。里面debug是为了显示错误的 生产环境里面不要用 #!/usr/bin/envpython#-*-coding:utf-8-*-#AuthorYuanLiimportmemcachemc=memcache.Client(['10.2.1.107:12000'],debug=True)mc.set("foo","bar")mc.add("name","John")print(mc.get('foo'))print(mc.get('name'))-----------barJohn memcached的第二个特点是他默认支持集群,原理是内存里面创建一个主机的列表;每个主机有一个权重,权重的数目和主机在列表里面出现的数目成正比。通过算法可以决定把键值对放在哪个服务器的内存里面。 例2 mc=memcache.Client([('1.1.1.1:12000',1),('1.1.1.2:12000',2),('1.1.1.3:12000',1)],debug=True)mc.set('k1','v1') 除了get和set以外,他还具有以下常用函数 add添加一条键值对,如果已经存在的 key,重复执行add操作异常 replacereplace 修改某个key的值,如果key不存在,则异常 set 和 set_multi set 设置一个键值对,如果key不存在,则创建,如果key存在,则修改set_multi 设置多个键值对,如果key不存在,则创建,如果key存在,则修改 delete 和 delete_multi delete 在Memcached中删除指定的一个键值对delete_multi 在Memcached中删除指定的多个键值对 append 和 prepend append 修改指定key的值,在该值 后面 追加内容prepend 修改指定key的值,在该值 前面 插入内容 decr 和 incr incr 自增,将Memcached中的某一个值增加 N ( N默认为1 )decr 自减,将Memcached中的某一个值减少 N ( N默认为1 ) gets 和cas 这个组合可以避免脏数据的产生,如果在gets数据,和cas数据回去这个过程中有其他用户执行了get,那么则不允许修改

优秀的个人博客,低调大师

Storm Ack框架笔记

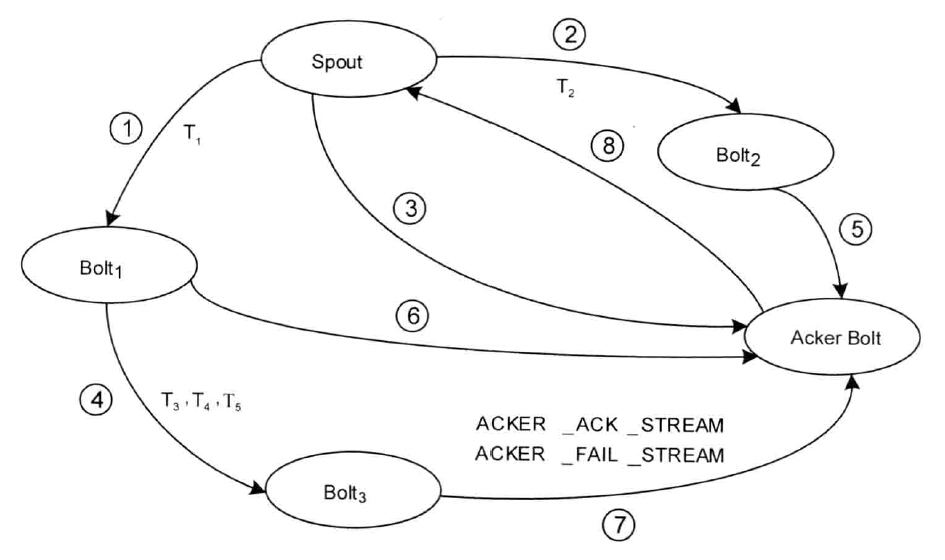
Storm利用Acker Bolt节点跟踪消息,当Spout发送出去的消息以及这些消息所衍生出来的消息均被处理后,Spout将受到对应于该消息的Ack。实现要点: 1、Storm中每条发送出去的消息都会对应一个随机的消息ID。 2、Spout发送消息后,将向Acker Bolt发送一条消息,该消息内容为<RootId,消息ID>,Acker bolt将为该消息创建一条跟踪项。 3、Bolt产生要发送的消息时,会计算每条新消息的消息ID,并将消息ID发送至Acker Bolt,Acker Bolt对消息ID进行异或后存储。于是,Storm对新发送的消息进行了跟踪。 4、Blot对输入的消息进行Ack时,也会将该消息ID发送到Acker Bolt,Acker Bolt对每条消息ID进行异或存储,由于该消息在被发送时,已经向Acker Bolt发送过消息ID,之后再被Acker时又再次发送该消息ID。根据异或的语义,这相当于对该消息的跟踪结束。 5、Acker Bolt在更新某一个消息的跟踪值时,若发现其跟踪值变为零,则向Spout节点发送消息,表明Spout发送的这条消息已经被成功处理。 6、若Spout在发送消息时未指定用于消息跟踪的ID,系统则不对消息进行跟踪,Blot新产生的消息并不会被单独跟踪。 7、Spout的每条消息以及由该消息演化而来的所有消息的跟踪负载为16个字节,8个字节的根消息ID以及8个字节的消息跟踪值AckValue.但是,由于Storm中采用HashMap对其进行存储,在32位的JVM中,每条消息至少需要20个字节的额外负载,故一条消息的跟踪需要40个字节左右的负载。 (一)1与2中,Spout发送T1到Bolt1,发送T2到Bolt2.T1和T2具有相同的内容,但表示不同的备份,每条消息都会对应一个ID,消息T1的anchors为<RootId,T1>,消息T2的anchors为<RootId,T2> (二)3中,Spout在Acker Bolt中注册了一条记录RootId=T1^T2。 (三)4与6中,Bolt1发送新的消息T3、T4、T5到Blot3,同时对输入的消息进行Ack操作,消息内容为<RootId,T1^T3^T4^T5>,此时,Acker Bolt中的跟踪项为<RootId,T1^T2^T1^T3^T4^T5=>T2^T3^T4^T5>。 (四)在5中,Bolt2对输入的消息T2进行Ack操作,它没有产生新的消息,发送到Acker Bolt的消息为<RootId,T2>,T2异或后消失。 (五)在7中,Blot3对输入的消息进行Ack操作,发送的消息为<RootId,T3^T4^T5>,此时Acker Bolt中的跟踪项为<RootId,T3^T4^T5^T3^T4^T5 =>0> (六)Acker Bolt发现RootId对应的值为零,它认为该RootId对应的消息以及所有衍生出来的消息均已经被成功处理,于是它向Spout发送消息,而Spout将调用Ack回调方法。 那么每条被处理的消息必须进行Ack或者Fail操作,否则,虽然有超时机制可以对过期消息进行清空,但可能导致消息不断重传。(所以项目中每次进入bolt都有唯一性过滤?) 参考:《Storm 源码分析》

优秀的个人博客,低调大师

docker app 打包笔记

docker介绍 https://www.docker.io/ 我的需求 此次希望将要发布的app和执行环境进行打包, app使用python django开发。 这次我打算打包的步骤为: 自己制作docker的base image 配置app执行环境 将制作好的容器导出成文件,用于其他机器的导入 开始执行 制作base image 首先我们先提取一个最小的rootfs, 我现在使用的系统是ubuntu12.04, 我想制作一个12.04的也就是precise的rootfs: sudo debootstrap precise ubuntu #precise 为 /usr/share/debootstrap/scripts 下存在的debootstrap script #ubuntu 就是当前目录下的一个目录 制作过程比较长,制作完成后我们来把它导入到docker中成为一个image: tar -C ubuntu -c . | sudo docker import - ubuntu 完成后我们就制作好了一个docker的base image, 我们可以同做下面这个命令来查看: sudo docker images 配置app环境 首先我要把app代码拷进容器中,这个是可以通过dockerfile 中的ADD来做的,不过我还没有仔细看dockerfile,就先手动通过qiniu上传在下载到运行中的容器中的. 首先我们要用docker使用我们前面制作好的image跑起一个shell sudo docker run -i -t ubuntu bash => root@210ae349a593:/# 然后我们就可以在这个启动中的bash中来执行我们的常用操作了,我把上传的代码wget下来到/docker_app, 对我把它放在了启动的容器的根目录下的docker_app,现在我要安装我app的依赖。 我先手动wget下来python的setuptools和pip,手动安装好.因为依赖中有MySQL-python,如果要用pip来安装的话要编译,编译的话需要安装mysql的一些lib,会使image变大,所以直接用apt-get安装了二进制的,并在requirments.txt中删掉了MySQL-python. 因为依赖中还有一个Pillow需要编译,所以忍痛装上的gcc和python-dev. 然后在docker_app目录下 pip install -r requirments.txt -i http://pypi.douban.com/simple 修改app配置文件中的数据库的地址,我们要查看我们本机docker0虚拟网卡的ip, 我机器的显示是: ifconfig => docker0 Link encap:Ethernet HWaddr 76:71:61:ca:84:1b inet addr:172.17.42.1 Bcast:0.0.0.0 Mask:255.255.0.0 inet6 addr: fe80::c10:64ff:fe74:c0c6/64 Scope:Link UP BROADCAST RUNNING MULTICAST MTU:1500 Metric:1 RX packets:617463 errors:0 dropped:0 overruns:0 frame:0 TX packets:678907 errors:0 dropped:0 overruns:0 carrier:0 collisions:0 txqueuelen:0 RX bytes:56062519 (56.0 MB) TX bytes:267105247 (267.1 MB) 所以我就把数据库ip改成 172.17.42.1, ok,环境配置好的,我们保持这个shell session,然后打开另一个shell session执行以下命令查看现在运行的这个容器的id: sudo docker ps => CONTAINER ID IMAGE .... 210ae349a593 ubuntu:latest .... 然后我们将这个容器commit 成 docker_app: sudo docker commit 210ae349a593 docker_app 我们再次执行sudo docker images, 就会发现我们生成的 docker_app 的image 下面我们 exit 刚才我们配置环境的那个 shell, 来测试一下我们配置的环境的image. sudo docker run -i -t -d -p 8000:8000 docker_app python /docker_app/manage.py runserver 0.0.0.0:8000 这样我们就把本地8000端口和任务容器的8000端口做了映射,接下来我们就可以在本地浏览器上访问我们http://127.0.0.1:8000来访问我们的应用了, 我们还可以查看容器的输出日志,容器id为我们sudo docker ps出来的CONTAINER ID: sudo docker logs -f <容器id> => Validating models... 0 errors found March 27, 2014 - 14:14:10 Django version 1.6.1, using settings 'app.settings' Starting development server at http://0.0.0.0:8000/ Quit the server with CONTROL-C. 导出我们制作好的image docker 本身是有push 来上传的 index.docker.io 的,使用是用pull来拉取,但是由于在天朝,网络不给力。所以就导出成文件吧,docker官方也有给出自建image server的方案,貌似项目还不太成熟,以后再研究. 现在我们 docker ps 出刚才运行的那个容器的 id, 将它导出 sudo docker export <容器id> > docker_app.tar 完成后我们刚才制作的容器就导出成了 docker_app.tar 文件, 以后在其他机器部署的时候执行导入 cat docker_app.tar | sudo docker import - docker_app 管道后面的 docker_app 为导入后image命名,自己指定

优秀的个人博客,低调大师

NDK抄书笔记【枯燥】

版权归他们:《Android高级开发实战---UI、NDK与安全》 王氏兄弟 1.何为JNI JNI (Java Native Interface) 即Java本地开发接口,也是C/C++与Java通信的一个协议,这个协议可以使Java代码与C/C++代码之间进行沟通,通过该协议,Java代码就可以调用C/C++代码,C/C++代码也可以调用Java代码,这样就可以将Java程序与C/C++程序集成到一起。 2.为什么要用JNI a. JNI扩张了Java虚拟机的能力。Java语言是不能够直接操作硬件的(Java在实现跨平台操作时,将硬件操作全部封装起来)。例如,Java语言是不能够直接用来开发驱动的,但Java可以通过JNI来做一些驱动开发(驱动开发需要操作硬件,而C语言可以实现对硬件的操作,Java通过JNI协议,可以实现对C的调用) b. C/C++语言的运行效率高(Java的执行效率相对低一点,魔乐科技的李兴华说:java实在c++的基础上改写而来,C#是由java和c++改写而来),应用比较广泛例如,数学运算、实时渲染Opengl、音/视频处理ffmpeg c. 直接复用C/C++中的优秀代码(文件压缩、人脸识别) d. Java不可以手动释放内存,而C/C++可以实现手动控制内存,如果对内存的利用有较高要求时,需要使用C/C++来实现。 e.特殊的业务场景,如高级汽车上安装的车载电脑的onboard debug system,需要获取硬件的电信号 3.如何使用JNI NDK,Natvie Develop Kits,·可以将C/C++语言写出来的源代码编译成可执行的文件(文件格式以.so为 扩展名,该文件组成的库称之为“可执行动态库”)。 Java端需要有JVM和Class类(得到Class对象后,就可以调用该Class中的方法);C/C++端需要有function函数与function.lib函数库。C/C++的函数通过JNI机制去调用Java端的Class方法;Java端通过JNI机制去调用C/C++端的函数或者函数库。JNI在此充当C/C++与Java通信的桥梁。 Java源码经过被编译后生成了.class文件(Java字节码),通过类加载器将字节码加载到Java类库中,然后再JVM中对字节码进行解释 、翻译后才可以被计算机所识别出来;而C/C++经过编译后,生成了一个.exe文件,没有Java中将数据装载到虚拟机中进行解释、翻译这一步,两者从编译到运行的基本过程比较:C/C++-->(*.exe)-->机器,Java-->(*.class)-->JVM-->机器,这是 C/C++的运行效率高于Java的原因。 4.NDK与JNI的关系 Java通过JNI机制和C/C++沟通的具体步骤: a.编写包含native本地方法的Java类 b.通过javah工具生成C/C++语言的头文件 c.使用C/C++语言实现头文件 d.使用交叉编译工具对C/C++本地代码进行编译,最后通过链接生成*.so可执行的C/C++库 e.实际执行Java代码去和本地的C/C++代码相互沟通 5.JNI中的Java VM与JNIEnv对象 在标准的Java平台下,每一个进程里可以产生很多Java VM对象,每一个Java VM对象都有一个与之对应的Java VM对象,但是在Android平台上,每一个进程只能产生一个Dalvik VM对象,也就是说一个Android的进程中是通过有且只有一个虚拟器对象来服务所有的Java和C/C++代码 Android中的JNIEnv对象与Dalvik的Java VM具体关系: a. JNIEnv *内部包含一个指针,指针指向Dalvik的Java VM对象的Function Table,JNIEnv *关于程序执行环境众多函数正式来源于Dalvik虚拟机 b.Android中每当一个Java线程第一次要调用本地C/C++代码时,Dalvik虚拟机实例会为该Java线程产生一个JNIEnv*指针 c.Java每条线程在和C/C++相互调用时的JNIEnv*是相互独立的,互不干扰,这就提升了并发执行时的安全性 d.当本地的C/C++代码想获得当前线程所要使用的JNIEnv时可以使用Dalvik VM对象的Java VM* jvm->GetEnv()方法,该方法即会返回当前线程所在的JNIEnv * 6.Java、Dalvik VM、C/C++的运行机制与流程 a.Java的dex字节码和C/C++的*.so同时运行Dalvik VM之内,共同使用一个进程空间。 b.Java和C/C++可以相互调用,其调用的关键均是Dalvik VM c.一般而言,比较经典的模式是Java通过JNI的C组件和C++相互沟通,一般的业务处理代码是放在C++中的 d.C++代码处于核心的控制地位具有更高的价值 当Java代码需要C/C++代码时,在Dalvik虚拟机加载进*.so库时,会先调用JNI_OnLoad()函数,此时就会把Java VM对象的指针存储于C层JNI组件的全局环境中。在Java层调用C层的本地函数时,调用C本地函数的线程必然会通过Dalvik VM来调用C层的本地函数,此时Dalvik虚拟机会为本地的C组件实例化一个JNIEnv指针,该指针指向Dalvik 虚拟机的具体的函数列表,当JNI 的C组件调用Java成的方法或者属性时,需要通过JNIEnv指针来进行调用 当C++组件主动调用Java的方法或属性时,需要 通过JNI的C组件把JNIEnv指针传递给C++组件,此后,C++组件即可通过JNIEnv指针来掌控Java层代码。 关于android系统的图像处理再多说一句,运行时间长的操作尽量都放在服务器端,否则用户会崩溃的。

优秀的个人博客,低调大师

深度学习入门笔记系列 ( 七 ) ——循环神经网络(RNN)学习笔记

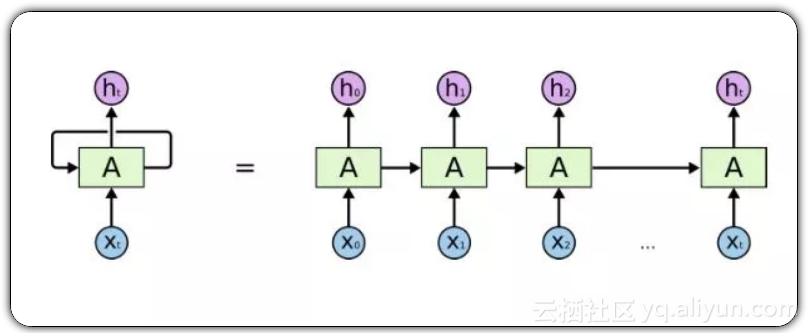
1.引言 在传统的神经网络模型中 ,是从输入层到隐含层再到输出层 ,层与层之间是全连接的 ,每层之间的节点是无连接的 。但是这种普通的神经网络对于很多问题却无能无力 。例如 ,你要预测句子的下一个单词是什么 ,一般需要用到前面的单词 ,因为一个句子中前后单词并不是独立的 。于是乎 ,我们就名正言顺的引出了这篇文章的 RNN 。 2.什么是RNN RNN(Recurrent Neural Networks)翻译为循环神经网路 ,与传统神经网络模型对比 ,RNN 一个序列当前的输出与前面的输出也有关 。具体的表现形式为网络会对前面的信息进行记忆并应用于当前输出的计算中 。重点的讲就是 ,隐藏层之间的节点之间是有连接的 ,并且隐藏层的输入不仅包括输入层的输出还包括上一时刻隐藏层的输出 。 例如上图 ,中间A表示隐含层 ,能够看出来从左到右的序列中 ,隐含层输入不仅包括输入层还有上一个序列的隐含层输出 。 3.RNN 能干些啥 理论上 ,RNN 能够对任何长度的序列数据进行处理 。但是在实践中 ,为了降低复杂性往往假设当前的状态只与前面的几个状态相关 ,下图便是一个典型的RNN : 坦白讲 ,小詹对 RNN 只知道基础概念 ,用的很少很少 。因为个人感觉 RNN 更多的应用到 NLP 即自然语言处理中 ,如如词向量表达 、语句合法性检查 、词性标注 。与之相对的 ,在计算机视觉领域 ,可能 CNN 及其变种使用的更为频繁 ,但是 RNN 也并非无用武之地 。 RNN 可以应用的领域大致有 : ●语言模型与文本生成(Language Modeling and Generating Text) ●机器翻译(Machine Translation) ●语音识别(Speech Recognition) ●图像描述生成 (Generating Image Descriptions) 4.LSTM网络 和 CNN 一样 ,基础的 RNN 网络也存在很多改进和拓展 ,相信大家听到比较多的是 LSTM(Long Short Term Memory)。 它与一般的 RNN 结构本质上并没有什么不同 ,只是使用了不同的函数去去计算隐藏层的状态 。在 LSTM 中 ,i 结构被称为 cells ,可以把 cells 看作是黑盒用以保存当前输入 xt 之前的保存的状态 ht−1 ,这些 cells 更加一定的条件决定哪些 cell 抑制哪些 cell 兴奋 。它们结合前面的状态 、当前的记忆与当前的输入 。已经证明 ,该网络结构在对长序列依赖问题中非常有效 。 原文发布时间为:2018-09-4 本文作者:小詹 本文来自云栖社区合作伙伴“小詹学Python”,了解相关信息可以关注“小詹学Python”。

优秀的个人博客,低调大师

LangChain原理学习笔记

最新越发觉得AI的发展,对未来是一场革命,LangChain已经在工程设计上有了最佳实践,类似于AI时代的编程模型或编程框架,有点Spring框架的意思。之前在LangChain上也有些最佳实践,所以在这里分享记录下。 LangChain解决什么问题 LangChain是基于LLM之上的,在应用层和底层LLM之前的一个很好的编程框架,如果把LLM比喻为各种类型的数据库、中间件等这些基础设施,应用层是各种业务逻辑的组合之外,那么LangChain就负责桥接与业务层和底层LLM模型,让开发者可以快速地实现对接各种底层模型和快速实现业务逻辑的软件开发框架。 那么LangChain是如何做到的呢?试想一下,现在底层有一个大模型的推理能力,除了在对话框手动输入跟他聊天之外。如何用计算机方式跟它互动呢?如果把一次LLM调用当作一个原子能力,如何编排这些原子能力来解决一些业务需求呢?Langchain就是来解决这个事情的。 LangChain的几个核心概念 ▐Model I/O 这里重点把背后的LLM模型做了一层封装,开发者可以通过更改配置的方式快速切换底层LLM模型,比如chatgpt,chatGLM、通义千问等模型。 同时还有些高阶功能:比如提供了缓存等功能,这样对于语义上类似的query,如果缓存有,那么langchain可以快速返回结果,而不需要调用大模型。 ▐Retriver 检索是为了解决大模型打通用户的本身数据,做一些面向业务属性的东西。这里的检索并非传统的关系型数据库,更多的是与大模型的本身逻辑相似的,比如向量数据库。 一个经典的结合LLM和外部用户的文档进行智能答疑的场景 文档->分词->embedding->向量数据库 query->向量数据库查询->TOP N->上下文+ 用户提问 + prompt -> LLM -> 返回结果 一个经典的图如下: 关键技术:文档如何拆分、embedding过程、 TOPN 向量距离的选择 embedding技术选型 embedding是将现实中的物体通过向量化的方法转化为高维向量,可被机器学习模型所识别。他是一种映射,同时也保证了能清晰地表达现实物体的特征。基于此,可以进行一些归类分析、回归分析等。 现在市面上常见的embedding方法有通义千问的embedding等方法。 向量数据库: 向量数据库底层存储的是一堆向量,它提供了根据向量相似度进行查询的能力,一般情况下,向量相似度代表了现实世界中物体的相似度。比如”我的名字是小明“ 和“我叫小明”这两句话所代表的含义几乎是相同的,那么在embedding之后,基于向量数据库进行查询的时候,它们俩的相似度就会很近。 ▐Chain 各种类型的chain,chain代表了各种业务类型的组合,类似于工作流的编排。 ▐Memory LLM本身提供了记忆的能力,同时提供了接口,开发者可以将历史的对话记录传入给LLM。LangChain需要使用外部存储保存这些历史的会话和记忆。可以使用数据库、缓存等进行保存。 ▐Agent 重点是代理工具 代理工具可以让应用程序基于大模型的推理能力,然后进行代理工具或代理服务的调用。因为LLM是没有“联网”的能力的,如果想解决特定的应用场景,代理工具是个完美的选择。 代理工具通常包含三个方面:用户输入、prompt编排LLM思考与路由代理的过程、背后的代理服务。其中难点可能就在于prompt设计了。通常的“套路”是这样的: ReAct 模型 输入:用户的问题 思考过程:如果是情况1(这个是需要LLM进行意图识别进行思考的),那么推理和提取出一些关键参数,调用agent1,如果是情况2,那么推理和提取出一些关键参数,调用agent2 Act:调用agent1对应一个JSON格式化的输入,调用function1,返回结果。 观察:观察调用后的结果,再结合推理的能力,再进行循环思考。 LangChain的在实际场景中的实践 集团内部开发了一个JAVA版本的LangChain框架,以下实践基于此框架与开源大模型chatGLM-6B进行。 ▐淘宝开放平台智能问答 淘宝开放平台对内托管了上万个API,每天在内部群里都会有开发者咨询API发布问题,之前我们是通过NLP来实现智能问答的,现将它升级为基于大模型的智能问答,以下是具体的技术实现过程。 知识库Embedding过程 由于之前已经沉淀好了很多知识库,都是Question-Answer的这种形式,这里我们对Question,也就是问题进行Embedding,此处采用通义千问提供的Embedding方法。 知识库embedding: TongYiEmbeddings embeddings = new TongYiEmbeddings();embeddings.setServerAccessId(ALINLP_EMBEDDINGS_ACCESSID);embeddings.setServerUrl(ALINLP_EMBEDDINGS_SERVER_URL);embeddings.setServerUuid(ALINLP_EMBEDDINGS_UUID);Document document = new Document();document.setPageContent(rawText);List<Document> documents = embeddings.embedDocument(Arrays.asList(document));Document vecDocument= documents.get(0);// 向量化知识String embeddingString = JSON.toJSONString(vecDocument.getEmbedding()).replaceAll("\\[", "{").replaceAll("\\]", "}");return embeddingString; 向量数据库存储和查询 此处采用hologres向量数据库,图中红框表示知识库问题与回答在数据库中具体的向量化存储数据。 向量距离数据库查询: select origin_content as originContent, origin_title as originTitle, pm_approx_squared_euclidean_distance(embedding_title, #{embeddingTitle}) as distancefrom vs_knowledgeorder by distance asclimit #{limit} 大模型问答链路 问答chain的基本实现: //1. 初始化ChatGLM的参数ChatGLMV2Internal chatGLMV2Internal = new ChatGLMV2Internal();chatGLMV2Internal.setTemperature(0.01d);chatGLMV2Internal.setMaxLength(2048);//2. 提示词编写PromptTemplate prompt = new PromptTemplate();String template = "已知信息:\n" +"{context} \n" +"\n" +"根据上述已知信息,简洁和专业的来回答用户的问题。如果无法从中得到答案,请说 “根据已知信息无法回答该问题” 或 “没有提供足够的相关信息”,不允许在答案中添加编造成分,答案请使用中文。问题是:{question}";prompt.setTemplate(template);//3. 向量数据库检索配置,比如最大向量距离RetrievalQA qa = new RetrievalQA();qa.setRecommend(5);qa.setMaxDistanceValue(10000.0d);qa.setLlm(chatGLMV2Internal);qa.setPrompt(prompt);qa.setRetriever(holoRetriver.asRetriever());qa.init();//4. LLM大模型问答Map<String, Object> inputs = new HashMap<>();inputs.put("question", question);inputs.put("input", question);Map<String, Object> outputs = qa.run(inputs);llmKonwledgeDO.setContent(String.valueOf(outputs.get("text")));// 补充 doclistreturn llmKonwledgeDO; ▐AI Agent实践 以下实现了一个网关API调用日志解析的agent。 Agent工具注册: this.setName("ApiLogTool");this.setDescription("这是一个调用日志查询接口,如果[{question}]中包含requestId关键字,你可以请求这个工具与日志系统进行交互,调用这个工具。\n" + "请先提取出requestId的值,将它赋值为value。调用参数:[{\"requestId\": \"value\", \"type\": \"String\", \"description\": \"调用请求id\"}]。"); 工具解析: Map<String,Object> parse = (Map<String,Object>)JSON.parse(toolInput);if(parse.get("requestId")==null){ return new ToolExecuteResult("");}String requestId = parse.get("requestId").toString();ApiLogSearchQuery apiLogSearchQuery = new ApiLogSearchQuery();//日志查询解析处理 思考决策逻辑: public static final String FORMAT_INSTRUCTIONS_CH ="用户提出了一个问题: {question} \n" +"你可以选择使用下面这些工具:\n"+"{tool_list_description}"+"\n"+"同时你的思考过程如下:"+"Thought: 每一次你需要首先思考你应该做什么\n" +"Action: 你需要决定是否使用工具,应该是[{tool_names}] 中的一个Action,格式为JSON。如果匹配不到工具,就不要思考了,直接返回结果,请不要把思考过程返回给用户。\n" +"Input: 如果匹配到工具,使用的工具的输入参数,赋值给params\n" +"Observation: 如果匹配到工具,工具的输出结果 格式为[]。\n" +"Answer: 每一步回答问题的答案,格式为JSON。你可以多次使用Thought/Action/Input/Observation/Answer来一步一步的思考如何回答问题。\n"; 个人小思考 未来微服务HSF这种形式会向上往 agent工厂或者agent服务框架这种形式演进,因为这个框架搭好了后,后面各个业务方快速集成到agent服务上,可被上层AI应用层调用 如果多个agent联动了,才是真正的智能 如何定义agent? Agent体系架构可以分为慎思型、反应型和混合型。 慎思型构建负责规划和推理行为,反应型构建处理需要快速响应的重要事件。 信念-期望-意图(Belief-Desire-ltension, BDI) 体系架构是混合型体系架构的一个重要类型。 Agent的表示形式,Agent的行为可以被描述成好像拥有信念、期望和意图等思维状态。信念表示Agent拥有的知识,期望描述Agent追求的目标,意图说明Agent选择计划以实现哪些目标。 openai提供的agent概念 团队介绍 我们是淘天集团商家与开放平台团队,目前主要围绕商家的日常经营场景,为中小商家提供高效易用的电商工具。 ¤ 拓展阅读 ¤ 3DXR技术| 终端技术| 音视频技术 服务端技术|技术质量|数据算法 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

shell总结笔记——关于变量

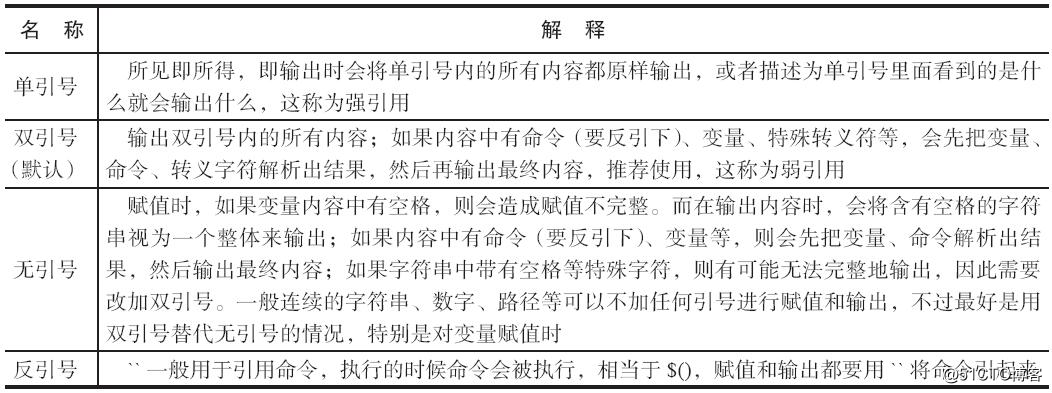
BASH:主要的优点: 命令编修能力; 命令与文件补全功能; 命令别名设置功能; 工作控制、前景背景控制; 程序化脚本; 万用字符; 1、什么是变量? 1、 让某一个特定的字符串代表不固定的内容。2、 变量就是让一组文字或符号等来取代一些设置,或者是一串保留的数据。3、变量的格式:变量名=变量内容(变量名一般设置为大写字母,专业一些)。 设置变量的规则:1、 变量与变量内容以一个等号“=”来链接;2、 等号两边不能直接接空白字符;3、 变量名称只能是英文字母与数字,但是开头字符不能是数字;4、 变量内容若有空白字符可以使用双引号,或单引号讲变量内容结合起来。双引号内的特殊字符如$等,可以保有原本的特性;单引号内的特殊字符则仅作为一般字符(纯文本)。5、 可用转义符“\”将特殊符号变成一般字符;6、 在一串指令的执行中,还需要借由其他额外的指令所提供的信息时,可以使用反撇号,而不是单引号。7、 若该变量需要在其他子程序执行,则需要一export来使自定义变量变成环境变量。8、 通常大写字符为系统默认变量,自行设置变量可以使用小写字符,方便判断;9、 取消变量的方法为使用unset: “unset 变量名称”例如取消myname的设置:unset myname。 有关shell变量定义、赋值及变量输出加单引号、双引号、反引号与不加引号的简要说明,如下表所示: 建议: 在脚本中定义普通字符串变量时,应尽量把变量的内容用双引号括起来;单纯数字的变量内容可以不加引号;希望变量的内容原样输出时需要加单引号;希望变量值引用命令并获取命令的结果时就用反单引号或$( )。env命令——查询环境变量。random命令:随机产生的数字是在0——32768之间。 set命令:查询的是所有的变量,包括环境变量和自定义变量。 $:代表的是当前shell的PID号,如echo $$; ?:代表的是上一个指令的回传值,如echo $? 自定义变量与环境变量最大的区别是:该变量是否会被子程序(子shell)继续使用。 各种变量定义的作用域: 环境变量=全域变量 自定义变量=区域变量 关于系统中的环境变量解释: PS1——系统特定变量名 其中PS1这个变量需要解释下,其他可以自行看懂,PS1可用的选项如下: \d :可显示出“星期月日”的日期格式,如:"Mon Feb 2" \H :完整的主机名称。举例来说,我的练习机为“study.centos.vbird” \h :仅取主机名称在第一个小数点之前的名字,如我主机则为“study”后面省略 \t :显示时间,为 24 小时格式的“HH:MM:SS” \T :显示时间,为 12 小时格式的“HH:MM:SS” \A :显示时间,为 24 小时格式的“HH:MM” \@ :显示时间,为 12 小时格式的“am/pm”样式 \u :目前使用者的帐号名称,如“dmtsai”; \v :BASH 的版本信息,如我的测试主机版本为 4.2.46(1)-release,仅取“4.2”显示 \w :完整的工作目录名称,由根目录写起的目录名称。但主文件夹会以 ~ 取代; \W :利用 basename 函数取得工作目录名称,所以仅会列出最后一个目录名。 #:下达的第几个指令。 \$ :提示字符,如果是 root 时,提示字符为 # ,否则就是 $ 用法示例: [root@localhost ~]# PS1='[\u@\h\w\A#\#]\$' #添加上面的一些选项 [root@localhost~13:07#5]#cd /etc #多执行两下命令 [root@localhost/etc13:07#6]#cd /boot [root@localhost/boot13:07#7]#exit #可以发现,执行PS1这个变量并结合一些选项的使用,可以暂时改变命令提示符的变化, #并且后面的数字会每执行一次,就增加一个数,这是\#的作用 设置变量的方式1 [root@localhost ~]# path=$PATH #先自定义一个变量,引用“PATH”的值,用“path”变量做测试 [root@localhost ~]# echo $path #输出进行确认下 /usr/local/sbin:/usr/local/bin:/usr/sbin:/usr/bin:/root/bin [root@localhost ~]# echo ${path#/*local/sbin:} #试着删除一个 /usr/local/bin:/usr/sbin:/usr/bin:/root/bin #在上面的命令中,“$”是关键字,用在这种删除模式所必须存在的; #“path”就是原本的变量名称; #“#”代表从变量内容的最前面开始向右删除,且只删除最短的那个; #“/*local/sbin:”代表要被删除的部分,由于“#”代表从前面开始删除, #所以这里就从“/”写起,并且可以使用“*”这个万用字符,可以代表任意内容。 #但这条命令并没有改变“path”变量的内容,可以将“echo”换为“path=”即可直接改变变量内容。 #如下: [root@localhost ~]# path=${path#/*local/sbin:} [root@localhost ~]# echo $path /usr/local/bin:/usr/sbin:/usr/bin:/root/bin #这就将原本的变量值更改成功了。 关于其他的更改方式,参考上面的表格即可咯! (2) 示例1——测试一下是否存在username这个变量,若不存在则赋值username为root。 [root@localhost ~]# echo $username #查看username变量是否存在 [root@localhost ~]# username=${username-root} #如果变量内容不存在就赋值为root [root@localhost ~]# echo $username #变量不存在,所以将它赋值了root root [root@localhost ~]# username='lv jian zhao' #那么现在给它赋值 [root@localhost ~]# username=${username-root} #再次使用这个,表示如果值不存在,则将它赋值为root [root@localhost ~]# echo $username #再次输出,会发现还是我们手工赋的值,并没有给它赋值为root lv jian zhao #从上面可以看出“-”号的作用,就是如果值不存在,就给它赋值“-”号后面的值,若存在,则放弃。 示例2——若username未设置或为空字串,则将username内容设置为root [root@localhost ~]# username="" #将username设置为空字串 [root@localhost ~]# username=${username-root} #若值不存在,则赋值为root [root@localhost ~]# echo $username #输出该变量,会发现还是空的,因为username的值是存在的,只不过是空字串而已,所以并没有赋值为root [root@localhost ~]# username=${username:-root} #使用“:-”试试 [root@localhost ~]# echo $username #会发现已经赋值为root了 root #说明:“:-”的作用就是如果值为空或是未设置,都能被后面的内容替换。 设置变量的方式2 环境变量一般是指用export内置命令导出的变量,用于定义Shell的运行环境,保证Shell命令的正确执行。Shell通过环境变量来确定登录用户名、命令路径、终端类型、登录目录等,所有的环境变量都是系统全局变量,可用于所有子进程中,这包括编辑器、Shell脚本和各类应用。环境变量可以在命令行中设置和创建,但用户退出命令行时这些变量值就会丢失,因此,如果希望永久保存环境变量,可在用户家目录下的.bash_profile或.bashrc(非用户登录模式特有,例如远程文件中,或者全局配置/etc/bashrc(非用户登录模式特有,例如远程SSH)或/etc/profile文件中定义。在将环境变量放入上述的文件中后,每次用户登录时这些变量都将被初始化。按照系统规范,所有环境变量的名字均采用大写形式。在将环境变量应用于用户进程程序之前,都应该用export命令导出定义,例如:正确的环境变量定义方法为export OLDGIRL=1。有一些环境变量,比如HOME、PATH、SHELL、UID、USER等,在用户登录之前就已经被/bin/login程序设置好了。通常环境变量被定义并保存在用户家目录下的.bash_profile文件或全局的配置文件/etc/profile中,具体的环境变量说明请参考下表:在查看设置的变量时,有3个命令可以显示变量的值:set、env和declare(替代早期的typeset)。set命令输出所有的变量,包括全局变量和局部变量;env命令只显示全局变量;declare命令输出所有的变量、函数、整数和已经导出的变量。set-o命令显示bash Shell的所有参数配置信息。查看举例: [root@localhost ~]# env | tail #使用env命令进行查看全局变量 [root@localhost ~]# set -o #使用set -o查看bash shell的所有参数配置信息 设置环境变量的方式 如果想要设置环境变量,就要在给变量赋值之后或在设置变量时使用export命令,具体设置见下文的示例。其实,除了export命令,带-x选项的declare内置命令也可以完成同样的功能(注意:此处不要在变量名前面加$):export命令和declare命令的格式如下: ①export 变量名=value②变量名=value ; export 变量名③declare -x 变量名=value #以上就是三种设置环境变量的三种方法 上面设置的全局变量只是临时设置的,重启系统后,就失效了,那么可以将变量写入以下几个文件其中之一即可,使其永久生效: 1、只对用户的环境变量配置 [lv@localhost ~]$ ls ~/.bashrc ~/.bash_profile #对于用户的环境变量设置,比较常见的是用户家目录下的这两个目录,推荐写入第一个文件“.bashrc” 2、全局环境变量的配置常见的全局环境变量的配置文件如下: /etc/profile /etc/bashrc #推荐在此文件中优先设置 /etc/profile.d/ 环境变量总结 环境变量的定义: 变量名通常要大写; 变量可以在自身的shell及子shell中使用; 常用export来定义环境变量; 数字内容的变量定义可以不加引号,其他没有特殊要求的字符串等定义最好都加上双引号;如果真的需要原样输出就加单引号;定义变量加双引号是最常见的使用场景; 如果需要获取命令结果赋值给变量,则可以使用反撇号``(tab键上面的那个按键)或者括号“()”将命令字括起来; 执行env默认可以显示所有的环境变量名称及对应的值; 输出时用“echo $变量名”,取消时用“unset 变量名”; 书写crond定时任务时要注意,脚本要用到环境变量最好现在所执行的shell脚本中重新定义; 如果希望环境变量永久生效,则可以将其放在用户环境变量文件或全局环境变量文件里; 环境变量初始化与对应文件的生效顺序:在登录Linux系统并启动一个bash shell时,默认情况下bash会在若干个文件中查找环境变量的设置这些文件,这些文件可统称为系统环境文件。bash检查的环境变量文件的情况取决于系统运行shell的方式。系统运行shell的方式一般有3种:①通过系统用户登录后默认运行的shell;②非登录交互式运行shell;③执行脚本运行非交互式shell。 用户登录系统后首先会加载/etc/profile全局环境变量文件,这是Linux系统上默认的shell主环境变量文件,系统上每个用户登录都会加载这个文件。 当加载完/etc/profile文件后,才会执行/etc/profile.d目录下的脚本文件,这个目录下的脚本文件有很多,例如:系统的字符集设置(/etc/sysconfig/il8n)等。 之后开始运行$HOME/.bash_profile(用户环境变量文件),在这个文件中,又会去找$HOME/.bashrc(用户环境变量文件),如果有,则执行,如果没有,则不执行。在$HOME/.bashrc文件中又会去找/etc/bashrc(全局环境变量文件),如果有,则执行,如果没有,则不执行。 如果用户的shell不是登录时启动的(比如手动敲下bash时或者其他不需要输入密码的登录及远程连接情况),那么这种非登录shell只会加载$HOME/.bashrc,并会去找/etc/bashrc文件。因此如果希望在非登录shell下也可以督导设置的环境变量等内容,就需要将变量设定等写入$HOME/.bashrc或者/etc/bashrc,而不是$HOME/.bash_profile或/etc/profile。 ———————— 本文至此结束,感谢阅读 ————————

优秀的个人博客,低调大师

三万字,Spark学习笔记

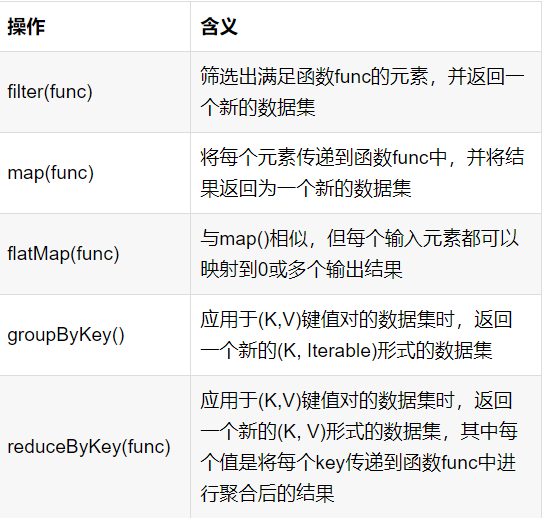
Spark 基础 Spark特性 Spark使用简练优雅的Scala语言编写,基于Scala提供了交互式编程体验,同时提供多种方便易用的API。Spark遵循“一个软件栈满足不同应用场景”的设计理念,逐渐形成了一套完整的生态系统(包括 Spark提供内存计算框架、SQL即席查询(Spark SQL)、流式计算(Spark Streaming)、机器学习(MLlib)、图计算(Graph X)等),Spark可以部署在yarn资源管理器上,提供一站式大数据解决方案,可以同时支持批处理、流处理、交互式查询。 MapReduce计算模型延迟高,无法胜任实时、快速计算的需求,因而只适用于离线场景,Spark借鉴MapReduce计算模式,但与之相比有以下几个优势(快、易用、全面): Spark提供更多种数据集操作类型,编程模型比MapReduce更加灵活; Spark提供内存计算,将计算结果直接放在内存中,减少了迭代计算的IO开销,有更高效的运算效率。 Spark基于DAG的任务调度执行机制,迭代效率更高;在实际开发中MapReduce需要编写很多底层代码,不够高效,Spark提供了多种高层次、简洁的API实现相同功能的应用程序,实现代码量比MapReduce少很多。 Spark作为计算框架只是取代了Hadoop生态系统中的MapReduce计算框架,它任需要HDFS来实现数据的分布式存储,Hadoop中的其他组件依然在企业大数据系统中发挥着重要作用。 Spark的不足:虽然Spark很快,但现在在生产环境中仍然不尽人意,无论扩展性、稳定性、管理性等方面都需要进一步增强;同时Spark在流处理领域能力有限,如果要实现亚秒级或大容量的数据获取或处理需要其他流处理产品。 Cloudera旨在让Spark流数据技术适用于80%的使用场合,就考虑到这一缺陷,在实时分析(而非简单数据过滤或分发)场景中,很多以前使用S4或Storm等流式处理引擎的实现已经逐渐被Kafka+Spark Streaming代替; Hadoop现在分三块HDFS/MR/YARN,Spark的流行将逐渐让MapReduce、Tez走进博物馆;Spark只是作为一个计算引擎比MR的性能要好,但它的存储和调度框架还是依赖于HDFS/YARN,Spark也有自己的调度框架,但不成熟,基本不可商用。 Spark部署(on Yarn) YARN实现了一个集群多个框架”,即在一个集群上部署一个统一的资源调度管理框架,并部署其他各种计算框架,YARN为这些计算框架提供统一的资源调度管理服务,并且能够根据各种计算框架的负载需求调整各自占用的资源,实现集群资源共享和资源弹性收缩; 并且,YARN实现集群上的不同应用负载混搭,有效提高了集群的利用率;不同计算框架可以共享底层存储,避免了数据集跨集群移动 ; 这里使用Spark on Yarn 模式部署,配置on yarn模式只需要修改很少配置,也不用使用启动spark集群命令,需要提交任务时候须指定在yarn上。 Spark运行需要Scala语言,须下载Scala和Spark并解压到家目录,设置当前用户的环境变量(~/.bash_profile),增加SCALA_HOME和SPARK_HOME路径并立即生效;启动scala命令和spark-shell命令验证是否成功;Spark的配置文件修改按照官网教程不好理解,这里完成的配置参照博客及调试。 Spark的需要修改两个配置文件:spark-env.sh和spark-default.conf,前者需要指明Hadoop的hdfs和yarn的配置文件路径及Spark.master.host地址,后者需要指明jar包地址; spark-env.sh配置文件修改如下: exportJAVA_HOME=/home/stream/jdk1.8.0_144exportSCALA_HOME=/home/stream/scala-2.11.12exportHADOOP_HOME=/home/stream/hadoop-3.0.3exportHADOOP_CONF_DIR=/home/stream/hadoop-3.0.3/etc/hadoopexportYARN_CONF_DIR=/home/stream/hadoop-3.0.3/etc/hadoopexportSPARK_MASTER_HOST=xxexportSPARK_LOCAL_IP=xxxspark-default.conf配置修改如下://增加jar包地址spark.yarn.jars=hdfs://1xxx/spark_jars/* 该设置表明将jar地址定义在hdfs上,必须将~/spark/jars路径下所有的jar包都上传到hdfs的/spark_jars/路径(hadoop hdfs –put ~/spark/jars/*),否则会报错无法找到编译jar包错误; Spark启动和验证 直接无参数启动./spark-shell ,运行的是本地模式: 启动./spark-shell –master yarn,运行的是on yarn模式,前提是yarn配置成功并可用: 在hdfs文件系统中创建文件README.md,并读入RDD中,使用RDD自带的参数转换,RDD默认每行为一个值: 使用./spark-shell --master yarn启动spark 后运行命令:val textFile=sc.textFile(“README.md”)读取hdfs上的README.md文件到RDD,并使用内置函数测试如下,说明spark on yarn配置成功. 常见问题 在启动spark-shell时候,报错Yarn-site.xml中配置的最大分配内存不足,调大这个值为2048M,需重启yarn后生效。 设置的hdfs地址冲突,hdfs的配置文件中hdfs-site.xml设置没有带端口,但是spark-default.conf中的spark.yarn.jars值带有端口,修改spark-default.conf的配置地址同前者一致: Spark基本原理 在实际应用中,大数据处理主要包括以下三个类型:复杂的批量数据处理:通常时间跨度在数十分钟到数小时之间;基于历史数据的交互式查询:通常时间跨度在数十秒到数分钟之间;基于实时数据流的数据处理:通常时间跨度在数百毫秒到数秒之间; 同时存在以上场景需要同时部署多个组件,如:MapReduce/Impala/Storm,这样做难免会带来一些问题:不同场景之间输入输出数据无法做到无缝共享,通常需要进行数据格式的转换,不同的软件需要不同的开发和维护团队,带来了较高的使用成本,比较难以对同一个集群中的各个系统进行统一的资源协调和分配; Spark的设计遵循“一个软件栈满足不同应用场景”的理念,逐渐形成了一套完整的生态系统,其生态系统包含了Spark Core、Spark SQL、Spark Streaming( Structured Streaming)、MLLib和GraphX 等组件,既能够提供内存计算框架,也可以支持SQL即席查询、实时流式计算、机器学习和图计算等。 而且Spark可以部署在资源管理器YARN之上,提供一站式的大数据解决方案;因此,Spark所提供的生态系统足以应对上述三种场景,即批处理、交互式查询和流数据处理。 Spark概念/架构设计 RDD:是Resilient Distributed Dataset(弹性分布式数据集)的简称,是分布式内存的一个抽象概念,提供了一种高度受限的共享内存模型 ; DAG:是Directed Acyclic Graph(有向无环图)的简称,反映RDD之间的依赖关系 ; Executor:是运行在工作节点(WorkerNode)的一个进程,负责运行Task ; 应用(Application):用户编写的Spark应用程序; 任务( Task ):运行在Executor上的工作单元 ; 作业( Job ):一个作业包含多个RDD及作用于相应RDD上的各种操作; 阶段( Stage ):是作业的基本调度单位,一个作业会分为多组任务,每组任务被称为阶段,或者也被称为任务集合,代表了一组关联的、相互之间没有Shuffle依赖关系的任务组成的任务集; Spark运行架构包括集群资源管理器(Cluster Manager)、运行作业任务的工作节点(Worker Node)、每个应用的任务控制节点(Driver)和每个工作节点上负责具体任务的执行进程(Executor),资源管理器可以自带或使用Mesos/YARN; 一个应用由一个Driver和若干个作业构成,一个作业由多个阶段构成,一个阶段由多个没有Shuffle关系的任务组成; 当执行一个应用时,Driver会向集群管理器申请资源,启动Executor,并向Executor发送应用程序代码和文件,然后在Executor上执行任务,运行结束后,执行结果会返回给Driver,或者写到HDFS或者其他数据库中。 Spark运行流程 SparkContext对象代表了和一个集群的连接: (1)首先为应用构建起基本的运行环境,即由Driver创建一个SparkContext,进行资源的申请、任务的分配和监控; (2)资源管理器为Executor分配资源,并启动Executor进程; (3)SparkContext根据RDD的依赖关系构建DAG图,DAG图提交给DAGScheduler解析成Stage,然后把一个个TaskSet提交给底层调度器TaskScheduler处理;Executor向SparkContext申请Task,Task Scheduler将Task发放给Executor运行,并提供应用程序代码; (4)Task在Executor上运行,把执行结果反馈给TaskScheduler,然后反馈给DAGScheduler,运行完毕后写入数据并释放所有资源; Spark RDD RDD概念/特性 许多迭代式算法(比如机器学习、图算法等)和交互式数据挖掘工具,共同之处是不同计算阶段之间会重用中间结果, MapReduce框架把中间结果写入到稳定存储(如磁盘)中,带来大量的数据复制、磁盘IO和序列化开销。 RDD就是为了满足这种需求而出现的,它提供了一个抽象的数据架构,开发者不必担心底层数据的分布式特性,只需将具体的应用逻辑表达为一系列转换处理,不同RDD之间的转换操作形成依赖关系,可以实现管道化,避免中间数据存储。一个RDD就是一个分布式对象集合,本质上是一个只读的分区记录集合,每个RDD可分成多个分区,每个分区就是一个数据集片段,并且一个RDD的不同分区可以被保存到集群中不同的节点上,从而可以在集群中的不同节点上进行并行计算。 RDD提供了一种高度受限的共享内存模型,即RDD是只读的记录分区的集合,不能直接修改,只能基于稳定的物理存储中的数据集创建RDD,或者通过在其他RDD上执行确定的转换操作(如map、join和group by)而创建得到新的RDD。 RDD提供了丰富的操作以支持常见数据运算,分“转换”(Transformation)和“动作”(Action)两种类型;RDD提供的转换接口都非常简单,都是类似map、filter、groupBy、join等粗粒度的数据转换操作,而不是针对某个数据项的细粒度修改(不适合网页爬虫),表面上RDD的功能很受限、不够强大,实际上RDD已经被实践证明可以高效地表达许多框架的编程模型(比如MapReduce、SQL、Pregel);Spark用Scala语言实现了RDD的API,程序员可以通过调用API实现对RDD的各种操作 RDD典型的执行过程如下,这一系列处理称为一个Lineage(血缘关系),即DAG拓扑排序的结果: RDD读入外部数据源进行创建; RDD经过一系列的转换(Transformation)操作,每一次都会产生不同的RDD,供给下一个转换操作使用; 最后一个RDD经过“动作”操作进行转换,并输出到外部数据源 优点:惰性调用、管道化、避免同步等待、不需要保存中间结果、操作简单; Spark采用RDD以后能够实现高效计算的原因主要在于: (1)高容错性:血缘关系、重新计算丢失分区、无需回滚系统、重算过程在不同节点之间并行、只记录粗粒度的操作; (2)中间结果持久化到内存:数据在内存中的多个RDD操作之间进行传递,避免了不必要的读写磁盘开销; (3)存放的数据是Java对象:避免了不必要的对象序列化和反序列化; RDD依赖关系 Spark通过分析各个RDD的依赖关系生成了DAG,并根据RDD 依赖关系把一个作业分成多个阶段,阶段划分的依据是窄依赖和宽依赖,窄依赖可以实现流水线优化,宽依赖包含Shuffle过程,无法实现流水线方式处理。 窄依赖表现为一个父RDD的分区对应于一个子RDD的分区或多个父RDD的分区对应于一个子RDD的分区;宽依赖则表现为存在一个父RDD的一个分区对应一个子RDD的多个分区。 逻辑上每个RDD 操作都是一个fork/join(一种用于并行执行任务的框架),把计算fork 到每个RDD 分区,完成计算后对各个分区得到的结果进行join 操作,然后fork/join下一个RDD 操作; RDD Stage划分:Spark通过分析各个RDD的依赖关系生成了DAG,再通过分析各个RDD中的分区之间的依赖关系来决定如何划分Stage,具体方法: 在DAG中进行反向解析,遇到宽依赖就断开; 遇到窄依赖就把当前的RDD加入到Stage中; 将窄依赖尽量划分在同一个Stage中,可以实现流水线计算; RDD运行过程 通过上述对RDD概念、依赖关系和Stage划分的介绍,结合之前介绍的Spark运行基本流程,总结一下RDD在Spark架构中的运行过程: (1)创建RDD对象; (2)SparkContext负责计算RDD之间的依赖关系,构建DAG; (3)DAG Scheduler负责把DAG图分解成多个Stage,每个Stage中包含了多个Task,每个Task会被TaskScheduler分发给各个WorkerNode上的Executor去执行; RDD创建 RDD的创建可以从从文件系统中加载数据创建得到,或者通过并行集合(数组)创建RDD。Spark采用textFile()方法来从文件系统中加载数据创建RDD,该方法把文件的URI作为参数,这个URI可以是本地文件系统的地址,或者是分布式文件系统HDFS的地址; 从文件系统中加载数据: scala>vallines=sc.textFile("file:///usr/local/spark/mycode/rdd/word.txt") 从HDFS中加载数据: scala>vallines=sc.textFile("hdfs://localhost:9000/user/hadoop/word.txt") 可以调用SparkContext的parallelize方法,在Driver中一个已经存在的集合(数组)上创建。 scala>valarray=Array(1,2,3,4,5)scala>valrdd=sc.parallelize(array) 或者从列表中创建: scala>vallist=List(1,2,3,4,5)scala>valrdd=sc.parallelize(list) RDD操作 对于RDD而言,每一次转换操作都会产生不同的RDD,供给下一个“转换”使用,转换得到的RDD是惰性求值的,也就是说,整个转换过程只是记录了转换的轨迹,并不会发生真正的计算,只有遇到行动操作时,才会发生真正的计算,开始从血缘关系源头开始,进行物理的转换操作; 常用的RDD转换操作,总结如下: filter(func)操作:筛选出满足函数func的元素,并返回一个新的数据集 scala>vallines=sc.textFile(file:///usr/local/spark/mycode/rdd/word.txt)scala>vallinesWithSpark=lines.filter(line=>line.contains("Spark")) map(func)操作:map(func)操作将每个元素传递到函数func中,并将结果返回为一个新的数据集 scala>data=Array(1,2,3,4,5)scala>valrdd1=sc.parallelize(data)scala>valrdd2=rdd1.map(x=>x+10) 另一个实例: scala>vallines=sc.textFile("file:///usr/local/spark/mycode/rdd/word.txt")scala>valwords=lines.map(line=>line.split("")) flatMap(func)操作:拍扁操作 scala>vallines=sc.textFile("file:///usr/local/spark/mycode/rdd/word.txt")scala>valwords=lines.flatMap(line=>line.split("")) groupByKey()操作:应用于(K,V)键值对的数据集时,返回一个新的(K, Iterable)形式的数据集; reduceByKey(func)操作:应用于(K,V)键值对的数据集返回新(K, V)形式数据集,其中每个值是将每个key传递到函数func中进行聚合后得到的结果: 行动操作是真正触发计算的地方。Spark程序执行到行动操作时,才会执行真正的计算,这就是惰性机制,“惰性机制”是指,整个转换过程只是记录了转换的轨迹,并不会发生真正的计算,只有遇到行动操作时,才会触发“从头到尾”的真正的计算,常用的行动操作: RDD持久 Spark RDD采用惰性求值的机制,但是每次遇到行动操作都会从头开始执行计算,每次调用行动操作都会触发一次从头开始的计算,这对于迭代计算而言代价是很大的,迭代计算经常需要多次重复使用同一组数据: scala>vallist=List("Hadoop","Spark","Hive")scala>valrdd=sc.parallelize(list)scala>println(rdd.count())//行动操作,触发一次真正从头到尾的计算scala>println(rdd.collect().mkString(","))//行动操作,触发一次真正从头到尾的计算 可以通过持久化(缓存)机制避免这种重复计算的开销,可以使用persist()方法对一个RDD标记为持久化,之所以说“标记为持久化”,是因为出现persist()语句的地方,并不会马上计算生成RDD并把它持久化,而是要等到遇到第一个行动操作触发真正计算以后,才会把计算结果进行持久化,持久化后的RDD将会被保留在计算节点的内存中被后面的行动操作重复使用; persist()的圆括号中包含的是持久化级别参数,persist(MEMORY_ONLY)表示将RDD作为反序列化的对象存储于JVM中,如果内存不足,就要按照LRU原则替换缓存中的内容;persist(MEMORY_AND_DISK)表示将RDD作为反序列化的对象存储在JVM中,如果内存不足,超出的分区将会被存放在硬盘上;一般而言,使用cache()方法时,会调用persist(MEMORY_ONLY),同时可以使用unpersist()方法手动地把持久化的RDD从缓存中移除。 针对上面的实例,增加持久化语句以后的执行过程如下: scala>vallist=List("Hadoop","Spark","Hive")scala>valrdd=sc.parallelize(list)scala>rdd.cache()//会调用persist(MEMORY_ONLY),但是,语句执行到这里,并不会缓存rdd,因为这时rdd还没有被计算生成scala>println(rdd.count())//第一次行动操作,触发一次真正从头到尾的计算,这时上面的rdd.cache()才会被执行,把这个rdd放到缓存中scala>println(rdd.collect().mkString(","))//第二次行动操作,不需要触发从头到尾的计算,只需要重复使用上面缓存中的rdd RDD分区 RDD是弹性分布式数据集,通常RDD很大,会被分成很多个分区分别保存在不同的节点上,分区的作用:(1)增加并行度(2)减少通信开销。RDD分区原则是使得分区的个数尽量等于集群中的CPU核心(core)数目,对于不同的Spark部署模式而言(本地模式、Standalone模式、YARN模式、Mesos模式),都可以通过设置spark.default.parallelism这个参数的值,来配置默认的分区数目,一般而言: 本地模式:默认为本地机器的CPU数目,若设置了local[N],则默认为N; Standalone或YARN:在“集群中所有CPU核心数目总和”和2二者中取较大值作为默认值; 设置分区的个数有两种方法:创建RDD时手动指定分区个数,使用reparititon方法重新设置分区个数; 创建RDD时手动指定分区个数:在调用textFile()和parallelize()方法的时候手动指定分区个数即可,语法格式如 sc.textFile(path, partitionNum),其中path参数用于指定要加载的文件的地址,partitionNum参数用于指定分区个数。 scala>valarray=Array(1,2,3,4,5)scala>valrdd=sc.parallelize(array,2)//设置两个分区 reparititon方法重新设置分区个数:通过转换操作得到新 RDD 时,直接调用 repartition 方法即可,如: scala>valdata=sc.textFile("file:///usr/local/spark/mycode/rdd/word.txt",2)scala>data.partitions.size//显示data这个RDD的分区数量scala>valrdd=data.repartition(1)//对data这个RDD进行重新分区scala>rdd.partitions.sizeres4:Int=1 Spark-shell批处理 完成Spark部署后,使用spark-shell指令进入Scala交互编程界面,spark-shell默认创建一个sparkContext(sc),在spark-shell启动时候可以查看运行模式是on yarn还是local模式,使用交互式界面可以直接引用sc变量使用; 使用Spark-shell处理数据实例:读取HDFS文件系统中文件实现WordCount 单词计数: sc.textFile("hdfs://172.22.241.183:8020/user/spark/yzg_test.txt").flatMap(_.split("")).map((_,1)).reduceByKey(_+_).collect() 其中,map((_,1)) 等同于map(x => (x, 1)) 使用saveAsText File()函数可以将结果保存到文件系统中。 Scala及函数式编程 Spark采用Scala语言编写,在开发中需要熟悉函数式编程思想,并熟练使用Scala语言,使用Scala进行Spark开发的代码量大大少于Java开发的代码量; 函数式编程特性 函数式编程属于声明式编程的一种,将计算描述为数学函数的求值,但函数式编程没有准确的定义,只是一系列理念,并不需要严格准守,可以理解为函数式编程把程序看做是数学函数,输入的是自变量,输出因变量,通过表达式完成计算,当前越来越多的命令式语言支持部分的函数式编程特性。 在函数式编程中,函数作为一等公民,就是说函数的行为和普通变量没有区别,可以作为函参进行传递,也可以在函数内部声明一个函数,那么外层的函数就被称作高阶函数。 函数式编程的curry化:把接受多个参数的函数变换成接受一个单一参数的函数,返回接受余下的参数并且返回结果的新函数。 函数式编程要求所有的变量都是常量(这里所用的变量这个词并不准确,只是为了便于理解),erlang是其中的典型语言,虽然许多语言支持部分函数式编程的特性,但是并不要求变量必须是常量。这样的特性提高了编程的复杂度,但是使代码没有副作用,并且带来了很大的一个好处,那就是大大简化了并发编程。 Java中最常用的并发模式是共享内存模型,依赖于线程与锁,若代码编写不当,会发生死锁和竞争条件,并且随着线程数的增加,会占用大量的系统资源。在函数式编程中,因为都是常量,所以根本就不用考虑死锁等情况。为什么说一次赋值提高了编程的复杂度,既然所有变量都是常量,那么我们没办法更改一个变量的值,循环的意义也就不大,所以haskell与erlang中使用递归代替了循环。 Scala语法 Scala即可伸缩的语言(Scalable Language),是一种多范式的编程语言,类似于java的编程,设计初衷是要集成面向对象编程和函数式编程的各种特性。 Scala函数地位:一等公民 在Scala中函数是一等公民,像变量一样既可以作为函参使用,也可以将函数赋值给一个变量;而且函数的创建不用依赖于类、或对象,在Java中函数的创建则要依赖于类、抽象类或者接口。Scala函数有两种定义: Scala的函数定义规范化写法,最后一行代码是它的返回值: 精简后函数定义可以只有一行:也可以直接使用val将函数定义成变量,表示定义函数addInt,输入参数有两个,分别为x,y,均为Int类型,返回值为两者的和,类型Int: Scala匿名函数(函数字面量) Scala中的匿名函数也叫做函数字面量,既可以作为函数的参数使用,也可以将其赋值给一个变量,在匿名函数的定义中“=>”可理解为一个转换器,它使用右侧的算法,将左侧的输入数据转换为新的输出数据,使用匿名函数后,我们的代码变得更简洁了。 valtest=(x:Int)=>x+1 Scala高阶函数 Scala使用术语“高阶函数”来表示那些把函数作为参数或函数作为返回结果的方法和函数。比如常见的有map,filter,reduce等函数,它们可以接受一个函数作为参数。 Scala闭包 Scala中的闭包指的是当函数的变量超出它的有效作用域的时候,还能对函数内部的变量进行访问;Scala中的闭包捕获到的是变量的本身而不仅仅是变量的数值,当自由变量发生变化时,Scala中的闭包能够捕获到这个变化;如果自由变量在闭包内部发生变化,也会反映到函数外面定义的自由变量的数值。 Scala部分应用函数 部分应用函数只是在“已有函数”的基础上,提供部分默认参数,未提供默认参数的地方使用下划线替代,从而创建出一个“函数值”,在使用这个函数值(部分应用函数)的时候,只需提供下划线部分对应的参数即可;部分应用函数本质上是一种值类型的表达式,在使用的时候不需要提供所有的参数,只需要提供部分参数。 Scala柯里化函数 scala中的柯里化指的是将原来接受两个参数的函数变成新的接受一个参数的函数的过程,新的函数返回一个以原有第二个参数作为参数的函数; defsomeAction(f:(Double)=>Double)=f(10) 只要满足:函数参数是一个double、返回值也是一个double,这个函数就可以作为f值; Spark SQL Shark和Spark SQL Shark的出现,使得SQL-on-Hadoop的性能比Hive有了10-100倍的提高,但Shark的设计导致了两个问题: 一是执行计划优化完全依赖于Hive,不方便添加新的优化策略 二是因为Spark是线程级并行,而MapReduce是进程级并行,因此,Spark在兼容Hive的实现上存在线程安全问题,导致Shark不得不使用另外一套独立维护的打了补丁的Hive源码分支 ; Spark SQL在Hive兼容层面仅依赖HiveQL解析、Hive元数据,也就是说,从HQL被解析成抽象语法树(AST)起,就全部由Spark SQL接管了。Spark SQL执行计划生成和优化都由Catalyst(函数式关系查询优化框架)负责 ; DataFrame和RDD Spark SQL增加了DataFrame(即带有Schema信息的RDD),使用户可以在Spark SQL中执行SQL语句,数据既可以来自RDD,也可以是Hive、HDFS、Cassandra等外部数据源,还可以是JSON格式的数据,Spark SQL目前支持Scala、Java、Python三种语言,支持SQL-92规范 ; DataFrame的推出,让Spark具备了处理大规模结构化数据的能力,不仅比原有的RDD转化方式更加简单易用,且获得了更高的计算性能; Spark可轻松实现从MySQL到DataFrame的转化,且支持SQL查询; RDD是分布式的 Java对象的集合,但是,对象内部结构对于RDD而言却是不可知的;DataFrame是一种以RDD为基础的分布式数据集,提供了详细的结构信息。 RDD就像一个屋子,找东西要把这个屋子翻遍才能找到;DataFrame相当于在你的屋子里面打上了货架,只要告诉他你是在第几个货架的第几个位置, DataFrame就是在RDD基础上加入了列,处理数据就像处理二维表一样。 DataFrame与RDD的主要区别在于,前者带schema元信息,即DataFrame表示的二维表数据集的每一列都带有名称和类型。这使得Spark SQL得以洞察更多的结构信息,从而对藏于DataFrame背后的数据源以及作用于DataFrame之上的变换进行了针对性的优化,最终达到大幅提升运行时效率的目标。反观RDD,由于无从得知所存数据元素的具体内部结构,Spark Core只能在stage层面进行简单、通用的流水线优化。 DataFrame的创建 Spark2.0版本开始,Spark使用全新的SparkSession接口替代Spark1.6中的SQLContext及HiveContext接口来实现其对数据加载、转换、处理等功能。SparkSession实现了SQLContext及HiveContext所有功能; SparkSession支持从不同的数据源加载数据,并把数据转换成DataFrame,支持把DataFrame转换成SQLContext自身中的表,然后使用SQL语句来操作数据。SparkSession亦提供了HiveQL以及其他依赖于Hive的功能的支持;可以通过如下语句创建一个SparkSession对象: scala>importorg.apache.spark.sql.SparkSessionscala>valspark=SparkSession.builder().getOrCreate() 在创建DataFrame前,为支持RDD转换为DataFrame及后续的SQL操作,需通过import语句(即import spark.implicits._)导入相应包,启用隐式转换。 在创建DataFrame时,可使用spark.read操作从不同类型的文件中加载数据创建DataFrame,如:spark.read.json("people.json"):读取people.json文件创建DataFrame;在读取本地文件或HDFS文件时,要注意给出正确的文件路径;spark.read.csv("people.csv"):读取people.csv文件创建DataFrame; 读取hdfs上的json文件,并打印,json文件为: {"name":"Michael"}{"name":"Andy","age":30}{"name":"Justin","age":19} 读取代码: importorg.apache.spark.sql.SparkSessionvalspark=SparkSession.builder().getOrCreate()importspark.implicits._valdf=spark.read.json("hdfs://172.22.241.183:8020/user/spark/json_sparksql.json")df.show() RDD转换DataFrame Spark官网提供了两种方法来实现从RDD转换得到DataFrame:① 利用反射来推断包含特定类型对象的RDD的schema,适用对已知数据结构的RDD转换;② 使用编程接口,构造一个schema并将其应用在已知的RDD上; Spark-sql即席查询 SparkSQL 的元数据的状态有两种:① in_memory,用完了元数据也就丢了;② 通过hive保存,hive的元数据存在哪儿,它的元数据也就存在哪,SparkSQL数据仓库建立在Hive之上实现的,使用SparkSQL去构建数据仓库的时候,必须依赖于Hive。 Spark-sql命令行提供了即席查询能力,可以使用类sql方式操作数据源,效率高于hive,常用语句:https://www.cnblogs.com/BlueSkyyj/p/9640626.html; spark-sql导入数据到数仓:https://www.cnblogs.com/chenfool/p/4502212.html; Spark Streaming Spark Streaming是Spark Core扩展而来的一个高吞吐、高容错的实时处理引擎,同Storm的最大区别在于无法实现毫秒级计算,而Storm可以实现毫秒级响应,Spark Streaming 实现方式是批量计算,按照时间片对stream切割形成静态数据,并且基于RDD数据集更容易做高效的容错处理。Spark Streaming的输入和输出数据源可以是多种。Spark Streaming 实时读取数据并将数据分为小批量的batch,然后在spark引擎中处理生成批量的结果集。Spark Streaming提供了称为离散流或DStream的高级抽象概念,它表示连续的数据流。DStreams既可以从Kafka、Flume等源的输入数据流创建,也可以通过在其他DStreams上应用高级操作创建。在内部DStream表示为RDD序列。 在这里从一个例子开始介绍,StreamingContext是所有的流式计算的主要实体,创建含有两个执行线程的本地StreamingContext和1秒钟的batch,然后创建一个Dstream(lines)用于监听TCP端口,lines中的每一行就是一个RDD,flatMap函数将一个RDD分解成多个记录,是一对多的Dstream操作,这里使用空格将lines分解成单词,words被映射成(word, 1)对,随后进行词频统计,例子的代码如下: importorg.apache.spark._importorg.apache.spark.streaming._valconf=newSparkConf().setMaster("local[2]").setAppName("NetworkWordCount")valssc=newStreamingContext(conf,Seconds(1))vallines=ssc.socketTextStream("localhost",9999)valwords=lines.flatMap(_.split(""))valpairs=words.map(word=>(word,1))valwordCounts=pairs.reduceByKey(_+_)wordCounts.print()ssc.start()ssc.awaitTermination() Streaming 原理 可以参考官网教程:http://spark.apache.org/docs/latest/streaming-programming-guide.html,Spark Streaming提供了称为离散流或DStream的高级抽象,它表示连续的数据流,在内部DStream表示为RDD序列,每个RDD包含一定间隔的数据,如下图所示: 所有对于DStream的操作都会相应地转换成对RDDs的操作,在上面的例子中,flatMap操作被应用到lines 中的每个RDD中生成了一组RDD(即words) 总结编写Spark Streaming程序的基本步骤是: 1.通过创建输入DStream来定义输入源 2.通过对DStream应用转换操作和输出操作来定义流计算 3.用streamingContext.start()来开始接收数据和处理流程 4.通过streamingContext.awaitTermination()方法来等待处理结束(手动结束或因为错误而结束) 5.可以通过streamingContext.stop()来手动结束流计算进程 StreamingContext 有两种创建StreamingContext的方式:通过SparkContext创建和通过SparkConf创建; Spark conf创建: valconf=newSparkConf().setAppName(appName).setMaster(master);valssc=newStreamingContext(conf,Seconds(1)); appName是用来在Spark UI上显示的应用名称。master是Spark、Mesos或Yarn集群的URL,或者是local[*]。batch interval可以根据你的应用程序的延迟要求以及可用的集群资源情况来设置。 SparkContext创建: valsc=newSparkContext(conf)valssc=newStreamingContext(sc,Seconds(1)) 输入DStreams和Receiver 在前面的例子中lines就是从源得到的输入DStream,输入DStream对应一个接收器对象,可以从源接收消息并存储到Spark内存中进行处理。Spark Streaming提供两种streaming源: 基础源:直接可以使用streaming上下文API的源,比如files和socket; 高级源:通过引用额外实体类得到的Kafka,Flume源;可以在应用中创建使用多个输入DStreams来实现同时读取多种数据流,worker/executor 是持久运行的任务,因此它将占用一个分给该应用的core,因此Spark Streaming需要分配足够的core去运行接收器和处理接收的数据; 在本地运行Spark Streaming程序时,不要使用“local”或“local[1]”作为主URL。这两者中的任何一个都意味着在本地运行任务只使用一个线程。如果使用基于receiver的输入DStream(如Kafka、Flume等),这表明将使用单个线程运行receiver,而不留下用于处理所接收数据的线程。因此在本地运行时,始终使用“local[n]”作为主URL,其中n必须大于运行的receiver数量,否则系统将接收数据,但不能处理它。 Kafka和Flume这类源需要外部依赖包,其中一些库具有复杂的依赖关系,Spark shell中没有这些高级源代码,因此无法在spark-shell中测试基于这些高级源代码的应用程序,但可以手动将包引入; 基于可靠性的考虑,可以将数据源分为两类:可靠的接收器的数据被Receiver 接收后发送确认到源头(如Kafka ,Flume)并将数据存储在spark,不可靠的接收器不会向源发送确认。 DStreams转换 与RDD类似,转换操作允许修改来自输入DStream的数据,转换操作包括无状态转换操作和有状态转换操作。 无状态转换操作实例:下节spark-shell中“套接字流”词频统计采用无状态转换,每次统计都只统计当前批次到达的单词的词频,和之前批次无关,不会进行累计。 有状态转换操作实例:滑动窗口转换操作和updateStateByKey操作; 一些常见的转换如下: 窗口操作 每次窗口在源DStream上滑动,窗口内的源RDD被组合/操作生成了窗口RDD,在图例中,过去3个时间单位的数据将被操作,并按2个时间单位滑动。 任何窗口操作都需要指定两个参数:窗口长度:窗口的持续时间(图中值是3);滑动间隔:执行窗口操作的间隔(图中值是2)。这两个参数必须是源DStream的批处理间隔的倍数(图中值是1) 举例说明窗口操作:希望通过每隔10秒在最近30秒数据中生成字数来扩展前面的示例。为此,我们必须在最近的30秒数据上对(word,1)的DStream键值对应用reduceByKey操作。这是使用reduceByKeyAndWindow操作完成的。 valwindowedWordCounts=pairs.reduceByKeyAndWindow((a:Int,b:Int)=>(a+b),Seconds(30),Seconds(10)) 所有的滑动窗口操作都需要使用参数:windowLength(窗口长度)和slideInterval(滑动间隔),常见窗口操作总结如下,对应的含义可参照RDD的转换操作: Window:基于源DStream产生的窗口化的批数据计算得到新的Dstream; countByWindow: 返回DStream中元素的滑动窗口计数; reduceByWindow:返回一个单元素流。利用函数func聚集滑动时间间隔的流的元素创建这个单元素流。函数func必须满足结合律从而支持并行计算; reduceByKeyAndWindow(三参数):应用到一个(K,V)键值对组成的DStream上时,会返回一个由(K,V)键值对组成的新的DStream。每一个key的值均由给定的reduce函数(func函数)进行聚合计算。注意:在默认情况下,这个算子利用了Spark默认的并发任务数去分组。可以通过numTasks参数的设置来指定不同的任务数; reduceByKeyAndWindow(四参数):比上述reduceByKeyAndWindow(三参数)更高效的reduceByKeyAndWindow,每个窗口的reduce值是基于先前窗口的reduce值进行增量计算得到的;它会对进入滑动窗口的新数据进行reduce操作,并对离开窗口的老数据进行“逆向reduce”操作。但是,只能用于“可逆reduce函数”,即那些reduce函数都有一个对应的“逆向reduce函数”(以InvFunc参数传入)。 countByValueAndWindow:当应用到一个(K,V)键值对组成的DStream上,返回一个由(K,V)键值对组成的新的DStream。每个key的值都是它们在滑动窗口中出现的频率。 updateStateByKey:需要在跨批次之间维护状态时,必须使用updateStateByKey操作; 多流关联 窗口计算上join操作非常有用,在Spark Streaming中可以轻松实现不同类型的join,包括leftouterjoin、rightouterjoin和fulloterjoin。每个批处理间隔中stream1生成的RDD与stream2生成的RDD关联如下: valstream1:DStream[String,String]=...valstream2:DStream[String,String]=...valjoinedStream=stream1.join(stream2) Dstream的输出 输出操作允许将DStream的数据推送到外部系统,如数据库或files,由于输出操作触发所有DStream转换的实际执行(类似于RDD的操作),并允许外部系统使用转换后的数据,输出操作有以下几种: 在输出DStream中,Dstream.foreachRDD是一个功能强大的原语. DataFrame和SQL操作 可以轻松地对流数据使用DataFrames和SQL操作,但必须使用StreamingContext正在用的SparkContext创建SparkSession。下面例子使用DataFrames和SQL生成单词计数。每个RDD都转换为DataFrame,注册为临时表后使用SQL进行查询: valwords:DStream[String]=words.foreachRDD{rdd=>valspark=SparkSession.builder.config(rdd.sparkContext.getConf).getOrCreate()importspark.implicits._valwordsDataFrame=rdd.toDF("word")wordsDataFrame.createOrReplaceTempView("words")valwordCountsDataFrame=spark.sql("selectword,count(*)astotalfromwordsgroupbyword")wordCountsDataFrame.show()} Spark-shell流处理 进入spark-shell后就默认获得了的SparkConext,即sc,从SparkConf对象创建StreamingContext对象,spark-shell中创建StreamingContext对象如下: scala>importorg.apache.spark.streaming._scala>valssc=newStreamingContext(sc,Seconds(1)) 如果是编写一个独立的Spark Streaming程序,而不是在spark-shell中运行,则需要通过如下方式创建StreamingContext对象: importorg.apache.spark._importorg.apache.spark.streaming._valconf=newSparkConf().setAppName("TestDStream").setMaster("local[2]")valssc=newStreamingContext(conf,Seconds(1)) 文件流 文件流可以读取本机文件,也可以读取读取HDFS上文件,如果部署的on yarn模式的Spark,则启动spark-shell默认读取HDFS上对应的: hdfs:xxxx/user/xx/ 下的文件; scala>importorg.apache.spark.streaming._scala>valssc=newStreamingContext(sc,Seconds(5))scala>vallines=ssc.textFileStream("hdfs://xxx/yzg_test.txt")scala>valCounts=lines.flatMap(_.split("")).map((_,1)).reduceByKey(_+_)scala>Counts.saveAsTextFiles("hdfs://xxx/bendi"))scala>ssc.start()scala>ssc.awaitTermination()scala>ssc.stop() 以上代码在spark-shell中运行后,每隔5秒读取hdfs上的文件并进行词频统计后写入到hdfs中的“bendi-时间戳”文件夹下,直到ssc.stop();Counts.saveAsTextFiles("file://xxx/bendi"))和Counts.print分别写本地和std输出; Socket套接字流 Spark Streaming可以通过Socket端口实时监听并接收数据计算,步骤如下: driver端创建StreamingContext对象,启动上下文时依次创建JobScheduler和ReceiverTracker,并调用他们的start方法。ReceiverTracker在start方法中发送启动接收器消息给远程Executor,消息内部含有ServerSocket的地址信息。在executor一侧,由Receiver TrackerEndpoint终端接受消息,抽取消息内容,利用sparkContext结合消息内容创建ReceiverRDD对象,最后提交rdd给spark集群。在代码实现上,使用nc –lk 9999 开启 地址172.22.241.184主机的9999监听端口,并持续往里面写数据;使用spark-shell实现监听端口代码如下,输入源为socket源,进行简单的词频统计后,统计结果输出到HDFS文件系统; scala>importorg.apache.spark._scala>importorg.apache.spark.streaming._scala>importorg.apache.spark.storage.StorageLevelscala>valssc=newStreamingContext(sc,Seconds(5))scala>vallines=ssc.socketTextStream("172.22.241.184",9999,StorageLevel.MEMORY_AND_DISK_SER)scala>valwordCounts=lines.flatMap(_.split("")).map((_,1)).reduceByKey(_+_)scala>wordCounts.saveAsTextFiles("hdfs://xxx/bendi-socket"))scala>ssc.start()scala>ssc.awaitTermination()scala>ssc.stop() Kafka流(窗口) Kafka和Flume等高级输入源需要依赖独立的库(jar文件),如果使用spark-shell读取kafka等高级输入源,需要将对应的依赖jar包放在spark的依赖文件夹lib下。 根据当前使用的kafka版本,适配所需要的spark-streaming-kafka依赖的版本,在maven仓库下载,地址如下:https://mvnrepository.com/artifact/org.apache.spark/spark-streaming-kafka_2.10/1.2.1 将对应的依赖jar包放在CDH的spark的依赖文件夹lib下,通过引入包内依赖验证是否成功: scala>importorg.apache.spark._scala>importorg.apache.spark.streaming._scala>importorg.apache.spark.streaming.kafka._scala>valssc=newStreamingContext(sc,Seconds(5))scala>ssc.checkpoint("hdfs://usr/spark/kafka/checkpoint")scala>valzkQuorum="172.22.241.186:2181"scala>valgroup="test-consumer-group"scala>valtopics="yzg_spark"scala>valnumThreads=1scala>valtopicMap=topics.split(",").map((_,numThreads.toInt)).toMapscala>vallineMap=KafkaUtils.createStream(ssc,zkQuorum,group,topicMap)scala>valpair=lineMap.map(_._2).flatMap(_.split("")).map((_,1))scala>valwordCounts=pair.reduceByKeyAndWindow(_+_,_-_,Minutes(2),Seconds(10),2)scala>wordCounts.printscala>ssc.start updateStateByKey操作 当Spark Streaming需要跨批次间维护状态时,就必须使用updateStateByKey操作。以词频统计为例,对于有状态转换操作而言,当前批次的词频统计是在之前批次的词频统计结果的基础上进行不断累加,所以最终统计得到的词频是所有批次的单词总的词频统计结果。 valupdateFunc=(values:Seq[Int],state:Option[Int])=>{valcurrentCount=values.foldLeft(0)(_+_)valpreviousCount=state.getOrElse(0)Some(currentCount+previousCount)} 实现: importorg.apache.spark._importorg.apache.spark.streaming._importorg.apache.spark.storage.StorageLevelvalssc=newStreamingContext(sc,Seconds(5))ssc.checkpoint("hdfs:172.22.241.184:8020//usr/spark/checkpoint")vallines=ssc.socketTextStream("172.22.241.184",9999,StorageLevel.MEMORY_AND_DISK_SER)valwordCounts=lines.flatMap(_.split("")).map((_,1)).updateStateByKey[Int](updateFunc)wordCounts.saveAsTextFiles("hdfs:172.22.241.184:8020//user/spark/bendi-socket")ssc.start()ssc.awaitTermination()ssc.stop() Streaming同Kafka交互 Dstream创建 关于SparkStreaming实时计算框架实时地读取kafka中的数据然后进行计算,在spark1.3版本后kafkaUtils提供两种Dstream创建方法,一种为KafkaUtils.createDstream,另一种为KafkaUtils.createDirectStream。 KafkaUtils.createDstream方式 其构造函数为KafkaUtils.createDstream(ssc,[zk], [consumer group id], [per-topic,partitions] ),使用receivers来接收数据,利用的是Kafka高层次的消费者api,对于所有的receivers接收到的数据将会保存在Spark executors中,然后通过Spark Streaming启动job来处理这些数据,默认会丢失,可启用WAL日志,它同步将接受到数据保存到分布式文件系统上比如HDFS。所以数据在出错的情况下可以恢复出来。A、创建一个receiver来对kafka进行定时拉取数据,ssc的RDD分区和Kafka的topic分区不是一个概念,故如果增加特定主消费的线程数仅仅是增加一个receiver中消费topic的线程数,并不增加spark的并行处理数据数量。 B、对于不同的group和topic可以使用多个receivers创建不同的DStream C、如果启用了WAL(spark.streaming.receiver.writeAheadLog.enable=true) 同时需要设置存储级别(默认StorageLevel.MEMORY_AND_DISK_SER_2),即KafkaUtils.createStream(….,StorageLevel.MEMORY_AND_DISK_SER) KafkaUtils.createDirectStream方式 在spark1.3之后,引入了Direct方式,不同于Receiver的方式,Direct方式没有receiver这一层,其会周期性的获取Kafka中每个topic的每个partition中的最新offsets,之后根据设定的maxRatePerPartition来处理每个batch。如图:这种方法相较于Receiver方式的优势在于: 简化的并行:在Receiver的方式中我们提到创建多个Receiver之后利用union来合并成一个Dstream的方式提高数据传输并行度。而在Direct方式中,Kafka中的partition与RDD中的partition是一一对应的并行读取Kafka数据,这种映射关系也更利于理解和优化。 高效:在Receiver的方式中,为了达到0数据丢失需要将数据存入Write Ahead Log中,这样在Kafka和日志中就保存了两份数据,浪费!而第二种方式不存在这个问题,只要我们Kafka的数据保留时间足够长,我们都能够从Kafka进行数据恢复。 精确一次:在Receiver的方式中,使用的是Kafka的高阶API接口从Zookeeper中获取offset值,这也是传统的从Kafka中读取数据的方式,但由于Spark Streaming消费的数据和Zookeeper中记录的offset不同步,这种方式偶尔会造成数据重复消费。而第二种方式,直接使用了简单的低阶Kafka API,Offsets则利用Spark Streaming的checkpoints进行记录,消除了这种不一致性。 此方法缺点是它不会更新Zookeeper中的偏移量,因此基于Zookeeper的Kafka监视工具将不会显示进度。但是您可以在每个批处理中访问此方法处理的偏移量,并自行更新Zookeeper。 位置策略 参照官方的API文档地址:http://spark.apache.org/docs/latest/streaming-kafka-0-10-integration.html,位置策略是用来控制特定的主题分区在哪个执行器上消费的,在executor针对主题分区如何对消费者进行调度,并且位置的选择是相对的,位置策略有三种方案: 1、PreferBrokers:首选kafka服务器,只有在kafka服务器和executor位于同一主机可以使用该策略。 2、PreferConsistent:首选一致性,多数时候采用该方式,在所有可用的执行器上均匀分配kakfa的主题的所有分区,能够综合利用集群的计算资源。 3、PreferFixed:首选固定模式,如果负载不均衡可以使用该策略放置在特定节点使用指定的主题分区;该配置是手动控制方案,若没有显式指定的分区仍然采用(2)方案。 消费策略 消费者策略是控制如何创建和配制消费者对象或者如何对Kafka上的消息进行消费界定,比如t1主题的分区0和1,或者消费特定分区上的特定消息段。该类可扩展,自行实现。 1、ConsumerStrategies.Assign:指定固定的分区集合; defAssign[K,V](topicPartitions:Iterable[TopicPartition],kafkaParams:collection.Map[String,Object],offsets:collection.Map[TopicPartition,Long]) 2、ConsumerStrategies.Subscribe:允许消费订阅固定的主题集合; 3、ConsumerStrategies.SubscribePattern:使用正则表达式指定感兴趣的主题集合。 Spark Streaming开发 IDEA作为常用的开发工具使用maven进行依赖包的统一管理,配置Scala的开发环境,进行Spark Streaming的API开发; 下载并破解IDEA,并加入汉化的包到lib,重启生效; 在IDEA中导入离线的Scala插件:需要确保当前win主机上已经下载安装Scala并设置环境变量,首先下载IDEA的Scala插件,无须解压,然后将其添加到IDEA中,具体为new---setting--plugins--"输入scala"--install plugin from disk; Maven快捷键 shift键多次------查找类和插件;shift+ctrl+enter-------结束当前行,自动补全分号;shift+alter+s-----------setting设置alter+enter-----------补全抛出的异常alter+insert---------自动生成get、set、构造函数等;Ctrl+X--------------删除当前行ctrl+r----------------替换ctrl+/----------------多行代码分行注释,每行一个注释符号ctrl+shift+/---------多行代码注释在一个块里,只在开头和结尾有注释符号 任务提交 新建maven工程:file--new--project--maven(选择quickstart框架模型新建),groupId和ArtifactID用来区分该java工程; maven自动生成pom.xml配置文件,用于各种包的依赖和引入,如果使用maven打包,需要引入maven的打包插件:使用maven-compiler-plugin、maven-jar-plugin插件,并在prom.xml中增加指定程序入口的 配置;具体可参照:https://blog.csdn.net/qq_17348297/article/details/79092383 将mainClass设置为HelloWorld(主类),点击右边窗口maven -> package,生成jar包,打包完成后使用spark-submit指令提交jar包并执行。 spark-submit--class"JSONRead"/usr/local/spark/mycode/json/target/scala-2.11/json-project_2.11-1.0.jar 若有cannot find main class错误,需要删除-class xx.jar选项;若出现“Invalid signature file digest for Manifest main”错误,则运行zip -d xxx.jar 'META-INF/.SF' 'META-INF/.RSA' 'META-INF/*SF' 指令,删除所属jar包中.SF/.RSA/相关文件。任务yarn管理器查看任务运行情况; Structured Streaming 在Spark2.x中,spark新开放了一个基于DataFrame的无下限的流式处理组件Structured Streaming,在过去使用streaming时一次处理是当前batch的所有数据,针对这波数据进行各种处理,如果要做一些类似pv,uv的统计,需要借助有状态的state的DStream,或者借助一些分布式缓存系统,如Redis,做一些类似Group by的操作Streaming是非常不便的,在面对复杂的流式处理场景时捉襟见肘,且无法支持基于event_time的时间窗口做聚合逻辑。 在Structured Streaming中,把源源不断到来的数据通过固定的模式“追加”或者“更新”到无下限的DataFrame中。剩余的工作跟普通的DataFrame一样,可以去map、filter,也可以去groupby().count(),甚至还可以把流处理的dataframe跟其他的“静态”DataFrame进行join。另外,还提供了基于window时间的流式处理。总之,Structured Streaming提供了快速、可扩展、高可用、高可靠的流式处理。 Structured Streaming构建于sparksql引擎之上,可以用处理静态数据的方式去处理你的流计算,随着流数据的不断流入,Sparksql引擎会增量的连续不断的处理并且更新结果。可以使用DataSet/DataFrame的API进行 streaming aggregations, event-time windows, stream-to-batch joins等,计算的执行也是基于优化后的sparksql引擎。通过checkpointing and Write Ahead Logs该系统可以保证点对点,一次处理,容错担保。 - END - 欢迎加入 大数据 |数仓技术交流群 。 进群方式:请加微信(微信号:dataclub_bigdata),回复:数据,通过审核会拉你进群。 (备注:行业-职位-城市) 福利时刻 01. 后台回复「数据」,即可领取大数据经典资料。 02.后台回复「转型」,即可传统数据仓库转型大数据必学资料。 03. 后台回复「加群」,或添加一哥微信ID:dataclub_bigdata拉您入群(大数据|数仓|分析)或领取资料。 !关注不迷路~ 各种福利、资源定期分享! 你点的每个 在看 ,我都认真当成了喜欢 本文分享自微信公众号 - 数据社(DataClub)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册