首页 文章 精选 留言 我的

精选列表

搜索[深度集成],共10008篇文章
优秀的个人博客,低调大师

深度学习必备包

安装 Tensorflow Keras Opencv # For a specific version: !pip install tensorflow-gpu==1.5.0rc0 # To determine which version you're using: !pip show tensorflow-gpu # For the current version: !pip install --upgrade tensorflow-gpu # For the latest nightly build: !pip install tf-nightly-gpu !pip install -U tensorflow-gpu !pip install -U keras !pip install opencv-contrib-python --upgrade Keras: The Python Deep Learning library OpenCV An open-source software library for Machine Intelligence Install 7zip reader libarchive !pip install -U libarchive Install GraphViz & PyDot !pip install -U pydot graphviz Install xgboost !pip install -U xgboost import tensorflow as tf tf.keras # Keras 为 TensorFlow 提供了 API 探寻有趣之事!

优秀的个人博客,低调大师

Docker网络深度解读

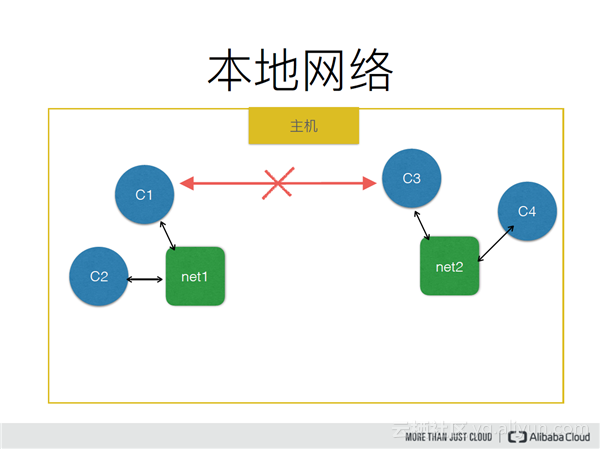
Docker概念和默认网络 什么是Docker网络呢?总的来说,网络中的容器们可以相互通信,网络外的又访问不了这些容器。具体来说,在一个网络中,它是一个容器的集合,在这个概念里面的一个容器,它会通过容器的IP直接去通信,又能保证在这个集合外的一些容器不能够通过这个容器IP去通信,能做到网络隔离。网络这个概念是由网络的驱动去创建、管理的。网络的驱动又分为全局的和本地的,全局的意思是这个网络可以跨主机,没必要说我的两个容器非要在一个主机上才能通过这个网络去通信,我可以在不同主机上还是通过容器的IP相互通信。 本地网络 首先我们看一个本地网络的图,这个图中有一台主机,上面跑了四个容器,分别分布在两个网络里面,一个是NET1,一个是NET2。NET1里面的两个容器是可以互相通过自己的IP通信的,但是NET1里面的容器和NET2里面的容器又是隔离

优秀的个人博客,低调大师

Greenplum深度优化技巧

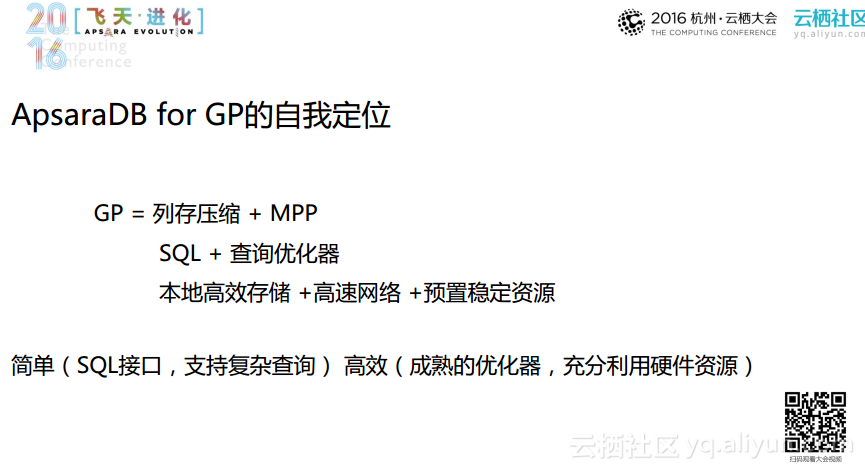
以下内容根据演讲PPT以及现场分享整理而成。 本次的分享将主要对云上的Greenplum进行介绍。有的同学往往有一些疑问就是Greenplum产品有什么优势?为什么要使用Greenplum?Greenplum能解决什么问题?在今天的分享中也将探讨这几个问题。最后还会提到一些阿里云Greenplum小组所做的工作。 本次的分享主要分为三个方面: 一、ApsaraDB for GP的定位 二、ApsaraDB for GP内核定制 三、未来规划 一、ApsaraDB for GP的定位 首先提出两个问题:Greenplum的优势是什么?它能解决什么问题? 阿里云的Greenplum产品叫做ApsaraDB for GP,我们给这个产品的定位只有两个字:性能,也就是阿里云的ApsaraDB for GP在性能方面一定要比其他的分析性的数据库解决方案更高。 在我看来,Greenplum的优势在于这样的几点:首先,Greenplum使用了MPP的架构,除此之外,它还使用了列存和压缩。列存和压缩在现在看来是比较普通的技术,但是其实像IBM的DB2数据库也才在近几年支持了列存和压缩技术,而Greenplum从很早就支持了这些技术,这些技术的在性能上会有很大的优势。而且Greenplum不仅能够支持复杂的SQL,而且它的查询优化器能力也大大超出预期。Greenplum产品性能的定位是在秒级或者小于秒级能够实现对于复杂查询的响应,Greenplum执行器的性能其实是来自多年来Postgre的积淀,要远远超过其他的解决方案。另外Greenplum使用的是本地高效存储和高速网络,当然最好是万兆网络,还有预置稳定资源,不会出现性能的波动,简单而言就是Greenplum可以高效地解决大数据分析的需求。 MPP架构处理举例 举一个例子:Select count(*) from customer group by city 这是一条很简单的SQL语句,比方是在数据库中按照城市分组查询每个城市的用户数量。 对比MySQL的执行过程来看,首先MySQL数据库会对所有的数据记录进行扫描,对用户按照城市进行分组,然后对于每组用户的数量进行统计,最后将结果返回给用户。对于1亿条记录而言,这时即使IO不出现问题,那么机器的CPU也会被占满。对于MySQL而言,这样的一个简单SQL语句就可以使机器的CPU占用率达到100%,而且这样执行的速度也是非常慢的。 而Greenplum则采取多核进行计算处理,比方在扫描数据的时候将会采用多个进程,多个CPU去处理,在Hash的时候也会使用多个CPU,这样速度就会变快。当数据量太大,多到一个机器处理不了的时候,就需要MPP了。所以Greenplum使用MPP架构解决了对于大数据量的问题,对于同样的一条SQL语句,Greenplum将会启动多个实例和进程去做同样的事情,执行同样的流程,但是处理的是不同的数据分片,如此就实现了多机器的查询计算,这也就是Greenplum的最核心能力,也是与传统数据库不同之处。 列存与压缩原理举例 再举一个SQL语句的例子:Select count(*) from customer where status = valid group by city 对于这条语句,DBA在对像MySQL这样的传统的数据库进行优化的时候,可能会选择使用索引。但是其实这种情况下使用索引是不恰当的,使用索引只能够过滤20%左右的数据,而增加的性能开销却是很大的,所以不应该使用索引。 列存方式则将会把status单独存储在一个列存块,经过压缩以后,占用的存储空间也会大大降低,同时也可以单独对status数据取出并进行处理。其实在这种情况下列存近似等于开销极小的索引,而且效率非常高。 Greenplum VS Hadoop Greenplum的Orca优化器,使得其在响应时间上比Hadoop的离线计算产品性能更加优秀。 Greenplum的 SQL Runtime是从Postgre几十年的沉淀演变来的,并且是由C语言构建的,比Hadoop的SQL Runtime效率高很多。还有Greenplum使用的是本地存储,而Hadoop使用的则是分布式存储。所以总体来看,Greenplum的性能可以达到Hadoop的5-30倍。 ApsaraDB for GP VS AWS Redshift 在亚马逊上有一款卖的非常好的产品,名字叫“Redshift”,它被称为亚马逊“有史以来卖的最好的云服务”,其实ApsaraDB for GP在功能上与Redshift很像,而且ApsaraDB for GP有很多Redshift不具备的特性。 在使用ApsaraDB for GP产品时,推荐使用ECS VPC的架构。架构搭建完成之后的一个问题就是:如何将ECS上的数据导入到ApsaraDB for GP进行分析呢?其实可以通过写程序的方式将数据导入到主节点上,也可以使用EMR图去主动地抓取并分析数据。EMR与OSS结合得非常好,将数据存放在OSS上之后,可以通过执行SQL语句使得所有的子节点并发地拉取数据。当然也可以通过应用服务器直接将数据或者日志上传到OSS上面去,对于其他的阿里云服务可也以通过阿里云CDB服务将数据定向迁移到OSS上面,再通过Greenplum进行数据拉取,进而使用可视化工具对数据进行分析。 二、ApsaraDB for GP 内核定制 接下来分享阿里云在Greenplum上做的一些优化工作。在阿里云ApsaraDB for GP架构设计中,子节点分散地存储在不同的物理机上面,每2个或者是16个子节点为一组。对于子节点组采取了资源限制,但是组内节点之间可以弹性共享资源,这样就降低资源倾斜造成的影响,也便于管理,同时节点之间使用万兆网络进行数据传输。 这样架构的一个优点是支持OSS外部表读写,可以在OSS外部创建一张表,使用简单的SQL语句就可以将数据导入到Greenplum的子节点上,同时也可以很简单地将数据从Greenplum导回到OSS。简而言之,就是让OSS充当数据存储中心,让Greenplum作为数据分析中心。 而且Greenplum支持将一些语法作为插件提供,很多这样插件目前已经提交开源社区,很快大家就可以用到了。而且未来ApsaraDB for GP将会完善对于JSON的支持,如果社区动作较慢,我们会考虑在阿里云自己的产品中优先支持。而对于OOM的很难提前监控的问题,阿里云采取的方法就是利用外部脚本监控cgroup中的内存统计,发生内存水位较高时,将实例移入公共cgroup,同时发出cancel query信号给内核;当水位下降时移回实例的cgroup。 三、未来规划 谈到未来规划,第一点就是必须要满足客户需求。另外还要继续对于列存进行优化,希望在未来能够在某些场景下将性能进一步提高。对于CPU优化方面,我们希望在未来能对GP执行器的静态编译进行进一步优化。最后我们希望与Greenplum厂商、用户和开发者一起为Greenplum社区的发展贡献力量,一起推动Greenplum的发展。

优秀的个人博客,低调大师

MapReduce-深度剖析

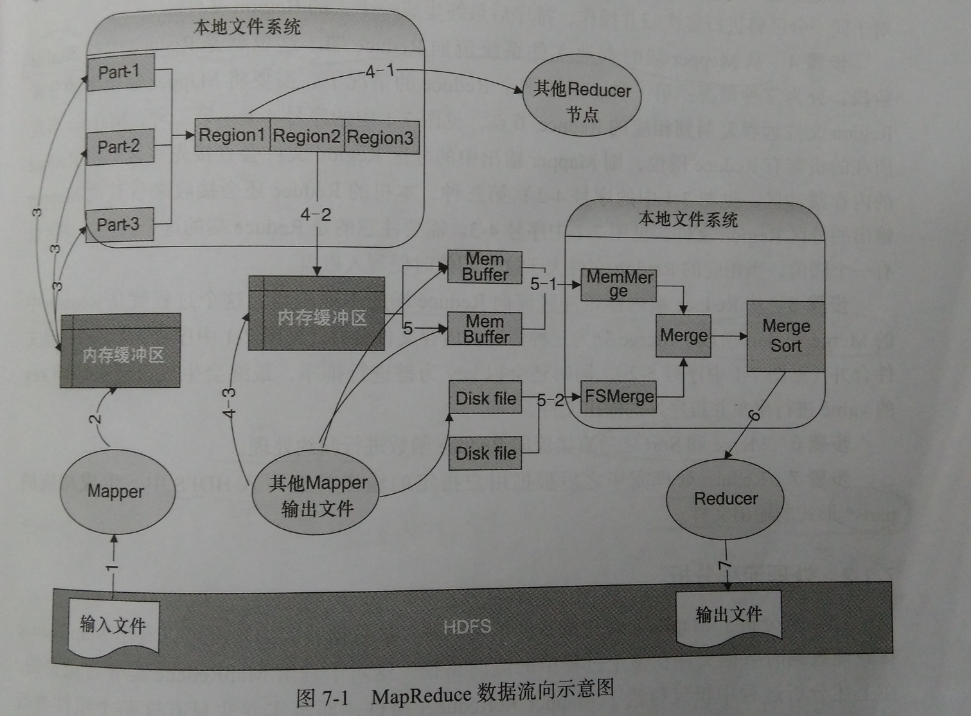
1.概述 在接触了第一代MapReduce和第二代MapReduce之后,或许会有这样的疑惑,我们从一些书籍和博客当中获取MapReduce的一 些原理和算法,在第一代当中会有JobTrack,TaskTrack之类的术语,在第二代会有 ResourceManager,NodeManager,ApplicationMaster等等术语。然又有Shuffle、 Partitioner、Sort、Combiner等关键字,如何区分它们,理顺其之间的联系。 在Hadoop2.x大行其道的年代,其优秀的资源管理框架(系统),高可用的分布式存储系统,备受企业青睐。然因上述之惑,往往不能尽得其中之深意。此篇博客笔者为大家一一解惑。 2.计算模型 在阅读和研究第一代MapReduce和第二代MapReduce之后,我们可以发现MapReduce其实由两部分组成,一者为其计算模型, 二者为其运行环境。到这里,就不难解释为何在第一代MapReduce里面由Shuffle、Sort等内容,而在第二代MapReduce中也同样存在 其相关内容。原因很简单,在Hadoop2.x中,MapReduce的变化,只有其运行环境变化了,然其计算模型依旧不变。 在MapReduce的计算模型当中,对方法进行了高阶抽象,其精华为Map Task和Reduce Task,在Map阶段完成对应的map函数的逻辑实现,与之相对的在Reduce阶段完成对应的reduce函数的逻辑实现,即可编写好整个核心的 MapReduce的处理过程,在Main函数入口之处,申请对应的Job,指定相应的Mapper和Reducer继承类,以及其输入输出类型等相关信 息,即可运行一个完整的MapReduce任务。 虽说我们能够编写一个完成MapReduce程序,并运行它。然其运行的细节,我们却未必清楚,往往初学者在编写一个MapReduce作业时,遇到错误而不去研究分析其错误之根本,转而求助于搜索引擎,在搜索无望之下,会让自己瞬间懵逼,不知所措。 这里,我们去剖析其计算模型的执行细节,虽不敢说剖析之后能解决所有的疑难杂症,但起码能让我们知晓错误原因,能够找到解决问题的方向,继而解决我们所遇之难题。下面为大家剖析MapReduce的计算模型。 Map阶段,简言之: Read:该步骤是去读取我们的数据源,将数据进行filter成一个个的K/V Map:在map函数中,处理解析的K/V,并产生新的K/V Collect:输出结果,存于环形内缓冲区 Spill:内存区满,数据写到本地磁盘,并生产临时文件 Combine:合并临时文件,确保生产一个数据文件 Reduce阶段,简言之: Shuffle:Copy阶段,Reduce Task到各个Map Task远程复制一分数据,针对某一份数据,若其大小超过一定阀值,则写磁盘;否则放到内容 Merge:合并内存和磁盘上的文件,防止内存占用过多或磁盘文件过多 Sort:Map Task阶段进行局部排序,Reduce Task阶段进行一次归并排序 Reduce:将数据给reduce函数 Write:reduce函数将其计算的结果写到HDFS上 上述为其计算模型的执行过程,需有几点要额外注意。这里有些阶段,我们在编写相关应用时,需有谨慎。 这里有一个Combine阶段,这个阶段的使用有助与我们对MapReduce的性能进行优化,为何这么说?细细剖析该过程便可明白。在map 函数时,它只管处理数据,并不负责统计处理数据的结果,也就是说并没有Combine阶段,那么,问题来了,在reduce过程当中,因为每个map函数 处理后的数据没有统计,它除了要统计所有map的汇总数量,还要统计单个map下的处理数。也许,这里有点绕,大家可以参照下图来理解这层意思,如下图所 示: 然而,这样是不行的,所以Reduce为了减轻压力,每个map都必须统计自己旗下任务处理结果,即:Combine。这样,Reduce所做 的事情就是统计每个map统计之后的结果,这样子就会轻松许多。因而,Combine在map所做的事情,减轻了Reduce的事情,省略了上图中的步骤 1。 具体代码细节,可在Job的属性方法中设置对应的参数,如下所示: job.setCombinerClass(DefReducer.class); 另外,我们也有必要理解Partition相关职责,它是分割map节点的结果,按照Key分别映射给不同的Reduce,这里我们可以理解为归类,对一些复杂的数据进行归类。在Job属性中设置对应的分区类,那么你的分区函数就生效了,如下所示: job.setPartitionerClass(DefPartition.class); 3.运行环境 在Hadoop2.x中,由于有了YARN来做资源管理,因而第二代MapReduce的运行环境,对比第一代MapReduce有了些许的改变。 4.总结 本篇博客给大家剖析了MapReduce的计算模型和运行环境,其中计算模型不变,变者乃其运行环境。所变内容,简言之:RM下包含AM和 NM,NM会RM申请Container(其可理解为一个运行时的JVM),NM与RM的通信属于“Pull模型”,即NM主动上报状态信息,RM被动接 受上报信息。 5.结束语 这篇文章就和大家分享到这里,如果大家在研究和学习的过程中有什么疑问,可以加群进行讨论或发送邮件给我,我会尽我所能为您解答,与君共勉!

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册