首页 文章 精选 留言 我的

精选列表

搜索[最大转化投放],共10007篇文章
优秀的个人博客,低调大师

功能区域分析--如何将业务架构转化成为IT应用

功能区域分析可以从组件业务模型开始,并可将确定的CBM 能力作为起点。业务建模的工作由正在研究的业务领域确定范围,所以功能区域分析可从这组初始业务领域中进行选择,然后进一步将它们分解为子领域,并最终分解成功能区域 - 来自初始模型的CBM 组件应在此处提供良好的指导信息。 功能区域分析以创建摘要描述开始,摘要描述用于定义每个领域的高级别的主要功能职责。接下来,每个领域又分解成更小更离散的功能区域。每个功能区域将按它负责的具体功能以及它与其他功能区域协作过程中所依赖的功能来进行描述。 如果功能区域分析是使用 CBM 工作的输入执行的,那么业务领域通常将映射为 CBM 能力,CBM 业务组件是识别功能区域的好起点,CBM 组件服务和活动是识别功能的好方法。CBM 组件通常一对一映射到功能区域,虽然在某些情况下,CBM 组件可能过于笼统而包含过多种类的功能。在这种情况下,就需要把它进一步分解成多个功能区域。 这些功能区域将分配到业务系统,业务系统将支持一些服务来交付这些功能(这些功能本身可能也指示了自动化),这些功能即为业务系统内将实现这些服务中的一些或全部的 IT 子系统。 具体步骤 1、将领域分解为功能区域 功能区域分析以创建摘要描述开始,摘要描述用于定义每个领域的高级别的主要功能职责。接下来,每个领域又分解成更小更离散的功能区域。每个功能区域将按它负责的具体功能以及它与其他功能区域协作过程中所依赖的功能来进行描述。 如果功能区域分析是使用 CBM 工作的输入执行的,那么业务领域通常将映射为 CBM 能力,CBM 业务组件是识别功能区域的好起点,CBM 组件服务和活动是识别功能的好方法。CBM 组件通常一对一映射到功能区域,虽然在某些情况下,CBM 组件可能过于笼统而包含过多种类的功能。 在这种情况下,就需要将它进一步分解成多个功能区域。这些功能区域将分配到业务系统,业务系统将支持一些服务来交付这些功能。 由于每个功能区域按其功能来进行分析和描述,因此分析时还将识别一个较大的环境,其中包含了该功能区域与其他功能区域之间的关系(即:功能区域之间的交互和协作)。这将有助于确定拥有功能区域的业务系统如何进行协作。 2、将功能区域映射到(IT)子系统 对业务领域的分区形成了一组功能区域。这些功能区域应指示了内聚功能的聚集,这些内聚功能可分配到子系统,子系统将交付该能力。每个子系统是一个概念性机制,用来帮助定义交付该能力的服务的封装,而该能力可能最终由业务系统内的 IT 系统自动执行。子系统相互协作来交付由拥有功能区域的业务系统提供的服务。 源自功能区域分析的子系统识别实现了从对功能区域进行业务识别、将功能区域映射到业务系统、直到决定哪些子系统实际参与实施给定功能区域的无缝转换。这些子系统将成为供复用的蓝图。该方法不仅向我们提供了子系统行为的抽象规范,还提供了子系统相互协作和依赖所遵循的约束。 可能不必进一步优化分配到业务系统的功能。在这种情况下,功能区域和子系统之间存在一对一的映射,即支持该功能区域的业务系统具有一个 IT 子系统(等价对象),可产生自己的行为。另一方面,子系统的数量增长可能意味着功能区域过于宽泛而无法分配到单个业务系统,并需要对其进行进一步的划分。 本文转自肖勇51CTO博客,原文链接:http://blog.51cto.com/xiaoyong/248307,如需转载请自行联系原作者
优秀的个人博客,低调大师

财务智能体落地最大阻碍是什么?

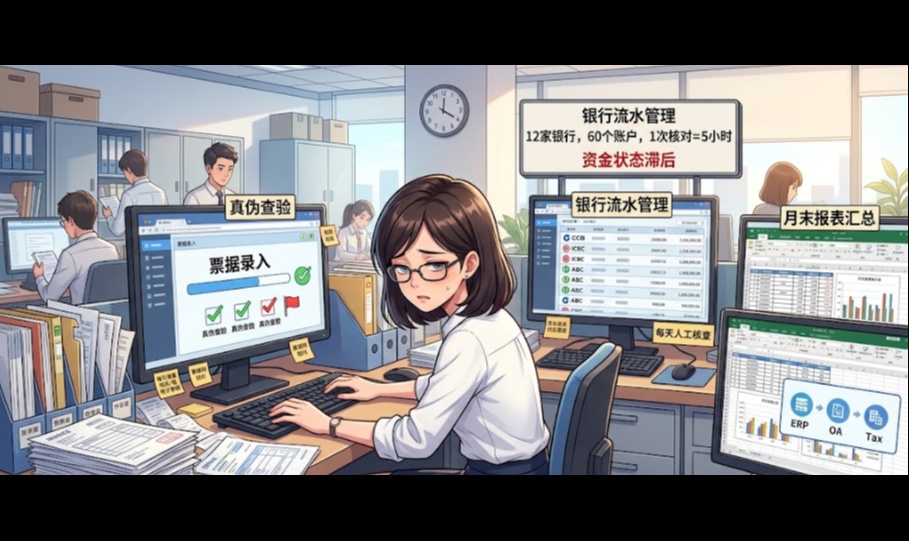
某集团财务部去年做了一个决定——把票据处理和银行对账全部交给智能体来跑。这个决定差点因为一个细节被否掉:上线前的评审会上,有人问了一句"机器人算错了算谁的",没人能立刻答上来。这也是几乎所有财务部门推进自动化时都要过的第一道坎:效率提升是共识,但责任怎么划分,才是决定项目能不能真正落地的关键。

优秀的个人博客,低调大师

python spark 求解最大 最小 平均 中位数

rating_data_raw = sc.textFile("%s/ml-100k/u.data" % PATH) print rating_data_raw.first() num_ratings = rating_data_raw.count() print "Ratings: %d" % num_ratings # In[35]: rating_data = rating_data_raw.map(lambda line: line.split("\t")) ratings = rating_data.map(lambda fields: int(fields[2])) max_rating = ratings.reduce(lambda x, y: max(x, y)) min_rating = ratings.reduce(lambda x, y: min(x, y)) mean_rating = ratings.reduce(lambda x, y: x + y) / float(num_ratings) median_rating = np.median(ratings.collect()) ratings_per_user = num_ratings / num_users ratings_per_movie = num_ratings / num_movies print "Min rating: %d" % min_rating print "Max rating: %d" % max_rating print "Average rating: %2.2f" % mean_rating print "Median rating: %d" % median_rating print "Average # of ratings per user: %2.2f" % ratings_per_user print "Average # of ratings per movie: %2.2f" % ratings_per_movie # In[36]: # we can also use the stats function to get some similar information to the above ratings.stats() 上面是粗暴的做法 简单的做法: >>> all_data = sc.parallelize([1,2,3,4,5,6,7,8,100]) >>> all_data.mean() 15.11111111111111 >>> all_data.max() 100 >>> all_data.min() 1 >>> all_data.median() Traceback (most recent call last): File "<stdin>", line 1, in <module> AttributeError: 'RDD' object has no attribute 'median' >>> all_data.stats() (count: 9, mean: 15.1111111111, stdev: 30.0903987804, max: 100.0, min: 1.0) 本文转自张昺华-sky博客园博客,原文链接:http://www.cnblogs.com/bonelee/p/7153889.html ,如需转载请自行联系原作者

优秀的个人博客,低调大师

最大的Redis集群:新浪Redis集群揭秘

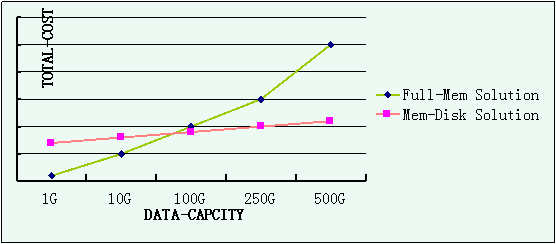
前言 Tape is Dead,Disk is Tape,Flash is Disk,RAM Locality is King. — Jim Gray Redis不是比较成熟的Memcache或者Mysql的替代品,是对于大型互联网类应用在架构上很好的补充。现在有越来越多的应用也在纷纷基于Redis做架构的改造。 可以简单公布一下Redis平台实际情况 2200+亿 commands/day 5000亿Read/day 500亿Write/day 18TB+ Memory 500+ Servers in6 IDC 2000+instances 应该是国内外比较大的Redis使用平台,今天主要从应用角度谈谈Redis服务平台。 Redis使用场景 1.Counting(计数) 计数的应用在另外一篇文章里较详细的描述,计数场景的优化http://www.xdata.me/?p=262这里就不坳述了。 可以预见的是,有很多同学认为把计数全部存在内存中成本非常高,我在这里用个图表来表示下我的观点: 很多情况大家都会设想纯使用内存的方案会很有很高成本,但实际情况往往会有一些不一样: 1.COST,对于有一定吞吐需求的应用来说,肯定会单独申请DB、Cache资源,很多担心DB写入性能的同学还会主动将DB更新记入异步队列,而这三块的资源的利用率一般都不会太高。资源算下来,你惊异的发现:反而纯内存的方案会更精简! 2.KISS原则,这对于开发是非常友好的,我只需要建立一套连接池,不用担心数据一致性的维护,不用维护异步队列。 3.Cache穿透风险,如果后端使用DB,肯定不会提供很高的吞吐能力,cache宕机如果没有妥善处理,那就悲剧了。 4.大多数的起始存储需求,容量较小。 2.Reverse cache(反向cache) 面对微博常常出现的热点,如最近出现了较为火爆的短链,短时间有数以万记的人点击、跳转,而这里会常常涌现一些需求,比如我们向快速在跳转时判定用户等级,是否有一些账号绑定,性别爱好什么的,已给其展示不同的内容或者信息。 普通采用Memcache+Mysql的解决方案,当调用id合法的情况下,可支撑较大的吞吐。但当调用id不可控,有较多垃圾用户调用时,由于memcache未有命中,会大量的穿透至Mysql服务器,瞬间造成连接数疯长,整体吞吐量降低,响应时间变慢。 这里我们可以用redis记录全量的用户判定信息,如string key:uid int:type,做一次反向的cache,当用户在redis快速获取自己等级等信息后,再去Mc+Mysql层去获取全量信息。如图: 当然这也不是最优化的场景,如用Redis做bloomfilter,可能更加省用内存。 3.Top 10 list 产品运营总会让你展示最近、最热、点击率最高、活跃度最高等等条件的top list。很多更新较频繁的列表如果使用MC+MySQL维护的话缓存失效的可能性会比较大,鉴于占用内存较小的情况,使用Redis做存储也是相当不错的。 4.Last Index 用户最近访问记录也是redis list的很好应用场景,lpush lpop自动过期老的登陆记录,对于开发来说还是非常友好的。 5.Relation List/Message Queue 这里把两个功能放在最后,因为这两个功能在现实问题当中遇到了一些困难,但在一定阶段也确实解决了我们很多的问题,故在这里只做说明。 Pinterest使用Redis存储社交graph信息: http://blog.gopivotal.com/case-studies-2/using-redis-at-pinterest-for-billions-of-relationships Message Queue就是通过list的lpop及lpush接口进行队列的写入和消费,由于本身性能较好也能解决大部分问题。 6.Fast transaction with Lua Redis 的Lua的功能扩展实际给Redis带来了更多的应用场景,你可以编写若干command组合作为一个小型的非阻塞事务或者更新逻辑,如:在收到 message推送时,同时1.给自己的增加一个未读的对话 2.给自己的私信增加一个未读消息 3.最后给发送人回执一个完成推送消息,这一层逻辑完全可以在Redis Server端实现。 但是,需要注意的是Redis会将lua script的全部内容记录在aof和传送给slave,这也将是对磁盘,网卡一个不小的开销。 7.Instead of Memcache 很多测试和应用均已证明, 1.在性能方面Redis并没有落后Memcache多少,而单线程的模型给Redis反而带来了很强的扩展性。 2.在很多场景下,Redis对同一份数据的内存开销是小于Memcache的slab分配的。 3.Redis提供的数据同步功能,其实是对cache的一个强有力功能扩展。 Redis使用的重要点 1.rdb/aof Backup! 我们线上的Redis 95%以上是承担后端存储功能的,我们不仅用作cache,而更为一种k-v存储,他完全替代了后端的存储服务(MySQL),故其数据是非常重要的,如 果出现数据污染和丢失,误操作等情况,将是难以恢复的。所以备份是非常必要的!为此,我们有共享的hdfs资源作为我们的备份池,希望能随时可以还原业务 所需数据。 2.Small item & Small instance! 由于Redis单线程(严格意义上不是单线程,但认为对request的处理是单线程的)的模型,大的数据结构list,sorted set,hash set的批量处理就意为着其他请求的等待,故使用Redis的复杂数据结构一定要控制其单key-struct的大小。 另外,Redis单实例的内存容量也应该有严格的限制。单实例内存容量较大后,直接带来的问题就是故障恢复或者Rebuild从库的时候时间较长, 而更糟糕的是,Redis rewrite aof和save rdb时,将会带来非常大且长的系统压力,并占用额外内存,很可能导致系统内存不足等严重影响性能的线上故障。我们线上96G/128G内存服务器不建议 单实例容量大于20/30G。 3.Been Available! 业界资料和使用比较多的是Redis sentinel(哨兵) http://www.huangz.me/en/latest/storage/redis_code_analysis/sentinel.html http://qiita.com/wellflat/items/8935016fdee25d4866d9 2000行C实现了服务器状态检测,自动故障转移等功能。 但由于自身实际架构往往会复杂,或者考虑的角度比较多,为此@许琦eryk和我一同做了hypnos项目。 hypnos是神话中的睡神,字面意思也是希望我们工程师无需在休息时间处理任何故障。:-) 其工作原理示意如下: Talk is cheap, show me your code! 稍后将单独写篇博客细致讲下Hypnos的实现。 4.In Memory or not? 发现一种情况,开发在沟通后端资源设计的时候,常常因为习惯使用和错误了解产品定位等原因,而忽视了对真实使用用户的评估。也许这是一份历史数据,只有最近一天的数据才有人进行访问,而把历史数据的容量和最近一天请求量都抛给内存类的存储现实是非常不合理的。 所以当你在究竟使用什么样的数据结构存储的时候,请务必先进行成本衡量,有多少数据是需要存储在内存中的?有多少数据是对用户真正有意义的。因为这其实对后端资源的设计是至关重要的,1G的数据容量和1T的数据容量对于设计思路是完全不一样的 Plans in future? 1.slave sync改造 全部改造线上master-slave数据同步机制,这一点我们借鉴了MySQL Replication的思路,使用rdb+aof+pos作为数据同步的依据,这里简要说明为什么官方提供的psync没有很好的满足我们的需求: 假设A有两个从库B及C,及 A `— B&C,这时我们发现master A服务器有宕机隐患需要重启或者A节点直接宕机,需要切换B为新的主库,如果A、B、C不共享rdb及aof信息,C在作为B的从库时,仍会清除自身数 据,因为C节点只记录了和A节点的同步状况。 故我们需要有一种将A`–B&C 结构切换切换为A`–B`–C结构的同步机制,psync虽然支持断点续传,但仍无法支持master故障的平滑切换。 实际上 我们已经在我们定制的Redis计数服务上使用了如上功能的同步,效果非常好,解决了运维负担,但仍需向所有Redis服务推广,如果可能我们也会向官方Redis提出相关sync slave的改进。 2.更适合redis的name-system Or proxy 细心的同学发现我们除了使用DNS作为命名系统,也在zookeeper中有一份记录,为什么不让用户直接访问一个系统,zk或者DNS选择其一呢? 其实还是很简单,命名系统是个非常重要的组件,而dns是一套比较完善的命名系统,我们为此做了很多改进和试错,zk的实现还是相对复杂,我们还没有较强的把控粒度。我们也在思考用什么做命名系统更符合我们需求。 3.后端数据存储 大内存的使用肯定是一个重要的成本优化方向,flash盘及分布式的存储也在我们未来计划之中。 via:http://www.xdata.me/?p=301 分类: 分布式消息框架 本文转自快乐就好博客园博客,原文链接:http://www.cnblogs.com/happyday56/p/3955634.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

网络间谍成今年全球企业最大威胁

网络安全公司趋势科技最新研究表明,全球20%的企业将网络间谍列为其商业面临的最严重威胁,26%的企业正努力跟上快速变化的威胁格局。2016年,美国有1/5的企业曾遭受过网络间谍相关的攻击。 趋势科技通过调查2402名欧美企业IT决策者后发现,2017年,受访者最担忧的安全问题是网络间谍活动(20%),其次是针对性攻击(17%)和网络钓鱼攻击(16%)。最恐惧网络间谍活动的企业按国家排名为:意大利(36%)、法国(24%)、德国(20%)和荷兰(17%)。值得注意的是,这些国家2017年都将进行大选。 据调查,10个国家中有8个国家将网络犯罪的不可预见性(总体占比36%)视为防范网络威胁的三大挑战之一。另外两大挑战为:对最新的威胁形势缺乏了解(29%),努力跟上快速变化的威胁格局以及应对日益复杂化的网络犯罪活动(26%)。 趋势科技首席技术官雷蒙德·吉恩称:“随着越来越多的重要数据转移到网上,国家企图通过企业获取这些重要数据,而企业也在努力跟上步伐,这也可能使关键基础设施面临危险。国家能使用更复杂的方法针对如医院、公共事业和交通信号服务等机构展开攻击,从而造成更具灾难性的后果。” 研究指出,在过去的12个月内,64%的企业都经历过至少一次“已知”的大型网络攻击。勒索软件是这些网络攻击中最常见的威胁类型。78%的受访者称在此期间至少遭受过一次勒索软件攻击。事实上,只有16%的受攻击企业表示还未遭遇过勒索软件攻击。 根据趋势科技的预测,只有10%的企业认为勒索软件将在2017年构成威胁,尽管2016年勒索软件攻击增加了748%,导致全球企业损失高达10亿美元。预计在2017年,勒索软件家族数量会增加25%,并扩展到移动电话、物联网和工业物联网(IIoT)等设备。 商业电子邮件入侵也被称为首席执行官欺诈或“捕鲸”——仅被12%的受访者视为威胁,这表明企业低估了这些攻击的影响。这种诈骗十分有利可图,仅2016年,这种攻击就导致全球企业损失14万美元 本文转自d1net(转载)

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册