首页 文章 精选 留言 我的

精选列表

搜索[智能创作],共10002篇文章
优秀的个人博客,低调大师

30 秒给代码做年检:一个单文件 HTML 工具的创作全记录

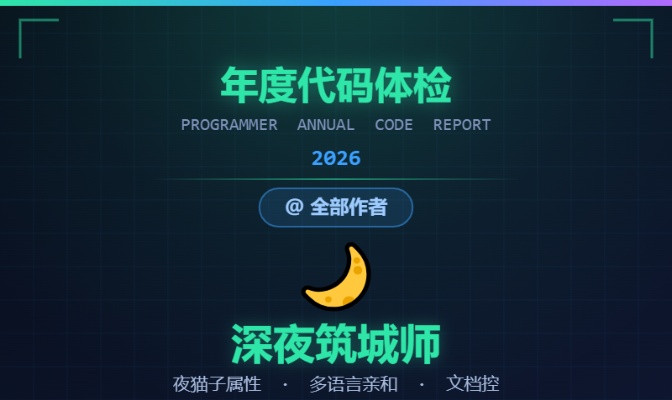
# 我把一年的 git 提交做成了一份体检报告|1024 造物挑战参赛作品 > 体验地址:https://code-health-report-68057.app.workbuddy.host/?sharecode=JVVZ5LADAZ > 单文件 HTML,双击即用,git 数据全程本地解析,不上传任何服务器。 ## 一、起因:一年 300 次提交,我却从没看清过自己 每年 1024 刷朋友圈,看着大家晒各种代码截图,总觉得少一份属于自己的东西。去年年底打算复盘下自己这一年的提交习惯,没发现可顺手的工具。公司内部的代码平台又没有个人视角的统计;自己写脚本拉数据,还得折腾环境、搭依赖,嫌麻烦一直没弄。 平时也碰到两个很实在的场景:一、写团队年度总结的时候,拿不出直观的个人开发素材;二、到了程序员节想发条朋友圈,又找不到可直观的分享图。于是这次 1024 造物挑战,我做了这个:**粘贴一段 git log,出一份年度代码体检报告**。 ![1-输入与操作说明.png](https://developer.qcloudimg.com/http-save/yehe-12838928/af6dfdebf7f0bd6d5bce02576a4a7f98.png) ## 二、三步用法 1. 在 git 仓库目录执行下面这条命令(页面内置「复制命令」按钮,不用手敲): git log --numstat --pretty=format:"#C|%ad|%an|%s" --date=iso > gitlog.txt 2. 全选复制文件内容,粘贴到页面输入框 3. 点「生成体检报告」。想先看效果可以点「加载示例」 ## 三、它给了你什么 **代码人格画像。** 8 种人格:深夜筑城师、晨光先行者、全栈游侠、重构艺术家、连击狂人、高产永动机、周末战士、稳健筑路人。用有序规则链判定,命中即停,规则写在页面内置的「评分图鉴」里——不是黑盒猜谜,每一项怎么来的都能自己验算。尤其是看到代码人格时,突然眼前一亮,比较吸引人眼球。 ![2-人格画像与核心指标.png](https://developer.qcloudimg.com/http-save/yehe-12838928/6296c4c4d93b412c2730b503e27c0533.png) **成就徽章墙。** 10 枚徽章按真实阈值点亮:夜猫子(深夜提交 ≥25%)、连击狂人(连续 ≥14 天)、重构狂(删除/新增 ≥0.6)、文档卫士(Markdown 占比 ≥8%)、团队核心(多人协作且贡献最高)…… **代码健康分。** 满分 100 = 活跃度 55 + 连续性 25 + 语言多样性 20。公式公开,可复算。 **可视化。** GitHub 风格的提交热力图、一天中的提交时段、月度趋势、代码净增长累计曲线、星期分布、commit message 词云(中英文混合词频,手写实现,没引第三方库)。 ![3-提交热力图.png](https://developer.qcloudimg.com/http-save/yehe-12838928/098f09799df62577fb7c9dabc8ae22c8.png) **分享。** 一键复制金句;canvas 手绘 800×1660 竖版海报,本地生成直接下载,带作者署名和连击日期区间。 ![7-分享海报.png](https://developer.qcloudimg.com/http-save/yehe-12838928/1d890596e8c58d5b6235d2e4046a2fc3.png) **按年份 / 按作者 / 组合筛选。** 标题、跨度、人格、徽章、海报全部联动重算。这一条是被人骂出来的——第一版只有全量统计,朋友试了说"我看团队报告干嘛,我就想知道我自己这一年",于是加了双维度筛选。 ## 四、技术选择:为什么坚持单文件零依赖 最终产物是**一个 51KB 的 HTML 文件**:零依赖、零构建、零 CDN,断网可跑,双击即用,扔微信群就能打开。 - 所有图表用 `createElementNS` 手写 SVG 逐元素绘制,不引 Chart.js / ECharts - 词频引擎手写:英文正则匹配 + 中文词表多重匹配计数 - 人格判定是有序规则链,优先级明确、可解释 - git 解析器要处理 numstat 的重命名条目(`{old => new}` 和 `old => new` 两种形态)、中文路径的八进制转义还原(`"doc/\344\270\264\346\227\266.txt"`)、jeecg 模板的 `${entityName}Controller.javai` 这类花括号文件名 之所以这么选,是因为它解决的是"看一眼自己的一年"这种轻需求——**让人先装环境,需求就死了**。 ## 五、踩过的三个坑(最有价值的部分) **坑 1:SVG 缩放让面板高度乱跳。** 热力图最初用 `viewBox + width:100%`,我切换作者或年度后发现,结果周数少时(比如 10 周)viewBox 窄,整张图被放大 2.8 倍,格子变成 40×40px、面板涨到 380px;换成 52 周又缩成 8px 小格。同一份数据换个筛选条件,页面就跳动。解法:固定像素方格 + 像素宽高输出,不再缩放;容器放不下时只画最近 N 周并提示。 **坑 2:canvas 文字不能用字号估算间距。** 生成海报的时候,我打开发现emoji 头像和作者名字发生重叠、文字被盖住。原因:canvas 的 `measureText` 只算文字宽度,不能简单拿字号当行高 / 偏移去估算垂直间距,emoji 渲染宽高和普通文字还不一样,直接按字号偏移很容易错位覆盖。 **坑 3:powershell导出gitlog.txt中文乱码。** 我发现用 PowerShell 执行 git log 输出到 txt 文件,中文乱码;换成 cmd 跑同一条导出命令,乱码问题消失 ## 六、隐私:一条硬约束 整个工具**不发送任何网络请求**。git log 只在你的浏览器里解析,不经过任何服务器。这不是附加说明,是设计前提——谁会愿意把公司仓库的提交记录传到第三方网站上? ## 七、欢迎试玩 体验地址:https://code-health-report-68057.app.workbuddy.host/?sharecode=JVVZ5LADAZ 欢迎点进去试试,尤其是把你的 git log 粘进去看看你是什么人格。用着不顺手的地方,评论区告诉我。 #WorkBuddy #1024程序员节 --- 原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。 如有侵权,请联系 cloudcommunity@tencent.com 删除。

优秀的个人博客,低调大师

AI 漫剧创作的专业工程化实践:从分镜 JSON 到成片合成

AI 漫剧不是“输入一句话生成一部剧”,而是一条工程流水线:选题、剧本、分镜、角色设定、画面生成、动态化、配音、字幕、合成、审核、复盘。专业视角下,核心是**结构化、可复现、可观测、可合规**。 ## 一、专业流程拆解 1. 选题:高频情绪、强冲突、明确受众。 1. 剧本:三幕结构,前 3 秒抓人,每 15 秒一个小转折。 1. 分镜:场景、景别、运镜、动作、对白、时长。 1. 角色卡:外形、服装、配色、比例、禁止项。 1. 视觉生成:文生图、图生视频、动态漫。 1. 音频:TTS、音效、BGM。 1. 合成:ffmpeg 拼接、字幕、转场。 1. 审核:版权、敏感内容、AI 标注。 ## 二、分镜结构化:让 LLM 输出可校验 JSON 自由文本难以编排,建议用 Pydantic 定义模型。 ``` import os, json from openai import OpenAI from pydantic import BaseModel, Field client = OpenAI( api_key=os.getenv("OPENAI_API_KEY"), base_url=os.getenv("OPENAI_BASE_URL"), ) class Shot(BaseModel): shot_id: int scene: str camera: str = Field(description="景别与运镜,如中景推近") action: str dialogue: str = "" duration: float = Field(ge=1, le=8) class Episode(BaseModel): title: str characters: list[str] shots: list[Shot] def generate_episode(theme: str) -> Episode: prompt = f""" 你是漫剧分镜师。根据主题生成 6 个镜头,每镜 3-5 秒。 主题:{theme} 要求:原创角色,无侵权元素,无真实品牌,无违法内容。 只输出 JSON,字段符合 Episode 模型。 """ resp = client.chat.completions.create( model=os.getenv("OPENAI_MODEL", "gpt-4o-mini"), messages=[{"role": "user", "content": prompt}], response_format={"type": "json_object"}, temperature=0.7, ) return Episode.model_validate(json.loads(resp.choices[0].message.content)) ep = generate_episode("原创小猫在雨夜寻找回家的路") print(ep.model_dump_json(indent=2)) ``` 关键点:角色名、场景名、风格词固定;单镜头只写一个动作;时长 3—5 秒,便于图生视频。 ## 三、角色一致性 每个角色建立角色卡: ``` 角色名:小灰 外形:原创灰色小猫,绿色眼睛,红色围巾,二头身 风格:扁平卡通,粗描边,低饱和,贴纸感 禁止:文字、Logo、真实动物照片、复杂背景 ``` 生成时固定 seed、模型、采样器,并使用参考图或 IP-Adapter。角色复杂可训练 LoRA。每次只改表情和动作,不改角色描述。 ## 四、图生视频与合成 将分镜图作为首帧,调用视频生成 API 生成 3—5 秒片段。 ``` def gen_video(image_path: str, motion_prompt: str) -> str: # 实际调用即梦、可灵、Runway 等官方 API # 参数:首帧图、运动描述、时长、比例、种子 return "outputs/shot_01.mp4" ``` 拼接所有片段: ``` # list.txt 内容:file 'outputs/shot_01.mp4' ffmpeg -f concat -safe 0 -i list.txt -c copy rough_cut.mp4 ``` 添加字幕: ``` ffmpeg -i rough_cut.mp4 -vf "subtitles=subtitle.srt" final.mp4 ``` ## 五、工程化与合规 1. 任务队列:每个镜头一个任务,支持重试、超时、取消。 1. 成本控制:低分辨率预览,定稿后高清生成。 1. 可观测:记录 trace_id、模型、耗时、token、视频时长。 1. 审核:敏感词、版权、肖像权、AI 标注。 1. 合规:只使用原创或授权素材;不生成违法、暴力、色情、歧视内容;不冒充真人;不绕过平台审核。 审核函数示例: ``` BAD_WORDS = {"违法", "暴力", "色情"} def audit(text: str) -> bool: if any(w in text for w in BAD_WORDS): raise ValueError("审核未通过") return True ``` ## 六、总结 AI 漫剧的专业流程是:结构化剧本 → 分镜 JSON → 角色卡 → 图生视频 → TTS/字幕 → ffmpeg 合成 → 审核发布。代码可以简单,但数据校验、角色一致性、任务编排和合规审查不能省。先跑通 15 秒短片,再扩展到系列化生产。不要承诺爆款,不要侵权,不要刷量,把内容质量和合规放在第一位。
优秀的个人博客,低调大师

爆款漫剧创作指南:从剧本到成片的工程化实践(含代码)

漫剧不是简单地把漫画配个音。它更接近一条小型动画流水线:选题、剧本、分镜、角色设定、画面生成、动态化、配音、字幕、合成、审核、复盘。专业角度下,核心是**结构化、可复现、可观测、可合规**。 ## 一、漫剧生产流水线 1. 选题:高频情绪、强冲突、明确受众。 1. 剧本:三幕结构,前 3 秒抓人,每 15 秒一个小转折。 1. 分镜:场景、景别、运镜、动作、对白、时长。 1. 角色卡:外形、服装、配色、比例、禁止项。 1. 视觉生成:文生图、图生视频、动态漫。 1. 音频:TTS、音效、BGM。 1. 合成:ffmpeg 拼接、字幕、转场。 1. 审核:版权、敏感内容、AI 标注。 1. 复盘:完播率、互动率、转化点。 ## 二、用 Pydantic 定义分镜 让 LLM 输出可校验 JSON,避免自由文本难以编排。 ``` import os, json from openai import OpenAI from pydantic import BaseModel, Field client = OpenAI( api_key=os.getenv("OPENAI_API_KEY"), base_url=os.getenv("OPENAI_BASE_URL"), ) class Shot(BaseModel): shot_id: int scene: str camera: str = Field(description="景别与运镜,如中景推近") action: str dialogue: str = "" duration: float = Field(ge=1, le=8) class Episode(BaseModel): title: str characters: list[str] shots: list[Shot] def generate_episode(theme: str) -> Episode: prompt = f""" 你是漫剧分镜师。根据主题生成 6 个镜头,每镜 3-5 秒。 主题:{theme} 要求:原创角色,无侵权元素,无真实品牌,无违法内容。 只输出 JSON,字段符合 Episode 模型。 """ resp = client.chat.completions.create( model=os.getenv("OPENAI_MODEL", "gpt-4o-mini"), messages=[{"role": "user", "content": prompt}], response_format={"type": "json_object"}, temperature=0.7, ) return Episode.model_validate(json.loads(resp.choices[0].message.content)) ep = generate_episode("原创小猫在雨夜寻找回家的路") print(ep.model_dump_json(indent=2)) ``` 关键点:角色名、场景名、风格词固定;单镜头只写一个动作;时长 3—5 秒,便于图生视频。 ## 三、角色一致性 每个角色建立角色卡: ``` 角色名:小灰 外形:原创灰色小猫,绿色眼睛,红色围巾,二头身 风格:扁平卡通,粗描边,低饱和,贴纸感 禁止:文字、Logo、真实动物照片、复杂背景 ``` 生成时固定 seed、模型、采样器,并使用参考图或 IP-Adapter。角色复杂可训练 LoRA。每次只改表情和动作,不改角色描述。 ## 四、动态化与合成 将分镜图作为首帧,调用视频生成 API 生成 3—5 秒片段。伪代码: ``` def gen_video(image_path: str, motion_prompt: str) -> str: # 实际调用即梦、可灵、Runway 等官方 API # 参数:首帧图、运动描述、时长、比例、种子 return "outputs/shot_01.mp4" ``` 拼接所有片段: ``` # list.txt 内容:file 'outputs/shot_01.mp4' ffmpeg -f concat -safe 0 -i list.txt -c copy rough_cut.mp4 ``` 添加字幕: ``` ffmpeg -i rough_cut.mp4 -vf "subtitles=subtitle.srt" final.mp4 ``` ## 五、工程化要点 1. 任务队列:每个镜头一个任务,支持重试、超时、取消。 1. 成本控制:低分辨率预览,定稿后高清生成。 1. 可观测:记录 trace_id、模型、耗时、token、视频时长。 1. 审核:敏感词、版权、肖像权、AI 标注。 1. 合规:只使用原创或授权素材;不生成违法、暴力、色情、歧视内容;不冒充真人;不绕过平台审核。 ## 六、总结 漫剧的专业流程是:结构化剧本 → 分镜 JSON → 角色卡 → 图生视频 → TTS/字幕 → ffmpeg 合成 → 审核发布。代码可以简单,但数据校验、角色一致性、任务编排和合规审查不能省。先跑通 15 秒短片,再扩展到系列化生产。不要承诺爆款,不要侵权,不要刷量,把内容质量和合规放在第一位。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册