首页 文章 精选 留言 我的

精选列表

搜索[单机],共5459篇文章
优秀的个人博客,低调大师

突破极限:高负载场景下的单机 300M 多行正则日志采集不是梦

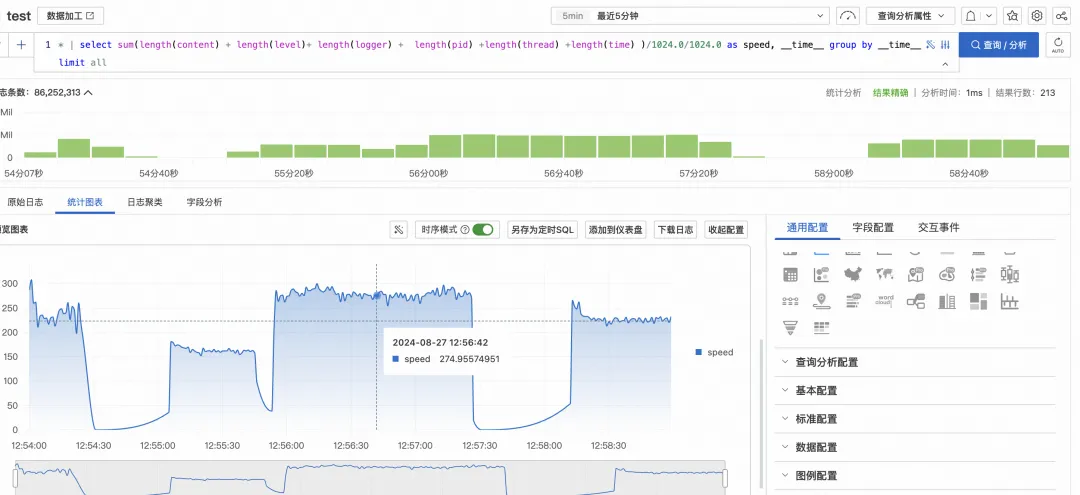
作者:裘文成(翊韬) 问题背景 在当今数字化时代,日志数据已成为企业 IT 运营和业务分析的关键资源。然而,随着业务规模的扩大和系统复杂度的提升,日志数据的体量呈现爆发式增长,给日志采集和处理系统带来了巨大挑战。最近,我们遇到了一个典型案例,充分体现了当前日志服务采集在高负载场景下面临的困境,以下为客户现状: 海量日志与正则采集:客户的某项业务产生了数量巨大的多行日志,并且需要通过正则表达式进行日志解析。这种复杂的采集模式本身就对系统资源提出了较高要求。 关键业务影响:这些日志数据和客户的核心业务分析任务直接相关。过高的采集延迟会影响数据分析的准确性。 采集性能瓶颈:客户根据 iLogtail 启动参数配置文档【1】对 iLogtail 的线程数等进行了调整,在压测时采集速度依然只有 90M/s,但实际压测时的日志生成速度在 200M/s,远超采集速度。这导致了日志采集出现近 1 小时的延迟。 业务需求升级:客户计划进一步增加压测量,预计写入流量将达到 300MB/s。这将进一步加剧采集延迟问题。 业务负载高:客户的业务已经占据了大部分的 CPU 资源,比较困难继续为 iLogtail 提供更多的资源。 技术难点 在收到客户反馈后,我们立即着手分析问题并制定优化策略。通过获取客户的测试日志样本并进行深入测试,我们发现了以下关键技术难点: 性能瓶颈 挑战: 即使在优化的测试环境中,我们也无法达到客户期望的 300MB/s 处理速度。 数据: 采用 16 线程并行处理,最高吞吐量仅为约 270MB/s。 影响: 无法满足客户的性能需求,可能导致日志处理延迟和数据分析滞后。 资源消耗与业务冲突 挑战: 为接近目标性能,iLogtail 需要占用大量系统资源。 数据: 需要 16 个线程才能达到 270MB/s 的处理速度。 影响: 高强度的资源占用严重影响服务器上的其他业务进程,可能导致整体系统性能下降。 线程扩展效益递减 挑战: 简单增加处理线程数量并不能线性提升性能,达到一定线程数后,性能增益呈现边际递减趋势。 影响: 表明仅依靠增加硬件资源难以实现质的突破,需要从算法层面进行优化。 优化过程与成果 怕看官们等不及,在深入技术细节之前,让我们先一睹为快,直观呈现这次优化的成果: 性能质的飞跃:成功将采集速率提升至超过 300MB/s,完全满足客户需求。 资源利用大幅优化:在保持高性能的同时,将所需线程数从16减少到8,显著降低了 CPU 占用。 创新解决方案:针对资源受限的场景,我们推出了 IngestProcessor 方案。使用这种方案,iLogtail 仅需 1 个线程就能实现 320MB/s 的采集速度,为客户提供了极致的资源效率选择。 本文分析和测试,皆在以下硬件环境进行测试 硬件环境 计算资源:阿里云 ECS 实例(规格:ecs.c5.8xlarge) 存储资源:PL3 规格的 ESSD 云盘 为避免磁盘 I/O 出现瓶颈,在高日志量的输出和采集场景,我们推荐使用 PL3 规格的 ESSD 云盘。本文将基于该规格的 ESSD 云盘进行性能分析,详情可参考 ESSD 云盘官方文档【2】 多行日志采集性能提升 初步观察 为深入了解性能瓶颈,我们首先将注意力放在多行日志的处理性能上。 客户的日志主要是多行格式。 多行日志采集步骤在日志正则处理之前,可能对整体性能产生重大影响。 在深入研究多行日志采集性能时,我们观察到了一个令人震惊的现象。尽管预期多行日志处理会对性能产生一定影响,但实际测试结果却远远超出了我们的初步估计。在统一的单线程环境下,我们记录到以下数据: 单行日志采集速度:425MB/s 多行日志采集速度:98MB/s 这近乎 80% 的性能下降不仅令人惊讶,更引发了我们对多行采集算法实现的深度思考: 性能差距:从 425MB/s 骤降至 98MB/s,这种程度的性能退化远远超出了我们对多行处理的初始预期。 异常性:如此巨大的差异明显超出了正常的多行处理开销,显然存在一个重大的性能瓶颈。 算法效率质疑:这一现象使我们不得不重新审视当前多行采集算法的实现效率。可能存在某些未优化的操作或不必要的重复计算。 iLogtail 多行日志处理原理 iLogtail 的多行日志合并功能基于特定的日志格式将分散的多行数据聚合为完整事件。其工作流程如下: 用户配置行首正则表达式。 iLogtail 对每行日志开头应用此正则。 若某行不匹配,iLogtail 继续等待直至找到匹配的行首。 举个例子,假设我们有如下的日志格式,通常我们会配置行首正则为 \d+-\d+-\d+\s\d+:\d+:\d+.\d+\s.*,iLogtail 会拿着这个正则对每行进行匹配,将这些单行日志合并成一个完整的多行日志。 2024-03-15 14:23:45.678 ERROR 987654 --- [TaskExecutor-1] c.e.d.s.TaskScheduler : Failed to process task due to unexpected exception java.lang.NullPointerException: Cannot invoke "com.example.data.model.Task.getPriority()" because "task" is null at com.example.data.processor.TaskProcessor.processTask(TaskProcessor.java:123) at com.example.data.scheduler.TaskScheduler.lambda$scheduleTask$1(TaskScheduler.java:89) at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149) at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624) at java.lang.Thread.run(Thread.java:748) Caused by: java.lang.IllegalArgumentException: Task ID cannot be null or empty at com.example.data.validator.TaskValidator.validateTask(TaskValidator.java:45) at com.example.data.processor.TaskProcessor.processTask(TaskProcessor.java:115) ... 4 common frames omitted 性能瓶颈分析 深入 iLogtail 的实现机制,我们发现性能瓶颈的关键在于其正则匹配方法。 iLogtail 使用 boost::regex_match 函数进行全量匹配,这在处理大规模日志时会产生显著的性能开销。 bool BoostRegexMatch(const char* buffer, size_t size, const boost::regex& reg, string& exception) { // ... if (boost::regex_match(buffer, buffer + size, reg)) return true; // ... } 对于之前提到的日志示例,正则表达式会对第一行的全部 253 个字符进行匹配,这在处理大量日志时会导致性能下降。 为了量化这一性能问题,我编写了测试代码进行实验,目的是观察随着与行首正则无关的日志长度增加(即 .* 匹配的部分),boost::regex_match 的执行时间如何变化。 static void BM_Regex_Match(int batchSize) { std::string buffer = "2024-07-19 15:02:16.055 INFO "; std::string regStr = "\\d+-\\d+-\\d+\\s\\d+:\\d+:\\d+\\.\\d+\\s.*"; boost::regex reg(regStr); std::ofstream outFile("BM_Regex_Match.txt", std::ios::trunc); outFile.close(); for (int i = 0; i < 1000; i++) { std::ofstream outFile("BM_Regex_Match.txt", std::ios::app); buffer += "a"; int count = 0; uint64_t durationTime = 0; for (int j = 0; j < batchSize; j++) { count++; uint64_t startTime = GetCurrentTimeInMicroSeconds(); if (!boost::regex_match(buffer, reg)) { std::cout << "error" << std::endl; } durationTime += GetCurrentTimeInMicroSeconds() - startTime; } outFile << i << '\t' << "durationTime: " << durationTime << std::endl; outFile << i << '\t' << "process: " << formatSize(buffer.size() * (uint64_t)count * 1000000 / durationTime) << "/s" << std::endl; outFile.close(); } } int main(int argc, char** argv) { logtail::Logger::Instance().InitGlobalLoggers(); std::cout << "BM_Regex_Match" << std::endl; BM_Regex_Match(10000); return 0; } 通过这个实验,可以观察到一个关键现象: 随着与行首正则无关的日志长度增加(即 .* 匹配的那部分日志),boost::regex_match 的执行时间也呈线性增长。 基于实验结果,我们可以得出以下结论: 全量匹配的低效性:boost::regex_match 对整行进行匹配,即使只有行首部分是关键的。 资源浪费:匹配时间与日志行长度呈线性关系,大部分匹配时间花在了与实际分割逻辑无关的内容上(.* 匹配的部分),这在处理大量长行日志时会导致严重的性能下降。 性能优化 基于性能瓶颈分析,我们确定了关键的优化方向:实现部分匹配。这种方法只对日志行首进行匹配,而不是整行,有望显著提高处理效率。 为了避免重复造轮子,在调研后,我们发现 Boost 库提供了一个替代方案:boost::regex_search 函数,通过适当配置,这个函数能够精确满足我们的需求。以下是优化后的代码实现: bool BoostRegexSearch(const char* buffer, size_t size, const boost::regex& reg, string& exception) { // ... if (boost::regex_search(buffer, buffer + size, what, reg, boost::match_continuous)) { return true; } // ... } 关键改进点: 使用 boost::regex_search 替代 boost::regex_match。 添加 boost::match_continuous 标志,确保只匹配前缀,如果字符串的开头子串满足正则表达式,就会返回成功。 这种实现方式允许我们精确控制匹配过程,只关注日志行首,这正是多行日志处理所需要的。 为了量化这一优化的效果,和 boost::regex_match 一样,我也对 boost::regex_search 根据日志长度进行了测试。可以发现,新方案的执行时间基本保持稳定,不受日志长度影响。 优化后的多行算法,实际采集效果 我们对使用优化后多行算法的 iLogtail,进行了多行日志采集,以下是测试的详细结果: 多行采集性能飞跃 优化后的多行采集速度从 98MB/s 提升到 350MB/s 性能提升幅度:257%(约 3.57 倍) 接近单行采集性能 优化后的多行采集速度(350MB/s)已接近单行采集(425MB/s) 相对于单行采集的性能比:82.35% 资源利用效率 在保持单线程的情况下实现显著性能提升 体现了算法优化在提高资源利用效率方面的巨大潜力 用户体验优化 在 iLogtail 的已有实现中,用户配置的行首正则表达式通常包含 .*后缀。这是由于之前的匹配机制会匹配整行内容,为了让客户不改动采集配置,只需要升级 iLogtail 版本 2.1 及以上,就能享受到该多行采集性能优化,我们设计了一个以下兼容性策略: 正则表达式解析: 在处理用户配置时,iLogtail 会自动分析正则表达式。 如果检测.*后缀的存在,iLogtail 动态调整正则表达式,移除.*后缀。 正则匹配双方案 改进多行日志性能后的多行正则匹配采集 在优化多行日志采集性能后,我们进一步探讨了将改进后的多行采集与正则提取相结合的效果。下面详细分析了这种组合方案的性能表现及其实际应用价值。在 8 线程下, iLogtail 的多行日志采集性能已经可以到 370MB/s,已经足够满足客户的采集速度需求。 采集速率提升 优化后的采集速率从 270MB/s 提升到 370MB/s 性能提升幅度:37% 资源利用优化 线程数从 16 减少到 8,减少了 50% 在减少一半 CPU 资源的同时,仍然实现了显著的性能提升 正则提取的限制 由于正则提取需要对日志进行全量匹配,多行采集的部分优化手段在此无法应用 本地资源紧张 - 快速迁移 IngestProcessor 尽管我们成功地在 8 线程下实现了 iLogtail 对多行日志的采集和正则提取,但这种方法仍然面临着一些挑战: 高资源需求:需要占用 8 个 CPU 核心,对机器资源造成显著压力。 客户端限制:并非所有客户都有能力或意愿增加机器资源。 可扩展性问题:随着业务压力增加,客户端资源可能成为瓶颈。 为了应对这些挑战,阿里云日志服务推出了一个创新的解决方案:写入处理器(IngestProcessor)。这种方法不仅有效解决了资源限制问题,还大幅提高了处理效率。 工作原理 数据流:通过 iLogtail 采集的日志数据首先经过 IngestProcessor。 处理位置:数据处理过程在日志服务中完成,而非客户端。 资源优化:这种方法显著减少了客户端资源占用,释放计算能力。 注意事项 IngestProcessor不支持日志聚合(将多个日志合并为一个)。 该功能需要额外计费。详细信息请参考阿里云官方文档:https://help.aliyun.com/zh/sls/user-guide/overview-of-sls-data-processing。 IngestProcessor 不仅可以解决资源限制问题,还提供了丰富的数据处理能力: 字段提取:从原始日志字段中通过正则表达式、Key-Value 格式、JSON 等解析方式提取出新的字段。 扩展字段:为原始日志添加新的字段。 丢弃字段:删除原始日志的部分字段。 数据脱敏:将原始日志的敏感信息进行脱敏处理。 数据过滤:丢弃原始日志的部分数据。 由于 IngestProcessor 使用的 SPL 语法和 iLogtail 使用的 SPL 语法一致,因此我们可以直接把 iLogtail 使用的 SPL 语句复制到 IngestProcessor 上,实现快速迁移。 我们在 10 个 shard 的环境下进行了详细的性能测试。以下是使用的 SPL 语句和测试结果: 资源利用效率: IngestProcessor 方案将客户端 CPU 占用从 16 核心降至 1 核心 ,减少了 93.75% 。 同时保持了 320MB/s 的高采集速率,与不解析正则时的多行采集极限速率接近。 性能平衡: 虽然采集速率略有下降,但资源占用的大幅减少使得整体效率显著提升。 对于资源受限的环境,这种轻微的速度降低是完全可以接受的。 可扩展性: 通过将处理负载转移到云端,客户端获得了更大的扩展空间。 这种方案为处理更大规模的日志数据提供了可能性。 实际应用价值 成本效益:客户可以通过评估硬件资源成本和 IngestProcessor 使用成本,灵活选择适合自己的方案,降低了总体拥有成本。 灵活部署:使客户能在资源受限的环境中部署高级日志处理功能。 快速迁移:与 iLogtail 使用相同的 SPL 语法,便于现有用户快速采用新方案。 结论 通过这次全面的性能测试和优化,我们可以得出以下结论: 高效性:优化后的 iLogtail 能够在 8 线程下稳定地处理 300MB/s 的多行日志数据并进行正则提取,展现了卓越的性能。 灵活的计算迁移方案:在传统的基于 iLogtail 进行日志采集和处理的方案外,结合 iLogtail 的高效采集和 IngestProcessor 的强大处理能力,我们实现了一个既高效又灵活的日志处理方案,能够在 1 线程下稳定地处理 300MB/s 的多行日志数据并进行正则提取。这种组合能够满足各种复杂的日志处理需求,而不会对客户端性能造成额外负担。 注意事项:正则提取的性能还受到正则表达式本身复杂度的影响。如果正则表达式设计得过于复杂,或者包含大量的回溯操作,可能会导致匹配效率显著下降,尤其是在处理大规模数据时。因此,在编写正则表达式时,应尽量优化其结构,避免不必要的嵌套和冗余匹配。 相关链接: 【1】iLogtail 启动参数配置文档: https://help.aliyun.com/zh/sls/user-guide/configure-the-startup-parameters-of-logtail 【2】ESSD 云盘官方文档: https://help.aliyun.com/zh/ecs/user-guide/essds

优秀的个人博客,低调大师

突破极限: 高负载场景下的单机300M多行正则日志采集不是梦

作者:裘文成(翊韬) 问题背景 在当今数字化时代,日志数据已成为企业 IT 运营和业务分析的关键资源。然而,随着业务规模的扩大和系统复杂度的提升,日志数据的体量呈现爆发式增长,给日志采集和处理系统带来了巨大挑战。最近,我们遇到了一个典型案例,充分体现了当前日志服务采集在高负载场景下面临的困境,以下为客户现状: 海量日志与正则采集:客户的某项业务产生了数量巨大的多行日志,并且需要通过正则表达式进行日志解析。这种复杂的采集模式本身就对系统资源提出了较高要求。 关键业务影响:这些日志数据和客户的核心业务分析任务直接相关。过高的采集延迟会影响数据分析的准确性。 采集性能瓶颈:客户根据 iLogtail 启动参数配置文档【1】对 iLogtail 的线程数等进行了调整,在压测时采集速度依然只有 90M/s,但实际压测时的日志生成速度在 200M/s,远超采集速度。这导致了日志采集出现近 1 小时的延迟。 业务需求升级:客户计划进一步增加压测量,预计写入流量将达到 300MB/s。这将进一步加剧采集延迟问题。 业务负载高:客户的业务已经占据了大部分的 CPU 资源,比较困难继续为 iLogtail 提供更多的资源。 技术难点 在收到客户反馈后,我们立即着手分析问题并制定优化策略。通过获取客户的测试日志样本并进行深入测试,我们发现了以下关键技术难点: 性能瓶颈 挑战: 即使在优化的测试环境中,我们也无法达到客户期望的 300MB/s 处理速度。 数据: 采用 16 线程并行处理,最高吞吐量仅为约 270MB/s。 影响: 无法满足客户的性能需求,可能导致日志处理延迟和数据分析滞后。 资源消耗与业务冲突 挑战: 为接近目标性能,iLogtail 需要占用大量系统资源。 数据: 需要 16 个线程才能达到 270MB/s 的处理速度。 影响: 高强度的资源占用严重影响服务器上的其他业务进程,可能导致整体系统性能下降。 线程扩展效益递减 挑战: 简单增加处理线程数量并不能线性提升性能,达到一定线程数后,性能增益呈现边际递减趋势。 影响: 表明仅依靠增加硬件资源难以实现质的突破,需要从算法层面进行优化。 优化过程与成果 怕看官们等不及,在深入技术细节之前,让我们先一睹为快,直观呈现这次优化的成果: 性能质的飞跃:成功将采集速率提升至超过 300MB/s,完全满足客户需求。 资源利用大幅优化:在保持高性能的同时,将所需线程数从16减少到8,显著降低了 CPU 占用。 创新解决方案:针对资源受限的场景,我们推出了 IngestProcessor 方案。使用这种方案,iLogtail 仅需 1 个线程就能实现 320MB/s 的采集速度,为客户提供了极致的资源效率选择。 本文分析和测试,皆在以下硬件环境进行测试 硬件环境 计算资源:阿里云 ECS 实例(规格:ecs.c5.8xlarge) 存储资源:PL3 规格的 ESSD 云盘 为避免磁盘 I/O 出现瓶颈,在高日志量的输出和采集场景,我们推荐使用 PL3 规格的 ESSD 云盘。本文将基于该规格的 ESSD 云盘进行性能分析,详情可参考 ESSD 云盘官方文档【2】 多行日志采集性能提升 初步观察 为深入了解性能瓶颈,我们首先将注意力放在多行日志的处理性能上。 客户的日志主要是多行格式。 多行日志采集步骤在日志正则处理之前,可能对整体性能产生重大影响。 在深入研究多行日志采集性能时,我们观察到了一个令人震惊的现象。尽管预期多行日志处理会对性能产生一定影响,但实际测试结果却远远超出了我们的初步估计。在统一的单线程环境下,我们记录到以下数据: 单行日志采集速度:425MB/s 多行日志采集速度:98MB/s 这近乎 80% 的性能下降不仅令人惊讶,更引发了我们对多行采集算法实现的深度思考: 性能差距:从 425MB/s 骤降至 98MB/s,这种程度的性能退化远远超出了我们对多行处理的初始预期。 异常性:如此巨大的差异明显超出了正常的多行处理开销,显然存在一个重大的性能瓶颈。 算法效率质疑:这一现象使我们不得不重新审视当前多行采集算法的实现效率。可能存在某些未优化的操作或不必要的重复计算。 iLogtail 多行日志处理原理 iLogtail 的多行日志合并功能基于特定的日志格式将分散的多行数据聚合为完整事件。其工作流程如下: 用户配置行首正则表达式。 iLogtail 对每行日志开头应用此正则。 若某行不匹配,iLogtail 继续等待直至找到匹配的行首。 举个例子,假设我们有如下的日志格式,通常我们会配置行首正则为 \d+-\d+-\d+\s\d+:\d+:\d+.\d+\s.*,iLogtail 会拿着这个正则对每行进行匹配,将这些单行日志合并成一个完整的多行日志。 2024-03-15 14:23:45.678 ERROR 987654 --- [TaskExecutor-1] c.e.d.s.TaskScheduler : Failed to process task due to unexpected exception java.lang.NullPointerException: Cannot invoke "com.example.data.model.Task.getPriority()" because "task" is null at com.example.data.processor.TaskProcessor.processTask(TaskProcessor.java:123) at com.example.data.scheduler.TaskScheduler.lambda$scheduleTask$1(TaskScheduler.java:89) at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149) at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624) at java.lang.Thread.run(Thread.java:748) Caused by: java.lang.IllegalArgumentException: Task ID cannot be null or empty at com.example.data.validator.TaskValidator.validateTask(TaskValidator.java:45) at com.example.data.processor.TaskProcessor.processTask(TaskProcessor.java:115) ... 4 common frames omitted 性能瓶颈分析 深入 iLogtail 的实现机制,我们发现性能瓶颈的关键在于其正则匹配方法。 iLogtail 使用 boost::regex_match 函数进行全量匹配,这在处理大规模日志时会产生显著的性能开销。 bool BoostRegexMatch(const char* buffer, size_t size, const boost::regex& reg, string& exception) { // ... if (boost::regex_match(buffer, buffer + size, reg)) return true; // ... } 对于之前提到的日志示例,正则表达式会对第一行的全部 253 个字符进行匹配,这在处理大量日志时会导致性能下降。 为了量化这一性能问题,我编写了测试代码进行实验,目的是观察随着与行首正则无关的日志长度增加(即 .* 匹配的部分),boost::regex_match 的执行时间如何变化。 static void BM_Regex_Match(int batchSize) { std::string buffer = "2024-07-19 15:02:16.055 INFO "; std::string regStr = "\\d+-\\d+-\\d+\\s\\d+:\\d+:\\d+\\.\\d+\\s.*"; boost::regex reg(regStr); std::ofstream outFile("BM_Regex_Match.txt", std::ios::trunc); outFile.close(); for (int i = 0; i < 1000; i++) { std::ofstream outFile("BM_Regex_Match.txt", std::ios::app); buffer += "a"; int count = 0; uint64_t durationTime = 0; for (int j = 0; j < batchSize; j++) { count++; uint64_t startTime = GetCurrentTimeInMicroSeconds(); if (!boost::regex_match(buffer, reg)) { std::cout << "error" << std::endl; } durationTime += GetCurrentTimeInMicroSeconds() - startTime; } outFile << i << '\t' << "durationTime: " << durationTime << std::endl; outFile << i << '\t' << "process: " << formatSize(buffer.size() * (uint64_t)count * 1000000 / durationTime) << "/s" << std::endl; outFile.close(); } } int main(int argc, char** argv) { logtail::Logger::Instance().InitGlobalLoggers(); std::cout << "BM_Regex_Match" << std::endl; BM_Regex_Match(10000); return 0; } 通过这个实验,可以观察到一个关键现象: 随着与行首正则无关的日志长度增加(即 .* 匹配的那部分日志),boost::regex_match 的执行时间也呈线性增长。 基于实验结果,我们可以得出以下结论: 全量匹配的低效性:boost::regex_match 对整行进行匹配,即使只有行首部分是关键的。 资源浪费:匹配时间与日志行长度呈线性关系,大部分匹配时间花在了与实际分割逻辑无关的内容上(.* 匹配的部分),这在处理大量长行日志时会导致严重的性能下降。 性能优化 基于性能瓶颈分析,我们确定了关键的优化方向:实现部分匹配。这种方法只对日志行首进行匹配,而不是整行,有望显著提高处理效率。 为了避免重复造轮子,在调研后,我们发现 Boost 库提供了一个替代方案:boost::regex_search 函数,通过适当配置,这个函数能够精确满足我们的需求。以下是优化后的代码实现: bool BoostRegexSearch(const char* buffer, size_t size, const boost::regex& reg, string& exception) { // ... if (boost::regex_search(buffer, buffer + size, what, reg, boost::match_continuous)) { return true; } // ... } 关键改进点: 使用 boost::regex_search 替代 boost::regex_match。 添加 boost::match_continuous 标志,确保只匹配前缀,如果字符串的开头子串满足正则表达式,就会返回成功。 这种实现方式允许我们精确控制匹配过程,只关注日志行首,这正是多行日志处理所需要的。 为了量化这一优化的效果,和 boost::regex_match 一样,我也对 boost::regex_search 根据日志长度进行了测试。可以发现,新方案的执行时间基本保持稳定,不受日志长度影响。 优化后的多行算法,实际采集效果 我们对使用优化后多行算法的 iLogtail,进行了多行日志采集,以下是测试的详细结果: 多行采集性能飞跃 优化后的多行采集速度从 98MB/s 提升到 350MB/s 性能提升幅度:257%(约 3.57 倍) 接近单行采集性能 优化后的多行采集速度(350MB/s)已接近单行采集(425MB/s) 相对于单行采集的性能比:82.35% 资源利用效率 在保持单线程的情况下实现显著性能提升 体现了算法优化在提高资源利用效率方面的巨大潜力 用户体验优化 在 iLogtail 的已有实现中,用户配置的行首正则表达式通常包含 .*后缀。这是由于之前的匹配机制会匹配整行内容,为了让客户不改动采集配置,只需要升级 iLogtail 版本 2.1 及以上,就能享受到该多行采集性能优化,我们设计了一个以下兼容性策略: 正则表达式解析: 在处理用户配置时,iLogtail 会自动分析正则表达式。 如果检测.*后缀的存在,iLogtail 动态调整正则表达式,移除.*后缀。 正则匹配双方案 改进多行日志性能后的多行正则匹配采集 在优化多行日志采集性能后,我们进一步探讨了将改进后的多行采集与正则提取相结合的效果。下面详细分析了这种组合方案的性能表现及其实际应用价值。在 8 线程下, iLogtail 的多行日志采集性能已经可以到 370MB/s,已经足够满足客户的采集速度需求。 采集速率提升 优化后的采集速率从 270MB/s 提升到 370MB/s 性能提升幅度:37% 资源利用优化 线程数从 16 减少到 8,减少了 50% 在减少一半 CPU 资源的同时,仍然实现了显著的性能提升 正则提取的限制 由于正则提取需要对日志进行全量匹配,多行采集的部分优化手段在此无法应用 本地资源紧张 - 快速迁移 IngestProcessor 尽管我们成功地在 8 线程下实现了 iLogtail 对多行日志的采集和正则提取,但这种方法仍然面临着一些挑战: 高资源需求:需要占用 8 个 CPU 核心,对机器资源造成显著压力。 客户端限制:并非所有客户都有能力或意愿增加机器资源。 可扩展性问题:随着业务压力增加,客户端资源可能成为瓶颈。 为了应对这些挑战,阿里云日志服务推出了一个创新的解决方案:写入处理器(IngestProcessor)。这种方法不仅有效解决了资源限制问题,还大幅提高了处理效率。 工作原理 数据流:通过 iLogtail 采集的日志数据首先经过 IngestProcessor。 处理位置:数据处理过程在日志服务中完成,而非客户端。 资源优化:这种方法显著减少了客户端资源占用,释放计算能力。 注意事项 IngestProcessor不支持日志聚合(将多个日志合并为一个)。 该功能需要额外计费。详细信息请参考阿里云官方文档:https://help.aliyun.com/zh/sls/user-guide/overview-of-sls-data-processing。 IngestProcessor 不仅可以解决资源限制问题,还提供了丰富的数据处理能力: 字段提取:从原始日志字段中通过正则表达式、Key-Value 格式、JSON 等解析方式提取出新的字段。 扩展字段:为原始日志添加新的字段。 丢弃字段:删除原始日志的部分字段。 数据脱敏:将原始日志的敏感信息进行脱敏处理。 数据过滤:丢弃原始日志的部分数据。 由于 IngestProcessor 使用的 SPL 语法和 iLogtail 使用的 SPL 语法一致,因此我们可以直接把 iLogtail 使用的 SPL 语句复制到 IngestProcessor 上,实现快速迁移。 我们在 10 个 shard 的环境下进行了详细的性能测试。以下是使用的 SPL 语句和测试结果: 资源利用效率: IngestProcessor 方案将客户端 CPU 占用从 16 核心降至 1 核心 ,减少了 93.75% 。 同时保持了 320MB/s 的高采集速率,与不解析正则时的多行采集极限速率接近。 性能平衡: 虽然采集速率略有下降,但资源占用的大幅减少使得整体效率显著提升。 对于资源受限的环境,这种轻微的速度降低是完全可以接受的。 可扩展性: 通过将处理负载转移到云端,客户端获得了更大的扩展空间。 这种方案为处理更大规模的日志数据提供了可能性。 实际应用价值 成本效益:客户可以通过评估硬件资源成本和 IngestProcessor 使用成本,灵活选择适合自己的方案,降低了总体拥有成本。 灵活部署:使客户能在资源受限的环境中部署高级日志处理功能。 快速迁移:与 iLogtail 使用相同的 SPL 语法,便于现有用户快速采用新方案。 结论 通过这次全面的性能测试和优化,我们可以得出以下结论: 高效性:优化后的 iLogtail 能够在 8 线程下稳定地处理 300MB/s 的多行日志数据并进行正则提取,展现了卓越的性能。 灵活的计算迁移方案:在传统的基于 iLogtail 进行日志采集和处理的方案外,结合 iLogtail 的高效采集和 IngestProcessor 的强大处理能力,我们实现了一个既高效又灵活的日志处理方案,能够在 1 线程下稳定地处理 300MB/s 的多行日志数据并进行正则提取。这种组合能够满足各种复杂的日志处理需求,而不会对客户端性能造成额外负担。 注意事项:正则提取的性能还受到正则表达式本身复杂度的影响。如果正则表达式设计得过于复杂,或者包含大量的回溯操作,可能会导致匹配效率显著下降,尤其是在处理大规模数据时。因此,在编写正则表达式时,应尽量优化其结构,避免不必要的嵌套和冗余匹配。 相关链接: 【1】iLogtail 启动参数配置文档: https://help.aliyun.com/zh/sls/user-guide/configure-the-startup-parameters-of-logtail 【2】ESSD 云盘官方文档: https://help.aliyun.com/zh/ecs/user-guide/essds
优秀的个人博客,低调大师

单机服务器如何充分利用服务器性能,达到最大并发量?

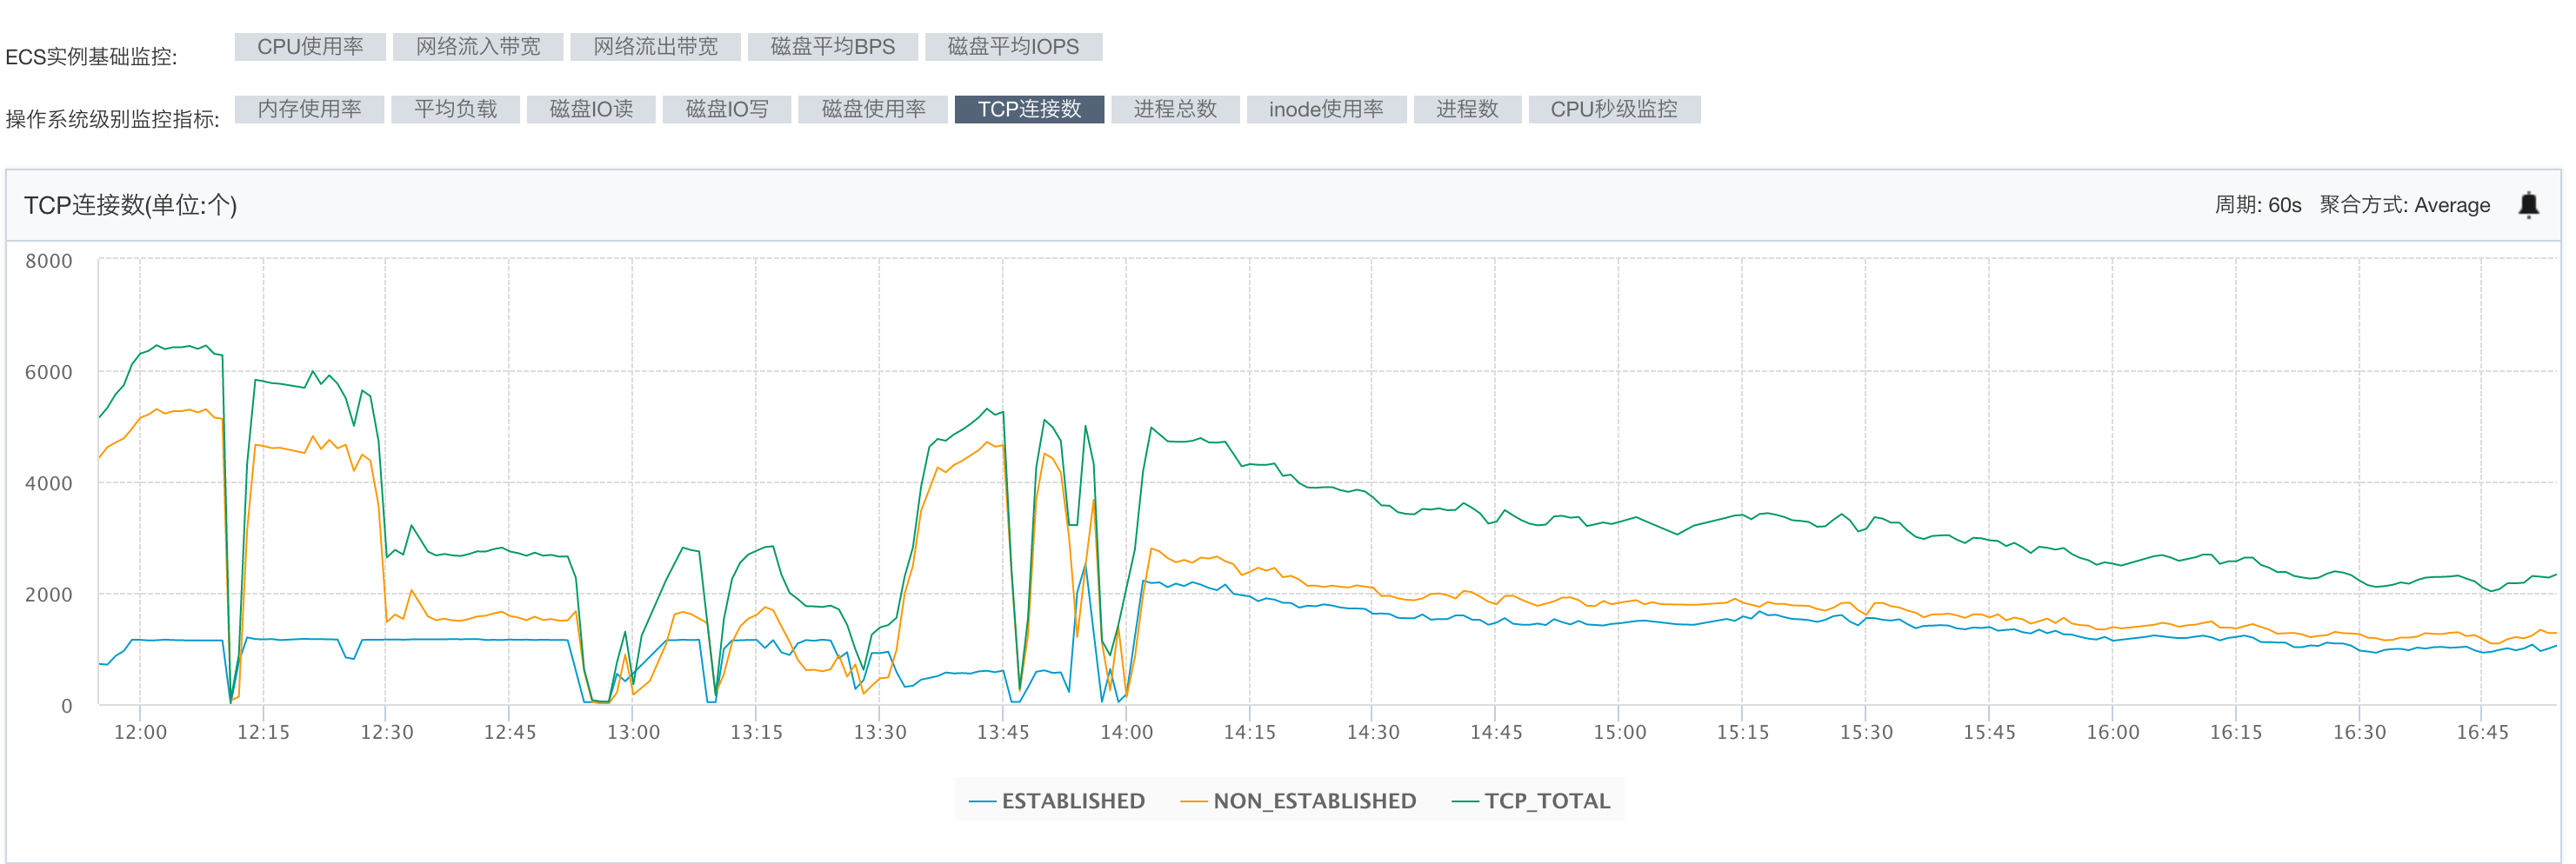
23号当天12点一瞬间有大量的用户涌进来,具体多少人不好说,我看TCP链接是6千左右。 我的服务器配置如下: 数据库是使用阿里云的PolarDB,8核32GB,有读写分离,最大IOPS是64000,我查看过数据库相关压力,数据库几乎没有波动,排除是数据库原因造成的,我们的业务相对简单,且大部分查询是单表查询,数据量很小。 服务器是使用阿里云的ECS,8核16G,CPU占用最高不到百分之二十,基本都在百分之五左右,内存占用也没有什么波动,CPU和内存没有充分得到利用。 我是使用的spring boot 部署,容器是tomcat,配置如下: server.tomcat.accept-count=500 server.tomcat.max-connections=30000 server.tomcat.max-threads=2000 server.servlet.session.timeout=3600s server.max-http-header-size=1024000 我启动的时候给JVM分配了内存,命令如下: nohup java -server -Xms10240m -Xmx10240m -jar xxx.jar & 另外我使用的是nginx代理到tomcat的,当天高峰期服务瘫痪的时候,nginx部署的另外一个静态页也同时不能访问,所以我怀疑是nginx或tomcat在哪一个环节出现了问题。 以下是当天12点-16点的一些服务器监控截图: 所以我想请教一下大家,这是哪个环节的问题造成了瓶颈,有哪些优化方案?

优秀的个人博客,低调大师

联机为什么比单机麻烦:这一局里「世界」跑在哪台机器上

![](https://developer.qcloudimg.com/http-save/yehe-11953936/ed3d325b71d8611cee1b5319b1c8ee25.png) 用 PCL2-我的世界启动器 联机时,会遇到几类看起来很随机的问题: - 开房的人退了,房间就散了 - 开房的人卡,所有人一起卡 - 我能进别人的房间,别人进不来我的 - 装了模组之后就连不上了 这几件事看起来互不相干。但它们其实来自同一个问题:这一局里,"世界"到底跑在哪台机器上。 ## 一、两种联机方式的真正区别:谁在算 先说清楚"联机"其实有两种形态,它们的差异不在"连谁",而在谁承担计算。 第一种:自己开房。 用 PCL2-我的世界启动器 进入游戏后,一方把世界"开放到局域网",其他人连进来。 这种模式下,开房那台机器就是"世界"——它负责模拟整个世界(生物的移动、方块的变化、时间的推进),其他人只是把操作发过去、把画面收回来。 第二种:独立服务器。 有一台机器专门运行服务端,所有人(包括开服的人)都作为客户端连它。 世界在服务器上,不跟着任何玩家走。 这个差别一句话就能概括: > 房间的性质,取决于"世界"这台机器上跑在谁那儿。 ## 二、由此推出四个必然结果 结果一:开房的人退出,房间就没了。 因为"世界"跟着他一起退出了。 这不是软件设计得不好,而是这种模式下世界本来就在他那台机器上。 结果二:开房的人卡,所有人都卡。 因为大家等的是同一台机器算完。 他那边一旦出现停顿,所有人同时感受到——而且这个延迟是没有办法靠"换个更好的网络"解决的,因为瓶颈不在网络上。 结果三:开房的人负担最重。 他要同时做三件事:模拟世界、渲染自己的画面、把结果发给所有人。而其他人只需要"渲染 %2B 收发操作"。 所以"谁开房谁吃亏"是有原因的,不是心理作用。 结果四:独立服务器更稳定,但需要有人维护。 因为世界不跟着玩家走。 谁掉线都不影响房间,代价是要有台机器一直开着,而且配置与内容的一致性要求更高。 ## 三、为什么"只有部分人能进得来" 这一节和上面的不是一回事,但经常被混在一起。 主动连出去(出站)几乎总是通的——你请求外部服务,网络环境通常不拦。 但让别人连进来(入站)需要额外条件:你那台机器要能被外部找到并建立连接。 家庭网络通常是"在路由器后面"的:没有对外的地址,外部无法直接连入。 于是在同一台机器上会出现这种不对称: - 我能进别人的房间 → 说明出站没问题 - 别人进不来我的 → 说明入站条件不满足 这两个结果可以同时成立,而且它们并不矛盾。 所以"能连上别人"这件事,不能用来证明"别人也能连上你"。 具体的处理方向不是在本机反复切换设置,而是解决"可达性":要么让这台机器变得可被访问,要么借助一个双方都能访问的中间节点来转发。 中转方案改变了什么、没改变什么,值得分清: - 改变了:不需要对外地址、不用动路由器,双方都主动连出去即可 - 没改变的:如果走的是"自己开房"模式,世界仍然在那台玩家机器上 → 所以发起人一退,房间照样散 - 代价:数据多绕一跳,路径更长 ## 四、另一条硬要求:内容必须一致 这是"装了模组就连不上"的原因。 联机要求参与方的"内容集合"一致:游戏版本、加载器、装了什么模组,甚至部分配置。 不一致的后果有两种: - 进不去:在校验阶段就被拒绝(这算好的,至少提示明确) - 进去了但行为对不上:某些东西在一边存在、另一边没有,于是表现成"诡异的不同步"——这种比直接报错更难查 所以"我装了模组就连不上"通常不是网络问题,而是参与方不在同一套规则下。 这与"同一个游戏的两套实现不能互通"是同一类要求:联机的前提不是"网络能通",而是"双方按同一套规则计算"。 ## 五、怎么选 按人数和持续性来定: - 两三个人偶尔一起玩 → 开房或中转就够用,但要接受"发起人就是世界,他退了就结束" - 人多、想随时在线、要求稳定 → 独立服务器更合适,代价是要有人维护,且内容一致性的要求更严格(所有人必须对得上服务端的配置) 一句话的判断方法:你能接受"世界跟着某个人的电脑走"吗? 能接受就用开房;不能,就得有台独立的机器。 ## 六、按现象定位 - 开房的人退出,全员掉线(原因方向:世界在那台机器上;处理方向:属预期;要长期在线就用独立服务器) - 开房的人卡,所有人都卡(原因方向:计算集中在他那台机器;处理方向:属预期;换独立服务器或降低模拟负担) - 我能进别人房间,别人进不来(原因方向:入站条件不满足;处理方向:解决可达性,或改用中转) - 局域网内互相看不到(原因方向:设备之间被隔离;处理方向:换网络环境或改用中转) - 装了模组就连不上(原因方向:内容集合不一致;处理方向:对齐版本、加载器与模组清单) - 进去了但行为诡异(原因方向:内容部分不一致;处理方向:同样对齐清单,别只看能不能进) - 中转之后发起人退出仍然散房(原因方向:世界仍在玩家机器上;处理方向:属预期;中转只解决可达性) - 联机后自己机器很吃力(原因方向:同时承担模拟与渲染;处理方向:属预期;或改用独立服务器) ## 七、小结 关于 PCL2-我的世界启动器 的联机,记住四条: - 先问"世界跑在哪台机器上"——这一条决定了房间的稳定性和"谁退出会散房" - "开房"模式下,发起人就是世界:他退出房间结束,他卡大家都卡,他的机器负担最重 - 进出不对称是网络的固有性质:你能连出去,不代表别人能连进来;这一节和"谁在算"是两回事,别混着查 - 内容一致是另一条硬要求:联机的前提是双方按同一套规则计算,不一致时可能连不上,也可能"进去了但不对" 这里可以带走的经验是关于"权威"的:任何多方协作的系统,都必须有明确的"谁说了算"——游戏里的世界模拟是这样,其他场景也一样。 不理解这一点,就会把"架构决定的现象"当成"配置没调好":反复换网络、改设置、重装,而问题从一开始就出在"该由谁承担计算"这个选择上。 https://www.ijinshan.com/software/PCL2.html?channel=4099

优秀的个人博客,低调大师

openGauss单机版从2.1.0经停3.0.0升级至5.0.0

前言 如前文所述,我们的小demo项目起初安装了openGauss的2.1.0版本,由于2.1.0不是长期维护(LTS)版本,所以要升级到5.0.0LTS。考虑到虽然是DEMO项目,但也有些体验用户,所以为了保障业务连续性,决定还是按照升级的方式,而不采取卸载重装的方式。本篇从2.1.0经停3.0.0再到5.0.0版本升级过程的简要总结,供朋友们参考和指导。 升级路径: 官网对于从2.1.0到5.0.0的升级路径是不保证成功的,但是对于2.0.0的升级路径是支持的,可以从2.0.0到3.0.0,也可以从2.0.0直接到5.0.0,当然3.0.0也可以到5.0.0,如下图所示: 参考:https://docs-opengauss.osinfra.cn/zh/docs/5.0.0/docs/DatabaseOMGuide/%E5%8D%87%E7%BA%A7%E5%89%8D%E5%BF%85%E8%AF%BB.html 下面开始升级的操作过程: 1.查看数据库版本和状态信息 gs_om -t status --detail gsql -p 26000 -d postgres -U omm gaussdb –V 2.检查OS gs_checkos -i A (该命令需在root用户下执行,可选执行) 3.检查数据库和表信息 创建了一个demo项目用的数据库,以及用到的表,表里面有部分测试数据。 select count(1) from device; 4.备份数据(商用环境务必执行,内部调测环境建议执行) 因升级如果失败,存在数据库不能启动且不能回退的风险,因此强烈建议备份数据,具体备份策略可根据实际业务情况确定。 5.创建3.0.0版本升级目录,目录命名可自行确定,建议见名知意 偷懒起见,我把5.0.0的升级目录也直接创建了,放在software目录下,可根据个人情况自行制定。 mkdir gaussdb_upgrade3.0.0 6.下载3.0.0版本软件包 进入创建好的3.0.0的目录:通过wget下载3.0.0的软件包,注意查看操作系统及版本,制式正确。 wget:https://opengauss.obs.cn-south-1.myhuaweicloud.com/5.0.0/x86_openEuler/openGauss-3.0.0-openEuler-64bit-all.tar.gz 注意:尽管3.0.5是3.0.x最新的包,但是由于3.0.5版本发布日期比5.0.0更晚,因此不支持3.0.5到5.0.0的升级路径。我刚开始用了这个包走了好多弯路,在HW朋友们的帮助和提醒下,才后知后觉的了解到这点。 7.解压 (这部分和安装类似,就不做详细展开) tar zxvf openGauss-3.0.0-openEuler-64bit-all.tar.gz tar zxvf openGauss-3.0.0-openEuler-64bit-om.tar.gz 8.执行preinstall (这部分和安装类似,就不做详细展开) 进入script目录,执行preinstall命令,注意要用root用户执行: ./gs_preinstall -U omm -G dbgrp -X /opt/software/openGauss/5.0.1/script/clustcfg/clust_config.xml 执行过程会询问是否创建omm用户,回复yes。 9.修改目录权限 如不修改会提示文件无访问权限。 chmod 755 -R /opt/software/gaussdb_upgrade3.0.0/ 10.执行升级过程 关于openGauss就地升级和灰度升级的区别,主要在于灰度升级的时候业务不中断。切换至omm用户,执行升级命令,注意确认路径在3.0.0。 gs_upgradectl -t auto-upgrade -X /opt/software/openGauss/5.0.1/script/clustcfg/clust_config.xml --grey 升级成功。 11.检查升级效果 检查数据库版本: 检查数据库和表存在: 12.提交升级 若经过3.0.0升级至5.0.0,则一定要提交升级,否则在升级5.0的时候会报错。另外需注意,提交升级之后就不能再回退至升级前的版本了。 gs_upgradectl -t commit-upgrade -X /opt/software/openGauss/5.0.1/script/clustcfg/clust_config.xml 13.再次查看数据库版本和状态信息 gs_om -t status –detail ---至此,版本已成功升级至3.0.0 14.创建5.0.0版本升级目录 (过程上需要记录,但我们偷懒在前面已经一并创建了) mkdir gaussdb_upgrade5.0.0 15.下载5.0.0版本软件包 wget:https://opengauss.obs.cn-south-1.myhuaweicloud.com/5.0.0/x86_openEuler/openGauss-5.0.0-openEuler-64bit-all.tar.gz 仍然要确认好操作系统和版本以及制式。 16.解压5.0.0软件包 tar zxvf openGauss-3.0.0-openEuler-64bit-all.tar.gz tar zxvf openGauss-3.0.0-openEuler-64bit-om.tar.gz 17.执行5.0.0preinstall (这部分和安装类似,就不做详细展开) 进入5.0.0的script目录,执行5.0.0的preinstall,注意要用root用户执行。 18.修改目录权限 chmod 755 -R /opt/software/gaussdb_upgrade5.0.0/ 19.执行升级过程 (推荐灰度升级方式) 切换至omm用户,执行升级过程,确认目录: gs_upgradectl -t auto-upgrade -X /opt/software/openGauss/5.0.1/script/clustcfg/clust_config.xml –grey 说明:命令格式和3.0.0的升级一样。 20.检查升级效果 检查数据库版本 检查数据库和表数据 21.检查无误后提交升级 gs_upgradectl -t commit-upgrade -X /opt/software/openGauss/5.0.1/script/clustcfg/clust_config.xml 22.再次查看数据库版本和状态信息 至此,数据库已经成功从2.1.0升级至5.0.0了,由于官网的不保证,升级之前还是很忐忑的,事实证明了openGauss实际是支持的,这是一种低调的实力。 说明: 请大家忽略xml文件路径中5.0.1的干扰,整个过程和5.0.1没有关系,只是前面安装5.0.1版本时把xml文件放置在这个目录下,升级时懒得改了就没动。 从2.1.0也可以越过3.0.0直接升级至5.0.0,按照文中的操作步骤略作调整也可实现,考虑篇幅所限不单独罗列了。 本文内容来自于数据库领域资深技术专家赵锋老师,希望我们的文章正好能解决你的问题。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册