首页 文章 精选 留言 我的

精选列表

搜索[千问小酒窝],共10004篇文章
优秀的个人博客,低调大师

Python 技术百问

如何让用户保持登录状态https://yq.aliyun.com/ask/495120 如何迭代Pandas Dataframe中的行https://yq.aliyun.com/ask/495119 如何在Python中查找或删除列表中的子串列表https://yq.aliyun.com/ask/495117 无法创建文件notepad txt utf-8https://yq.aliyun.com/ask/495113 在数据框中查找值并在相应列中交叉引用值https://yq.aliyun.com/ask/495109 (Django)我们如何将单选按钮值存储到数据库中https://yq.aliyun.com/ask/495108 Python:如何检查两个字符串的匹配字符数?https://yq.aliyun.com/ask/49510
优秀的个人博客,低调大师

开源日报 | 开源模型行业化;国产Sora的秘密;谷歌Python基金会团队裁员;通义千问千亿参数模型开源;开源鸿蒙价值

欢迎阅读 OSCHINA 编辑部出品的开源日报,每天更新一期。 # 2024.4.28 今日要点 谷歌 Python 基金会团队被裁员 Thomas Wouters 是谷歌 Python 工程师、CPython 核心开发者兼 Python 指导委员会成员,昨天晚上他在社交媒体发布动态称:包括自己在内的同事、主管均已被裁员。 综合 Thomas 本人陈述和其他网友的补充评论,谷歌解雇了内部参与 Python 基金会工作的团队,并要求被裁员工对将在慕尼黑办公室【接替他们工作】的员工进行培训。 阿里巴巴开源 1100 亿参数 Qwen1.5-110B 模型 阿里巴巴宣布开源 Qwen1.5 系列首个千亿参数模型 Qwen1.5-110B,该模型在基础能力评估中与 Meta-Llama3-70B 相媲美,在 Chat 评估中表现出色,包括 MT-Bench 和 AlpacaEval 2.0。 据介绍,Qwen1.5-110B 与其他 Qwen1.5 模型相似,采用了相同的 Transformer 解码器架构。它包含了分组查询注意力(GQA),在模型推理时更加高效。该模型支持 32K tokens 的上下文长度,同时它仍然是多语言的,支持英、中、法、西、德、俄、日、韩、越、阿等多种语言。 阿里 Qwen1.5-110B 模型与最近的 SOTA 语言模型 Meta-Llama3-70B 以及 Mixtral-8x22B 进行了比较,结果如下: 国内首个汽车大模型标准正式发布 本标准主要围绕场景丰富度、能力支持度和应用成熟度三个方面构建汽车大模型评价指标,其中:场景丰富度关注汽车大模型产品对汽车研发、生产、使用、销售和售后场景等任务的支持度;能力支持度关注汽车大模型的功能丰富度和性能优越度;应用成熟度关注汽车大模型的算力配置、部署推理及车机系统生态方面的成熟度。 本标准聚焦汽车行业高质量发展,结合汽车的研发、生产、销售、使用等全过程,形成汽车大模型应用成熟度评价方法,便于各方衡量汽车大模型的应用能效,助推汽车大模型产品升级优化。 华为高管评价开源鸿蒙价值:被国外持续打压仍有自己的操作系统 在近日的第八届山东软件生态大会 —OpenHarmony 城市大会上,华为终端 BG 软件部副总裁柳晓见发表了主题演讲。 柳晓见表示:“我们做一个自己的操作系统并且开源,核心是要解决两个问题:一是连续性问题,二是先进性问题。” 他认为所谓连续性是指,当我们被国外打压 “卡脖子” 的时候,仍然有自己的操作系统可以用,不至于倒下。而先进性是指,我们不仅要有自己的操作系统,还要有一个面向下一代、更先进、更有竞争力、更好用的操作系统,这才是 OpenHarmony 开源鸿蒙真正的价值。 今日观察 社交观察 开源世界的多模态也要起飞了 基于Phi-3和LLaMA-3的LLaVA++开源多模态LLM出来了,以后图片理解打标啥的也不再需要调API了~! LLaVA++项目扩展了LLaVA模型,集成了Phi-3 Mini Instruct和LLaMA-3 Instruct模型,提升了模型的视觉和语言指令处理能力。 - 微博Simon的白日梦 开源模型的一个价值方向在于行业化 对于通用大模型公司而言,往往无暇顾及行业垂直细分市场。但是对某些在这个细分领域的人而言,这个市场就是它们的全部。 所以未来大模型领域的一个商业赛道可能是有专有数据的公司加开源模型,发展自己的第二曲线。不过这些公司可能不一定有技术能力,所以模型技术服务商也有一定的机会。 - 微博高飞 开源 AI 图片上色模型 DDColor 这是"DDColor:通过双解码器实现照片级真实感图像着色"(Towards Photo-Realistic Image Colorization via Dual Decoders)的官方实现。DDColor 可以为历史黑白老照片提供生动自然的着色。它甚至可以对动漫游戏中的风景进行着色/重新着色,将您的动画风景转变为逼真的现实生活风格! - 微博 黄建同学 新 AI 搜索工具免费开源 还记得老黄之前自称离不开的 AI 搜索工具 “Perplexity” 吗?有人搞了个类似的,而且还完全开源了。 这款新的AI工具名叫 Perplexica,也支持多种搜索模式 ,包括学术搜索、YouTube视频搜索、Reddit搜索和计算专用模式等。而且它还支持使用本地部署的大语言模型,如 Llama3 和 Mixtral。 - 微博 量子位 媒体观察 MTK和Intel联手,投资RISC-V芯片新贵谋发展? 全球众多RISC-V科技公司的CEO纷纷聚焦于构建更加完善的RISC-V生态。 在这一背景下,全球RISC-V软件生态计划RISE(RISC-V Software Ecosystem)应运而生,该计划由谷歌、英特尔、高通、联发科、Andes、平头哥、Rivos、SiFive、Ventana、三星、英伟达、Imagination等13家行业领军企业共同发起。 该计划旨在与RISC-V国际基金会紧密合作,共同推动RISC-V商用软件生态的快速发展。 RISE组织的成立标志着RISC-V软件生态进入了一个全新的阶段,即从过去的纯开源和基金会主导模式转变为商业化主导、全球大规模共建的新时代。 -AI芯天下 Elektrobit 开源突破加速向软件定义出行转型 Elektrobit今日宣布推出面向功能安全应用的EB corbos Linux for Safety Applications,这是全球首个符合汽车功能安全标准的开源操作系统 (OS) 解决方案。在其他高科技行业,自由开源软件(FOSS)一直是常态,但汽车行业由于严格的安全要求,迄今为止一直受到其影响的限制。 随着面向功能安全应用的 EB corbos Linux for Safety Applications 的推出,汽车制造商和供应商首次可以在诸如高级驾驶辅助系统(ADAS)和自动驾驶汽车(AV)等安全相关的高性能计算(HPC)功能领域中利用 Linux。这是一个多功能的解决方案,还可以在其他行业的安全相关领域中使用,例如医疗保健、机械工程和能源。 EB corbos Linux for Safety Applications提供长达15 年的维护,以确保产品在整个生命周期内的安全性,这是另一个行业基准。该解决方案的其他主要优势还包括,由于开源软件的开发周期更快,产品上市时间最多可缩短50%,从而大大节省了成本。开源软件凭借其固有的透明度、灵活性和安全性,进一步彰显了其与专有软件的区别。 -美通社PRNewswire 国产 Sora 的秘密,藏在这个清华系大模型团队中 在一众长视频生成算法中,Sora 的技术突破是具备革命性的。相比传统的 Stable Diffusion,Sora 采用的 Diffusion 加 Transformer 架构,既克服了 Stable Diffusion 扩展性的缺失,更是在生成内容的准确性和灵活性上有了质的飞跃。 唯一美中不足是,Sora 并非开源算法。 没了开源,也就没了复现的可能;没了复现可能,那么哪怕经管出身的合伙人睡前读物变成了《Scalable diffusion models with transformers》,投资经理一周跑遍北京、深圳科技产业园掘地三尺,所有人都不得不承认一个现实,尽管视频大模型企业众多,但或许尚未等到国产 Sora 正式发掘,视频大模型的淘汰赛就已经走到尾声。 近日,生数科技联合清华大学宣布推出国内首个基于纯自研 U-ViT 架构的视频大模型「Vidu」,支持一键生成长达 16 秒、分辨率高达 1080p 的高清视频内容。从官宣的短片来看,Vidu 在多镜头生成、时间和空间一致性、模拟真实物理世界以及想象力等方面,几乎与 Sora 齐平。 而相比其他国产「类 Sora」的工作,Vidu 一个最明显的特点就是,画面时间足够长。 - 极客公园 今日推荐 开源项目 MrGlockenspiel/activate-linux https://github.com/MrGlockenspiel/activate-linux activate-linux 是仿 Windows 的 “激活 Linux” 水印工具,可以在 Linux 桌面上显示 “激活 Linux” 水印,使他看起来像是未激活的 Windows 一样。 每日一博 AI 生图美学在淘宝的实践应用 本文介绍了如何制定和应用美学标准来评估和改善人工智能生成的图像质量,特别是在电商领域的应用,主要分为制定美学标准、训练美学模型、应用美学模型、升级淘宝风格模型四个步骤。​ 事件点评 赤字三年,GNOME 基金会将专注于筹款 GNOME 基金会主席 Robert McQueen 于日前发布了一篇公告称,在连续赤字三年后,基金会将致力于推动更多新的筹款计划以稳定局势。 基金会曾在去年 10 月聘请了一位新的执行董事 Holly Million。Robert 指出,董事会当初聘用 Holly 一大重要原因就是,看中了她在沟通和筹款方面的经验。希望她的加入可以帮助基金会建立更好的财务控制和报告制度、制定战略计划,并开始筹款。 点评 这一决策反映了 GNOME 基金会对可持续发展和财务稳定的重视。在经历了多年的赤字状态后,基金会意识到必须采取措施来确保其核心业务的持续运作。 GNOME 基金会面临的连续三年赤字也反映了开源社区普遍的资金挑战。开源项目通常依赖社区捐赠和志愿者工作,但这种模式可能难以维持长期的稳定运营。 而 Sovereign Tech Fund 的投资不仅对 GNOME 基金会本身具有重要意义,还反映了开源社区和开源软件的重要性。这笔资金将帮助 GNOME 基金会维持其在开源桌面环境领域的领导地位,并可能对其他开源项目产生积极影响。 FCC 投票恢复 “网络中立性” 原则 美国联邦通信委员会(Federal Communications Commission,FCC)以 3 比 2 的投票决定恢复 “网络中立 性 (NetNeutrality)” 法规,即互联网服务提供商 (ISP) 必须平等对待所有通信服务。 点评 这一决策在美国引起了广泛关注,并对整个互联网行业产生了重要影响。首先,网络中立性的恢复强调了互联网公平和平等访问的重要性。根据新的裁决,ISP将无法再阻止、限制特定网站或服务或确定其优先级。这一决策有助于保护用户免受ISP对互联网内容的干预,确保网络的开放性和公平性。 其次,这一决策可能对ISP的业务模式产生影响。虽然ISP普遍表示他们遵守网络中立原则,但他们反对将宽带服务重新归类为Title II电信服务,因为这可能使FCC有能力监管他们的定价。尽管FCC决定对ISP的价格监管持保留态度,但未来可能会有变化。 这一决策还反映了美国在互联网监管方面的政治斗争。民主党多数派FCC投票支持恢复网络中立性,而共和党少数派则持反对意见。表明网络中立性问题是美国政治中一个持续存在的争议点。 消息称 x.AI 正以 180 亿美元估值融资 60 亿美元 科技网站TechCrunch援引据知情人士消息称,埃隆 - 马斯克(Elon Musk)旗下的人工智能公司 xAI 正在以 180 亿美元的投前估值融资 60 亿美元。除非交易条款发生变化,否则这笔交易有望在未来几周内完成,投资者将获得公司四分之一的股份。 在此之前,交易条款已经变更过一次。上周末,马斯克家族办公室负责人 Jared Birchall 曾向潜在投资者透露,xAI 将以 150 亿美元的投前估值融资 30 亿美元。但鉴于有大量投资者争相参与这笔交易,相关数字很快重新进行了调整,而投资者基本也都不介意这一变更。 点评 马斯克一直公开表示他的目标是成为美国人工智能行业的领导者。这笔融资的价值表明,尽管马斯克因其争议性言论而受到批评,但他的商业理念仍然受到风险投资家的支持。 这笔融资将大大增强 xAI 的研发和市场竞争力,可能加速其在人工智能领域的技术创新和市场扩张;以及对顶尖人才的吸引,加剧行业内的人才争夺。提升 xAI 在行业中的地位,使其成为更有影响力的参与者,对行业标准和趋势产生更大影响。 甚至可能使竞争对手感受到更大的压力,导致竞争对手加快自己的研发步伐或寻找新的商业模式。 开源之声 媒体观点 (经济观察)让AI“人人可得”还有多远? 在大模型技术助推下,人工智能已取得长足进步,但AI距离人类智能仍有差距,专家认为,AI“飞入寻常百姓家”还有一定距离。 -中国新闻网 “我们做自己的开源操作系统,核心是要解决两个问题” “我们做一个自己的操作系统并且开源,核心是要解决两个问题:一是连续性问题,二是先进性问题。” 柳晓见表示,所谓连续性是指,当我们被国外打压“卡脖子”的时候,仍然有自己的操作系统可以用,不至于倒下;而先进性是指,我们不仅要有自己的操作系统,还要有一个面向下一代、更先进、更有竞争力、更好用的操作系统,这才是OpenHarmony真正的价值。 “如果只是解决有无的问题,其实有很多方法,但要做到好用并不容易。” -观察者网 Altman 斯坦福闭门演讲:「我们欠自己和未来的人们一个更美好的世界」 「我们欠自己和未来的人们一个更美好的世界」,而 AGI 可以为社会带来高质量的教育、疾病治疗、娱乐和太空探索。 -极客公园 人形机器人的风来了?一季度融资额32亿美元,同比接近翻倍 风险投资者为支持利用人工智能的机器人初创公司支付高昂的溢价,希望其中一家能成为机器人版的 OpenAI。 以Skild为例,这是一家年轻的公司,一直在开发软件,用于驱动各种机器人,包括双腿或四腿的机器人,据一位同意参与该交易的投资者所说,该公司即将与 Lightspeed Venture Partners、Coatue Management 和其他公司达成一项交易,筹集近 3 亿美元,估值达到 15 亿美元。 - 乌鸦智能说 用户观点 谷歌Python团队全员被裁——负责内部Python所有基础设施、曾对数亿行代码执行自动重构 观点 1:谷歌下一步干脆把自己的搜索也裁了,直接接入百度的API? 观点 2:這麼慢的垃雜,還有什麼價值可用 观点 3:以前硬件资源紧缺Python都活了下来,现在硬件资源便宜了要干死Python?谁会像这样因为速度慢就完全否定Python?还是你纯属自嗨 观点 4:裁python团队也并不是说这门语言不好,只是人家公司内部有自己的考虑而已 观点 5:码农永远只是资本的工具,哪怕你是最顶级的码农。 观点 6:JavaScript团队瑟瑟发抖 观点 7:首先调岗不等于解雇,除非对于被调岗的人来说这种调岗完全不可接受,这里需要论证说明。其次如果上层就是不看好Python团队了,那也要看背后的动机,适用于Python团队不一定适用于JavaScript团队 观点 8:应该是这些人是维护代码,专门研究Python的。而ai只是用了Python,这是两码事。这些人其实并不会为公司带来直接效益,也可替代,实质工作可能也是维护开源。 观点 9:正常,也不正常。人工智能的相关部门肯定不会裁掉,python只是一个编程语言/一个工具,只是AI“生态链”一个很小的部分。不能把python等同于人工智能,遇到过某些人以为学会python就学会了人工智能/大数据,也挺无语的。大公司存在一个python“兴趣小组”,对公司很多技术系统是有益的,毕竟python应用广泛 观点 10:Tensorflow,JAX 还搞不搞了,不搞谷歌就赶紧发个通知盖棺定论 Deprecated 掉,大家好聚好散 观点 11:微软赶紧捡漏啊 火速冲上GitHub热榜——我的VS Code不可能这么可爱! 观点 1:有点杂乱,简洁才是王道 观点 2:那是工作上……我见过的大部分写代码的都很二次元。而且一个喜欢的外观对于工作时的心情也是很重要的。我会在安装新的IDE时花半小时把它的主题改成我最喜欢的Material You Design,这可以保证我不会因为区区几十条报错就开口埋怨。 观点 3:日漫进军编程 PHP 获得来自 STF 的 20 万欧元投资 观点 1:资金到位 开始起飞 观点 2:这点钱够吗 观点 3:对于开源社区,多少资金都不算少,有人赞助是最大的鼓励。 观点 4:我想跟投20元,怎么投? 观点 5:去 open collective 的 php foundation 就行 ---END--- 最后,欢迎扫码下载「开源中国 APP」,阅读海量技术报告、程序员极客分享!

优秀的个人博客,低调大师

Apache Doris 入门 10 问

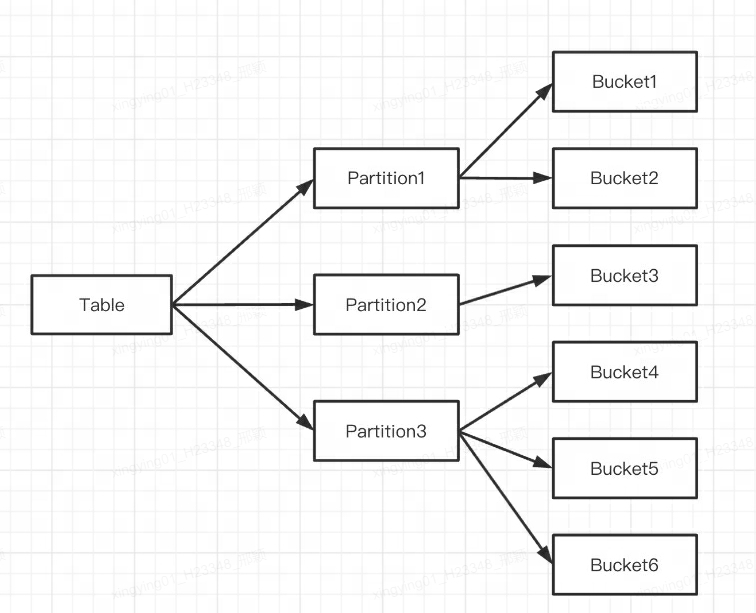
基于 Apache Doris 在读写流程、副本一致性机制、 存储机制、高可用机制等方面的常见疑问点进行梳理,并以问答形式进行解答。在开始之前,我们先对本文相关的名词进行解释: FE:Frontend,即 Doris 的前端节点。主要负责接收和返回客户端请求、元数据以及集群管理、查询计划生成等工作。 BE:Backend,即 Doris 的后端节点。主要负责数据存储与管理、查询计划执行等工作。 BDBJE:Oracle Berkeley DB Java Edition, 在 Doris 中,使用 BDBJE 完成元数据操作日志的持久化、FE 高可用等功能。 Tablet:Tablet 是一张表实际的物理存储单元,一张表按照分区和分桶后在 BE 构成分布式存储层中以 Tablet 为单位进行存储,每个 Tablet 包括元信息及若干个连续的 RowSet。 RowSet:RowSet 是 Tablet 中一次数据变更的数据集合,数据变更包括了数据导入、删除、更新等。RowSet 按版本信息进行记录。每次变更会生成一个版本。 Version:由 Start、End 两个属性构成,维护数据变更的记录信息。通常用来表示 RowSet 的版本范围,在一次新导入后生成一个 Start、End 相等的 RowSet,在 Compaction 后生成一个带范围的 RowSet 版本。 Segment:表示 RowSet 中的数据分段,多个 Segment 构成一个 RowSet。 Compaction:连续版本的 RowSet 合并的过程成称为 Compaction,合并过程中会对数据进行压缩操作。 Key 列、Value 列:在 Doris 中,数据以表(Table)的形式进行逻辑上的描述。一张表包括行(Row)和列(Column),Row 即用户的一行数据,Column 用于描述一行数据中不同的字段。Column 可以分为两大类:Key 和 Value。从业务角度看,Key 和 Value 可以分别对应维度列和指标列。Doris 的 Key 列是建表语句中指定的列,建表语句中的关键字 unique key 或 aggregate key 或 duplicate key 后面的列就是 Key 列,除了 Key 列剩下的就是 Value 列。 数据模型:Doris 的数据模型主要分为 3 类:Aggregate、Unique、Duplicate。 Base 表:在 Doris 中,我们将用户通过建表语句创建出来的表称为 Base 表(Base Table),Base 表中保存着按用户建表语句指定方式存储的基础数据。 ROLLUP 表:在 Base 表之上,用户可以创建任意多个 ROLLUP 表。这些 ROLLUP 的数据是基于 Base 表产生的,并且在物理上是独立存储的。ROLLUP 表的基本作用,在于在 Base 表的基础上,获得更粗粒度的聚合数据,类似于物化视图。 Q1:Doris 分区跟分桶有什么区别? Doris 支持两层数据划分: 第一层是 Partition(分区),支持 Range 和 List 的划分方式(类似于 MySQL 的分区表的概念)。若干个 Partition 组成一个 Table,Partition 可以视为是逻辑上最小的管理单元。数据的导入与删除,仅能针对一个 Partition 进行。 第二层是 Bucket(Tablet 也称为分桶),支持 Hash 和 Random 的划分方式。每个 Tablet 包含若干数据行,各个 Tablet 之间的数据没有交集,并且在物理上是独立存储的。Tablet 是数据移动、复制等操作的最小物理存储单元。 也可以仅使用一层分区,建表时如果不写分区的语句即可,此时 Doris 会生成一个默认的分区,对用户是透明的。 示意如下: 多个 Tablet 在逻辑上归属于不同的分区(Partition),一个 Tablet 只属于一个 Partition,而一个 Partition 包含若干个 Tablet。因为 Tablet 在物理上是独立存储的,所以可以视为 Partition 在物理上也是独立。 从逻辑上来讲,分区和分桶最大的区别就是分桶随机分割数据库,分区是非随机分割数据库。 怎么保证数据多副本的? 为了提高保存数据的可靠性和计算时的性能,Doris 对每个表复制多份进行存储。数据的每份复制就叫做一个副本。Doris 按 Tablet 为基本单元对数据进行副本存储,默认一个分片有 3 个副本。建表时可在 PROPERTIES 中设置副本的数量: PROPERTIES ( "replication_num" = "3" ); 下图示例,有两个表分别导入 Doris,表 1 导入后按 3 副本存储,表 2 导入后按 2 副本存储。数据分布如下: Q2:为什么需要分桶? 为了分桶裁剪,并且避免数据倾斜,同时也为了分散读 IO,提升查询性能,可以将 Tablet 的不同副本分散在不同机器上,查询时可以充分发挥不同机器的 IO 性能。 Q3:物理文件的存储结构及格式是怎样的? Doris 的每次导入可视为一个事务,会生成一个 RowSet 。而 RowSet 又包括多个 Segment,即 Tablet-->Rowset-->Segment 。那 BE 是如何存储这些文件的呢? Doris 的存储结构 Doris 通过 storage_root_path 进行存储路径配置,Segment 文件存放在 tablet_id 目录下按 SchemaHash 管理。Segment 文件可以有多个,一般按照大小进行分割,默认为 256MB。存储目录以及 Segment 文件命名规则为: ${storage_root_path}/data/${shard}/${tablet_id}/${schema_hash}/${rowset_id}_${segment_id}.dat 进入 storage_root_path 目录,可以看到如下存储结构: ${shard}:即上图中的 0、1。是存储目录下 BE 自动创建的,是随机的。会随着数据的增多而增多。 ${tablet_id}:即上图中的 15123、27003 等,即上面提到的 Bucket 的 ID。 ${schema_hash}:即上图中的 727041558、1102328406 等。因为一个表的结构可能会被变更,所以对每个 Schema 的版本生成一个 SchemaHash,来标识该版本下的数据。 ${segment_id}.dat:其中前面的为 rowset_id,即上图中的 02000000000000e3ba4924368a21695d8cc3cf8525f80789;${segment_id} 为当前 RowSet 的 segment_id,从 0 开始递增。 Segment 文件的存储格式 Segment 整体的文件格式分为数据区域,索引区域和 Footer 三个部分,如下图所示: Data Region: 用于存储各个列的数据信息,这里的数据是按需分 Page 加载的,其中 Page 中包含了列的数据,每个 Page 为 64k。 Index Region:Doris 中将各个列的 Index 数据统一存储在 Index Region,这里的数据会按照列粒度进行加载,所以跟列的数据信息分开存储。 Footer 信息:包含文件的元数据信息、内容的 Checksum 等。 Q4:Doris 的不同表模型在 DML 方面有什么限制? Update:Update 语句目前仅支持 UNIQUE KEY 模型,并且只支持更新 Value 列。 Delete:1)如果是使用聚合类的表模型(AGGREGATE、UNIQUE),Delete 操作只能指定 Key 列上的条件;2)该操作会同时删除和此 Base Index 相关的 Rollup Index 的数据。 Insert:所有数据模型均可 Insert。 Insert 怎么实现?数据插入后如何被查询到? AGGREGATE 模型:Insert 阶段将增量的数据按照 Append 的方式写到 RowSet,查询阶段采用 Merge on Read 的方式进行进行合并。也就是说数据在导入时先写入一个新的 RowSet,写入后并不会执行去重,只有在发起查询时才会做多路并发排序,在进行多路归并排序时,会将重复的 Key 排在一起,并进行聚合操作。其中高版本 Key 的会覆盖低版本的 Key,最终只返回给用户版本最高的那一条记录。 DUPLICATE 模型:该模型写入与上述类似,读取阶段不会有任何聚合操作。 UNIQUE 模型:在 1.2 版本之前,该模型本质上是聚合模型的一个特例,行为与 AGGREGATE 模型一致。由于聚合模型的实现方式是读时合并(Merge on Read),因此在一些聚合查询上性能不佳。Doris 在 1.2 版本后引入了 Unique 模型新的实现方式,写时合并(Merge on Write),通过在写入时将被覆盖和被更新的数据进行标记删除,在查询的时候,所有被标记删除的数据都会在文件级别被过滤掉,读取出来的数据就都是最新的数据,消除掉了读时合并中的数据聚合过程,并且能够在很多情况下支持多种谓词的下推。 简单来讲,Merge on Write 的处理流程是: 对于每一条 Key,查找它在 Base 数据中的位置(RowSetid + Segmentid + 行号)【内存中维护了 Segment 级别的主键区间树,加速查询】 如果 Key 存在,则将该行数据标记删除。标记删除的信息记录在 Delete Bitmap 中,其中每个 Segment 都有一个对应的 Delete Bitmap。 将更新的数据写入新的 RowSet 中,完成事务,让新数据可见,即能够被用户查询到。 查询时,读取 Delete Bitmap,将被标记删除的行过滤掉,只返回有效的数据【对于命中的所有 Segment,按照版本从高到低进行查询】 下面介绍一下写入流程和读取流程的实现。 写入流程:写入数据时会先创建每个 Segment 的主键索引,再更新 Delete Bitmap。 读取流程:Bitmap 的读取流程如下图所示,从图片中我们可知: 一个请求了版本 7 的 Query,只会看到版本 7 对应的数据 读取 RowSet5 的数据时,会将 V6 和 V7 对它的修改产生的 Bitmap 合并在一起,得到 Version7 对应的完整 DeleteBitmap,用来过滤数据 在上图的示例中,版本 8 的导入覆盖了 RowSet1 的 Segment2 一条数据,但请求版本 7 的 Query 仍然能读到该条数据 Update 怎么实现的? UNIQUE 模型 Update 过程本质上是 Select+Insert。 Update 利用查询引擎自身的 Where 过滤逻辑,从待更新表中筛选出需要被更新的行,基于此维护 Delete Bitmap 以及生成新插入的数据。 接着再执行 Insert 逻辑,具体流程跟上述的 UNIQUE 模型写入逻辑类似。 Q5:Doris 的 Delete 是怎么实现的?也是会生成一个 RowSet?如何删除对应的数据? Doris 的 Delete 也是会生成一个 RowSet,DELETE 模式下没有对数据进行实际删除操作,而是对数据删除条件进行了记录。存储在 Meta 信息中。当执行 Base Compaction 时删除条件会一起被合入到 Base 版本中。 Doris 在 UNIQUE KEY 模型下也支持了 LOAD_DELETE ,实现了通过批量导入要删除的 key 对数据进行删除,能够支持大量数据删除能力。整体思路是在数据记录中加入删除状态标识,在 Compaction 流程中会对删除的 Key 进行压缩。Compaction 主要负责将多个 RowSet 版本进行合并。 Q6:Doris 有哪些索引? 目前 Doris 主要支持两类索引: 内建的智能索引,包括前缀索引和 ZoneMap 索引。 用户手动创建的二级索引,包括倒排索引、 Bloomfilter 索引、 Ngram Bloomfilter 索引 和 Bitmap 索引。 其中 ZoneMap 索引是在列存格式上,对每一列自动维护的索引信息,包括 Min/Max,Null 值个数等等。这种索引对用户透明。 索引是什么级别? 现在 Doris 里所有索引都是 BE 级别 Local 的,例如:倒排索引、 Bloomfilter 索引、 Ngram Bloomfilter 索引 和 Bitmap 索引、前缀索引和 ZoneMap 索引等 Doris 没有 Global Index。广义理解上,分区间+分桶键 这些也能算是 Global 的,但是比较粗粒度。 索引的存储格式是怎样的? Doris 中将各个列的 Index 数据统一存储在 Segment 文件的 Index Region,这里的数据会按照列粒度进行加载,所以跟列的数据信息分开存储。这里以 Short Key Index 前缀索引为例进行介绍。 Short Key Index 前缀索引,是在 Key(AGGREGATE KEY、UNIQ KEY 和 DUPLICATE KEY)排序的基础上,实现的一种根据给定前缀列,快速查询数据的索引方式。这里 Short Key Index 索引也采用了稀疏索引结构,在数据写入过程中,每隔一定行数,会生成一个索引项。这个行数为索引粒度默认为 1024 行,可配置。该过程如下图所示: 其中,KeyBytes 中存放了索引项数据,OffsetBytes 存放了索引项在 KeyBytes 中的偏移。 Short Key Index 采用了前 36 个字节,作为这行数据的前缀索引。当遇到 VARCHAR 类型时,前缀索引会直接截断。 Short Key Index 采用了前 36 个字节,作为这行数据的前缀索引。当遇到 VARCHAR 类型时,前缀索引会直接截断。 读的过程如何命中索引? 在查询一个 Segment 中的数据时,根据执行的查询条件,会对首先根据字段加索引的情况对数据进行过滤。然后在进行读取数据,整体的查询流程如下: 首先,会按照 Segment 的行数构建一个 row_bitmap,表示记录哪些数据需要进行读取。没有使用任何索引的情况下,需要读取所有数据。 当查询条件中按前缀索引规则使用到了 Key 时,会先进行 ShortKey Index 的过滤,可以在 ShortKey Index 中匹配到的 Oordinal 行号范围,合入到 row_bitmap 中。 当查询条件中列字段存在 BitMap Index 索引时,会按照 BitMap 索引直接查出符合条件的 Ordinal 行号,与 row_bitmap 求交过滤。这里的过滤是精确的,之后去掉该查询条件,这个字段就不会再进行后面索引的过滤。 当查询条件中列字段存在 BloomFilter 索引并且条件为等值(eq,in,is)时,会按 BloomFilter 索引过滤,这里会走完所有索引,过滤每一个 Page 的 BloomFilter,找出查询条件能命中的所有 Page。将索引信息中的 Ordinal 行号范围与 row_bitmap 求交过滤。 当查询条件中列字段存在 ZoneMap 索引时,会按 ZoneMap 索引过滤,这里同样会走完所有索引,找出查询条件能与 ZoneMap 有交集的所有 Page。将索引信息中的 Ordinal 行号范围与 row_bitmap 求交过滤。 生成好 row_bitmap 之后,批量通过每个 Column 的 OrdinalIndex 找到到具体的 Data Page。 批量读取每一列的 Column Data Page 的数据。在读取时,对于有 Null 值的 Page,根据 Null 值位图判断当前行是否是 Null,如果为 Null 进行直接填充即可。 Q7:Doris 如何进行 Compaction 的? Doris 通过 Compaction 将增量聚合 RowSet 文件提升性能,RowSet 的版本信息中设计了有两个字段 Start、End 来表示 Rowset 合并后的版本范围。未合并的 Cumulative RowSet 的版本 Start 和 End 相等。Compaction 时相邻的 RowSet 会进行合并,生成一个新的 RowSet,版本信息的 Start、End 也会进行合并,变成一个更大范围的版本。另一方面,Compaction 流程大大减少 RowSet 文件数量,提升查询效率。 如上图所示,Compaction 任务分为两种,Base Compaction 和 Cumulative Compaction。cumulative_point 是分割两种策略关键。 可以这样理解: cumulative_point 右边是从未合并过的增量 RowSet,其每个 RowSet 的 Start 与 End 版本相等; cumulative_point 左边是合并过的 RowSet,Start 版本与 End 版本不等。 Base Compaction 和 Cumulative Compaction 任务流程基本一致,差异仅在选取要合并的 InputRowSet 逻辑有所不同。 Compaction 是按照什么 Key 来的? 在一个 Segment 中,数据始终按照 Key(AGGREGATE KEY、UNIQ KEY 和 DUPLICATE KEY)排序顺序进行存储,即 Key 的排序决定了数据存储的物理结构,确定了列数据的物理结构顺序。 所以 Doris Compaction 过程是基于 AGGREGATE KEY、UNIQ KEY 和 DUPLICATE KEY 来进行的。 Q8:Doris 怎么实现跨集群数据复制功能? 为了实现跨集群数据复制功能,Doris 引入了 Binlog 机制。通过 Binlog 机制自动记录数据修改记录和操作,以实现数据的可追溯性,同时还可以基于 Binlog 回放机制来实现数据的重放和恢复。 Binlog 怎么记录的? 在开启 Binlog 属性后,FE 和 BE 会将 DDL/DML 操作的修改记录持久化成 Meta Binlog 和 Data Binlog。 Meta Binlog:Doris 对 EditLog 的实现进行了增强,以确保日志的有序性。通过构建一个递增序列的 LogID,对每个操作进行准确记录,并按顺序持久化。这种有序的持久化机制有助于保证数据的一致性。 Data Binlog:在 FE 发起 Publish Transaction 的时候,BE 会执行对应的 Publish 操作,BE 会将这次 Transaction 涉及 RowSet 的元数据信息写入以 rowset_meta 为前缀的 KV 中,并持久化到 Meta 存储中,提交后会把导入的 Segment Files 链接到 Binlog 文件夹下。 Binlog 生成: BInlog 数据回放: Q9:Doris 的表是多副本的,写入阶段怎么保证多副本的,是否有主从概念?需要 Majority 后再返回写入成功吗? Doris BE 的 3 副本没有主从的概念,采用 Quorum 算法保证多副本写入。 在写入过程中,FE 会判断每一个 Tablet 成功写入数据的副本数量是否超过了 Tablet 副本总数的一半,如果每一个 Tablet 成功写入数据的副本数量都超过 Tablet 副本总数的一半(多数成功),则 Commit Transaction 成功,并将事务状态设置为 COMMITTED;COMMITTED 状态表示数据已经成功写入,但是数据还不可见,需要继续执行 Publish Version 任务,此后,事务不可被回滚。 FE 会有一个单独的线程对 Commit 成功的 Transaction 执行 Publish Version,FE 执行 Publish Version 时会通过 Thrift RPC 向 Transaction 相关的所有 Executor BE 节点下发 Publish Version 请求,Publish Version 任务在各个 Executor BE 节点异步执行,将数据导入生成的 RowSet 变为可见的数据版本。 为什么会有 Publish 机制:类似于 MVCC,如果没有 Publish 机制,用户可能读到还没有提交的数据。 如果表为 3 副本,只写入成功 1 个副本会怎样:这个时候事务会 ABORTED 如果表为 3 副本,只写入成功 2 副本会怎样:这个时候事务会 COMMITTED,Doris FE 会定期执行 Tablet 监控巡检,如果发现 Tablet 副本异常,会生成 Clone 任务,Clone 一个新的副本。 为什么用户执行完 Insert Into,立即执行查询,结果可能为空呢:原因是事务还没有 Publish Q10:Doris 的 FE 怎么保证高可用的? 元数据层面,Doris 采用 Paxos 协议以及 Memory + Checkpoint + Journal 的机制来确保元数据的高性能及高可靠。 元数据的数据流具体过程如下: 只有 Leader FE 可以对元数据进行写操作。写操作在修改 Leader 的内存后,会序列化为一条 Log,按照 key-value 的形式写入 BDBJE。其中 Key 为连续的整型,作为 log id,Value 即为序列化后的操作日志。 日志写入 BDBJE 后,BDBJE 会根据策略(写多数/全写),将日志复制到其他 Non-Leader 的 FE 节点。Non-Leader FE 节点通过对日志回放,修改自身的元数据内存镜像,完成与 Leader 节点的元数据同步。 Leader 节点的日志条数达到阈值(默认 10w 条)并且满足 Checkpoint 线程执行周期(默认六十秒)。Checkpoint 会读取已有的 Image 文件,和其之后的日志,重新在内存中回放出一份新的元数据镜像副本。然后将该副本写入到磁盘,形成一个新的 Image。之所以是重新生成一份镜像副本,而不是将已有镜像写成 Image,主要是考虑写 Image 加读锁期间,会阻塞写操作。所以每次 Checkpoint 会占用双倍内存空间。 Image 文件生成后,Leader 节点会通知其他 Non-Leader 节点新的 Image 已生成。Non-Leader 主动通过 HTTP 拉取最新的 Image 文件,来更换本地的旧文件。 BDBJE 中的日志,在 Image 做完后,会定期删除旧的日志。 解释: 元数据的每次更新,都首先写入到磁盘的日志文件中,然后再写到内存中,最后定期 Checkpoint 到本地磁盘上。 相当于是一个纯内存的一个结构,也就是说所有的元数据都会缓存在内存之中,从而保证 FE 在宕机后能够快速恢复元数据,而且不丢失元数据。 Leader、Follower 和 Observer 它们三个构成一个可靠的服务,单机的节点故障的时候其实基本上三个就够了,因为 FE 节点毕竟它只存了一份元数据,它的压力不大,所以如果 FE 太多的时候它会去消耗机器资源,所以多数情况下三个就足够了,可以达到一个很高可用的元数据服务。 用户可以使用 MySQL 连接任意一个 FE 节点进行元数据的读写访问。如果连接的是 Non-Leader 节点,则该节点会将写操作转发给 Leader 节点。 作者介绍 隐形(邢颖) 网易资深数据库内核工程师,毕业至今一直从事数据库内核开发工作,目前主要参与 MySQL 与 Apache Doris 的开发维护和业务支持工作。作为 MySQL 内核贡献者,为 MySQL 上报了 50 多个 Bug 及优化项,多个提交被合入 MySQL 8.0 版本。从 2023 年起加入 Apache Doris 社区,Apache Doris Active Contributor,已为社区提交并合入数十个 Commits。

优秀的个人博客,低调大师

《叶问》第1期

2018年6月10日,周日 MySQL主从复制什么原因会造成不一致,如何预防及解决? 一、导致主从不一致的原因主要有: 1、人为原因导致从库与主库数据不一致(从库写入)2、主从复制过程中,主库异常宕机3、设置了ignore/do/rewrite等replication等规则4、binlog非row格式5、异步复制本身不保证,半同步存在提交读的问题,增强半同步起来比较完美。 但对于异常重启(Replication Crash Safe),从库写数据(GTID)的防范,还需要策略来保证。6、从库中断很久,binlog应用不连续,监控并及时修复主从7、从库启用了诸如存储过程,从库禁用存储过程等8、数据库大小版本/分支版本导致数据不一致?,主从版本统一9、备份的时候没有指定参数 例如mysqldump --master-data=2 等10、主从sql_mode 不一致11、一主二从环境,二从的server id一致12、MySQL自增列 主从不一致13、主从信息保存在文件里面,文件本身的刷新是非事务的,导致从库重启后开始执行点大于实际执行点14、采用5.6的after_commit方式半同步,主库当机可能会引起主从不一致,要看binlog是否传到了从库15、启用增强半同步了(5.7的after_sync方式),但是从库延迟超时自动切换成异步复制 二、预防和解决的方案有: 1、master:innodb_flush_log_at_trx_commit=1&sync_binlog=12 、slave:master_info_repository="TABLE"&relay_log_info_repository="TABLE"&relay_log_recovery=13 、设置从库库为只读模式4 、可以使用5.7增强半同步避免数据丢失等5 、binlog row格式6 、必须引定期的数据校验机制7 、当使用延迟复制的时候,此时主从数据也是不一致的(计划内),但在切换中,不要把延迟从提升为主库哦~8 、mha在主从切换的过程中,因主库系统宕机,可能造成主从不一致(mha本身机制导致这个问题) 2018年6月11日,周一 你为什么会决定进行分库分表,分库分表过程中遇到什么难题,如何解决的? 一、为什么决定进行分库分表? 1 、根据业务类型,和业务容量的评估,来选择和判断是否使用分库分表2 、当前数据库本事具有的能力,压力的评估3 、数据库的物理隔离,例如减少锁的争用、资源的消耗和隔离等4 、热点表较多,并且数据量大,可能会导致锁争抢,性能下降5 、数据库的高并发,数据库的读写压力过大,可能会导致数据库或系统宕机6 、数据库(MySQL5.7以下)连接数过高,会增加系统压力7 、单表数据量大,如SQL使用不当,会导致io随机读写比例高。查询慢(大表上的B+树太大,扫描太慢,甚至可能需要4层B+树)8 、备份和恢复时间比较长 二、都遇到什么问题? 1 、全局pk(主键和唯一索引)的冲突检测不准确,全局的自增主键支持不够好2 、分片键的选择。如没有选择好,可能会影响SQL执行效率3 、分布式事务,中间价产品对分布式事务的支持力度4 、对于开发来说,需要进行业务的拆分5 、对于开发来说,部分SQL不兼容则需要代码重构,工作量的评估6 、对于开发来说,跨库join,跨库查询 三、如何解决? 1 、使用全局分号器。或者使用全局唯一id,(应用生成顺序唯一int类型做为全局主键)2 、应用层来判断唯一索引3 、配合应用选择合适的分片键,并加上索引4 、配合应用,配合开发,对不兼容SQL的进行整改 2018年6月12日,周二 MySQL高可用架构应该考虑什么? 你认为应该如何设计? 一、MySQL高可用架构应该考虑什么? 1 、对业务的了解,需要考虑业务对数据库一致性要求的敏感程度,切换过程中是否有事务会丢失2 、对于基础设施的了解,需要了解基础设施的高可用的架构。例如 单网线,单电源等情况 3 、对于数据库故障时间掌握,业务方最多能容忍时间范围,因为高可用切换导致的应用不可用时间4 、需要了解主流的高可用的优缺点:例如 MHA/PXC/MGR 等。5 、考虑多IDC多副本分布,支持IDC级别节点全部掉线后,业务可以切到另一个机房 二、你认为应该如何设计? 1 、基础层 和基础运维部门配合,了解和避免网络/ 硬盘/ 电源等是否会出现单点故障 2、应用层 和应用开发同学配合,在关键业务中记录SQL日志,可以做到即使切换,出现丢事务的情况,也可以通过手工补的方式保证数据一致性,例如:交易型的业务引入状态机,事务状态,应对数据库切换后事务重做 3、业务层 了解自己的应用,根据不同的应用制定合理的高可用策略。 4 、单机多实例 环境及基于虚拟机或容器的设计不能分布在同一台物理机上。 5 、最终大招 在数据库不可用 ,可以把已提及的事务先存储到队列或者其他位置,等数据库恢复,重新应用 2018年6月13日,周三 MySQL备份,使用xtrabackup备份全实例数据时,会造成锁等待吗?那么如果使用mysqldump进行备份呢? 一、xtrabackup和mysqldump会造成锁等待吗? 1 、xtrabackup会,它在备份时会产生短暂的全局读锁FTWL(flush table with read lock),用于拷贝frm/MYD/MYI等文件,以及记录binlog信息。如果MyISAM表的数据量非常大,则拷贝时间就越长,加锁的时间也越长2、mysqldump有可能会。如果只是添加 --single-transacton 选项用于保证备份数据一致性,这时就不会产生FTWL锁了。但通常我们为了让备份文件和binlog保持一致,通常也会设置 --master-data 选项用于获得当前binlog信息,这种情况也会短暂加锁3 、数据量特别大的话,建议优先用 xtrabackup,提高备份/恢复速度。而如果数据量不是太大或者想备份单表,则建议用mysqldump了,方便逻辑恢复。各有利弊,注意其适用场景 二、xtrabackup冷知识 1 、基于MySQL 5.6版本开发的xtrabackup,会在备份过程中生成内部通信文件 suspend file,用于 xtrabackup 和 innobackupex 的通信,备份结束后文件删除,默认文件位置 /tmp/xtrabackup_suspended 2 、如果在备份过程中,修改了 /tmp 的访问权限或该文件的权限,则两个程序间直接不能通信,会造成 xtrabackup hang 住,正在备份的表不能正常释放锁,会造成锁等待,此时需要强制 kill 掉 xtrabackup 进程 2018年6月15日,周五 MySQL 5.7开始支持JSON,那还有必要使用MongoDB存JSON吗?请列出你的观点/理由。 一、观点A:支持MySQL存储JSON 1 、MongoDB不支持事务,而MySQL支持事务2 、MySQL相对MongoDB而言,MySQL的稳定性要优于MongoDB3 、MySQL支持多种存储引擎 二、观点B:支持MongoDB存储JSON 1 、从性能的角度考虑,对于JSON读写效率MongoDB要优于MySQL2 、MongoDB相对MySQL而言,MongoDB的扩展性要优于MySQL3 、MongoDB支持更多的JSON函数 三、总结 1 、如果应用程序无事务要求,存储数据表结构复杂并且经常被修改, 例如游戏中装备等场景用MongoDB比较适合2 、如果应用程序有事务要求,存储数据的"表"之间相互有关联,例如有订单系统等场景用MySQL比较合适3 、整体来看相对看好MySQL的JSON功能,在未来官方的努力下MySQL的JSON功能有机会反超MongoDB 2018年6月17日,周日 当数据被误删除/误操作后造成数据丢失。你尝试过用什么手段来挽救数据/损失? 一、前提 1 、当数据被误删除/误操作后,第一时间要关闭数据库。业务方需要紧急挂停机公告,避免数据二次污染,用于保护数据的一致性2 、BINLOG格式为ROW格式,不讨论其他格式的BINLOG 二、数据被误操作(update/delete/drop)造成数据丢失,可以用哪些手段来恢复? 1 、BINLOG恢复:可以使用逆向解析BINLOG工具来恢复。例如:binlog2SQL等2 、延迟从库: 可以通过解除延迟从库,并指定BINLOG结束位置点,可以实现数据恢复 三、数据被误删除(rm/物理文件损坏)造成数据丢失,可以用哪些手段来恢复? 1 、如果有备份,可以通过备份恢复 mysqldump/xtrabackup + binlog 来实现全量+增量恢复2 、如果无备份但是有从库,可以通过主从切换,提升从库为主库,从而实现数据恢复3 、如果无备份并且无从库,但MySQL没有重启,可以通过拷贝/proc/$pid/fd中的文件,来进行尝试恢复4 、如果无备份并且无从库,但MySQL有重启,可以通过extundelete或undrop-for-innodb来恢复 2018年6月19日,周二 MySQL 5.7的复制架构,在有异步复制、半同步、增强半同步、MGR等的生产中,该如何选择? 一、生产环境中: 几种复制场景都有存在的价值。下面分别描述一下: 1 、从成熟度上来选择,推荐:异步复制(GTID+ROW)2 、从数据安全及更高性能上选择:增强半同步 (在这个结构下也可以把innodb_flush_log_trx_commit调整到非1, 从而获得更好的性能)3、对于主从切换控制觉的不好管理,又对数据一致性要求特别高的场景,可以使用MGR 二、理由: 1 、异步复制,相对来讲非常成熟,对于环境运维也比较容易上手 2 、增强半同步复制,可以安全的保证数据传输到从库上,对于单节点的配置上不用要求太严格,特别从库上也可以更宽松一点,而且在一致性和性能有较高的提升,但对运维上有一定的要求3 、MGR组复制。相对增强半同步复制,MGR更能确保数据的一致性,事务的提交,必须经过组内大多数节点(n/2+1)决议并通过,才能得以提交。MGR架构对运维难度要更高,不过它也更完美 总的来讲,从技术实现上来看:MGR> 增强半同步>异步复制。 未来可能见到更多的MGR在生产中使用,对于MySQL的运维的要求也会更上一层楼。

优秀的个人博客,低调大师

《叶问》第6期

2018年7月26日,周四 专访黄炎:MySQL中间件的性能测试和常规业务性能测试相比有什么不同? 1、性能测试的方法论基本都一样, 以“观察-分析-改进-再观察”这个循环进行。2、常规业务由于业务交互复杂、技术栈庞杂、性能瓶颈通常集中于业务, 性能测试使用的分析方法比较简单, 通过诊断业务通常可以低成本地找到性能瓶颈。3、MySQL中间件的应用场景比较简单、技术栈稳定、性能瓶颈通常集中于架构和环境, 性能测试使用的分析方法比较多, 对性能瓶颈的分析通常成本比较高. 另外在这一方面的现有知识积累并不很成体系, 也是成本较高的原因之一。 2018年8月2日,周四 《全方位认识SYS系统库》公开课精彩互动问答: 1、为什么我用root用户调用call ps_setup_enable_instrument('wait');报错说存储过程不存在? 1、答:sys schema是从MySQL 5.7之后才默认支持,请确保你的数据库版本正确,且先使用use语句切换默认数据库,否则请带上 sys.库名称限定前缀。 2、myisam锁如何查询? 1、答:MyISAM 不支持事务,所以不存在事务锁,但可以查询表级锁(例如:MDL锁),通常表级锁是Server层添加的锁,与具体的存储引擎无关,所以与InnoDB存储引擎查询方法一致,建议多多尝试即可得出答案。 3、为什么我查询session系统表,当前正在执行SQL的会话的progress为 NULL 呢? 1、答:对于progress信息,仅支持stages事件(performance_schema.setup_instruments表的name字段以stages开头的采集项),其他事件类型不支持,且就算是stages类型事件,也不是所有的采集项都支持,可以通过观察performance_schema.events_stages_current表的WORK_COMPLETED和WORK_ESTIMATED字段,需要不为NULL值,progress信息就是根据这些不为NULL的值进行计算的 注意:要成功采集stages性能数据,必须打开stages事件相关的instruments和consumers如果不满足以上条件,session视图查询到的progress字段就会显示NULL。 4、线上数据库,开启ps和关闭ps功能,mysqld使用的内存会相差20G,可以判断ps会用到很多主机内存。怎么判断ps功能回来多少内存?怎么进行优化ps对内存的使用? 1、答:ps的整体功能无法动态开关,必须在数据库启动之前就设置好,能够动态开关的只是ps的具体的instruments采集项和consumers存储表,对于查询ps使用的内存总量,可以使用语句 select sys.format_bytes(sum(current_alloc)) from sys.x$memory_global_by_current_bytes where event_name like 'memory/performance_schema%'; 查询,对于ps内存使用的优化,MySQL 提供了一系列performance_schema打头的系统变量来进行灵活配置,请根据需要自行调整,默认情况下不建议调整,除非你真的需求,否则就会浪费内存空间。 2018年8月7日,周二 在MySQL中如果发现乱码的情况该如何判断原因及应对? 1、直接修改法. alter或者pt-osc等其他工具直接对数据进行修改。2、备份修改法. 利用mysqldump或者其他逻辑备份进行备份,备份的结果集再利用iconv进行转换3、跳过字符集备份.利用mysqldump备份的时候跳过字符集-t --skip-set-charset。在恢复的时候指定表的字符集。 那么应该如何避免乱码呢? 1、首先要从应用端到MySQL,采用统一编码格式。2、在MySQL的配置中,指定编码格式。3、在上线或者导入SQL的时候,要注意本地的编码集。

优秀的个人博客,低调大师

《叶问》第5期

2018年7月17日,周二 MongoDB高并发写场景开启读写分离读从库为何阻塞? 我们该如何处理? 1、按业务拆分逻辑降低读写并发度2、添加分片均衡读写 3、升级至即将到来的4.0通过读snapshot解决从库读阻塞 2018年7月19日,周四 MongoDB 4.0有哪些新特性,你最期待的有哪些,为什么? 1、多文档事务的支持,解决了多文档操作的原子性问题2、snapshot读相关支持,使得可在某个timestamp点上读到一个一致性的快照3、Change Streams 支持实例及库级别粒度为业务提供了更多实时捕获变更的选择4、聚合框架支持类型转换及字符前后空格截断操作5、加入对SCRAM-SHA-256认证策略以支持更强的认证加密验证6、提供通过简单的命令开启免费监控功能7、更多的操作支持w:majority 比如对集合进行分片,创建删除集合等8、listCollections 可以指定nameOnly:true 而不加锁9、增加 rollbackTimeLimitSecs参数控制节点回滚的最大时间限制10、支持直接在mongos路由节点直接kill具体操作无需按分片进行11、使用WiredTiger引擎不允许关闭journal日志 2018年7月24日,周二 Redis如何获取所有的key,不阻塞? 1、在slave上执行Save命令,拷贝rdb文件到其他redis实例上用于统计key。 2、可以利用scan命令,来遍历当前数据库中的数据库键。、 2018年7月26日,周四 MySQL中间件的性能测试和常规业务性能测试相比有什么不同? 1、性能测试的方法论基本都一样,以观察-分析-改进-再观察这个循环进行。2、常规业务由于业务交互复杂、技术栈庞杂、性能瓶颈通常集中于业务, 性能测试使用的分析方法比较简单, 通过诊断业务通常可以低成本地找到性能瓶颈。3、MySQL中间件的应用场景比较简单、技术栈稳定、性能瓶颈通常集中于架构和环境, 性能测试使用的分析方法比较多, 对性能瓶颈的分析通常成本比较高。另外在这一方面的现有知识积累并不很成体系, 也是成本较高的原因之一。

优秀的个人博客,低调大师

《叶问》第4期

2018年7月4日,周三 如何优化Linux操作系统用于MySQL环境? 一、初级玩法 1、在BIOS及内核层面关闭NUMA 2、在BIOS层面将CPU、内存均设置最大性能模式 3、 在BIOS层面关闭CPU节能模式 4、修改IO Scheduler为deadline 或 noop 5、使用xfs文件系统,挂载选项noatime、nodiratime、nobarrier 6、在内核层面设置vm.swappiness<=5,vm.dirty_ratio<=10, vm.dirty_background_rati<=5 7、在内核层面修改用户可最大打开文件数和线程数为65535 8、禁用SWAP分区 二、高端玩法 1、使用最新稳定Linux发行版 2、升级各个硬件设备到最新稳定firmware版本 3、 使用SSD时,开启TRIM功能,并且可以的话文件系统block size和SSD对齐 4、 当磁盘I/O存在瓶颈时,除了常规因素外,还需要关注中断不均衡的可能性 2018年7月5日,周四 MySQL 8.0 InnoDB哪些新特性你最期待,为什么? 1、数据字典全部采用InnoDB引擎存储,支持DDL原子性、crash safe,metadata管理更完善 2、快速在线加新列(腾讯互娱DBA团队贡献) 3、并行redo log,并提升redo log的I/O性能 4、新增倒序索引 5、 增强CBO特性 6、消除了buffer pool mutex(Percona的贡献) 7、 自增ID持久化 8、行锁增加SKIP LOCKED和NOWAIT特性选项 9、 新增事务CATS特性,大大提升事务性能(Michigan大学贡献) 10、 memcached plugin增强 11、 增强JSON性能、功能 12、 新增智能选项 innodb_dedicated_server 2018年7月5日,周四 MySQL hang的原因有哪些? 1、MySQL使用资源过高导致服务器太累扛不住。例如CPU、内存、 I/O等开销。 2、磁盘无可用空间。 3、MySQL频繁的创建和销毁连接。 4、 MySQL使用的最大文件打开数和连接数,超过了操作系统的限制。 5、MySQL的锁不能有效的释放。例如持有行锁或者表锁,造成了MDL等待。 6、MySQL的bug导致的。 7、导致MySQL hang住的原因有很多,不局限于上述因素,还需要机智的你来挖掘。 2018年7月12日,周四 专访王晓伟老师,MySQL数据导入数据仓库(Hadoop)有哪几种方式? 1、传统方式,采用mysqldump等工具将数据文件上传至HDFS 2、使用Sqoop Kettle等ETL工具,将数据表对应导入Hive的数据表 3、 使用kafka+flume方案,将mysql binlog通过流式采集的方式导入Hadoop 4、 设计实现Hive的快照表、增量表、全量表,实现MySQL到Hive数据的增量导入,并支持分库分表等特性。

优秀的个人博客,低调大师

探索式测试的18问

一、探索式测试的范围 1.探索式测试是不是就是一种黑盒的测试?显然探索式测试不区分黑盒还是白盒,可以用在任何一个测试里面,但是它需要我们更加理解产品,去产品内部理解产品的设计细节,才能发现一些更深层次的、隐蔽的问题。 2.探索式测试能不能用于硬件上?理论上来说,纯硬件是很难做探索式测试的,脚本测试都很难,硬件一般我们关注的是行数验证,硬件的老化测试,但是硬件上的软件是可以用探索式测试的。对纯硬件进行某一领域的探索式测试,如果造成了损坏,结果往往是不可逆的。 3.探索式测试怎么融入用户体验测试?探索式测试是一种 Test Style,不会局限于哪一种测试,把用户体验测试融入探索式测试就可以。 4.ET(探索式测试)主导和ST(基于测试用例的测试方法)辅助的探索式测试方法适合什么类型的项目?我们牢牢抓住探索式测试更灵活、适应性强、不需要编制繁杂的测试用例、鼓励测试人员探索出难以发现的问题等特点,所以就能得出ET主导和ST辅助的探索式测试方法适用于: 采用MVP模式的敏捷项目。 在Bug优先级定义中,出现的Bug不会是很高优先级且项目本身是中等类型的项目(因为特别高优先级的Bug往往是需要记录在规范的测试用例中以便审查的)。 离核心模块比较边缘的项目。 二、探索式测试的价值 5.探索式测试能够提供给团队什么帮助?探索式测试最大的特点就是机动性,通过探索式测试得出的结果,分析探索出来的缺陷密度,可以帮助调整团队的测试计划、测试策略以及测试设计,并且探索式测试可以分配到整个软件生命周期中。 6.做探索式测试的价值高吗,目前很多公司没有推行?有很多时候,在做了探索式测试之后,才会得到一些额外的测试用例,想要得到价值高的时候,那么它的价值就是很高的。为什么公司没有实行,因为有些公司对软件质量的要求不高,当一个软件的质量关乎重大利益的时候,对质量要求也很高的时候,那么探索式测试就很有价值,公司自然也会推行。 7.怎么在合理的时间内,进行有效的探索性测试,并且度量探索性测试的结果是合理并且是足够的?不管是敏捷模型还是瀑布模型,会有测试轮次的概念,第一轮会跑全链路的 Case,第二轮做 Bug 验证,第三轮会做全链路 Case 的回归;第一轮测试往往会用交叉测试的思路,这就是探索式测试的思路,在计划内、时间内去做探索性测试,做到什么样的程度是可控的;还有一个判断标准是,有没有在一个独立的 Session 内,到底有没有关注到很多探索式测试的执行,你关注到在探索式测试执行中后,你在这个 Session 内测了很多东西,即使没有发现 Bug 也没有关系,因为你知道自己测了什么,哪部分是没有问题的,然后根据自己的计划想停止就停止,不停止也可以,所以进行到哪种程度是和我们的测试模式是有关系的。 度量探索式测试做得好还是不好,Bug 和问题的产出可以来度量,但很难证明探索式测试的价值,从 Bug 产出的角度来看,不同实践方式做的探索式测试产出的 Bug 数量是不一样的,例如用ET主导、ST主导、Free Style的 ET,还是结对测试 BugBash 得出的 Bug 产出是不一样的;一个 Session 做完了,综合起来看 Bug 的数量、Issue 的数量,Test Note,Test Data 可以反映出一个价值。 三、探索式测试的前提条件 8.探索式测试对测试工程师的能力有什么特别的要求?探索式测试也要分阶段,这里的阶段包括对软件系统业务流以及数据流熟悉程度的不同阶段,还有测试设计能力的不同阶段,所以不要想到自己要做多么完美,把自己当前能力能做的探索式测试做好就行,每个阶段都可以做探索式测试。 9.探索式测试方法论比较依赖经验,是不是不适合新人?除了ET主导和ST辅助不适合新人以外,其它的方式新人都可以尝试学习,只要不把自己当新人,这些方法都可以去实践。 四、探索式测试怎么做 10.项目安排紧张,怎么保障足够的探索式测试?瀑布模型内做探索性测试,60-120分钟的时间都抽不出来,那就没办法做了,肯定是要抽一定时间来做探索式测试的,一个功能至少要进行两到三次探索式测试,还要进行功能与功能间结合式的探索;敏捷模式基本在敏捷开发中每个 Stage 都会做,在一张卡的各个阶段也会进行实施。 11.如何在大量回归测试过程中,进行探索式测试? 第一是先用交叉方式。 第二用 PI Testing(突变测试),可以缩小测试的范围,精确的测试该测的地方。 第三实在没有时间,那就用 Bug Bash 借助更多人的力量,不仅能 cover回归测试的范围,还可以找到一些测试范围以外的场景 case。 五、探索式测试的区别和优势 12.探索式测试和传统测试的区别是什么?依书中所言,从结果来看的话,传统测试流程和方法每小时发现 Bug 的数大概在0.2-0.3个,ET辅助和ST主导每小时大概在1.0左右,ST辅助和ET主导大概在1.5左右,Feel Style大概3个 Bug,其次探索式测试为了看系统是否能做超出既定期望的事,以及做了超出期望的事之后系统所做出的反应。 13.探索式测试和随机测试的区别以及探索式测试有什么优势?adhoc测试可以理解为错误猜测方法的升级版,随机测试没有那么聚焦的目的,探索式测试有明确的聚焦,发现 Bug 核心的影响力要比 adhoc 更大,探索式测试是抱着发现 Bug 的目的去做的,更重视UT。 14.探索式测试和混沌工程之间有什么联系和差异?没有关联,思路不同;混沌工程的核心就是故障注入,故障注入分系统层面、应用层面、中间键层面,断网,超时等一些破坏性测试,有日志级别的和代码级别的故障注入;做故障注入已经是知道这一块会出现故障,已经知道这里会设计怎样场景,探索式测试是不清楚情况,不断去探索,才会知道哪里可能有问题。 六、探索式测试的内容延伸 15.探索式测试跟我们的测试覆盖率是不是矛盾的?根本不矛盾,算测试覆盖率的时候我们要有明确的分母才能算出,如果探索式测试是保证每个功能都测试到了,那么我们的测试覆盖率就是100%;如果探索式测试的分母是整个测试用例集,是无法统计出测试覆盖率的。 16.活文档会花费 QA 较多时间来记录和管理吗?这个“活”字看大家怎么去理解,开发们的单元测试和 swagger 文档就是典型的例子,对于 QA 来说活文档是自动化测试代码的更改,要改其实和修改传统的测试用例一样的,花时间维护活文档带来的好处是会使活文档与产品代码保持一致性,并且及时提醒哪些文档错了需要修改,所以花时间去管理是很有意义的。 17.如何提高测试设计能力?首先要了解测试的基本理论,还要加深了解被测对象,然后去熟悉相关的测试类型所需要的测试知识和工具。 七、探索式测试的发展 18.探索式测试会越来越重要吗,它以后发展的趋势是怎么样的?国外是一种稳中求胜的趋势,在 Facebook 上都经常能看到很多探索式测试一些新奇的讨论;国内逐渐被自动化测试的声浪盖过去了,这个趋势跟大环境有关,其实有很多公司虽然说在做敏捷,其实并不是真正的敏捷,探索式测试做得很差,甚至不知道如何实施探索式测试,真正意义上在做敏捷的公司和项目,就会觉得探索式测试是真的很重要的,得到的回报往往在敏捷项目上反映得最明显(感觉作者也很认可敏捷)。 在我把这些问题总结出来然后去和前辈们交流的时候,有一些感悟,其实测试的本质就是对软件系统各个变量的单变量验证以及各种变量的组合验证,假设整个软件系统所有变量的组合结果为如图所示的空间几何体,已知的变量组合结果空间为S(可理解为我们期望软件系统能做和不能做的事,往往是故事卡上写的 AC),那么未知的变量空间区域为 S’(可理解为软件系统能不能做更多期望之外的事,以及做了更多不能做的事的反应),那么 S’就是我们要探索的一个领域。 在我们平常测试过程中,页面上的一个按钮、一个选择框其实就是一个变量,我们会去验证按钮和选择框各自的功能,也会去验证选择框加上按钮一起的组合功能,然后在这些变量上我们可能会去产生探索其他场景的想法;API的各个参数验证也是相同的道理。

优秀的个人博客,低调大师

2021年,十问云计算

刚刚过去的 2020 年是不平凡的一年,这一年,由于新冠疫情肆虐全球,云计算在这一年中展现出了巨大的优越性。 据 MariaDB 的一项调查显示,由于新冠疫情大流行,将近 40%的公司加快了业务向云的迁移。来自各行各业的企业都意识到,在历史上从未见过的大规模动荡之后,云计算的优势可以让企业在动荡中保持竞争力。2021 年将成为控制新冠疫情并使各行各业恢复常态的一年,因此,预计今年前半年,疫情的一些影响还将延续,一个主要特征将是大规模兴起的数字化经济。 从餐饮业到购物再到娱乐业,几乎所有国家都经历了由传统经营模式向数字化转型的过程。对于企业来说,这是一个巨大的机会,可以将更多的服务迁移到云平台中,并让大众使用。根据 IDC 的数据显示,仅在 2020 年第一季度,全球云 IT 基础设施支出就增长了 2.2%,而同期的整体 IT 支出则比上年下降了 16.3%。有了如此巨大的增长和预期的潜力,我们有理由对那些质疑云计算发展前景的声音进行反驳了。 以下是全球开发人员提出的云计算领域的十大问题,是时候揭开云计算的神秘面纱了。 1、云计算是否能像其所宣称的那样大大降低企业 IT 成本? 从长远的角度来看,云计算到底可以为企业节省多少成本,还需要进一步计算。但通过多年来的优化,云计算的确可以节省大量的运营成本。例如,使用 AWS 的 EC2 A1 实例,图像和照片共享平台 SmugMug 降低了约 40%的运营成本。三星的工程部门报告说,迁移到 AWS 来处理其 EPC 设计和信息管理可节省近 20%的费用。 2、在云上运行服务总是很便宜吗? 如前所述,云计算从长期来看开始显示其优越性。随着更多企业技术转移到云服务,与管理基础架构以在本地设置中运行它们相比,运营成本将大大降低。在内部运行一些应用程序在短期内似乎更便宜,但是随着业务的增长,更多部门将需要访问 IT 资源,这将增加保持内部 IT 支持企业所需的基础架构成本,需求增加。 3、我的数据在云上是否安全? 在云的最初阶段,安全性是一个严重的问题。但是,今天的云服务已经得到了极大的改善,现在部署了最新的防火墙和基于 AI 的智能安全监控,可以极大地提高安全性。如果云供应商加强了云服务的创新和市场调研,对于他们自身来说也大有裨益,这样也保证了数据的安全性。这比为您的技术堆栈选择内部托管更好。 4、云计算仅适用于科技公司吗? 云计算适合所有人。据 Gartner 报告显示,在所有高级业务领导人中,有 87% 的人将数字化作为组织中的一项重要计划。云计算是数字友好业务的核心,每个行业都有众多的参与者。受益于云计算的不仅仅是大公司或大型科技公司。如果企业需要更新社交媒体资料或在线检查银行对帐单,则说明这家企业正在使用托管在云上的应用程序。我们每天使用的大多数应用程序都是通过 Internet 连接访问的。 5、可以将云用于关键任务应用程序吗? 2019 年,美国五角大楼与 Microsoft Azure 签订了 100 亿美元的合同,将关键防御应用程序转移到安全的云环境中。Cerner 是世界上最大的医疗保健 ERP 供应商之一,它使用 AWS 来构建重要的临床信息管理服务,医生依靠该服务来每天挽救数百万患者的生命。这是两个引人注目的示例,它们表明云是任何关键任务服务的可靠选择。 6、云计算会减少内部的 IT 工作吗? 与任何新兴技术一样,云计算将为现有技术人员创造机会来提升技能并将其专业知识转移到新的领域。随着越来越多的企业转变为技术驱动型企业,未来几年对具有云技能的人员的需求将会增加。 7、迁移到云是否会导致停机时间延长? 微服务等现代技术架构与较新的部署和 DevOps 技术相结合,可确保企业在将业务服务迁移到云的同时几乎零停机时间。当诸如 Facebook 之类的社交媒体巨头升级其网络或引入新服务时,我们几乎不会注意到其在云中运行的系统的任何停机时间。任何云服务的情况都将类似。 8、云计算对于小型企业是否可行? 82% 的小型企业表示,在迁移到云时可以节省大量成本。在 2020 年新冠疫情肆虐之际,仅由底层云基础架构支持其数字优势,一些小型企业就可以保持竞争力。中小企业已经报告了生产力和敏捷性都有显著提高。 9、在迁移到云服务提供商时,对 IT 的控制权会减少吗? 现代云服务按照客户的条款运行,提供商没有虚拟锁定。迁移到云的企业将具有完全的灵活性来管理其应用程序、数据和策略,并可以按其规模扩大或缩小其云使用量。 10、通过迁移到云,企业组织会完全数字化吗? 云计算是数字化转型的基本支柱。但是,仅将现有技术转移到云中并不能保证完成全部的数字化转型。企业需要重新调整业务流程、工作流,并在战略上向企业中的每个部门引入在云上运行的新数字平台,以利用 IT 支出对企业的业务进行彻底的转变。 Gartner 报告称,到 2022 年,全球 IT 领域的支出中有近 28%或约 1.3 万亿美元将直接或间接归因于云的发展。无论您的企业规模或运营领域如何,云计算都是一个不错的选择。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册