首页 文章 精选 留言 我的

精选列表

搜索[AI可见性],共10000篇文章
优秀的个人博客,低调大师

C++ 线程池原理与实现:从零构建一个可复用的线程池

多线程程序里,频繁创建和销毁线程的开销并不小:每次创建线程都要分配栈空间、建立内核对象,销毁时还要回收。如果一个任务只需要几毫秒,而线程创建销毁就要花掉其中一大半时间,显然不划算。线程池(Thread Pool)就是为解决这个问题而生的:提前创建好一批工作线程,让它们循环从任务队列里取任务执行,任务提交方只负责"丢任务",完全不关心线程的生死。

优秀的个人博客,低调大师

WorkBuddy 实践:安全 PO 验收核对 Skill,让邮件、采购订单与客户表可审计地对上

在采购验收、项目交付和付款申请场景中,“核对 PO”看似只是比较金额,实际往往涉及多份材料:验收邮件、采购订单(PO)、客户确认表,以及不同版本的附件。人工处理时,最容易发生的问题不是不会算,而是证据链断裂、税额口径混用、分期比例错误,或者在公开演示时误带出客户信息。

优秀的个人博客,低调大师

构建可复核的媒体整理流水线:哈希去重、元数据抽取与模型标注

图片、录屏、短视频和扫描件一旦进入共享盘或个人资料库,整理成本通常并不来自“文件太多”,而来自三个不一致:同一内容有多份副本,文件名不表达业务含义,自动标签的依据又难以回看。直接把目录交给模型分类看似省事,却会带来更棘手的问题:重复文件被重复计费或重复处理;模型输出格式不稳定;敏感素材可能在未经审批时被发送到外部服务;以后发现分类错误,也无法判断是原文件、提示词还是模型配置导致。

优秀的个人博客,低调大师

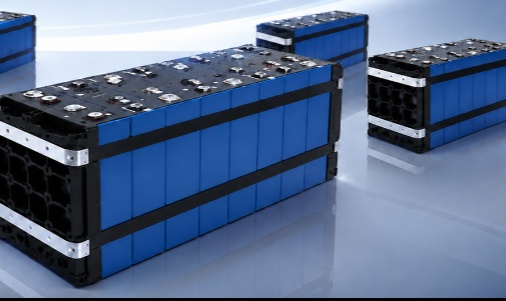
储能模组钢带加工设备的数据闭环架构:从高频丢包到工艺可复现

在动力电池与储能模组PACK自动化产线中,钢带作为模组结构件的核心承重件,其冲压、折弯与焊接成型精度直接决定了电芯入框间隙、模组结构强度以及最终激光焊接良率。当前行业量产标准已提升至厚度公差±0.05mm、折弯角度误差不超过±0.5°、端面毛刺低于0.02mm。2025年国内锂电配套钢带市场规模突破1270亿元,全年增速超35%,下游车型与储能舱规格碎片化趋势持续加剧。然而,在大量产线落地实践中,一个经典的技术困境反复出现:单台折弯设备的出厂重复定位精度达到±0.02mm,但整线成品装配间隙误差却漂移到±0.5mm以上。这种“单机达标、整线失控”的现象,本质上揭示了传统产线架构的系统性缺陷——自动化到位了,数字化没跟上。结合30余条钢带自动化产线的改造实测,现有传统三层单机架构——PLC加本地上位机加独立数据库——存在四类底层技术瓶颈,也是企业数字化改造失败、项目收益不达预期的核心原因。多工序误差的非线性累积。钢带从开卷整平、伺服冲切、多道折弯到激光焊接定型,通常经历五道以上核心工序。传统架构下,每道工序独立控制、独立检测,单道工序的微小偏差在串联传递中并非简单线性相加,而是受应力释放、热变形等因素呈非线性放大。我们在某产线做过逐站测量:折弯角度偏差0.5度,在后续焊接热输入后,末端捆扎位置偏移量超过激光焊缝跟踪的补偿极限,直接导致该批次模组间隙超标的返工率上升至12%。数据采集的时序断层。这是最隐蔽但破坏力最大的问题。整条产线通常集成8到12台异构设备,分属不同供应商,通信协议涵盖Modbus RTU、Profinet、OPC UA及各类私有TCP协议。传统OPC DA轮询式采集下,100Hz以上采样频率的丢包率超过5%,设备间数据时间戳偏差最高可达200ms。折弯工位的扭矩峰值、激光焊接的电流突变、冲切时的冲击振动等关键工艺信号大量丢失,工序间前馈补偿完全无法建立。回弹控制的“盲折”困局。钢带折弯的核心物理难点在于回弹。不同批次材料屈服强度——HV180到220区间——的波动,会导致回弹量产生1度以上的差异。传统产线依赖“首件测试加固定补偿”的离线策略,模具磨损和车间温湿度变化实时改变回弹特性,但产线没有任何反馈机制能捕捉这些变化。某次调试中我们发现,同一卷材料上午和下午的折弯回弹角偏差达到0.8度,仅仅因为车间温度上升了5℃。边缘算力的闲置与云端存储成本失控。多数产线部署的工控机仅承担PLC通讯与HMI展示功能,CPU利用率常低于15%。与此同时,单条产线200加传感点位、200Hz高频采集场景下,每日原始时序数据可达320GB,全量原始数据上传云端,月度存储与专线带宽成本提升400%以上。高频信号——如伺服驱动的扭矩反馈、冲切时的振动波形——恰恰是设备健康状态与工艺异常的敏感指示器,却因“存储成本高、分析价值不明确”被直接丢弃。针对上述痛点,核心设计思路是在MES与PLC之间引入边缘计算层,实现协议转换、数据预处理与实时控制的就地闭环,而非将所有数据裸传至云端。设备感知层:协议统一与高频采集。保留产线原有PLC、伺服驱动器、激光焊机、线扫视觉相机等全部硬件,通过工业交换机做协议汇聚,老旧串口设备搭配RS485转以太网网关统一接入。核心改动在PLC程序:将关键工艺变量的采集移至OB35循环中断块,周期设为5毫秒,通过OPC UA Pub/Sub主动推送数据,替代传统DA轮询模式。实测表明,这种推送机制将带宽消耗降低约60%,支持1kHz高频传感信号接入。同时为每件钢带产品分配RFID唯一编码作为全链路数据主键,从开卷到成品堆叠的所有工序数据全部绑定单品ID。边缘计算层:就地闭环与数据压缩。这是架构的核心,我们对比了三类主流工业边缘开源框架。EdgeX Foundry采用微服务模块化架构,原生适配Modbus、OPC UA等多协议,内存占用峰值不超过2.2G,无需容器集群运维,适配单产线独立边缘网关部署,是钢带产线的最优选型。KubeEdge依赖完整K8s集群,资源占用高,适合多车间大规模集群场景,单条产线部署成本冗余。EMQX仅为消息中间件,无协议解析、本地时序存储、工艺规则能力,需搭配多套组件二次开发,集成复杂度高。针对EdgeX原生无时序数据库的短板,搭配Apache IoTDB做本地存储。我们曾将50毫秒采样率的高频数据写入MySQL,单日数据量暴增至12GB,查询24小时张力曲线响应时间超过40秒,连接池频繁耗尽影响MES正常查询。迁移至IoTDB后,同样数据压缩至约800MB,压缩比15比1,查询响应时间缩短至800毫秒以内,单节点写入吞吐稳定支持每秒2万数据点。IoTDB的TsFile列式存储加Gorilla编码,压缩比可达15比1到18比1,单条产线每日产生的约318GB原始时序数据,经特征提取压缩后仅需上传云端27.5GB,压缩率超过90%。边缘层同时承载实时控制逻辑:冲切压力、折弯扭矩波形做滑动窗

优秀的个人博客,低调大师

企业舆情搜索工作台:用证据链、报告快照与查询预算支撑可交付结果

企业使用舆情系统,不只是为了看到几条相关内容,还要回答“这个结论来自哪里”“当时页面是什么样”“为什么纳入统计”“报告发送后数据是否发生变化”。如果搜索索引、原始快照和报告结果没有关联,分析员只能手工复制链接,审计人员也无法判断结论是否因后续页面变化而失真。

优秀的个人博客,低调大师

电池模组捆扎钢带产线数据闭环架构重构——从高频丢包到工艺可复现

动力电池与储能电池的规模化量产,对电芯模组捆扎钢带的加工精度与一致性要求越来越高。钢带作为模组结构固定的核心承重件,厚度公差、折弯精度直接影响电池包装配安全和服役寿命。2025年国内锂电配套钢带市场规模突破1270亿元,年增速超过35%,下游车型和储能舱规格碎片化趋势非常明显。我们当时接手的这条模组钢带自动成型产线,集成了开卷、整平、伺服冲切、多道折弯、激光焊接、视觉检测六大工序,需要覆盖0.5mm到2.0mm厚度、10mm到30mm宽度、200mm到2200mm长度全规格生产。行业量产标准要求厚度公差±0.05mm以内,折弯角度误差不超过±0.5°,端面毛刺低于0.02mm。但坦白说,行业里自动化产线普及率还不到40%,大量中小厂商靠半自动化单机组合生产,数字化基础相当薄弱。实际生产中有将近18%的电池模组装配性能波动,追根溯源就是钢带成型精度不一致,返工损耗常年卡在1.5%到3%之间。这套产线的数据系统设计,有几个让人头疼的问题。高频采集丢包太严重。整条产线8到12台异构设备,伺服折弯、激光焊机、线扫视觉、张力传感器分属不同厂家,原生协议有Modbus RTU、Profinet,还有私有串口协议。我们一开始用传统OPC DA轮询采集,折弯工位100Hz以上的扭矩和角度数据丢包率超过5%,冲切冲击瞬间和焊接电流峰值信号基本抓不到。设备之间没有统一校时,时间戳偏差最大能到200ms,工艺参数、运行数据、质检结果根本对不上号。有一次排查批次质量波动,光是拉齐各设备时间就耗了大半天。数据孤岛把工艺经验锁死了。每个工位设备各自存数据,没有一个统一的钢带编码串起来。同一款钢带不同设备不同班次的折弯补偿量、整平张力、激光功率参数散落各处,换型时只能靠人工抄配方本。更麻烦的是,核心工艺全凭老师傅手感调,不同班组调出来的参数差异不小,良品率在94%到98%之间来回晃。一个老师傅休假,某个规格的钢带不良率能直接翻倍。边缘算力闲置,带宽账单却飙涨。单条产线200多个传感点位,200Hz高频采集下一天原始数据就320GB。但我们现场那些工控机基本只跑PLC通讯和HMI展示,CPU利用率连15%都不到。与此同时,大量高频数据比如伺服扭矩反馈波形、冲切振动信号,因为存不起、分析价值说不清就被直接扔掉。可要是把原始数据全往云端推,一个月的专线和存储成本能翻四倍,财务那边直接找过来了。踩完这些坑之后我们想清楚了一个原则:不是所有数据都值得存,也不是所有计算都在云上做。核心思路是在边缘侧完成清洗和特征工程,采集、计算、存储三层彻底解耦。整体架构分三层:设备感知层、边缘计算层、云端管控层。设备层保留原PLC、伺服、视觉相机,通过工业交换机做协议汇聚。我们重构了PLC程序,在OB35里做5ms中断采集关键工艺变量,改用OPC UA Pub/Sub主动推数据,把轮询模式改掉之后带宽占用降了60%。同时给每件钢带分配RFID编码作为全链路主键,哪道工序出的问题一查就知道。边缘层是我们花精力最多的地方。选了EdgeX Foundry做微服务网关底座,按需加载Modbus、OPC UA、视觉图像驱动,完成多协议统一解析和PTP高精度校时。本地挂IoTDB存原始波形,再跑一个轻量Python特征提取服务做实时处理:对冲切压力、折弯扭矩波形做滑动窗口3σ滤波,提取峰值、积分、DTW曲线匹配特征,只把压缩后的特征标签往上送。我们在边缘层还嵌了一个本地规则引擎,实现工序前馈补偿、异常联动停机这些实时逻辑。断网也不怕,产线照跑不误。云端我们基于ThingsBoard搭轻量化管控中台,主要管三件事:统一工艺配方库、产线可视化看板、Cpk分析和预测性维护。云端只收边缘处理完的特征数据,承担批量模型训练和历史归档,往下发标准化钢带配方到各产线边缘节点。时序数据库选型时我们测了一圈,MySQL和InfluxDB都试过,最后选了Apache IoTDB。50ms采样率下一整天的数据量,MySQL要12GB,IoTDB压缩完就800MB,压缩比15比1。查24小时张力曲线,MySQL要40秒,IoTDB 800毫秒以内返回,这个差距在排查问题时体感非常明显。这套架构最终落地在华东一家新能源结构件配套厂,单条产线年产80万件捆扎钢带,供储能280Ah和动力50Ah两类模组。改造前折弯尺寸不良率1.8%,换型要4.5小时,设备稼动率只有63%。硬件上我们只加了两台4核8G工业边缘网关、8路RS485网关和全线RFID读写工位,原有设备全部利旧。软件基于开源搭,没花一分钱授权费。这里讲几个具体数据。采集质量。改之前100Hz采集丢包率5.2%,设备间时间偏差160到200毫秒。改完之后丢包率降到0.28%以下,全工位PTP同步偏差不超过8毫秒。折弯闭环补偿指令从采集到执行本地延迟22到45毫秒,完全满足毫秒级控制需求。边缘每天原始数据318GB,特征提取压缩后只往云端传27.5GB,压缩率

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册