首页 文章 精选 留言 我的

精选列表

搜索[AI搜索优化],共10000篇文章
优秀的个人博客,低调大师

全文搜索引擎Elasticsearch的安装过程

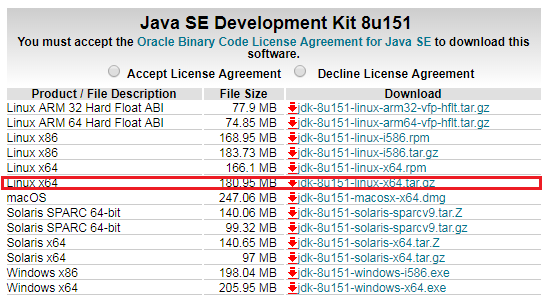
Elasticsearch是目前为止比较屌炸天的一款大数据日志收集工具,而且在很多知名大公司比如360、蚂蚁金服、京东、腾讯等都急需这方面的研究人才,在https://elasticsearch.cn/explore/category-12官方网站就有N多Elasticsearch招聘贴。 要安装Elasticsearch,需要在机器里先有java1.8+的环境,我这2个机器都是阿里云centos 7.4 64位纯净系统,配置是2核2G。 首先#yum -y update一波,更新一下最新的yum,在更新的时候呢,也不要干坐着,登陆http://www.oracle.com/technetwork/java/javase/downloads/jdk8-downloads-2133151.html ,下载最新的java安装包,我为了省事直接就选择的tar包,如图: 下载完并且上传之后,执行一下#rpm -qa | grep java,看一下有没有以前老的java,比如: 1 2 3 4 5 6 7 [root@chen-elk-001usr] #rpm-qa|grepjava java-1.7.0-openjdk-headless-1.7.0.51-2.4.5.5.el7.x86_64 python-javapackages-3.4.1-5.el7.noarch tzdata-java-2014b-1.el7.noarch javapackages-tools-3.4.1-5.el7.noarch java-1.7.0-openjdk-1.7.0 [root@chen-elk-001usr] # 如果有的话就#rpm -e --nodeps加上查询出的java名逐一删除掉java,比如: 1 2 [root@chen-elk-001usr] #rpm-e--nodepsjava-1.7.0-openjdk-headless-1.7.0.51-2.4.5.5.el7.x86_64 [root@chen-elk-001usr] #rpm-e--nodepsjava-1.7.0-openjdk-1.7.0 删除完毕之后,要#java -version检查一下是否已经不会出现版本了。 现在更新也更新完了,以前老的java也干掉了,那么就把jdk-8u151-linux-x64.tar.gz 拆包解压缩到/usr/local里,如图: 然后就#vim /etc/profile,在全文的末尾加上这样的内容: 1 2 3 4 5 6 #java1.8config JAVA_HOME= /usr/local/jdk1 .8.0_151#这里就是jdk1.8的那个路径,根据解压缩的位置而定 JRE_HOME=$JAVA_HOME /jre CLASSPATH=:$JAVA_HOME /lib/dt .jar:$JAVA_HOME /lib/tools .jar:$JRE_HOME /lib/dt .jar PATH=$PATH:$JAVA_HOME /bin :$JRE_HOME /bin export JAVA_HOMEJRE_HOMECLASSPATHPATH 保存退出之后,#source /etc/profile,然后#java -version看一下版本: java 1.8安装完毕,下面就是安装Elasticsearch,直接下载压缩包吧,比较简单暴力。 1 2 3 4 #wgethttps://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-5.5.1.zip #unzipelasticsearch-5.5.1.zip #cdelasticsearch-5.5.1/bin #./elasticsearch 启动之后,发现爆了一个错误,"Java HotSpot(TM) 64-Bit Server VM warning: INFO: os::commit_memory(0x000000008a660000, 1973026816, 0) failed; error='Cannot allocate memory' (errno=12)",如图: vim打开elasticsearch会看到下面这句话 1 #ES_JAVA_OPTS="-Xms8g-Xmx8g"./bin/elasticsearch 这个错误代表8G内存才可以启动elasticsearch,于是就升级到8G,这玩意的确是有钱人玩的东西。 升级之后,再次启动,出现了"can not run elasticsearch as root"这个错误: 既然不让root,那就建立一个新的用户吧: 1 2 3 4 5 roupaddelsearch useradd elsearch-gelsearch-pelasticsearch chown -Relsearch:elsearch/安装路径 /elasticsearch-5 .5.1 cd /安装路径 /elasticsearch-5 .5.1 /bin su elsearch. /elasticsearch 这样就看到正确启动的样子: 如果要后台启动的话,命令就是#su elsearch ./elasticsearch -d。如果你非要用root用户去启动的话,也不是不可以,命令是#./安装路径/bin/elasticsearch -Des.insecure.allow.root=true。 如果启动的时候,爆“max virtual memory areas vm.maxmapcount [65530] is too low”这个错误,那么就先运行如下命令:#sudo sysctl -w vm.max_map_count=262144。 如果启动的时候,爆“max file descriptors [65535] for elasticsearch process is too low, increase to at least [65536]”,那么#vim /etc/security/limits.conf,把文末内容改成这样,改完了之后#sysctl -p即可: 1 2 3 4 5 6 7 #Endoffile rootsoftnofile65535 roothardnofile65535 *softnofile165536 *hardnofile165536 *softnproc2048 *hardnproc4096 启动之后,在命令行里输入#curl localhost:9200,就会返回JSON 对象,包含当前节点、集群、版本等信息。 我这个Elasticsearch版本是5.11,中文教程https://elasticsearch.cn/book/elasticsearch_definitive_guide_2.x/ 已经有点老了,所以研究之路不仅充满荆棘还充满各种墙和英语... 参考资料:http://www.yiibai.com/elasticsearch/ 参考资料:http://www.cnblogs.com/Wolfmanlq/p/5984376.html 最后的最后,如果您觉得本文对您升职加薪有帮助,那么请不吝赞助之手,刷一下下面的二维码,赞助本人继续写更多的博文! 本文转自 苏幕遮618 51CTO博客,原文链接:http://blog.51cto.com/chenx1242/2043924

优秀的个人博客,低调大师

mapreduce实现搜索引擎简单的倒排索引

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/qq1010885678/article/details/44458825 使用hadoop版本为2.2.0 倒排索引简单的可以理解为全文检索某个词 例如:在a.txt 和b.txt两篇文章分别中查找统计hello这个单词出现的次数,出现次数越多,和关键词的吻合度就越高 现有a.txt内容如下: hello tom hello jerry hello kitty hello world hello tom b.txt内容如下: hello jerry hello tom hello world 在hadoop平台上编写mr代码分析统计各个单词在两个文本中出现的次数 其实也只是WordCount程序的改版而已~ 将两个文本上传到hdfs根目录的ii文件夹下(mr直接读取ii文件夹,会读取所有没有以_(下划线)开头的文件) 编写mr代码 首先分析,map输入的格式为 该行偏移量 该行文本 如: 0 hello 我们知道,map的输出之后会根据相同的key来进行合并 而每个单词都不是唯一的,它可能在两个文本中都出现,使用单词作为key的话无法分辨出该单词属于哪个文本 而使用文本名字作为key的话,那么将达到我们原来的目的,因为map的输出就会变成a.txt->单词..单词..单词 这显然不是我们想要的结果 所以map输出的格式应该为 单个单词->所在文本 1 如: hello->a.txt 1 这里用->作为单词和所在文本的分隔 这样就可以在根据key进行合并的时候不会影响到我们的结果 map代码如下: public static class MyMapper extends Mapper<LongWritable, Text, Text, Text> { private Text k = new Text(); private Text v = new Text(); protected void map( LongWritable key, Text value, org.apache.hadoop.mapreduce.Mapper<LongWritable, Text, Text, Text>.Context context) throws java.io.IOException, InterruptedException { String[] data = value.toString().split(" "); //FileSplit类从context上下文中得到,可以获得当前读取的文件的路径 FileSplit fileSplit = (FileSplit) context.getInputSplit(); //文件路径为hdfs://hadoop:9000/ii/a.txt //根据/分割取最后一块即可得到当前的文件名 String[] fileNames = fileSplit.getPath().toString().split("/"); String fileName = fileNames[fileNames.length - 1]; for (String d : data) { k.set(d + "->" + fileName); v.set("1"); context.write(k, v); } }; } 在map执行完毕之后 我们需要一个combiner来帮助完成一些工作 注意,combiner的输入格式和输出格式是一致的,也就是map的输出格式,否则会出错 再次分析,根据key合并value之后的键值对是这个样子的: (hello->a.txt,{1,1,1,1,1}) combiner要做的工作就是讲values统计累加 并将key的单词和文本分隔开,将文本名和统计之后的values组合在一起形成新的value 如: (hello,a.txt->5) 为什么要这么做? 因为在combiner执行完毕之后 还会根据key进行一次value的合并,跟map之后的是一样的 将key相同的value组成一个values集合 如此一来,在经过combiner执行之后,到达reduce的输入就变成了 (hello,{a.txt->5,b.txt->3}) 这样的格式,然后在reduce中循环将values输出不就是我们想要的结果了吗~ combiner代码如下: public static class MyCombiner extends Reducer<Text, Text, Text, Text> { private Text k = new Text(); private Text v = new Text(); protected void reduce( Text key, java.lang.Iterable<Text> values, org.apache.hadoop.mapreduce.Reducer<Text, Text, Text, Text>.Context context) throws java.io.IOException, InterruptedException { //分割文件名和单词 String[] wordAndPath = key.toString().split("->"); //统计出现次数 int counts = 0; for (Text t : values) { counts += Integer.parseInt(t.toString()); } //组成新的key-value输出 k.set(wordAndPath[0]); v.set(wordAndPath[1] + "->" + counts); context.write(k, v); }; } 接下来reduce的工作就简单了 代码如下: public static class MyReducer extends Reducer<Text, Text, Text, Text> { private Text v = new Text(); protected void reduce( Text key, java.lang.Iterable<Text> values, org.apache.hadoop.mapreduce.Reducer<Text, Text, Text, Text>.Context context) throws java.io.IOException, InterruptedException { String res = ""; for (Text text : values) { res += text.toString() + "\r"; } v.set(res); context.write(key, v); }; } main方法代码: public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); FileSystem fs = FileSystem.get(conf); Path inPath = new Path("hdfs://hadoop:9000" + args[0]); Path outPath = new Path("hdfs://hadoop:9000" + args[1]); if (fs.exists(outPath)) { fs.delete(outPath, true); } Job job = Job.getInstance(conf); job.setJarByClass(InverseIndex.class); FileInputFormat.setInputPaths(job, inPath); job.setInputFormatClass(TextInputFormat.class); job.setMapperClass(MyMapper.class); job.setMapOutputKeyClass(Text.class); job.setMapOutputValueClass(Text.class); job.setCombinerClass(MyCombiner.class); job.setReducerClass(MyReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(Text.class); FileOutputFormat.setOutputPath(job, outPath); job.setOutputFormatClass(TextOutputFormat.class); job.waitForCompletion(true); } 在hadoop上运行jar包执行结果如图: 初学hadoop,仅作笔记之用,其中如有错误望请告知^-^


优秀的个人博客,低调大师

# #WorkBuddy# 每天早上 7:30,AI 自动帮我搜索全球财经新闻并发到邮箱——WorkBuddy 定时自动化 + Agent Mail 实战教程

本文记录了我用 WorkBuddy 搭建「每日全球财经早报自动分发系统」的完整过程。从零开始配置定时任务、编写信息检索 Prompt、接入 Agent Mail 发送 HTML 邮件,到调试收件人列表,全流程可复现。每天早上醒来,邮箱里已经躺着一份覆盖 8 大板块、25-30 条的财经早报,这种感觉确实不一样。

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册