首页 文章 精选 留言 我的

精选列表

搜索[多模态Agent],共10000篇文章
优秀的个人博客,低调大师

Manytree Mall v2.12.0 发布,多树开源

演示链接 商城 商城后台 登录中心 商城管理员测试账户(1):mall@duoshu.org密:root 普通测试账户(2):user1@duoshu.org密:root 登录中心超级管理员测试账户(3):superadmin@duoshu.org密:root 请勿删除任何数据,谢谢 更新日志 通用 移除了本地运行时对服务注册的依赖 添加了websocket通信模块,新订单创建后通知到管理员 mt-saga 代码重构,简化了分布式事务管理 mt-ui-admin 代码重构,简化了分布式事务管理 mt-ui-user 修复了公共URL返回403错误码

优秀的个人博客,低调大师

ShopWind 多商户商城 v3.4.1 正式发布

2022新的一年已经到来,ShopWind开源电商系统迎来了虎年的第一波更新,v3.4.1版本正式发布啦,大家来一起了解一下吧! 1.新增买家评价晒单功能、商品详情页插入店铺信息 2.新增商品头部信息和幻灯片效果,店铺商品列表支持瀑布流效果 3.商品详情页支持视频播放功能 4.商品列表页支持瀑布流效果,支持产品长图,浏览体验效果更佳 5.商品增加多个产品标识,新品、店长推荐、优惠券等促销标识 6.升级支付宝支付接口、微信支付APIv3接口(证书模式),支持退款原路返回 7.新增提现在线审核,即时提现到支付宝余额功能 8. 更多操作可以下载源码安装体验,或者登录官方演示站体验实地操作。有问题可以前往官方论坛进行交流。 前台体验:http://test.shopwind.net买家测试账号:buyer 密码:123456 支付密码:123456 后台体验:http://test.shopwind.net/admin平台管理员账号:admin 密码:123456 商家体验:http://test.shopwind.net/seller/login.html商家测试账号:seller 密码:123456 H5端体验:https://h5.shopwind.net买家测试账号:18978189192 密码:111111 支付密码:111111 微信小程序(手机浏览器点击链接):https://wxaurl.cn/VUdm2kw795s Android(安卓版)体验:https://appgallery.huawei.com/#/app/C103448437 iOS(苹果版)体验:https://apps.apple.com/cn/app/id1548625748 商家端体验(小程序):https://wxaurl.cn/gIG5wMZSOFc 通用体验账号:买家(账号:18978189192 密码:111111 支付密码:111111)、商家(账号:18978189171 密码:111111) 官方论坛:https://forum.shopwind.net ShopWind v3.4.1 更新日志(2022.02.14): 【新增】买家评价订单时可以晒图 【新增】移动端商铺主页 【新增】详情页显示最近买家评价信息 【新增】即时提现到支付宝余额功能 【新增】查看买家评价页 【新增】商品新品标识 【新增】移动端商品展示支持瀑布流效果 【新增】退款原路返回功能(支持支付宝和微信) 【升级】支付宝支付接口(证书模式) 【升级】微信支付APIv3接口 【升级】微信小程序登录接口(微信getUserInfo接口变更) 【优化】提现银行卡数据表字段 【优化】移动端支付方式传值 【优化】商品价格货币化显示方式 【优化】在线支付订单不再额外新增财务收支记录 【优化】商品评价页好中差评传值 【优化】充值到余额返现逻辑 【优化】我的钱包账户内余额转账逻辑 【优化】余额提现页面效果 【修复】后台订单编号可修改的问题 【修复】移动端商品详情页商品属性弹窗显示异常 【修复】商品评价统计数据有误的问题 【修复】优惠券在多个订单可重复使用的问题

优秀的个人博客,低调大师

DataGrip 2021.1.3 发布,多引擎数据库平台

DataGrip 2021.1.3 现已发布,这是 DataGrip 2021.1 的第三个错误修复版本。 主要更新内容 处于安全方面的考虑,Java 放弃了对 TLSv1 和 TLSv1.1 协议的使用。这会在连接到只接受这些协议的旧服务器出现问题。作为修复,DataGrip 现在提供了明确打开这些协议的能力,不过用户需要记住,这样做会导致一些漏洞问题 即使数据库支持 TLSv1.2 和 TLSv1.3 协议,连接到 MySQL 也可能出现问题。由于服务器端的错误,驱动程序禁用了对这些版本的 TLSv1.2 和 TLSv1.3 支持。用户可以尝试启用它们。但如果服务器返回一个 "bad handshake" 的错误,请禁用这些版本 代码完成现在可以在修改表中工作,即使案例不匹配 [SQL Server] 生成的 DDL 中不包含扩展属性 [Oracle] Introspection 与版本 9i 兼容 详情请查看更新公告。

优秀的个人博客,低调大师

MyBatis映射器(一)--多参数传递方式

在mybatis映射器的接口中,一般在查询时需要传递一些参数作为查询条件,有时候是一个,有时候是多个。当只有一个参数时,我们只要在sql中使用接口中的参数名称即可,但是如果是多个呢,就不能直接用参数名称了,mybatis中有以下四种 第一种:使用map传递 1⃣️定义接口 1//使用map传递多个参数进行查询 2publicListgetByMap(MapparamMap); 2⃣️sql语句 1 23SELECT*FROMproduct 4WHEREproduct_nameLIKEconcat('%',#{name},'%')AND 5CAST(product_priceASINT)>#{price} 6 需要注意的有: 1、parameterType参数类型为map(此处使用别名) 2、参数名称是map中的key 3⃣️查询 1/** 2*通过map传递多个参数 3* 4*@return 5*/ 6publicvoidgetProductsByMap(){ 7System.out.println("使用map方式传递多个参数"); 8Listproducts=newArrayList<>(); 9MapparamMap=newHashMap<>(); 10paramMap.put("name","恤"); 11paramMap.put("price",200); 12sqlSession=MybatisTool.getSqlSession(); 13productMapper=sqlSession.getMapper(ProductMapper.class); 14products=productMapper.getByMap(paramMap); 15printResult(products); 16} 4⃣️查看结果 1使用map方式传递多个参数 2T恤2的价格是230元 3T恤3的价格是270元 4T恤4的价格是270元 这种方式的缺点是: 1、map是一个键值对应的集合,使用者只有阅读了它的键才能知道其作用; 2、使用map不能限定其传递的数据类型,可读性差 所以一般不推荐使用这种方式。 第二种:使用注解传递 1⃣️创建接口 1//使用注解传递多个参数进行查询 2publicListgetByAnnotation(@Param("name")Stringname,@Param("price")intprice); 2⃣️定义sql 1 23SELECT*FROMproduct 4WHEREproduct_nameLIKEconcat('%',#{name},'%')ANDCAST(product_price 5ASINT)> 6#{price} 7 这种方式不需要设置参数类型 ,参数名称为注解定义的名称 3⃣️查询 1/** 2*通过注解传递多个参数 3*/ 4publicvoidgetProductByAnnotation(){ 5System.out.println("使用注解方式传递多个参数"); 6Listproducts=newArrayList<>(); 7sqlSession=MybatisTool.getSqlSession(); 8productMapper=sqlSession.getMapper(ProductMapper.class); 9products=productMapper.getByAnnotation("恤",200); 10printResult(products); 11} 4⃣️查看结果 1使用注解方式传递多个参数 2T恤2的价格是230元 3T恤3的价格是270元 4T恤4的价格是270元 这种方式能够大大提高可读性,但是只适合参数较少的情况,一般是少于5个用此方法,5个以上九要用其他方式了。 第三种:使用javabean传递 此中方式需要将传递的参数封装成一个javabean,然后将此javabean当作参数传递即可,为了方便,我这里只有两个参数封装javabean。 1⃣️参数封装成javabean 1/** 2*定义一个Javabean用来传递参数 3*/ 4publicclassParamBean{ 5publicStringname; 6publicintprice; 7 8publicParamBean(Stringname,intprice){ 9this.name=name; 10this.price=price; 11} 12 13publicStringgetName(){ 14returnname; 15} 16 17publicvoidsetName(Stringname){ 18this.name=name; 19} 20 21publicintgetPrice(){ 22returnprice; 23} 24 25publicvoidsetPrice(intprice){ 26this.price=price; 27} 28} 2⃣️创建接口 1//使用JavaBean传递多个参数进行查询 2publicListgetByJavabean(ParamBeanparamBean); 3⃣️定义sql 1 23SELECT*FROMproduct 4WHEREproduct_nameLIKEconcat('%',#{name},'%') 5ANDCAST(product_priceASINT)>#{price} 6 需要注意的是: 1、参数类型parameterType为前面定义的javabean的全限定名或别名; 2、sql中的参数名称是javabean中定义的属性; 4⃣️查询 1/** 2*通过javabean传递多个参数 3*/ 4publicvoidgetProductByJavabean(){ 5System.out.println("使用javabean方式传递多个参数"); 6Listproducts=newArrayList<>(); 7sqlSession=MybatisTool.getSqlSession(); 8productMapper=sqlSession.getMapper(ProductMapper.class); 9ParamBeanparamBean=newParamBean("恤",200); 10products=productMapper.getByJavabean(paramBean); 11printResult(products); 12} 5⃣️查看结果 1使用javabean方式传递多个参数 2T恤2的价格是230元 3T恤3的价格是270元 4T恤4的价格是270元 这种方式在参数多于5个的情况下比较实用。 第四种:使用混合方式传递 假设我要进行分页查询,那么我可以将分页参数单独封装成一个javabean进行传递,其他参数封装成上面的javabean,然后用注解传递这两个javabean,并在sql中获取。 1⃣️封装分页参数javabean 1/* 2*定义一个分页的javabean 3*/ 4publicclassPageParamBean{ 5publicintstart; 6publicintlimit; 7 8publicPageParamBean(intstart,intlimit){ 9super(); 10this.start=start; 11this.limit=limit; 12} 13 14publicintgetStart(){ 15returnstart; 16} 17 18publicvoidsetStart(intstart){ 19this.start=start; 20} 21 22publicintgetLimit(){ 23returnlimit; 24} 25 26publicvoidsetLimit(intlimit){ 27this.limit=limit; 28} 29 30} 2⃣️创建接口 1//使用混合方式传递多个参数进行查询 2publicListgetByMix(@Param("param")ParamBeanparamBean,@Param("page")PageParamBeanpageBean); 可以看出此处使用javabean+注解的方式传递参数 3⃣️定义sql 1 23SELECT*FROMproductWHERE 4product_nameLIKEconcat('%',#{param.name},'%')ANDCAST(product_price 5ASINT)> 6#{param.price}LIMIT#{page.limit}OFFSET#{page.start} 7 只要是注解方式,就不需要定义参数类型。 4⃣️查询 1/** 2*通过混合方式传递多个参数 3*/ 4publicvoidgetProductByMix(){ 5System.out.println("使用混合方式传递多个参数"); 6Listproducts=newArrayList<>(); 7sqlSession=MybatisTool.getSqlSession(); 8productMapper=sqlSession.getMapper(ProductMapper.class); 9ParamBeanparamBean=newParamBean("恤",200); 10PageParamBeanpageBean=newPageParamBean(0,5); 11products=productMapper.getByMix(paramBean,pageBean); 12printResult(products); 5⃣️查看结果 1使用混合方式传递多个参数 2T恤2的价格是230元 3T恤3的价格是270元 4T恤4的价格是270元 以上就是四种方式传递多个参数的实例。

优秀的个人博客,低调大师

DataGrip 2021.1.1 发布,多引擎数据库平台

DataGrip 2021.1.1 现已发布,这是 DataGrip 2021.1 的第一个错误修复版本。 主要更新内容 [Oracle] 可以从同义词导航到表格 [MySQL] datetime 单元格的默认日期现在是正确的 [BigQuery] 支持 CREATE/ALTER/DROP SCHEMA,TABLESAMPLE 和 EXPORT DATA [PostgreSQL,Redshift,Greenplum] 修复了自省问题,该问题影响了没有 CTID 列的表 [Redshift] 批处理模式现已启用,可导入 CSV 详情请查看更新公告。

优秀的个人博客,低调大师

“12306”的架构到底有多牛逼?

关注我们,设为星标,每天7:30不见不散,架构路上与您共享 回复"架构师"获取资源 作者丨绘你一世倾城 来源:https://juejin.im/post/5d84e21f6fb9a06ac8248149 “ 每到节假日期间,一二线城市返乡、外出游玩的人们几乎都面临着一个问题:抢火车票! 12306 抢票,极限并发带来的思考 虽然现在大多数情况下都能订到票,但是放票瞬间即无票的场景,相信大家都深有体会。 尤其是春节期间,大家不仅使用 12306,还会考虑“智行”和其他的抢票软件,全国上下几亿人在这段时间都在抢票。 “12306 服务”承受着这个世界上任何秒杀系统都无法超越的 QPS,上百万的并发再正常不过了! 笔者专门研究了一下“12306”的服务端架构,学习到了其系统设计上很多亮点,在这里和大家分享一下并模拟一个例子:如何在 100 万人同时抢 1 万张火车票时,系统提供正常、稳定的服务。 Github代码地址: https://github.com/GuoZhaoran/spikeSystem 大型高并发系统架构 高并发的系统架构都会采用分布式集群部署,服务上层有着层层负载均衡,并提供各种容灾手段(双火机房、节点容错、服务器灾备等)保证系统的高可用,流量也会根据不同的负载能力和配置策略均衡到不同的服务器上。 下边是一个简单的示意图: 负载均衡简介 上图中描述了用户请求到服务器经历了三层的负载均衡,下边分别简单介绍一下这三种负载均衡。 ①OSPF(开放式最短链路优先)是一个内部网关协议(Interior Gateway Protocol,简称IGP) OSPF 通过路由器之间通告网络接口的状态来建立链路状态数据库,生成最短路径树,OSPF 会自动计算路由接口上的 Cost 值,但也可以通过手工指定该接口的 Cost 值,手工指定的优先于自动计算的值。 OSPF 计算的 Cost,同样是和接口带宽成反比,带宽越高,Cost 值越小。到达目标相同 Cost 值的路径,可以执行负载均衡,最多 6 条链路同时执行负载均衡。 ②LVS (Linux Virtual Server) 它是一种集群(Cluster)技术,采用 IP 负载均衡技术和基于内容请求分发技术。 调度器具有很好的吞吐率,将请求均衡地转移到不同的服务器上执行,且调度器自动屏蔽掉服务器的故障,从而将一组服务器构成一个高性能的、高可用的虚拟服务器。 ③Nginx 想必大家都很熟悉了,是一款非常高性能的 HTTP 代理/反向代理服务器,服务开发中也经常使用它来做负载均衡。 Nginx 实现负载均衡的方式主要有三种: 轮询 加权轮询 IPHash轮询 下面我们就针对 Nginx 的加权轮询做专门的配置和测试。 Nginx 加权轮询的演示 Nginx 实现负载均衡通过 Upstream 模块实现,其中加权轮询的配置是可以给相关的服务加上一个权重值,配置的时候可能根据服务器的性能、负载能力设置相应的负载。 下面是一个加权轮询负载的配置,我将在本地的监听 3001-3004 端口,分别配置 1,2,3,4 的权重: #配置负载均衡upstreamload_rule{server127.0.0.1:3001weight=1;server127.0.0.1:3002weight=2;server127.0.0.1:3003weight=3;server127.0.0.1:3004weight=4;}...server{listen80;server_nameload_balance.comwww.load_balance.com;location/{proxy_passhttp://load_rule;}} 我在本地/etc/hosts 目录下配置了 www.load_balance.com 的虚拟域名地址。 接下来使用 Go 语言开启四个 HTTP 端口监听服务,下面是监听在 3001 端口的 Go 程序,其他几个只需要修改端口即可: packagemainimport("net/http""os""strings")funcmain(){http.HandleFunc("/buy/ticket",handleReq)http.ListenAndServe(":3001",nil)}//处理请求函数,根据请求将响应结果信息写入日志funchandleReq(whttp.ResponseWriter,r*http.Request){failedMsg:="handleinport:"writeLog(failedMsg,"./stat.log")}//写入日志funcwriteLog(msgstring,logPathstring){fd,_:=os.OpenFile(logPath,os.O_RDWR|os.O_CREATE|os.O_APPEND,0644)deferfd.Close()content:=strings.Join([]string{msg,"\r\n"},"3001")buf:=[]byte(content)fd.Write(buf)} 我将请求的端口日志信息写到了 ./stat.log 文件当中,然后使用 AB 压测工具做压测: ab-n1000-c100http://www.load_balance.com/buy/ticket 统计日志中的结果,3001-3004 端口分别得到了 100、200、300、400的请求量。 这和我在 Nginx 中配置的权重占比很好的吻合在了一起,并且负载后的流量非常的均匀、随机。 具体的实现大家可以参考 Nginx 的 Upsteam 模块实现源码,这里推荐一篇文章《Nginx 中 Upstream 机制的负载均衡》: https://www.kancloud.cn/digest/understandingnginx/202607 秒杀抢购系统选型 回到我们最初提到的问题中来:火车票秒杀系统如何在高并发情况下提供正常、稳定的服务呢? 从上面的介绍我们知道用户秒杀流量通过层层的负载均衡,均匀到了不同的服务器上,即使如此,集群中的单机所承受的 QPS 也是非常高的。如何将单机性能优化到极致呢? 要解决这个问题,我们就要想明白一件事: 通常订票系统要处理生成订单、减扣库存、用户支付这三个基本的阶段。 我们系统要做的事情是要保证火车票订单不超卖、不少卖,每张售卖的车票都必须支付才有效,还要保证系统承受极高的并发。 这三个阶段的先后顺序该怎么分配才更加合理呢?我们来分析一下: 下单减库存 当用户并发请求到达服务端时,首先创建订单,然后扣除库存,等待用户支付。 这种顺序是我们一般人首先会想到的解决方案,这种情况下也能保证订单不会超卖,因为创建订单之后就会减库存,这是一个原子操作。 但是这样也会产生一些问题: 在极限并发情况下,任何一个内存操作的细节都至关影响性能,尤其像创建订单这种逻辑,一般都需要存储到磁盘数据库的,对数据库的压力是可想而知的。 如果用户存在恶意下单的情况,只下单不支付这样库存就会变少,会少卖很多订单,虽然服务端可以限制 IP 和用户的购买订单数量,这也不算是一个好方法。 支付减库存 如果等待用户支付了订单在减库存,第一感觉就是不会少卖。但是这是并发架构的大忌,因为在极限并发情况下,用户可能会创建很多订单。 当库存减为零的时候很多用户发现抢到的订单支付不了了,这也就是所谓的“超卖”。也不能避免并发操作数据库磁盘 IO。 预扣库存 从上边两种方案的考虑,我们可以得出结论:只要创建订单,就要频繁操作数据库 IO。 那么有没有一种不需要直接操作数据库 IO 的方案呢,这就是预扣库存。先扣除了库存,保证不超卖,然后异步生成用户订单,这样响应给用户的速度就会快很多;那么怎么保证不少卖呢?用户拿到了订单,不支付怎么办? 我们都知道现在订单都有有效期,比如说用户五分钟内不支付,订单就失效了,订单一旦失效,就会加入新的库存,这也是现在很多网上零售企业保证商品不少卖采用的方案。 订单的生成是异步的,一般都会放到 MQ、Kafka 这样的即时消费队列中处理,订单量比较少的情况下,生成订单非常快,用户几乎不用排队。 扣库存的艺术 从上面的分析可知,显然预扣库存的方案最合理。我们进一步分析扣库存的细节,这里还有很大的优化空间,库存存在哪里?怎样保证高并发下,正确的扣库存,还能快速的响应用户请求? 在单机低并发情况下,我们实现扣库存通常是这样的: 为了保证扣库存和生成订单的原子性,需要采用事务处理,然后取库存判断、减库存,最后提交事务,整个流程有很多 IO,对数据库的操作又是阻塞的。 这种方式根本不适合高并发的秒杀系统。 接下来我们对单机扣库存的方案做优化:本地扣库存。 我们把一定的库存量分配到本地机器,直接在内存中减库存,然后按照之前的逻辑异步创建订单。 改进过之后的单机系统是这样的: 这样就避免了对数据库频繁的 IO 操作,只在内存中做运算,极大的提高了单机抗并发的能力。 但是百万的用户请求量单机是无论如何也抗不住的,虽然 Nginx 处理网络请求使用 Epoll 模型,c10k 的问题在业界早已得到了解决。 但是 Linux 系统下,一切资源皆文件,网络请求也是这样,大量的文件描述符会使操作系统瞬间失去响应。 上面我们提到了 Nginx 的加权均衡策略,我们不妨假设将 100W 的用户请求量平均均衡到 100 台服务器上,这样单机所承受的并发量就小了很多。 然后我们每台机器本地库存 100 张火车票,100台服务器上的总库存还是1 万,这样保证了库存订单不超卖,下面是我们描述的集群架构: 问题接踵而至,在高并发情况下,现在我们还无法保证系统的高可用,假如这 100台服务器上有两三台机器因为扛不住并发的流量或者其他的原因宕机了。 那么这些服务器上的订单就卖不出去了,这就造成了订单的少卖。 要解决这个问题,我们需要对总订单量做统一的管理,这就是接下来的容错方案。服务器不仅要在本地减库存,另外要远程统一减库存。 有了远程统一减库存的操作,我们就可以根据机器负载情况,为每台机器分配一些多余的“Buffer 库存”用来防止机器中有机器宕机的情况。 我们结合下面架构图具体分析一下: 我们采用 Redis 存储统一库存,因为 Redis 的性能非常高,号称单机 QPS 能抗 10W 的并发。 在本地减库存以后,如果本地有订单,我们再去请求 Redis 远程减库存,本地减库存和远程减库存都成功了,才返回给用户抢票成功的提示,这样也能有效的保证订单不会超卖。 当机器中有机器宕机时,因为每个机器上有预留的 Buffer 余票,所以宕机机器上的余票依然能够在其他机器上得到弥补,保证了不少卖。 Buffer 余票设置多少合适呢,理论上 Buffer 设置的越多,系统容忍宕机的机器数量就越多,但是 Buffer 设置的太大也会对 Redis 造成一定的影响。 虽然 Redis 内存数据库抗并发能力非常高,请求依然会走一次网络 IO,其实抢票过程中对 Redis 的请求次数是本地库存和 Buffer 库存的总量。 因为当本地库存不足时,系统直接返回用户“已售罄”的信息提示,就不会再走统一扣库存的逻辑。 这在一定程度上也避免了巨大的网络请求量把 Redis 压跨,所以 Buffer 值设置多少,需要架构师对系统的负载能力做认真的考量。 代码演示 Go 语言原生为并发设计,我采用 Go 语言给大家演示一下单机抢票的具体流程。 初始化工作 Go 包中的 Init 函数先于 Main 函数执行,在这个阶段主要做一些准备性工作。 我们系统需要做的准备工作有:初始化本地库存、初始化远程 Redis 存储统一库存的 Hash 键值、初始化 Redis 连接池。 另外还需要初始化一个大小为 1 的 Int 类型 Chan,目的是实现分布式锁的功能。 也可以直接使用读写锁或者使用 Redis 等其他的方式避免资源竞争,但使用 Channel 更加高效,这就是 Go 语言的哲学:不要通过共享内存来通信,而要通过通信来共享内存。 Redis 库使用的是 Redigo,下面是代码实现: ...//localSpike包结构体定义packagelocalSpiketypeLocalSpikestruct{LocalInStockint64LocalSalesVolumeint64}...//remoteSpike对hash结构的定义和redis连接池packageremoteSpike//远程订单存储健值typeRemoteSpikeKeysstruct{SpikeOrderHashKeystring//redis中秒杀订单hash结构keyTotalInventoryKeystring//hash结构中总订单库存keyQuantityOfOrderKeystring//hash结构中已有订单数量key}//初始化redis连接池funcNewPool()*redis.Pool{return&redis.Pool{MaxIdle:10000,MaxActive:12000,//maxnumberofconnectionsDial:func()(redis.Conn,error){c,err:=redis.Dial("tcp",":6379")iferr!=nil{panic(err.Error())}returnc,err},}}...funcinit(){localSpike=localSpike2.LocalSpike{LocalInStock:150,LocalSalesVolume:0,}remoteSpike=remoteSpike2.RemoteSpikeKeys{SpikeOrderHashKey:"ticket_hash_key",TotalInventoryKey:"ticket_total_nums",QuantityOfOrderKey:"ticket_sold_nums",}redisPool=remoteSpike2.NewPool()done=make(chanint,1)done<-1} 本地扣库存和统一扣库存 本地扣库存逻辑非常简单,用户请求过来,添加销量,然后对比销量是否大于本地库存,返回 Bool 值: packagelocalSpike//本地扣库存,返回bool值func(spike*LocalSpike)LocalDeductionStock()bool{spike.LocalSalesVolume=spike.LocalSalesVolume+1returnspike.LocalSalesVolume<spike.LocalInStock} 注意这里对共享数据 LocalSalesVolume 的操作是要使用锁来实现的,但是因为本地扣库存和统一扣库存是一个原子性操作,所以在最上层使用 Channel 来实现,这块后边会讲。 统一扣库存操作 Redis,因为 Redis 是单线程的,而我们要实现从中取数据,写数据并计算一些列步骤,我们要配合 Lua 脚本打包命令,保证操作的原子性: packageremoteSpike......constLuaScript=`localticket_key=KEYS[1]localticket_total_key=ARGV[1]localticket_sold_key=ARGV[2]localticket_total_nums=tonumber(redis.call('HGET',ticket_key,ticket_total_key))localticket_sold_nums=tonumber(redis.call('HGET',ticket_key,ticket_sold_key))--查看是否还有余票,增加订单数量,返回结果值if(ticket_total_nums>=ticket_sold_nums)thenreturnredis.call('HINCRBY',ticket_key,ticket_sold_key,1)endreturn0`//远端统一扣库存func(RemoteSpikeKeys*RemoteSpikeKeys)RemoteDeductionStock(connredis.Conn)bool{lua:=redis.NewScript(1,LuaScript)result,err:=redis.Int(lua.Do(conn,RemoteSpikeKeys.SpikeOrderHashKey,RemoteSpikeKeys.TotalInventoryKey,RemoteSpikeKeys.QuantityOfOrderKey))iferr!=nil{returnfalse}returnresult!=0} 我们使用 Hash 结构存储总库存和总销量的信息,用户请求过来时,判断总销量是否大于库存,然后返回相关的 Bool 值。 在启动服务之前,我们需要初始化 Redis 的初始库存信息: hmsetticket_hash_key"ticket_total_nums"10000"ticket_sold_nums"0 响应用户信息 我们开启一个 HTTP 服务,监听在一个端口上: packagemain...funcmain(){http.HandleFunc("/buy/ticket",handleReq)http.ListenAndServe(":3005",nil)} 上面我们做完了所有的初始化工作,接下来 handleReq 的逻辑非常清晰,判断是否抢票成功,返回给用户信息就可以了。 packagemain//处理请求函数,根据请求将响应结果信息写入日志funchandleReq(whttp.ResponseWriter,r*http.Request){redisConn:=redisPool.Get()LogMsg:=""<-done//全局读写锁iflocalSpike.LocalDeductionStock()&&remoteSpike.RemoteDeductionStock(redisConn){util.RespJson(w,1,"抢票成功",nil)LogMsg=LogMsg+"result:1,localSales:"+strconv.FormatInt(localSpike.LocalSalesVolume,10)}else{util.RespJson(w,-1,"已售罄",nil)LogMsg=LogMsg+"result:0,localSales:"+strconv.FormatInt(localSpike.LocalSalesVolume,10)}done<-1//将抢票状态写入到log中writeLog(LogMsg,"./stat.log")}funcwriteLog(msgstring,logPathstring){fd,_:=os.OpenFile(logPath,os.O_RDWR|os.O_CREATE|os.O_APPEND,0644)deferfd.Close()content:=strings.Join([]string{msg,"\r\n"},"")buf:=[]byte(content)fd.Write(buf)} 前边提到我们扣库存时要考虑竞态条件,我们这里是使用 Channel 避免并发的读写,保证了请求的高效顺序执行。 我们将接口的返回信息写入到了 ./stat.log 文件方便做压测统计。 单机服务压测 开启服务,我们使用 AB 压测工具进行测试: ab-n10000-c100http://127.0.0.1:3005/buy/ticket 下面是我本地低配 Mac 的压测信息: ThisisApacheBench,Version2.3<$revision: 1826891="">Copyright1996AdamTwiss,ZeusTechnologyLtd,http://www.zeustech.net/LicensedtoTheApacheSoftwareFoundation,http://www.apache.org/Benchmarking127.0.0.1(bepatient)Completed1000requestsCompleted2000requestsCompleted3000requestsCompleted4000requestsCompleted5000requestsCompleted6000requestsCompleted7000requestsCompleted8000requestsCompleted9000requestsCompleted10000requestsFinished10000requestsServerSoftware:ServerHostname:127.0.0.1ServerPort:3005DocumentPath:/buy/ticketDocumentLength:29bytesConcurrencyLevel:100Timetakenfortests:2.339secondsCompleterequests:10000Failedrequests:0Totaltransferred:1370000bytesHTMLtransferred:290000bytesRequestspersecond:4275.96[#/sec](mean)Timeperrequest:23.387[ms](mean)Timeperrequest:0.234[ms](mean,acrossallconcurrentrequests)Transferrate:572.08[Kbytes/sec]receivedConnectionTimes(ms)minmean[+/-sd]medianmaxConnect:0814.76223Processing:21517.611232Waiting:11113.58225Total:72322.818239Percentageoftherequestsservedwithinacertaintime(ms)50%1866%2475%2680%2890%3395%3998%4599%54100%239(longestrequest) 根据指标显示,我单机每秒就能处理 4000+ 的请求,正常服务器都是多核配置,处理 1W+ 的请求根本没有问题。 而且查看日志发现整个服务过程中,请求都很正常,流量均匀,Redis 也很正常: //stat.log...result:1,localSales:145result:1,localSales:146result:1,localSales:147result:1,localSales:148result:1,localSales:149result:1,localSales:150result:0,localSales:151result:0,localSales:152result:0,localSales:153result:0,localSales:154result:0,localSales:156... 总结回顾 总体来说,秒杀系统是非常复杂的。我们这里只是简单介绍模拟了一下单机如何优化到高性能,集群如何避免单点故障,保证订单不超卖、不少卖的一些策略 完整的订单系统还有订单进度的查看,每台服务器上都有一个任务,定时的从总库存同步余票和库存信息展示给用户,还有用户在订单有效期内不支付,释放订单,补充到库存等等。 我们实现了高并发抢票的核心逻辑,可以说系统设计的非常的巧妙,巧妙的避开了对 DB 数据库 IO 的操作。 对 Redis 网络 IO 的高并发请求,几乎所有的计算都是在内存中完成的,而且有效的保证了不超卖、不少卖,还能够容忍部分机器的宕机。 我觉得其中有两点特别值得学习总结: ①负载均衡,分而治之 通过负载均衡,将不同的流量划分到不同的机器上,每台机器处理好自己的请求,将自己的性能发挥到极致。 这样系统的整体也就能承受极高的并发了,就像工作的一个团队,每个人都将自己的价值发挥到了极致,团队成长自然是很大的。 ②合理的使用并发和异步 自 Epoll 网络架构模型解决了 c10k 问题以来,异步越来越被服务端开发人员所接受,能够用异步来做的工作,就用异步来做,在功能拆解上能达到意想不到的效果。 这点在 Nginx、Node.JS、Redis 上都能体现,他们处理网络请求使用的 Epoll 模型,用实践告诉了我们单线程依然可以发挥强大的威力。 服务器已经进入了多核时代,Go 语言这种天生为并发而生的语言,完美的发挥了服务器多核优势,很多可以并发处理的任务都可以使用并发来解决,比如 Go 处理 HTTP 请求时每个请求都会在一个 Goroutine 中执行。 总之,怎样合理的压榨 CPU,让其发挥出应有的价值,是我们一直需要探索学习的方向。 到此文章就结束了。如果今天的文章对你在进阶架构师的路上有新的启发和进步,欢迎转发给更多人。欢迎加入架构师社区技术交流群,众多大咖带你进阶架构师,在后台回复“加群”即可入群。 第一期打卡送书5本+1个腾讯视频VIP月卡(11月1日-12月1日) 这些年小编给你分享过的干货 《IDEA 2020.2最新破解教程,有效期到2089年》 《Kubernetes的前世今生》 《你们公司的架构师是什么样的?》 《Docker与CI持续集成/CD持续部署》 《还有40天,Java 11就要横空出世了》 《JDK 10 的 109 项新特性》 《学习微服务的十大理由》 《进大厂必须掌握的50个微服务面试问题》 转发在看就是最大的支持❤️ 本文分享自微信公众号 - Java架构师社区(mush_java_jg)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。


优秀的个人博客,低调大师

60 亿次 for 循环,原来这么多东西

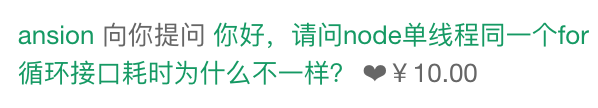
起因 有人在思否论坛上向我付费提问 当时觉得,这个人问的有问题吧。仔细一看,还是有点东西的 问题重现 编写一段 Node.js代码 varhttp=require('http');http.createServer(function(request,response){varnum=0for(vari=1;i<5900000000;i++){num+=i}response.end('Hello'+num);}).listen(8888); 使用 nodemon启动服务,用 time curl调用这个接口 首次需要7.xxs耗时 多次调用后,问题重现 为什么这个耗时突然变高,由于我是调用的是本机服务,我看 CPU使用当时很高,差不多打到 100%了.但是我后面发现不是这个问题. 问题排查 排除掉 CPU问题,看内存消耗占用。 varhttp=require('http');http.createServer(function(request,response){console.log(request.url,'url');letused=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'start',);console.time('测试');letnum=0;for(leti=1;i<5900000000;i++){num+=i;}console.timeEnd('测试');used=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'end',);response.end('Hello'+num);![](https://imgkr2.cn-bj.ufileos.com/13455121-9d87-42c3-a32e-ea999a2cd09b.png?UCloudPublicKey=TOKEN_8d8b72be-579a-4e83-bfd0-5f6ce1546f13&Signature=E3cF2kymC92LifrIC5IOfIZQvnk%253D&Expires=1598883364)![](https://imgkr2.cn-bj.ufileos.com/1e7b95df-2a48-41c3-827c-3c24b39f4b5b.png?UCloudPublicKey=TOKEN_8d8b72be-579a-4e83-bfd0-5f6ce1546f13&Signature=%252FANTTuhgbpIsXslXMc1qCkj2TMU%253D&Expires=1598883362)}).listen(8888); 测试结果: 内存占用和 CPU都正常 跟字符串拼接有关,此刻关闭字符串拼接(此时为了快速测试,我把循环次数降到 5.9亿次) 发现耗时稳定下来了 定位问题在字符串拼接,先看看字符串拼接的几种方式 一、使用连接符 “+” 把要连接的字符串连起来 vara='java'varb=a+'script' * 只连接100个以下的字符串建议用这种方法最方便 二、使用数组的 join 方法连接字符串 vararr=['hello','java','script']varstr=arr.join("") 比第一种消耗更少的资源,速度也更快 三、使用模板字符串,以反引号( ` )标识 vara='java'varb=`hello${a}script` 四、使用 JavaScript concat() 方法连接字符串 vara='java'varb='script'varstr=a.concat(b) 五、使用对象属性来连接字符串 functionStringConnect(){this.arr=newArray()}StringConnect.prototype.append=function(str){this.arr.push(str)}StringConnect.prototype.toString=function(){returnthis.arr.join("")}varmystr=newStringConnect()mystr.append("abc")mystr.append("def")mystr.append("g")varstr=mystr.toString() 更换字符串的拼接方式 我把字符串拼接换成了数组的 join方式(此时循环 5.9亿次) varhttp=require('http');http.createServer(function(request,response){console.log(request.url,'url');letused=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'start',);console.time('测试');letnum=0;for(leti=1;i<590000000;i++){num+=i;}constarr=['Hello'];arr.push(num);console.timeEnd('测试');used=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'end',);response.end(arr.join(''));}).listen(8888); 测试结果,发现接口调用的耗时稳定了( 注意此时是5.9亿次循环) 《javascript高级程序设计》中,有一段关于字符串特点的描述,原文大概如下: ECMAScript中的字符串是不可变的,也就是说,字符串一旦创建,他们的值就不能改变。要改变某个变量的保存的的字符串,首先要销毁原来的字符串,然后再用另外一个包含新值的字符串填充该变量 就完了? 用 +直接拼接字符串自然会对性能产生一些影响,因为字符串是不可变的,在操作的时候会产生临时字符串副本, +操作符需要消耗时间,重新赋值分配内存需要消耗时间。 但是,我更换了代码后,发现,即使没有字符串拼接,也会耗时不稳定 varhttp=require('http');http.createServer(function(request,response){console.log(request.url,'url');letused=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'start',);console.time('测试');letnum=0;for(leti=1;i<5900000000;i++){//num++;}constarr=['Hello'];//arr[1]=num;console.timeEnd('测试');used=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'end',);response.end('hello');}).listen(8888); 测试结果: 现在我怀疑,不仅仅是字符串拼接的效率问题,更重要的是 for循环的耗时不一致 varhttp=require('http');http.createServer(function(request,response){console.log(request.url,'url');letused=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'start',);letnum=0;console.time('测试');for(leti=1;i<5900000000;i++){//num++;}console.timeEnd('测试');constarr=['Hello'];//arr[1]=num;used=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'end',);response.end('hello');}).listen(8888); 测试运行结果: for循环内部的 i++其实就是变量不断的重新赋值覆盖 经过我的测试发现, 40亿次跟 50亿次的区别,差距很大, 40亿次的for循环,都是稳定的,但是 50亿次就不稳定了. Node.js的 EventLoop: 我们目前被阻塞的状态: 我电脑的CPU使用情况 优化方案 遇到了 60亿次的循环,像有使用多进程异步计算的,但是本质上没有解决这部分循环代码的调用耗时。 改变策略,拆解单次次数过大的 for循环: varhttp=require('http');http.createServer(function(request,response){console.log(request.url,'url');letused=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'start',);letnum=0;console.time('测试');for(leti=1;i<600000;i++){num++;for(letj=0;j<10000;j++){num++;}}console.timeEnd('测试');constarr=['Hello'];console.log(num,'num');arr[1]=num;used=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'end',);response.end(arr.join(''));}).listen(8888); 结果,耗时基本稳定, 60亿次循环总共: 推翻字符串的拼接耗时说法 修改代码回最原始的 +方式拼接字符串 varhttp=require('http');http.createServer(function(request,response){console.log(request.url,'url');letused=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'start',);letnum=0;console.time('测试');for(leti=1;i<600000;i++){num++;for(letj=0;j<10000;j++){num++;}}console.timeEnd('测试');//constarr=['Hello'];console.log(num,'num');//arr[1]=num;used=process.memoryUsage().heapUsed/1024/1024;console.log(`Thescriptusesapproximately${Math.round(used*100)/100}MB`,'end',);response.end(`Hello`+num);}).listen(8888); 测试结果稳定,符合预期: 总结: 对于单次循环超过一定阀值次数的,用拆解方式, Node.js的运行耗时是稳定,但是如果是循环次数过多,那么就会出现刚才那种情况,阻塞严重,耗时不一样。 为什么? 深度分析问题 遍历60亿次,这个数字是有一些大了,如果是40亿次,是稳定的 这里应该还是跟 CPU有一些 关系,因为 top 查看一直是在 升高 此处虽然不是真正意义上的内存泄漏,但是我们如果在一个循环中不仅要不断更新 i的值到 60亿,还要不断更新 num的值 60亿,内存使用会不断上升,最终出现两份 60亿的数据,然后再回收。( 因为GC自动垃圾回收,一样会阻塞主线程,多次接口调用后, CPU占用也会升高) 使用 for循环拆解后: for(leti=1;i<60000;i++){num++;for(letj=0;j<100000;j++){num++;}} 只要 num到 60亿即可,解决了这个问题。 哪些场景会遇到这个类似的超大计算量问题: 图片处理 加解密 ❝ 如果是异步的业务场景,也可以用多进程参与解决超大计算量问题,今天这里就不重复介绍了 ❞ 最后 如果感觉写得不错,可以点个 在看/ 赞,转发一下,让更多人看到 我是 Peter谭老师,欢迎你关注公众号: 前端巅峰,后台回复: 加群即可加入大前端交流群 本文分享自微信公众号 - 前端巅峰(Java-Script-)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册