首页 文章 精选 留言 我的

精选列表

搜索[文档解析],共10000篇文章
优秀的个人博客,低调大师

HarmonyOS NEXT自由流转能力解析(基础)

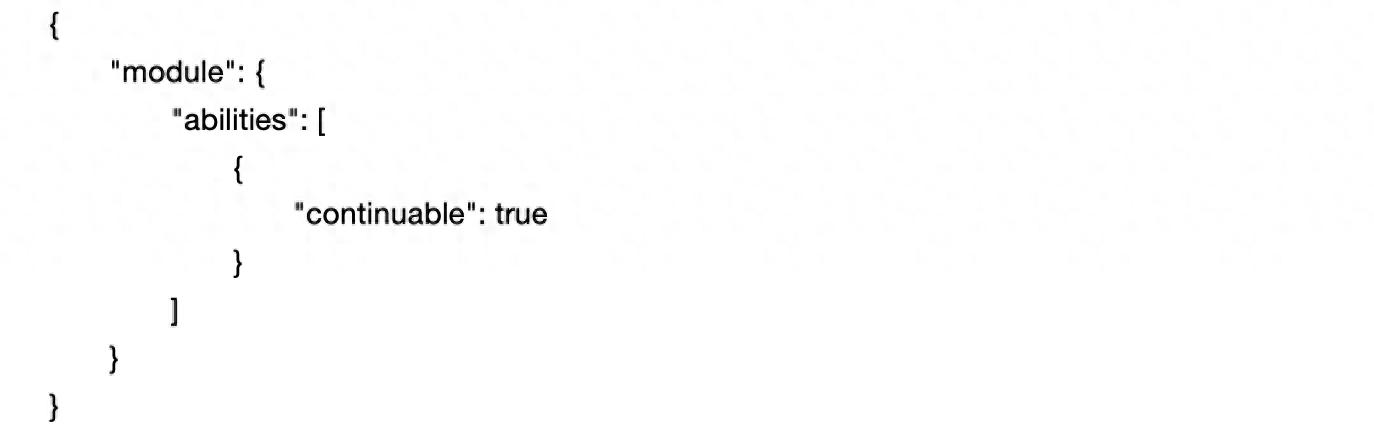
踏入鸿蒙世界的敲门砖,标志着您在技术征途上的全新起点,提升就业竞争力,获得行业认可,点亮职业成长先机,快人一步抢占未来应用开发赛道!https://developer.huawei.com/consumer/cn/training/dev-cert-detail/101666948302721398?ha_source=hmosclass-kaiyuanzhongguo&ha_sourceId=89000441 在HarmonyOS NEXT的生态体系中,自由流转能力是实现多设备协同的关键,它打破了设备之间的壁垒,让用户能够在不同设备间畅享无缝的操作体验。今天,咱们就来深入剖析一下这项强大的能力。 自由流转的核心概念(跨端迁移 vs 多端协同) 自由流转是HarmonyOS NEXT中跨多设备分布式操作的统称,其中跨端迁移和多端协同是两种重要的实现形式。 跨端迁移就像是一场应用的“设备之旅”。在用户使用设备的过程中,一旦使用情境发生变化,比如从室外回到室内,发现原本使用的手机在处理某些任务时不太方便,而身边的平板更合适,此时就可以借助跨端迁移,将正在手机上运行的应用“搬”到平板上继续使用。从开发角度来讲,就是A设备上运行的UIAbility迁移到B设备上,A设备上的UIAbility可根据实际需求选择是否退出。例如,在手机上观看视频时,回到家将视频迁移到智慧屏上继续播放,视频的播放进度、播放设置等都能原封不动地延续,给用户带来无缝的观看体验。 多端协同则更像是设备之间的“团队协作”。多个设备作为一个整体,共同为用户提供比单设备更高效、更沉浸的服务。多个设备上的不同UIAbility或ServiceExtensionAbility可以同时运行,也能交替运行来完成完整的业务。比如,在两台设备上同时打开备忘录的同一篇笔记进行协同编辑,设备A可以插入本地图库中的图片,设备B负责文字内容的编辑,不同设备各司其职,大大提升了用户的编辑效率和体验。 典型应用场景分析 1、 邮件跨设备编辑:这是跨端迁移的典型应用。当用户在手机上撰写邮件时,中途切换到电脑上继续编辑。HarmonyOS NEXT的自由流转能力会保存邮件的编辑状态,包括已输入的内容、插入的附件以及设置的格式等。在电脑上打开邮件应用时,这些信息会被完整恢复,就好像用户一直在电脑上编辑一样。开发时,通过应用接续技术,在源端UIAbility的onContinue()接口中保存邮件数据,在目的端的onCreate()或onNewWant()接口中恢复数据,实现邮件编辑的无缝切换。 2、 多设备协同健身:在这个场景中,多端协同发挥得淋漓尽致。用户佩戴智能手表进行运动,手表实时采集心率、步数等数据。同时,手机或平板上的健身应用接收这些数据,并根据数据提供个性化的运动建议、展示运动课程视频等。手机还能作为控制中心,方便用户调整健身计划。开发过程中,需要实现不同设备间的数据实时传输和交互,确保各个设备上的应用能够协同工作,为用户提供全面的健身体验。 3、 多屏游戏:多屏游戏充分展现了自由流转的魅力。以一款冒险游戏为例,玩家在手机上进行游戏的前期探索和操作。当连接到大屏电视后,游戏画面自动切换到电视上,借助电视的大屏幕和高画质,玩家能获得更震撼的视觉体验。此时,手机可以作为游戏手柄,利用其传感器实现精准操控。这一过程中,跨端迁移实现了游戏画面和操作的无缝切换,多端协同让手机和电视共同为玩家打造出沉浸式的游戏体验。开发者需要解决设备间的图形同步、操作指令传输以及性能优化等问题,确保游戏在不同设备上都能流畅运行。 实战案例:如何让一个应用在多个设备上自由切换 下面通过一个简单的文本编辑器应用示例,展示如何实现应用在多个设备上的自由切换。 配置应用接续能力 在module.json5文件的abilities中,将continuable标签配置为true,表示该UIAbility可被迁移: 在源端保存数据 在源端UIAbility中实现onContinue()接口,保存文本编辑器中的内容: 在目的端恢复数据 在目的端UIAbility中实现onCreate()或onNewWant()接口,恢复文本编辑器的内容: 通过以上步骤,就可以实现一个简单的文本编辑器应用在多个设备上的自由切换,用户在不同设备上打开应用时,都能继续之前的编辑工作。当然,在实际应用开发中,还需要考虑更多的细节,如数据的一致性、设备兼容性等问题,但这个示例为大家提供了一个基本的实现思路。 HarmonyOS NEXT的自由流转能力为开发者提供了广阔的创新空间,通过合理运用跨端迁移和多端协同技术,我们可以打造出更加智能、高效的多设备应用,为用户带来前所未有的便捷体验。希望大家在实际开发中能够充分利用这一能力,创造出更多优秀的应用。(转载自51CTO,作者:SameX)

优秀的个人博客,低调大师

Docker 容器编排技术解析与实践

本文全面探索了容器编排技术的核心概念、工具和高级应用,包括Docker Compose、Kubernetes等主要平台及其高级功能如网络和存储管理、监控、安全等。此外,文章还探讨了这些技术在实际应用中的案例,提供了对未来趋势的洞见。 关注【TechLeadCloud】,分享互联网架构、云服务技术的全维度知识。作者拥有10+年互联网服务架构、AI产品研发经验、团队管理经验,同济本复旦硕,复旦机器人智能实验室成员,阿里云认证的资深架构师,项目管理专业人士,上亿营收AI产品研发负责人 一、容器编排介绍 容器编排是现代云原生应用管理的核心,它涉及在大规模的环境中自动化部署、管理、扩展和网络配置容器。随着微服务架构的兴起和应用的复杂性增加,容器编排成为了实现高效、可靠和动态服务管理的关键技术。 容器编排的概念和重要性 容器编排的概念源自于需要在大量的物理或虚拟机上有效管理成百上千个容器的需求。容器本身虽然轻量级且快速,但在复杂的生产环境中,手动管理这些容器的部署和生命周期是不切实际的。容器编排通过自动化这些过程,提供了如下几个关键优势: 高效的资源利用:通过智能调度,编排工具能够确保容器在最合适的主机上运行,优化资源的使用。 快速扩展和恢复:应对突然的流量峰值或服务故障,容器编排能够快速扩展或重新部署服务。 自动化和一致性:编排工具保证了部署的一致性,减少了人为错误,使得部署过程更加自动化和可重复。 服务发现和负载均衡:容器之间的网络配置和通信通过编排工具自动管理,提高了整体的应用性能。 容器编排的发展趋势 近年来,随着技术的快速发展,容器编排已经从最初的单一服务自动化,发展为支持复杂应用的全面解决方案。例如,Kubernetes 不仅支持基础的部署和扩展,还提供了服务网格(如Istio),以支持微服务之间复杂的通信和安全需求。此外,GitOps的兴起,将Git仓库作为应用部署的真理来源,使得容器编排更加透明和易于管理。 容器编排的实际应用案例 在实际应用中,容器编排已经成为许多成功项目的基石。例如,Netflix的容器化平台 Spinnaker,利用容器编排技术支持了他们庞大的微服务架构,实现了快速的服务部署和高效的资源管理。在金融领域,Goldman Sachs 通过Kubernetes管理他们的交易系统,不仅提高了系统的稳定性,还加快了新功能的上线速度。 二、容器编排工具概览 在容器编排领域,有几个关键的工具和平台已经成为行业的标准。这些工具不仅提供了基础的容器管理功能,还引入了高级特性,如自动扩展、服务发现和自我修复能力。我们将探讨其中最重要的几个工具:Docker Compose、Kubernetes 和 Docker Swarm,了解它们的基本概念、特性和适用场景。 Docker Compose Docker Compose 是一个用于定义和运行多容器Docker应用程序的工具。通过Compose,用户可以使用YAML文件来配置应用服务。然后,只需一个简单的命令,就可以创建并启动所有服务。Docker Compose 特别适合于开发环境和小型项目,因为它简化了多容器应用的构建和管理过程。 特点 易于使用:通过一个YAML文件管理整个应用的服务。 开发友好:适合在开发环境中快速部署和测试。 轻量级:不需要额外的基础设施或复杂的配置。 应用案例 例如,一个开发团队可以使用Docker Compose来搭建他们的本地开发环境,包括应用服务器、数据库和缓存服务。这使得整个团队能够在一个一致的环境中工作,减少了“在我的机器上运行正常”的问题。 Kubernetes Kubernetes(K8s)是目前最流行的开源容器编排系统,用于自动部署、扩展和管理容器化应用程序。由Google开发,并由Cloud Native Computing Foundation(CNCF)维护。 特点 高度可扩展:可以管理大规模的容器部署。 强大的生态系统:支持广泛的工作负载类型、服务发现和负载均衡。 自动化运维:包括自动扩展、自我修复和滚动更新。 应用案例 在全球范围内,许多大型企业(如Spotify、华为和IBM)都使用Kubernetes来支持他们的生产环境。Kubernetes不仅提高了这些公司的运维效率,还为他们提供了无与伦比的系统稳定性和可扩展性。 Docker Swarm Docker Swarm 是 Docker 的原生集群管理工具。它使用Docker API,因此已经熟悉Docker的用户会发现Swarm易于上手和使用。 特点 Docker原生:紧密集成在Docker生态系统中。 简单易用:对于小型到中型项目而言,Swarm提供了足够的功能。 轻量级:不需要额外的安装,只需要Docker。 应用案例 对于那些已经在使用Docker并且需要更简单的解决方案来扩展他们的应用到多个主机的团队,Docker Swarm提供了一个理想的选择。例如,一个中小型企业可以使用Swarm来管理他们的几个服务,而无需投入更多资源来学习和部署Kubernetes。 三、Docker Compose全解 Docker Compose 是一个用于定义和运行多容器Docker应用程序的工具。它允许用户使用YAML文件来声明式地定义服务、网络和卷,从而在Docker环境中轻松构建、测试和部署应用程序。 Docker Compose 的基本概念 1. 服务(Service) 定义:服务是Docker Compose中的核心概念,它代表一个应用的组成部分(例如,数据库、前端、后端)。 特性:每个服务都可以定义其容器镜像、端口映射、卷挂载和依赖关系。 2. 网络(Network) 定义:Compose允许定义网络来实现容器间的通信。 特性:支持不同的网络类型,如桥接或覆盖网络,确保容器之间的隔离和安全通信。 3. 卷(Volume) 定义:卷用于数据持久化和共享。 特性:可以被多个容器共享,用于存储数据库文件、配置文件等。 Docker Compose 文件结构 YAML文件是Docker Compose的核心,其中定义了所有相关的服务、网络和卷配置。 示例 version: "3.9" # 使用的Compose文件版本 services: web: image: "my-web-app:latest" # 定义使用的镜像 ports: - "5000:5000" # 端口映射 networks: - webnet # 网络配置 redis: image: "redis:alpine" networks: - webnet networks: webnet: 高级功能 1. 服务扩展(Scale) 描述:自动增加或减少服务的实例数量。 用途:在高流量时期动态扩展服务实例,以应对负载。 2. 健康检查(Healthcheck) 描述:监控服务的运行状态。 用途:确保服务正常运行,对故障实例进行自动重启。 3. 环境变量(Environment Variables) 描述:设置和管理服务运行时的环境变量。 用途:配置数据库连接、API密钥等敏感信息。 Docker Compose 在实际应用中的应用 在微服务架构中,Docker Compose被广泛用于本地开发和测试环境。它允许开发人员在本地复现生产环境,确保应用的每个组件都能在一个隔离且一致的环境中运行。 应用示例 假设一个团队正在开发一个包含前端、后端和数据库的Web应用。使用Docker Compose,他们可以定义三个服务:一个用于前端的Node.js应用,一个用于后端的Python API,以及一个PostgreSQL数据库。每个服务都可以在其专用容器中运行,并且通过定义的网络相互通信。这样,整个团队可以在相同的配置下工作,减少环境差异带来的问题。 总结 Docker Compose提供了一个简单而强大的工具,用于管理和编排多容器应用。它的易用性和灵活性使其成为开发和小规模部署环境的理想选择。通过深入了解Compose的各种功能和最佳实践,开发团队可以显著提升其开发效率和应用质量。 四、Kubernetes全解 Kubernetes,通常称为K8s,是当前最流行的开源容器编排平台。它为自动化部署、扩展和管理容器化应用程序提供了一个健壮的框架。 Kubernetes的核心概念 1. Pod 定义:Pod是Kubernetes中最小的可部署单元,通常包含一个或多个容器。 特点:Pod中的容器共享存储、网络和运行配置。 2. Service 定义:Service是定义如何访问一组具有相同功能的Pod的抽象方式。 特点:确保网络访问的稳定性和负载均衡。 3. Deployment 定义:Deployment为Pod和ReplicaSet(Pod的集合)提供声明式的更新能力。 特点:支持滚动更新和版本回滚。 Kubernetes的架构组件 1. 控制平面(Control Plane) 功能:管理集群状态,如调度、响应Pod生命周期事件等。 组件:包括API服务器、调度器、控制器管理器等。 2. 节点(Node) 功能:运行应用程序容器。 组件:包括Kubelet、Kube-proxy和容器运行时。 3. 存储(Storage) 功能:提供持久存储解决方案。 组件:支持多种存储选项,如本地存储、公有云存储等。 Kubernetes的高级特性 1. 自动扩缩容(Auto-Scaling) 描述:根据负载自动增加或减少Pod数量。 应用:保证应用在不同负载下的性能和成本效率。 2. 服务发现和负载均衡 描述:自动配置网络,使得服务能够互相发现和负载均衡。 应用:简化了微服务架构中服务间通信的复杂性。 3. 自动化部署和回滚 描述:通过声明式配置自动管理应用部署和回滚。 应用:提高部署的可靠性和频率,降低部署失败的风险。 Kubernetes在实际应用中的应用 Kubernetes已经成为微服务架构的事实标准。它能够支持从小型初创企业到大型企业的不同规模应用。 应用示例 假设一个在线零售平台,需要管理其多个微服务(如订单处理、支付处理、用户认证等)。使用Kubernetes,这些服务可以被部署为独立的Pod或Deployment,并通过Service进行互联。随着用户数量的增长,Kubernetes可以自动扩展服务,确保应用的可靠性和性能。 Kubernetes的未来趋势 Kubernetes不断发展,正在融合更多的云原生技术,如服务网格、Serverless架构等。未来,Kubernetes可能会进一步简化应用部署和管理的复杂性,使得它不仅仅是容器编排工具,而是整个云原生应用生态系统的核心。 五、高级容器编排技术 在现代的容器化生态系统中,随着应用和部署的复杂性增加,高级容器编排技术成为了不可或缺的组成部分。这些技术不仅提升了容器管理的效率和灵活性,还确保了系统的可靠性和安全性。 网络管理 容器网络管理是确保容器间正确、安全通信的重要部分。在复杂的容器化环境中,网络管理包括但不限于以下方面: 1. 网络模型 概念:容器网络模型定义了容器如何在网络中交互。 技术:如CNI(Container Network Interface)、Flannel、Calico。 2. 服务网格 概念:服务网格管理微服务间的通信,提供负载均衡、服务发现等功能。 技术:如Istio、Linkerd。 应用:服务网格使得微服务间的复杂通信变得透明和可控。 存储管理 在容器编排中,存储管理保证了数据的持久性和一致性。高级存储管理技术包括: 1. 持久化存储 概念:为容器提供持久化的存储解决方案。 技术:如Persistent Volumes (PV) 和 Persistent Volume Claims (PVC) 在Kubernetes中的应用。 2. 存储编排 概念:自动管理存储资源的分配和生命周期。 技术:如Rook、Portworx。 容器监控和日志管理 为了确保容器化环境的健康和性能,监控和日志管理是必不可少的。 1. 监控 概念:实时监控容器和集群的性能指标。 工具:如Prometheus、Grafana。 2. 日志管理 概念:集中收集、存储和分析容器日志。 工具:如ELK Stack(Elasticsearch, Logstash, Kibana)、Fluentd。 容器安全性 容器安全性是容器编排中一个重要且日益受到关注的领域,包括: 1. 容器安全扫描 概念:检测容器镜像中的安全漏洞。 工具:如Clair、Trivy。 2. 运行时安全 概念:保护运行中容器免受攻击。 工具:如Falco、Sysdig。 自动化和策略驱动管理 容器编排的自动化和策略驱动管理提供了更高层次的控制和效率。 1. 自动化部署 技术:如GitOps,使用Git仓库作为唯一的真理来源,实现自动化的应用部署。 2. 策略驱动管理 技术:如OPA (Open Policy Agent),为云原生环境提供统一的策略执行。 关注【TechLeadCloud】,分享互联网架构、云服务技术的全维度知识。作者拥有10+年互联网服务架构、AI产品研发经验、团队管理经验,同济本复旦硕,复旦机器人智能实验室成员,阿里云认证的资深架构师,项目管理专业人士,上亿营收AI产品研发负责人 如有帮助,请多关注 TeahLead KrisChang,10+年的互联网和人工智能从业经验,10年+技术和业务团队管理经验,同济软件工程本科,复旦工程管理硕士,阿里云认证云服务资深架构师,上亿营收AI产品业务负责人。

优秀的个人博客,低调大师

解析$nextTick魔力,为啥大家都爱它?

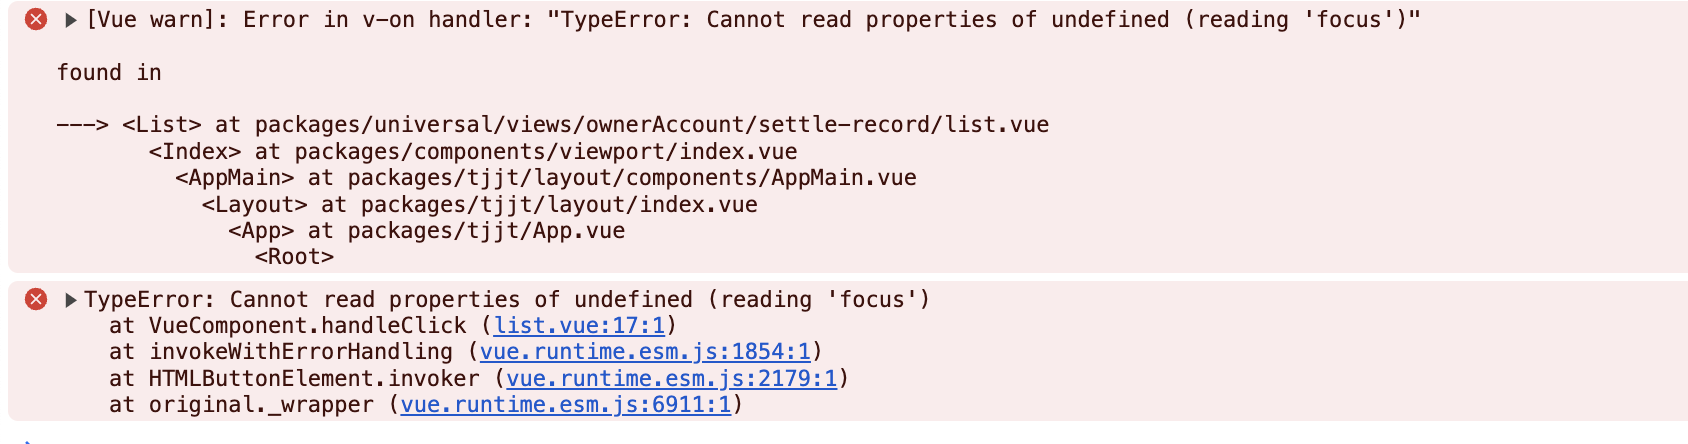
1.为什么需要使用$nextTick? 首先我们来看看官方对于$nextTick的定义: 在下次 DOM 更新循环结束之后执行延迟回调。在修改数据之后立即使用这个方法,获取更新后的 DOM。 由于vue的试图渲染是异步的,生命周期的created()钩子函数进行的DOM操作一定要放在Vue.nextTick()的回调函数中,原因是在created()钩子函数执行的时候DOM其实并未进行渲染,而此时进行DOM操作是徒劳的,所以一定要将DOM操作的js代码放到Vue.nextTick()的回调函数中。除了在created()钩子函数中使用之外咱们还会遇到很多种需要使用到Vue.nextTick()的场景,如下所示: 咱们日常生活中常常会遇上上述场景,当我们点击按钮更新数据时候,如下示例: <template> <div> <input type="text" v-if = "isShow" ref="input"/> <button @click="handleClick">点击显示输入框,并且获取输入框焦点</button> </div> </template> <script> export default { data() { return { isShow: false } }, methods : { handleClick () { this.isShow = true this.$refs.input.focus() //控制栏会报错,因为还没有这个dom } } } </script> 点击控制栏显示效果:控制栏报错,提示没有获取到dom元素;   所以现在Vue.nextTick()派上了用场,Vue.nextTick() 方法的作用正是等待上一次事件循环执行完毕,并在下一次事件循环开始时再执行回调函数。这样可以保证回调函数中的 DOM 操作已经被 Vue.js 进行过更新,从而避免了一些潜在的问题,如下代码所示: <template> <div> <input type="text" v-if = "isShow" ref="input"/> <button @click="handleClick">点击显示输入框,并且获取输入框焦点</button> </div> </template> <script> export default { data() { return { isShow: false } }, methods : { handleClick () { this.isShow = true this.$nextTick(()=>{ this.$refs.input.focus() }) } } } </script> 加上this.$nextTick后就能够使得输入框获取到焦点; 总而言之Vue.nextTick()就是下次 DOM 更新渲染后执行延迟回调函数。在日常开发中,我们在修改数据之后使用这个方法,就可以获取更新后的 DOM的同时进行在对DOM进行相对应操作的 js代码; 2.$nextTick如何实现的? JS是单线程执行的,所有的同步任务都是在主线程上执行的,形成了一个执行栈,从上到下依次执行,异步代码会放在任务队列里面。 • 同步任务 在主线程里执行,当浏览器第一遍过滤html文件的时候可以执行完;(在当前作用域直接执行的所有内容,包括执行的方法、new出来的对象) • 异步任务 耗费时间较长或者性能较差的,浏览器执行到这些的时候会将其丢到异步任务队列中,不会立即执行 同时异步任务分为宏任务(如setTimeout、setInterval、postMessage、setImmediate等)和微任务(Promise、process.nextTick等),浏览器执行这两种任务的优先级不同;会优先执行微任务队列的代码,微任务队列清空之后再执行宏任务的队列,这样循环往复; JS自上向下进行代码的编译执行,遇到同步代码压入JS执行栈执行后出栈,遇到异步代码放入任务队列,当JS执行栈清空,去执行异步队列中的回调函数,先去执行微任务队列,当微任务队列清空后,去检测执行宏任务队列中的回调函数,直至所有栈和队列清空 整体流程如下图所示:    接下来让我们看看nextTick的源码~ vue将nextTick的源码放在了vue/core/util/next-tick.js中。如下图所示:   我们把这个文件拆成三个部分来看: 1.nextTick定义函数 我们将nextTick函数单独拿出来,callbacks是一个回调队列,其实调用nextTick就是往这个数组里面传执行任务,callbacks新增回调函数之后执行timerFunc函数,pending是用来限制同一个事件循环内只能执行一次的pending锁; const callbacks = [] // 回调队列 let pending = false // export function nextTick (cb?: Function, ctx?: Object) { let _resolve callbacks.push(() => { // cb 回调函数会经统一处理压入 callbacks 数组 if (cb) { try { cb.call(ctx) } catch (e) { handleError(e, ctx, 'nextTick') } } else if (_resolve) { _resolve(ctx) } }) // 执行异步延迟函数 timerFunc if (!pending) { pending = true timerFunc() } // $flow-disable-line // 当 nextTick 没有传入函数参数的时候,返回一个 Promise 化的调用 if (!cb && typeof Promise !== 'undefined') { return new Promise(resolve => { _resolve = resolve }) } } 2.timerFunc函数 做了四个判断,先后尝试当前环境是否能够使用原生的Promise.then、MutationObserver和setImmediate,不断的降级处理,如果以上三个都不支持,则最后就会直接使用setTimeOut,主要操作就是将flushCallbacks中的函数放入微任务或者宏任务,等待下一个事件循环开始执行;宏任务耗费的时间是大于微任务的,所以在浏览器支持的情况下,优先使用微任务。如果浏览器不支持微任务,使用宏任务;但是,各种宏任务之间也有效率的不同,需要根据浏览器的支持情况,使用不同的宏任务; export let isUsingMicroTask = false let timerFunc if (typeof Promise !== 'undefined' && isNative(Promise)) { //是否支持Promise const p = Promise.resolve() timerFunc = () => { p.then(flushCallbacks) if (isIOS) setTimeout(noop) } isUsingMicroTask = true } else if (!isIE && typeof MutationObserver !== 'undefined' && ( isNative(MutationObserver) || MutationObserver.toString() === '[object MutationObserverConstructor]' )) { //是否支持MutationObserver let counter = 1 const observer = new MutationObserver(flushCallbacks) const textNode = document.createTextNode(String(counter)) observer.observe(textNode, { characterData: true }) timerFunc = () => { counter = (counter + 1) % 2 textNode.data = String(counter) } isUsingMicroTask = true } else if (typeof setImmediate !== 'undefined' && isNative(setImmediate)) { timerFunc = () => { //是否支持setImmediate setImmediate(flushCallbacks) } } else { // Fallback to setTimeout. timerFunc = () => { //上面都不行,直接使用setTimeout setTimeout(flushCallbacks, 0) } } 3.flushCallbacks函数 flushCallbacks函数只有几行,也很好理解,将pending锁置为false,同时将callbacks数组复制一份之后再将callbacks置为空,接下来将复制出来的callbacks数组的每个函数依次进行执行,简单来说它的主要作用就是用来执行callbacks中的回调函数; function flushCallbacks () { pending = false const copies = callbacks.slice(0) callbacks.length = 0 for (let i = 0; i < copies.length; i++) { copies[i]() } } 值得注意的是,$nextTick 并不是一个真正意义上的微任务microtask,而是利用了事件循环机制来实现异步更新。因此,它的执行时机相对于微任务可能会有所延迟,但仍能保证在 DOM 更新后尽快执行回调函数。 总的来说,nextTick就是 1.将传入的回调函数放入callbacks数组等待执行,定义pending判断锁保证一个事件循环中只能调用一次timerFunc函数; 2.根据环境判断使用异步方式,调用timerFunc函数调用flushCallbacks函数依次执行callbacks中的回调函数; 3.个人小结 nextTick可避免数据更新后导致DOM的数据不一致的问题,提供了更稳定的异步更新机制,解决了created钩子函数DOM未渲染会造成的异步数据渲染问题,但如果过多的使用nextTick会导致事件循环中任务数量和回调函数增多,有可能出现可怕的回调地狱,导致性能下降,同时过度依赖nextTick也会降低代码的可读性,所以大家还是"按需加载"的好~  作者:京东保险 卓雅倩 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

ES的索引结构与算法解析

作者:京东物流 李洪吉 提到ES,大多数爱好者想到的都是搜索引擎,但是明确一点,ES不等同于搜索引擎。不管是谷歌、百度、必应、搜狗为代表的自然语言处理(NLP)、爬虫、网页处理、大数据处理的全文搜索引擎,还是有明确搜索目的的搜索行为,如各大电商网站、OA、站内搜索、视频网站的垂直搜索引擎,他们或多或少都使用到了ES。 ​作为搜索引擎的一部分,ES自然具有速度快、结果准确、结果丰富等特点,那么ES是如何达到“搜索引擎”级别的查询效率呢?首先是索引,其次是压缩算法,接下来我们就一起了解下ES的索引结构和压缩算法 1 结构 1.1 Mysql Mysql下的data目录存放的文件就是mysql相关数据,mysql文件夹对应的就是数据库mysql。 其中表columns_priv对应了3个文件:columns_priv.frm、columns_priv.MYD、columns_priv.MYI。 .frm:表结构;.MYD:myisam存储引擎原数据;.MYI:myisam存储引擎索引;.ibd:innodb存储引擎数据 1.2 Elasticsearch cfe为索引文,cfs 为数据文件,cfe文件保存Lucene各文件在.cfs文件的位置信息 cfs、cfe 在segment还很小的时候,将segment的所有文件都存在在cfs中,在cfs逐渐变大时,大小超过shard的10%,则会拆分为其他文件,如tim、dvd、fdt等文件 1.3 存储结构 倒排索引结构分为倒排表、词项字典、词项索引 倒排表包含某个词项的所有id的数据存储了在.doc文件中 词项字典包含了index field的所有经过处理之后的词项数据,最终存储在.tim文件中 1.4 结构对比 我们以某商城的手机为例,左侧为es倒排索引结构,右侧为原始数据。左侧图示只是为了展示倒排索引结构,并不是说es中倒排表就是简单的数组 以上面结构对比示例图为例,假如共有10亿条数据需要存储在ES中(上图右),分词后存储的倒排表(上图左)大概包含分词term以及对应的id数组等,在10亿条数据中,分词“小米”相关的数据有100万条,也就是说分词“小米”对应的数组Posting List长度是100万 id是int类型的有序主键,分词“小米”在数组Posting List中100万int类型数字总长度=100万✖每个int占4字节=400万Byte≈4MB。1个分词占4MB空间,假如10亿条数据有500万个分词,总空间=4MB✖500万=2千万MB,磁盘空间直接爆炸 2 算法 分词对应的数组Posting List实际就是一个个有序数组,而有序数值数组是比较容易进行压缩处理的,而且一般来说压缩效益也不错,如果能对其进行压缩是能够大大节约空间资源的 ES中倒排索引的压缩算法主要有FOR算法(Frame Of Reference)和RBM算法(RoaringBitMap) 2.1 FOR FOR算法的核心思想是用减法来削减数值大小,从而达到降低空间存储。 假设V(n)表示数组中第n个字段的值,那么经过FOR算法压缩的数值V(n)=V(n)-V(n-1)。也就是说存储的是后一位减去前一位的差值。存储是也不再按照int来计算了,而是看这个数组的最大值需要占用多少bit来计算 我们按照差值计算的方式来保存数据,初始值为1,2与1的差值为1,3与2的差值为1……最终我们就将原始Posting List数据转化为100万个1,每个1我们可以用1bit来记录,总空间=1bit✖100万=100万bit,相比原有400万Byte=3200bit,空间压缩了32倍 在实际生产中,不可能出现一个term的Posting List是这种差值均为1的情况,所以我们以通用示例举例。假如原数据为[73,300,302,332,343,372],数组中6个数字占据总空间为24字节。按照差值方式记录,数组转化为[73,227,2,30,11,29],最大数字为227,大于2的7次方128,小于2的8次方256,所以每个数字可以使用8bit即1Byte来保存,占据总空间为1Byte*6 + 1Byte=7Byte 在此基础上,我们将差值数组按照密集度划分为[73,227]和[2,30,11,29],其中[73,227]中最大值227介于2的7次方和2的8次方之间,所以用8bit=1Byte作为切割分段,[2,30,11,29]中最大数30介于2的4次方和2的5次方之间,所以用5bit作为切割分段。 数组[73,227]占据总空间为8bit✖2个=16bit=2Byte 数组[2,30,11,29]占据总空间为5bit✖4个=20bit=3Byte 为什么20bit=3Byte呢?因为8bit=1Byte,小于8bit也会占据1个字节空间,所以17bit到24bit均为3Byte 所以,最终占据总空间=1+2+1+3=7Byte 疑问一:既然原数组[73,300,302,332,343,372]要按照密集度拆分为[73,227]和[2,30,11,29]两个数组,那为什么不继续往下拆分,直接拆分到每个数字是一个数组,这样使用bit记录时占据总空间会更少? 答:如果继续拆分数组,空间确实会使用更少,但是,之前我们提到搜索引擎速度快的方式有两种:高效的压缩算法和快速的编码解码速度,单个数字存储确实压缩了空间,但是我们无法再通过解码的方式将源数据还原 疑问二:为什么源数据使用差值记录占据6Byte,拆分数组后占据7Byte,拆分后占据空间不变,有时候甚至会变大,为什么? 答:数据量小的情况下确实会出现该情况,因为我们需要拆分数组并记录拆分数组的长度(如上面示例中的8bit和5bit),在原数据存储空间基础上还要存储拆分长度,所以数据量小的情况下会出现比直接存储占据空间大的情况。但是不管是搜索引擎还是Elasticsearch更多处理的是海量数据,数据量越多,差值数组拆分的方式节省空间越明显 2.2 RBM 我们已经了解了FOR压缩算法,算法核心是将PostingList按照差值密集度转化成两个差值数组。在这里我们要考虑一种情况就是:在大数据中,10亿条数据分词500万个,如果分词“小米”所在PostList比较分散且差值很大,此时使用FOR算法效果就会大打折扣。所以稀疏的数组,不适合使用FOR算法 在这里我们以[1000,62101,131385,132052,191173,196658]为例,如果按照FOR算法,转化成的差值数组为[1000,61101,69284,667,59121,5485]密集度很低。我们采用RBM算法 源数据PostingList是由int类型组成的数组,int类型=4Byte=32bit,最大值=2的32次方-1=4294967295≈43亿。当数据较大且稀疏时,我们将32bit拆分为16bit和16bit,16bit最大值=65535,前16bit存放商,后16bit存放余数,所以商和余数都不会超过65535.我们将源数组的值除以65536,得到的商和余数分别存放在前16bit和后16bit。 以数字196658为例,转化为2进制,前16位=3,后16位=50 得到的结果以K-V存放。Key最大值为16bit,所以以short[]数组存放,Value以Container存放。 由于源数组为有序数组,所以按照高低16位转化后,商和余数都是从小到大排列 通过看Container源码,我们可以看到Container有3种:ArrayContainer、BitmapContainer、RunContainer。 ArrayContainer本质为集合,所以随着数组中数量越多,占用空间越多,呈正向增长。 当数组种数量为4096时,占据总空间=4096个✖16bit(即2Byte)➗1024=8KB 当数组种数量为65536时,占据总空间=65536个✖16bit(即2Byte)➗1024=128KB BitmapContainer位图,核心就是将原有存储数值转化成该数值在哪个位置上存在 由于余数最大值为65535,所以我们需要65536位位图,数值是多少,在位图上对应的位置就是多少。数值等于4096,则位图上4096位值为1;数值等于65535,则位图上65535位值为1。每个位置上的数都占用8KB空间(8KB=65536bit) RunContainer用法相对狭隘,这种类型是Lucene 5之后新增的类型,主要应用在连续数字的存储商,比如倒排表中存储的数组为 [1,2,3…100W] 这样的连续数组,如果使用RunContainer,只需存储开头和结尾两个数字:1和100W,即占用8个字节。这种存储方式的优缺点都很明显,它严重收到数字连续性的影响,连续的数字越多,它存储的效率就越高 如果数组是如下形式 [1,2,3,4,5,100,101,102,999,1000,1001] 就会被拆分为三段:[1,5],[100,102],[999,1001] 至于每次存储采用什么容器,需要进行一下判定,比如ArrayContainer,当存储的元素少于4096个时,他会比BitmapContainer占用更少空间,而当大于4096个元素时,采用ArrayContainer所需要的空间就会大于8kb,那么采用BitmapContainer就会占用更少空间 3 总结 ES在处理海量数据时通过其独到的结构和压缩算法,将索引效率尽可能的提升。虽然在实际业务处理中我们极少遇到海量数据处理的情况,但是通过了解ES的原理,能够帮我们开阔下视野,了解数字之美,算法之美。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册